Lleva Databricks a Kiro IDE con el Databricks Power
Dos formas de conectar Kiro IDE a la plataforma Databricks: los cuatro servidores MCP administrados por Databricks para empezar en 10 minutos, o el Databricks Power y las habilidades de agente oficiales para disponer de toda la funcionalidad.
- Dos formas de conectar Kiro IDE a Databricks: los cuatro servidores MCP administrados por Databricks (Genie, SQL, Unity Catalog Functions, AI Search) para una configuración en 10 minutos basada en un PAT, o el Databricks Power, que instala las habilidades de agente oficiales de Databricks con la Databricks CLI.
- Desarrollo asistido por IA basado en metadatos reales del espacio de trabajo: ambas opciones heredan tus permisos de Unity Catalog, tus filtros de filas y tus máscaras de columnas, de modo que el asistente escribe SQL con tus columnas reales y solo ve lo que tú puedes ver.
- Elige según el alcance: la opción A es la configuración más ligera para analistas y desarrolladores centrados en SQL; la opción B abre toda la plataforma Databricks (pipelines, jobs, Agent Bricks, Lakebase, Declarative Automation Bundles) dentro del IDE.
Por qué es importante
El desarrollo asistido por IA se viene abajo en cuanto el asistente tiene que adivinar nombres de columnas, la estructura de las tablas o qué catálogos puedes leer. La solución es el grounding: conecta el asistente a los metadatos en vivo del espacio de trabajo mediante el Model Context Protocol (MCP). Así, el SQL que escribe usa tus columnas reales, los modelos de dbt combinan tablas reales y cada consulta hereda los permisos de Unity Catalog que ya tienes configurados. El acceso se aplica en Databricks, por lo que la IA solo ve lo que tú puedes ver.
Dos hitos recientes hacen que esto sea práctico en Kiro IDE, creado por AWS:
Primero, Kiro ya es un agente compatible con la Databricks CLI. Desde la CLI v1.20.0, databricks aitools install --agents kiro instala las habilidades de agente oficiales de Databricks en ~/.kiro/skills/. Las habilidades que antes incluía el Databricks AI Dev Kit son ahora estas habilidades oficiales, y la CLI las instala.
Segundo, el Databricks Power del catálogo de Kiro Powers ahora instala esas mismas habilidades oficiales: configura las habilidades con la Databricks CLI y no incluye ningún servidor MCP. Instálalo desde el panel de Powers; su habilidad de configuración te guía por la comprobación de la CLI, el inicio de sesión y la instalación de las habilidades.
Junto con los cuatro servidores MCP remotos administrados por Databricks que ya forman parte de la plataforma, tienes dos formas de conectar Kiro a Databricks. Ambas llevan al mismo resultado: los desarrolladores entregan análisis, pipelines y flujos de trabajo de agentes más rápido cuando el asistente hereda los permisos reales del espacio de trabajo en lugar de adivinar esquemas, columnas y permisos.
Por qué Databricks para el desarrollo asistido por IA
Los dos hitos anteriores hacen que Kiro × Databricks sea práctico. Lo que de verdad importa es lo que hay debajo. Cuatro aspectos convierten a Databricks en la base preferida para el desarrollo asistido por IA, sea cual sea la opción que elijas.
Unity Catalog ancla la IA a nivel de datos. Cada llamada se ejecuta con tus propios permisos, ya sea una herramienta MCP en la opción A o un comando de la Databricks CLI que ejecuta una habilidad en la opción B: los permisos de tabla, los filtros de filas y las máscaras de columnas se aplican al SQL y a los agentes de Genie, y los índices de AI Search se comparten de forma individual. El asistente no tiene una vista privilegiada de tus datos; ve lo que tú ves. No hay una capa de control de acceso independiente que gestionar para el asistente.
Una sola copia de los datos, un solo conjunto de definiciones. Como Databricks es un lakehouse, la tabla que el asistente consulta mediante databricks-sql es la misma en la que escribe tu modelo de dbt, la misma que expone tu agente de Genie y la misma que lee tu dashboard de AI/BI. No hay ninguna sincronización entre warehouse y lago que pueda fallar, ni una capa semántica aparte que mantener sincronizada. Cuando el asistente se basa en samples.tpch.lineitem, se basa en la misma definición que usan todas las demás herramientas.
Toda la pila de IA está integrada, no añadida a posteriori. Unity Gateway enruta las llamadas a modelos. Agent Bricks orquesta flujos de trabajo multiagente. MLflow hace el seguimiento de experimentos y evaluaciones. AI Search impulsa la recuperación semántica. Lakebase gestiona el estado transaccional. Las habilidades cubren todo esto (databricks-unity-gateway, databricks-agent-bricks, databricks-mlflow-evaluation, databricks-vector-search y databricks-lakebase), todo sobre el mismo Unity Catalog. No estás uniendo cinco productos; estás usando una sola plataforma.
Las habilidades las crea Databricks. Los protocolos son abiertos, pero las indicaciones que contienen las habilidades las escribe Databricks específicamente para la forma en que trabajan nuestros clientes.
Las dos opciones de un vistazo
Aspecto | Opción A: servidores MCP administrados | Opción B: Databricks Power |
|---|---|---|
Alcance | 4 servidores: Genie, SQL, Unity Catalog Functions, AI Search | Habilidades de agente oficiales de Databricks, más las habilidades de MLflow |
Qué obtienes | SQL en lenguaje natural, búsqueda semántica, ejecución de funciones gobernada | El alcance de la opción A, más pipelines, jobs, dashboards, Lakebase, Agent Bricks, Declarative Automation Bundles, MLflow, Model Serving y Apps |
Alojamiento | Administrado por Databricks (HTTPS remoto) | Habilidades instaladas en tu equipo por la Databricks CLI (databricks aitools); sin servidor MCP |
Autenticación | PAT en el entorno del shell | Perfil de la Databricks CLI, se recomienda OAuth U2M |
Configuración | Editar ~/.kiro/settings/mcp.json y exportar las variables de entorno | Instalar el Power y seguir su configuración guiada de la CLI |
Ideal para | Analistas y desarrolladores centrados en SQL que quieren hacerle una pregunta a su warehouse en 10 minutos | Ingenieros de datos y desarrolladores de plataformas que necesitan toda la funcionalidad de Databricks en un solo IDE |
La arquitectura de integración de un vistazo
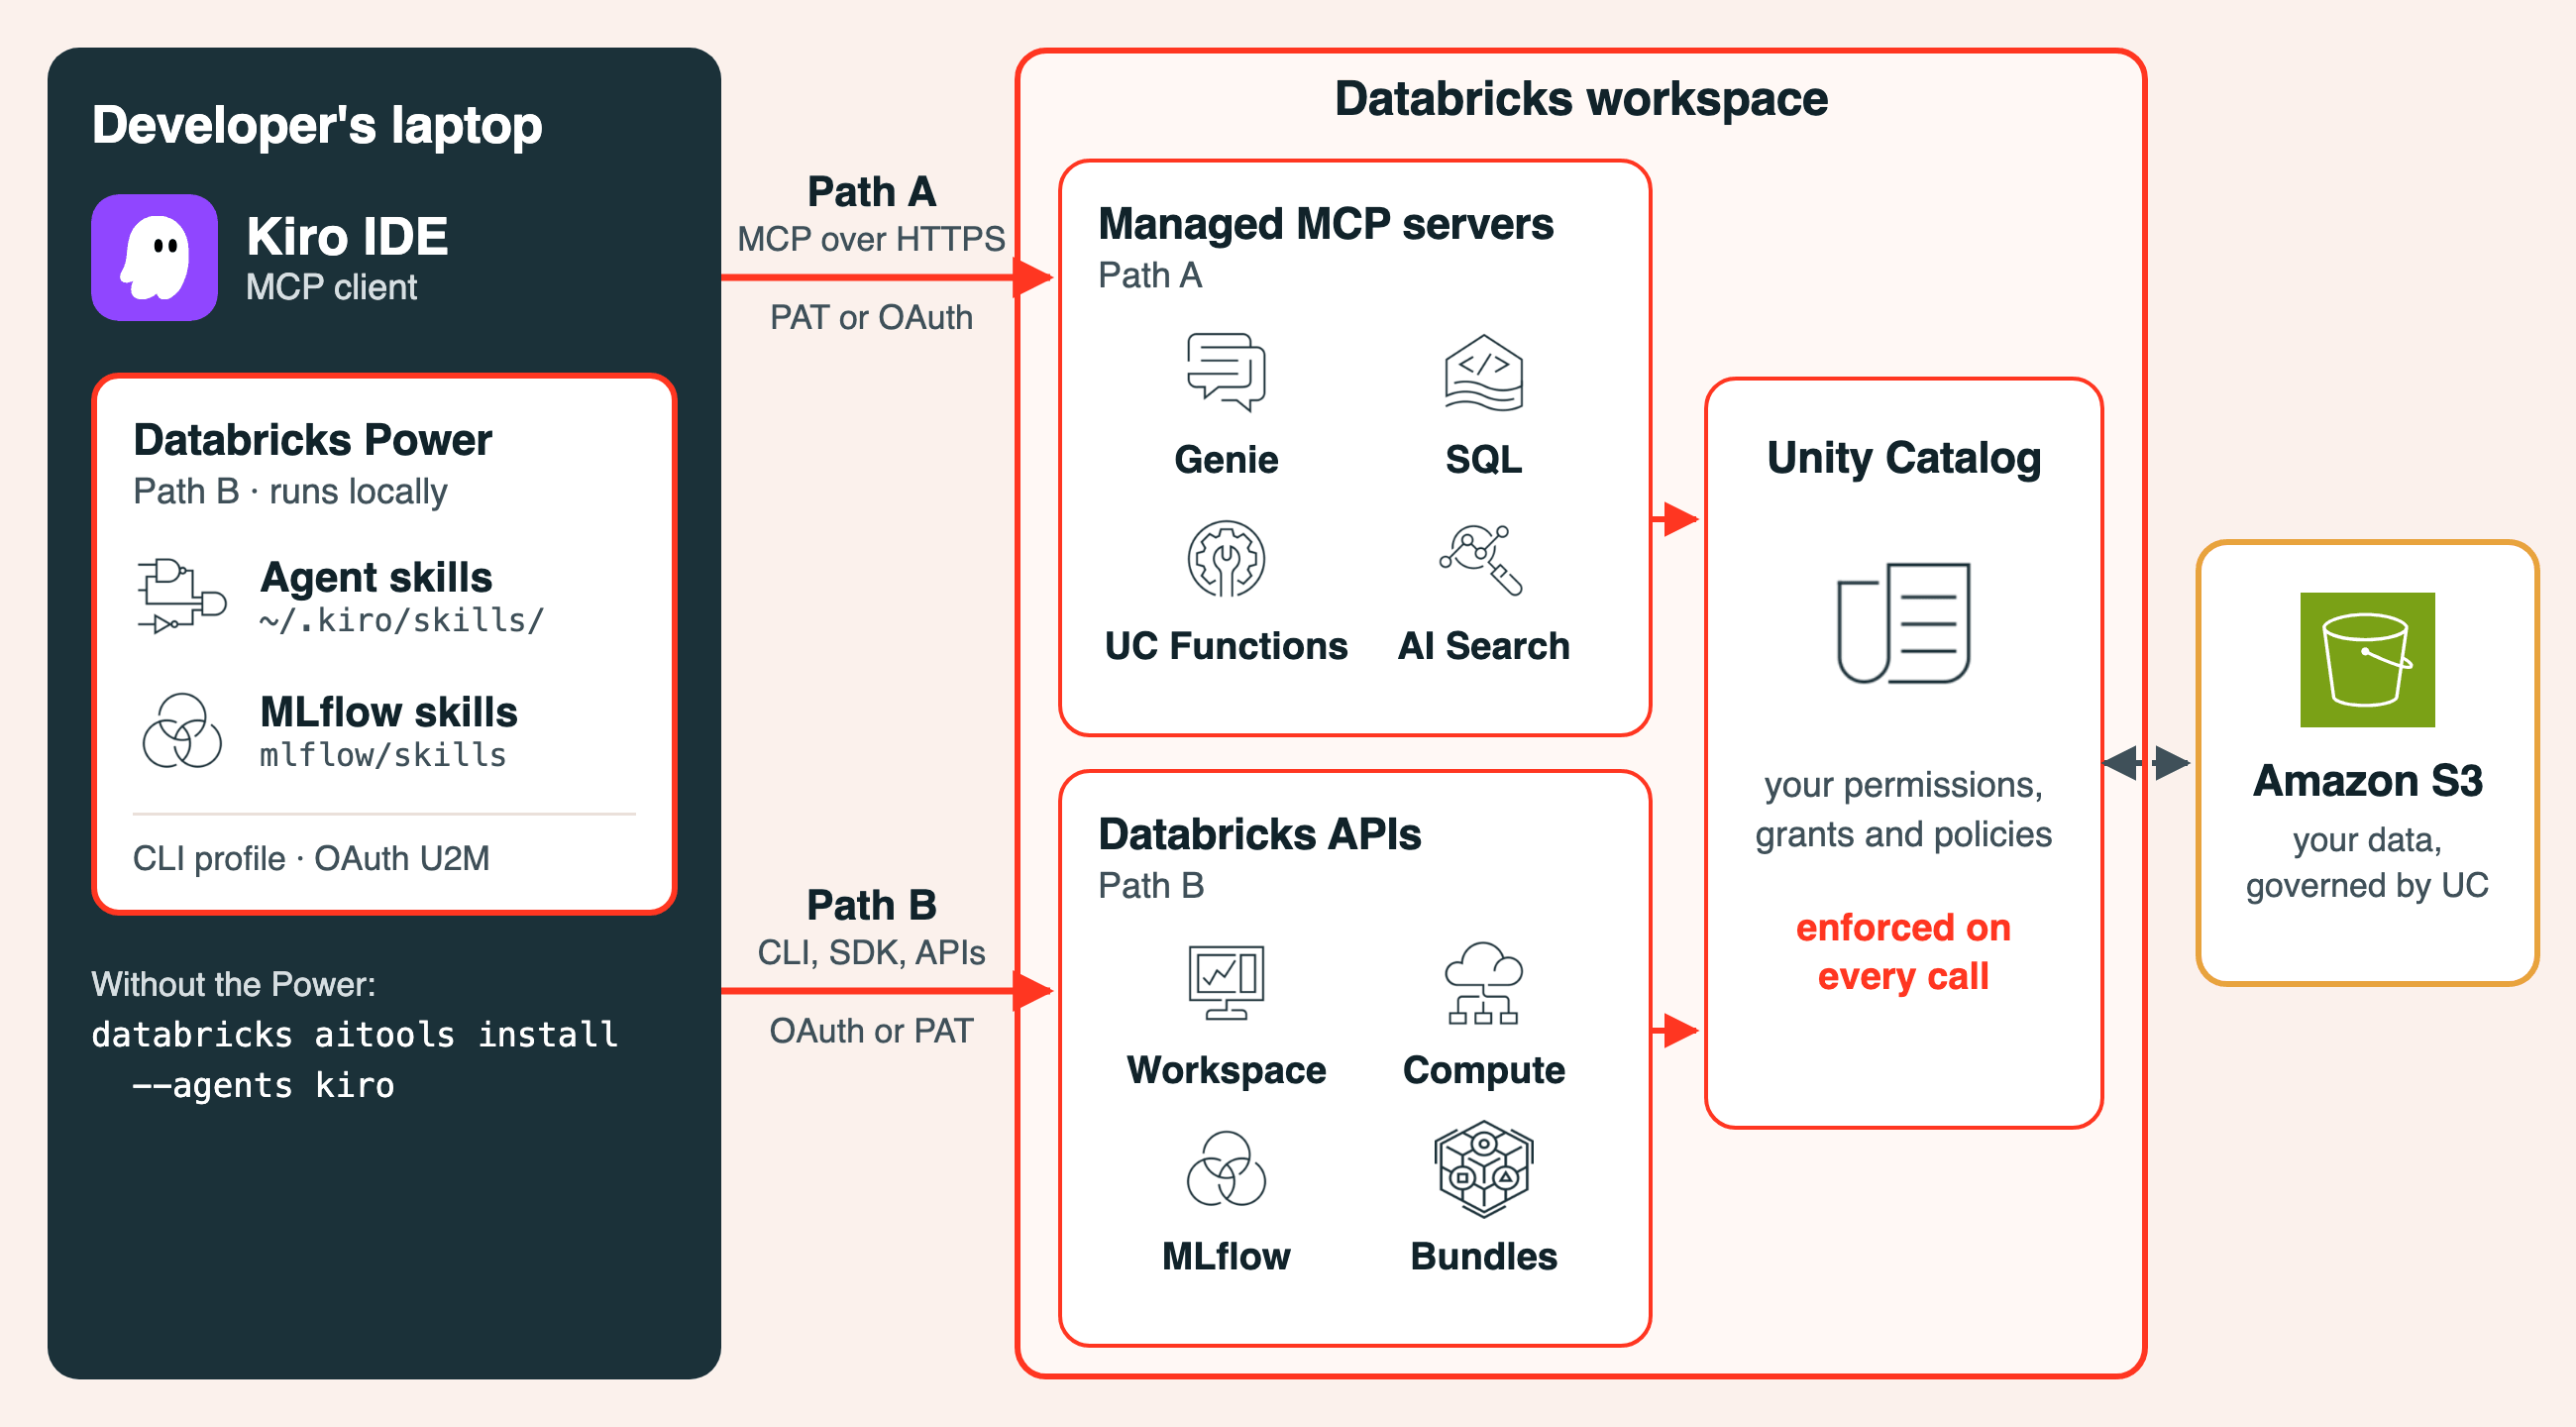
Ambas opciones comparten el mismo back-end: la aplicación de las reglas de Unity Catalog y la identidad del espacio de trabajo de Databricks. Se diferencian en el alcance y en el modelo de autenticación.
Opción A: conéctate a los cuatro servidores MCP administrados
Es la configuración más ligera: un archivo mcp.json, un Personal Access Token de Databricks y una modificación del perfil del shell. En menos de 10 minutos, Kiro se comunica con Genie, SQL, Unity Catalog Functions y AI Search.
Para las nuevas integraciones, Databricks recomienda ahora los MCP system.ai a través de Unity Gateway. Los cuatro endpoints /api/2.0/mcp de esta opción están en Public Preview y no los gobierna Unity Gateway. El acceso sigue dependiendo de tus permisos sobre los recursos subyacentes (agentes de Genie, tablas, funciones, índices y SQL warehouses); lo único que pierdes es el rastreo de Unity Gateway y sus permisos, políticas y barreras de protección a nivel de MCP. El MCP de Genie One (system.ai.genie_one_mcp) está disponible de forma general, y la habilidad de configuración del Databricks Power muestra cómo añadirlo a mcp.json. Consulta Databricks-provided MCPs para ver ambas opciones.
Requisitos previos
- Un espacio de trabajo de Databricks en AWS con Unity Catalog habilitado.
- Un administrador del espacio de trabajo ha habilitado Managed MCP Servers en la página Previews del espacio de trabajo. Sin esto, las URL que aparecen a continuación no funcionan.
- Un Personal Access Token (PAT) de Databricks o un token de OAuth con ámbito para los servidores MCP que vas a usar (
sql,unity-catalog,genie,ai-search). Los PAT que no se usan se revocan automáticamente a los 90 días. - Kiro instalado y abierto al menos una vez, de modo que exista
~/.kiro/. - El nombre de host de tu espacio de trabajo con el formato
<workspace>.cloud.databricks.com.
Genera un PAT de Databricks
En el espacio de trabajo de Databricks, ve a Settings, Developer, Access tokens, Manage, Generate new token. Define una fecha de caducidad que se ajuste a la política de rotación de tu equipo. Selecciona solo los ámbitos de API que necesites; el mínimo privilegio es mejor que la comodidad de «todo». Copia el token de inmediato. Databricks no lo vuelve a mostrar.
Dónde guarda Kiro la configuración de MCP
Kiro lee la configuración de MCP en formato JSON desde dos ámbitos; el del espacio de trabajo tiene prioridad sobre el del usuario.
- Ámbito de usuario:
~/.kiro/settings/mcp.jsonse aplica a todos los espacios de trabajo. - Ámbito del espacio de trabajo:
$PWD/.kiro/settings/mcp.jsonse aplica solo al espacio de trabajo actual y sustituye la entrada con la misma clave del ámbito de usuario.
Instalación con un clic desde el directorio de servidores de Kiro
Abre kiro.dev/docs/mcp/servers/, busca la fila de Databricks y haz clic en Add to Kiro. El navegador abre Kiro y muestra un cuadro de diálogo de confirmación con una configuración ya rellenada. Confirma para escribir la entrada databricks-sql en ~/.kiro/settings/mcp.json. La entrada llega desactivada, con una URL de ejemplo y una referencia a la variable DATABRICKS_ACCESS_TOKEN. A continuación, define la URL como ${DATABRICKS_SQL_MCP_URL}, cambia "disabled" a false y crea ambas variables.
Comprueba (o añade) la entrada databricks-sql
Define las variables de entorno
En el perfil del shell que abre Kiro (normalmente ~/.zshrc en macOS):
Recarga el perfil (source ~/.zshrc) antes de abrir Kiro. Cierra Kiro por completo (Cmd+Q en macOS) y vuelve a abrirlo. Reload Window no vuelve a leer las variables de entorno; solo lo hace un reinicio del proceso.
Kiro solo expande las referencias ${...} de mcp.json para las variables de entorno que hayas aprobado. Cuando Kiro muestre su aviso de seguridad con la lista de variables DATABRICKS_*, apruébalas, o añádelas tú mismo en Settings, Mcp Approved Env Vars.
Añade Genie, Unity Catalog Functions y AI Search
Los cuatro servidores administrados por Databricks se conectan como MCP HTTP remotos. El handshake initialize funciona incluso con una URL de ejemplo; el servidor solo valida el recurso cuando se invoca una herramienta. El fallo más habitual es un estado conectado pero roto, en el que tools/call devuelve RESOURCE_DOES_NOT_EXIST o PERMISSION_DENIED. Haz primero estas comprobaciones previas:
- Genie: comprueba que existe un agente de Genie y que puedes abrirlo. Copia su ID de espacio desde la pestaña Settings del agente (la interfaz lo llama Agent ID); es el
<genie_space_id>de la tabla de URL que aparece más abajo. - Unity Catalog Functions: comprueba que la función existe y que tienes
EXECUTE. Enumera las funciones conSELECT * FROM system.information_schema.routines WHERE routine_type = 'FUNCTION'. - AI Search: comprueba que existe un endpoint con al menos un índice accesible.
- Ámbito del PAT: un PAT con ámbito de espacio de trabajo puede seguir provocando
PERMISSION_DENIEDsi el usuario no tiene acceso al recurso concreto: Can View en el agente de Genie, oSELECTen el índice de AI Search (además deUSE CATALOGyUSE SCHEMA). Los agentes de Genie se comparten de forma individual.
Añade las variables de entorno adicionales (DATABRICKS_GENIE_MCP_URL, DATABRICKS_UC_FUNCTIONS_MCP_URL, DATABRICKS_AI_SEARCH_MCP_URL) y actualiza mcp.json con la configuración completa:
Formatos de URL por servidor:
Servidor | Patrón de URL |
|---|---|
databricks-genie | https://<workspace-hostname>/api/2.0/mcp/genie/<genie_space_id> |
databricks-sql | https://<workspace-hostname>/api/2.0/mcp/sql |
databricks-uc-functions | https://<workspace-hostname>/api/2.0/mcp/functions/<catalog>/<schema>/<function_name> |
databricks-ai-search | https://<workspace-hostname>/api/2.0/mcp/ai-search/<catalog>/<schema>/<index_name> |
Cierra Kiro y vuelve a abrirlo. Abre la sección MCP SERVERS del panel de Kiro; las cuatro entradas databricks-* aparecen con indicadores de estado en verde. Haz clic en reconnect en cualquiera que esté en rojo y repite las comprobaciones previas. Prueba una primera consulta de bajo riesgo en el panel de chat: «List the catalogs I have access to.»
Opción B: instala el Databricks Power
Los cuatro servidores administrados cubren el SQL, la búsqueda semántica y el análisis en lenguaje natural, lo que basta para muchos desarrolladores. Si tu flujo de trabajo incluye pipelines, jobs, Model Serving, Lakebase, Declarative Automation Bundles, Agent Bricks, dashboards de AI/BI, MLflow o Databricks Apps, la configuración de cuatro servidores te obliga a pasarte el día copiando y pegando en la interfaz del espacio de trabajo.
El Databricks Power lo resuelve. Una sola instalación configura las habilidades de agente oficiales de Databricks, que se cargan bajo demanda según la tarea en curso.
Qué obtienes
Ámbito | Cobertura |
|---|---|
SQL & Compute | Ejecutar SQL en warehouses; ejecutar Python o Scala en clústeres; gestionar el ciclo de vida del cómputo |
Pipelines & Jobs | Spark Declarative Pipelines (tablas de streaming, CDC, SCD Type 2, Auto Loader); DAG de jobs con varias tareas |
Unity Catalog | Tablas, volúmenes, permisos, etiquetas, credenciales de almacenamiento, tablas del sistema, metric views, External Iceberg Reads |
Dashboards de AI/BI | Visualizaciones, KPI, dashboards analíticos |
Agentes de Genie | Exploración de datos en lenguaje natural sobre conjuntos de datos gobernados |
Agent Bricks | Knowledge Assistants (RAG) y Multi-Agent Supervisors |
AI Search | Búsqueda semántica y RAG con índices administrados |
Model Serving | Modelos de ML, agentes de IA y Foundation Model APIs (FMAPI) con pago por token, enrutables a través de Unity Gateway |
MLflow | Experimentos, evaluaciones, instrumentación de trazas, consultas de métricas |
Lakebase | PostgreSQL administrado, aprovisionado o con escalado automático, para cargas de trabajo OLTP |
Databricks Apps | Aplicaciones web full-stack sobre el Lakehouse |
Declarative Automation Bundles (antes Databricks Asset Bundles) | Infraestructura como código para los recursos de Databricks |
Instala el Power
En Kiro (IDE 1.0.288 o posterior), abre el panel de Powers, busca databricks e instala el Databricks Power. Después, su habilidad de configuración te guía en cuatro pasos:
- Comprobar que la Databricks CLI es la v1.20.0 o posterior, la primera versión compatible con Kiro en
databricks aitools, e instalarla o actualizarla si hace falta. - Iniciar sesión en la CLI con
databricks auth logino reutilizar un perfil que ya tengas. - Instalar las habilidades con
databricks aitools install --agents kiro --scope global, que las coloca en~/.kiro/skills/. Usa--scope projectpara instalarlas solo en un espacio de trabajo. - Añadir ocho habilidades de MLflow desde mlflow/skills (rastreo, evaluación, análisis de trazas, métricas), que la CLI no incluye.
Aparte de su habilidad de configuración, el Power no incluye contenido ni ningún servidor MCP. La CLI descarga las habilidades desde databricks/databricks-agent-skills, y tú mismo las actualizas con databricks aitools update.
Autenticación
Las habilidades ejecutan comandos de la Databricks CLI, así que usan un perfil de la Databricks CLI. Para el uso interactivo, inicia sesión con OAuth user-to-machine: databricks auth login --host https://<your-workspace-url> --profile <profile-name> abre un navegador y el token se renueva automáticamente. El OAuth con entidad de servicio es adecuado para la automatización, y los Personal Access Tokens siguen siendo una opción; consulta Databricks CLI authentication. La habilidad de configuración enumera tus perfiles existentes sin mostrar ningún secreto y nunca reutiliza uno sin preguntarte.
Comprueba la instalación
Kiro carga las habilidades al iniciar una sesión de chat, así que abre una nueva sesión y pregunta: «Using the databricks-core skill, which workspace am I connected to?» Una respuesta correcta confirma la CLI, tu perfil y las habilidades. databricks aitools list muestra la versión instalada de cada habilidad.
Actualización desde el AI Dev Kit Power
Si instalaste el anterior Databricks AI Dev Kit Power, actualiza el Power en Kiro y luego sigue los pasos de las habilidades y de MLflow indicados arriba. Algunos elementos están fuera del Power y hay que limpiarlos a mano: una entrada databricks de nivel superior en mcp.json que ejecuta databricks-mcp-server/run_server.py, y cualquier exportación de credenciales DATABRICKS_* que la configuración anterior añadiera a tu perfil del shell. De forma opcional, elimina el clon de ai-dev-kit (~/.ai-dev-kit, o el directorio indicado en AIDEVKIT_HOME), pero solo si no usas ai-dev-kit para otros agentes o proyectos. Borra el directorio en lugar de ejecutar install.sh --uninstall de ai-dev-kit, que elimina carpetas de habilidades por nombre de ~/.kiro/skills/, incluidas las que instaló la Databricks CLI. La sección «Migrating from the AI Dev Kit Power» de la habilidad databricks-kiro-setup del Power cubre los tres puntos.
Cómo elegir entre las dos opciones
Un árbol de decisión sencillo:
- ¿Solo ejecutas SQL, haces preguntas en lenguaje natural sobre conjuntos de datos gobernados mediante Genie y buscas en índices de AI Search? Usa la opción A. Los cuatro servidores administrados hacen exactamente eso, y la configuración lleva 10 minutos.
- ¿Creas pipelines, gestionas jobs, despliegas Declarative Automation Bundles, trabajas con Lakebase, desarrollas Databricks Apps o llamas a Agent Bricks? Usa la opción B. El kit de herramientas completo es demasiado amplio para añadirlo como servidores MCP remotos sueltos.
- ¿Un poco de todo? Usa ambas. Las opciones A y B no entran en conflicto: la opción B añade habilidades, no servidores MCP, así que los cuatro servidores de la opción A (
databricks-genie,databricks-sql,databricks-uc-functions,databricks-ai-search) conviven con ella en el panel MCP de Kiro. La habilidad de configuración del Power también puede guiarte para añadir a tumcp.jsonun MCP proporcionado por Databricks, como Genie One, a través de Unity Gateway.
Para los desarrolladores que piensan trabajar a diario en Kiro con cargas de trabajo de Databricks, la opción B es la mejor solución a largo plazo. La opción A es la adecuada si tienes 10 minutos y un SQL warehouse con el que quieres conversar.
Desde la perspectiva de quien desarrolla
Las dos opciones encajan de forma distinta según quién use el IDE. Cuatro perfiles, cuatro problemas, cuatro respuestas.
El analytics engineer. Pasas la mitad del día consultando tablas que nunca has visto y la otra mitad copiando y pegando entre tu editor y la interfaz del espacio de trabajo. La opción A lo resuelve en 10 minutos. Los servidores de Genie y SQL basan cada consulta en metadatos de esquema reales; el asistente escribe con tus columnas reales, sin adivinar; y cada resultado hereda tus permisos de Unity Catalog. Se acabó cambiar de pestaña.
El ingeniero de datos. Tu día a día son los pipelines, los jobs, los Declarative Automation Bundles y las promociones entre entornos que conllevan. Escribir databricks.yml a mano y ejecutar databricks bundle deploy desde un terminal lateral es el camino lento. La opción B es el rápido. Las habilidades del Power para pipelines, jobs y Declarative Automation Bundles generan, validan y despliegan IaC en una sola conversación. Spark Declarative Pipelines, CDC, SCD Type 2, Auto Loader: todo generado a partir de tus tablas reales de Unity Catalog y listo para el commit.
El desarrollador de IA y agentes. Conectas llamadas a modelos, evaluación, gobierno y orquestación de agentes entre tres o cuatro herramientas que no terminan de coincidir en el esquema. La opción B cubre toda la oferta de IA de Databricks: Unity Gateway para el enrutamiento y las alternativas de respaldo, Agent Bricks para supervisores multiagente y asistentes de conocimiento, MLflow para la evaluación y AI Search para la recuperación, todo gobernado de extremo a extremo por Unity Catalog. Tu agente hereda los mismos permisos que quien lo invoca, y tus trazas de evaluación llegan al mismo espacio de trabajo que tus ejecuciones de entrenamiento.
El desarrollador de plataformas. Gestionas los recursos de Databricks como código, haces promociones entre dev/stage/prod y respondes cada semana a la pregunta «¿nos hemos desviado?». La habilidad de Declarative Automation Bundles de la opción B (databricks-dabs), junto con las habilidades de gestión de Unity Catalog, genera el bundle completo, lo valida y muestra el plan de despliegue (databricks bundle plan) antes de cambiar nada. Dejas de mantener un conjunto de YAML a mano y otro en un documento.
Un flujo de trabajo que puedes probar hoy
Sea cual sea la opción que hayas elegido, este ejercicio basa al asistente en metadatos reales del espacio de trabajo usando el conjunto de datos samples.tpch del catálogo samples integrado.
Preguntas: «What columns and types does samples.tpch.lineitem have, and what is the data distribution by l_shipdate year?»
Kiro devuelve el esquema real y un histograma a partir de una sola consulta. Nombres de columnas reales y una distribución real, basados en tu espacio de trabajo.
Preguntas: «Draft a dbt model that joins lineitem to orders and aggregates revenue by nation per quarter.»
Kiro genera SQL con los nombres de columna reales (l_extendedprice, l_discount, o_orderdate) en lugar de suposiciones. Como consultó primero el esquema, conoce los tipos exactos y la granularidad.
Preguntas: «Run my new aggregation against samples.tpch and compare the row count to last week's snapshot in poc.gold.revenue_by_nation_qtr.»
Kiro ejecuta ambas consultas y muestra las diferencias. Si una cifra no cuadra, «Show me the lineage for gold.revenue_by_nation_qtr» obtiene las tablas de origen desde system.access.table_lineage. Una vez verificado, Kiro genera el JSON del job de Databricks para el modelo e indica qué catálogos y esquemas utiliza.
En la opción B, el mismo flujo de trabajo se amplía a «Generate a Declarative Automation Bundle for this job and deploy it to staging», «Create an AI/BI dashboard backed by this aggregation» o «Wire this into a Unity Gateway endpoint with a fallback model», todo sin salir del IDE.
Prácticas recomendadas, sea cual sea la opción
- Autenticación con mínimo privilegio. Genera un PAT distinto por estación de trabajo y por conjunto de ámbitos. En la opción B, para el uso interactivo, es preferible OAuth U2M a los PAT.
- Nunca hagas commit de credenciales. Guarda
DATABRICKS_ACCESS_TOKENen tu perfil del shell o en un gestor de secretos. Nunca lo pongas en unmcp.jsonque esté en el control de versiones. - Un ámbito por proyecto. Guarda los ID de los agentes de Genie y las rutas de los índices de AI Search en
$PWD/.kiro/settings/mcp.jsonpara que cada proyecto lleve sus propias vinculaciones de recursos. - Confía en los permisos de Unity Catalog. En ambas opciones, la IA trabaja con tus permisos efectivos: permisos de tabla, filtros de filas y máscaras de columnas en el SQL y en los agentes de Genie, y uso compartido por recurso en los índices de AI Search. No hay una capa de control de acceso independiente que gestionar.
- Reinicia, no recargues. Kiro lee las variables de entorno una sola vez, al iniciar el proceso. Después de editar tu perfil del shell o añadir la autenticación, cierra Kiro por completo (Cmd+Q en macOS) y vuelve a abrirlo.
Solución de problemas
«Server not found» o estado en rojo en una entrada MCP.
Opción A: comprueba echo $DATABRICKS_SQL_MCP_URL en el shell desde el que se abrió Kiro. Un valor vacío significa que Kiro no puede resolver la URL. Asegúrate de que el mcp.json del ámbito del espacio de trabajo no está ocultando tu configuración del ámbito de usuario. Comprueba que el PAT sigue siendo válido en Settings, Developer, Access tokens.
Conectado a MCP, pero las llamadas a herramientas devuelven RESOURCE_DOES_NOT_EXIST o PERMISSION_DENIED.
Es el fallo más habitual de la opción A. El handshake initialize funciona con una URL de ejemplo porque el servidor aplaza la validación del recurso hasta la invocación. Repite las comprobaciones previas para el servidor concreto (el agente de Genie existe y está compartido contigo, la función existe y tienes EXECUTE, el índice de AI Search existe y tienes SELECT sobre él).
Kiro no usa las habilidades de Databricks (opción B).
Abre una nueva sesión de chat, ya que las habilidades se cargan al iniciar una sesión, y comprueba que databricks-core/SKILL.md existe en ~/.kiro/skills/. Error: unknown agent "kiro" significa que la Databricks CLI es anterior a la v1.20.0; actualízala y vuelve a ejecutar la instalación. Si el comando de la CLI de una habilidad no consigue autenticarse, ejecuta databricks auth profiles y vuelve a iniciar sesión con databricks auth login.
Pruébalo hoy. El Databricks Power es la forma más rápida de llevar toda la plataforma (pipelines, jobs, Lakebase, Agent Bricks y todo lo anterior) a Kiro. Instálalo desde el catálogo de Kiro Powers en kirodotdev/powers, o instala las mismas habilidades sin el Power ejecutando databricks aitools install --agents kiro con la Databricks CLI v1.20.0 o posterior. Para otros agentes de programación, databricks aitools install detecta los que tienes en tu equipo (Claude Code, Cursor, Codex, GitHub Copilot, Gemini CLI y otros); ejecuta databricks aitools --help para ver la lista actual, o consulta databricks/databricks-agent-skills. Para los cuatro servidores MCP administrados por Databricks, la instalación con un clic está en kiro.dev/docs/mcp/servers/.
¿Tienes comentarios o algún problema? Abre una issue: para la configuración o el empaquetado del Power, kirodotdev/powers; para las habilidades de agente, databricks/databricks-agent-skills; para la Databricks CLI y databricks aitools, databricks/cli. Las leemos todas.
Socios, Lakebase, Genie, Unity Gateway, Agent Bricks, Unity Catalog, MCP, Developer Tools, AI Search, MLOps & LLMOps y Business Intelligence
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.