Datos de fabricación y AI: conectando la cadena de valor del producto
Ofrezca a cada etapa de la cadena de valor de fabricación acceso a datos de confianza y AI
- Los datos de fabricación abarcan una cadena de valor de producto conectada, pero los sistemas que los capturan siguen separados por función y planta
- Databricks reúne los datos de sistemas dispares (o los consulta in situ) para que los equipos puedan responder a preguntas de distintas etapas a lo largo de la cadena de valor
- La semántica gobernada, la analítica de lenguaje natural y las aplicaciones agénticas ayudan a más personas a pasar de buscar datos a tomar medidas sin necesidad de convertirse en ingenieros de datos
Un defecto de fabricación rara vez pertenece a un solo sistema. Un pico de descarte puede estar relacionado con el ajuste de una máquina, un lote de un proveedor, un evento logístico o un problema recurrente registrado en un sistema de calidad. Sin embargo, los datos necesarios para investigarlo suelen estar divididos entre los límites de la planta, las funciones y los sistemas.
Hace más de 50 años, la visión del Dr. Joseph Harrington de la Manufactura Integrada por Computadora (CIM) reconoció que la fabricación depende de un flujo conectado de información entre las distintas funciones. Hoy en día, esa visión se está volviendo práctica a medida que los datos y la IA conectan las etapas de la cadena de valor del producto.
Las preguntas más difíciles en la fabricación son las que abarcan varias etapas:
- ¿Qué lote de proveedor llegó a los productos afectados?
- ¿Ha aparecido este defecto antes? ¿Funcionó la acción correctiva?
- ¿Qué clientes o casos de servicio podrían verse afectados?
Responder a cualquiera de estas preguntas requiere unificar datos de sistemas que nunca fueron diseñados para comunicarse entre sí. Los fabricantes no necesitan más informes aislados. Necesitan un flujo conectado de información a lo largo de la cadena de valor del producto, con la gobernanza y el contexto empresarial necesarios para que esa información sea útil. Este es el papel que puede desempeñar una plataforma moderna de datos e IA.
¿Qué es la cadena de valor del producto en la fabricación?
La cadena de valor del producto es la secuencia de extremo a extremo de funciones que transforma las materias primas y las ideas en productos entregados a los clientes y asistidos en el terreno. Conecta la investigación y desarrollo (R&D) y la ingeniería, las compras, la producción y la calidad, las ventas y el marketing, y el servicio de posventa y de campo. Cada etapa tiene sus propios objetivos, equipos y sistemas operativos:
- La investigación y desarrollo (R&D) y la ingeniería trabajan con la gestión del ciclo de vida del producto (PLM), el diseño asistido por computadora (CAD), la ingeniería asistida por computadora (CAE) y simulación, datos de prueba, requisitos y listas de materiales (BOM) de ingeniería.
- El departamento de compras trabaja con las compras de planificación de recursos empresariales (ERP), procesos de source-to-pay, contratos, riesgo de proveedores y portales de proveedores.
- La producción y la calidad trabajan con los sistemas de ejecución de manufactura (MES), datos de control de supervisión y adquisición de datos (SCADA)/controladores lógicos programables (PLC), historiadores de procesos, sistemas de gestión de calidad (QMS)/sistemas de gestión de información de laboratorio (LIMS) y sistemas de mantenimiento.
- La logística y la cadena de suministro trabajan con la planificación de recursos empresariales (ERP), sistemas de gestión de almacenes (WMS), sistemas de gestión de transporte (TMS), sistemas de planificación, intercambio electrónico de datos (EDI) y telemática.
- Las ventas y el marketing trabajan con la gestión de relaciones con el cliente (CRM), configuración, precio y cotización (CPQ), fijación de precios, gestión de distribuidores, automatización de marketing y comercio electrónico.
- El servicio de posventa y de campo trabaja con la gestión de servicios, garantías, planificación de repuestos de servicio, datos de productos conectados, diagnósticos y tickets.
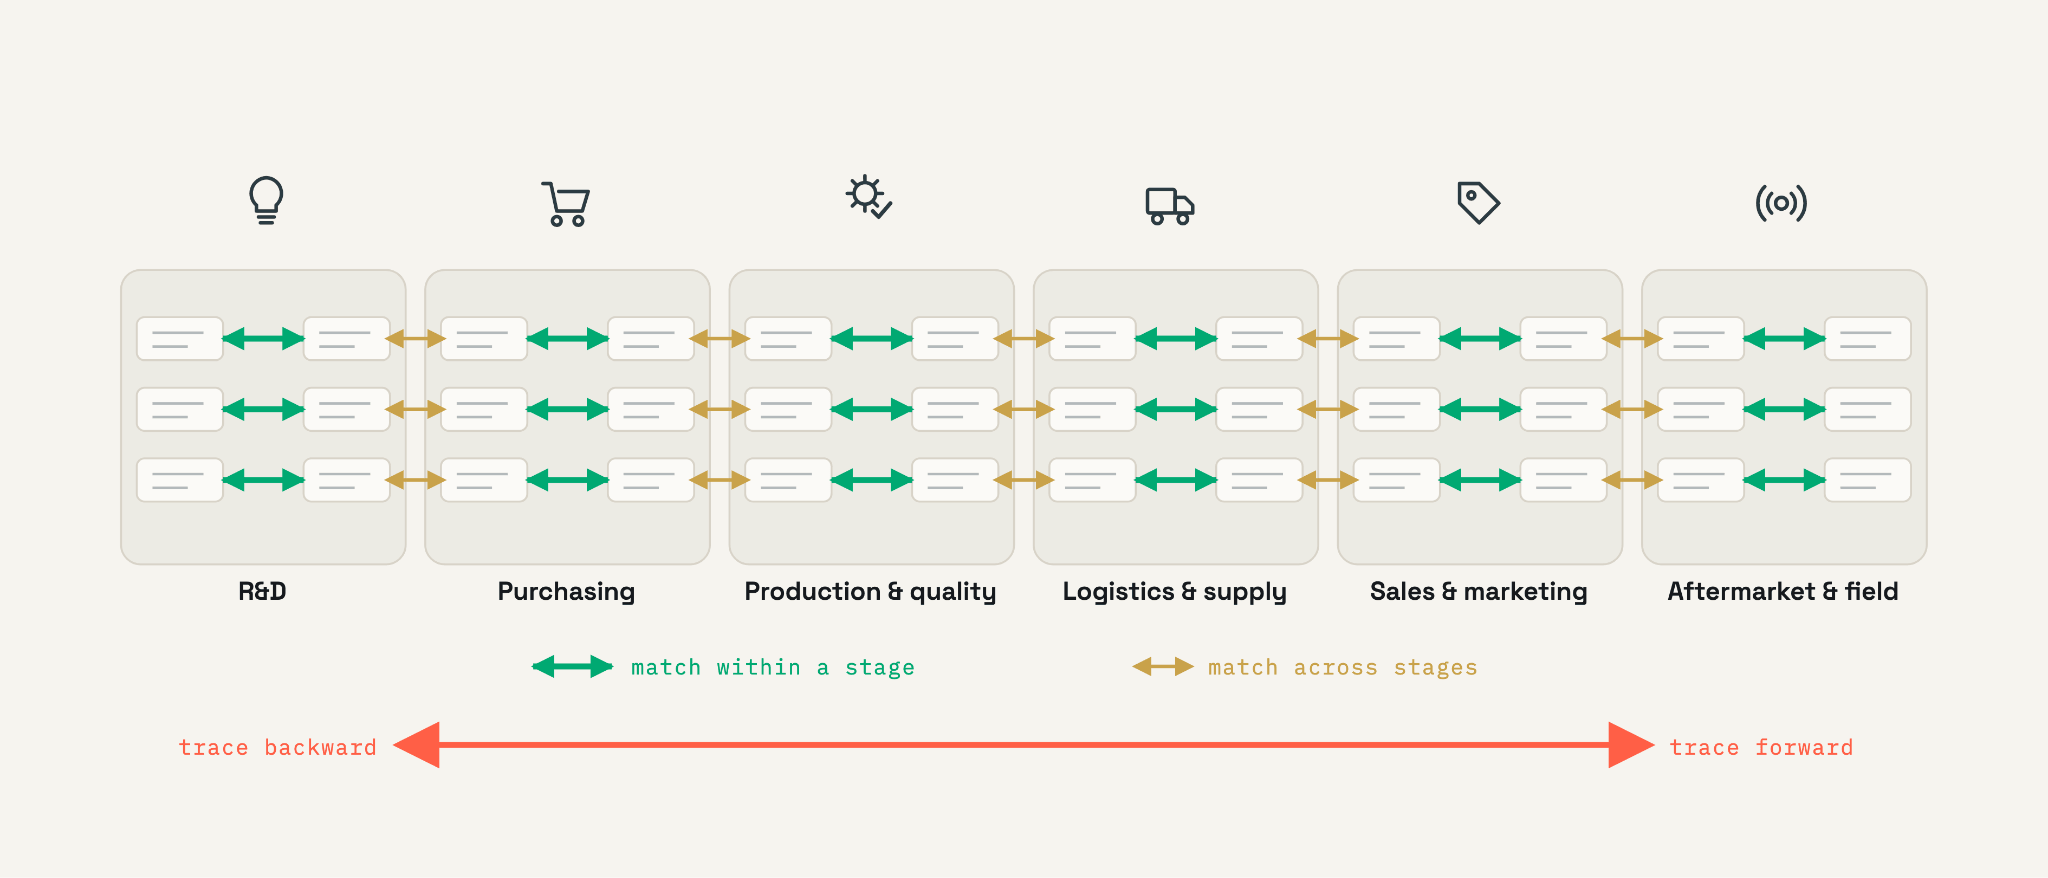
Cada etapa produce datos operativos valiosos. La mayor oportunidad surge al conectar un hallazgo en una parte de la cadena con una acción en otra: un problema de calidad detectado en producción investigado a través de registros de logística y proveedores, o una alerta de proveedor rastreada hacia adelante en cada producto que recibió el material afectado.
Por qué los límites de los sistemas son el verdadero problema
Cuando cada etapa de la cadena de valor está aislada, una pregunta que abarca varias etapas se convierte en un proyecto manual de tickets, exportaciones y conciliación. Cuando los datos son accesibles como un único sistema gobernado, la misma pregunta se convierte en una consulta.
Ejemplo 1: Un ingeniero de calidad de planta necesita responder tres preguntas:
- ¿El pico de descarte es causado por el lote, la máquina o la configuración, y sigue ocurriendo ahora?
- ¿Hemos visto este defecto antes y se mantuvo la solución?
- ¿Por qué una planta descarta muchas más piezas de la misma parte que otra?
Cada pregunta abarca múltiples sistemas: registros del sistema de ejecución de manufactura (MES), datos del historiador de procesos, datos de proveedores y de gestión de calidad de proveedores (SQM), historial del sistema de gestión de calidad (QMS), registros de las Ocho Disciplinas (8D) y, a menudo, múltiples instancias de plantas. Hoy en día, responder a cada una de ellas significa generar tickets, realizar exportaciones manuales y depender de unos pocos especialistas.
Ejemplo 2: Un analista de compras necesita responder tres preguntas:
- ¿Qué piezas críticas dependen de un solo proveedor que ahora está marcado con riesgo de entrega?
- ¿Ha disminuido el rendimiento de entrega a tiempo y de calidad de un proveedor en los pedidos recientes?
- Si un proveedor falla, ¿qué productos, plantas y pedidos abiertos quedan expuestos?
Cada pregunta abarca múltiples sistemas: registros de compras y de source-to-pay de planificación de recursos empresariales (ERP), contratos, fuentes de riesgo de proveedores y portales de proveedores. Hoy en día, responder a cada una de ellas puede convertirse en un pequeño proyecto de tickets, conocimiento especializado y exportaciones manuales.
Agrupar esas fuentes de datos operativos elimina esa fricción. Reúna la cadena de valor una vez, gobiérnela una vez y use un identificador compartido (un número de serie, de lote o de pieza) como clave de unión, y la trazabilidad se convertirá en una consulta. Seis preguntas, una necesidad subyacente: unir datos de sistemas que nunca fueron diseñados para conectarse y confiar en el resultado. Cuatro capacidades de la plataforma lo hacen posible.
Cómo Databricks conecta los datos de fabricación
No se requiere una migración disruptiva
Una cadena de valor conectada no requiere una migración disruptiva de cada sistema de origen. Los datos se pueden copiar cuando esa sea la opción correcta, o pueden permanecer en su lugar y seguir siendo consultados.
Con Open Sharing sin copia y Lakehouse Federation, las organizaciones pueden acceder a los datos en sus sistemas de origen sin crear otra canalización de extracción, transformación y carga (ETL) o copia para cada caso de uso. Cuando la duplicación es adecuada, los conectores y el almacenamiento de objetos en la nube proporcionan una ruta escalable para llevar los datos al lakehouse.
La plataforma de datos e IA de Databricks reúne esta flexibilidad con las capacidades que necesitan los equipos de fabricación: análisis histórico de los datos de producción, calidad y suministro; procesamiento de baja latencia para la telemetría de máquinas y vehículos; y aplicaciones que pueden leer y escribir registros individuales rápidamente.
Las cuatro capacidades en las que se basan los ejemplos
Agrupar o federar los datos de origen, sin una migración disruptiva: La pregunta del ingeniero de calidad abarca registros de MES, historiador de procesos, proveedores y SQM, QMS y 8D en todas las instancias de la planta; la del analista de compras abarca compras de ERP, contratos y fuentes de riesgo de proveedores. Con Open Sharing sin copia y Lakehouse Federation, esos datos se pueden consultar en su lugar y duplicar a través de conectores cuando copiar sea la mejor opción. De cualquier manera, no se requiere una nueva copia de ETL por pregunta.
Orquestación y refinamiento: Ambos ejemplos se unen contra tablas gold gobernadas, no contra extractos sin procesar. Lakeflow ayuda a los equipos a crear, programar y monitorear las canalizaciones que convierten las entradas de datos sin procesar en datos confiables y listos para el análisis, comúnmente a través de las capas Bronze, Silver y Gold.
Gobernanza para datos e IA: Unity Catalog es el plano de control único para los datos duplicados y federados: un modelo de permisos, linaje completo y descubrimiento que abarca datos, modelos y agentes de IA, de modo que la misma superficie gobernada responde a ambos ejemplos. Unity Gateway le permite controlar el acceso a la IA, el gasto y la observabilidad en agentes, herramientas, modelos y MCP.
Capacidades agénticas: Creado sobre esta base gobernada, Genie One es un compañero de trabajo de IA que se conecta a sus datos, Agent Bricks ayuda a crear agentes de IA basados en datos empresariales y Genie App Builder permite a cualquiera crear agentes y aplicaciones en lenguaje natural. El ingeniero y el analista pueden hacer sus preguntas en un lenguaje sencillo y obtener respuestas basadas en las definiciones que reconoce la empresa, el tema de las siguientes dos secciones.
El principio de diseño práctico es simple: agrupar los datos donde aportan valor, federarlos donde copiar no tiene sentido y gobernar ambos a través del mismo plano de control. El resultado es una forma de trabajar con los tipos y etapas de datos de fabricación sin crear un nuevo silo para cada caso de uso analítico o de IA.
Mejorar la alfabetización de datos: hacer que los datos sean útiles para más personas que solo los especialistas
Una plataforma solo es tan valiosa como las personas que pueden usarla. En muchas organizaciones de fabricación, un pequeño grupo de expertos comprende los sistemas específicos de la planta, mientras que los usuarios de negocio esperan informes o exportaciones.
La alfabetización de datos crece cuando las personas pueden avanzar a través de una progresión práctica: encontrar datos relevantes, comprender definiciones de confianza, analizarlos, hacer preguntas en lenguaje natural, crear agentes o aplicaciones gobernados y compartir esos activos con otros. No todos necesitan convertirse en ingenieros de datos para participar. Ese crecimiento sigue seis pasos, que se muestran a continuación.

La tecnología es solo una parte del cambio. La capacitación, las comunidades de práctica y una red de campeones ayudan a que cada función desarrolle confianza y comparta patrones reutilizables. Una superficie de datos común y gobernada ofrece a esas comunidades una base concreta sobre la cual trabajar: definiciones compartidas, vocabulario común y respuestas que se pueden reutilizar en todos los equipos.
Cómo funciona "Hablar con los datos" en la fabricación (y por qué requiere una semántica gobernada)
La forma más rápida de mejorar la alfabetización de datos es permitir que las personas hablen con sus datos: sin lenguajes de consulta que aprender, sin tickets que generar y sin informes que esperar. El análisis en lenguaje natural puede reducir la barrera de acceso a los datos, pero una interfaz conversacional no es suficiente. La respuesta debe basarse en definiciones que la empresa reconozca.
Ejemplo: Compras
Una pregunta como "¿Qué piezas críticas dependen de un único proveedor que ahora está marcado con riesgo de entrega?" puede requerir conocimiento de los encabezados de tabla específicos de SAP, uniones (joins) y reglas de negocio. Un analista de compras no debería necesitar convertirse en un especialista en datos para investigarlo.
La demostración de Purchasing Genie hace que este patrón sea concreto. El proyecto ejecutable sigue tres pasos: preparar datos gobernados, crear agentes expertos y luego componerlos bajo un supervisor y compartirlos como una sola aplicación gobernada.

Este patrón separa el trabajo que requiere experiencia técnica (preparar y gobernar los datos) del trabajo que los usuarios de negocio deberían poder hacer por sí mismos: hacer preguntas, revisar respuestas y tomar medidas.
Ejemplo: Informes de KPI
El mismo patrón se aplica a los informes diarios. Cuando las definiciones de KPI residen en una capa semántica gobernada, tanto las herramientas de BI como la AI trabajan a partir de la misma lógica de negocio. Los agentes de Genie responden preguntas dentro de una función utilizando esas definiciones de confianza, y Agent Bricks los compone en agentes basados en roles que funcionan en distintas funciones. El resultado: la misma pregunta obtiene la misma respuesta cada vez, basada en definiciones que la empresa reconoce en lugar de inferirse de esquemas complejos o informes desconectados.
Mercedes-Benz Korea aplica este patrón en la práctica, puede obtener más información aquí.
Un camino práctico a seguir
Hace más de 50 años, la visión del Dr. Joseph Harrington de la fabricación integrada por computadora (Computer Integrated Manufacturing) describía la fabricación como un sistema cohesivo, unificado por el flujo de información. Esa visión ahora es alcanzable a escala.
La receta de implementación consta de tres pasos:
- Agrupar los datos una vez y gobernarlos una vez con Unity Catalog como el plano de control único, que cubre fuentes de datos tanto reflejadas como federadas.
- Hacer que un identificador compartido sea la clave de unión (join key), ya sea un número de serie, de lote o de pieza, para que los hallazgos en una parte de la cadena de valor puedan impulsar acciones en otra, lo que permite la trazabilidad de extremo a extremo como una consulta. El identificador adecuado depende del dominio: unidades serializadas y VIN en algunos casos, números de lote o partida en la fabricación por procesos.
- Permitir que las personas hablen con sus datos al basar el acceso en lenguaje natural en una semántica de negocio gobernada.
Cuando los usuarios de negocio pueden hacer preguntas en un lenguaje sencillo y recibir respuestas confiables, la alfabetización de datos deja de ser el privilegio de unos pocos especialistas y se convierte en una capacidad organizacional. El resultado no es otro panel de control. Son miles de personas en toda la cadena de valor que pueden encontrar, comprender y actuar sobre datos de confianza.
Preguntas frecuentes (FAQ)
¿Cuál es el mayor beneficio de conectar los datos de fabricación en toda la cadena de valor?
El mayor beneficio de conectar los datos de fabricación en toda la cadena de valor es la capacidad de responder preguntas que comienzan en una etapa y requieren acción en otra. Un defecto de producción se puede rastrear a través de la logística hasta el lote del proveedor que lo causó, o un lote de proveedor sospechoso se puede rastrear hacia adelante hasta cada producto al que llegó. Sin datos conectados, cada una de estas investigaciones requiere días de trabajo manual. Con un lakehouse conectado, la misma pregunta se convierte en una consulta.
¿Necesitan los fabricantes migrar todos los datos de origen a Databricks?
Los fabricantes no necesitan migrar todos los datos de origen a Databricks. Los datos se pueden copiar cuando sea útil, pero Open Sharing sin copia y Lakehouse Federation permiten que los datos permanezcan en los sistemas de origen y se consulten en el lugar. Unity Catalog puede gobernar tanto los datos federados como los reflejados.
¿Qué es la trazabilidad?
La trazabilidad vincula los pasos del proceso de fabricación, los productos, los materiales y los registros operativos para que los equipos puedan realizar un seguimiento retrospectivo desde un producto afectado o un seguimiento prospectivo desde un material sospechoso. Esto permite resolver problemas más rápido y realizar análisis de retirada de productos más precisos. Un ejemplo es rastrear los números de serie o de lote de los productos fabricados.
¿Qué es LTAP y por qué lo necesitan los fabricantes?
LTAP significa Lake Transactional/Analytical Processing. Describe la ejecución de cargas de trabajo analíticas y transaccionales en una sola plataforma gobernada. La fabricación necesita tanto análisis a gran escala de datos históricos como aplicaciones receptivas que lean y escriban registros operativos. Históricamente, estos residían en dos pilas separadas con datos copiados entre ellas; LTAP ejecuta ambos en una sola copia de datos gobernados.
¿Qué hace que la alfabetización de datos crezca más allá de las características de la plataforma?
Las características por sí solas no son suficientes. La capacitación, las comunidades de práctica y los campeones en cada función ayudan a las personas a generar confianza, compartir patrones y utilizar una superficie de datos común y gobernada. La plataforma proporciona la base; una comunidad activa la convierte en una capacidad amplia.
¿Cómo se vuelve confiable "Hablar con los datos"?
El acceso en lenguaje natural debe basarse en una semántica de negocio gobernada: medidas documentadas, dimensiones, uniones (joins) y definiciones. Genie puede entonces responder preguntas utilizando el mismo contexto de confianza en lugar de inferir el significado a partir de esquemas complejos o informes desconectados.
¿Qué es Lakehouse Federation?
Lakehouse Federation es una capacidad de Databricks que permite que los datos permanezcan en su sistema de origen y, al mismo tiempo, se consulten a través de Databricks. Evita la creación de canalizaciones ETL adicionales o copias de datos. Los datos de origen se gobiernan a través de Unity Catalog junto con cualquier dato reflejado, lo que proporciona una capa de gobernanza unificada independientemente de dónde residan físicamente los datos.
¿Qué es Unity Catalog en el contexto de los datos de fabricación?
Unity Catalog es la capa de gobernanza unificada de Databricks para datos, modelos y agentes de AI. Proporciona un único modelo de permisos, linaje de datos completo y descubrimiento en todo el panorama de datos. Para la fabricación, significa un único plano de control que gobierna los datos de producción, los registros de calidad, los datos de proveedores y los agentes de AI, ya sea que esos datos residan en el lakehouse o estén federados desde los sistemas de origen.
¿La plataforma maneja telemetría de vehículos y máquinas de gran volumen?
Sí. La plataforma combina procesamiento por lotes (batch) y en tiempo real (streaming). La telemetría de vehículos y máquinas de gran volumen se puede ingerir como un flujo continuo de muy baja latencia y procesarse de manera confiable, de modo que no se pierda ningún evento en el camino.
¿Cómo ingresan los datos a Databricks?
La ingesta está diseñada para ser sencilla. Zerobus Ingest admite la transmisión basada en inserción (push-based streaming) directamente en tablas gobernadas, Lakeflow Connect proporciona conectores administrados y captura de datos modificados (change data capture) para sistemas de negocio, y Auto Loader y Structured Streaming manejan archivos y eventos.
¿La plataforma es abierta y multinube?
Sí. Las tablas Delta se almacenan en el almacenamiento de objetos en la nube, y el almacenamiento y el cómputo se escalan de forma independiente. Databricks se ejecuta en AWS, Azure y Google Cloud, y los datos se guardan en formatos abiertos como Delta Lake e Iceberg.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.