Procesamiento de datos en tiempo real desde múltiples plataformas de streaming utilizando Spark Declarative Pipelines
Administra y consume fácilmente desde diversas plataformas de streaming en múltiples nubes a través de una sola canalización de ETL.
Uno de los principales imperativos de las organizaciones hoy en día es permitir la toma de decisiones a la velocidad del negocio. Los equipos de negocio y los sistemas de toma de decisiones autónomos a menudo requieren toda la información necesaria para tomar decisiones y responder con rapidez en cuanto se producen sus eventos de origen, ya sea en tiempo real o casi real. Dicha información, conocida como eventos en la jerga del procesamiento de transmisiones, se transmite de forma asincrónica desde un origen a un destino y generalmente se realiza a medida a través de un intermediario de mensajes o bus de mensajes.
A medida que las organizaciones crecen y los equipos se ramifican en otros equipos, los patrones de uso, el número y la variedad de intermediarios de mensajes aumentan. En situaciones de fusiones y adquisiciones, las empresas a menudo heredan nuevos intermediarios de mensajes, que luego deben integrarse con sus procesos de ingeniería de datos existentes. Gestionar una multitud de intermediarios de mensajes, sus productores, consumidores y canales de ingeniería de datos de forma coherente puede ser un desafío debido a la cantidad de tecnologías, plataformas en la nube y lenguajes de programación en los que necesitan especializarse.
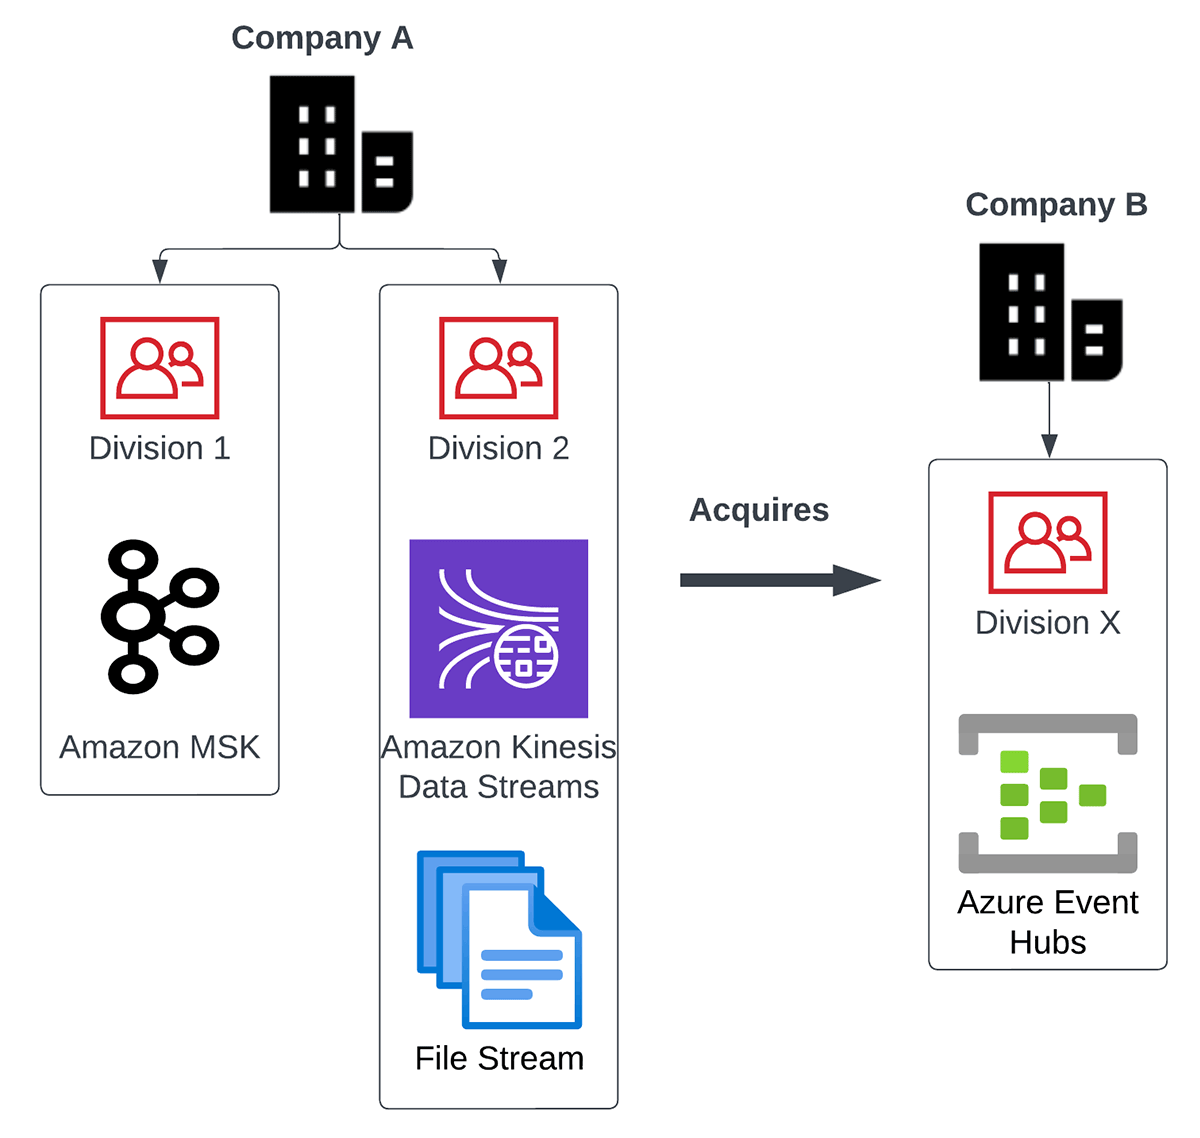
Por ejemplo, veamos un caso de uso de transmisión múltiple. Imagínate la siguiente situación en un conglomerado global, donde
- Tienen dos divisiones principales que utilizan dos intermediarios de mensajes separados: Amazon Kinesis Data Streams y Amazon Managed Service for Kafka (MSK).
- Adquirieron otra empresa de productos más pequeña que utiliza Azure Event Hubs internamente.
- También tienen una fuente principal de datos que llega en forma de una transmisión continua de archivos csv o json.
El siguiente diagrama representa el caso de uso de transmisión múltiple descrito anteriormente:
Estos son algunos de los principales desafíos al procesar todos estos datos en un escenario así:
- ¿Cómo integran todas estas fuentes de datos variadas y sus tecnologías juntas?
- ¿Cómo construyen sistemas de ingeniería de datos de tal manera que sean fáciles de escalar y mantener? ¿Contratan talento especializado para cada tecnología por separado?
- ¿Cómo se aseguran de que, en el proceso de resolver este enigma tecnológico, no olviden cuál es el objetivo final: dar sentido a los datos y permitir tomar decisiones más rápido?
- ¿Cómo se aseguran de que tanto las necesidades por lotes como las de transmisión puedan ser atendidas por el mismo sistema de procesamiento de datos?
A través de este blog, mostraremos cómo estos problemas se pueden resolver de una manera sencilla y limpia mediante Spark Declarative Pipelines (SDP). Spark Declarative Pipelines en la Databricks Lakehouse Platform simplifica la creación y gestión de canales de datos por lotes y de transmisión de alta calidad.
Caso de uso de transmisión múltiple
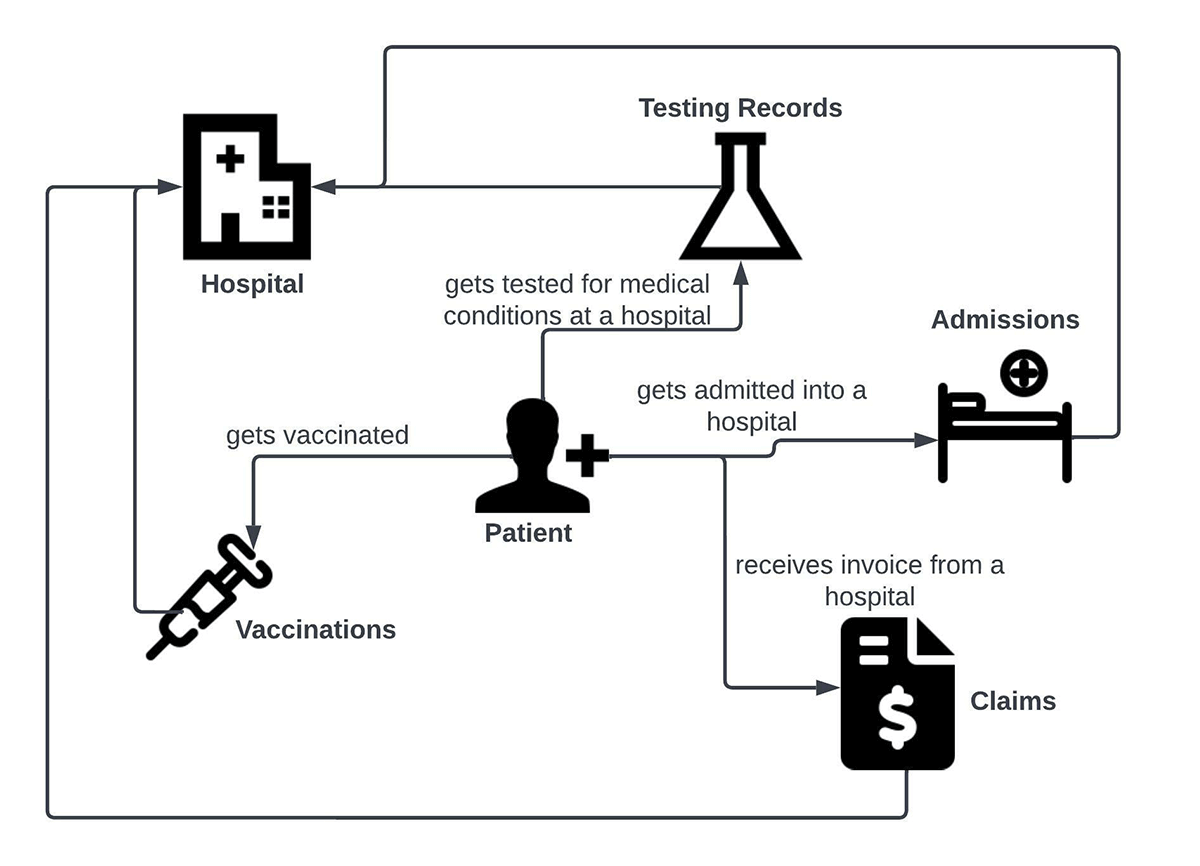
Para demostrar un escenario de procesamiento de transmisiones múltiples a través de SDP, imaginemos un caso de uso en el sector de la salud. En el centro del caso de uso se encuentra un paciente. El paciente completa las siguientes interacciones con otra entidad, el hospital:
- Recibe la vacuna contra afecciones médicas en un hospital
- Se hace una prueba para detectar afecciones médicas en un hospital
- Es admitido en un hospital por ciertas afecciones médicas
- Recibe la factura del tratamiento a través de un proceso de reclamaciones
Estas interacciones se pueden representar en el siguiente diagrama de casos de uso de negocio a continuación.
Las entidades involucradas en estas interacciones se pueden representar en forma de diagrama de entidad-relación (ER) a continuación. En adelante, haremos amplio uso de los términos Hechos y Dimensiones del léxico de modelado dimensional de almacenamiento de datos. En el diagrama ER, puedes ver que Paciente y Hospital son tablas de dimensión, mientras que los datos de admisiones, vacunaciones, registros de pruebas y reclamaciones se representan en forma de tablas de hechos.
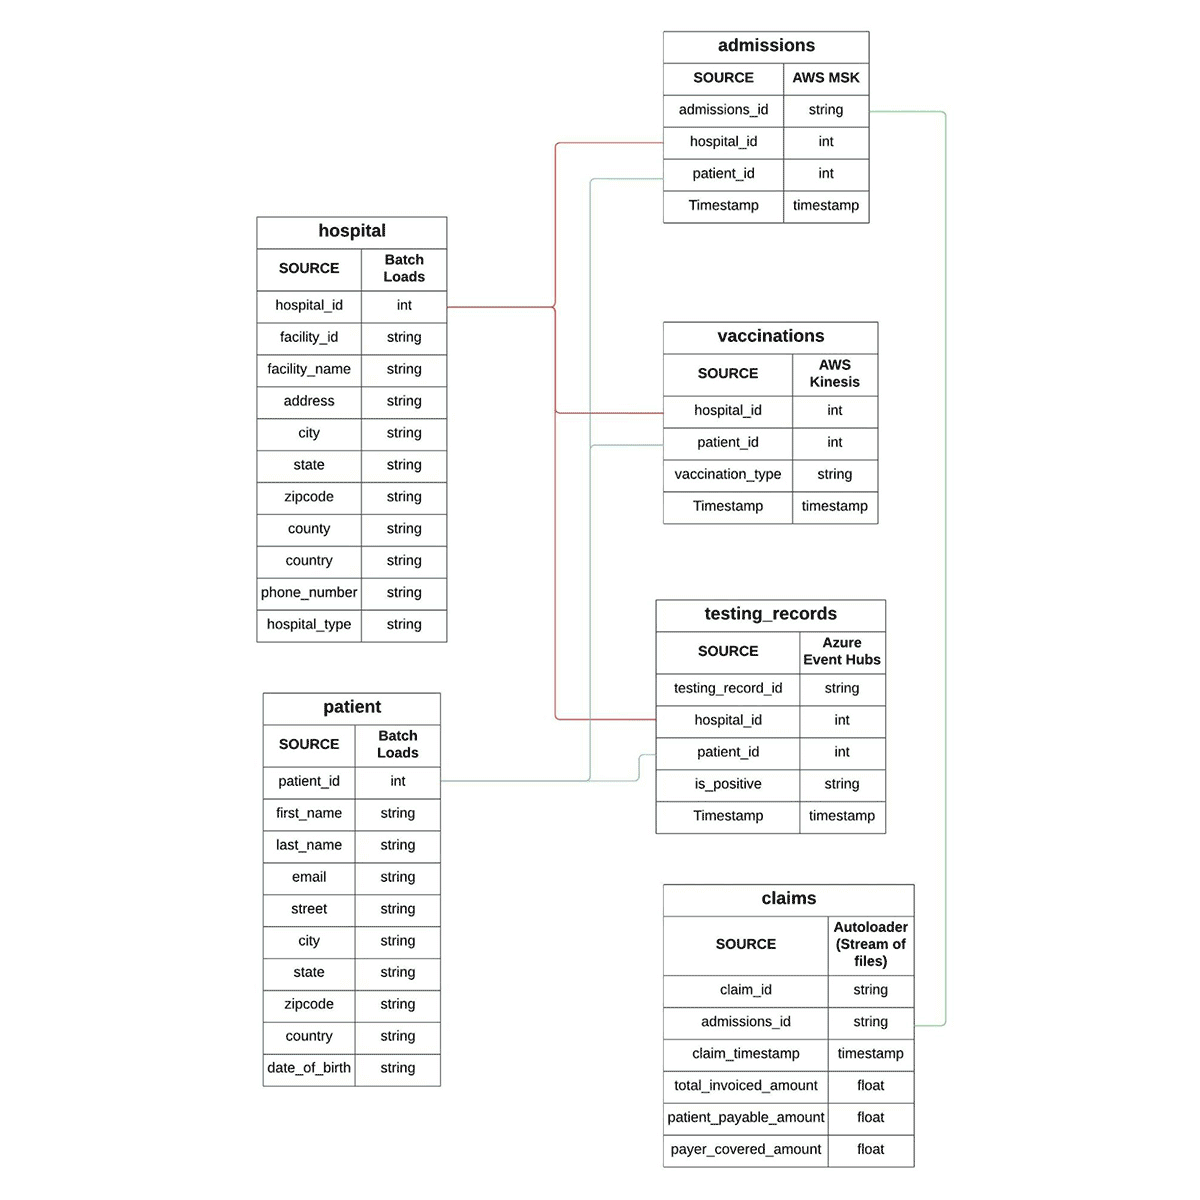
Supongamos que los datos de hechos para admisiones, vacunaciones, registros de pruebas y reclamaciones llegan a través de diferentes intermediarios de mensajes. Para este blog, hemos seleccionado los más populares de la industria, es decir, Apache Kafka (Amazon MSK), AWS Kinesis Data Streams y Azure Event Hubs. Nuestra cuarta forma de mostrar un escenario de procesamiento de transmisiones es ingiriendo una secuencia de archivos de forma incremental en tablas (Delta Lake en este caso). Hemos seleccionado Databricks Autoloader para este propósito. Con esta información, el diagrama de interacciones del paciente ahora se puede actualizar con las fuentes de datos relevantes:
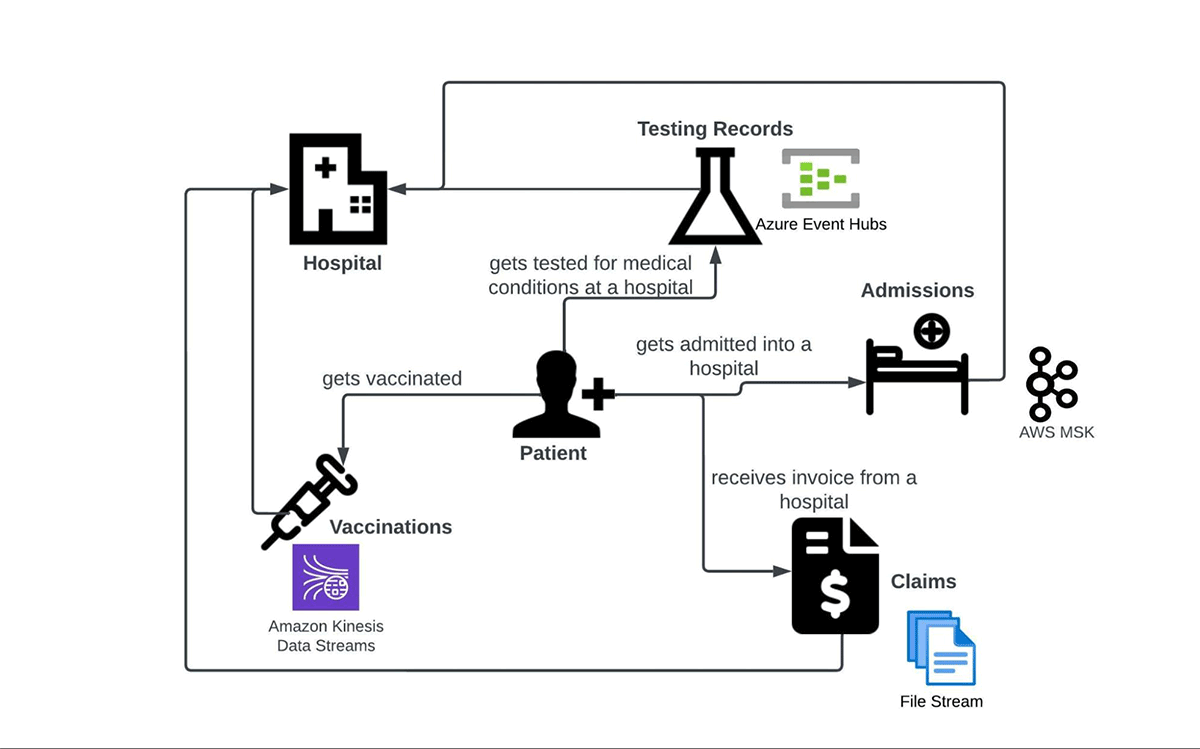
A continuación se resumen las fuentes de datos en formato tabular:
| Hechos | Fuente de datos |
| Admisiones | Amazon MSK (Apache Kafka) |
| Registros de pruebas | Azure Event Hubs |
| Vacunaciones | AWS Kinesis Data Streams |
| Reclamaciones | Transmisión incremental de archivos |
En la siguiente sección, mostraremos cómo un único canal de SDP puede ingerir datos de las fuentes de transmisión anteriores simultáneamente y también realizar ETL en ellos. Hemos utilizado la infraestructura de AWS para configurar los recursos y el canal para este blog, pero los escenarios deberían ser configurables de manera similar en otras nubes públicas como Azure y GCP.
Procesamiento de transmisiones múltiples a través de SDP
El diagrama siguiente muestra cómo se vería un canal de SDP común. Si bien la ingesta y transformación de los datos de transmisión provenientes de diversas fuentes abarcan el alcance de este blog, hay características adicionales de SDP que también merecen atención. Por ejemplo, la gestión de la calidad de los datos es una característica clave que puede ayudar a los equipos a procesar solo los datos que superan ciertas "expectativas". Los equipos pueden entonces tomar medidas correctivas y preventivas sobre los datos erróneos. Otros beneficios de SDP son la comprobación de estado gestionada y el escalado automático mejorado. Puedes leer sobre estas y más características en este artículo: Spark Declarative Pipelines concepts.
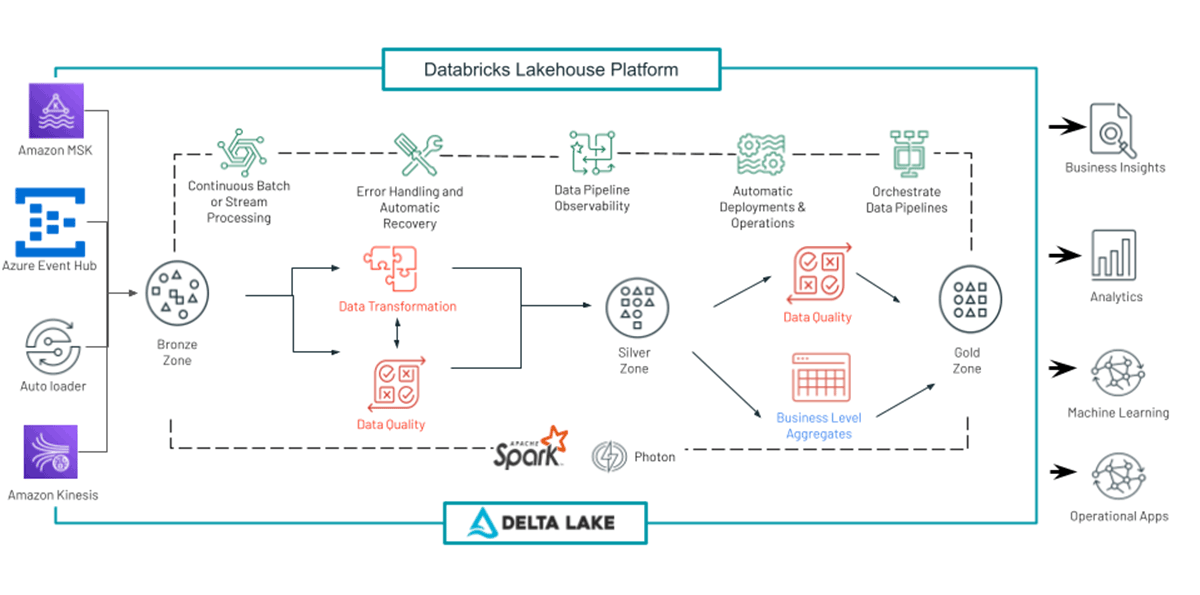
Nuestro canal de SDP para procesamiento de transmisiones múltiples (llamémoslo sdp_multistream_consumer para mayor simplicidad) incluye las siguientes operaciones:
- Cargar datos de transmisión desde los intermediarios de mensajes en una capa sin procesar de tablas de Delta Lake.
- Analizar y aplicar el esquema sobre los datos sin procesar para generar hechos significativos (tablas de hechos) a partir de las cargas útiles de los mensajes.
- Generar conjuntos de datos agregados para su consumo por parte de los equipos de BI y análisis. Esto se logra uniendo varias tablas de hechos y dimensiones, y segmentando y filtrando los registros generados.
Un canal de SDP se puede configurar para operar en los siguientes modos:
- Continuo: Un clúster activo procesa los datos en cuanto llegan de manera continua. Esto se recomienda para escenarios de transmisión donde la latencia es fundamental.
- Activado: Se activa un clúster según la programación deseada y procesa los datos disponibles en ese momento. Una vez que ya no hay datos pendientes de procesamiento (durante cierto umbral de duración de tiempo), el clúster se apaga. Este modo se recomienda cuando el ahorro de costos y el rendimiento tienen prioridad sobre la latencia.
Para este blog, estamos usando el modo continuo por dos razones. La primera es para demostrar un escenario de procesamiento de streaming "real" donde los datos se capturan y procesan en tiempo real. En segundo lugar, el conector de Amazon Kinesis Data Streams para Apache Spark, en el momento de publicar este blog, no admite un modo de ingesta por lotes (es decir, activar una vez o disponible ahora) como ocurre con el modo activado. Sin embargo, estará disponible pronto.
Otro punto a destacar es que, por lo general, en una configuración de producción, una vez que se ingieren los datos sin procesar, pasan por muchas etapas de procesamiento y enriquecimiento. Estas etapas limpian, transforman y agregan los datos para casos de uso empresariales que involucran análisis de datos, y análisis históricos y predictivos de datos. Nos referimos a la mejora progresiva en la estructura y calidad de los datos a medida que fluyen por cada capa de la arquitectura como la Medallion Lakehouse Architecture. Si bien la arquitectura Medallion es una práctica recomendada para casos de uso generales, para simplificar este blog, omitiremos la parte de transformación de datos y pasaremos a realizar análisis de datos para respaldar los casos de uso empresariales.
Ahora veamos cómo podemos realizar la ingesta de datos en streaming, todo a la vez desde una multitud de sistemas de streaming utilizando SDP en Delta Lake y analizar esos datos para generar información útil.
Ingesta de datos desde streams
En esta sección te mostramos cómo vamos a ingestar datos desde múltiples plataformas de streaming.
Ingesta de datos desde Amazon MSK
Amazon Managed Streaming for Apache Kafka (Amazon MSK) es un servicio totalmente administrado que te permite compilar y ejecutar aplicaciones que usan Apache Kafka para procesar datos en streaming. Amazon MSK proporciona las operaciones del plano de control, como las de creación, actualización y eliminación de clústeres.
Hemos utilizado un clúster MSK con las siguientes configuraciones para los fines de este blog:
- Tipo de clúster - Aprovisionado
- Número total de brokers - 2
- Versión de Apache Kafka - 2.5.1
- Tipo de broker - kafka.m5.large
- Número de zonas de disponibilidad - 2
- Volumen de almacenamiento EBS por broker - 300 GiB
- Cifrado entre clientes y brokers:
- Cifrado TLS - Habilitado
- Texto plano - Habilitado
Para la autenticación en el entorno de AWS, hemos adjuntado un perfil de instancia al clúster SDP. Este hace referencia a un rol de IAM que tiene los permisos de lectura/escritura adecuados según la configuración en la definición del rol.
La canalización sdp_multistream_consumer ingesta el conjunto de datos de admisiones hospitalarias desde el tópico MSK admission en la tabla de delta lake llamada msk_admissions_tbl_raw. La carga útil (payload) de Kafka (binario representado como una cadena) para un evento de admisión tiene el siguiente aspecto:
Utilizamos el siguiente código en un cuaderno de Python para la ingesta y lo adjuntamos a nuestra canalización SDP sdp_multistream_consumer.
La canalización sdp_multistream_consumer, al iniciarse, crea la tabla msk_admissions_tbl_raw dentro de la base de datos/esquema deseados y llena la tabla con los datos leídos del tópico admission. Luego, continúa ingiriendo datos adicionales a medida que se escriben nuevos datos en ese tópico.
Además de los cuatro campos ingeridos desde el tópico de Kafka, hemos agregado una columna msk_event_timestamp (derivada del evento timestamp generado por Kafka) a la tabla msk_admissions_tbl_raw. Los mensajes se reciben en el campo value de la carga útil de Kafka en formato binario. Deben convertirse a cadena para que los procesos posteriores puedan analizarlos.
Ingesta desde Amazon Kinesis
Amazon Kinesis Data Streams facilita la recopilación, el procesamiento y el análisis de datos en streaming en tiempo real. Los datos pueden ser de video, audio, registros de aplicaciones, flujos de clics de sitios web y datos de telemetría de IoT para machine learning, análisis y otras aplicaciones. Para nuestro blog, utilizamos un stream de datos de Kinesis con las siguientes configuraciones:
- Nombre del stream de datos: test_vaccination_data
- Modo de capacidad: Bajo demanda
- Capacidad de escritura: 200 MiB/segundo o 200,000 registros/segundo (máximo predeterminado)
- Capacidad de lectura: 400 MiB/segundo (predeterminado)
Para un mejor rendimiento, la función Amazon Kinesis enhanced fan-out (EFO) del conector de Databricks Runtime Kinesis se puede usar en escenarios de producción.
El stream test_vaccination_data, en nuestro caso de uso, transporta los datos (eventos) de vacunación de un paciente. A continuación, se muestra una carga útil de ejemplo:
El código SDP para consumir los datos del stream de datos de Kinesis a la zona de aterrizaje en Lakehouse es el siguiente:
La canalización sdp_multistream_consumer llena la tabla de destino kinesis_vaccination_tbl_raw con los datos disponibles en el stream de datos de Kinesis y realiza un punto de control (checkpoint) para evitar volver a leer los datos. Los mensajes se reciben en el campo data de la carga útil de Kinesis en formato binario. Deben convertirse a cadena para que los procesos posteriores puedan analizarlos.
Ingesta desde Azure Event Hubs
Azure Event Hubs es una plataforma de streaming popular ofrecida por Microsoft. Event Hubs admite múltiples protocolos para lectura y escritura, como AMQP, HTTPS y Apache Kafka. Para este blog, nuestra canalización SDP sdp_multistream_consumer utiliza la interfaz de Kafka de Event Hubs para consumir los mensajes, ya que el conector de Kafka para Spark viene integrado en Databricks Runtime sin necesidad de bibliotecas adicionales. Estamos utilizando el nivel de precios estándar para nuestro espacio de nombres de Event Hubs con 2 unidades de rendimiento.
La documentación de Azure describe los espacios de nombres como contenedores de administración para centros de eventos (o tópicos, en la jerga de Kafka). El centro de eventos (también conocido como tópico) de nuestro interés es testing_records_stream, que transporta eventos relacionados con los resultados de pruebas de laboratorio de un paciente. Cada mensaje se ve como el siguiente:
El código SDP para consumir mensajes del event hub testing_records_stream se ve muy similar al patrón de ingesta con Amazon MSK (después de todo, ambos usan el protocolo Kafka).
La canalización SDP lee de forma incremental los mensajes de registros de prueba desde Event Hubs y los agrega como nuevas filas en la tabla de Delta Lake eventhubs_testing_records_tbl_raw. Los mensajes se reciben en el campo de valor de la carga útil de la interfaz de Kafka en formato binario. Es necesario convertirlos a cadena de texto para que los procesos posteriores puedan analizarlos.
Ingesta de archivos mediante Auto Loader
Auto Loader es una de las herramientas de ingesta de archivos de datos más potentes y robustas de la industria. Procesa de manera incremental y eficiente los nuevos archivos de datos a medida que llegan al almacenamiento en la nube sin necesidad de ninguna configuración adicional. A día de hoy, puede ingerir formatos de archivo JSON, CSV, PARQUET, AVRO, ORC, TEXT y BINARYFILE.
Auto Loader permite a los consumidores configurar un origen de Structured Streaming llamado cloudFiles. Las opciones de configuración incluyen rutas de archivos de almacenamiento en la nube, patrones de filtrado de archivos y opciones de eventos de llegada de archivos para colas como Azure Queue Storage, AWS SQS, AWS SNS, entre otras. La canalización SDP utiliza estas opciones para ingerir automáticamente nuevos archivos a medida que llegan, con la opción de procesar también cualquier archivo preexistente en ese directorio. Auto Loader es compatible con Python y SQL en las canalizaciones SDP. Los clientes han utilizado Auto Loader para procesar miles de millones de archivos con el fin de migrar datos o rellenar una tabla. Se escala para admitir la ingesta casi en tiempo real de millones de archivos por hora.
En este blog hemos ingerido datos de reclamaciones de pacientes utilizando Auto Loader con el siguiente ejemplo:
En la canalización sdp_multistream_consumer, los archivos json de las reclamaciones de pacientes se ingieren a través de Auto Loader a medida que llegan a la ubicación de origen, tal como se muestra en el código a continuación:
Análisis de datos ingeridos para generar perspectivas de negocio
Como se mencionó anteriormente, para este blog ya hemos ingerido los conjuntos de datos de pacientes de cuatro fuentes diferentes: Amazon MSK, Amazon Kinesis Data Streams, Azure Event Hubs y Databricks Auto Loader. Por brevedad, hemos limitado la parte de transformación de datos solo a la aplicación de esquemas y avanzamos para realizar análisis de datos en estos conjuntos de datos con el fin de respaldar los casos de uso de negocio.
Hemos creado dos casos de uso de análisis de negocio para este blog. La idea es demostrar cómo los usuarios pueden utilizar las tablas de Delta Lake creadas por SDP para realizar análisis de datos y responder preguntas de negocio.
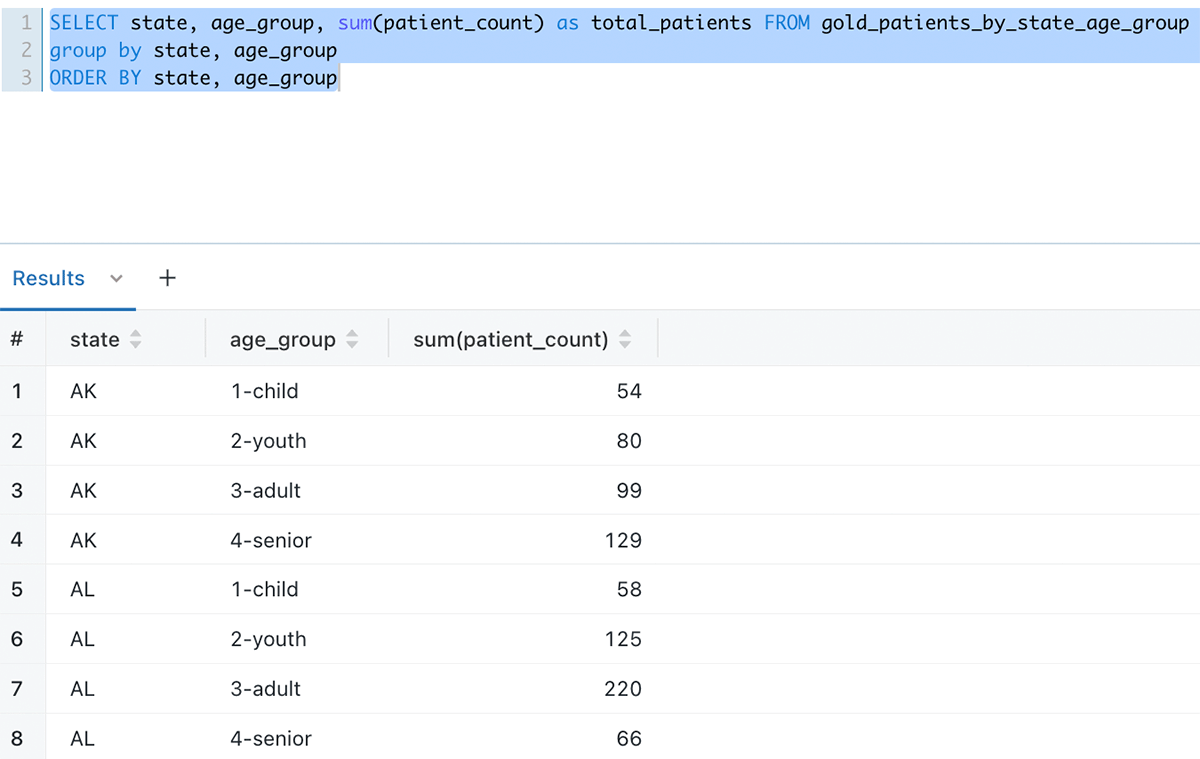
Número de pacientes por estado y grupos de edad que dieron positivo por Covid después de vacunarse contra el Covid
La tabla gold_patients_by_state_age_group se crea en SDP uniendo las tablas que se rellenaron mediante la ingesta de datos a través de SDP. A medida que llegan nuevos datos a la capa de ingesta, la canalización continua de SDP ingiere dichos datos en la capa de ingesta y actualiza esta tabla gold_patients_by_state_age_group para el análisis de datos. --
A continuación se muestra cómo se ven los datos al consultarlos a través del editor de consultas de Databricks SQL:
Número de admisiones por mes, ciudad y estado
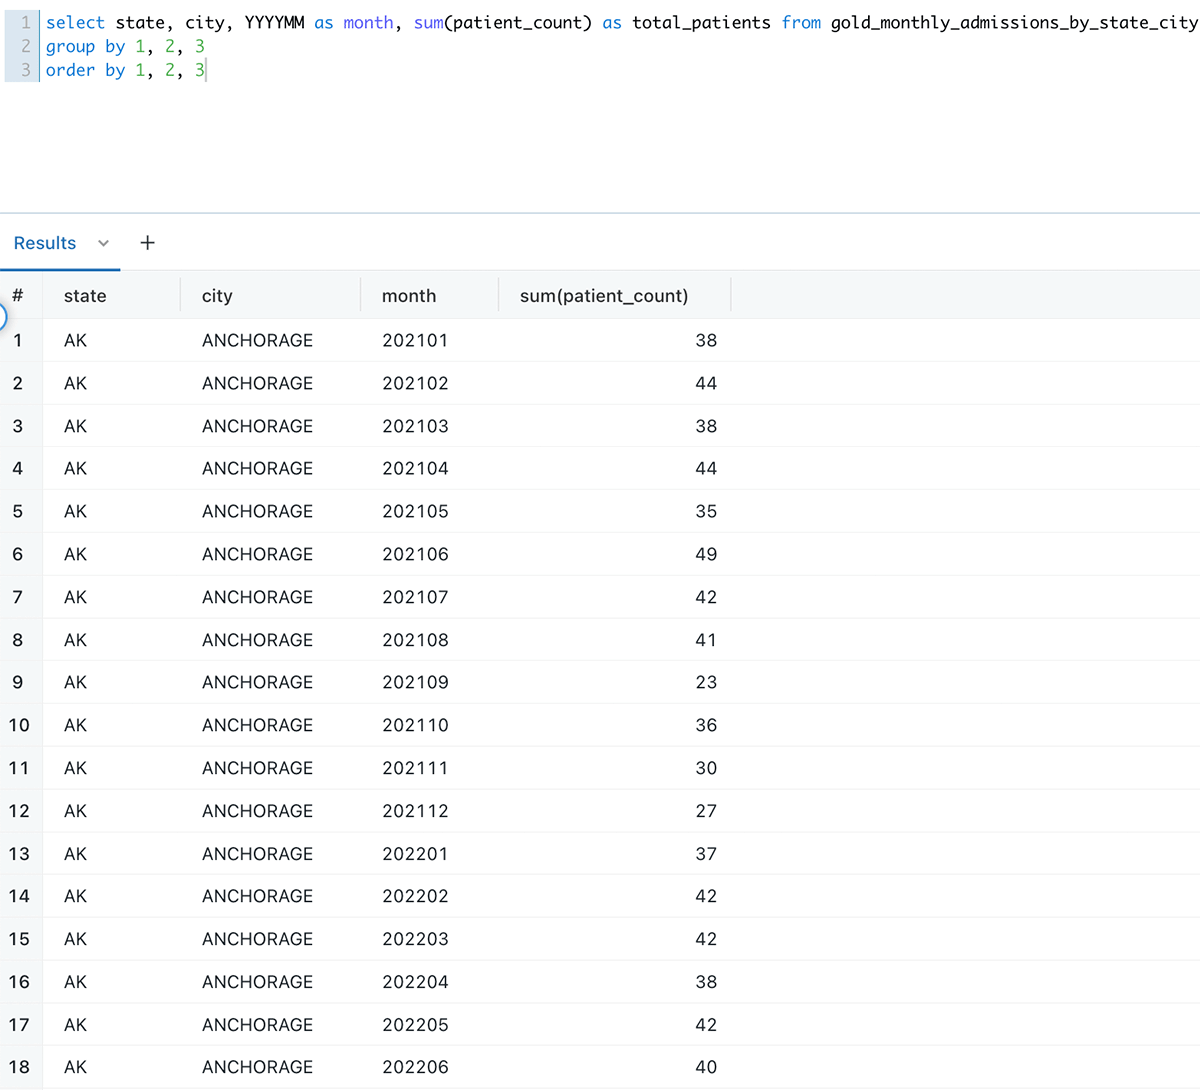
El número de admisiones por ciudad y estado por mes es otro caso de uso compatible al consultar la tabla gold_monthly_admissions_by_state_city.
A continuación se muestra cómo se ven los datos al consultarlos a través del editor de consultas de Databricks SQL:
Vista de extremo a extremo de la canalización de SDP
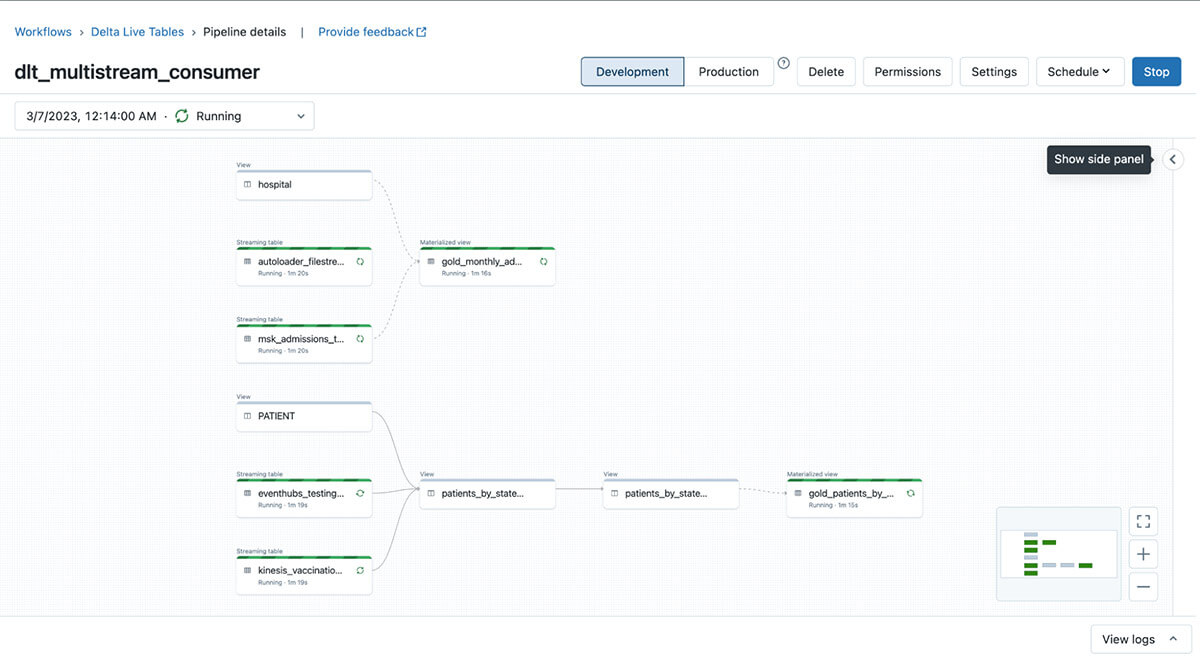
Una de las características clave de SDP es su capacidad para rastrear todas las dependencias a nivel de tabla entre los artefactos de código incluidos como parte de la canalización y luego mostrarlas en forma de un gráfico de linaje. Este gráfico es "en vivo". A medida que avanzan las operaciones de ETL, muestra las operaciones exitosas en color verde y las erróneas en rojo. A continuación se muestra una captura de pantalla de nuestra canalización de datos de SDP en ejecución continua:
Conclusión
En este blog, hemos mostrado cómo puedes ingerir y consumir datos de diversas plataformas de streaming en múltiples nubes utilizando Databricks Spark Declarative Pipelines mediante una única canalización de datos. El proceso de ETL ocurre de forma continua, tan pronto como llegan los datos. Los datos generados a través de las transformaciones están disponibles de forma continua para realizar análisis de datos y obtener respuestas para tus preguntas de negocio. Una solución así simplifica mucho la arquitectura técnica general y facilita su mantenimiento y escalado. Con Databricks introduciendo nuevas funciones en SDP regularmente, está encontrando una amplia adopción entre los clientes para cargas de trabajo de ETL. Prueba Spark Declarative Pipelines hoy mismo.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.