¿Qué es AIOps?
AIOps combina AI y machine learning con la observabilidad para automatizar las operaciones de IT. Explora sus componentes clave, beneficios, casos de uso y desafíos.
- AIOps (Inteligencia Artificial para Operaciones de IT) aplica AI, machine learning y datos operativos para detectar anomalías, correlacionar eventos, identificar causas raíz y automatizar la respuesta a incidentes.
- Ayuda a los equipos de IT y de ingeniería de plataformas a reducir el riesgo de tiempo de inactividad, disminuir la fatiga por alertas, acelerar la velocidad de toma de decisiones y reducir el tiempo medio de resolución (MTTR).
- AIOps complementa las prácticas de observabilidad y DevOps al convertir las señales brutas del sistema en inteligencia operativa procesable, al tiempo que mantiene la supervisión humana (human-in-the-loop) para las acciones de mayor riesgo.
Artificial Intelligence for IT Operations (AIOps) aplica AI y aprendizaje automático a las operaciones de IT para detectar anomalías, correlacionar eventos, identificar causas raíz y activar respuestas más rápido de lo que permitiría cualquier proceso manual.
Gartner acuñó el término en 2017. Entonces, ¿por qué estás leyendo sobre esto ahora?
Porque la infraestructura que ejecuta tus aplicaciones en 2026 no se parece en nada a aquello para lo que se diseñó el monitoreo tradicional. Estás gestionando cientos de microservicios, dependencias multinube, cargas de trabajo de AI y sistemas basados en agentes que generan más señales operativas en una hora de las que un ingeniero de guardia puede leer en una semana.
Esa brecha es la que AIOps está posicionada para cerrar ahora. Esta guía explica cómo funciona, dónde encaja y qué evaluar antes de elegir una plataforma.
- AIOps aplica AI y aprendizaje automático a las operaciones de IT para detectar anomalías, correlacionar eventos, identificar las causas raíz probables y permitir una respuesta más rápida a los incidentes.
- AIOps ayuda a los equipos a reducir el riesgo de tiempo de inactividad, disminuir la fatiga por alertas, mejorar la velocidad de toma de decisiones y acelerar la respuesta a incidentes al transformar los datos operativos en información accionable.
- AIOps complementa la observabilidad y DevOps en lugar de reemplazarlos, lo que aumenta las capacidades de los ingenieros de AI y de plataformas con inteligencia operativa, al tiempo que mantiene la supervisión humana para las acciones de mayor riesgo.
Qué hace y qué no hace AIOps
AIOps analiza datos de logs, trazas, eventos y topología de red para detectar problemas y predecir fallas antes de que se conviertan en incidentes.
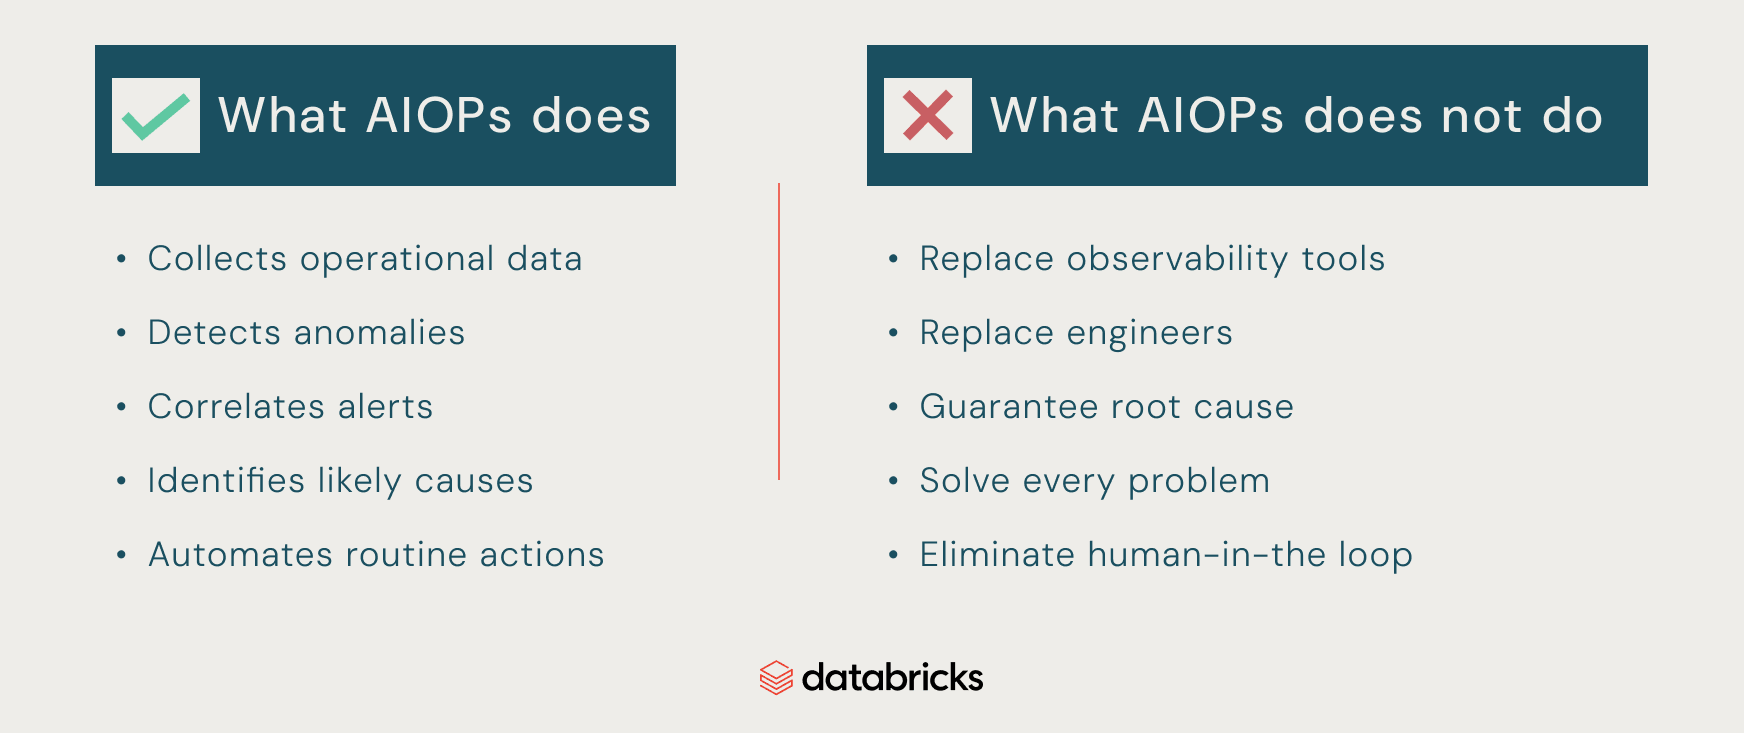
Se ubica entre la observabilidad y la acción. La observabilidad indica qué está sucediendo en todos los sistemas. AIOps toma esa señal, reduce el ruido, conecta los eventos relacionados y ayuda a los ingenieros de plataformas a decidir qué hacer a continuación. No reemplaza la observabilidad, DevOps ni el criterio humano. Hace que los tres sean más rápidos.
¿Por qué ahora?
A medida que la infraestructura se vuelve más distribuida, aumentan el volumen de datos operativos, la complejidad de las dependencias y la velocidad del cambio. Las herramientas de monitoreo tradicionales no satisfacen las crecientes demandas y, a menudo, generan un ruido excesivo, careciendo de un contexto claro para priorizar las amenazas. Como resultado, los equipos de datos tienen dificultades para identificar las señales importantes antes de que los incidentes afecten a los usuarios.
Cuando los equipos aprovechan la AI y el aprendizaje automático en las operaciones de IT, se optimizan para:
- Reducir el riesgo de tiempo de inactividad: AIOps puede detectar anomalías y correlacionar eventos relacionados para identificar posibles fallas de manera anticipada, lo que ayuda a resolver problemas antes de que interrumpan servicios principales y causen tiempos de inactividad.
- Disminuir la fatiga por alertas: El aprendizaje automático puede filtrar alertas repetitivas o de poco valor y destacar los eventos que tienen más probabilidades de requerir atención humana.
- Mejorar la velocidad de toma de decisiones: Al agregar contexto a los eventos operativos e identificar las causas raíz probables, AIOps ayuda a los ingenieros a determinar qué está sucediendo y qué investigar a continuación.
- Acelerar la respuesta a incidentes: Cuando se conoce la solución adecuada, AIOps puede recomendar o automatizar acciones como reiniciar servicios, escalar recursos o activar flujos de trabajo predefinidos.
Estos factores se orientan específicamente hacia una detección más temprana de amenazas y una recuperación más rápida. No pretenden sugerir que AIOps resuelva todos los cuellos de botella de automatización ni que elimine la necesidad de contar con ingenieros.
¿Cuáles son los componentes principales de AIOps?
Al evaluar una plataforma de AIOps, es importante comprender los componentes fundamentales y cómo funcionan en sus respectivos dominios:
- Ingesta de datos: aquí, las plataformas de AIOps recopilan y consolidan datos de métricas, logs, trazas, eventos y alertas de infraestructura, aplicaciones y dispositivos de red en un data lake, data warehouse o lakehouse. Una ingesta de datos amplia y confiable proporciona a AIOps la visibilidad que necesita para detectar problemas en todos los entornos de IT.
- Normalización y enriquecimiento de datos: después de que AIOps recopila datos de diversas fuentes, el análisis procesa los datos brutos para destacar tendencias, predecir las necesidades de capacidad de los entornos y detectar comportamientos inusuales del sistema antes de que causen interrupciones. Esto proporciona al análisis descendente una visión coherente de lo que está sucediendo y dónde es importante.
- Detección de anomalías. Para detectar actividad inusual en los sistemas, los métodos tradicionales dependen de umbrales estáticos, límites de CPU y medidas similares para activar alertas. Sin ningún tipo de contexto. AIOps aprende cómo es el comportamiento normal para cada métrica, por hora, día y temporada. Luego, solo alerta cuando ese comportamiento se desvía de la línea base. Esto les da a los ingenieros de AI más tiempo para investigar posibles problemas antes de que afecten a los usuarios.
- Correlación de eventos. Cuando 10 servidores diferentes muestran un alto uso de CPU, AIOps conecta las alertas relacionadas en lugar de tratar cada alerta como un incidente aislado. Esto reduce la fatiga por alertas y ayuda a enfocarse en el problema subyacente en lugar de en cientos de eventos individuales.
- Análisis de causa raíz. El método antiguo, en el que se activan 70 alertas y se sigue cada una de ellas, es insostenible. AIOps comprende la topología del sistema, examina los servicios dependientes durante las alertas y expone la causa raíz del problema. A partir de las alertas, AIOps determina que el servicio C está degradado, mientras que los servicios A y B solo están descendentes (downstream). Esto acelera la resolución de problemas, minimiza el tiempo de inactividad comercial y ahorra tiempo al evitar la investigación por incidente.
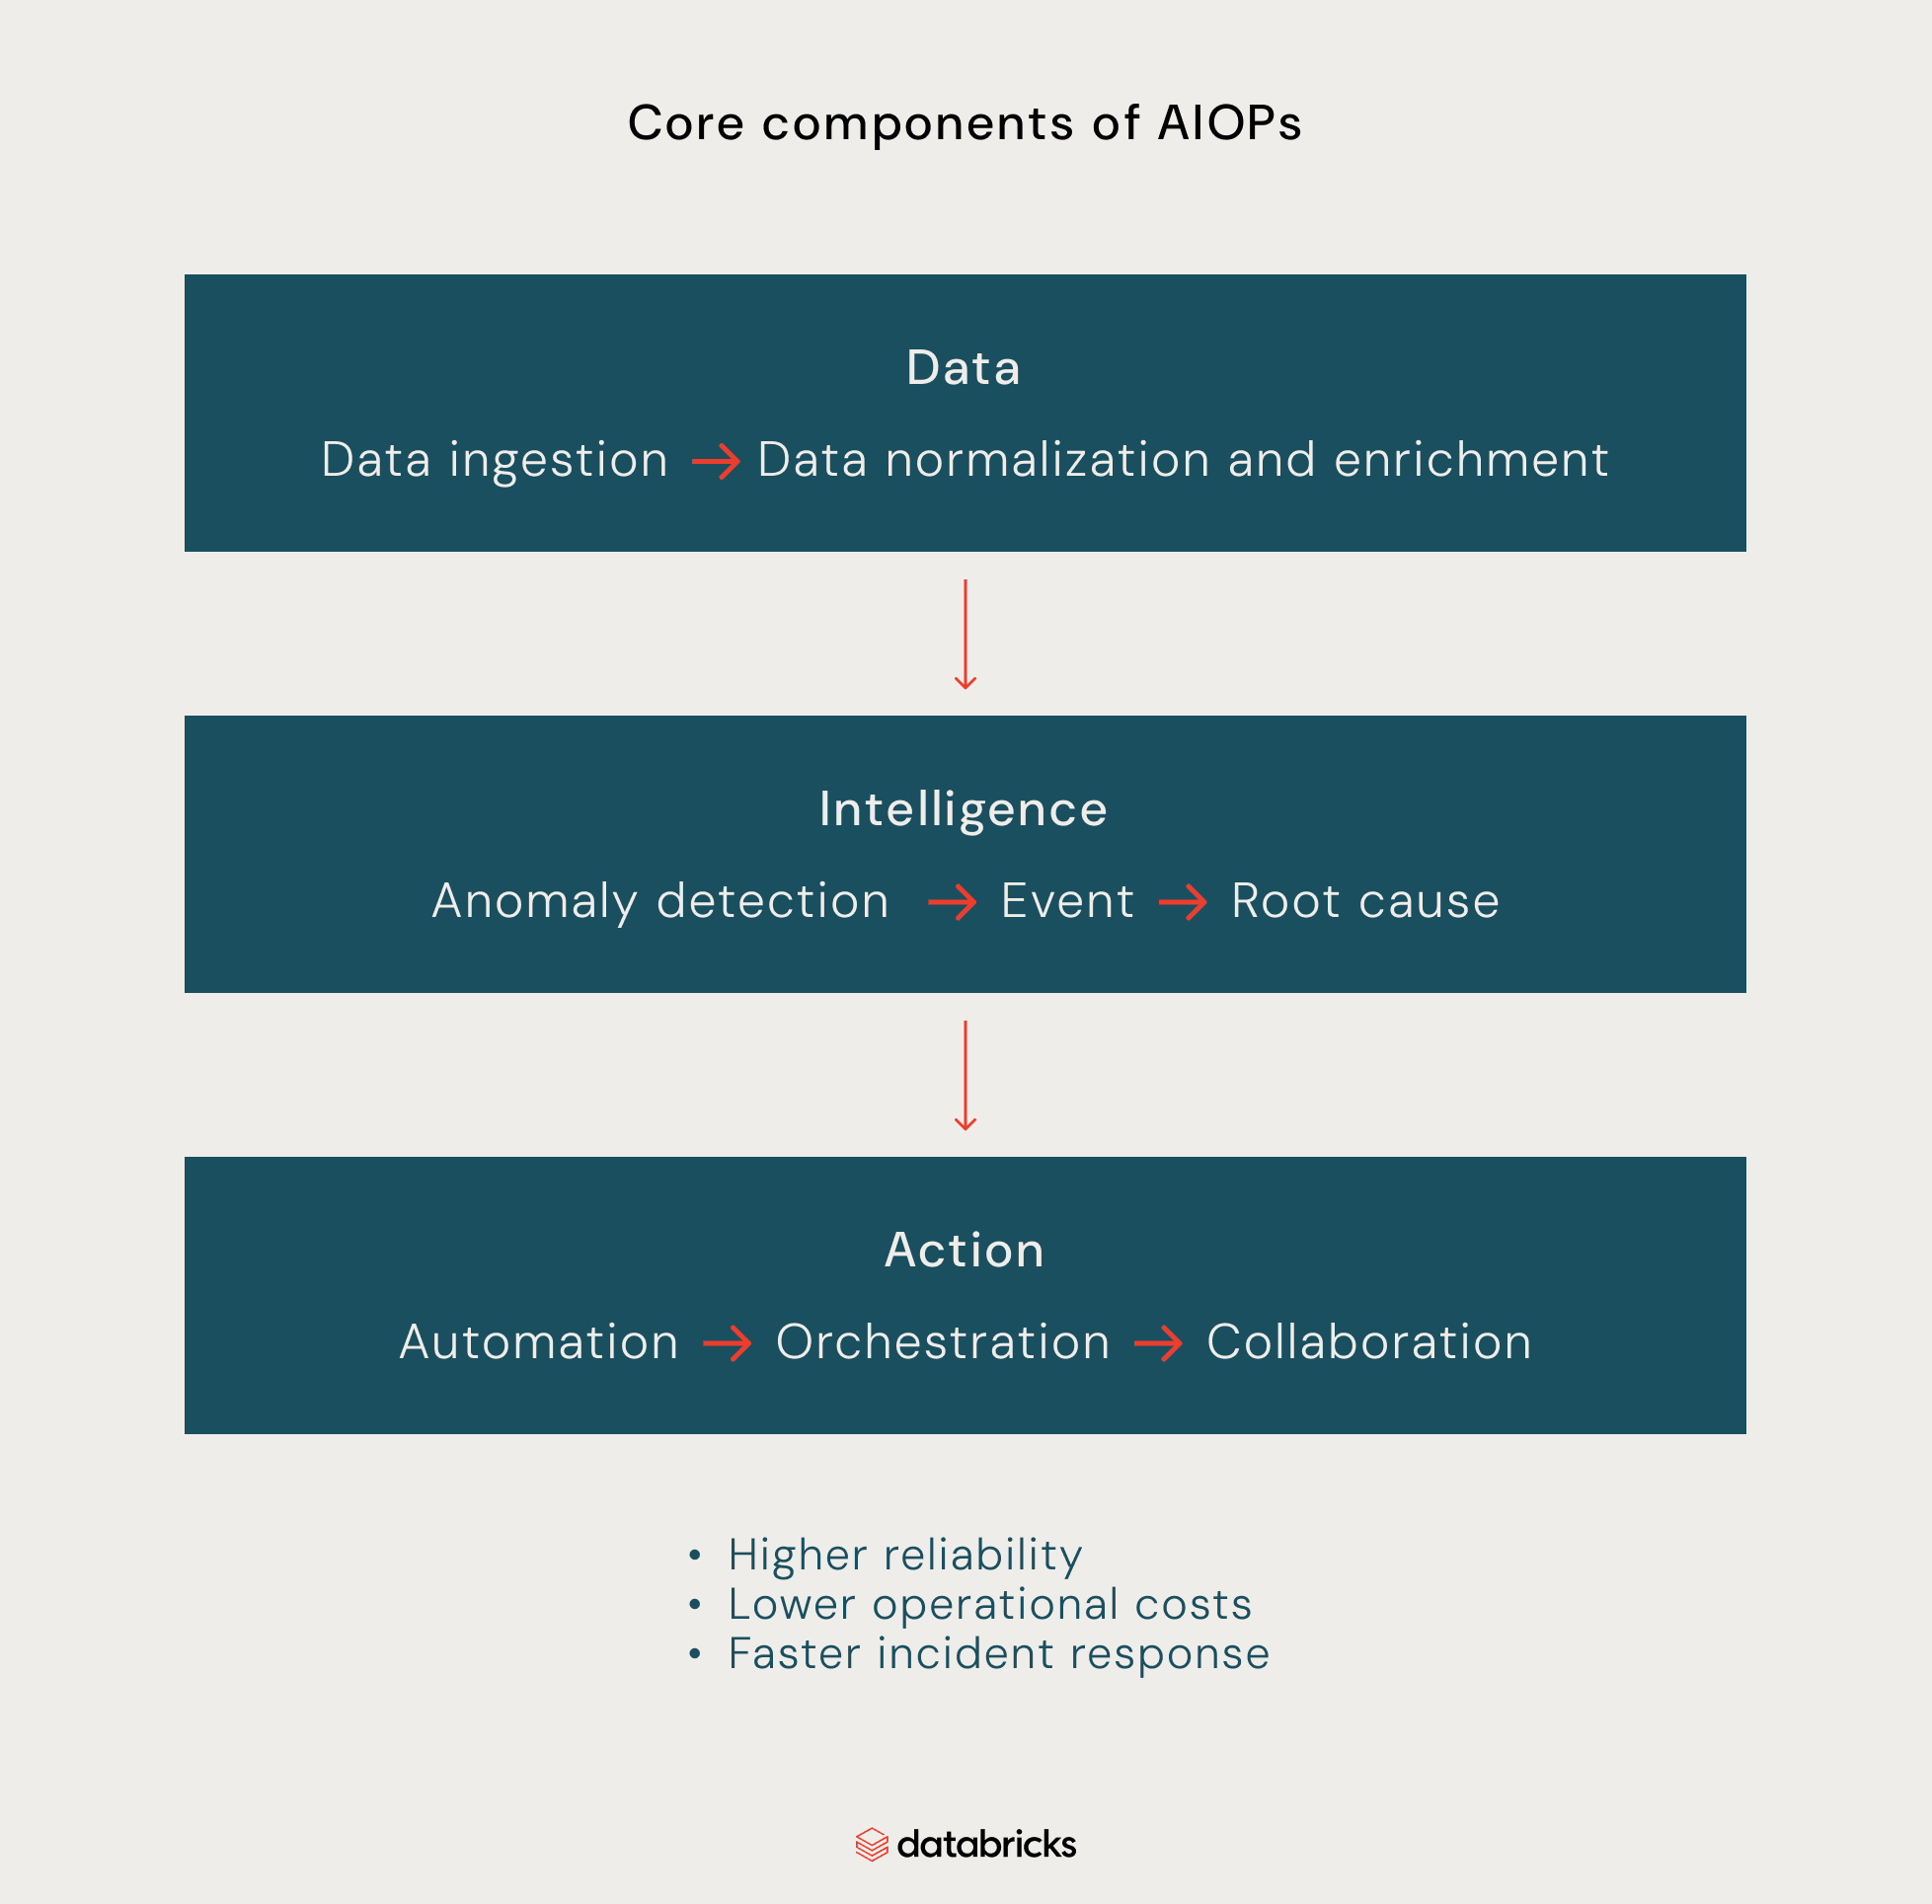
- Automatización y orquestación. Una vez que se identifica la causa raíz, AIOps transforma esta información en acción al recomendar o ejecutar respuestas predefinidas, como reiniciar un servicio, escalar la infraestructura, revertir una implementación o abrir un ticket. Este componente reduce la intervención manual, acelera la resolución de incidentes y ayuda a controlar los costos operativos. Para flujos de trabajo operativos más avanzados, Agent Bricks puede ayudar a los equipos a crear e implementar agentes de AI que utilicen herramientas y datos empresariales para realizar tareas de varios pasos.
- Flujos de trabajo de colaboración. Conecta la información de AIOps con las personas y los procesos responsables de resolver los incidentes. Esto puede incluir el enrutamiento de alertas, la asignación de responsabilidades, la escalación de incidentes y la provisión del contexto que los ingenieros necesitan para responder.
Con estos componentes principales, veamos cómo se integran en la siguiente sección.
¿Cómo funciona AIOps?
El proceso de AIOps comienza con la recopilación de señales de aplicaciones, infraestructura, redes y servicios en la nube. Luego, los datos se someten a una limpieza en la que las señales duplicadas, incompletas o inconsistentes se organizan en un formato que AIOps pueda analizar.
Por ejemplo, tu sistema de repente detecta que tu aplicación comienza a devolver una gran cantidad de errores de interfaz de programación de aplicaciones (API). AIOps compara el comportamiento actual de tu aplicación con patrones anteriores y marca el aumento de errores como inusual.
Con la correlación de eventos, la plataforma de AIOps conecta los errores de API con otras señales, como un aumento repentino en la carga de la base de datos o una implementación reciente. Luego, el análisis de causa probable examina estas señales conectadas para determinar las causas probables. En lugar de tratar los errores de API, la carga de la base de datos y la implementación como eventos separados, AIOps identifica la implementación reciente como la fuente probable del incidente.
La etapa final es la respuesta guiada o automatizada. Según el flujo de trabajo, AIOps puede recomendar una acción de remediación, abrir un ticket, notificar al equipo correspondiente o ejecutar automáticamente una respuesta predefinida, como revertir la implementación.
Las acciones de mayor riesgo deberían requerir la intervención humana (human-in-the-loop) para permitir que los ingenieros revisen y aprueben la respuesta antes de que afecte a la producción.
¿Cuáles son los principales tipos de AIOps?
Los tipos de AIOps dependen de lo que mejor se adapte a la organización, el alcance de sus operaciones, los sistemas a gestionar y el nivel de interconexión de la infraestructura.
Los enfoques centrados en el dominio y agnósticos del dominio son los dos tipos principales de AIOps. Ninguno es un sustituto directo del otro; ambos tienen sus fortalezas y ventajas y desventajas:
El AIOps centrado en el dominio se enfoca en un área específica, como la gestión de la nube, el rendimiento de la red o el monitoreo de aplicaciones. Un enfoque centrado en el dominio es la opción ideal para solucionar problemas en un dominio específico; proporciona un contexto más profundo y un análisis más especializado dentro de ese entorno.
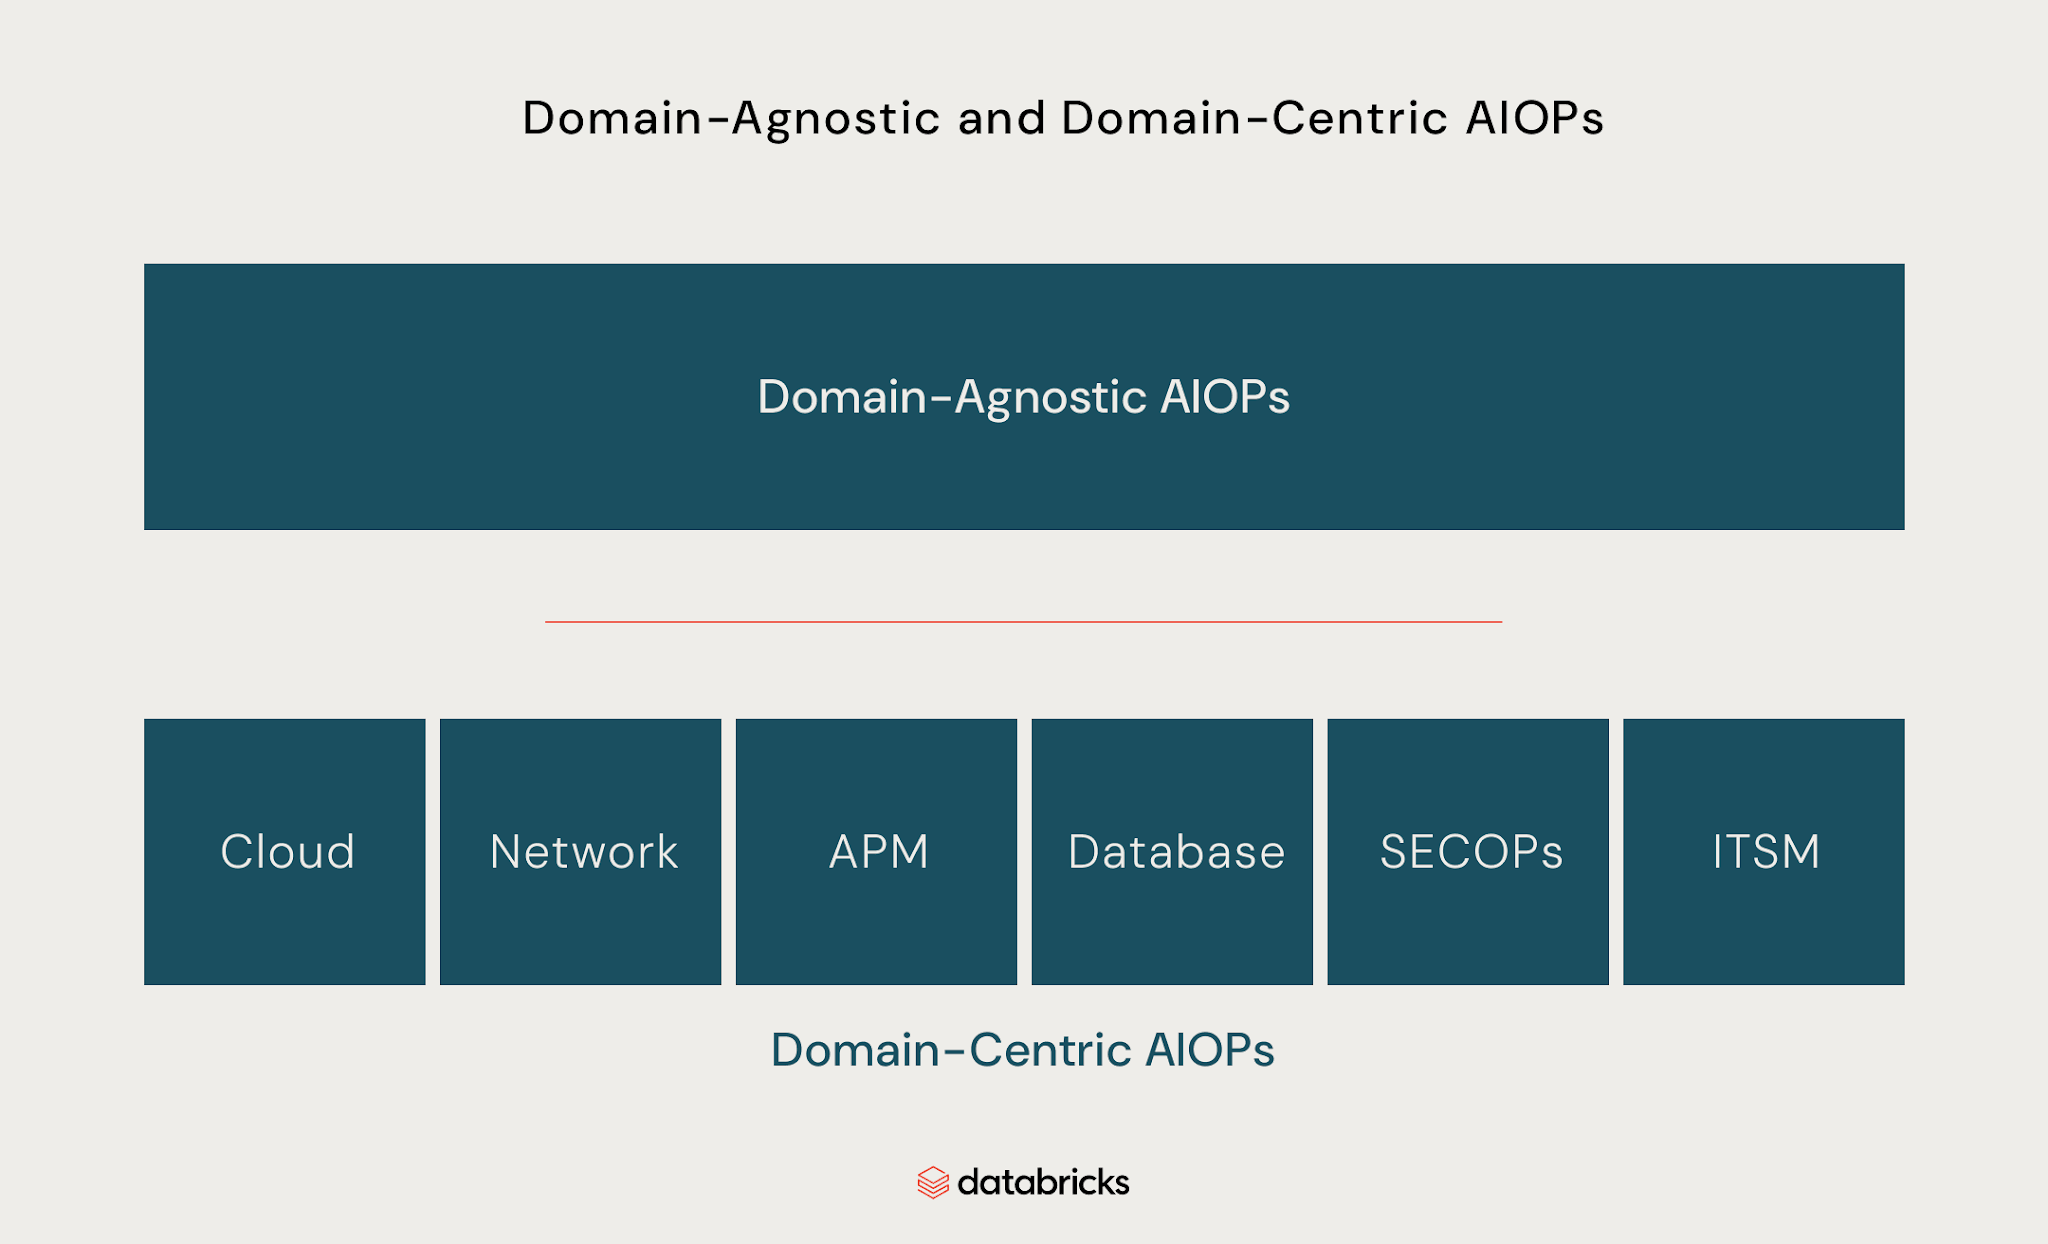
El AIOps agnóstico del dominio opera en múltiples entornos de IT, recopilando y analizando datos de sistemas como aplicaciones, redes, infraestructura en la nube y almacenamiento. A diferencia del enfoque centrado en el dominio, las plataformas de AIOps agnósticas del dominio son más adecuadas para resolver problemas más amplios. Esto las hace ideales para organizaciones que gestionan infraestructuras complejas e interconectadas donde los incidentes suelen cruzar los límites operativos.
El AIOps centrado en el dominio puede proporcionar una mayor profundidad e inteligencia más especializada dentro de un solo dominio, mientras que el AIOps agnóstico del dominio ofrece una mayor amplitud y una visibilidad más amplia en todos los sistemas y herramientas.
Casos de uso comunes de AIOps
Los casos de uso de AIOps abarcan muchas áreas de las operaciones de IT; algunas de las aplicaciones más comunes incluyen:
Análisis de causa raíz
AIOps ayuda a identificar la causa probable de una interrupción, error o problema de rendimiento. En lugar de tratar un pico en los errores de la API como un incidente aislado, AIOps puede correlacionarlo con un despliegue reciente, una falla en la base de datos o un cambio en la configuración de la red.
Detección de anomalías
AIOps escanea continuamente los datos del sistema para establecer una línea base y detectar desviaciones que podrían provocar incidentes y fallas.
Monitoreo de rendimiento
AIOps puede monitorear entornos de IT en la nube, locales e híbridos con servicios interconectados y dependencias. Esto ayuda a identificar tendencias y priorizar problemas mediante un monitoreo constante y la correlación del rendimiento.
Adopción y migración a la nube
Las migraciones a la nube introducen nuevas dependencias entre cargas de trabajo, APIs, servicios e infraestructura. AIOps mapea estas relaciones, monitorea los cambios en el comportamiento del sistema e identifica posibles cuellos de botella antes de que afecten a los servicios críticos. AIOps proporciona una visibilidad más clara de los entornos híbridos y multinube durante la migración.
Adopción de DevOps
DevOps aumenta la velocidad de desarrollo y despliegue, pero también introduce riesgos operativos y problemas que pueden pasar desapercibidos para los humanos. AIOps monitorea la actividad de despliegue, analiza su impacto en producción y puede activar respuestas predefinidas cuando ocurren problemas.
AIOps y DevOps abordan diferentes partes del ciclo de vida de entrega y operaciones de software, y son más efectivos cuando se integran.
La guía de IA agéntica para la empresa

AIOps frente a DevOps: ¿cuál es la diferencia?
No se trata de elegir entre AIOps o DevOps, sino de combinar AIOps y DevOps. Ambos enfoques se complementan en lugar de competir. DevOps proporciona el modelo operativo para compilar, probar y desplegar software, mientras que AIOps aplica inteligencia operativa a los sistemas que lo ejecutan.
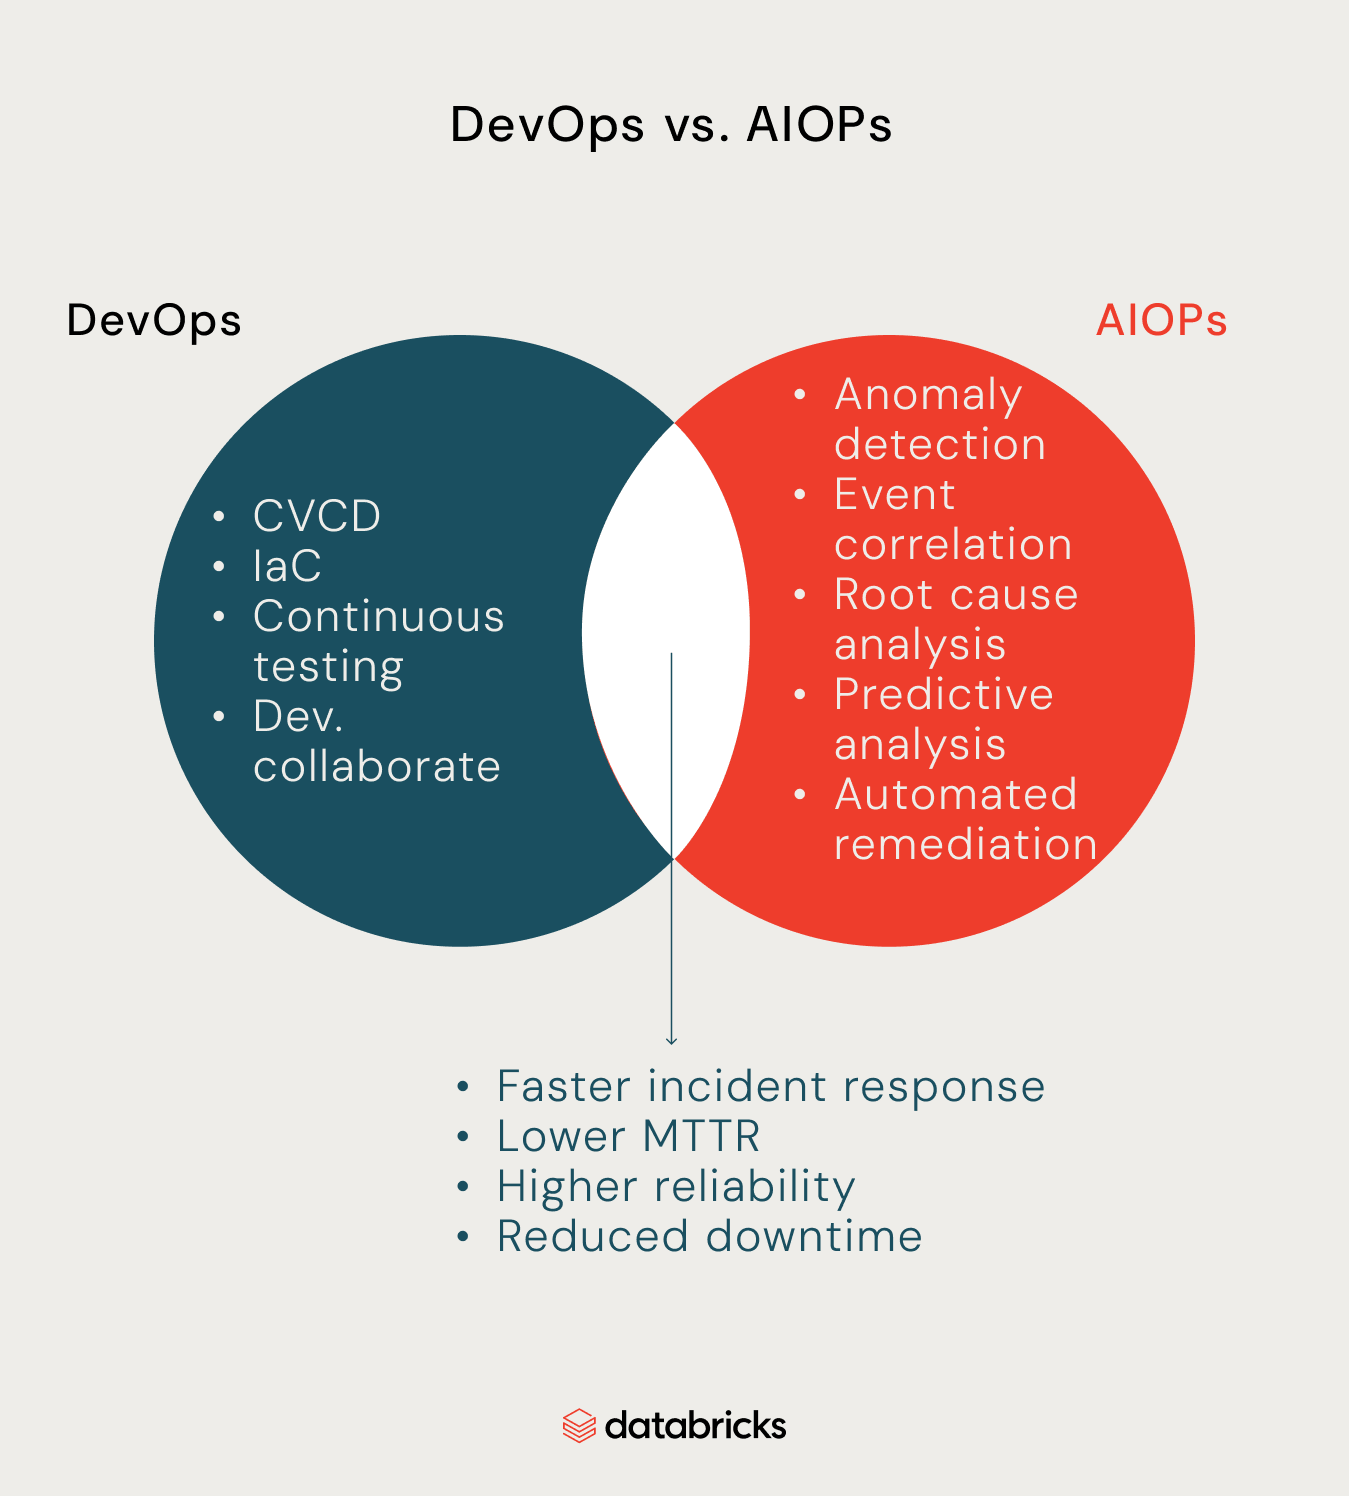
DevOps vincula el desarrollo y las operaciones al automatizar la entrega de software, al tiempo que permite a los desarrolladores lanzar cambios más rápido. AIOps amplía ese modelo operativo al analizar datos de infraestructura, aplicaciones y otros sistemas para detectar anomalías, correlacionar eventos, identificar causas probables y respaldar una resolución más rápida.
| DevOps | AIOps | |
|---|---|---|
| Enfoque principal | Entrega de software y colaboración | Operaciones de IT e inteligencia operativa |
| Rol | Modelo operativo y prácticas de ingeniería | Análisis y automatización impulsados por IA |
| Qué analiza | Código, compilaciones, pruebas, despliegues | Métricas, registros, trazas, eventos y alertas |
| Resultados clave | Lanzamientos más rápidos y confiables | Detección, respuesta y recuperación más rápidas |
| Cómo trabajan juntos | Entrega cambios a producción | Monitorea y responde a su impacto operativo |
DevOps puede desplegar una nueva versión de la aplicación mientras AIOps monitorea su impacto en producción. Si el despliegue muestra un comportamiento inusual, AIOps puede correlacionar señales, identificar la causa probable y activar una respuesta predefinida o alertar al ingeniero correspondiente. Juntos, ayudan a avanzar más rápido con una visibilidad clara.
¿Cuáles son los beneficios de AIOps?
Los principales beneficios de AIOps son un MTTR más rápido, menores costos operativos, una mejor observabilidad y colaboración, y una gestión de ITOps más predictiva. Cada beneficio se conecta directamente con la forma en que los ingenieros de plataformas detectan, comprenden y resuelven incidentes.
- MTTR más rápido: AIOps puede correlacionar eventos, identificar causas raíz probables y recomendar las siguientes acciones más rápido que una investigación manual. Esto reduce el tiempo que los ingenieros dedican a rastrear incidentes y ayuda a restaurar los servicios afectados antes.
- Menores costos operativos: AIOps automatiza las tareas repetitivas de detección, investigación y resolución, lo que reduce el esfuerzo manual necesario para gestionar entornos de IT en crecimiento. También puede ayudar a prevenir costosos tiempos de inactividad al identificar problemas antes de que se agraven.
- Mejor observabilidad y colaboración: AIOps reúne las señales de la infraestructura, las aplicaciones y otros sistemas operativos en una vista compartida del estado del sistema. Esto brinda a los equipos de desarrollo, seguridad y operaciones de IT un mejor contexto al investigar incidentes y coordinar respuestas.
- Gestión predictiva de ITOps: AIOps utiliza datos operativos históricos y en tiempo real para identificar patrones que puedan indicar futuras fallas o problemas de capacidad. Los equipos de datos pueden priorizar estos riesgos y tomar medidas antes de que se conviertan en incidentes graves.
Estos resultados dependen de la calidad de las señales que recibe la plataforma de AIOps, de una propiedad clara de los procesos operativos y de la integración con los flujos de trabajo existentes. Sin estos elementos, AIOps puede agregar más ruido y automatización sin mejorar la respuesta a incidentes.
A pesar de estas razones para integrar AIOps en las organizaciones, todavía existen algunas limitaciones a considerar.
¿Cuáles son las limitaciones de AIOps?
AIOps se queda corto en varios aspectos; su efectividad depende de la calidad de los datos, del contexto disponible para sus modelos y de cómo los ingenieros de IA integran sus recomendaciones en los flujos de trabajo existentes.
- Brechas en la calidad de los datos: Los datos incompletos, inconsistentes o con ruido provenientes de registros, métricas, trazas, eventos y otras fuentes pueden producir correlaciones inexactas, anomalías no detectadas o alertas innecesarias.
- Falta de contexto: Las señales operativas, sin información previa sobre dependencias, despliegues recientes, configuraciones o impacto comercial, pueden llevar a AIOps a identificar una anomalía sin comprender correctamente su causa o gravedad.
- Deriva del modelo: Los modelos entrenados con patrones históricos pueden volverse menos precisos a medida que cambian los sistemas, las cargas de trabajo y las líneas base operativas, lo que requiere un monitoreo y ajuste continuos.
- Riesgo de sobreautomatización: Los equipos no pueden automatizar por completo un paso de resolución complejo sin las salvaguardas adecuadas. Hacerlo puede convertir un pequeño incidente en uno mayor. Las acciones de mayor riesgo deben mantener la supervisión humana.
- Proliferación de herramientas: Agregar otra plataforma de AIOps a una pila de monitoreo y observabilidad fragmentada puede generar más complejidad.
- Poca confianza o adopción: Es menos probable que los ingenieros confíen en recomendaciones que no pueden entender o verificar. Los equipos de datos necesitan una propiedad clara, recomendaciones explicables y resultados medibles antes de expandir AIOps en operaciones críticas.
Los equipos de datos y los ingenieros de IA deben conocer estas limitaciones porque establecen expectativas y les ayudan a prepararse de manera más efectiva para sus estrategias de gobernanza y gestión de riesgos.
Unity Catalog proporciona estas estrategias de gobernanza y acceso a los activos de datos e IA en un solo catálogo, lo que ayuda a los equipos a controlar el acceso a datos confidenciales y regulados.
¿Cómo pueden las organizaciones implementar AIOps?
Para que las organizaciones implementen AIOps en sus operaciones de IT, es importante tener en cuenta que se trata de un proceso gradual en lugar de una transformación radical. Esto significa enfocarse en la secuenciación mediante su introducción por etapas, validando su valor y expandiéndose para generar confianza en el sistema.
Comience con un problema operativo de alto impacto en el que AIOps pueda ofrecer beneficios medibles, como reducir la fatiga por alertas o mejorar la respuesta a incidentes.
Unifique las señales operativas relevantes, agregue contexto sobre las dependencias y el comportamiento del sistema, y comience con recomendaciones antes de permitir que AIOps automatice acciones de mayor riesgo. Los equipos que crean flujos de trabajo operativos de agentes en Databricks pueden usar Agent Bricks para crear e implementar agentes, MLflow para el seguimiento y la evaluación, Unity Catalog para el acceso gobernado y Unity Gateway para los controles de tráfico de modelos y herramientas.
Los equipos comienzan a confiar en las recomendaciones, a operacionalizar los flujos de trabajo y a definir métricas como el MTTR, el volumen de alertas y la frecuencia de incidentes para medir el impacto. A partir de ahí, las organizaciones pueden expandir AIOps a otros sistemas mientras gestionan los cambios en las herramientas, los procesos y las responsabilidades existentes.
Vea cómo Mosaic AI ayuda a las organizaciones a gestionar y gobernar la AI en todas sus operaciones.
¿Cuáles son los diferentes enfoques de AIOps?
Para determinar si un enfoque de AIOps centrado en el dominio o agnóstico del dominio es mejor para la infraestructura y los procesos de su organización, considere la cobertura, la profundidad, las integraciones, el esfuerzo de configuración y la adaptación.
- Cobertura: ¿Necesita AIOps para un solo dominio operativo o para múltiples equipos, sistemas y entornos?
- Profundidad: ¿Su equipo necesita inteligencia especializada para un dominio específico o un análisis más amplio en sistemas interconectados?
- Integraciones: ¿Puede este enfoque conectarse con sus herramientas existentes de monitoreo, observabilidad, nube y operaciones de IT?
- Esfuerzo de configuración: ¿Cuánto tiempo y esfuerzo operativo se requerirá para implementar, configurar y mantener?
- Adaptación organizacional: ¿Se alinea con las habilidades de su equipo, los flujos de trabajo existentes, el modelo de responsabilidad y los objetivos operativos?
Revisar y responder cuidadosamente a estas preguntas ofrece a los equipos un mejor modelo de decisión sobre qué enfoque adoptar. La elección correcta es la que se adapta a sus requisitos operativos.
Qué hacer a continuación
AIOps aplica AI y aprendizaje automático a los datos operativos para detectar problemas antes, comprender su impacto y responder más rápido. Funciona mejor como una capa de inteligencia que complementa a los ingenieros y los procesos existentes de observabilidad y operaciones de IT, en lugar de reemplazarlos.
Comience por identificar dónde puede aportar más valor AIOps, ya sea en la detección de anomalías, el análisis de causa raíz, la respuesta a incidentes o el monitoreo del rendimiento. Luego, evalúe los datos y las integraciones disponibles, introduzca recomendaciones antes de implementar la automatización de mayor riesgo y mida el impacto en métricas clave como el volumen de alertas y los costos operativos.
Para crear y gestionar aplicaciones de agentes y de modelos de lenguaje grande (LLM), explore MLflow para ver cómo puede respaldar el ciclo de vida de sus aplicaciones y sus flujos de trabajo operativos.
Preguntas frecuentes
¿Qué significa AIOps?
AIOps significa Artificial Intelligence for IT Operations. Utiliza AI, aprendizaje automático y datos operativos para detectar, investigar y responder a problemas de IT.
¿Qué datos utiliza AIOps?
AIOps puede analizar datos operativos, incluidos registros, métricas, trazas, eventos, alertas, datos de configuración y otras señales de los sistemas de IT.
¿En qué se diferencia AIOps de la observabilidad?
La observabilidad recopila y comprende lo que sucede en los sistemas. AIOps se basa en estas señales operativas aplicando AI y aprendizaje automático para correlacionar eventos, detectar anomalías, identificar causas probables y respaldar o automatizar las respuestas.
¿En qué se diferencia AIOps de MLOps?
AIOps aplica AI y aprendizaje automático a las operaciones de IT, mientras que MLOps se centra en desarrollar, implementar, monitorear y gestionar modelos de aprendizaje automático y su ciclo de vida. Resuelven diferentes problemas operativos, aunque pueden superponerse en organizaciones que operan sistemas de ML a escala.
¿Es AIOps una herramienta o una práctica?
AIOps es tanto una práctica como una categoría de herramientas. La práctica implica aplicar AI y aprendizaje automático a las operaciones de IT, mientras que las plataformas de AIOps proporcionan las capacidades de procesamiento de datos, análisis, correlación y automatización necesarias para respaldar esa práctica.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.