Ramificación de bases de datos: guía para desarrolladores sobre flujos de trabajo estilo Git
Descubre cómo la ramificación de bases de datos lleva los flujos de trabajo al estilo Git a las bases de datos, utilizando copy-on-write para crear entornos aislados y desechables para desarrolladores, CI y agentes de AI.
- La ramificación de bases de datos crea entornos aislados a través de copy-on-write, compartiendo datos no modificados y almacenando solo las diferencias, sin necesidad de copias completas.
- Admite pruebas similares a las de producción, aislamiento de CI por PR y una recuperación sencilla, con las migraciones (no los merges) como fuente de verdad.
- Es fundamental para los agentes de AI que ejecutan muchas ramas de corta duración; el uso seguro requiere ramas padre protegidas, datos simulados, TTLs y controles de acceso.
Git convirtió el desarrollo aislado en una base de referencia para los equipos de software. Cada desarrollador puede crear una rama, trabajar de forma independiente y fusionar los cambios cuando estén listos.
La creación de ramas de bases de datos lleva este mismo aislamiento a la base de datos. Permite que los desarrolladores, los trabajos de integración continua (CI) y los agentes de AI creen entornos de bases de datos aislados a partir de un estado de base de datos compartido y realicen cambios sin afectar a la base de datos principal ni entre sí.
Esto significa menos tiempo de espera para los entornos compartidos, menos fallos en las pruebas causados por los cambios de otras personas y una respuesta más rápida sobre las migraciones de esquemas. Cuando algo sale mal, puedes descartar la rama en lugar de reparar o restaurar una base de datos compartida.
TL;DR
- La creación de ramas de bases de datos crea entornos aislados sin necesidad de realizar copias completas de la base de datos. El método de copia en escritura (copy-on-write) hace que esto sea posible al compartir los datos no modificados y almacenar solo lo que cambia.
- La creación de ramas de bases de datos es cada vez más importante para los agentes de AI. Les proporciona a los agentes entornos aislados para probar cambios y experimentar sin poner en riesgo la base de datos principal.
- Operar ramas de bases de datos de forma segura requiere controles claros. Protege las ramas principales, restringe el acceso a los datos confidenciales, automatiza la limpieza y mantén la reproducibilidad de los entornos desechables.
¿Qué es la creación de ramas de bases de datos?
La creación de ramas de bases de datos te ofrece un entorno de base de datos aislado basado en el estado de otra base de datos en un momento específico. La rama comienza con el esquema de la base de datos principal y sus datos, pero los cambios que realices en la rama no afectarán a la principal ni a ninguna rama hermana.
Si estás familiarizado con Git, la idea básica te resultará conocida. Una rama de código te ofrece una línea de desarrollo privada a partir de un commit conocido. Una rama de base de datos te ofrece un entorno de base de datos aislado a partir de un estado de base de datos conocido.
Una diferencia importante es que, por lo general, no se fusionan los cambios de una rama de base de datos de vuelta en la base de datos principal. En su lugar, los archivos de migración siguen siendo la fuente de verdad duradera. Puedes probar una migración en tu rama, asegurarte de que funcione con datos reales y luego dejar que tu pipeline de despliegue aplique esa misma migración a la base de datos de destino. De esta manera, la creación de ramas de bases de datos hace que prácticas consolidadas como el diseño evolutivo de bases de datos, los entornos de una base de datos por desarrollador y las migraciones con control de versiones sean prácticas incluso cuando se trabaja con datos a escala de producción.
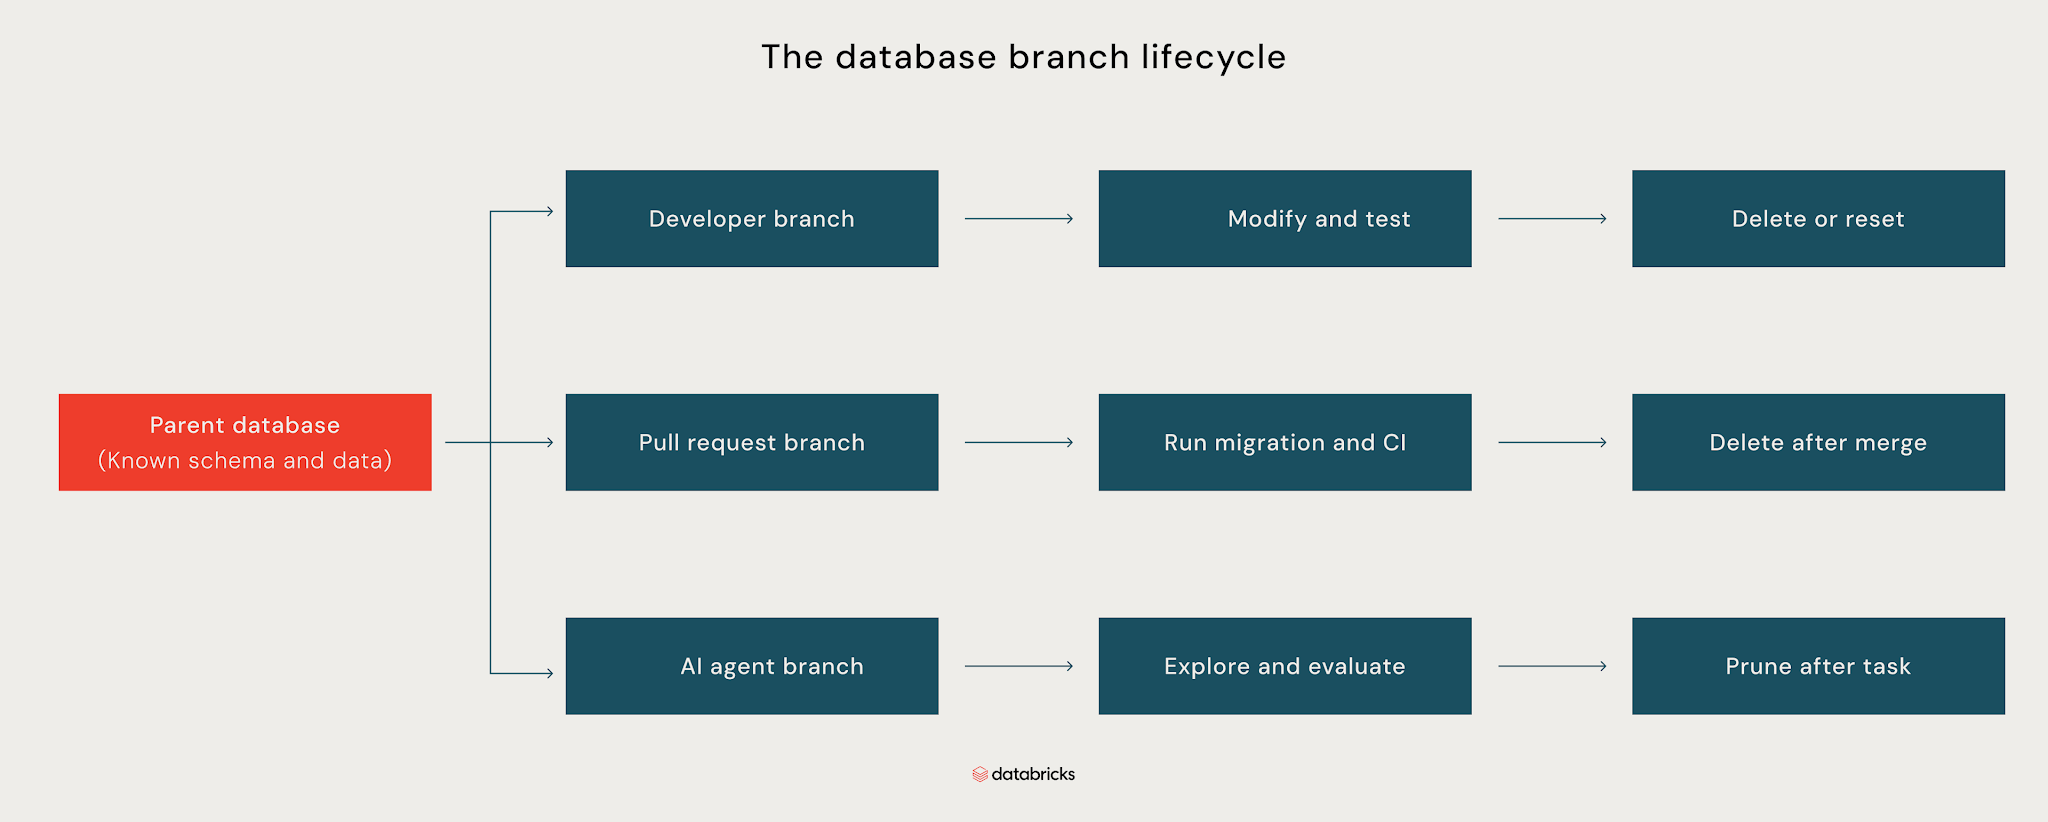
Como se muestra arriba, una base de datos principal proporciona el esquema y los datos conocidos para múltiples ramas aisladas. Puedes usar una rama de desarrollador para modificar y probar cambios, una rama de pull request para ejecutar migraciones y CI, o una rama de agente para explorar y evaluar cambios. Cuando el trabajo termina, cada rama se puede restablecer, eliminar o depurar sin afectar a la base de datos principal ni a las otras ramas. La creación de ramas de bases de datos hace posible este nivel de aislamiento a través de la copia en escritura.
Cómo funciona la creación de ramas de bases de datos con copia en escritura
La copia en escritura (CoW) hace que la creación de ramas de bases de datos sea práctica al evitar una copia completa inicial de la base de datos. Cuando creas una rama, esta comparte inicialmente los datos existentes de la principal en lugar de duplicarlos. Ambas pueden leer los mismos datos subyacentes, mientras que los cambios realizados en una permanecen aislados de la otra. Pero cuando la rama modifica los datos, la capa de almacenamiento crea una nueva versión de los datos afectados para esa rama, mientras que los datos no modificados se siguen compartiendo con la principal.
Lakebase utiliza este enfoque de copia en escritura para crear ramas de bases de datos sin duplicar toda la base de datos principal. Como resultado, cada rama requiere almacenamiento adicional solo para los datos que difieren de su principal.
Considera una base de datos de 40 GB. Con una copia completa tradicional, la creación de una rama de desarrollador y una rama de pull request requiere 80 GB adicionales de almacenamiento. Sin embargo, con la copia en escritura, ambas ramas comparten inicialmente los datos de la principal y consumen almacenamiento adicional solo cuando difieren.
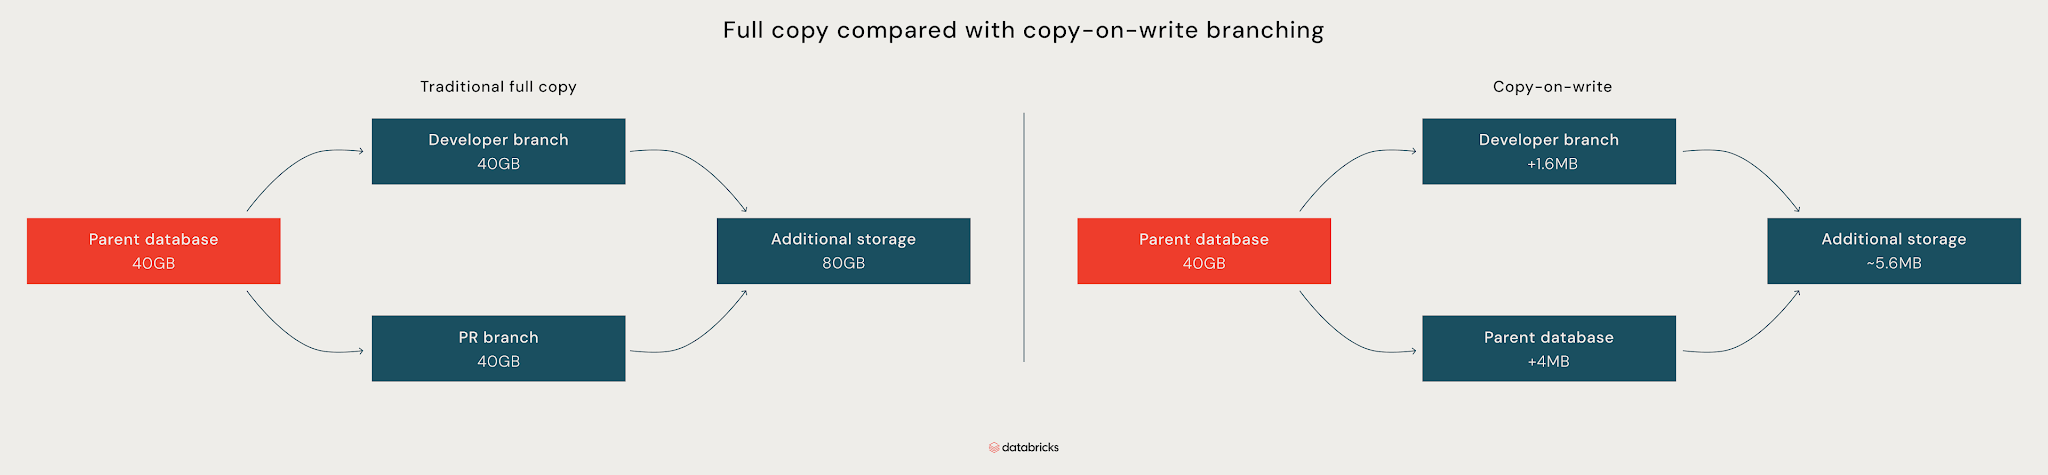
Como se muestra en el diagrama anterior, si los cambios en la rama del desarrollador son de solo 1.6 MB y los cambios en la rama de PR son de solo 4 MB, las dos ramas solo agregan alrededor de 5.6 MB de almacenamiento. Las copias tradicionales duplican toda la base de datos para cada rama, mientras que las ramas de copia en escritura comparten los datos no modificados y almacenan solo sus cambios.
El mismo principio se aplica cuando la principal cambia después de que se crea una rama. La rama continúa haciendo referencia a la versión original de los datos no modificados, mientras que la principal escribe nuevas versiones de las páginas que modifica. Esto permite que las dos ramas cambien de forma independiente sin duplicar los datos no modificados.
Lo que hace posible la creación de ramas de bases de datos
Bases de referencia similares a producción
Puedes crear ramas de bases de datos a partir de una instantánea de producción protegida para que cada desarrollador y trabajo de CI comience desde el mismo estado conocido. Eso te permite probar migraciones con datos reales, restricciones existentes y tablas a escala de producción en lugar de una base de datos local vacía o un entorno de staging desactualizado.
Por ejemplo, una migración como ALTER TABLE orders ADD COLUMN customer_id UUID NOT NULL puede funcionar en una base de datos vacía pero fallar con millones de pedidos existentes. Probarla en una rama similar a la de producción expone ese problema antes de que la migración llegue a staging o producción. Cuando la rama se desactualice, puedes eliminarla y crear una nueva a partir de la misma base de referencia.
Aislamiento por PR
Puedes darle a cada pull request su propio entorno de base de datos. CI crea la rama cuando se abre la PR, aplica las migraciones propuestas y ejecuta pruebas de integración en ella. Cuando se cierra la PR, el pipeline elimina la rama.
Esto significa que dos desarrolladores pueden realizar cambios de esquema en conflicto sin afectar las pruebas del otro. Una PR que agrega una columna, cambia una restricción o modifica un índice obtiene su propio estado de base de datos, por lo que CI prueba el cambio de forma aislada en lugar de hacerlo contra lo que sea que otro desarrollador esté haciendo en staging.
Recuperación de fallos más sencilla
Las ramas también facilitan el aislamiento de experimentos y migraciones fallidas. Si un backfill produce resultados inesperados, una prueba corrompe los datos o una migración deja una rama en mal estado, puedes descartar la rama afectada y crear una nueva a partir de la principal en lugar de seguir trabajando con un entorno de desarrollo contaminado.
Por ejemplo, puedes probar de forma segura una operación destructiva como DELETE FROM orders WHERE created_at < ... en una rama, inspeccionar los resultados y descartar la rama cuando hayas terminado. La base de datos principal permanece intacta en todo momento.
Para los desarrolladores y los equipos de DevOps, estos beneficios ya son convincentes. Sin embargo, si estás creando o ejecutando agentes de AI, la creación de ramas de bases de datos adquiere una importancia a una escala completamente diferente.
La guía de IA agéntica para la empresa

Por qué los agentes de AI hacen que la creación de ramas sea crítica para la infraestructura
Los agentes de AI pueden necesitar sus propios entornos de bases de datos para probar diferentes enfoques para una tarea. Pueden crear una rama para cada enfoque, comparar los resultados y descartar las que no necesiten. En una flota de agentes, eso puede significar cientos o miles de entornos de corta duración ejecutándose a la vez.
A esa escala, las copias completas de bases de datos se vuelven costosas y lentas de aprovisionar. La creación de ramas de bases de datos evita esa sobrecarga, lo que hace práctico que los agentes creen y descarten entornos a medida que trabajan.
La creación de ramas también puede reducir el radio de impacto de los errores de los agentes al proporcionarles un entorno aislado para probar cambios. En lugar de otorgar a un agente acceso de escritura a una base de datos de producción, puedes darle acceso a una rama donde pueda probar operaciones destructivas sin afectar a la principal.
Cómo operar ramas de bases de datos de forma segura
Las ramas de bases de datos son más fáciles de gestionar cuando las tratas como entornos desechables y automatizas su ciclo de vida. Algunas prácticas mantienen ese flujo de trabajo seguro y predecible:
- Protege las ramas de producción y principales: Restringe quién puede escribir, restablecer o eliminar las ramas de producción y otras ramas principales importantes. Los agentes y desarrolladores deberían trabajar en ramas secundarias en su lugar.
- Usa datos seguros para ramas efímeras: Evita copiar datos confidenciales de producción en ramas de desarrollo o de agentes de corta duración, a menos que sea necesario y estén protegidos adecuadamente. Siempre que sea posible, utiliza datos simulados para que los entornos desechables no se conviertan en una vía para exponer información de producción.
- Establezca un tiempo de vida (TTL) para las ramas: Asigne un tiempo de expiración a las ramas de corta duración para que los PRs abandonados, las ejecuciones de CI fallidas y las tareas de agentes terminadas no dejen entornos ejecutándose indefinidamente.
- Mantenga las migraciones como la fuente de verdad: Trate los archivos de migración como la fuente de verdad. Pruebe las migraciones en una rama, revíselas en el control de versiones y aplique la migración aprobada a la base de datos de destino en lugar de promover los cambios realizados directamente en una rama.
- Haga que los entornos sean reproducibles: Trate las ramas como desechables en lugar de entornos de larga duración que requieren reparación manual. Mantenga la configuración necesaria para recrear un entorno en el control de versiones para que una rama desactualizada o dañada pueda eliminarse y recrearse a partir de su rama padre.
- Controle el acceso y el uso de recursos: Otorgue a los desarrolladores y agentes solo los permisos que necesitan, y monitoree la antigüedad de las ramas, el cómputo, el almacenamiento y la cantidad de entornos activos. Utilice herramientas como Unity Catalog para gobernar el acceso a los datos disponibles dentro de estos entornos.
Con estas medidas de protección implementadas, los equipos pueden usar las ramas de bases de datos como entornos desechables en el desarrollo, la integración continua y entrega continua (CI/CD) y los flujos de trabajo de agentes. Cada rama proporciona un entorno aislado para probar cambios y se puede eliminar automáticamente cuando se completa el trabajo.
Conclusión
La ramificación de bases de datos le ofrece una forma práctica de crear entornos de bases de datos aislados sin el costo y la sobrecarga de las copias completas. Puede usar ramas para probar migraciones con datos realistas, asignar a cada pull request su propia base de datos, recuperarse de experimentos fallidos y ejecutar cargas de trabajo respaldadas por bases de datos en paralelo.
Comience con un flujo de trabajo simple, como una rama por pull request, y automatice la creación y la limpieza. A partir de ahí, puede extender la ramificación a los entornos de desarrollo y a las cargas de trabajo de agentes a medida que crezcan sus necesidades. ¿Listo para probarlo? Explore la ramificación de bases de datos con Databricks Lakebase o siga un tutorial práctico para implementar la ramificación de bases de datos en Postgres.
Preguntas frecuentes
¿Qué es la ramificación de bases de datos?
La ramificación de bases de datos crea un entorno de base de datos aislado a partir de una base de datos padre en un momento específico en el tiempo. La rama comienza con el esquema y los datos del padre, pero los cambios realizados en la rama permanecen aislados. Con copy-on-write, las ramas comparten datos sin modificar con el padre, lo que las hace rápidas de crear y económicas de desechar.
¿En qué se diferencia la ramificación de bases de datos de la ramificación de Git?
La idea es similar: ambas le permiten crear un entorno aislado a partir de un estado conocido y realizar cambios sin afectar al original. Las ramas de Git aíslan el código fuente, mientras que las ramas de bases de datos aíslan el esquema y los datos de la base de datos.
Los flujos de trabajo difieren después de eso. Las ramas de Git normalmente se fusionan de nuevo en la rama principal, mientras que las ramas de bases de datos no suelen fusionarse. En su lugar, prueba su migración en la rama de la base de datos y luego aplica la migración revisada a la base de datos de destino a través de su proceso de despliegue.
¿Cuál es el propósito de la ramificación de bases de datos?
La ramificación de bases de datos ofrece a los desarrolladores, trabajos de CI y agentes de AI entornos aislados para probar cambios sin afectar la producción u otras cargas de trabajo. Puede usar ramas para probar migraciones con datos realistas, crear entornos por PR, recuperarse de experimentos fallidos y ejecutar múltiples cargas de trabajo respaldadas por bases de datos en paralelo.
¿Cuáles son los dos tipos de ramificación de bases de datos?
Los dos enfoques comunes son la ramificación de copia completa (full-copy) y la ramificación de copia en escritura (copy-on-write). La ramificación de copia completa duplica la base de datos para cada rama, por lo que el tiempo de creación y los requisitos de almacenamiento aumentan con el tamaño de la base de datos. La ramificación de copia en escritura comparte datos sin modificar con el padre y almacena solo los cambios realizados en cada rama.
¿Qué tipos de bases de datos admiten la ramificación?
La ramificación depende más de la arquitectura de almacenamiento de la base de datos que de su modelo de datos. Las bases de datos relacionales, de documentos, clave-valor y de grafos pueden, en teoría, admitir la ramificación, pero la implementación y las capacidades varían según la plataforma.
¿Cómo implemento la ramificación de bases de datos?
La implementación depende de su plataforma de base de datos y arquitectura de almacenamiento. En general, necesita una base de datos padre y una forma de crear ramas aisladas a partir de un estado de base de datos conocido. Databricks Lakebase proporciona ramificación de bases de datos para flujos de trabajo de desarrollo, CI y agentes, con ramas que se pueden crear y eliminar según sea necesario. Para una implementación práctica, consulte el tutorial de desarrollo basado en ramas de Databricks.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.