Base de datos para agentes de AI: 5 criterios de evaluación
Conoce los 5 criterios para evaluar una base de datos para agentes de AI: aislamiento de ramas, escalado serverless, búsqueda híbrida, garantías ACID y acceso unificado.
- Los agentes de AI necesitan una base de datos que admita lecturas y escrituras continuas y simultáneas en múltiples tipos de memoria, no el patrón de una solicitud a la vez que usan las aplicaciones tradicionales.
- Cinco criterios definen una base de datos de agentes lista para producción: aislamiento de rama por agente, cómputo con escalado a cero, búsqueda híbrida en una sola consulta, garantías ACID bajo concurrencia y una plataforma unificada sin latencia de ETL.
- Lakebase de Databricks cumple con cada criterio, con validación en el mundo real de Superhuman y easyJet.
Los cinco criterios para evaluar una base de datos para agentes de AI son el aislamiento de ramas, el escalado serverless, la búsqueda híbrida, las garantías ACID y el acceso unificado a la plataforma. Juntos, estos criterios ayudan a los desarrolladores y equipos de datos a determinar si una base de datos puede dar soporte a los agentes a medida que pasan de prototipos a producción y comienzan a gestionar tareas concurrentes, datos operativos en tiempo real y un estado persistente.
Una base de datos para agentes de AI es un sistema diseñado para almacenar el estado, la memoria, los resultados de las herramientas y los datos operativos que un agente necesita para completar tareas a lo largo de múltiples pasos y sesiones. A diferencia de una base de datos que sirve a una aplicación convencional, esta debe admitir lecturas y escrituras repetidas, actividad concurrente de los agentes, recuperación en diferentes tipos de memoria y acceso a los datos operativos actuales.
El auge de los agentes de AI hace que estos requisitos sean aún más importantes. Cuando los desarrolladores ejecutan agentes de codificación, agentes de soporte al cliente o plataformas multi-tenant, los agentes hacen más que solo recuperar información. Escriben el estado, reanudan tareas, coordinan llamadas a herramientas y actúan sobre datos operativos cambiantes. A medida que los equipos de datos llevan los agentes a producción, las limitaciones de la base de datos pueden generar memoria desactualizada, conflictos de escritura, latencia y costos de cómputo innecesarios.
Por qué una base de datos para agentes de AI no es el mismo problema
Un agente listo para producción necesita recordar lo que ya hizo, retomar una tarea donde la dejó y obtener el contexto adecuado antes de actuar. Si se combina con la base de datos incorrecta, esa memoria puede volverse desactualizada, incompleta o inconsistente.
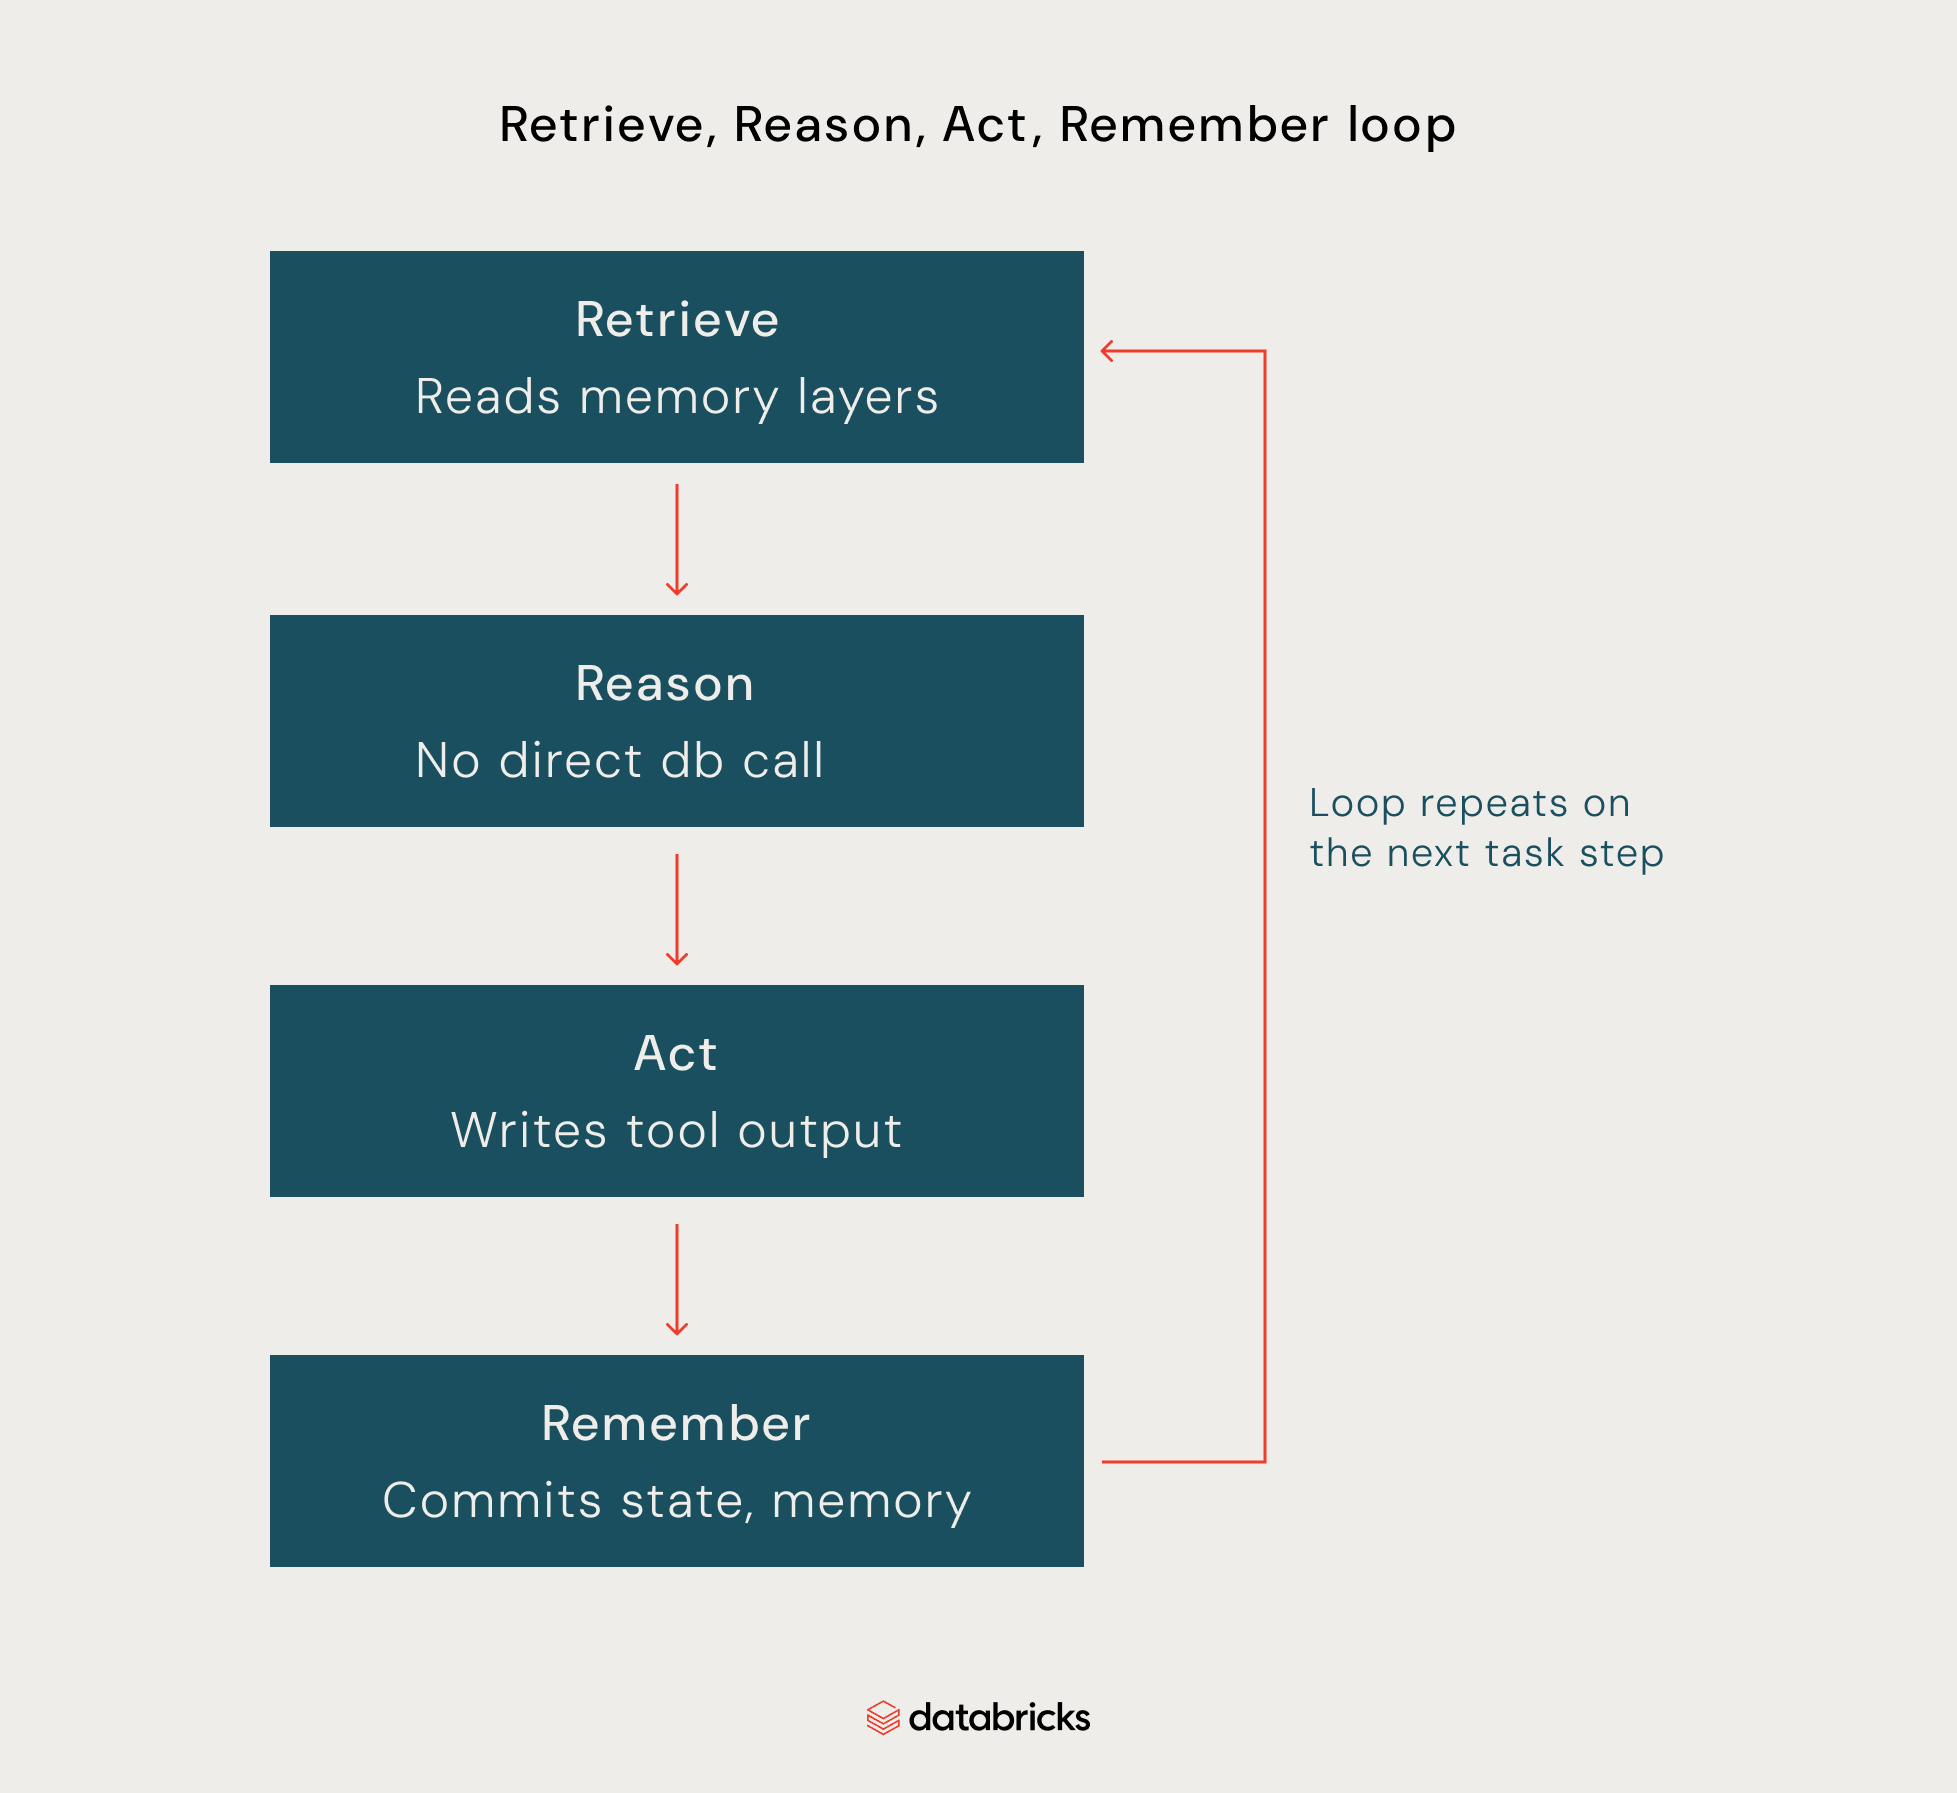
Los agentes en producción se apoyan en cuatro capas de memoria para lograr esto:
- Memoria a corto plazo: la memoria de trabajo en contexto disponible durante la interacción actual, que incluye mensajes recientes, información recuperada y resultados de herramientas.
- Memoria episódica: interacciones pasadas que permiten a un agente recordar conversaciones anteriores, preferencias del usuario y tareas completadas.
- Memoria procedimental: los flujos de trabajo, definiciones de herramientas e instrucciones que guían cómo se llevan a cabo las tareas, ya sea que estén almacenados externamente o integrados en el modelo.
- Estado operativo: el estado en tiempo real de la tarea, incluidos los pasos completados y pendientes, las salidas de las herramientas y los puntos de control para reanudar el trabajo más tarde.
Esta es una carga de trabajo más compleja que la de una aplicación típica, que simplemente envía una consulta a la base de datos y continúa. La mayoría de las bases de datos de producción son bases de datos operativas, también llamadas sistemas de procesamiento de transacciones en línea (OLTP), construidas en torno a ese mismo patrón de una solicitud a la vez. Un agente no funciona de esa manera. Realiza lectura tras lectura y escritura tras escritura dentro de una sola tarea, sin pausas humanas entre ellas, mientras cientos de otros agentes hacen lo mismo.
Los 5 criterios para evaluar cualquier base de datos para cargas de trabajo de agentes de AI
Al seleccionar una base de datos para agentes de AI, varios criterios son importantes, pero estos cinco son los que vale la pena evaluar, independientemente del proveedor que se esté considerando, ya sea gestionado o autohospedado.
Una rama por agente: pruebas seguras con datos reales
Probar un agente solo con datos sintéticos es como probar un sistema de soporte con un puñado de cuentas de clientes perfectamente formateadas. Puede que se comporte exactamente como se espera, pero las cuentas reales siempre son más desordenadas. Los equipos de datos tarde o tarde se topan con campos faltantes, registros inconsistentes, datos antiguos y casos extremos que nunca llegaron a sus entornos de prueba.
Por eso recomendamos considerar las pruebas aisladas con datos reales como un criterio de evaluación de la base de datos. El objetivo es que el agente trabaje con un estado similar al de producción sin permitirle modificar la producción. Una forma de lograr ese aislamiento es la ramificación sin copia (zero-copy branching), que permite a los desarrolladores crear un entorno independiente sin mantener una segunda copia completa de la base de datos.
Lakebase Projects está diseñado para manejar este tipo de desarrollo y pruebas aislados, permitiendo a los desarrolladores crear ramas a partir de datos de producción sin copiar los datos subyacentes. Ramificar una base de datos de producción a escala de terabytes toma alrededor de un segundo, sin costo de almacenamiento adicional hasta que la rama diverge de su elemento principal.
Escalado a cero: cómo los precios de serverless cambian la economía de los agentes
El 27% del gasto en la nube se desperdicia cada año, y el cómputo inactivo y subutilizado es constantemente el principal factor de esto. Las bases de datos de agentes son un claro ejemplo de por qué. La mayoría de los agentes no se ejecutan continuamente. Se activan, realizan una tarea, escriben los resultados y luego se quedan inactivos hasta que llega la siguiente solicitud. Pagar por cómputo dedicado las 24 horas del día significa pagar por ese mismo problema de cómputo inactivo en cada base de datos de agentes que un equipo esté ejecutando.
Un modelo serverless de escalado a cero soluciona esto suspendiendo el cómputo después de un período sin conexiones activas y reanudándolo cuando el trabajo comienza de nuevo. Esto hace que los costos se ajusten al uso real en lugar del tiempo de inactividad. Sin embargo, la velocidad de inicio importa tanto como el ahorro. Un agente que espera 20 o 30 segundos para que su base de datos se active no es práctico, especialmente cuando está respondiendo a un usuario o esperando la siguiente llamada a una herramienta.
Lakebase utiliza este modelo para Postgres, reanudando el cómputo en unos pocos cientos de milisegundos tras una nueva consulta. Esto mantiene el retraso de inicio lo suficientemente bajo como para que el escalado a cero funcione con cargas de trabajo de agentes interactivos.
Búsqueda híbrida: recuperación en las cuatro capas de memoria en una sola consulta
La búsqueda vectorial por sí sola es como un bibliotecario que solo puede buscar por "lo que parece similar", nunca por un número de clasificación exacto. Si le pides que busque documentos sobre arquitectura de bases de datos, lo hará bien. Si le pides el registro con el ID de cuenta 48291, no tiene una forma confiable de encontrarlo. La similitud semántica no está diseñada para coincidencias exactas.
Esa es la brecha con la que se topan muchos pipelines de generación aumentada por recuperación (RAG) cuando dependen únicamente de la búsqueda vectorial. La búsqueda híbrida la cierra al combinar la similitud vectorial, la coincidencia de palabras clave y el filtrado de metadatos en una sola consulta, en lugar de unir resultados de sistemas separados. Si divides eso entre un índice vectorial y un almacenamiento relacional, el agente realiza dos llamadas en lugar de una. Los sistemas pueden desincronizarse y cada salto adicional añade una latencia que el ciclo de un agente no siempre puede absorber. La recuperación debe realizarse en mucho menos de 100 milisegundos para seguir siendo utilizable dentro de un ciclo de razonamiento rápido.
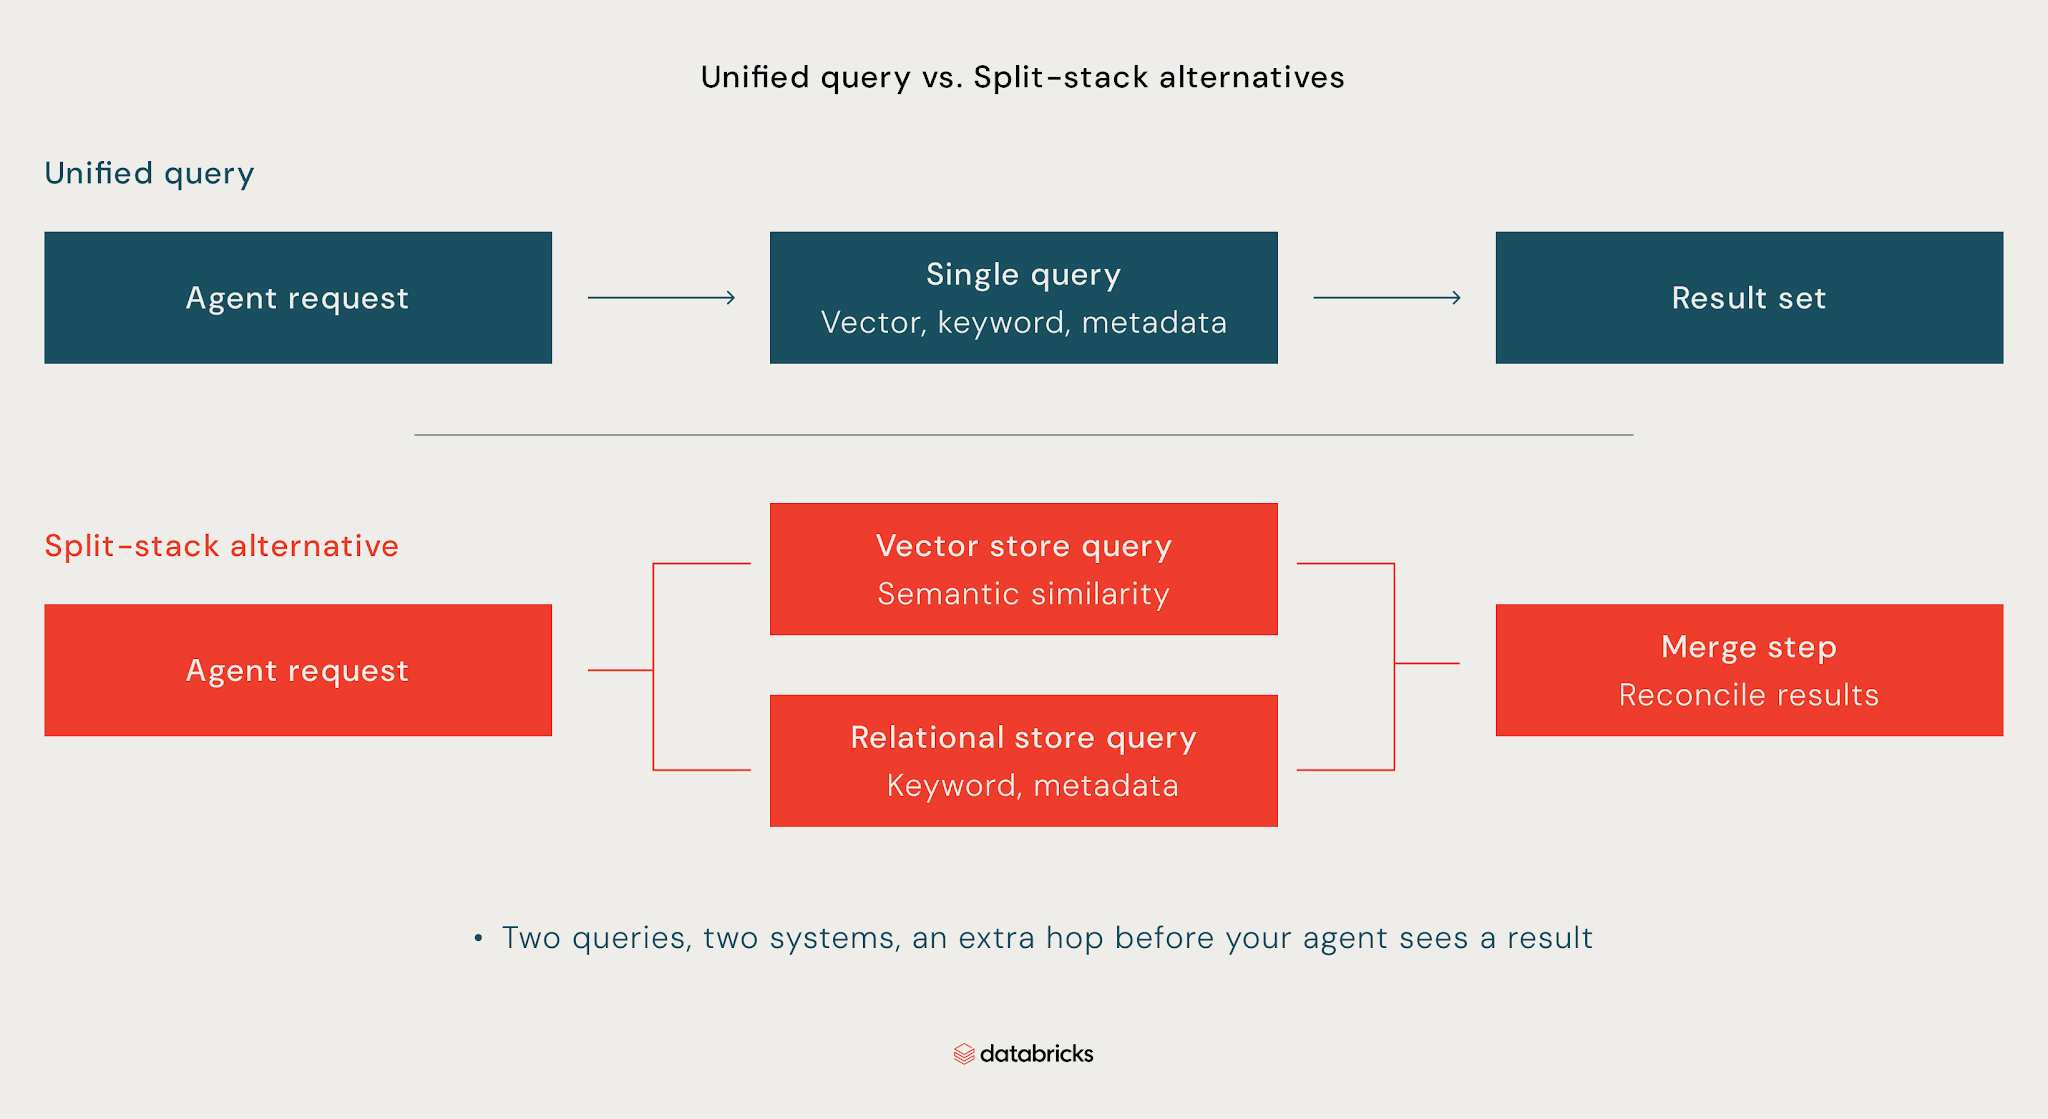
Lakebase Search ejecuta consultas vectoriales, de palabras clave y de metadatos en las mismas tablas de Postgres donde ya residen los datos operativos, por lo que no hay un segundo sistema que pueda desincronizarse. Su arquitectura LTAP es lo que mantiene esos datos actualizados, con un rendimiento de escritura hasta 5 veces más rápido que el de Postgres estándar. Esto significa que lo que un agente acaba de escribir puede estar disponible para su recuperación casi de inmediato.
Garantías ACID para sistemas multiagente
Imagina a dos agentes de soporte actualizando el mismo registro de cliente al mismo tiempo. Uno está resolviendo un problema de facturación y ajustando el nivel de suscripción, mientras que el otro está registrando un reembolso. Sin el aislamiento adecuado, una actualización puede sobrescribir la otra, dejando el registro en un estado que ninguno de los agentes deseaba.
Por eso, las garantías transaccionales deberían ser un criterio estricto al evaluar una base de datos para cargas de trabajo multiagente. ACID ofrece a los desarrolladores cuatro propiedades para verificar:
- Atomicidad: una transacción se completa por completo o no se realiza en absoluto.
- Consistencia: la base de datos sigue siendo válida antes y después de cada transacción.
- Aislamiento: las transacciones concurrentes no interfieren con el trabajo de las demás de formas inesperadas.
- Durabilidad: una escritura confirmada (committed) sobrevive a una caída o reinicio del sistema.
Para los sistemas multiagente, las preguntas prácticas importan más que el acrónimo. ¿Puede la confirmación (commit) de la salida de una herramienta ocurrir de forma atómica, de modo que una acción a medio terminar nunca se considere completa? ¿Qué sucede cuando dos agentes actualizan el mismo registro? ¿Qué niveles de aislamiento admite la base de datos? ¿Puede un agente reanudar su actividad después de un reinicio sin perder el estado confirmado?
Al comparar bases de datos, recomendamos verificar los niveles de aislamiento y la semántica de confirmación (commit) que realmente admiten, no solo si afirman "admitir transacciones". Una vez que varios agentes comparten datos operativos, esos detalles determinan si el trabajo concurrente sigue siendo predecible.
Plataforma unificada: datos operativos en el stack de AI sin ETL
Un agente que espera a que un pipeline se actualice está tomando decisiones basadas en datos desactualizados. Para cuando se ejecuta ese pipeline, el registro sobre el que está actuando puede haber cambiado de nuevo. Al evaluar una base de datos, observe qué tan estrechamente conecta los datos operativos con los sistemas de analítica y AI que dependen de ellos.
Una plataforma unificada mantiene las escrituras operativas y las lecturas analíticas en los mismos datos, sin una canalización de extracción, transformación y carga (ETL) independiente entre ellas. Sus agentes pueden trabajar con datos actualizados, mientras que sus modelos pueden usar resultados en tiempo real en lugar de esperar a un trabajo por lotes. Los equipos de datos también mantienen la gobernanza y las trazas de auditoría en la misma plataforma, en lugar de trasladar las cargas de trabajo de los agentes a un sistema independiente que es más difícil de rastrear. Unity Catalog es lo que aplica esa capa de gobernanza tanto en los datos operativos como analíticos en Databricks. La experiencia de Superhuman muestra cómo se ve esto en la práctica: reemplazar las canalizaciones de sincronización personalizadas hacia una capa de almacenamiento en caché y un almacén NoSQL gestionado por una plataforma unificada redujo su cronograma de integración de datos de casi tres meses a aproximadamente dos semanas.
easyJet adoptó un enfoque similar en su pila de gestión de ingresos. Desde que se trasladó a Lakebase, la aerolínea ha capturado la actividad de reservas y precios en tiempo real junto con la analítica en los mismos datos de lakehouse, ha consolidado más de 100 repositorios de Git en dos y ha reducido los ciclos de desarrollo de aplicaciones de seis a nueve meses a aproximadamente cuatro.
Lakebase mantiene los datos operativos en el lakehouse de Databricks, de modo que los mismos datos pueden admitir cargas de trabajo transaccionales y analítica descendente sin una canalización ETL independiente.
La guía de IA agéntica para la empresa

Ficha de evaluación de bases de datos para agentes de IA
Somete a cualquier candidato a estas cinco comprobaciones y sabrás en cuestión de minutos dónde se mantiene firme y dónde no, independientemente del proveedor que estés comparando.
| Criterio | Qué probar | Nivel mínimo | Señales de alerta | Comportamiento de Lakebase |
|---|---|---|---|---|
| Rama por agente | ¿Puedes crear una rama aislada a partir de datos reales de producción sin hacer una copia completa? | La creación de la rama se completa en segundos, no en minutos | Requiere una copia completa de la base de datos o tarda más que tu ciclo de prueba | Crea ramas de una base de datos a escala de terabytes en aproximadamente un segundo, sin costo de almacenamiento hasta que diverge |
| Escalado a cero | ¿Se suspende el cómputo tras un periodo de inactividad y se reanuda lo suficientemente rápido como para seguir siendo utilizable? | El cómputo se reanuda en menos de un segundo, sin necesidad de un paso de activación manual | El arranque en frío tarda más de 10 segundos, o las bases de datos inactivas se siguen facturando a la tarifa completa | Se reactiva en unos pocos cientos de milisegundos y no factura nada mientras está suspendida |
| Búsqueda híbrida | ¿Puede una sola consulta combinar la similitud de vectores, la coincidencia de palabras clave y un filtro estructurado? | Una sola consulta, en menos de 100 ms | Requiere llamadas independientes a un almacén de vectores y a un almacén relacional, y luego una fusión manual | Ejecuta consultas de vectores, palabras clave y metadatos en las mismas tablas de Postgres |
| Garantías ACID | ¿Pueden dos agentes escribir en el mismo registro a la vez sin perder ninguna de las escrituras? | Sin pérdida de escrituras; el aislamiento se mantiene bajo carga concurrente | Sobreescrituras silenciosas o aislamiento que se degrada bajo concurrencia | Garantías transaccionales estándar de Postgres, sin verse afectadas por la carga concurrente de los agentes |
| Plataforma unificada | ¿Cuánto tarda una nueva escritura en estar disponible para la analítica? | Sin paso ETL, o con un retraso medido en segundos, no en horas | Requiere una canalización programada antes de que los datos se puedan consultar en otro lugar | Cada escritura se vuelve consultable en el lakehouse de Databricks sin una canalización independiente |
Una base de datos que no supere más de uno de estos niveles mínimos representa un riesgo de producción una vez que ejecutas agentes a escala, no solo una pequeña concesión que puedas solucionar más adelante.
Conclusión
Elegir una base de datos para agentes de IA se reduce a la adecuación de la carga de trabajo, no a las listas de características. Los cinco criterios de esta guía ofrecen a los desarrolladores y equipos de datos un marco práctico para evaluar cualquier base de datos antes de comprometerse con ella en producción. Si un candidato no puede cumplir con esos requisitos hoy en día, los agentes en producción acabarán exponiendo las deficiencias a medida que asuman más usuarios, más tareas y más trabajo concurrente.
Si estás evaluando una base de datos para agentes de IA, explora Lakebase para ver cómo Databricks admite cargas de trabajo transaccionales, ramificaciones, escalado sin servidor, búsqueda híbrida y acceso unificado a datos operativos.
Preguntas frecuentes
¿Necesitan los agentes de IA una base de datos?
Sí. La mayoría de las implementaciones de agentes no retienen el contexto a corto plazo, el historial episódico, el conocimiento procedimental o el estado de la tarea en tiempo real entre llamadas a menos que los persistas y vuelvas a cargar explícitamente. Sin una base de datos detrás, tu agente normalmente pierde ese contexto en el momento en que finaliza una sesión y no puede retomar una tarea donde la dejó.
¿Es suficiente una base de datos de vectores para los agentes de IA?
No por sí sola. Una base de datos de vectores gestiona bien la recuperación semántica, pero tu agente también necesita escribir y actualizar el estado operativo, garantizar la integridad transaccional en escrituras concurrentes y filtrar por campos estructurados que una búsqueda de similitud no puede detectar de manera confiable. La búsqueda semántica cubre una parte de lo que necesita un agente, no toda la carga de trabajo.
¿Cuál es la mejor base de datos para RAG en agentes de IA?
No hay una única respuesta correcta. Para RAG en agentes de IA, la mejor base de datos es aquella que puede ejecutar una búsqueda híbrida en una sola consulta, mantener la recuperación lo suficientemente rápida para el bucle del agente y mantenerse lo suficientemente actualizada para evitar una memoria obsoleta.
¿Cómo cambian los requisitos de la base de datos los sistemas multiagente?
Una vez que varios agentes escriben en datos compartidos al mismo tiempo, la integridad transaccional deja de ser opcional. Tu base de datos necesita aislar las escrituras concurrentes para que la actualización de un agente no sobrescriba silenciosamente la de otro, y necesita confirmar los resultados de las herramientas de forma atómica para que una acción a medio terminar nunca se considere completa.
¿Cuál es la diferencia entre OLTP y OLAP para los agentes de IA?
Las acciones en tiempo real de tu agente, la escritura de resultados de herramientas, la actualización del estado y el registro del progreso son cargas de trabajo OLTP. Los informes y el entrenamiento de modelos sobre esos datos son cargas de trabajo OLAP. Los agentes normalmente necesitan que ambos trabajen con los mismos datos sin una canalización entre ellos. Por eso, los criterios de esta guía se centran en bases de datos que puedan atender tanto el trabajo de los agentes con un alto volumen de transacciones como la analítica descendente a partir de los mismos datos.
¿Es Postgres bueno para los agentes de IA?
El Postgres estándar proporciona garantías ACID sólidas y un ecosistema maduro, cubriendo parte de lo que necesita tu agente. No proporciona ramificación de copia cero, cómputo con escalado a cero ni acceso operativo y analítico unificado por sí mismo; eso depende de la plataforma construida a su alrededor.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.