MemCurrent: Diseño de memoria persistente para agentes en producción
Las herramientas de AI han facilitado la creación de agentes mediante vibe coding. Sin embargo, crear y mantener un agente empresarial en producción sigue siendo mucho más complejo. En particular, los desarrolladores a menudo se ven obligados a buscar un equilibrio entre la calidad (obtener buenas respuestas, especialmente en tareas atípicas) y la eficiencia (mantener bajo control el costo y la latencia a escala). Con frecuencia, las técnicas aportan mejoras en una dimensión a costa de otra.
La memoria es una forma prometedora de mejorar ambas dimensiones al mismo tiempo. Puede ayudar a los agentes a trasladar un contexto útil de una tarea a otra, como las preferencias del usuario, correcciones previas, definiciones de métricas y flujos de trabajo exitosos. En principio, esto puede mejorar la precisión, reducir errores repetidos y evitar descubrimientos innecesarios. Sin embargo, tener más historial no significa necesariamente tener una mejor memoria. Proporcionar todas las interacciones pasadas resulta costoso y puede introducir un contexto desactualizado, contradictorio o irrelevante. El principal desafío consiste en decidir qué retener, cómo mantenerlo y cómo medir su utilidad.
En esta publicación, presentamos MemCurrent, una arquitectura de memoria persistente para agentes en producción, que ahora impulsa las nuevas funciones de Agent Bricks Memory y Genie. Los agentes leen y escriben en la memoria a medida que trabajan, y un pipeline fuera de línea (offline) de "soñado" (dreaming) consolida la memoria para mantenerla coherente y actualizada. En nuestra prueba de referencia interna (benchmark), desarrollada a partir de tareas empresariales reales, MemCurrent triplica la tasa de éxito del agente en comparación con no usar memoria, al tiempo que utiliza un 31% menos de tokens y se ejecuta un 26% más rápido. El resto de esta publicación aborda cómo lo diseñamos y evaluamos, y qué aprendimos en el proceso.
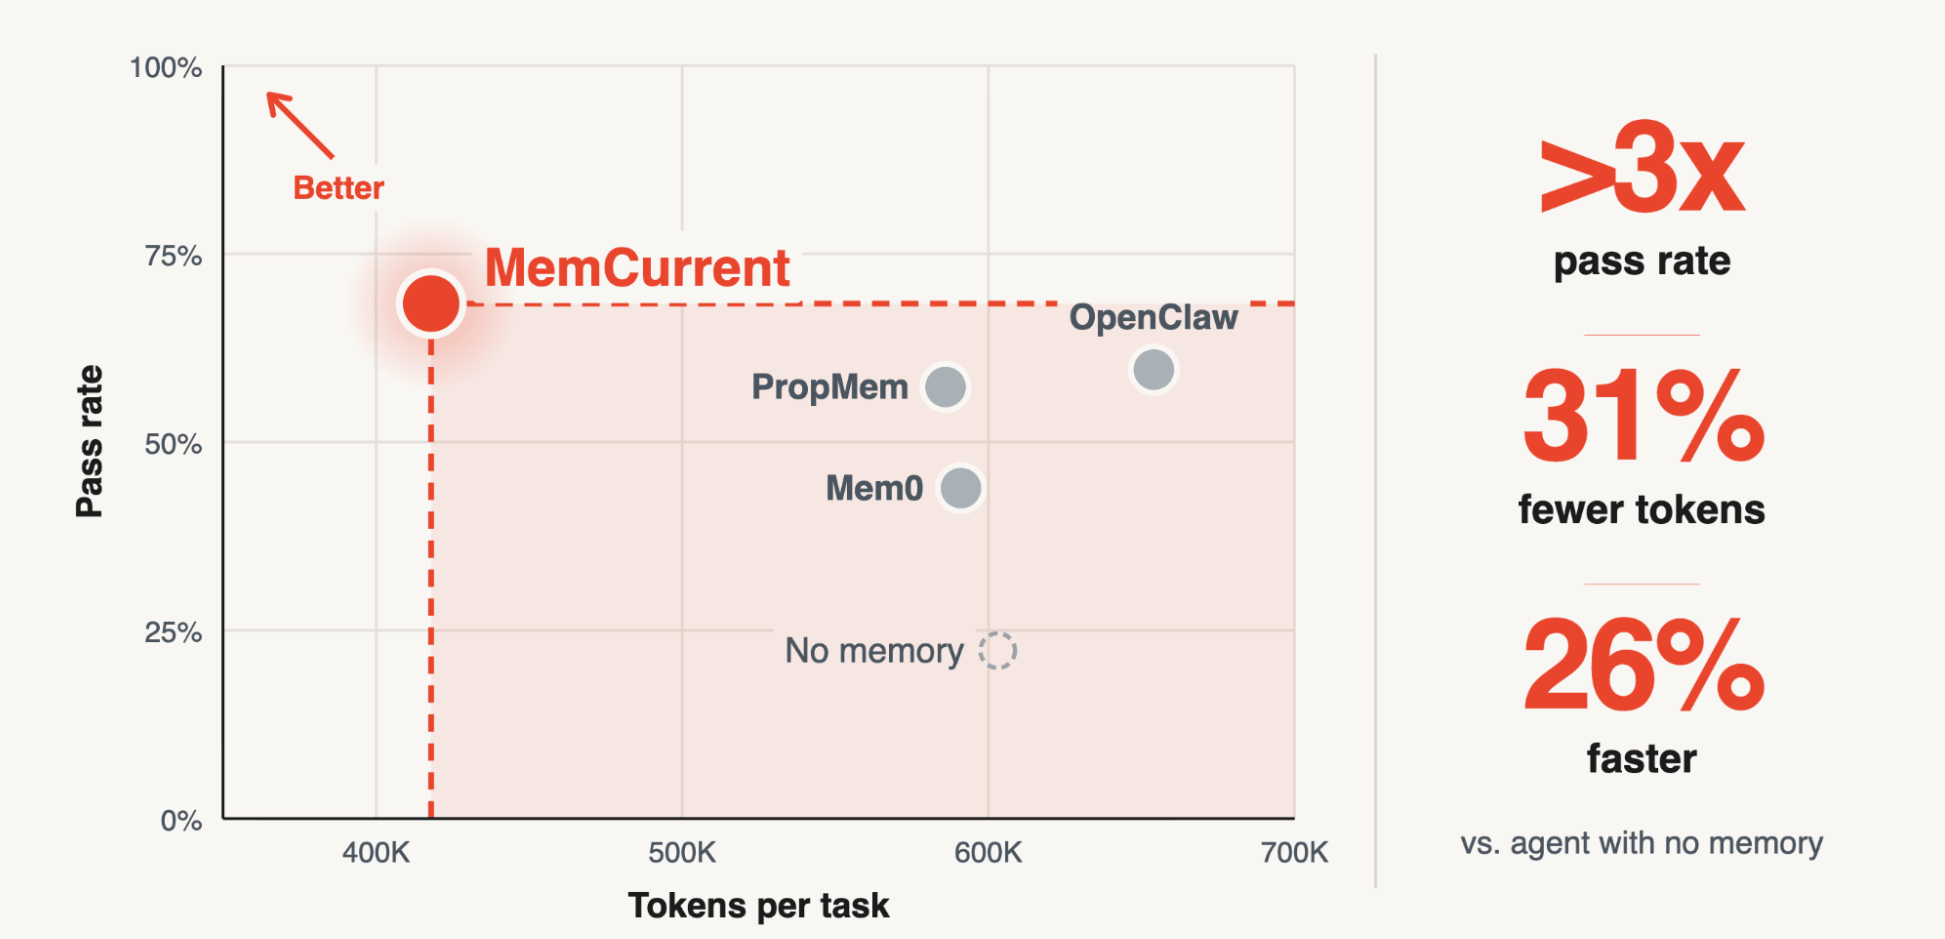
Figura 1. Tasa de éxito frente a tokens por tarea en nuestra prueba de referencia interna de memoria. MemCurrent se encuentra en la frontera de Pareto, superando a la memoria de Mem0, PropMem y OpenClaw en ambas dimensiones.
Cómo diseñamos la memoria
Existen tres formas de integrar la memoria en un agente. Como un complemento (plugin) (como en nuestro trabajo anterior sobre MemAlign y Memory Scaling), la memoria se lee y se escribe de forma automática en puntos fijos de una sesión. Como herramientas (tools), el agente decide qué y cuándo leer y escribir. Como un pipeline fuera de línea (offline), la memoria se actualiza en segundo plano según una programación o un activador, y se utiliza en sesiones posteriores. Cada opción presenta sus ventajas y desventajas:
La memoria como… | Activado por | Momento del cálculo | Ventajas | Desventajas |
Plugin | Automático | En línea |
|
|
Tool | Agente | En línea |
|
|
| Pipeline | Programación o activador | Fuera de línea |
|
|
Tabla 1. Tres patrones de acceso a la memoria: complemento (plugin), herramienta (tool) o pipeline fuera de línea (offline).
MemCurrent utiliza los tres enfoques, cada uno donde mejor se adapta.
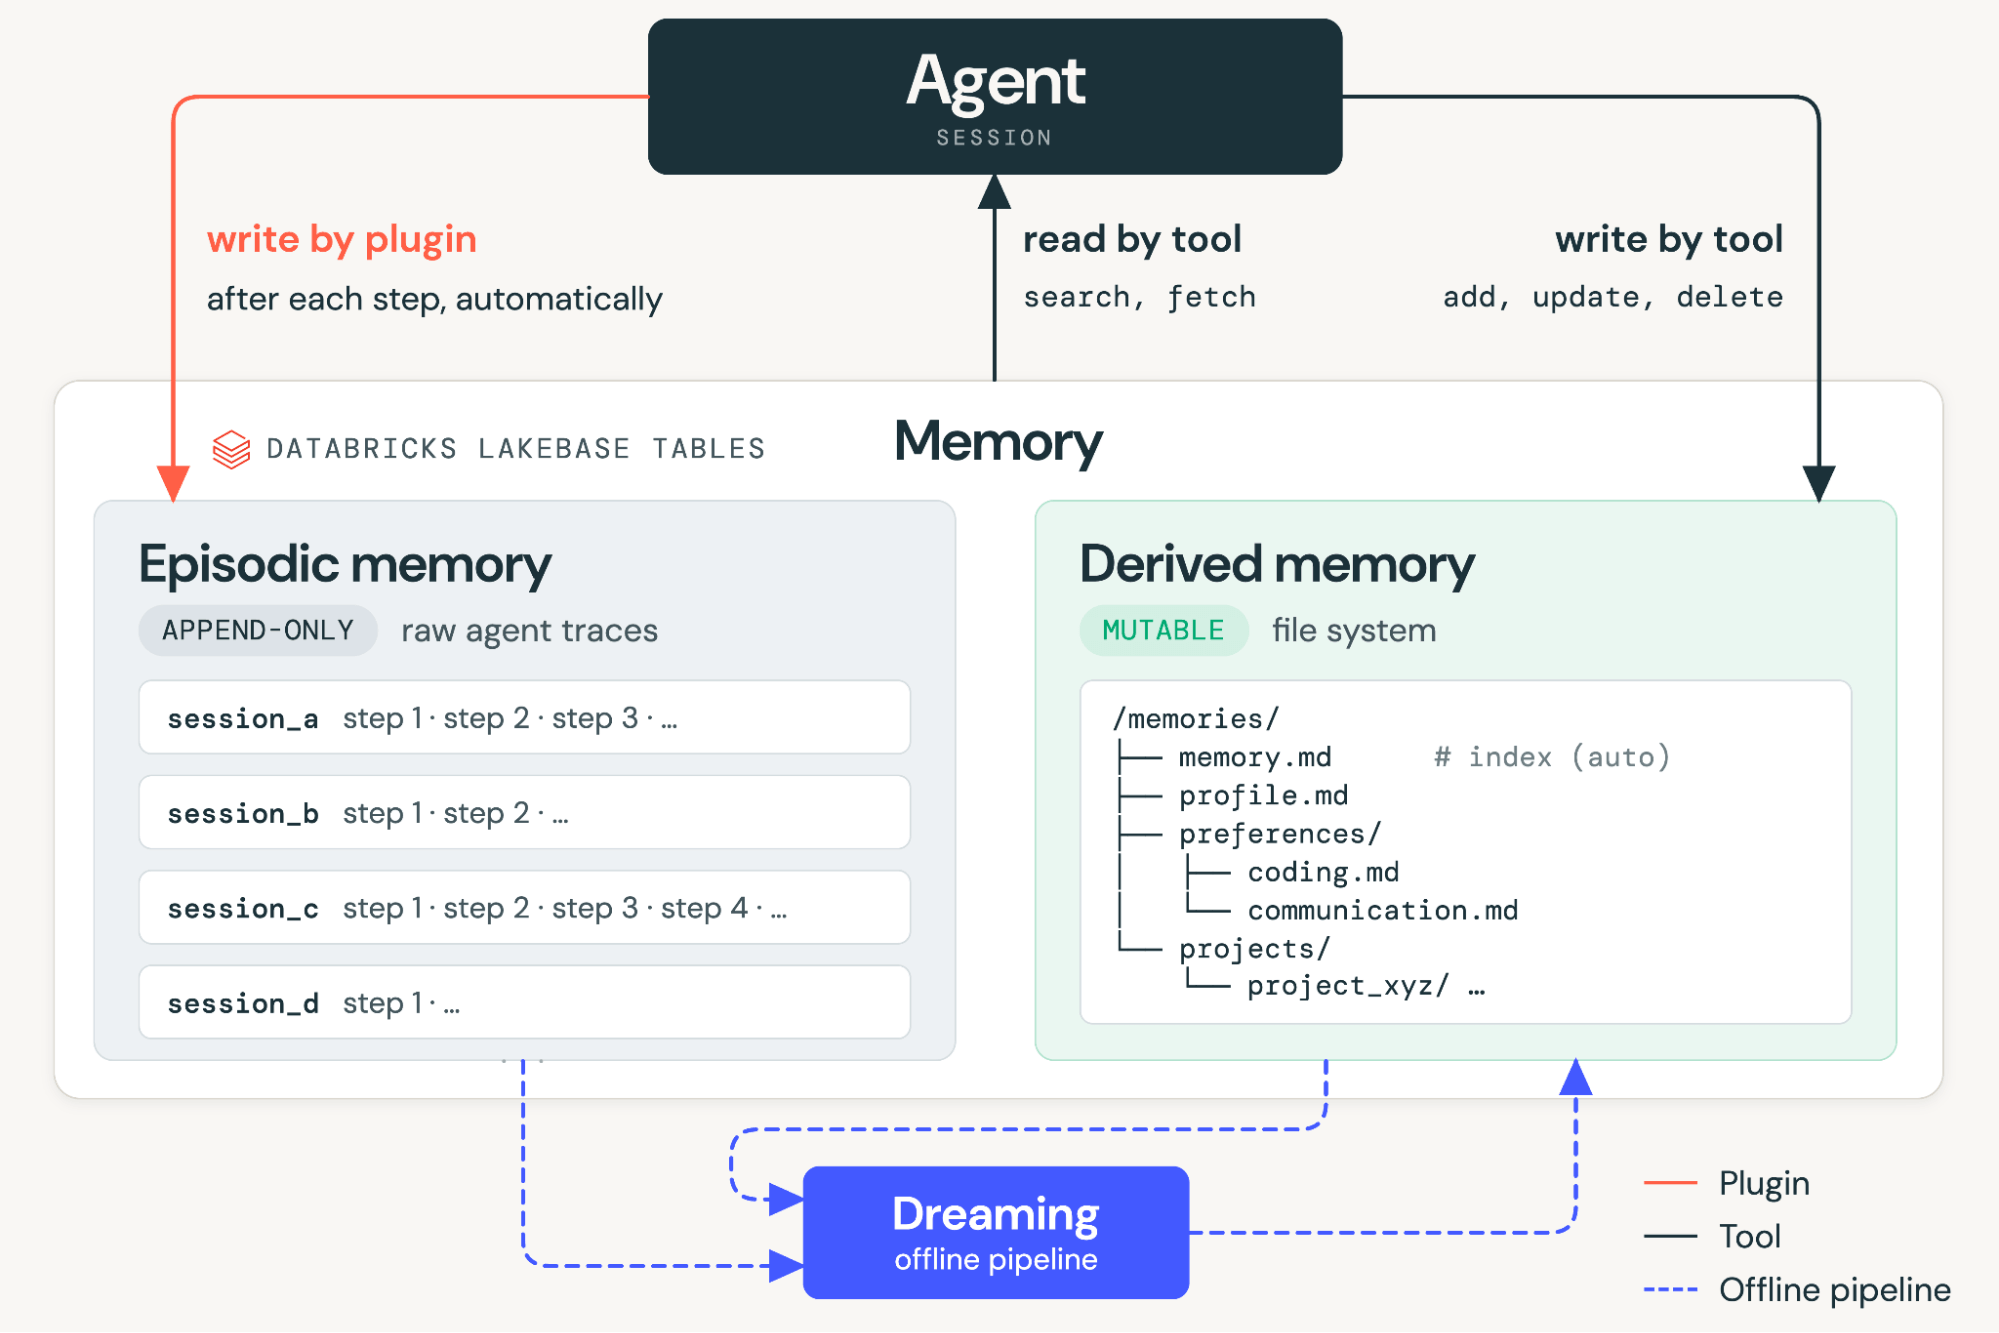
Figura 2. Visión general de MemCurrent.
MemCurrent cuenta con dos tipos de memoria: memoria episódica, que almacena trazas de sesión sin procesar; y memoria derivada, que contiene los aprendizajes sintetizados de estas trazas, almacenados como archivos en una base de conocimientos estructurada. Un índice memory.md generado automáticamente se sitúa en la parte superior, describiendo la estructura de archivos y el contenido de cada uno.
Tanto la memoria episódica como la derivada residen en una base de datos apta para producción que puede escalarse a muchos usuarios y ofrecer respuestas de baja latencia. La memoria episódica solo permite agregar información (append-only), donde un complemento registra cada paso a medida que se ejecuta la sesión. La memoria derivada es una tabla mutable que simula un sistema de archivos jerárquico, donde la escritura ocurre de dos formas. Las herramientas del agente (add_memory, update_memory, delete_memory) gestionan solicitudes explícitas como "Nunca escribas scripts en el directorio /tmp". Un pipeline de soñado fuera de línea captura el resto, sintetizando los aprendizajes implícitos de cada nueva sesión en los archivos correspondientes. Además, limpia todo el almacenamiento, dividiendo archivos demasiado grandes, fusionando duplicados y resolviendo conflictos.
La lectura funciona por capas. Al inicio de la sesión, un complemento inyecta el índice de memoria para que el agente sepa lo que conoce antes de empezar. Durante la sesión, el agente dispone de dos herramientas que funcionan en ambos tipos de memoria: search_memory devuelve las mejores coincidencias para una consulta (un paso en una traza pasada o una línea en un archivo de memoria) y fetch_memory devuelve la entrada completa según su identificador (ID de sesión o ruta de archivo).
Cómo evaluamos la memoria
Pruebas de referencia
Comenzamos con tres pruebas de referencia de código abierto muy populares: LoCoMo, LongMemEval y ConvoMem. Las tres evalúan si un agente puede recordar hechos mencionados anteriormente en conversaciones sintéticas abiertas.
Además, creamos una prueba de referencia interna de memoria a partir de conversaciones reales de Genie, en las que los usuarios realizan todo tipo de preguntas sobre sus datos. Como se muestra en la Figura 3, partimos de más de 12 000 sesiones, extrajimos 3000 candidatas con señales valiosas para la memoria y redactamos una pregunta de seguimiento con rúbricas de evaluación. Las demás sesiones del mismo usuario sirven como relleno para el caso de prueba. Luego, un evaluador de confrontación (adversarial judge) comprobó cada caso de prueba con respecto a 7 criterios, como si el conocimiento está realmente presente, si es específico del usuario, si es necesario para responder, si es natural y si es verificable. Tras una revisión manual final, la prueba de referencia cuenta con un total de 114 casos de prueba, con 29 usuarios y 2233 sesiones de historial.
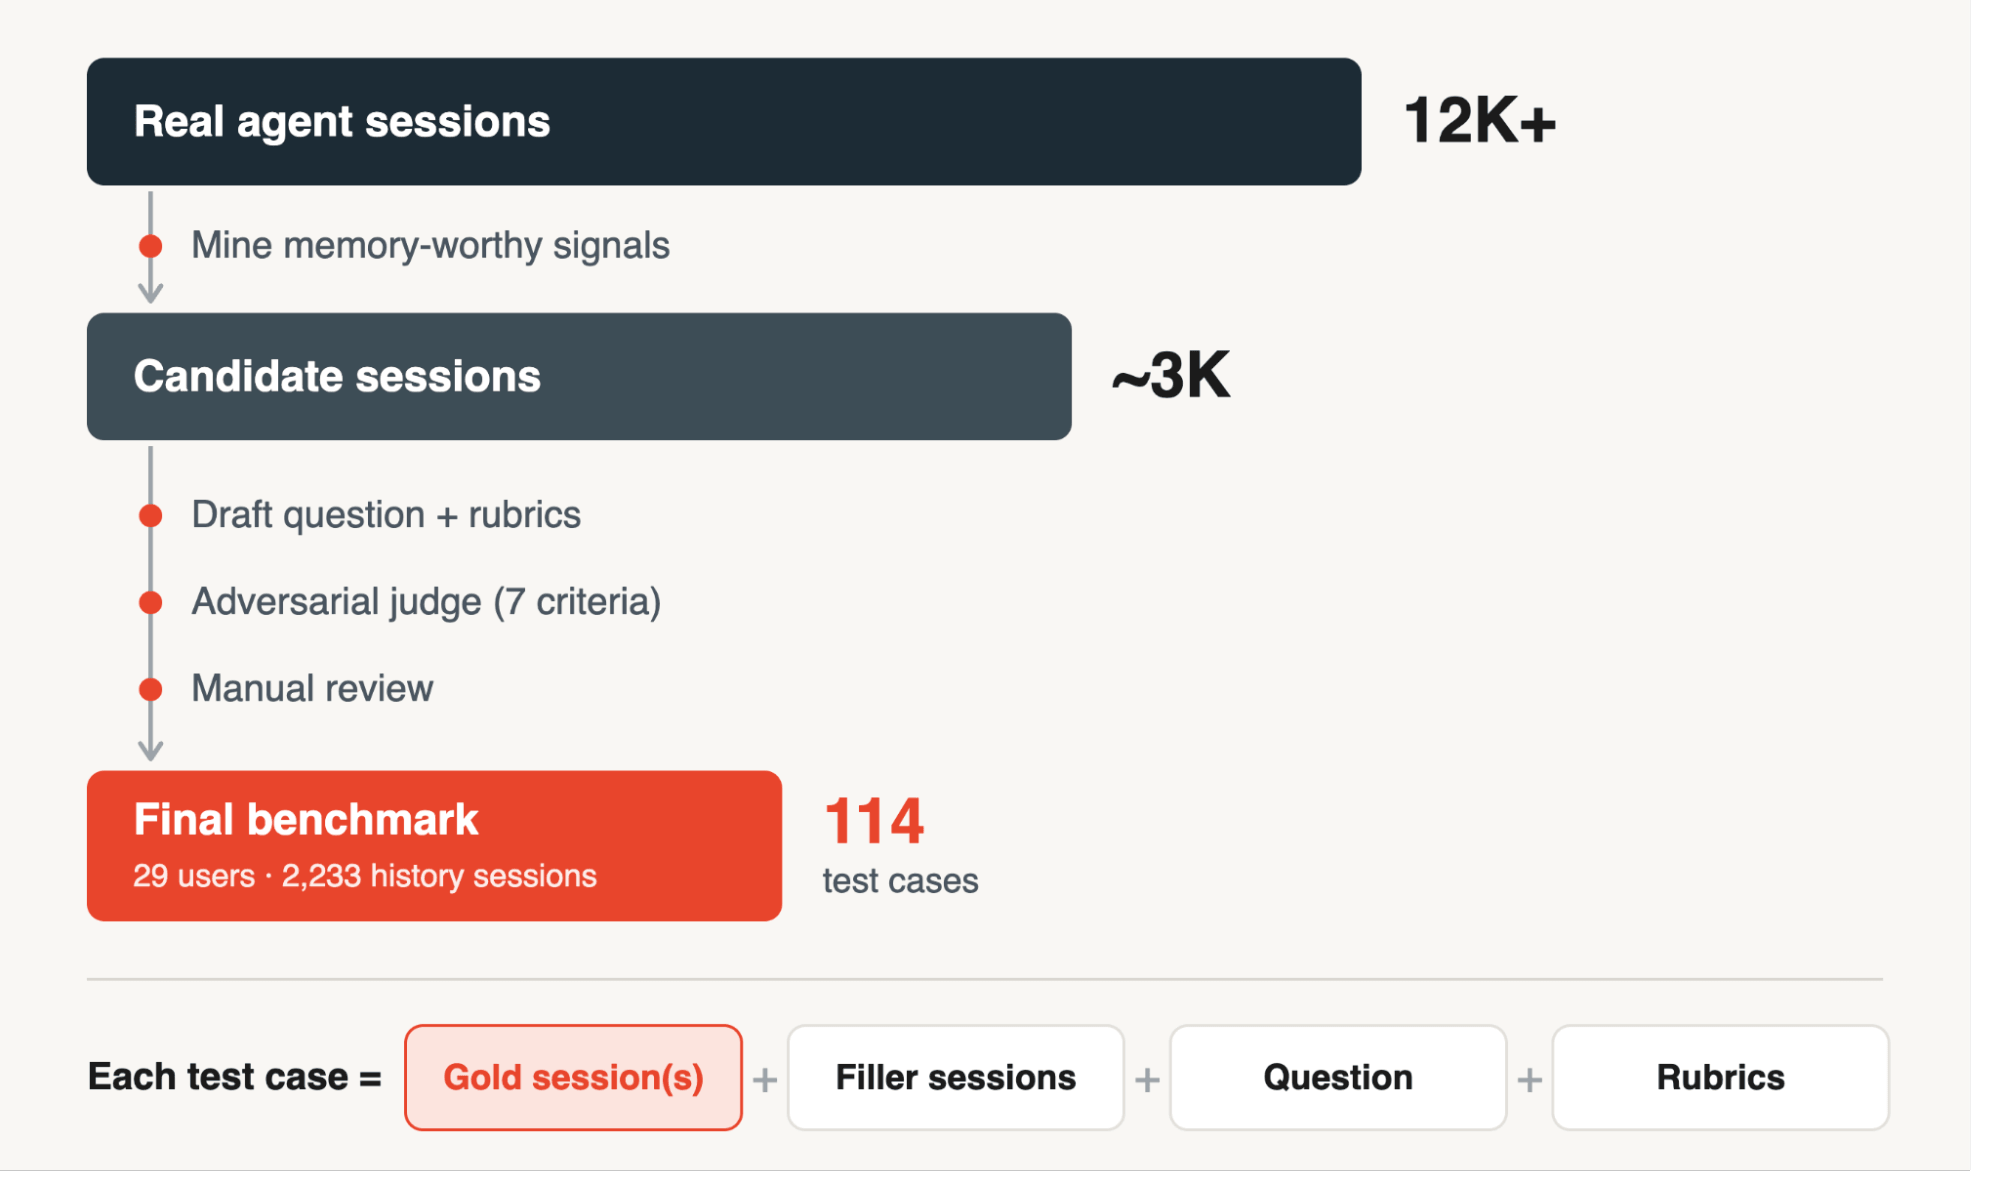
Figura 3. Cómo creamos nuestra prueba de referencia interna de memoria.
A continuación, se muestra un ejemplo:
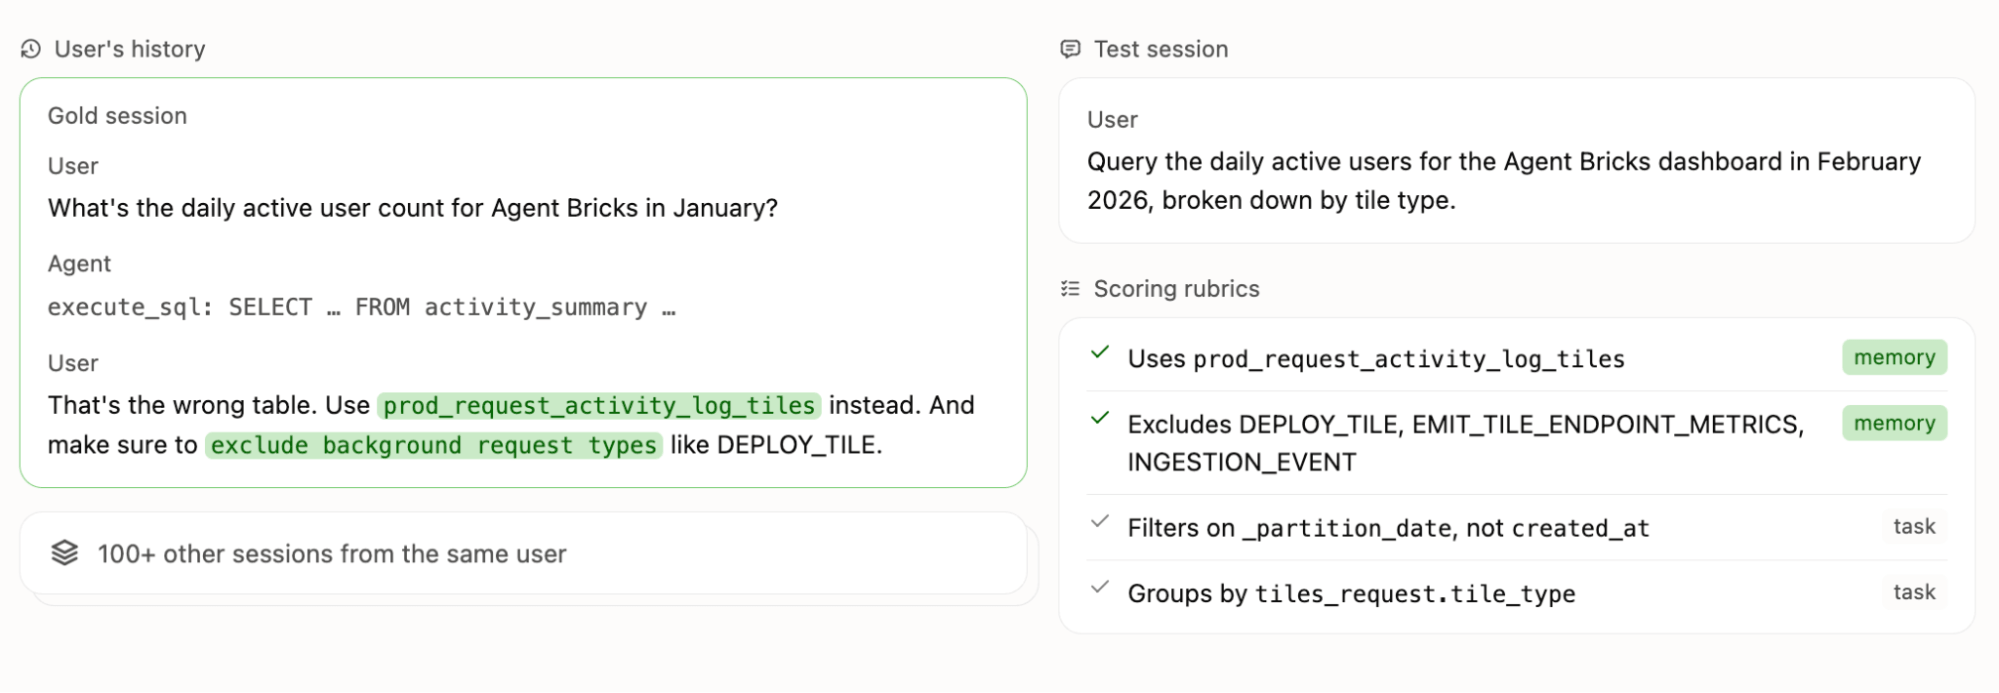
Figura 4. Ejemplo de caso de prueba de nuestra prueba de referencia interna de memoria. En una sesión anterior, el usuario corrige la elección de la tabla por parte del agente y le indica que excluya las solicitudes en segundo plano. Más adelante, el agente se enfrenta a una pregunta diferente pero relacionada, y tiene que encontrar esa sesión entre más de 100 y aplicar lo aprendido. Un evaluador LLM califica el resultado según una lista de rúbricas (algunas dependientes de la memoria y otras intrínsecas de la tarea).
Nuestra prueba de referencia se diferencia de las existentes en tres aspectos:
Dominio empresarial. Los benchmarks existentes son chats abiertos sobre las vidas de personas simuladas. El nuestro proviene del trabajo real en un entorno de datos, e involucra un rico conocimiento empresarial como la semántica de tablas, definiciones de métricas y flujos de trabajo.
La memoria alimenta acciones, no respuestas. Encontrar la cadena correcta en conversaciones pasadas no es suficiente; los agentes deben aplicar el conocimiento recuperado para completar tareas de varios pasos.
Diversidad. Los casos de prueba abarcan 5 tipos de memoria (perfil, preferencias, conocimiento del dominio, proyectos, flujos de trabajo) cruzados con 11 escenarios (instrucción directa, hechos cambiantes o desactualizados, agregación de varias sesiones, preguntas independientes de la memoria y más).
Resultados
Comparamos MemCurrent con tres backends de memoria de código abierto, Mem0, PropMem, OpenClaw memory, utilizando el mismo LLM subyacente.
Benchmarks de código abierto. Combinamos cada backend de memoria con un agente simple de preguntas y respuestas, creado con dos entornos para agentes (LangGraph y OpenAI Agents SDK). También ejecutamos dos líneas base: un límite inferior con sin memoria y un límite superior con contexto completo, donde cada sesión pasada se incluye en el contexto del agente. En los tres benchmarks, MemCurrent obtiene la puntuación más alta entre todos los backends de memoria y se mantiene en la frontera de Pareto de costo-precisión. En promedio, MemCurrent (88.1%) funciona a la par del contexto completo (87.8%) con ~12 veces menos tokens de entrada por pregunta (8.4K frente a 103K). En los dos benchmarks con los historiales más largos, incluso supera al contexto completo, donde volcar todo en el prompt termina confundiendo al agente.
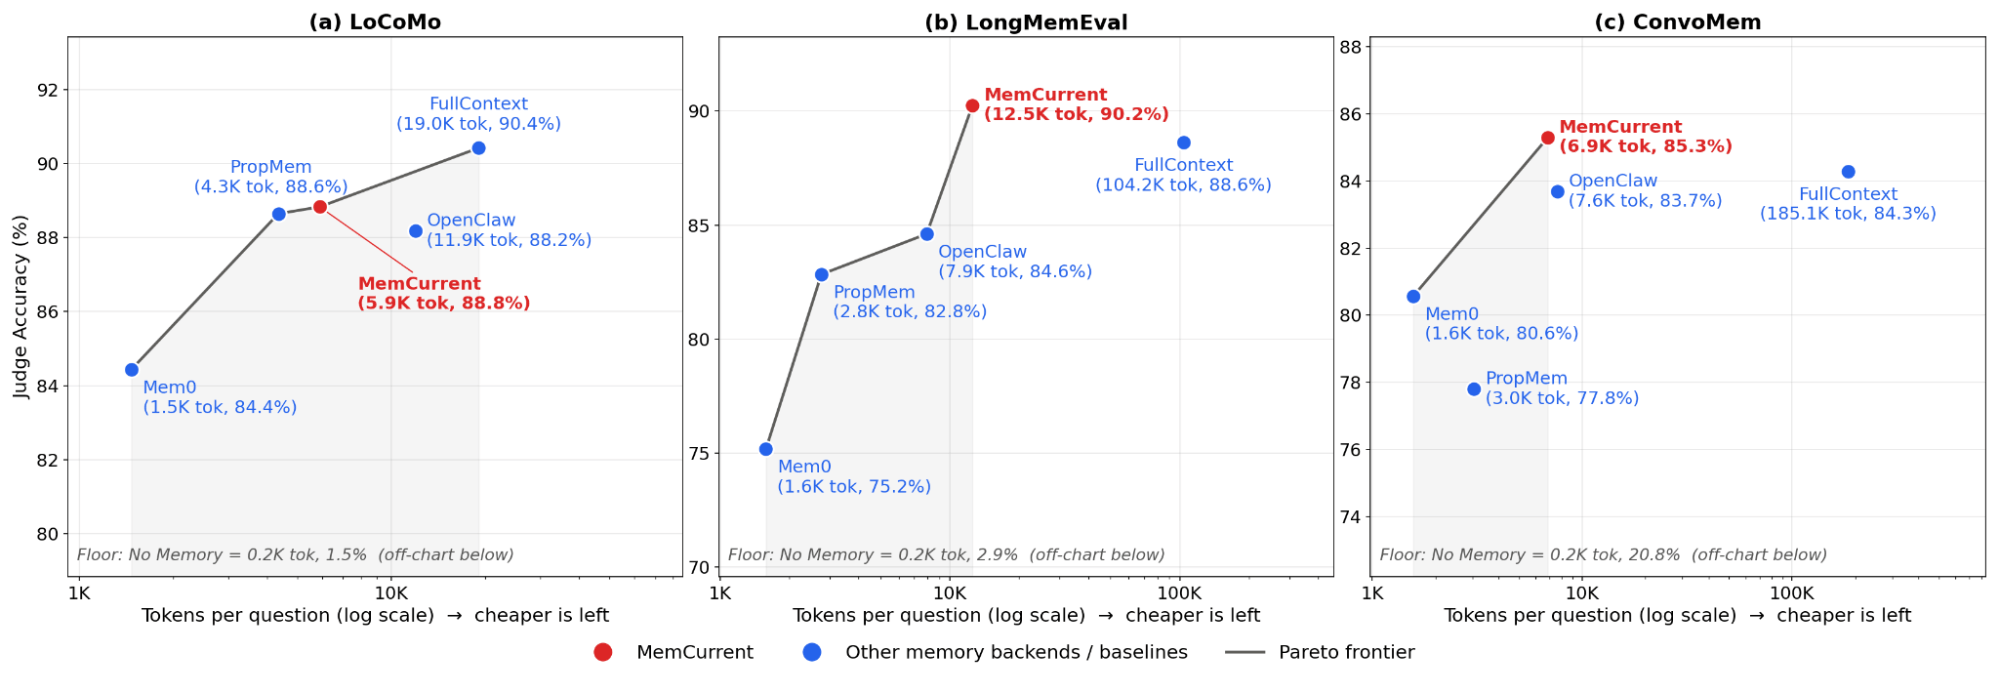
Figura 5. Compensación entre costo y precisión1 de los backends de memoria en (a) LoCoMo (19–32 sesiones/muestra), (b) LongMemEval (división s) (38–62 sesiones/muestra) y (c) ConvoMem (subconjunto estratificado de 500 muestras, 100 sesiones/muestra). Usamos GPT 5.6 luna como el modelo de agente y de memoria. Todos los backends de memoria se ejecutan como un complemento, que busca automáticamente memorias relacionadas con la pregunta y las inyecta en el contexto del agente al inicio de la sesión.2 La precisión es la media en los entornos de LangGraph y OpenAI Agents SDK y 3 repeticiones. El costo es la media de tokens de entrada por pregunta (escala logarítmica).
Benchmark interno de memoria. En nuestro benchmark, la brecha se amplía. Aquí, cada backend de memoria se ejecuta dentro de nuestro Genie interno, el mismo agente del que provinieron las sesiones del benchmark. Los historiales son demasiado largos para caber en el contexto, por lo que nuestro límite superior es la inyección de oro: inyectar solo las memorias ideales en el contexto del agente. Entre todos los backends de memoria, MemCurrent tiene la tasa de éxito más alta (68.4%) y la menor latencia (252 s) y uso de tokens (418K), cerrando más del 80% de la brecha entre sin memoria (22.3%) e inyección de oro (78.6%). Cabe destacar que, aunque Mem0 también estaba en la frontera en benchmarks anteriores, aquí se queda atrás con un 43.9% con mayor latencia y costo. En comparación con sin memoria, MemCurrent triplica la tasa de éxito del agente (22.3% → 68.4%) al tiempo que lo hace 1.35 veces más rápido y 1.44 veces más económico.
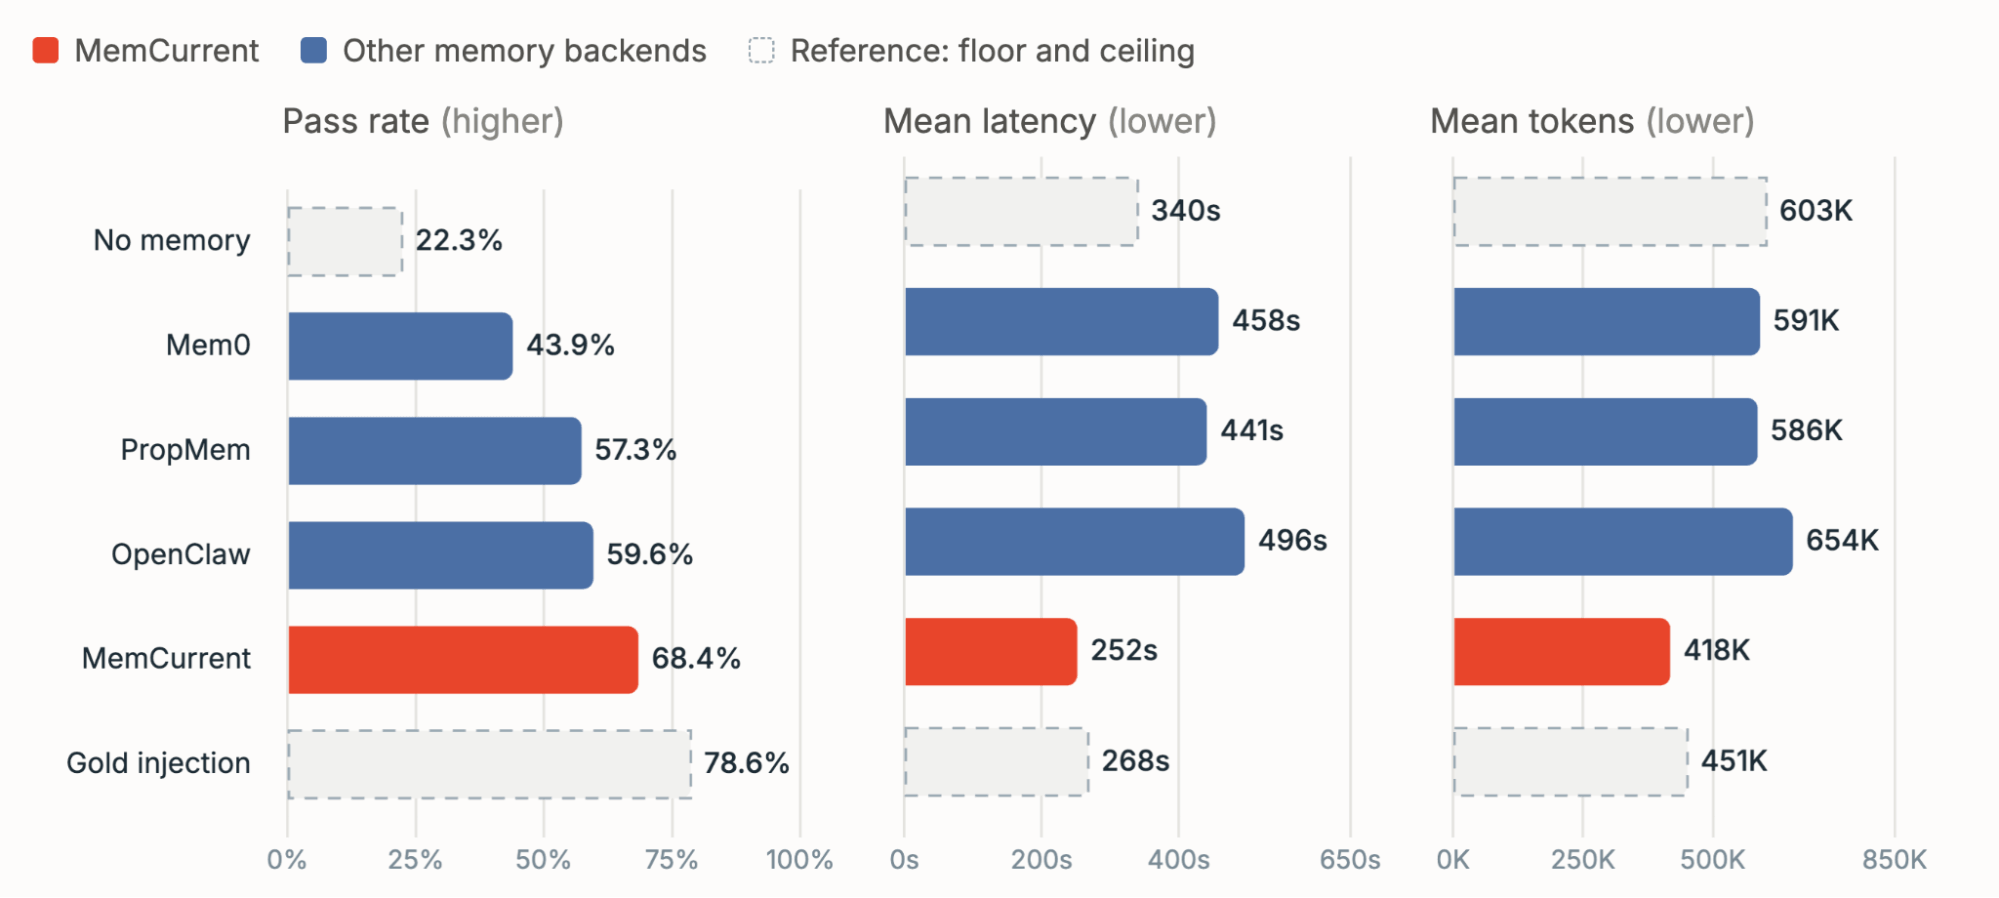
Figura 6. Tasa de éxito, latencia media y uso medio de tokens por tarea en nuestro benchmark interno de memoria a lo largo de 3 repeticiones. Usamos Claude Opus 4.6 como modelo de agente y GPT 5.6 sol como modelo de memoria. Todos los backends de memoria se proporcionan como herramientas de agente y un complemento de inicio de sesión.
MemCurrent en acción
Además de los números del benchmark, examinemos dos ejemplos de cómo MemCurrent ayuda en la práctica, provenientes de sesiones internas de Genie.
Ejemplo 1: La memoria detiene un error ocasional de alucinación. En la Figura 7, un usuario le pidió al agente los 20 usuarios principales del Producto X durante los últimos dos meses. El agente escribió una consulta SQL correcta, pero nunca leyó los resultados reales de la ejecución guardados en un archivo. Aun así, generó con confianza una tabla con contenido alucinado. Tras los comentarios del usuario, el agente guardó la lección en la memoria. La próxima vez, una vez ejecutada la consulta, el agente leyó primero los resultados y devolvió la tabla correcta. Una corrección de memoria evitó que un desliz puntual se convirtiera en un hábito.
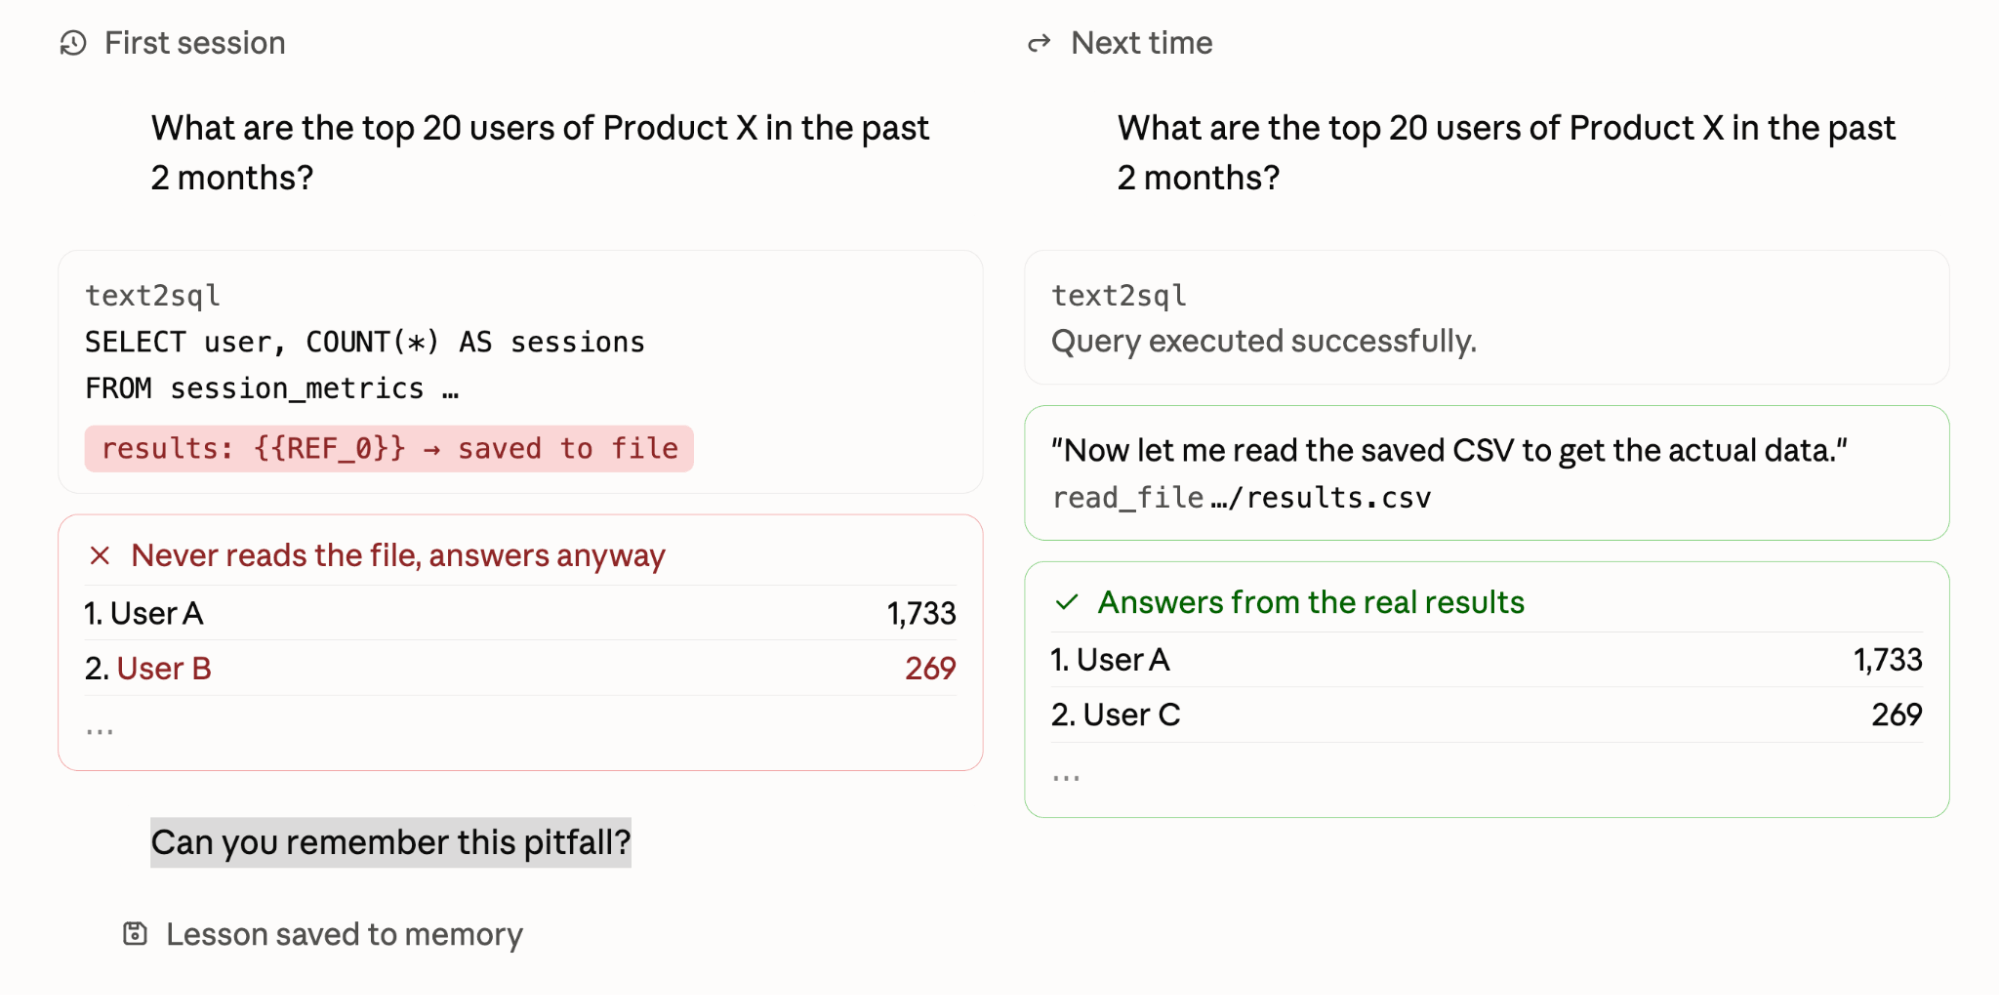
Figura 7. Un ejemplo anonimizado de cómo la memoria ayuda al agente a evitar un error de alucinación repetido.
Ejemplo 2: La memoria ahorra cómputo en tareas relacionadas. En la Figura 8, un usuario solicitó "los 5 clientes principales de SDP". El agente tuvo que averiguar todo desde cero: qué significa "SDP", qué tablas contenían datos de uso y cómo unirlas y filtrarlas. Requirió 11 llamadas a herramientas, 8 subagentes y casi seis minutos. El agente guardó estos pasos como un archivo de flujo de trabajo en la memoria, el cual pudo reutilizar en tareas relacionadas. Más tarde, el usuario hizo una pregunta diferente: cuántos clientes de SDP tuvieron más de 5 mil ejecuciones de pipeline el mes pasado. Utilizando el flujo de trabajo, el agente respondió con 2 llamadas a herramientas y 1 subagente en 41 segundos. La pregunta era nueva, pero el camino hacia la respuesta no lo era, y la memoria le permitió al agente omitir exploraciones innecesarias.
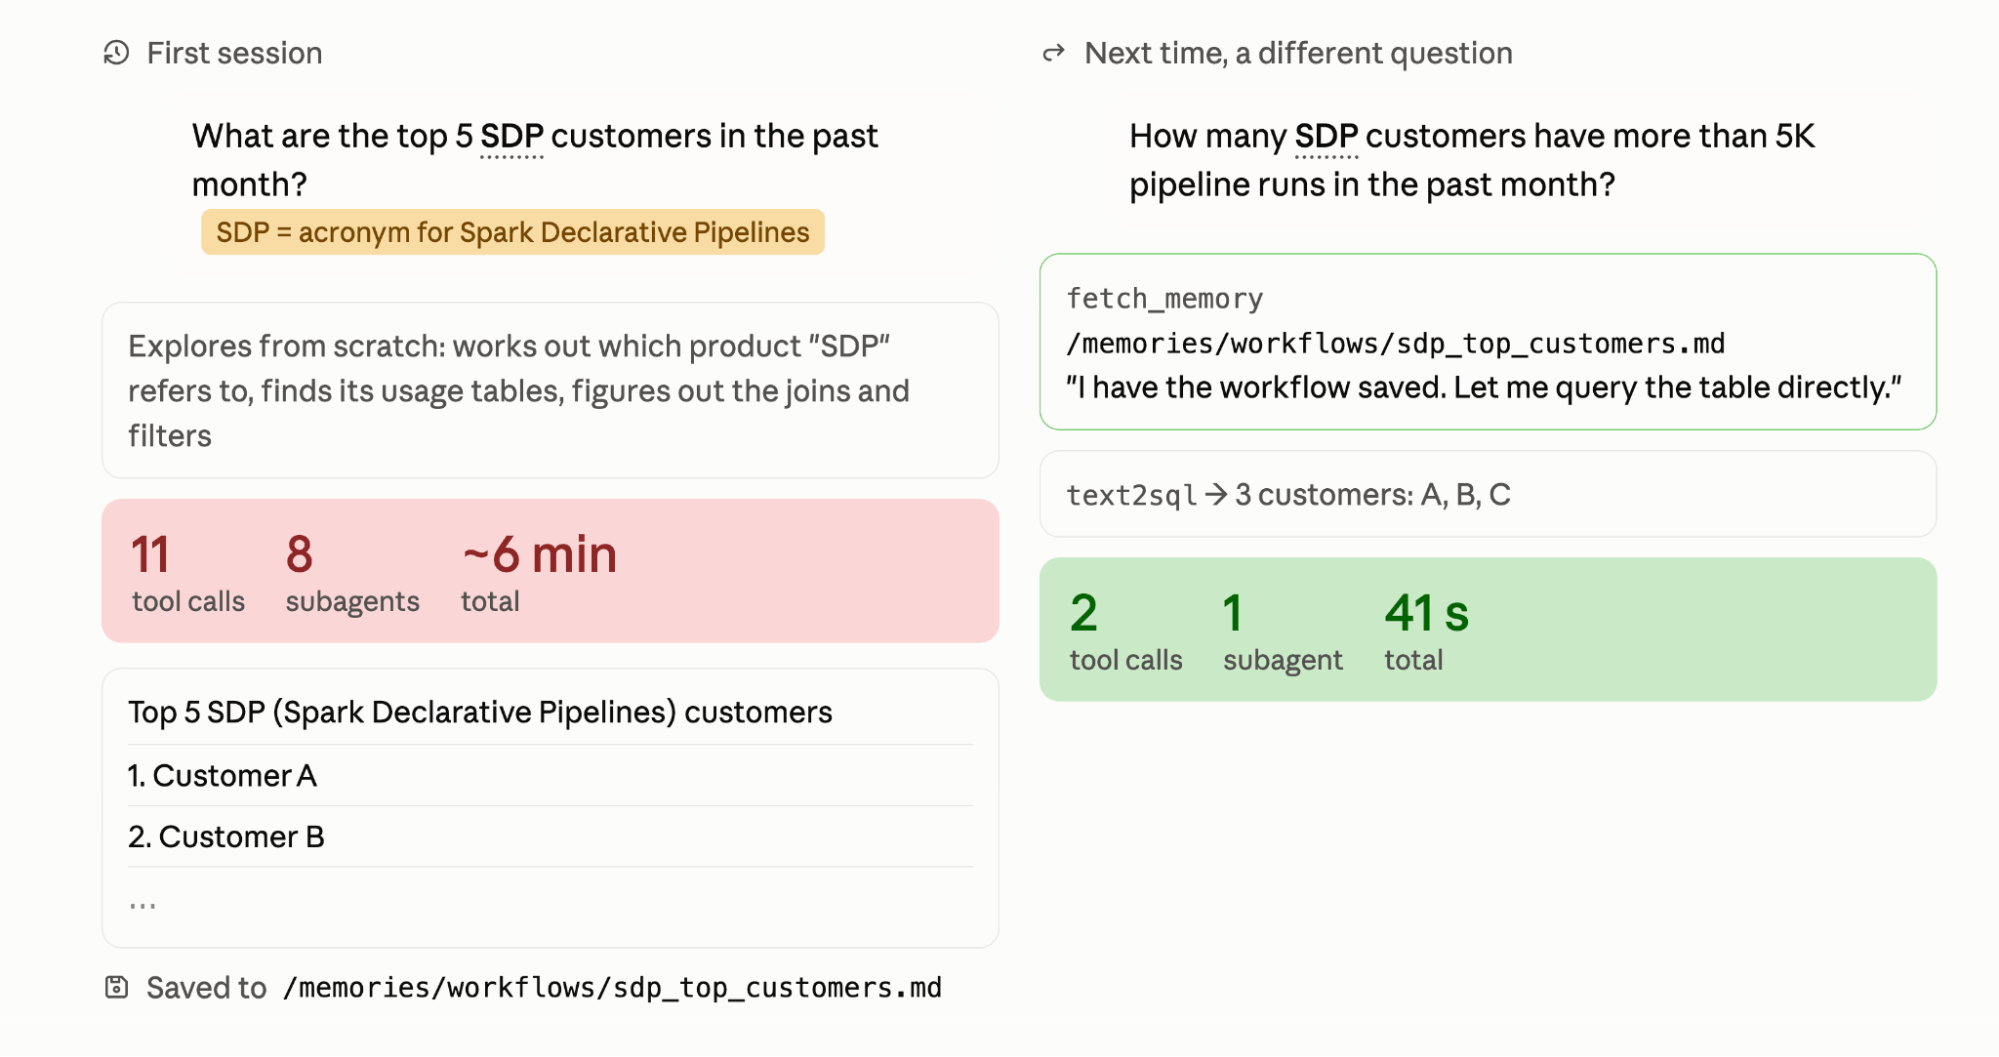
Figura 8. Un ejemplo anonimizado de cómo la memoria convierte una tarea de 6 minutos en una de 41 segundos.
Qué hace que MemCurrent funcione
Para comprender qué explica el rendimiento superior de MemCurrent, realizamos ablaciones en nuestro benchmark interno de memoria para dos opciones de diseño: tipos de memoria y estrategia de extracción.
¿Necesitamos ambos tipos de memoria? La memoria episódica por sí sola ayuda moderadamente: 35.8%, en comparación con el 22.3% sin memoria. El historial sin procesar es útil, pero el agente solo lo busca en aproximadamente un tercio de los casos de prueba, aunque aprueba el 60% de ellos cuando lo hace. La memoria derivada evita este problema, ya que el índice de memoria inyectado al inicio de la sesión le da al agente información sobre lo que está disponible en la memoria y cuándo buscar, lo que eleva la tasa de éxito al 66.1%. Agregar memoria episódica por encima ofrece el mejor resultado, con un 68.4%. La ganancia es pequeña, pero sugiere que las trazas sin procesar pueden recuperar detalles que la destilación omite.
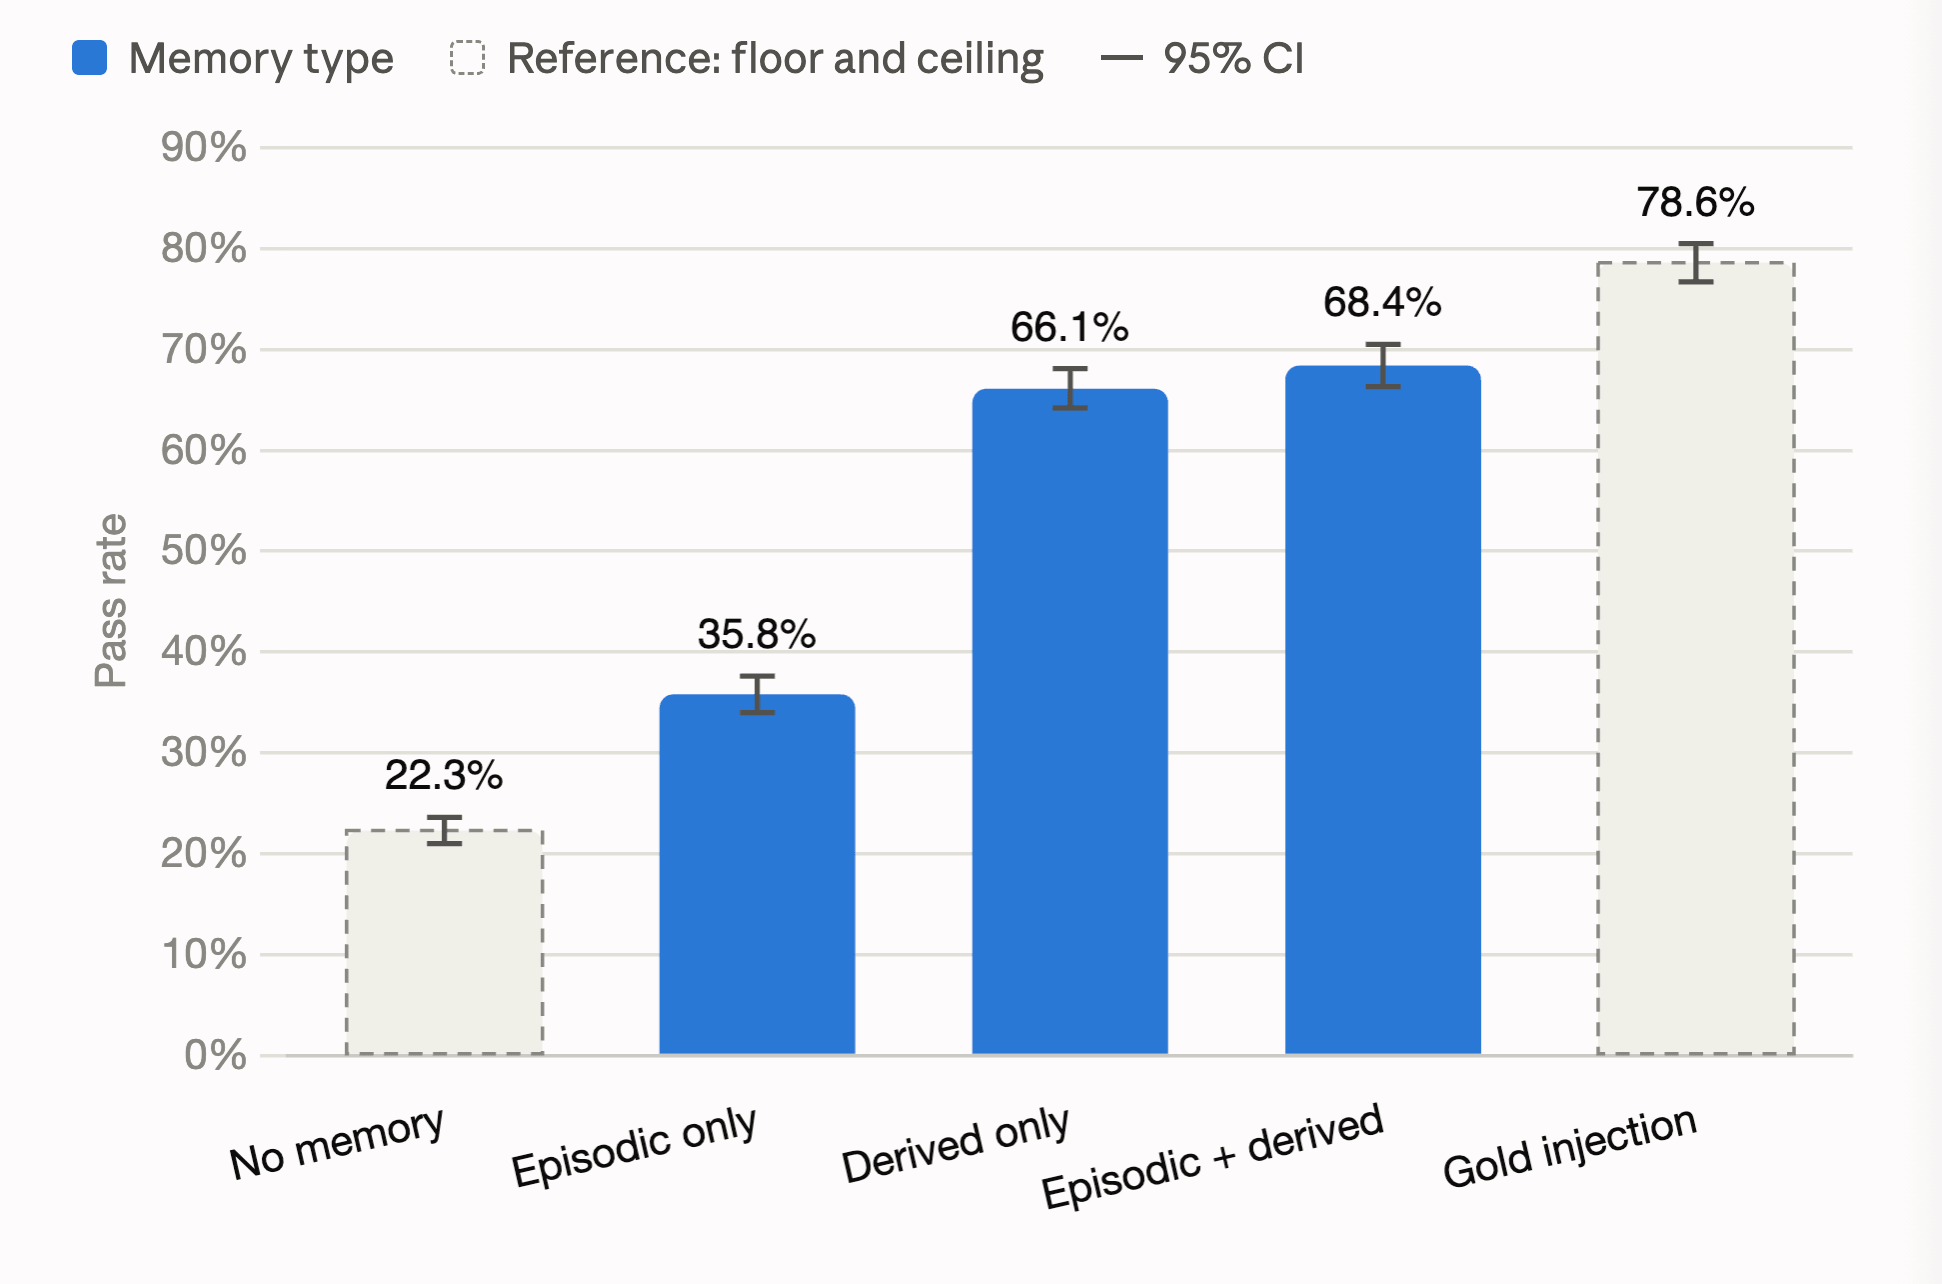
Figura 9. Tasa de éxito por tipo de memoria.
¿Cuál es una buena estrategia de extracción de memoria? Como se muestra en la Figura 2, dos canales extraen la memoria derivada: herramientas en línea y soñación fuera de línea. Cuando se aíslan, la soñación fuera de línea (63.5%) supera a las herramientas en línea (53.9%) por casi 10 puntos. Su combinación produce la tasa de éxito más alta, con un 66.1%. Esto respalda la división de funciones: la soñación se encarga de la extracción y consolidación en segundo plano, mientras que las herramientas en línea hacen que las solicitudes explícitas surtan efecto de inmediato.
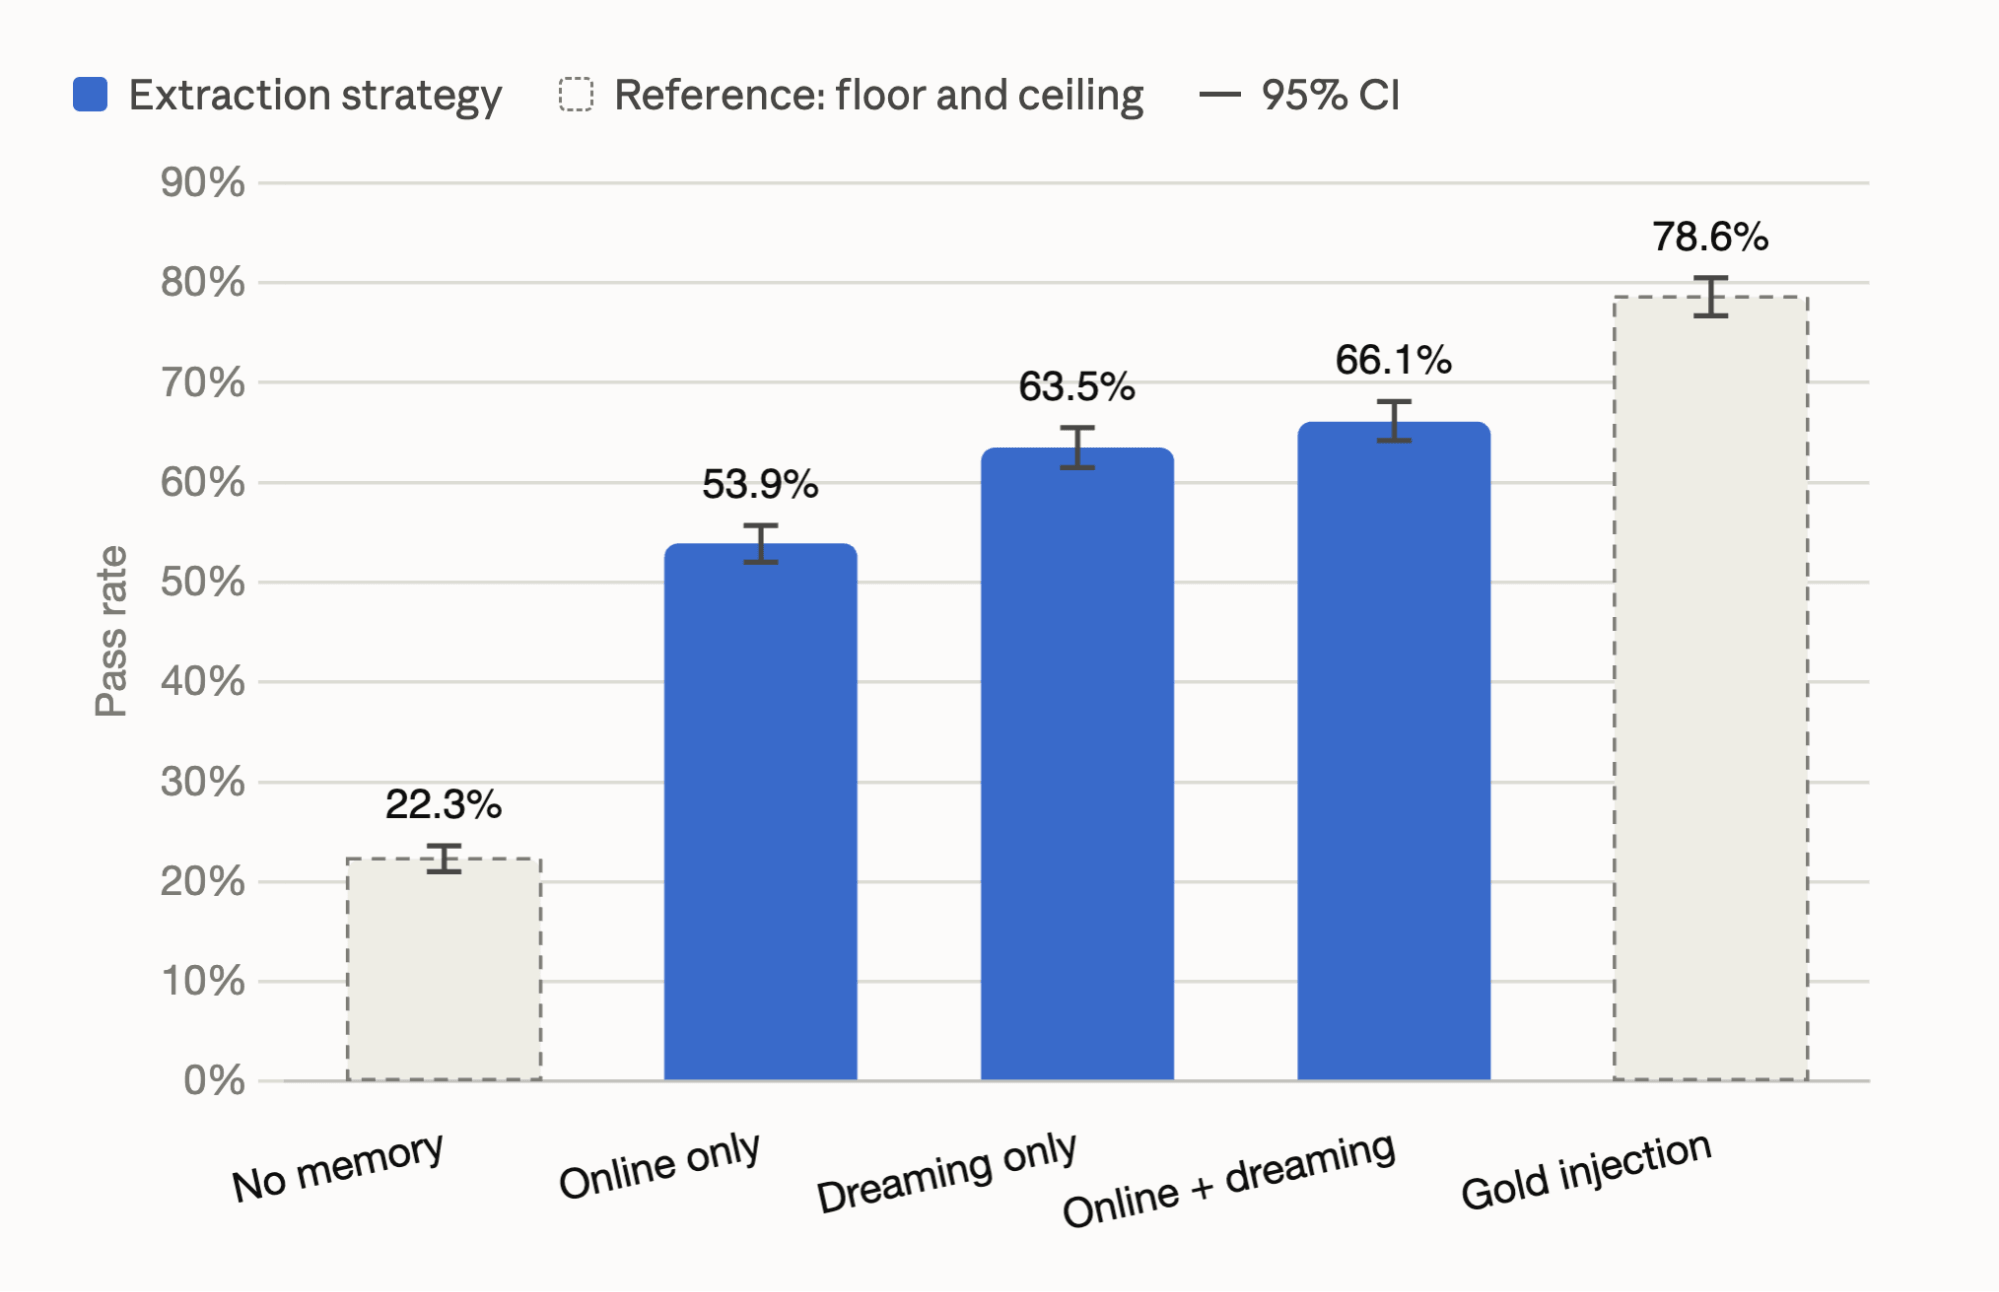
Figura 10. Tasa de éxito por estrategia de extracción.
Conclusión
La memoria es la forma en que un agente deja de empezar desde cero. En esta publicación, presentamos MemCurrent, una arquitectura de memoria para agentes de producción que combina memoria episódica y memoria derivada, con tres patrones de acceso: complementos para registrar y cargar el contexto automáticamente, herramientas que el agente llama a petición y un pipeline de soñación fuera de línea que consolida la memoria en segundo plano.
En todos los benchmarks que ejecutamos, MemCurrent mejora la calidad y la eficiencia al mismo tiempo, el compromiso que nos propusimos romper. En los benchmarks de código abierto, iguala el rendimiento del contexto completo con aproximadamente 12 veces menos tokens de entrada. En nuestro benchmark interno de memoria, creado a partir del trabajo con datos reales, triplica la tasa de éxito del agente con respecto a no usar memoria, al tiempo que lo hace más rápido y económico.
Las ablaciones señalan de dónde proviene el valor. La memoria derivada realiza la mayor parte del trabajo y la memoria episódica agrega un impulso menor al recuperar detalles que la destilación omite. La combinación de herramientas en línea con soñación fuera de línea genera la mejor estrategia de extracción: las solicitudes explícitas surten efecto de inmediato, mientras que la soñación destila los aprendizajes implícitos y consolida el almacenamiento en segundo plano.
Más allá de los números, la memoria proporciona una base de conocimiento que no está vinculada a un solo agente o LLM. Puede trasladarse con los usuarios a nuevos agentes o LLMs y podría sembrar conocimientos compartidos en toda su organización, una dirección que exploraremos a continuación.
Primeros pasos
Estamos incorporando estos hallazgos para impulsar mejoras en los productos de Databricks:
Para desarrolladores de agentes. Agent Bricks es la plataforma de desarrollo de Databricks para crear agentes personalizados. MemCurrent está integrado en la oferta de Memory de Agent Bricks, impulsado por Lakebase. La oferta incluye:
- Almacén de sesiones para memoria episódica
- Almacén de memoria para memoria derivada
- Un pipeline de dreaming automático
- Rastreo y evaluación de la calidad del agente, incluido el impacto de la memoria
- Una CLI que le ayuda a comenzar rápidamente con un agente de muestra end-to-end con todo lo anterior en <10 minutos
Comience a crear su agente personalizado hoy mismo.
Para usuarios de Databricks Genie. Genie es una interfaz donde los usuarios de Databricks pueden conversar con sus datos en lenguaje natural. MemCurrent ya está en funcionamiento en segundo plano, lo que ayuda a mejorar la calidad de las respuestas mientras reduce la latencia y el costo de respuesta.
Comience con Genie.
Autores: Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen
Agradecemos a Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu y a los participantes de nuestro estudio interno de usuarios por sus comentarios y apoyo a lo largo de este proyecto.
1 La latencia es similar (4-7 s/pregunta) en todos los backends de memoria, ya que la mayoría de las preguntas se pueden responder en un solo salto.
2 Encontramos que la memoria basada en plugins es suficiente para los benchmarks existentes. Los resultados obtenidos al agregar herramientas están estrictamente dominados y, por lo tanto, se omiten.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.