Uso de Structured Streaming con Delta Sharing en Unity Catalog
por Will Girten, Josh Seidel, Lin Zhou y Sachin Thakur
Nos complace anunciar que el soporte para usar Structured Streaming con Delta Sharing ya está disponible para el público general (GA) en Azure, AWS y GCP. Esta nueva función permitirá a los destinatarios de datos en la plataforma Databricks Lakehouse transmitir los cambios desde una tabla Delta compartida a través de Unity Catalog.
Los proveedores de datos pueden aprovechar esta capacidad para escalar fácilmente su servicio de datos como servicio (data-as-a-service), reducir el costo operativo de compartir grandes conjuntos de datos, mejorar la calidad de los datos con validaciones e inspecciones de calidad inmediatas a medida que llegan nuevos datos, y mejorar el servicio al cliente con la entrega de datos en tiempo real. Del mismo modo, los destinatarios de datos pueden transmitir los últimos cambios de un conjunto de datos compartido, lo que reduce el costo de infraestructura de procesar grandes volúmenes de datos en lote y sienta las bases para aplicaciones de datos en tiempo real de última generación. Los destinatarios de datos en diversos sectores de la industria pueden beneficiarse de esta nueva función; por ejemplo:
- Comercio minorista: Los analistas de datos pueden transmitir las últimas cifras de ventas de una línea de moda de temporada y presentar información empresarial en un informe de BI.
- Ciencias de la salud y de la vida: Los profesionales de la salud pueden transmitir lecturas de electrocardiogramas a un modelo de ML para identificar anomalías.
- Manufactura: Los equipos de gestión de edificios pueden transmitir lecturas de termostatos inteligentes e identificar a qué hora del día o de la noche los sistemas de calefacción y refrigeración deben encenderse o apagarse de manera eficiente.
A menudo, los equipos de datos dependen de pipelines de datos ejecutados por lotes para procesar sus datos debido a que la ejecución por lotes es tanto robusta como fácil de implementar. Sin embargo, hoy en día, las organizaciones necesitan los últimos datos entrantes para tomar decisiones comerciales en tiempo real. Structured Streaming no solo simplifica el procesamiento en tiempo real, sino que también simplifica el procesamiento por lotes al reducir la cantidad de trabajos por lotes a solo unos pocos trabajos de streaming. Convertir pipelines de datos por lotes a streaming es muy sencillo, ya que Structured Streaming admite la misma API de DataFrame.
En este artículo del blog, exploraremos cómo las empresas pueden aprovechar Structured Streaming con Delta Sharing para maximizar el valor comercial de sus datos casi en tiempo real utilizando un ejemplo del sector financiero. También examinaremos cómo otras funciones complementarias, como Databricks Workflows, se pueden utilizar junto con Delta Sharing y Unity Catalog para crear una aplicación de datos en tiempo real.
Soporte para Structured Streaming
Tal vez la función de Delta Sharing más anticipada durante los últimos meses haya sido el soporte añadido para utilizar una tabla Delta compartida como fuente en Structured Streaming. Esta nueva función permitirá a los destinatarios de datos crear aplicaciones en tiempo real utilizando tablas Delta compartidas a través de Unity Catalog en la plataforma Databricks Lakehouse.
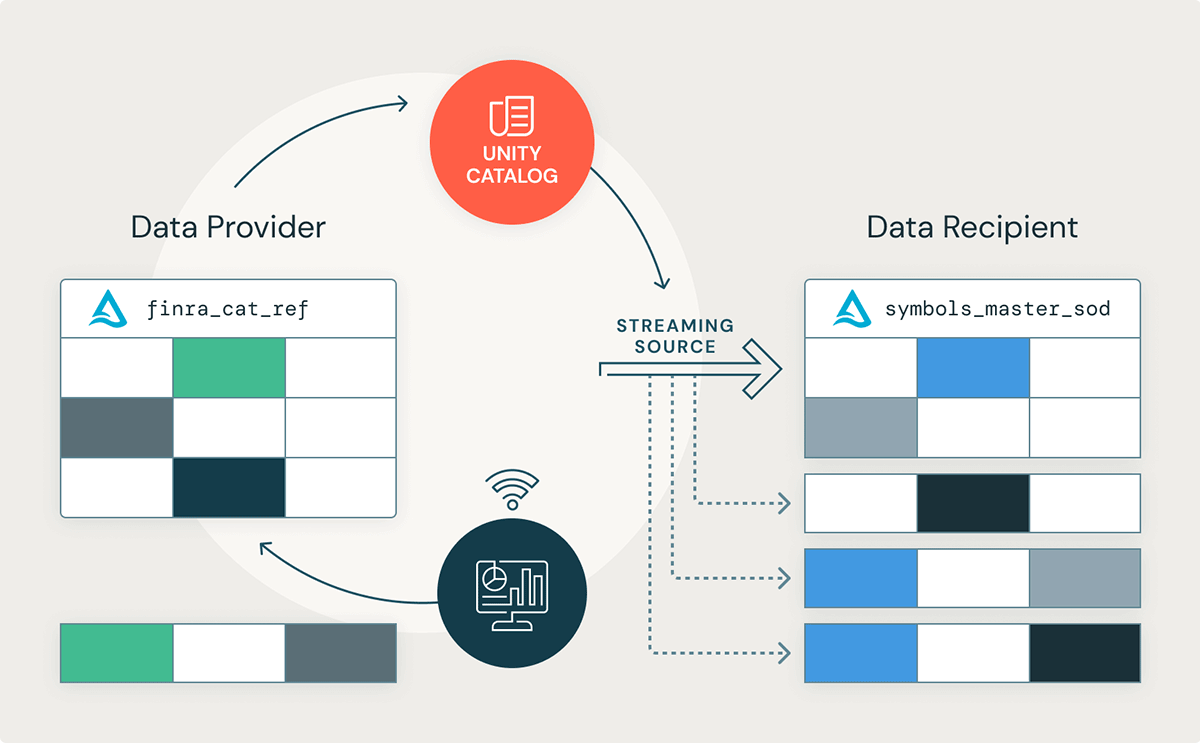

Cómo usar Delta Sharing con Structured Streaming
Echemos un vistazo más de cerca a cómo un destinatario de datos podría transmitir información de símbolos bursátiles cotizados en bolsa para obtener información sobre operaciones comerciales en tiempo real. Este artículo utilizará el conjunto de datos FINRA CAT Reportable Equity Securities Symbol Master, que enumera todas las acciones y valores de renta variable que se negocian en el Sistema de Mercado Nacional (NMS) de EE. UU. Structured Streaming se puede usar para crear aplicaciones en tiempo real, pero también puede ser útil en escenarios donde los datos llegan con menos frecuencia. Para una demostración sencilla en un notebook, usaremos un conjunto de datos que se actualiza tres veces al día: una vez al comienzo de la fecha de transacción (SOD), una segunda vez durante el día para reflejar cualquier cambio intradía y una tercera vez al final de la fecha de transacción (EOD). No se publican actualizaciones los fines de semana ni en días festivos de EE. UU.
| Archivo publicado | Horario |
|---|---|
| CAT Reportable Equity Securities Symbol Master – SOD | 6:00 a.m. EST |
| CAT Reportable Options Securities Symbol Master – SOD | 6:00 a.m. EST |
| Member ID (IMID) List | 6:00 a.m. EST |
| Member ID (IMID) Conflicts List | 6:00 a.m. EST |
| CAT Reportable Equity Securities Symbol Master – Intraday | 10:30 a.m. EST y aproximadamente cada 2 horas hasta que se publique el archivo EOD |
| CAT Reportable Options Securities Symbol Master – Intraday | 10:30 a.m. EST y aproximadamente cada 2 horas hasta que se publique el archivo EOD |
| CAT Reportable Equity Securities Symbol Master – EOD | 8 p.m. EST |
| CAT Reportable Options Securities Symbol Master – EOD | 8 p.m. EST |
Tabla 1.1: Los datos de referencia de miembros y símbolos de FINRA CAT se publican a lo largo del día hábil. No se publican actualizaciones los fines de semana ni en días festivos de EE. UU.
Desde la perspectiva del proveedor de datos: ingesta de datos de CAT con Databricks Workflows
Uno de los mayores beneficios de la plataforma Databricks Lakehouse es que simplifica enormemente la transmisión continua de cambios a una tabla Delta. Primero comenzaremos definiendo una tarea sencilla de Python que descarga el archivo de símbolos de valores de renta variable FINRA CAT al comienzo de la fecha de transacción (SOD). Posteriormente, guardaremos el archivo publicado en un directorio temporal en el sistema de archivos de Databricks.
Código 1.1. - Una tarea sencilla de Python puede descargar el archivo de símbolos de renta variable de FINRA CAT al inicio del día de negociación.
Para demostrarlo, también definiremos una función que ingerirá el archivo sin procesar y actualizará continuamente una tabla bronze en nuestro Delta Lake cada vez que se publique un archivo actualizado.
Código 1.2 - Los datos de símbolos de renta variable FINRA CAT se ingieren en una tabla Delta al inicio de cada día de negociación.
Una vez iniciado, el Databricks Workflow comenzará a rellenar el conjunto de datos de símbolos de renta variable CAT cada vez que se publique el archivo al inicio del día de negociación.
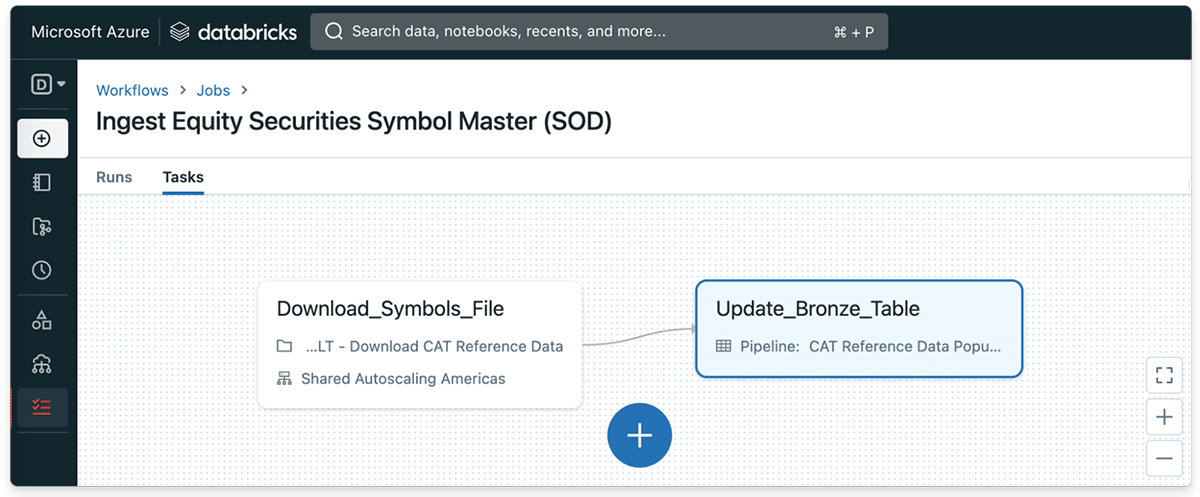

Desde la perspectiva del proveedor de datos: compartir una tabla Delta como fuente de streaming
Ahora que hemos creado una canalización de streaming para ingerir actualizaciones en el archivo de símbolos cada día de negociación, podemos aprovechar Delta Sharing para compartir la Delta Table con los receptores de datos. Crear un Delta Share en Databricks Lakehouse Platform se puede hacer con solo unos pocos clics o con una sola sentencia SQL si se prefiere la sintaxis SQL.
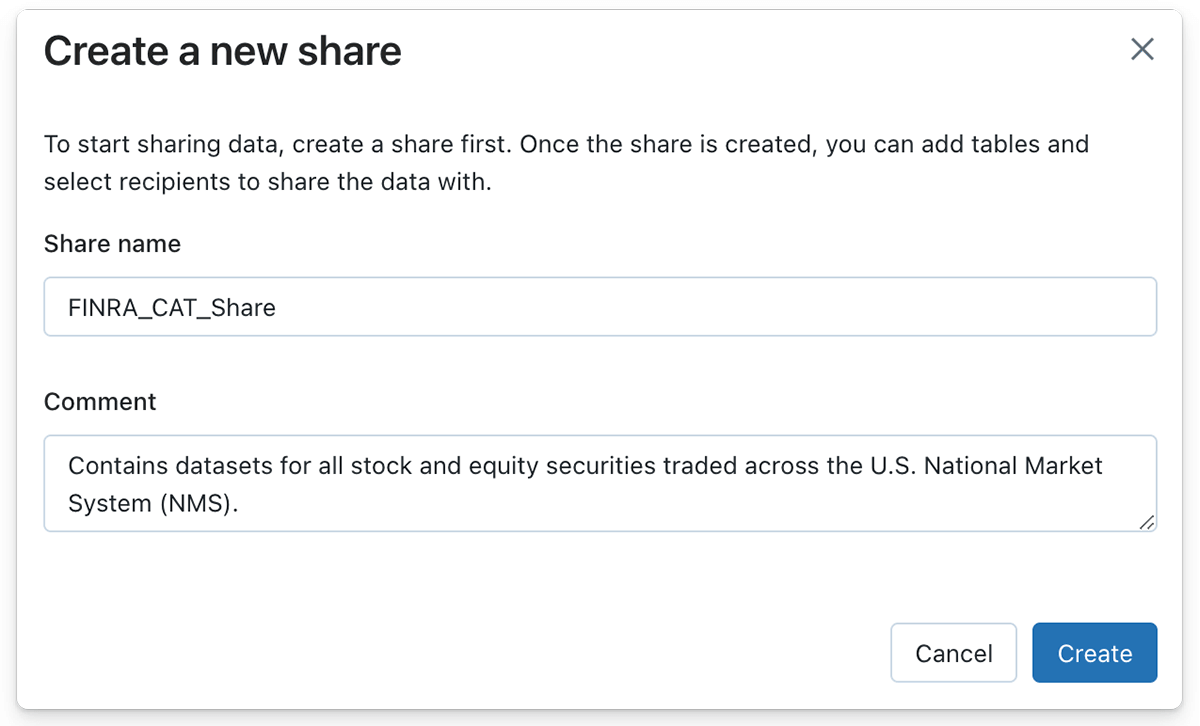

De manera similar, un proveedor de datos puede rellenar un Delta Share con una o más tablas haciendo clic en el botón 'Manage assets' y, a continuación, en el botón 'Edit tables'. En este caso, la Delta Table bronze que contiene los datos de símbolos de renta variable se añade al objeto Share.
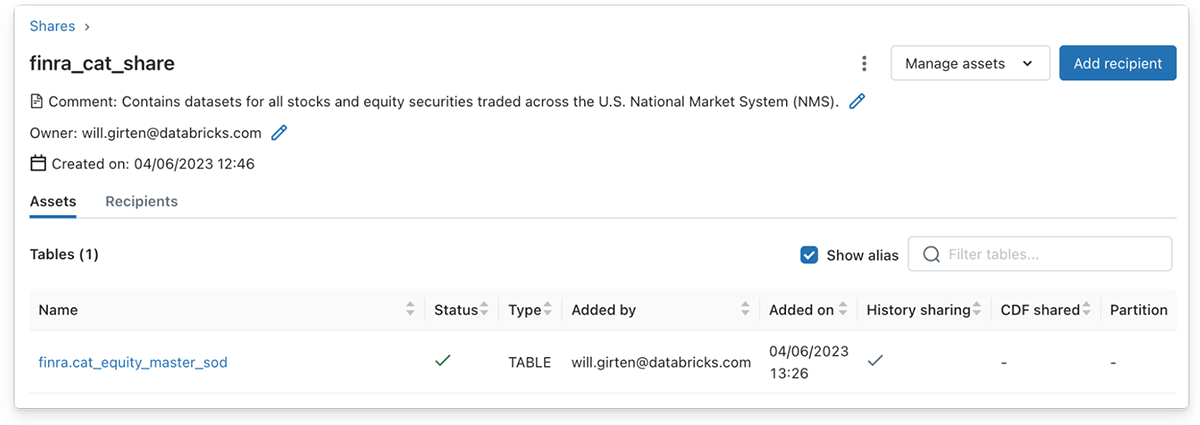

Tenga en cuenta que se debe compartir el historial completo de una tabla Delta para admitir lecturas mediante Structured Streaming. El uso compartido del historial está habilitado de forma predeterminada mediante la interfaz de usuario de Databricks para añadir una tabla Delta a un Share. Sin embargo, el uso compartido del historial se debe especificar explícitamente cuando se utiliza la sintaxis SQL.
Código 1.4 - El historial de una tabla Delta se debe compartir explícitamente para admitir lecturas de Structured Streaming cuando se utiliza la sintaxis SQL.
Desde la perspectiva del receptor de datos: streaming de una Delta Table compartida
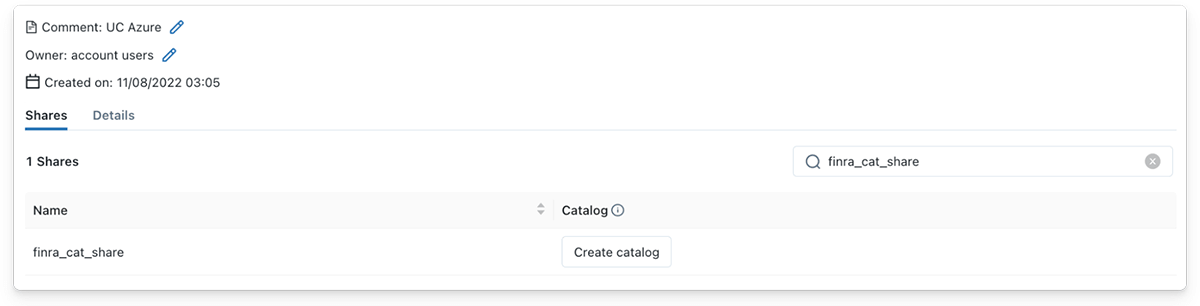

Como receptor de datos, ¡el streaming desde una tabla Delta compartida es igual de sencillo! Después de que el Delta Share se haya compartido con un receptor de datos, el receptor verá inmediatamente que el Share aparece bajo los detalles del proveedor en Unity Catalog. Posteriormente, el receptor de datos puede crear un nuevo catálogo en Unity Catalog haciendo clic en el botón 'Create catalog', proporcionando un nombre significativo y añadiendo un comentario opcional para describir el contenido del Share.
Los receptores de datos pueden realizar streaming desde una Delta Table compartida a través de Unity Catalog utilizando Databricks Runtime 12.1 o superior. En este ejemplo, hemos utilizado un clúster de Databricks con Databricks 12.2 LTS Runtime instalado. Un receptor de datos puede leer la tabla Delta compartida como un Spark Structured Stream utilizando la fuente de datos deltaSharing y proporcionando el nombre de la tabla compartida.
Código 1.4 - Un receptor de datos puede realizar streaming desde una Delta Table compartida utilizando la fuente de datos deltaSharing.
Como ejemplo adicional, combinemos el conjunto de datos maestro de símbolos de renta variable compartidos de CAT con un conjunto de datos de historial de precios de acciones, local en el Unity Catalog del receptor de datos. Comenzaremos definiendo una función de utilidad para obtener los historiales semanales de precios de acciones de un símbolo de cotización determinado.
A continuación, uniremos el flujo de datos maestro de acciones con los historiales de precios de acciones locales de 3 grandes empresas tecnológicas: Apple Inc. (AAPL), Microsoft Corporation (MSFT) e Invidia Corporation (NVDA).
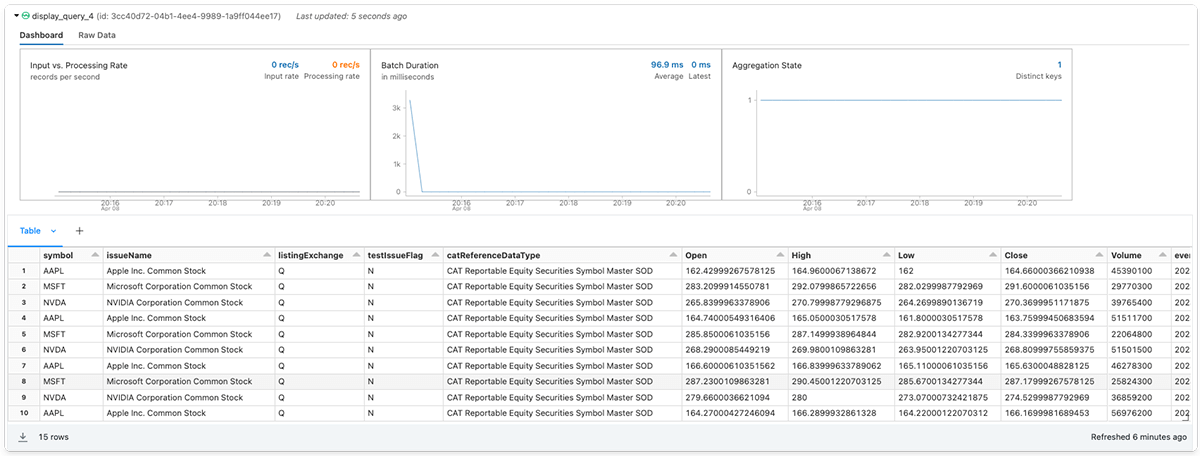
Finalmente, el receptor de datos puede añadir un sumidero de destino opcional e iniciar la consulta de streaming.

Introducción a Delta Sharing en Databricks
Espero que haya disfrutado de este ejemplo sobre cómo las organizaciones pueden aprovechar Delta Sharing para maximizar el valor comercial de sus datos casi en tiempo real.
¿Quiere comenzar con Delta Sharing pero no sabe por dónde empezar? Si ya es cliente de Databricks, siga la guía para comenzar a usar Delta Sharing (AWS | Azure | GCP). Lea la documentación para obtener más información sobre las opciones de configuración incluidas en la función. Si no es cliente de Databricks, regístrese para obtener una prueba gratuita con un espacio de trabajo Premium o Enterprise.
Créditos
Nos gustaría agradecer especialmente a todos los que contribuyeron a este lanzamiento, incluidos Abhijit Chakankar, Lin Zhou y Shixiong Zhu.
Recursos
- Notebooks complementarios:
- [eBook] Obtenga información sobre el uso compartido de datos y la colaboración con Databricks Lakehouse
- [eBook] Gran libro de gobernanza de IA
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.