El marco de canalización abierto para agentes y equipos de datos
Crea canalizaciones de forma segura para escala agéntica con calidad de datos, validación y gobe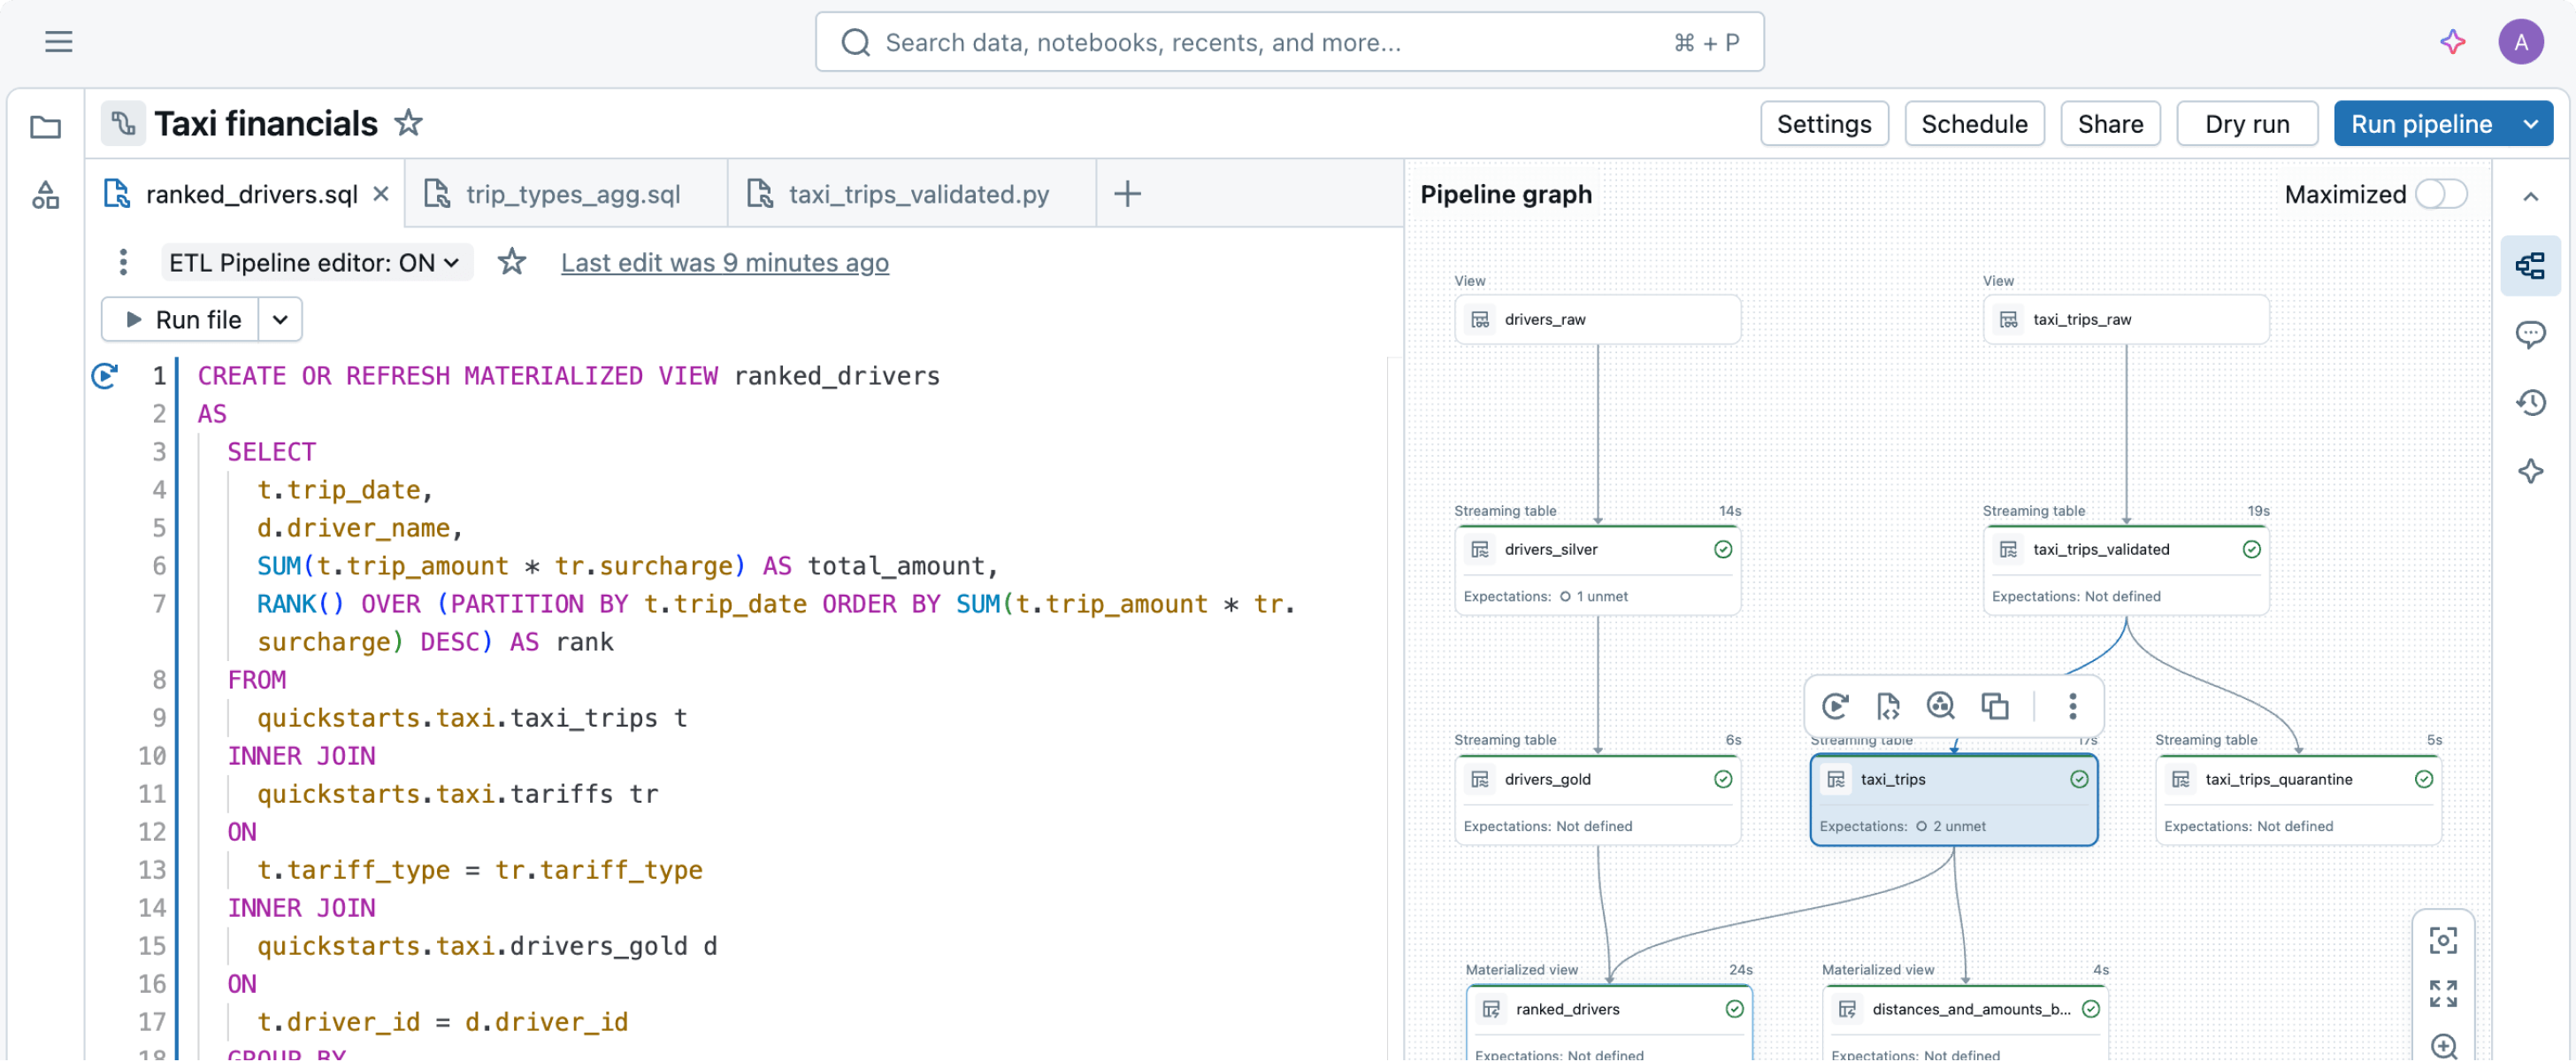
TOP TEAMS SUCCEED WITH INTELLIGENT DATA PIPELINES
Crea y ejecuta canalizaciones a escala agéntica con confianza
Capacita a los equipos de datos y a los agentes de IA con estándares abiertos, controles de calidad automatizados y gobernanza de nivel empresarial.
Estándares abiertos
El estándar abierto universal para canalizaciones de datos. Unifica los lotes y la transmisión, así como SQL y Python, en Apache Spark™ — proporcionando una base portátil para que los equipos de datos y los agentes de IA generen código de producción sólido.

Diseñado para agentes
El marco nativo para agentes de codificación. Los agentes declaran los resultados de los datos objetivo. Apache Spark™ Declarative Pipelines (SDP) resuelve automáticamente los gráficos de dependencia, realiza pruebas de compilación en seco y aplica las reglas de calidad antes de ejecutar las canalizaciones.

Ejecución gobernada
Ejecución de canalizaciones segura y autónoma. Unity Catalog impone límites estrictos de catálogo y medidas de seguridad, mientras que SDP se encarga de la gestión del estado, la recuperación ante errores y el procesamiento incremental de forma subyacente.
Diseñado para estandarizar el desarrollo de canalizaciones para agentes y humanos
Estandariza el desarrollo de canalizaciones mediante la creación preparada para agentes, la gestión automatizada de patrones y un marco de trabajo único para todos los equipos.Crea, valida e itera declarativamente utilizando lenguaje natural a través de Genie Code, o a través del agente de codificación de tu elección.
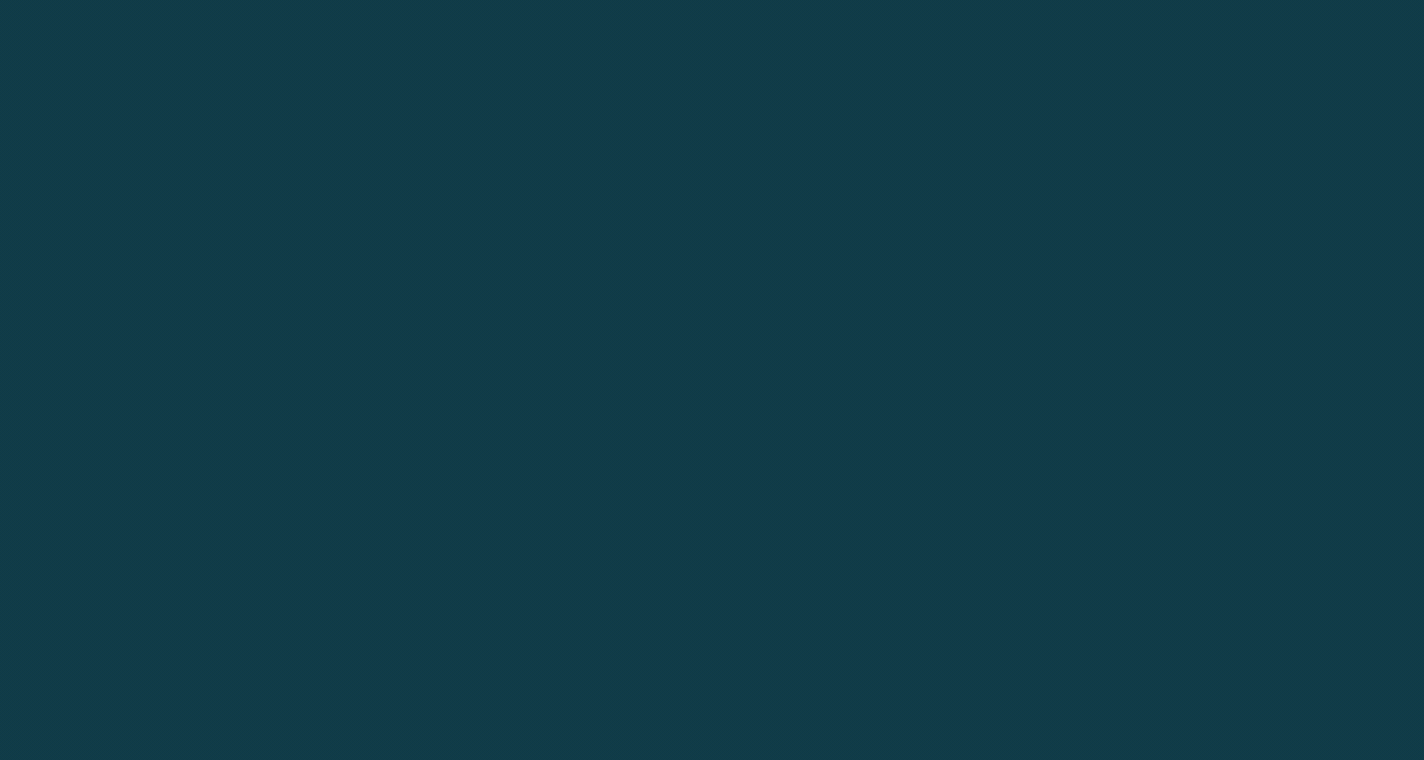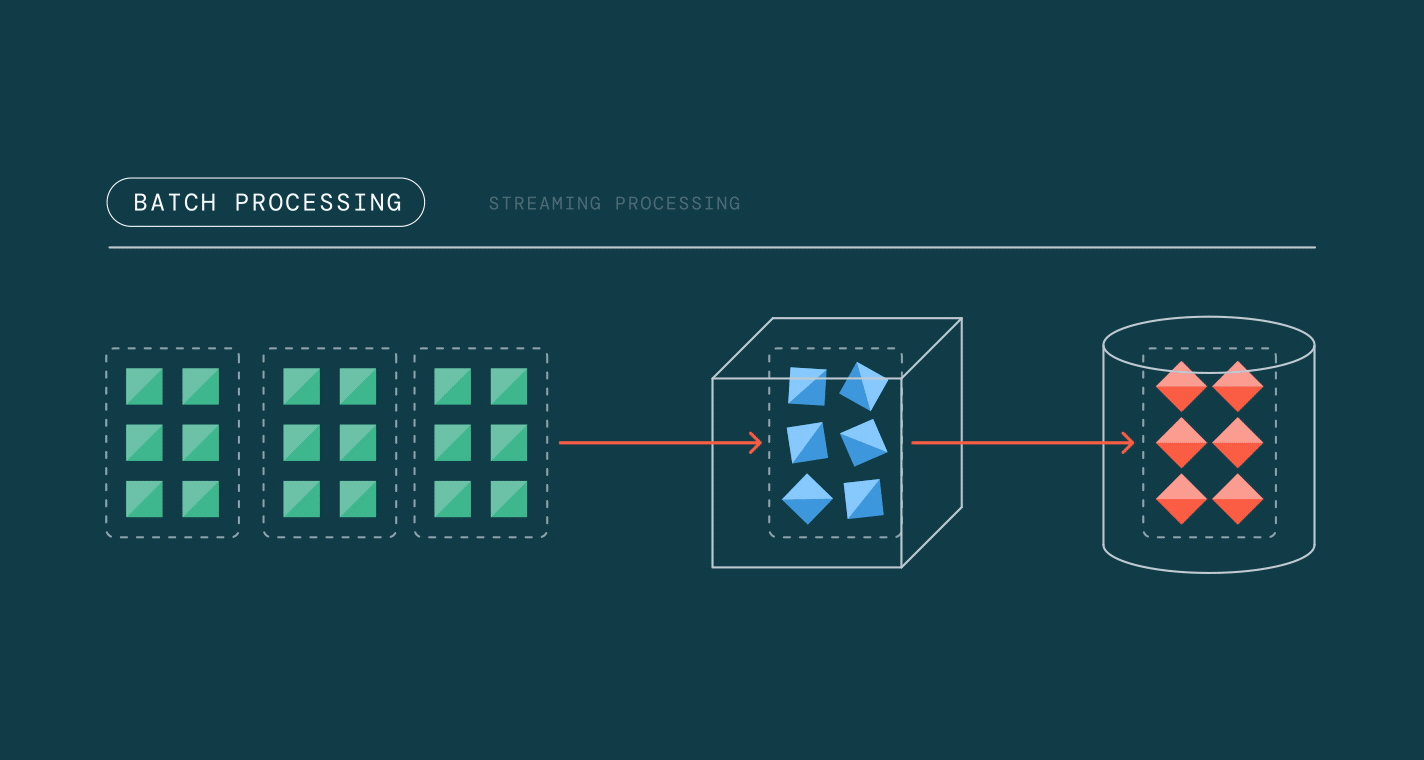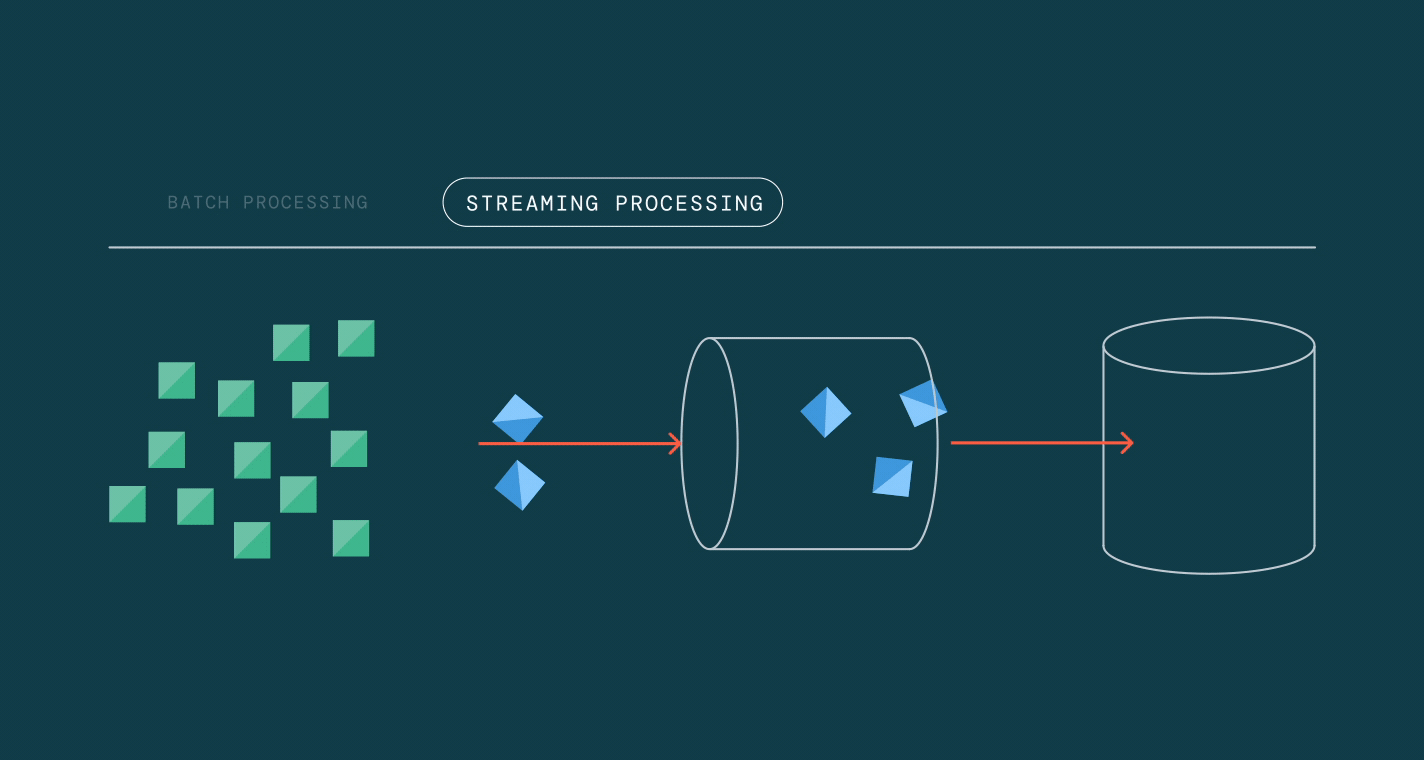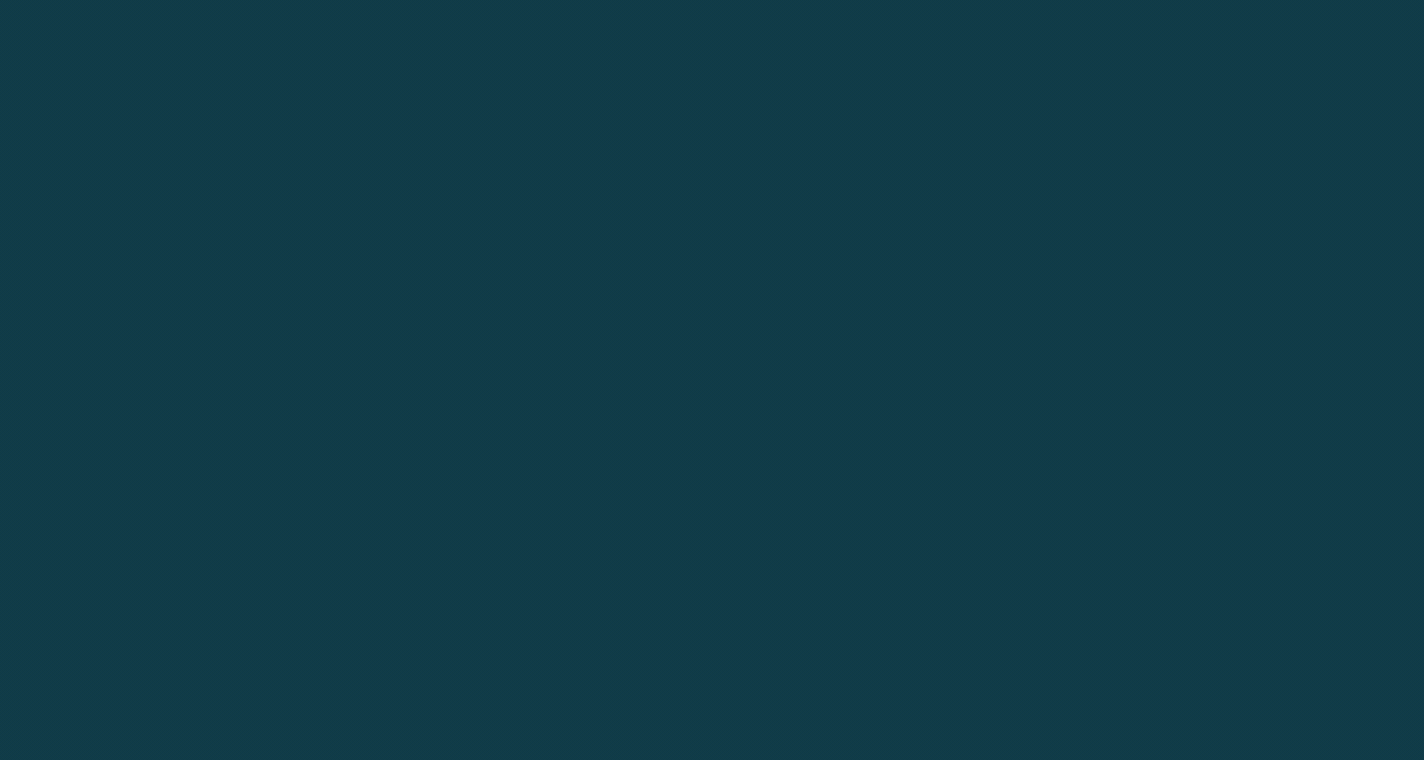
Aprovechando la API unificada de Spark para el procesamiento por lotes y de transmisión, SDP te permite alternar fácilmente entre los modos de procesamiento.
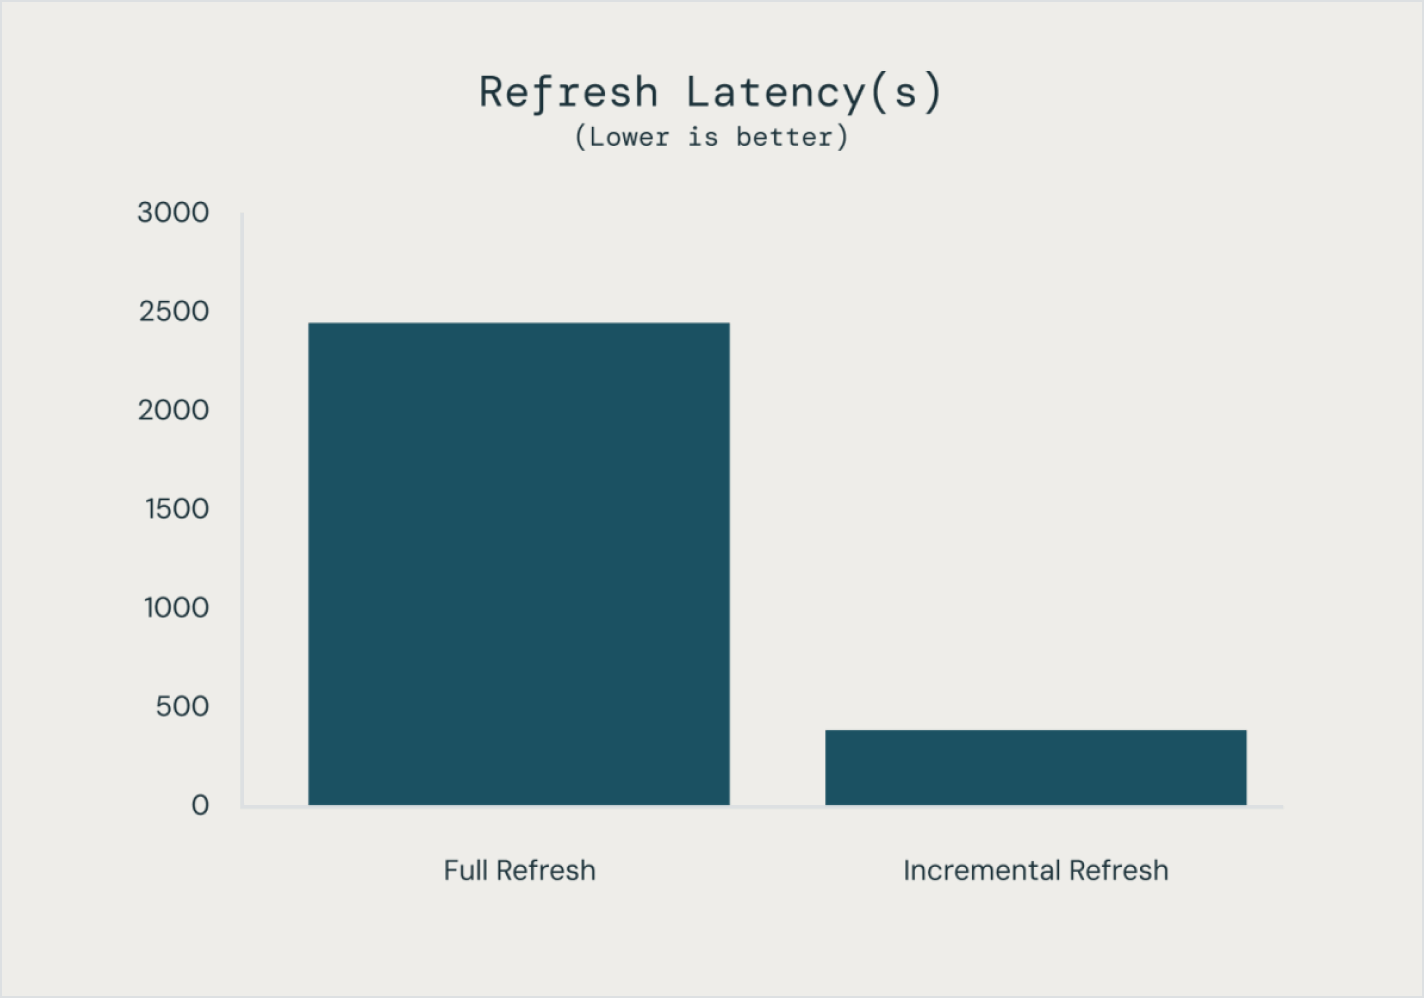
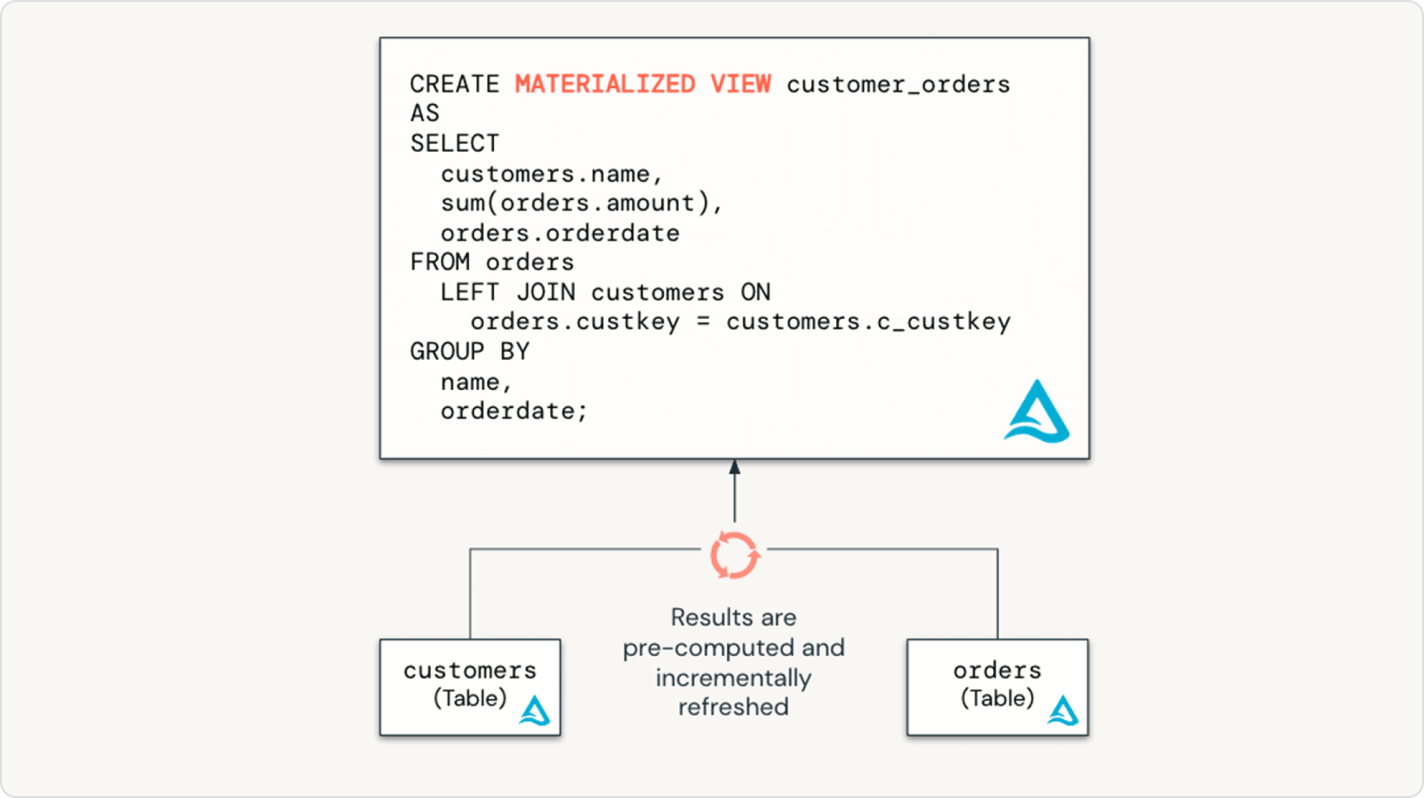
SDP facilita la optimización del rendimiento de la canalización al declarar una canalización de datos incrementales completa con tablas y vistas materializadas.
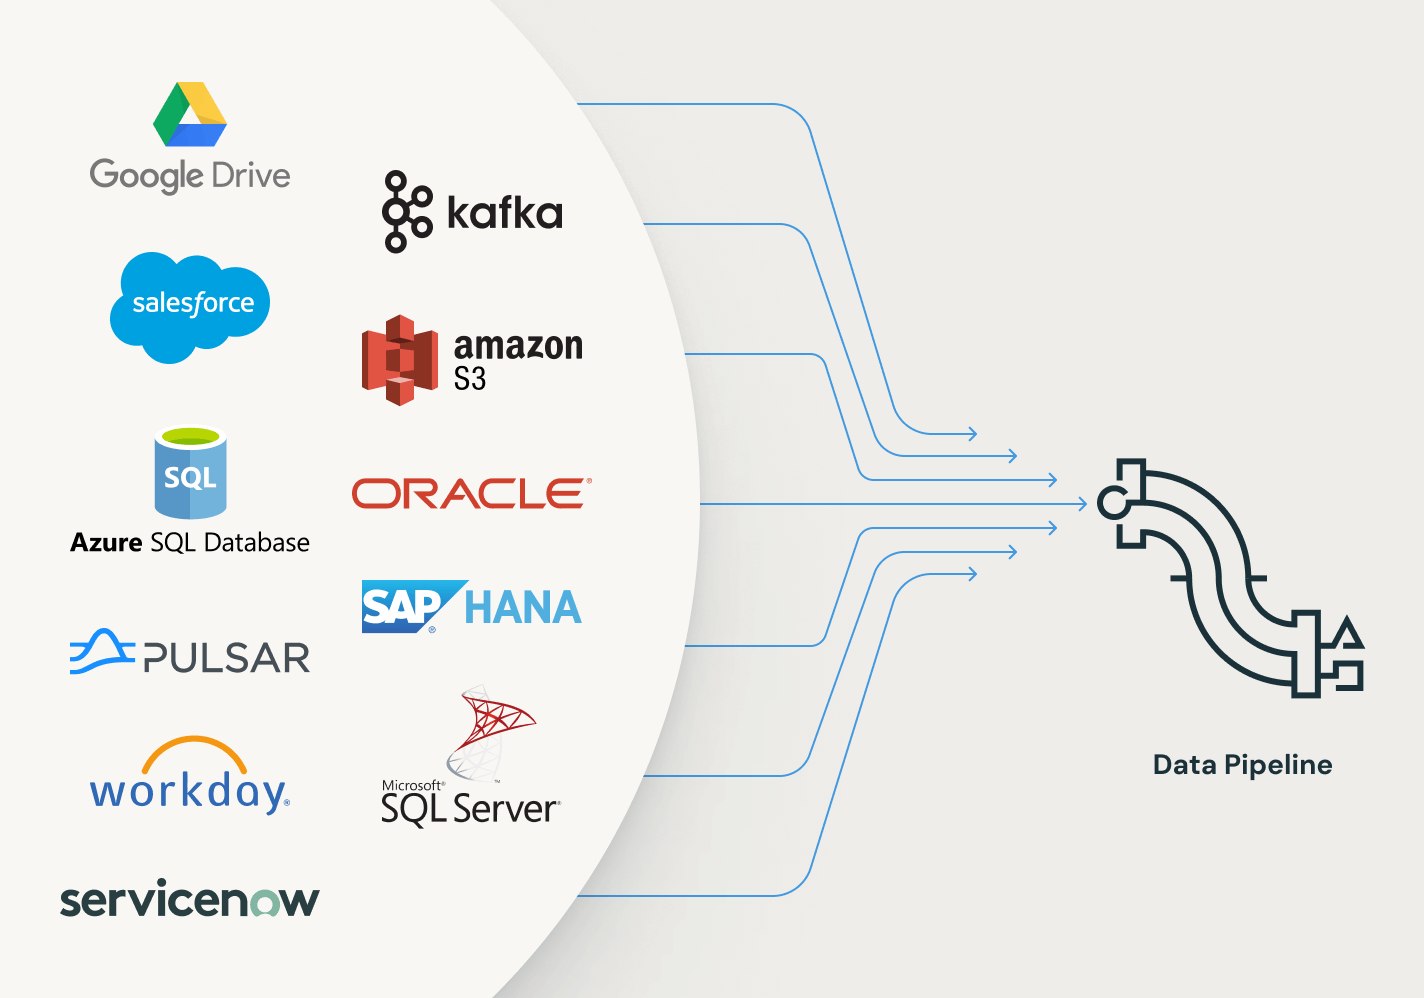
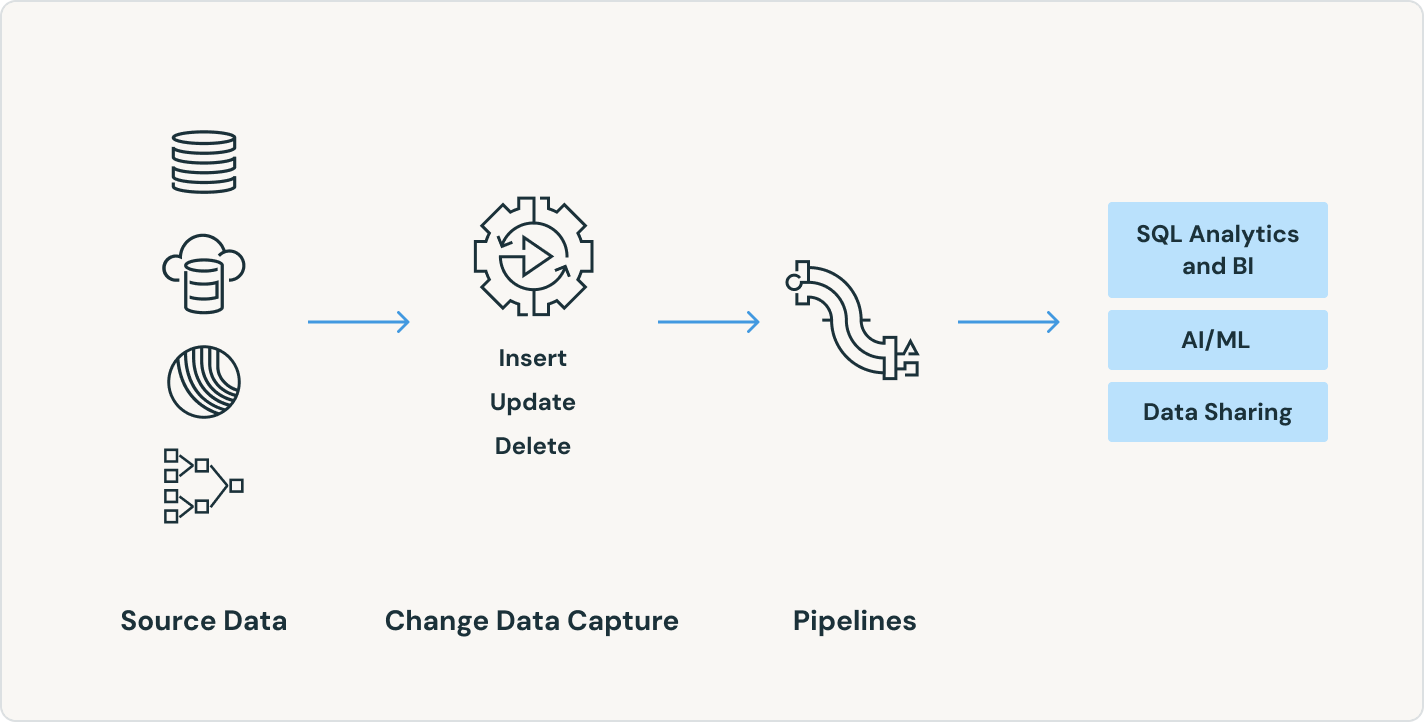
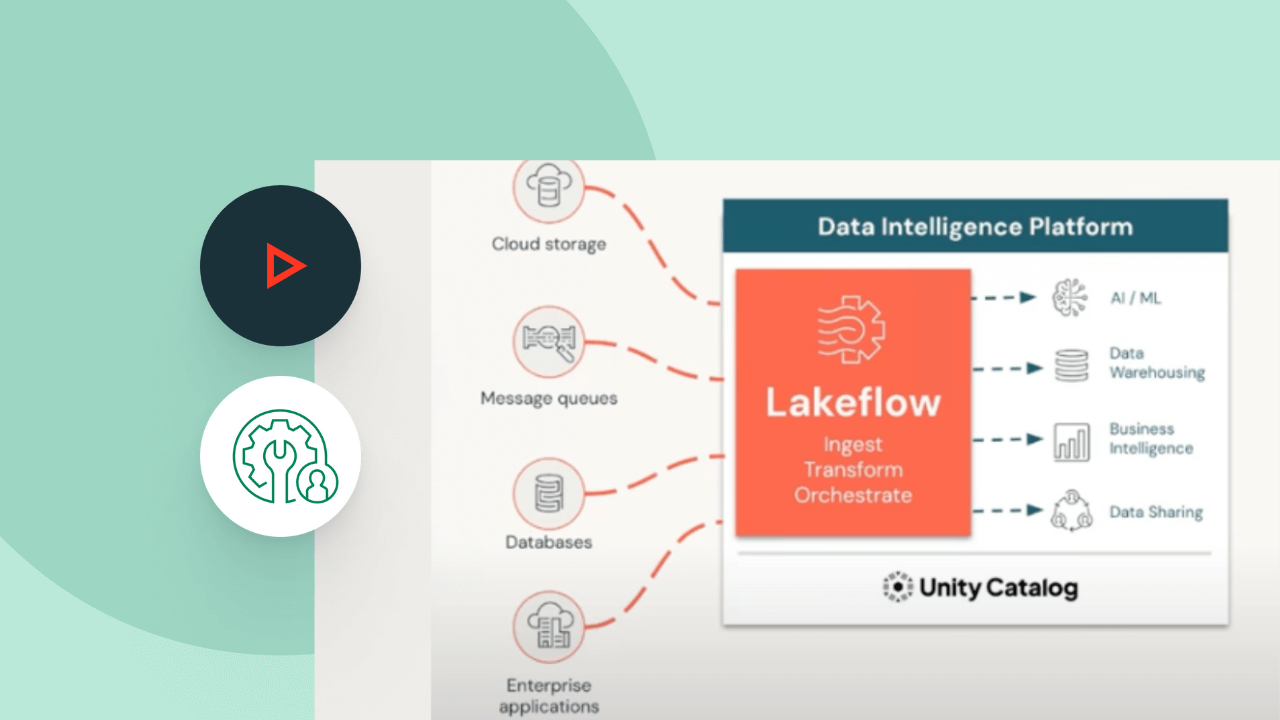
SDP es compatible con un amplio ecosistema de fuentes y destinos. Carga datos desde cualquier fuente, incluido el almacenamiento en la nube, los buses de mensajes, las fuentes de datos de cambio, las bases de datos y las aplicaciones empresariales.
Las expectativas te permiten garantizar que los datos que llegan a las tablas cumplan con los requisitos de calidad de los datos y brinden perspectivas sobre la calidad de los datos con cada actualización de la canalización.
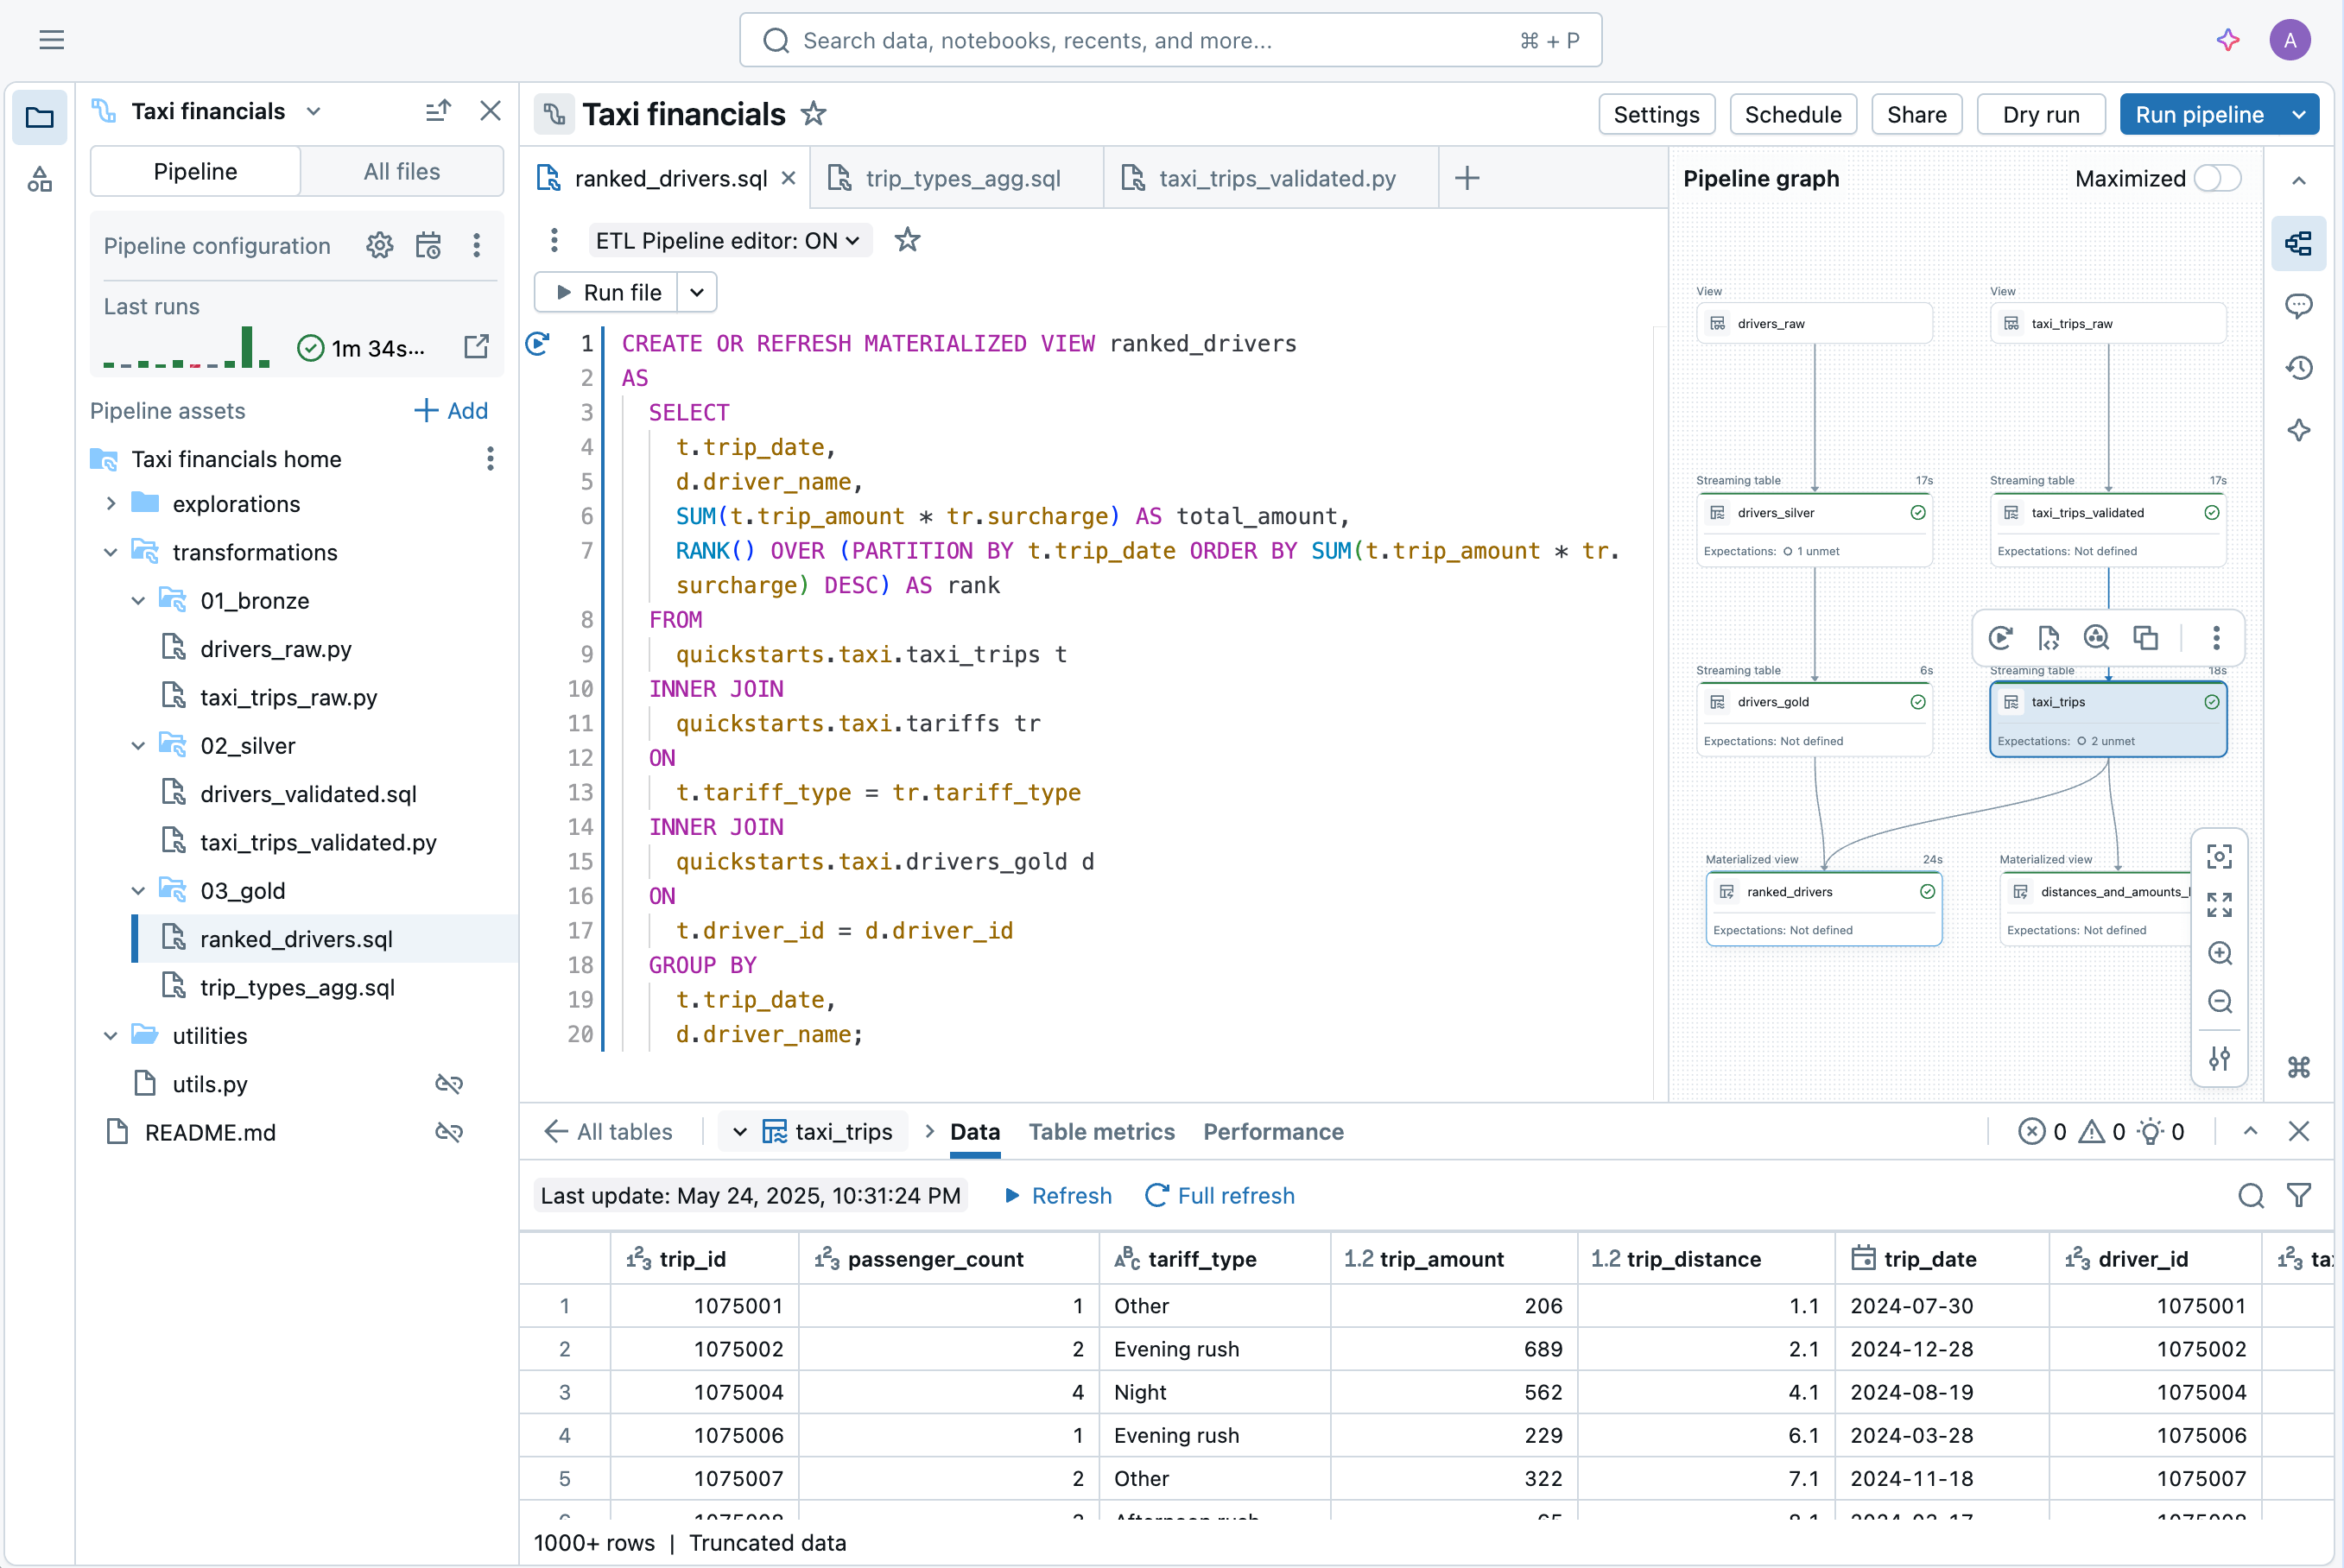
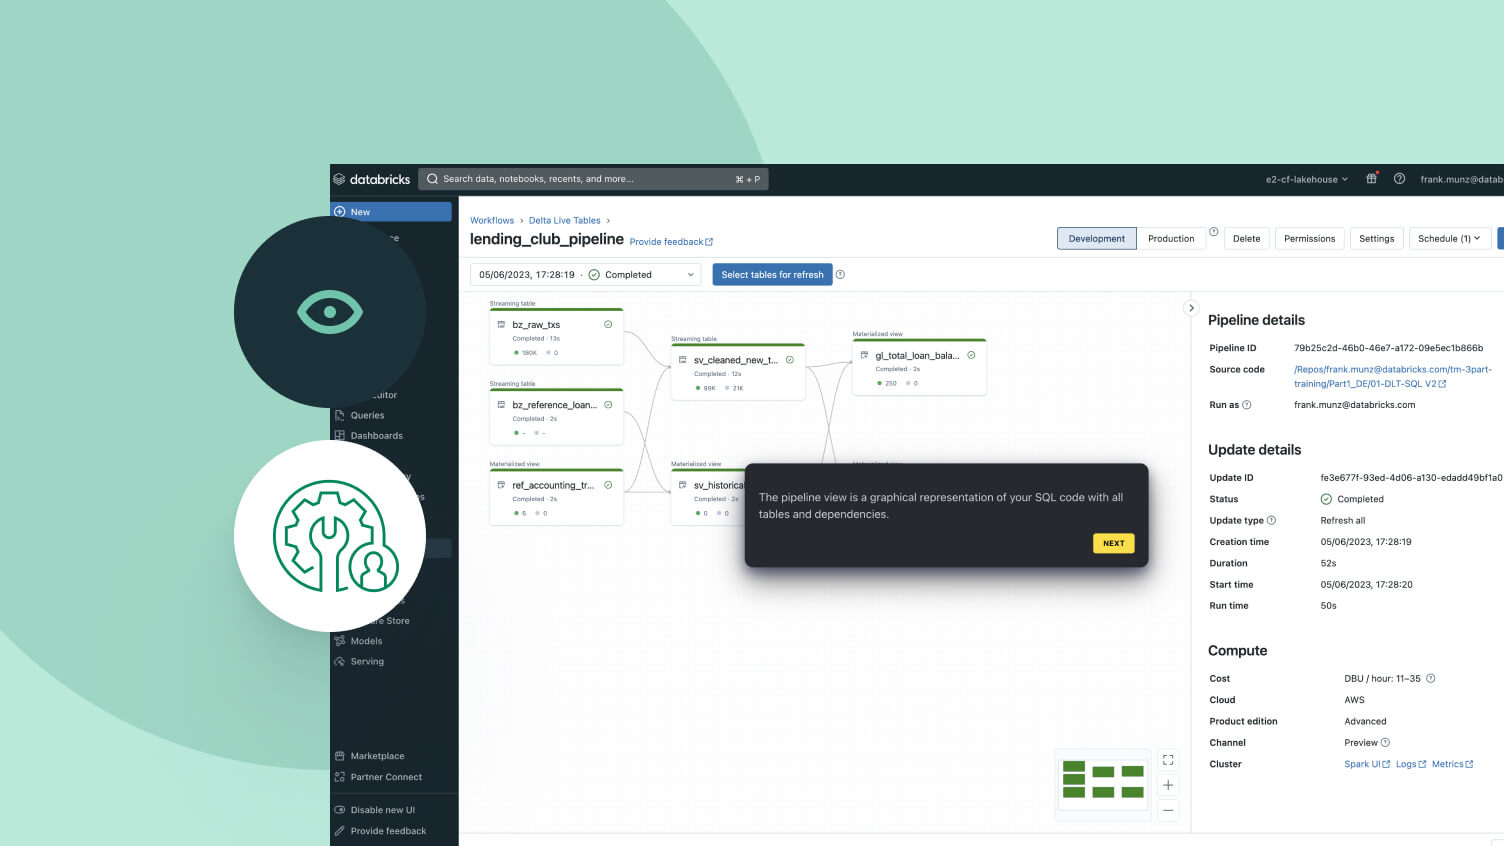
Desarrolla canalizaciones en el editor de canalización Lakeflow, un IDE nativo para ingeniería de datos, sin necesidad de cambiar de contexto. Consulta el DAG, la vista previa de datos y la información sobre la ejecución en una sola interfaz de usuario. Desarrolla código fácilmente utilizando las funcionalidades de autocompletado, detección de errores en línea y diagnóstico.
Más funciones
Optimiza tus canalizaciones de datos

Simplifica las fuentes, las transformaciones y los destinos
La programación declarativa significa que puedes aprovechar el poder de ETL en la plataforma Databricks con solo unas pocas líneas de intención.
Explorar las demostraciones de Spark Declarative Pipelines
Los precios basados en el uso mantienen el gasto bajo control
Paga solo por los productos que uses con una granularidad por segundo.Descubre más
Explora otras ofertas inteligentes e integradas en la plataforma de datos + IA de Databricks.
Genie Code
Tu socio autónomo de IA para el trabajo con datos.

Lakeflow Connect
Los conectores eficientes de ingesta de datos desde cualquier fuente y la integración nativa con la plataforma de datos + IA de Databricks permiten acceder fácilmente a la analítica y la IA, con una gobernanza unificada.

Trabajos de Lakeflow
Define, gestiona y supervisa fácilmente los flujos de trabajo multitarea para canalizaciones de ETL, analítica y aprendizaje automático. Con una amplia gama de tipos de tareas compatibles, capacidades de observabilidad profundas y alta confiabilidad, tus equipos de datos están facultados para automatizar y organizar mejor cualquier canalización y ser más productivos.

Almacenamiento en lakehouse
Unifica los datos de tu lakehouse, en todos los formatos y tipos, para todas tus cargas de trabajo analíticas e IA.

Unity Catalog
Gobierna sin problemas todos tus activos de datos con la única solución de gobernanza unificada y abierta de la industria para datos e IA, integrada en la plataforma de datos + IA de Databricks.

Document Intelligence
Analiza, extrae y clasifica documentos empresariales a escala con gobernanza integrada para IA agéntica.

La plataforma de datos + IA de Databricks
Descubre cómo la plataforma de datos + IA de Databricks habilita tus cargas de trabajo de datos e IA.
Da el siguiente paso
Preguntas frecuentes sobre Spark Declarative Pipelines
Spark Declarative Pipelines (SDP) es un marco abierto que simplifica la ingeniería de datos por lotes y de transmisión en Apache Spark. Al permitir que los equipos de datos y los agentes de codificación declaren estados de datos objetivo en lugar de escribir código de procedimiento, SDP resuelve automáticamente las dependencias, aplica las expectativas de calidad de los datos y gestiona el estado incremental.
¿Estás listo para transformarte en una empresa de datos + IA?
Da los primeros pasos en tu transformación