Ciencia de datos
Ciencia de datos colaborativa a escala

Flujo de trabajo completo de ciencia de datos en Databricks
Optimiza el flujo de trabajo de ciencia de datos de extremo a extremo, desde la preparación de datos hasta el modelado y el intercambio de información, con un entorno de ciencia de datos colaborativo y unificado creado sobre una base de lakehouse abierta. Obtén acceso rápido a datos limpios y confiables, recursos informáticos preconfigurados, integración IDE, soporte multilingüe y herramientas de visualización avanzadas integradas para ofrecer la máxima flexibilidad a los equipos de análisis de datos.

Colaboración en todo el flujo de trabajo de ciencia de datos
Escribe código en Python, R, Scala y SQL, explora datos con visualizaciones interactivas y descubre nuevas perspectivas internas con Databricks Notebooks. Comparte código de forma segura y confiable con coautoría, comentarios, control automático de versiones, integraciones con Git y controles de acceso basados en roles.

Escala la ciencia de datos con clústeres de nube gestionados automáticamente
Ya no tienes que limitarte a la cantidad de datos que cabe en tu portátil o a la cantidad de capacidad informática de que dispones. Migra rápidamente tu entorno local a la nube y conecta cuadernos a tu propio sistema informático personal y a clústeres gestionados automáticamente.
Utiliza tu IDE local favorito con computación escalable
La elección de un IDE es muy personal y afecta significativamente a la productividad. Conecta tu IDE favorito a Databricks para seguir beneficiándote de un almacenamiento de datos y un procesamiento ilimitados. O simplemente utiliza RStudio o JupyterLab directamente desde Databricks para una experiencia fluida.
Prepara datos para la ciencia de datos utilizando Delta Lake
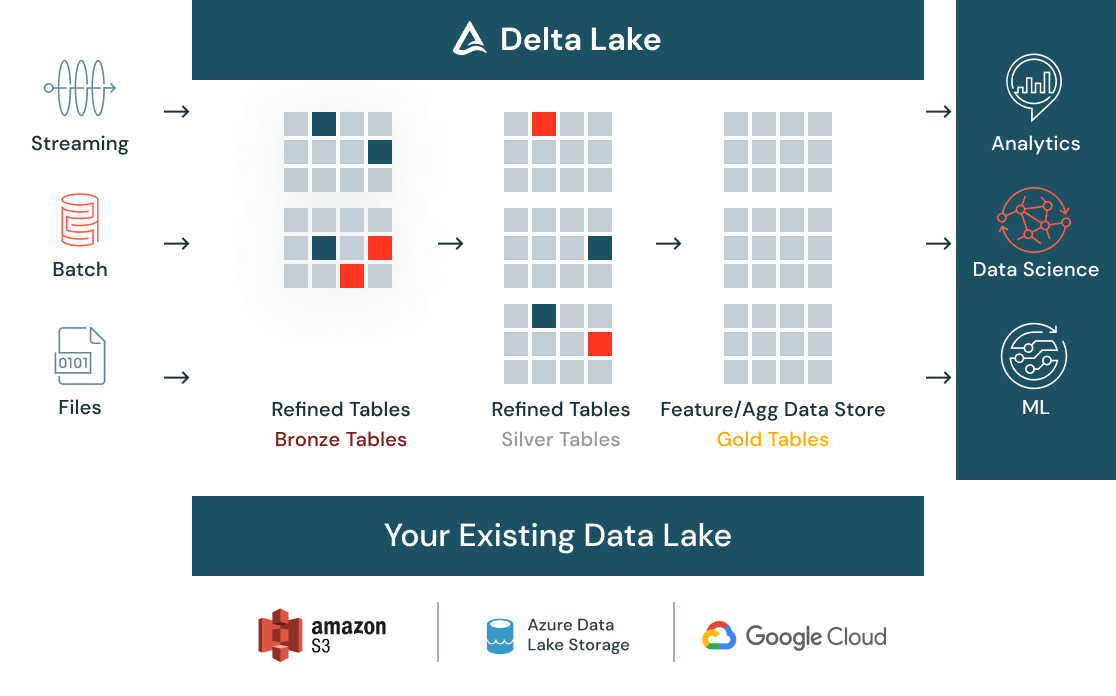
Limpia y cataloga todos tus datos (por lotes, streaming, estructurados o no estructurados) en un solo lugar con Delta Lake y haz que sean accesibles para toda tu organización a través de un almacén de datos centralizado. A medida que se reciben los datos, los controles de calidad automáticos garantizan que los datos cumplan las expectativas y estén listos para el análisis. A medida que los datos evolucionan con nuevos datos y transformaciones adicionales, el control de versiones de datos garantiza que puedas satisfacer las necesidades de cumplimiento.

Herramientas visuales de bajo código para la exploración de datos
Utiliza herramientas visuales de forma nativa desde los cuadernos de Databricks para preparar, transformar y analizar los datos, lo que permite a los equipos de todos los niveles de experiencia trabajar con datos. Una vez terminadas las transformaciones y visualizaciones de datos, puedes generar el código que se ejecuta en segundo plano, lo que te ahorra el tiempo de escribir código estándar y te permite dedicar más tiempo a trabajos de alto valor.
Convierte los análisis en paneles para compartir información
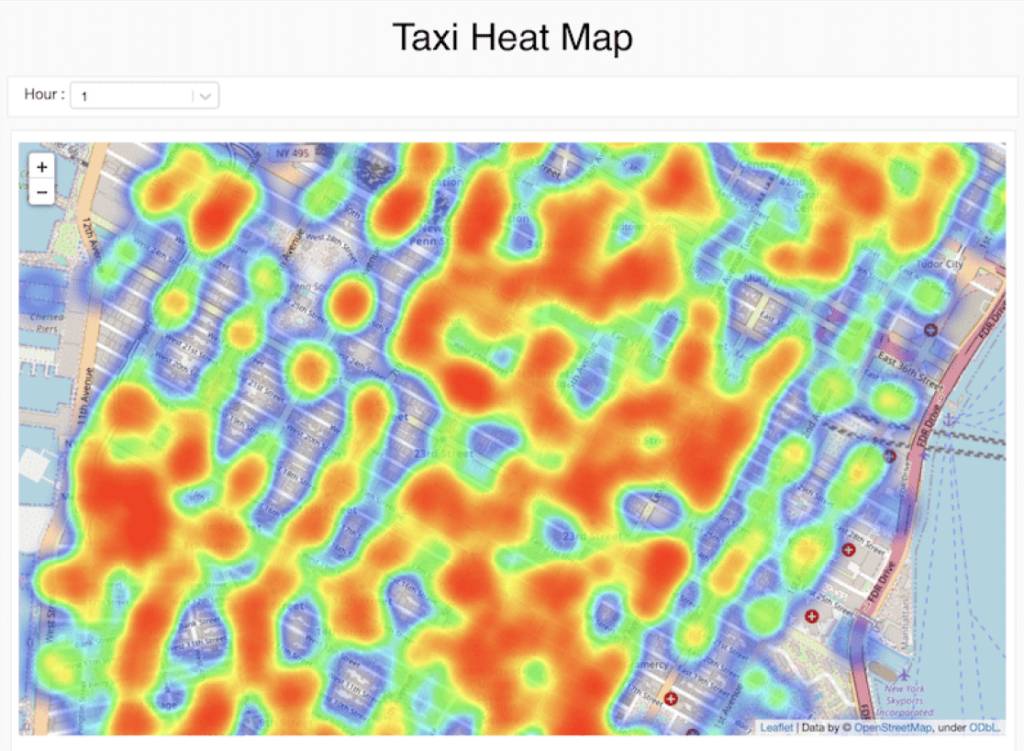
Comparte y exporta resultados fácilmente convirtiendo rápidamente tu análisis en un panel dinámico. Los paneles de control están siempre actualizados y también pueden ejecutar consultas interactivas. Las celdas, visualizaciones o cuadernos se pueden compartir con control de acceso basado en roles y exportar en varios formatos, incluidos HTML e IPython Notebook.
Migración a Databricks
¿Estás cansado de los silos de datos, el rendimiento lento y los altos costos asociados con los sistemas heredados como Hadoop y los almacenes de datos empresariales? Migra a Databricks Lakehouse: la plataforma moderna para todos tus casos de uso de datos, analítica e IA.

Informes sobre ciencia de datos, libros electrónicos, blogs y eventos
Informes y libros electrónicos
Blogs
Eventos virtuales
Preguntas frecuentes
Databricks Data Science es un entorno colaborativo y unificado para el flujo de trabajo de ciencia de datos de extremo a extremo, creado sobre una base de lakehouse abierta. Optimiza el proceso desde la preparación de datos hasta el modelado y el intercambio de información, ofreciendo a los equipos acceso rápido a datos limpios y fiables, recursos informáticos preconfigurados, integración IDE, soporte multilingüe y herramientas de visualización integradas. El entorno está diseñado para ofrecer la máxima flexibilidad a los equipos de análisis de datos que trabajan dentro de la plataforma de datos + IA de Databricks.