O que procurar em um serviço gerenciado do Postgres: Uma lista de verificação para compradores técnicos
O Postgres gerenciado tradicional se destaca em cargas de trabalho transacionais, mas peca em consultas analíticas — e a maioria das listas de verificação de avaliação deixa essa lacuna de fora. Se você está avaliando o Postgres como um mecanismo...
- Um serviço Postgres gerenciado deve ser avaliado pelo que ele consegue comprovar em cenários de falha, recuperação e carga de produção, e não apenas pelos recursos que anuncia.
- As principais verificações incluem alta disponibilidade, recuperação de desastres, compatibilidade com o PostgreSQL, segurança, escalabilidade, custo total, controle operacional e portabilidade.
- Um fluxo de trabalho de produção deve testar as promessas do provedor com testes de failover, recuperação para um ponto específico no tempo, carga e migração antes de adotar o serviço.
- O Lakebase Postgres oferece um Postgres gerenciado e sem servidor (serverless) com alta disponibilidade automática, escalabilidade automática e os recursos de segurança e governança do Databricks.
Gerenciado é um rótulo, não uma especificação. Avalie um serviço gerenciado de banco de dados em nuvem com base no que ele comprova em cenários de falha e recuperação, e não no que a página de recursos lista.
Um serviço gerenciado do Postgres é um banco de dados PostgreSQL onde o provedor opera a infraestrutura subjacente e automatiza a administração do banco de dados, como aplicação de patches, backups, failover e redimensionamento. O nível de gerenciamento do provedor varia conforme o serviço, o que torna "gerenciado" um rótulo e não uma especificação completa. Os principais provedores de nuvem, incluindo AWS, Microsoft Azure e Google Cloud, oferecem serviços gerenciados de PostgreSQL, assim como fornecedores focados em bancos de dados.
Um provedor pode anunciar alta disponibilidade, backups automatizados ou segurança corporativa, mas essas alegações não informam aos engenheiros de plataforma ou DBAs o que acontece quando o nó principal falha, a rapidez com que um banco de dados pode ser restaurado ou se uma extensão necessária do PostgreSQL é suportada. Quando um problema surge em produção, o que importa é a rapidez com que a equipe consegue identificá-lo e resolvê-lo.
Engenheiros de plataforma, DBAs, arquitetos de dados e gerentes de engenharia que estão avaliando um serviço gerenciado do Postgres para produção. O conteúdo abrange as áreas que costumam causar problemas após a migração, como controle operacional, alta disponibilidade, recuperação de desastres, redimensionamento e assim por diante. Cada seção analisa o que o provedor deve suportar, as perguntas que vale a pena fazer durante uma avaliação e como testar as respostas em um piloto. Se você for um DBA ou engenheiro de plataforma planejando uma migração, use este artigo como um checklist prático em vez de uma leitura única.
O checklist do serviço gerenciado do Postgres em resumo
Uma avaliação de um Postgres gerenciado deve ir além do provisionamento do banco de dados e da administração rotineira. A tabela abaixo oferece às equipes um ponto de partida para verificar os recursos e as respostas que devem motivar uma análise mais detalhada.
| Área | O que verificar | Alerta vermelho |
|---|---|---|
| Escopo operacional | Quem lida com patches, atualizações e ajustes, e quais controles de banco de dados continuam disponíveis | "Gerenciado" cobre apenas a máquina virtual e o sistema operacional |
| Alta disponibilidade | Failover automático, garantias de transações confirmadas e se o failover funciona entre zonas de disponibilidade | Nenhum RPO (Recovery Point Objective) declarado ou promoção manual |
| Backups e recuperação de desastres | Recuperação para um ponto no tempo (PITR), opções de restauração, retenção, recuperação entre regiões e objetivos de recuperação | A recuperação de desastres está disponível apenas por meio de solicitação de suporte, sem RPO ou RTO (Recovery Time Objective) declarados |
| Escalabilidade e desempenho | Comportamento de redimensionamento, réplicas de leitura, pool de conexões, armazenamento e modelo de operações de entrada/saída por segundo (IOPS) | O redimensionamento vertical exige tempo de inatividade prolongado |
| Segurança e conformidade | Conectividade privada, controles de identidade e acesso, chaves gerenciadas pelo cliente, logs de auditoria e escopo de conformidade | A conectividade pública é obrigatória ou as chaves de criptografia só podem ser controladas pelo provedor |
| Compatibilidade e extensões | Versões compatíveis do PostgreSQL, extensões, drivers, parâmetros e restrições de superusuário | Uma extensão crítica ou recurso necessário do PostgreSQL não é suportado |
| Migração | Caminhos de migração compatíveis, replicação lógica e opções de captura de dados de alterações (CDC) | Bancos de dados grandes só podem ser migrados por meio de despejo e restauração |
| Preços e custo total | Computação, armazenamento, IOPS, backups, réplicas, tráfego de rede de saída e custos de suporte estendido | Apenas o preço de computação está claro |
| Operações | Métricas de banco de dados, logs, alertas e acesso ao suporte em nível de PostgreSQL | Observabilidade limitada do banco de dados ou ausência de escalonamento para especialistas em PostgreSQL |
| Portabilidade e saída | Exportações padrão e replicação lógica para outro ambiente PostgreSQL | Os dados só podem sair por meio de um formato proprietário ou solicitação de suporte |
1. Escopo operacional e controle
A primeira coisa a verificar é onde a responsabilidade do provedor termina e a da equipe de banco de dados começa. Um serviço gerenciado deve cuidar da infraestrutura e das operações rotineiras do banco de dados sem remover os controles do PostgreSQL dos quais uma carga de trabalho de produção depende. Provedores que se referem a um serviço como totalmente gerenciado nem sempre querem dizer a mesma coisa.
Comece pela manutenção. Pergunte se as atualizações de versões secundárias são automáticas, se as equipes podem escolher uma janela de manutenção, com quanto de antecedência os provedores avisam antes das alterações e se as atualizações exigem reinicialização ou failover. As atualizações de versões principais merecem atenção especial. O PostgreSQL dá suporte a cada versão principal por cinco anos, portanto, as equipes devem entender por quanto tempo o provedor suporta cada versão e o que acontece quando esse suporte termina. Solicite a data de fim de vida útil (end-of-life) que o provedor utiliza para cada versão. Geralmente, quanto menor o aviso prévio dado pelo provedor antes de atualizar um banco de dados, mais difícil é se planejar para isso.
O acesso à configuração é outra fonte comum de surpresas. Serviços gerenciados costumam restringir o acesso de superusuário e limitar parâmetros ou comandos que possam afetar a infraestrutura subjacente. Antes de migrar, verifique quais funções estão disponíveis, quais parâmetros podem ser alterados, se ALTER SYSTEM é suportado e quais comandos do PostgreSQL são restritos. Por exemplo, alguns serviços permitem editar um conjunto de parâmetros por meio de um console ou API, mas bloqueiam totalmente o comando ALTER SYSTEM.
- Pergunte como funcionam as atualizações de versões principais e secundárias, incluindo janelas de manutenção, notificações e políticas de fim de suporte.
- Pergunte quais funções, parâmetros e comandos do PostgreSQL são restritos.
- Comprove isso aplicando uma atualização secundária no piloto e medindo o efeito nas conexões ativas e no tráfego da aplicação.
- Um alerta vermelho é um serviço que se autodenomina totalmente gerenciado, mas deixa a aplicação de patches, atualizações ou tarefas críticas de manutenção por conta da equipe de banco de dados, ou um serviço que não consegue documentar claramente seus limites de configuração e atualização.
2. Alta disponibilidade e failover automático
O failover automático em bancos de dados Postgres significa que o serviço pode promover automaticamente uma instância em espera em outra zona de disponibilidade e declarar claramente o que acontece com as transações confirmadas durante o failover. A alta disponibilidade protege contra falhas dentro de uma região, mas não é a mesma coisa que recuperação de desastres.
Pergunte se a instância em espera usa replicação síncrona ou assíncrona, qual é o ponto de recuperação suportado pelo provedor e se o endpoint do banco de dados permanece o mesmo após a promoção. As aplicações geralmente precisarão se reconectar após a queda das conexões existentes, portanto, o provedor deve documentar o comportamento esperado. Em um cluster de vários nós, confirme quais nós podem ser promovidos e como as aplicações encontram o novo nó principal. Garanta que seus pools de conexões e drivers, seja em Java, Python ou outra linguagem, lidem com as reconexões de forma limpa.
- Pergunte se a alta disponibilidade usa replicação síncrona e se a instância em espera é executada em uma zona de disponibilidade separada.
- Pergunte quanto tempo o failover costuma levar e se as transações confirmadas são preservadas.
- Comprove isso acionando um failover, cronometrando a recuperação e verificando os erros da aplicação, as gravações confirmadas e o comportamento de replicação.
- Um alerta vermelho é a promoção manual ou a falta de uma garantia clara em relação às transações confirmadas.
3. Backups, recuperação para um ponto no tempo e recuperação de desastres
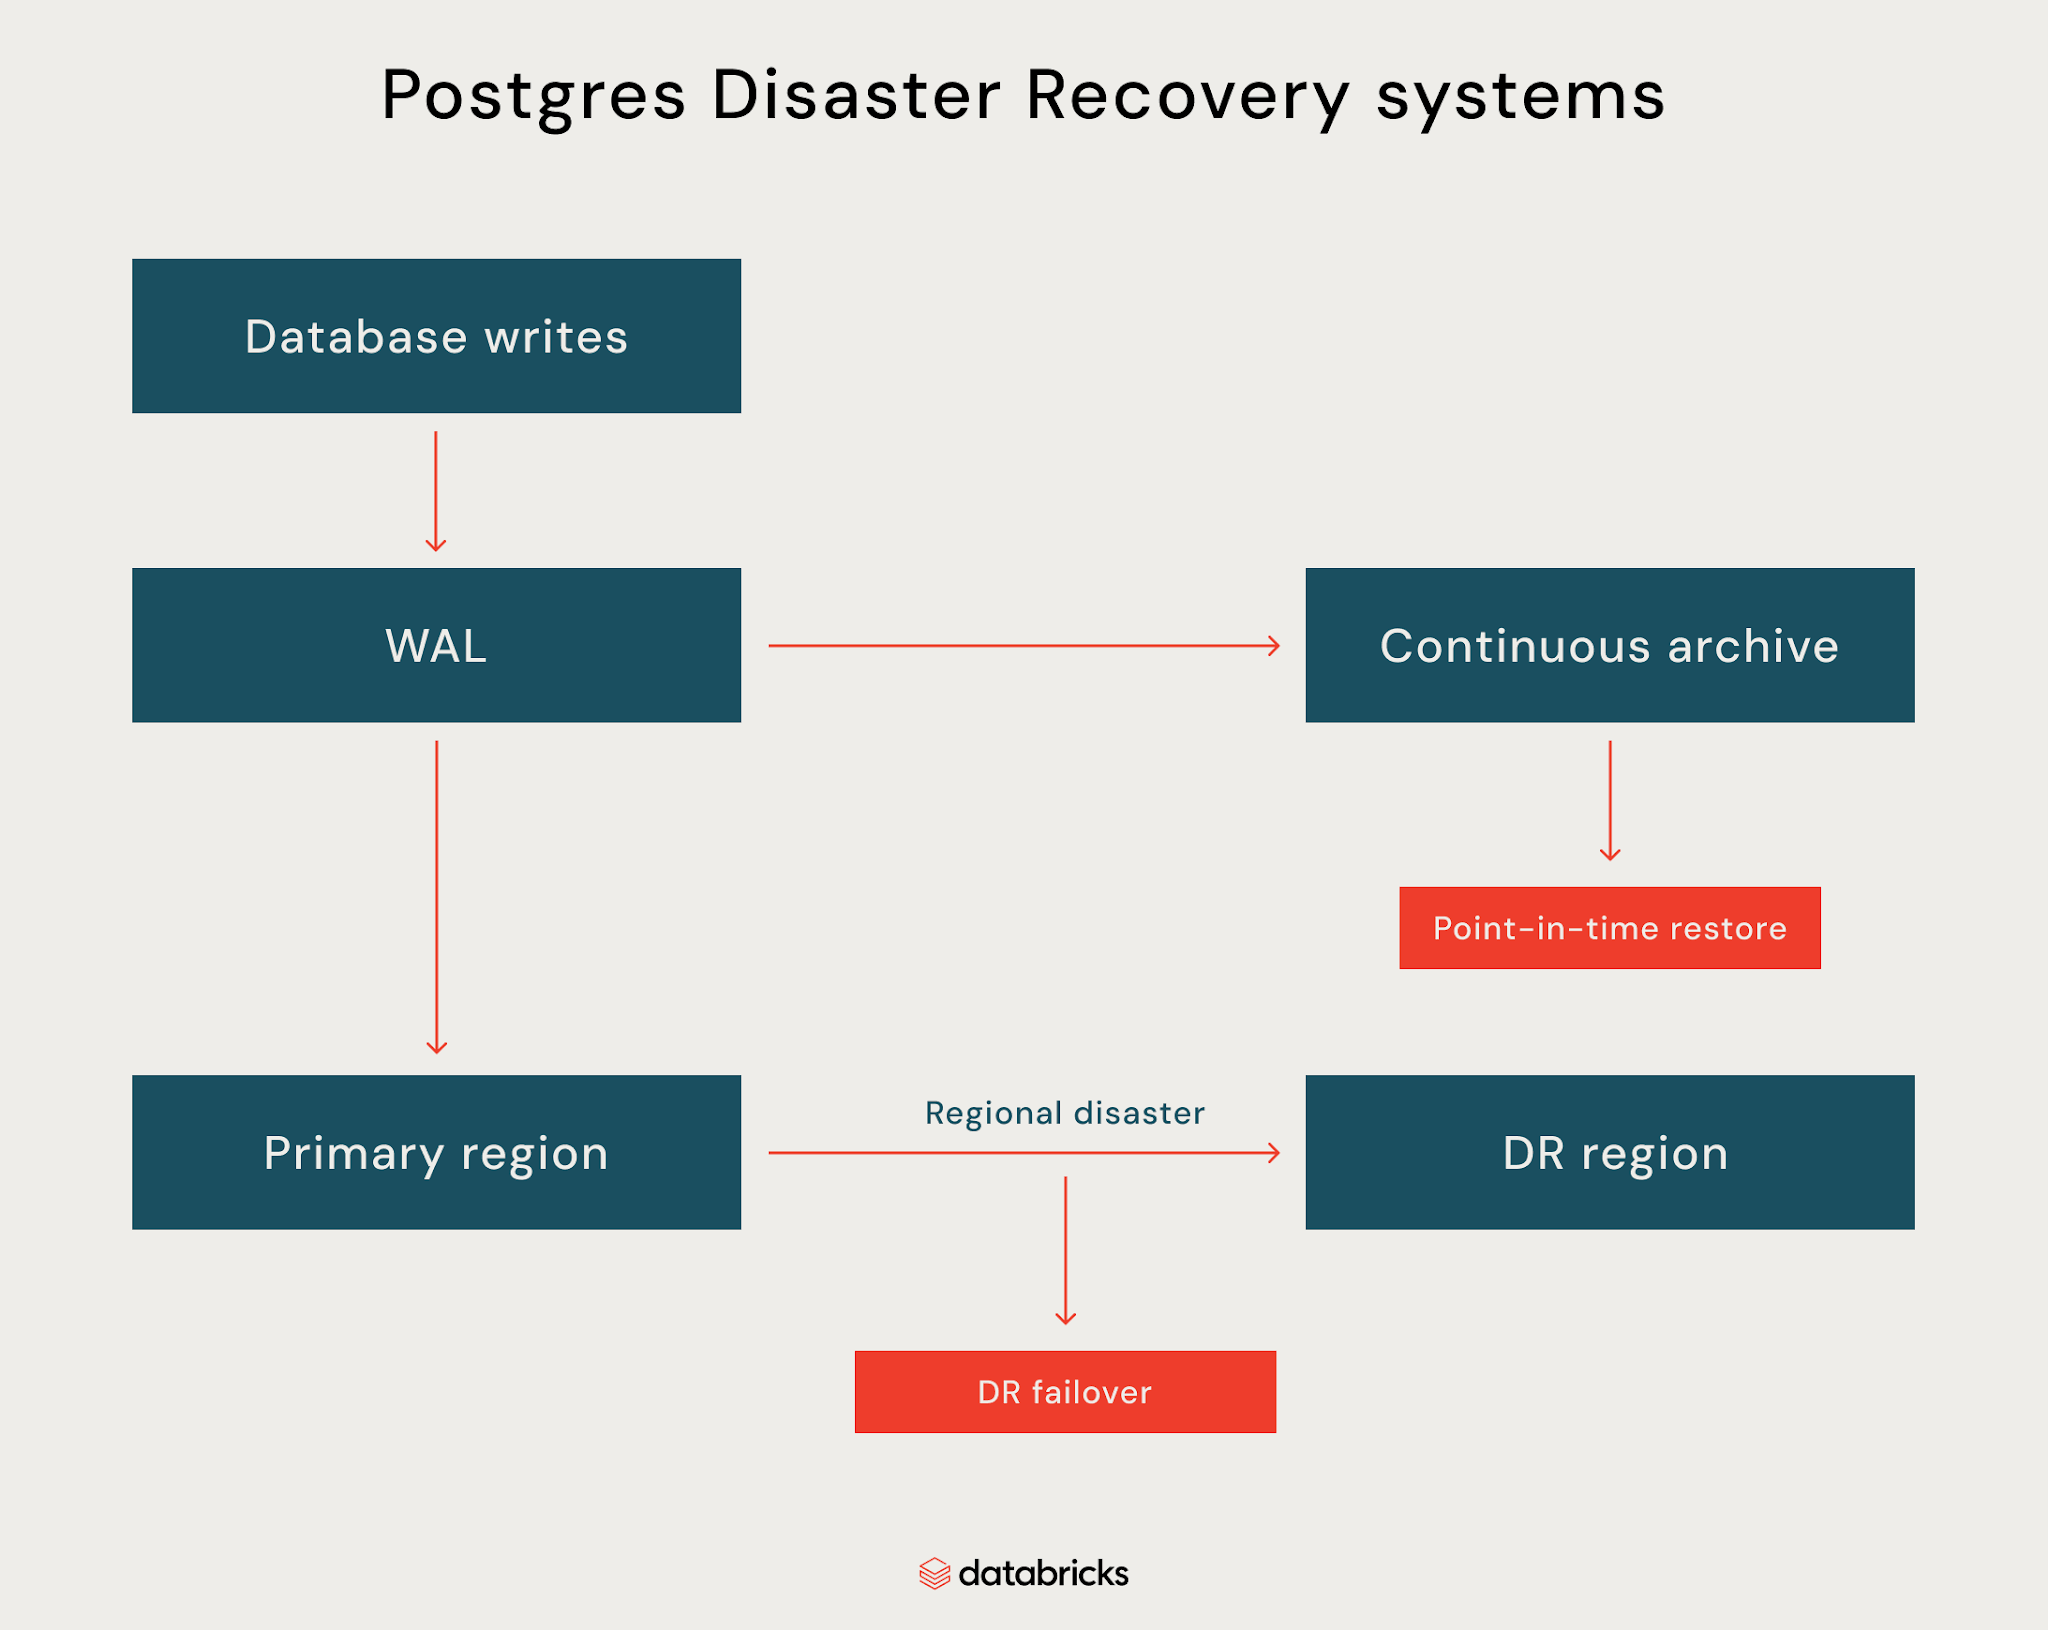
Backups e recuperação de desastres (DR) são importantes em bancos de dados. Verifique se os backups podem restaurar o banco de dados para um ponto específico no tempo e se o provedor define claramente seus objetivos de recuperação. O RPO define quanta carga de trabalho de dados se pode perder. O RTO define por quanto tempo o banco de dados pode ficar indisponível.
Pergunte se o serviço arquiva continuamente o WAL (Write-Ahead Log), por quanto tempo a recuperação para um ponto no tempo permanece disponível e se as restaurações são de autoatendimento. Para a recuperação de desastres, verifique se a replicação entre regiões é contínua ou periódica, se o failover é automático ou manual e se o provedor publica metas de RPO e RTO. Backups automatizados combinados com o arquivamento contínuo do WAL tornam possíveis a recuperação para um ponto no tempo e a restauração confiável de dados.
- Pergunte se é possível restaurar o banco de dados para um carimbo de data/hora (timestamp) específico e quanto tempo o processo costuma levar.
- Valide registros críticos e leituras do aplicativo após a restauração.
- Execute um teste de recuperação de desastres se o provedor oferecer suporte a um e documente as etapas de recuperação.
- Um sinal de alerta é a recuperação de desastres que só está disponível por meio de solicitação de suporte ou não possui RPO ou RTO publicados.
4. Dimensionamento e desempenho
Verifique como o serviço lida com o crescimento de computação, armazenamento, conexões e tráfego de leitura. O dimensionamento não deve introduzir tempo de inatividade inesperado nem exigir que você gerencie a infraestrutura manualmente.
Pergunte se a computação pode ser dimensionada verticalmente, se há réplicas de leitura disponíveis, como o armazenamento e as operações de entrada/saída por segundo (IOPS) são dimensionados e se o pooling de conexões é integrado. Para serviços com autoscaling, verifique o que aciona o dimensionamento, com que rapidez a capacidade muda e se o dimensionamento afeta conexões ou transações ativas. Na maioria dos serviços gerenciados, o dimensionamento de CPU e RAM geralmente requer apenas alguns cliques ou uma única chamada de API, o que permite às equipes adequar a capacidade ao crescimento dos usuários em vez de lançar nova infraestrutura.
- Pergunte se o dimensionamento vertical exige uma reinicialização ou failover.
- Pergunte como o armazenamento cresce e se há limites de conexões, IOPS ou réplicas.
- Comprove executando uma carga de produção representativa e testando o aumento de escala durante o tráfego ativo.
- Meça a latência de consultas, erros de conexão e o comportamento do aplicativo antes e depois do dimensionamento.
- Um sinal de alerta é o dimensionamento que exige tempo de inatividade prolongado ou possui limites de capacidade não documentados.
5. Segurança, conformidade e controle de acesso
Valide como o serviço protege os dados em trânsito e em repouso, controla o acesso ao banco de dados e se conecta à rede. Os recursos de segurança devem corresponder aos requisitos de identidade e conformidade existentes da organização, em vez de exigir um modelo operacional separado.
Pergunte se há suporte para conectividade privada, como o Identity and Access Management (IAM) se integra às funções de banco de dados e se as chaves gerenciadas pelo cliente (CMK) estão disponíveis. Verifique também o registro de auditoria, os controles de criptografia e o escopo de conformidade do provedor. Pergunte se os aplicativos podem se conectar por meio de um endereço IP privado, público ou ambos. A maioria dos provedores gerenciados impõe criptografia em repouso e em trânsito e aplica patches de SO rotineiros e atualizações de segurança automaticamente, portanto, confirme quais estruturas de conformidade, como HIPAA ou GDPR, o serviço suporta.
- Pergunte se os bancos de dados podem ser executados sem acesso público à Internet.
- Pergunte como a atividade do banco de dados, as ações administrativas e os eventos de autenticação são registrados.
- Verifique se as chaves de criptografia podem ser rotacionadas ou revogadas sem interromper o banco de dados.
- Comprove conectando-se por meio do caminho de rede privada pretendido e testando o acesso com diferentes funções.
- Um sinal de alerta é um serviço que exige conectividade pública, fornece visibilidade de auditoria limitada ou não oferece suporte aos controles de segurança exigidos pela organização.
6. Compatibilidade e extensões do Postgres
Você deve verificar se o serviço oferece suporte às versões, extensões, drivers e opções de configuração do PostgreSQL dos quais a carga de trabalho depende. A compatibilidade deve ser testada com o aplicativo real, em vez de ser inferida pela alegação do provedor de que ele oferece suporte ao PostgreSQL.
Verifique quais versões do PostgreSQL estão disponíveis, com que rapidez as novas versões principais passam a ser suportadas e quais extensões estão habilitadas. Verifique o suporte para extensões como pgvector, PostGIS e quaisquer dependências específicas do aplicativo. Confirme também quais parâmetros, funções e comandos do PostgreSQL são restritos. Verifique se as restrições de superusuário afetam tabelas, funções ou extensões existentes e se os objetos presentes no seu banco de dados atual precisariam ser alterados. Equipes autogerenciadas geralmente executam o PostgreSQL no Ubuntu ou em outra distribuição Linux com acesso total ao SO, portanto, as dependências do sistema operacional devem ser identificadas precocemente.
- Solicite a lista completa de extensões suportadas e limitações específicas da versão.
- Pergunte se os drivers de aplicativos, ORMs e ferramentas padrão do PostgreSQL funcionam sem modificações.
- Teste todas as extensões necessárias e parâmetros de banco de dados antes da migração.
- Comprove restaurando um esquema representativo e executando as migrações e testes de integração do aplicativo.
- Um sinal de alerta é uma extensão crítica sem suporte ou a compatibilidade depender de soluções alternativas não documentadas.
Para cargas de trabalho de IA, o suporte ao pgvector é importante para a pesquisa vetorial junto com cargas de trabalho transacionais.
Principais conclusões sobre sistemas multiagentes, casos de uso de IA, avaliações e muito mais

7. Caminhos de migração do Postgres e outros bancos de dados
Verifique como o provedor oferece suporte à migração de dados inicial e à virada de chave final. Um método de migração que funciona para um banco de dados pequeno pode não ser prático para um sistema de produção que deve continuar atendendo ao tráfego durante a movimentação.
Pergunte se o serviço oferece suporte a replicação lógica, Change Data Capture (CDC), ferramentas nativas do PostgreSQL e serviços de migração de terceiros. Para migrações de outros mecanismos de banco de dados, verifique quais sistemas de origem são suportados e como a conversão de esquema, a validação de dados e as alterações de aplicativos são tratadas. Mover um banco de dados de produção de outros bancos de dados, como Oracle ou SQL Server, também requer conversão de esquema e testes de aplicativos.
- Pergunte se grandes bancos de dados podem migrar sem tempo de inatividade prolongado.
- Pergunte como as alterações contínuas são replicadas durante a janela de migração.
- Comprove migrando um conjunto de dados representativo, executando verificações de validação e medindo o tempo final da virada de chave.
- Um sinal de alerta é um processo de migração que depende inteiramente de despejo e restauração (dump and restore) ou requer tempo de inatividade prolongado do aplicativo.
Sua solução de migração deve levar em conta as dependências em todo o seu ambiente de dados e minimizar as interrupções.
8. Preços e Custo Total de Propriedade
Um serviço gerenciado pode adicionar custos de armazenamento, backups, alta disponibilidade, réplicas, transferência de rede e outros recursos baseados em uso. Grande parte da economia em relação às implantações autogerenciadas vem de evitar hardware e manutenção locais, portanto, descubra quais recursos estão incluídos no preço base e quais são complementos pagos.
Verifique como a computação, armazenamento, IOPS, backups, réplicas e saída de rede são cobrados. Verifique se os preços mudam com o dimensionamento automático, capacidade em espera ou configurações de maior disponibilidade.
- Modele o uso normal e de pico, incluindo o crescimento do armazenamento e a retenção de backup.
- Calcule o Custo Total de Propriedade (TCO) durante o período de contrato esperado.
- Comprove construindo um modelo de TCO de 12 meses que cubra computação, capacidade em espera de alta disponibilidade, IOPS, backups, réplicas e saída de rede para sua carga de trabalho esperada. Não use apenas a linha de computação.
- Um sinal de alerta é um preço que mostra apenas a computação do banco de dados enquanto deixa o armazenamento, backups, réplicas ou custos de rede pouco claros.
A precificação baseada em uso pode facilitar o alinhamento dos custos com a demanda da carga de trabalho, mas as equipes ainda devem modelar padrões de tráfego realistas antes de se comprometerem.
9. Operações, monitoramento e solução de problemas
Um serviço de produção precisa de visibilidade suficiente para que as equipes de banco de dados entendam o que está acontecendo quando o desempenho ou a confiabilidade diminuem. Apenas as métricas de infraestrutura raramente são suficientes para diagnosticar problemas do PostgreSQL.
Pergunte se o serviço expõe métricas de banco de dados, logs e informações em nível de consulta, e se as equipes podem configurar alertas para condições importantes. Descubra qual suporte os engenheiros têm durante incidentes e se especialistas em PostgreSQL estão disponíveis para escalonamentos. Procure painéis com visibilidade em tempo real das métricas do sistema e verifique se os logs podem ser filtrados por banco de dados ou usuário e se você pode classificar eventos por horário ou gravidade. Considere também se sua equipe tem as habilidades necessárias para solucionar problemas do PostgreSQL usando apenas as ferramentas do provedor.
- Pergunte quais métricas, logs e estatísticas de consulta do PostgreSQL estão disponíveis.
- Pergunte se os dados de monitoramento podem ser exportados para a plataforma de observabilidade existente da organização.
- Comprove isso gerando um problema de desempenho controlado e usando as ferramentas disponíveis para identificar a causa raiz.
- Um sinal de alerta é a visibilidade limitada em nível de banco de dados ou um modelo de suporte que não consegue investigar problemas específicos do PostgreSQL.
Para grandes implantações, pergunte se as ferramentas do provedor podem identificar padrões em todos os seus bancos de dados, e não apenas métricas por instância.
10. Portabilidade e saída
Um serviço gerenciado do Postgres deve viabilizar a movimentação de dados e aplicativos para outro ambiente PostgreSQL sem depender de processos de exportação proprietários.
Pergunte se as ferramentas padrão do PostgreSQL e a replicação lógica podem ser usadas para exportar dados. Descubra se extensões, APIs ou formatos de armazenamento específicos do provedor tornariam a saída mais difícil. Quanto mais recursos exclusivos do provedor um aplicativo utilizar, mais difícil será a saída.
- Pergunte como funciona uma exportação completa de banco de dados e se ela pode ser executada sem o suporte do provedor.
- Pergunte se a replicação lógica pode transmitir dados para outro ambiente PostgreSQL.
- Comprove isso restaurando uma exportação em um ambiente PostgreSQL separado e executando testes de aplicativo.
- Um sinal de alerta são dados que só podem ser exportados por meio de uma solicitação de suporte ou de um formato proprietário.
Como executar um piloto antes de se comprometer
Um piloto deve testar as promessas do provedor em uma carga de trabalho semelhante à de produção. Uma lista de verificação de recursos pode mostrar o que um serviço oferece, mas testes controlados de falha e recuperação mostram se essas funcionalidades funcionam quando são necessárias.
Comece com um banco de dados representativo, tráfego de aplicativos e as extensões do PostgreSQL exigidas pelo sistema de produção. Em seguida, teste as áreas com maior probabilidade de influenciar a decisão. Se preferir uma abordagem em fases, comece com uma carga de trabalho não crítica e expanda o piloto gradualmente.
- Execute um failover e meça o tempo de recuperação, a recuperação de conexões e as transações perdidas.
- Restaure o banco de dados para um ponto específico no tempo e compare o resultado com os RPO e RTO esperados.
- Aplique carga de pico representativa e teste o dimensionamento com o aplicativo ainda ativo.
- Execute testes de migração e reversão, incluindo todas as extensões e alterações de aplicativo necessárias.
- Teste o monitoramento e o escalonamento de suporte.

Registre os resultados em relação aos requisitos originais e trate os testes com falha como pontos de decisão. A ramificação de banco de dados também pode ajudar as equipes a criar ambientes isolados para testes de migração e aplicativos. Capture os resultados de forma consistente para que a discussão pós-piloto entre as equipes de engenharia, segurança e finanças permaneça objetiva.
Como o Lakebase se alinha a esta lista de verificação
Lakebase se alinha bem a várias áreas abordadas nesta lista de verificação. A tabela abaixo mostra onde seus recursos atendem aos requisitos comuns de produção, além de áreas que ainda precisam de uma avaliação mais detalhada.
| Área da lista de verificação | Como o Lakebase se alinha |
|---|---|
| Operações | Postgres gerenciado e serverless com operações de infraestrutura automatizadas. |
| Alta disponibilidade | Promoção automática entre zonas de disponibilidade, preservando as transações confirmadas. As conexões existentes precisam se reconectar após o failover. |
| Dimensionamento | Autoscale com computação separada do armazenamento, permitindo que a capacidade se ajuste à demanda da carga de trabalho. |
| Segurança | Dá suporte a redes privadas e chaves gerenciadas pelo cliente, além dos recursos de governança do Databricks. |
| Compatibilidade com PostgreSQL | Dá suporte a ferramentas e extensões do PostgreSQL, incluindo o pgvector. |
| Recuperação de desastres | A DR entre regiões está atualmente em Private Preview na AWS com failover manual. Se a DR regional for um requisito rígido, entre em contato com a equipe da sua conta para obter mais informações. |
| Custo | A precificação baseada em uso pode alinhar os custos à demanda da carga de trabalho, mas as equipes devem modelar a carga de trabalho esperada e os padrões de uso. |
| Portabilidade | A compatibilidade padrão com PostgreSQL fornece uma base para testes de migração e saída, mas as dependências específicas do provedor ainda devem ser avaliadas. |
A lista de verificação oferece às equipes uma maneira consistente de comparar o Lakebase, outros serviços gerenciados do Postgres e implantações auto-gerenciadas com seus requisitos de produção.
Para equipes que estão avaliando o Postgres gerenciado, a questão importante é quanto do trabalho operacional é realmente retirado de suas mãos. O Lakebase gerencia a maior parte desse trabalho em uma região, enquanto a recuperação de desastres entre regiões continua sendo uma área em que as equipes ainda têm responsabilidades.
O Lakebase Postgres promove automaticamente a computação secundária entre zonas de disponibilidade, preservando as transações confirmadas e mantendo a string de conexão inalterada. As conexões existentes ainda precisam se reconectar.

O Lakebase documenta a recuperação de desastres entre regiões como uma Private Preview na AWS com failover manual, o que deve ser considerado quando a recuperação regional for um requisito de produção.
O Lakebase também separa a computação do armazenamento e dá suporte a autoscale, permitindo que a capacidade se ajuste à demanda da carga de trabalho em vez de depender apenas de tamanhos fixos de banco de dados.
Para equipes que usam o Databricks, redes privadas e chaves gerenciadas pelo cliente fornecem controles adicionais para proteger as implantações do Lakebase.
Perguntas frequentes
O que devo procurar em um serviço gerenciado do Postgres?
Concentre-se nos recursos que afetam a confiabilidade e as operações de produção. Alta disponibilidade, backups, recuperação para um ponto específico no tempo, recuperação de desastres, dimensionamento, segurança, compatibilidade com PostgreSQL, migração, custo e portabilidade devem ter respostas claras. Os provedores também devem ser capazes de demonstrar declarações importantes por meio de documentação e um piloto semelhante à produção. Cada tópico desta lista de verificação deve ter uma resposta documentada antes de você se comprometer.
Quais são os benefícios de um serviço gerenciado do Postgres?
Um serviço gerenciado pode reduzir o trabalho operacional envolvido na execução do PostgreSQL, assumindo a responsabilidade pela infraestrutura, manutenção, backups e outras tarefas rotineiras. Ele também pode fornecer recursos integrados de disponibilidade, dimensionamento, segurança e monitoramento. O valor depende de quanta responsabilidade operacional o provedor realmente assume e se o serviço ainda fornece os controles que a carga de trabalho exige.
Qual é a diferença entre o Postgres gerenciado e o Postgres auto-gerenciado?
O Postgres gerenciado transfere grande parte do trabalho de infraestrutura e administração de banco de dados para o provedor. O Postgres auto-gerenciado oferece às equipes de engenharia maior controle sobre infraestrutura, configuração, extensões e atualizações, mas também as torna responsáveis por operar esses componentes. A escolha certa depende da capacidade operacional, dos requisitos de controle e da carga de trabalho da organização.
Como devo testar um serviço gerenciado do Postgres antes da migração?
Use uma carga de trabalho representativa e teste os recursos mais importantes para a produção. Execute testes de failover, recuperação para um ponto específico no tempo, dimensionamento, migração e reversão. Meça os tempos de recuperação, o comportamento de conexão, a integridade dos dados e o desempenho do aplicativo. O piloto também deve abranger monitoramento, escalonamento de suporte e exportação de dados. Qualquer recurso que não possa ser demonstrado deve permanecer como um risco em aberto.
(Esta publicação no blog foi traduzida utilizando ferramentas baseadas em inteligência artificial) Publicação original
Receba os posts mais recentes na sua caixa de entrada
Assine nosso blog e receba os posts mais recentes diretamente na sua caixa de entrada.