Cómo sacar el máximo provecho al ejecutar dbt en Databricks
Haz que los pipelines de dbt en Databricks sean más económicos, rápidos y sencillos de operar.
- Evita integrar distintas herramientas y mantén todo el pipeline en un solo proyecto de dbt en Databricks, desde la ingesta en streaming hasta las definiciones de métricas gobernadas
- Orquesta dbt de forma nativa en Lakeflow Jobs sin necesidad de un orquestador externo.
- Define la gobernanza en el propio proyecto de dbt, de modo que Unity Catalog aplique las reglas de acceso directamente desde las configuraciones de tu proyecto.
Decenas de miles de organizaciones confían en dbt para la transformación de datos. El lugar donde lo ejecutas lo condiciona todo: cuánto cuesta ejecutar tus pipelines de dbt, qué tan rápido se entregan y cuánta carga operacional conllevan. Ejecutar dbt en Databricks proporciona a tus cargas de trabajo de dbt una plataforma abierta y un pipeline unificado.
Más de 3000 organizaciones ejecutan dbt en Databricks, y la mayoría de los equipos podrían sacarle mucho más provecho. Este blog destaca las prácticas que hacen que los pipelines de dbt sean más económicos, rápidos y sencillos de operar en Databricks.
Haz que tus pipelines de dbt sean más económicos y rápidos
Las facturas de dbt aumentan debido al trabajo que no necesitas repetir. Las reconstrucciones completas vuelven a calcular datos que no han cambiado, mantener las consultas rápidas requiere ajuste manual y, cuando la factura se dispara, no hay una atribución clara hacia los modelos de dbt que la causaron. Adopta las prácticas de esta sección y tus pipelines:
- Reconstruirán solo los datos que realmente hayan cambiado
- Se mantendrán rápidos sin necesidad de elegir o reelaborar claves de partición
- Ejecutarán el mantenimiento de las tablas de forma automática sin post-hooks
- Rastrearán cada dólar de gasto hasta un modelo específico
1. Construye solo lo que haya cambiado con estrategias incrementales
Las reconstrucciones completas de tablas son el mayor coste evitable en la mayoría de los proyectos de dbt. Cuando solo una pequeña fracción de los datos cambia entre ejecuciones, volver a calcular toda la tabla desperdicia tus recursos de cómputo y aumenta tu factura. Las estrategias incrementales de dbt, todas compatibles con dbt-databricks, permiten que cada modelo procese solo los datos nuevos, y la elección correcta depende de cómo llegan realmente tus datos.
Estrategia | Úsala cuando |
|---|---|
append | Las filas solo se insertan, nunca se actualizan |
merge | La misma clave puede llegar más de una vez y requiere una operación de upsert (dimensiones de cambio lento, deduplicación, actualizaciones de llegada tardía) |
replace_where | El modelo vuelve a derivar una ventana de tiempo reducida en cada ejecución, como los últimos días de actividad |
insert_overwrite | Tu consulta devuelve particiones enteras |
delete+insert | Deseas reemplazar registros por clave, sin lógica de actualización a nivel de columna |
microbatch | Datos de series temporales con una columna event_time y necesidades de backfill estructurado |
La mayoría de los proyectos recurren por defecto a merge cuando bastaría con una estrategia más acotada. Si puedes describir los datos modificados con un predicado, replace_where realiza menos trabajo que un merge que debe escanear el destino para encontrar coincidencias. Si no puedes, incremental_predicates en merge reduce considerablemente ese escaneo.
Cada estrategia anterior es una decisión que tomas y debes mantener. La siguiente práctica permite que la plataforma se encargue de esto por ti.
2. Deja que las vistas materializadas gestionen la incrementalización por ti
Las vistas materializadas automatizan la incrementalización. Puedes definir el modelo como SQL plano, y Databricks rastrea qué datos subyacentes han cambiado y actualiza solo los resultados afectados. En dbt-databricks, una vista materializada es una materialización nativa, por lo que se trata de un cambio de configuración de una sola línea:
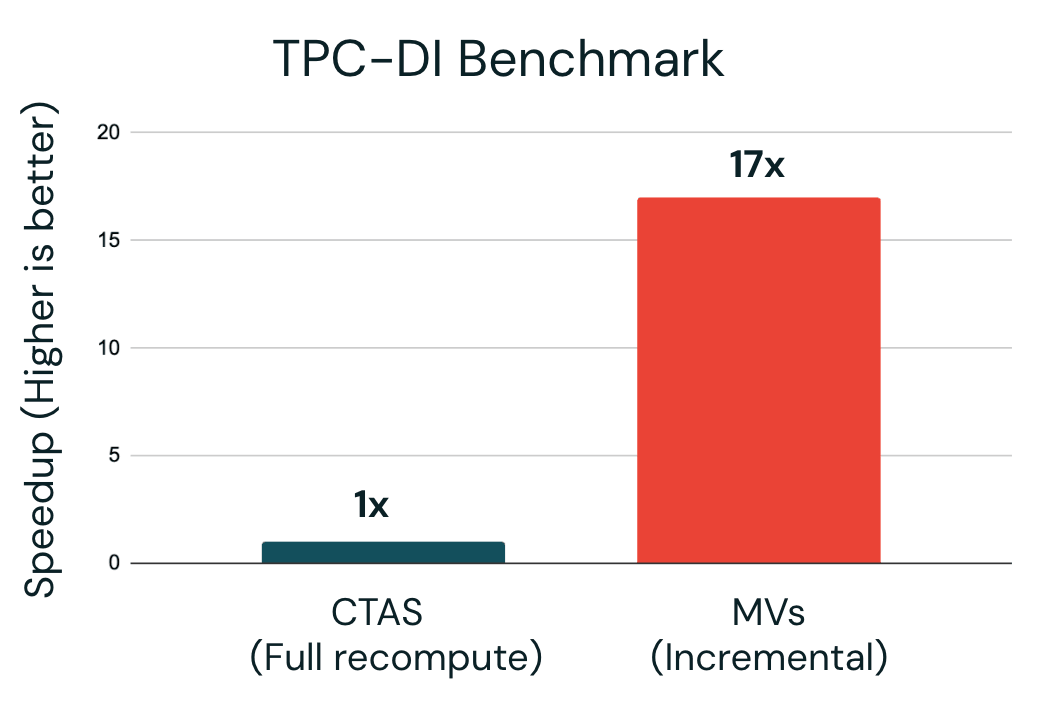
Las vistas materializadas se adaptan mejor a la capa de servicio (serving layer): agregaciones sobre fuentes que cambian con frecuencia, especialmente las más costosas que respaldan paneles de control y necesitan mantenerse actualizadas. En nuestra prueba de rendimiento TPC-DI, cambiar los cálculos completos por vistas materializadas en la capa de servicio ofreció una aceleración de 17x.
3. Automatiza la disposición de los datos para la optimización del rendimiento
Elegir claves de partición, reelaborarlas cuando cambian los patrones de consulta y programar OPTIMIZE, VACUUM y ANALYZE en post-hooks requiere tiempo de ingeniería.
Predictive Optimization ejecuta OPTIMIZE, VACUUM y la recopilación de estadísticas en tablas administradas de forma automática, eligiendo qué ejecutar y cuándo según cómo se consulte cada tabla. Habilítalo una vez a nivel de catálogo o esquema, y podrás retirar los post-hooks que los proyectos de dbt suelen acumular para el mantenimiento de tablas.
Para la disposición de datos, Liquid Clustering sustituye el diseño de particiones por una disposición con ajuste automático. Organiza los datos en función de cómo se consulta realmente la tabla, evita la explosión de archivos pequeños que sufren las tablas sobreparticionadas y se adapta a medida que cambian los patrones de consulta. O deja que Databricks los elija y los ajuste a partir del historial de consultas con el Liquid Clustering automático (CLUSTER BY AUTO), impulsado por Predictive Optimization. Una única configuración a nivel de proyecto aplica clustering a cada tabla nueva que cree el proyecto.
Ambas funciones están diseñadas como decisiones únicas. Con las actualizaciones automáticas, las tablas administradas de Unity Catalog continúan incorporando nuevas optimizaciones a medida que Databricks las lanza.
4. Atribuye cada dólar con etiquetas de consulta
Al final del trimestre, el departamento de finanzas pregunta por qué aumentó la factura del warehouse. En la mayoría de las configuraciones nadie puede responder, porque una consulta en los datos de uso no guarda ninguna relación con el modelo de dbt que la emitió.
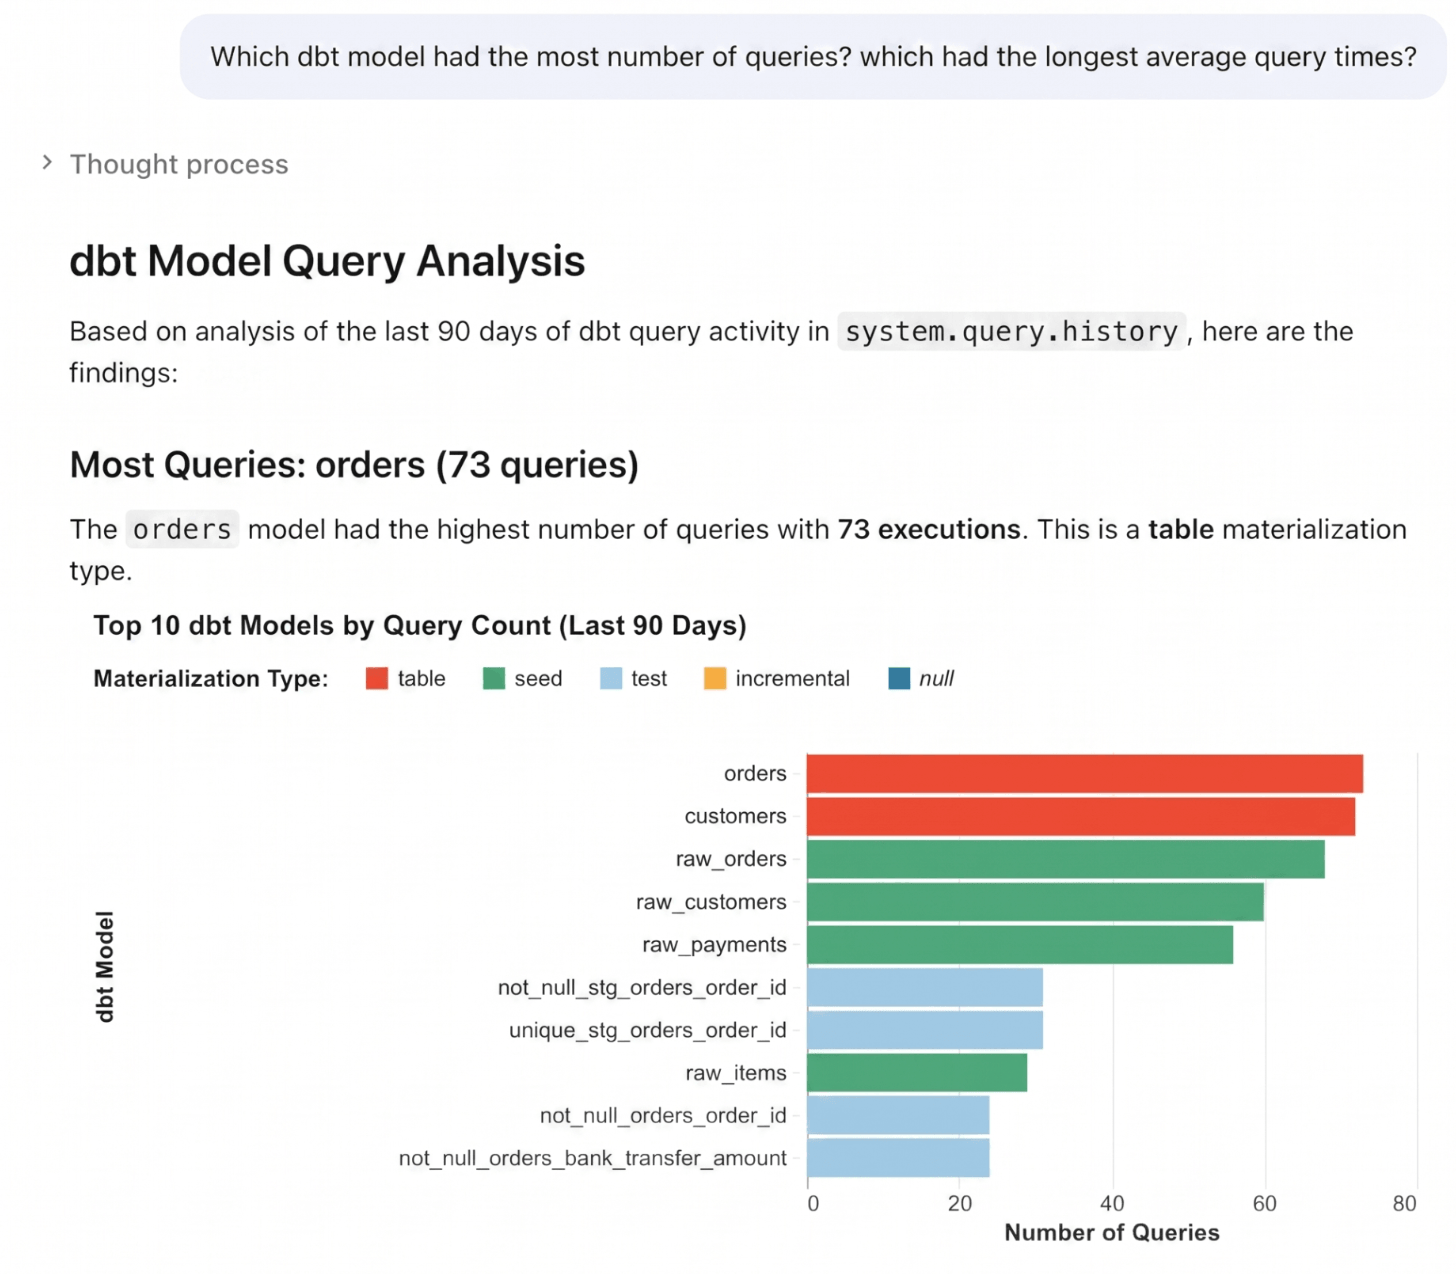
Las etiquetas de consulta hacen que la conexión sea automática. Cada consulta que dbt ejecuta en Databricks queda marcada automáticamente con el nombre del modelo, la versión de dbt y el tipo de materialización. Añade tus propias etiquetas personalizadas para las dimensiones según las cuales tu organización elabora sus presupuestos:
Las etiquetas se muestran en system.query.history y, al combinarlas con system.billing.usage, atribuyen el gasto del warehouse serverless a cualquier agrupación admitida por las etiquetas: costo por modelo, por equipo, por dominio o por materialización. Puedes ver exactamente qué modelos cuestan más.
Simplifica tus pipelines de dbt
Una configuración típica de dbt se apoya en un conjunto de otras herramientas: un sistema independiente para ingestar los datos, un orquestador externo para ejecutar el proyecto, herramientas de BI en las que cada una vuelve a definir las mismas métricas y una gobernanza que vive fuera de tu proyecto de dbt. Cada una representa un elemento más que mantener y un punto más en el que las cosas pueden desalinearse. Adopta las prácticas de esta sección y un solo proyecto de dbt podrá:
- Ingestar datos directamente en el proyecto
- Ejecutarse y desplegarse desde Databricks, sin necesidad de mantener un orquestador de terceros
- Ofrecer una única definición de métrica gobernada a cada herramienta
- Incluir sus propias reglas de gobernanza, con control de versiones junto a tus modelos de dbt
1. Incorpora la ingesta al proyecto de dbt con Streaming Tables
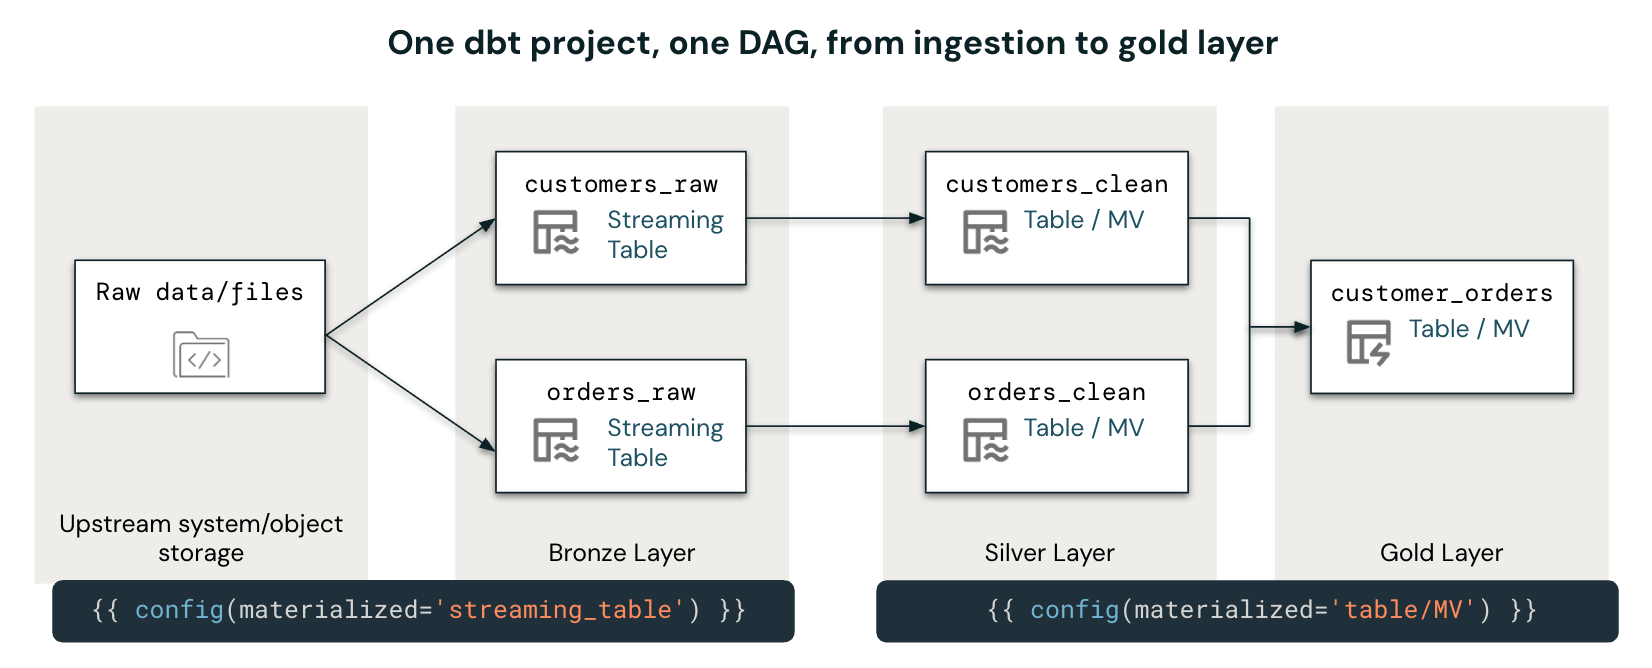
La ingesta es la parte del pipeline que tradicionalmente ha quedado fuera de dbt, lo que genera una arquitectura dividida sin una visión unificada del linaje. La materialización streaming_table elimina esa división. Un modelo de dbt materializado como una streaming table recoge de forma incremental los nuevos archivos o eventos a medida que llegan, por lo que la ingesta se convierte en un modelo más dentro del DAG.
A partir de ahí, el resto del pipeline (modelos silver y gold) puede hacer referencia a la streaming table con ref(), las pruebas y la documentación se aplican a cada capa, y el linaje abarca todo el recorrido, desde los archivos sin procesar hasta el mart final.
2. Estandariza las métricas con Unity Catalog Semantics
Cada herramienta de BI, agente u otro consumidor de datos crea sus propias definiciones de métricas, lo que genera confusión y desacuerdos entre los interesados. Una metric view traslada la definición a un único lugar gobernado: declaras las medidas y dimensiones una sola vez y todos los consumidores consultan la misma lógica.
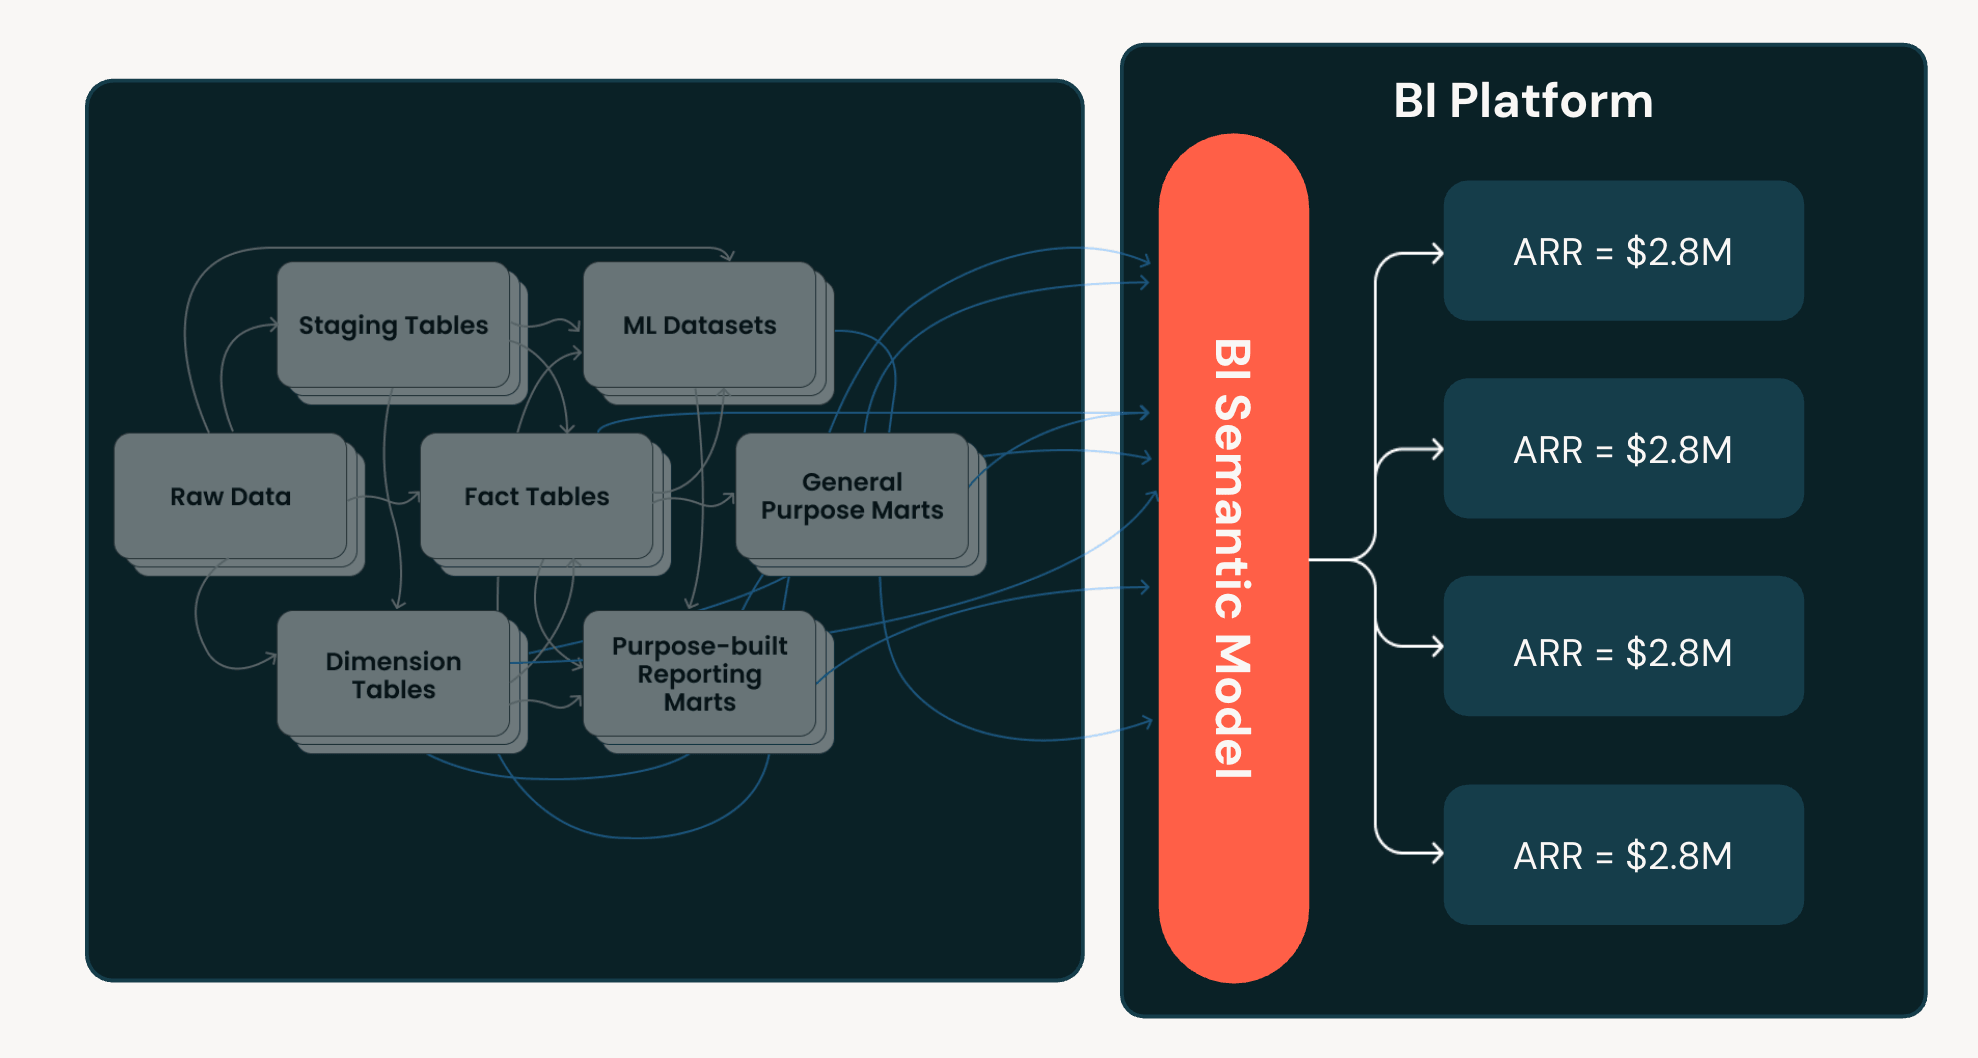
dbt-databricks ofrece metric views como un tipo de materialización nativo, de modo que la definición permanece en tu proyecto de dbt, con control de versiones y revisión como cualquier otro modelo.
Los usuarios pueden elegir sus propias agrupaciones al momento de realizar la consulta con la función MEASURE(), por lo que la misma definición sirve para el editor de SQL, los tableros de BI, los notebooks y Genie.
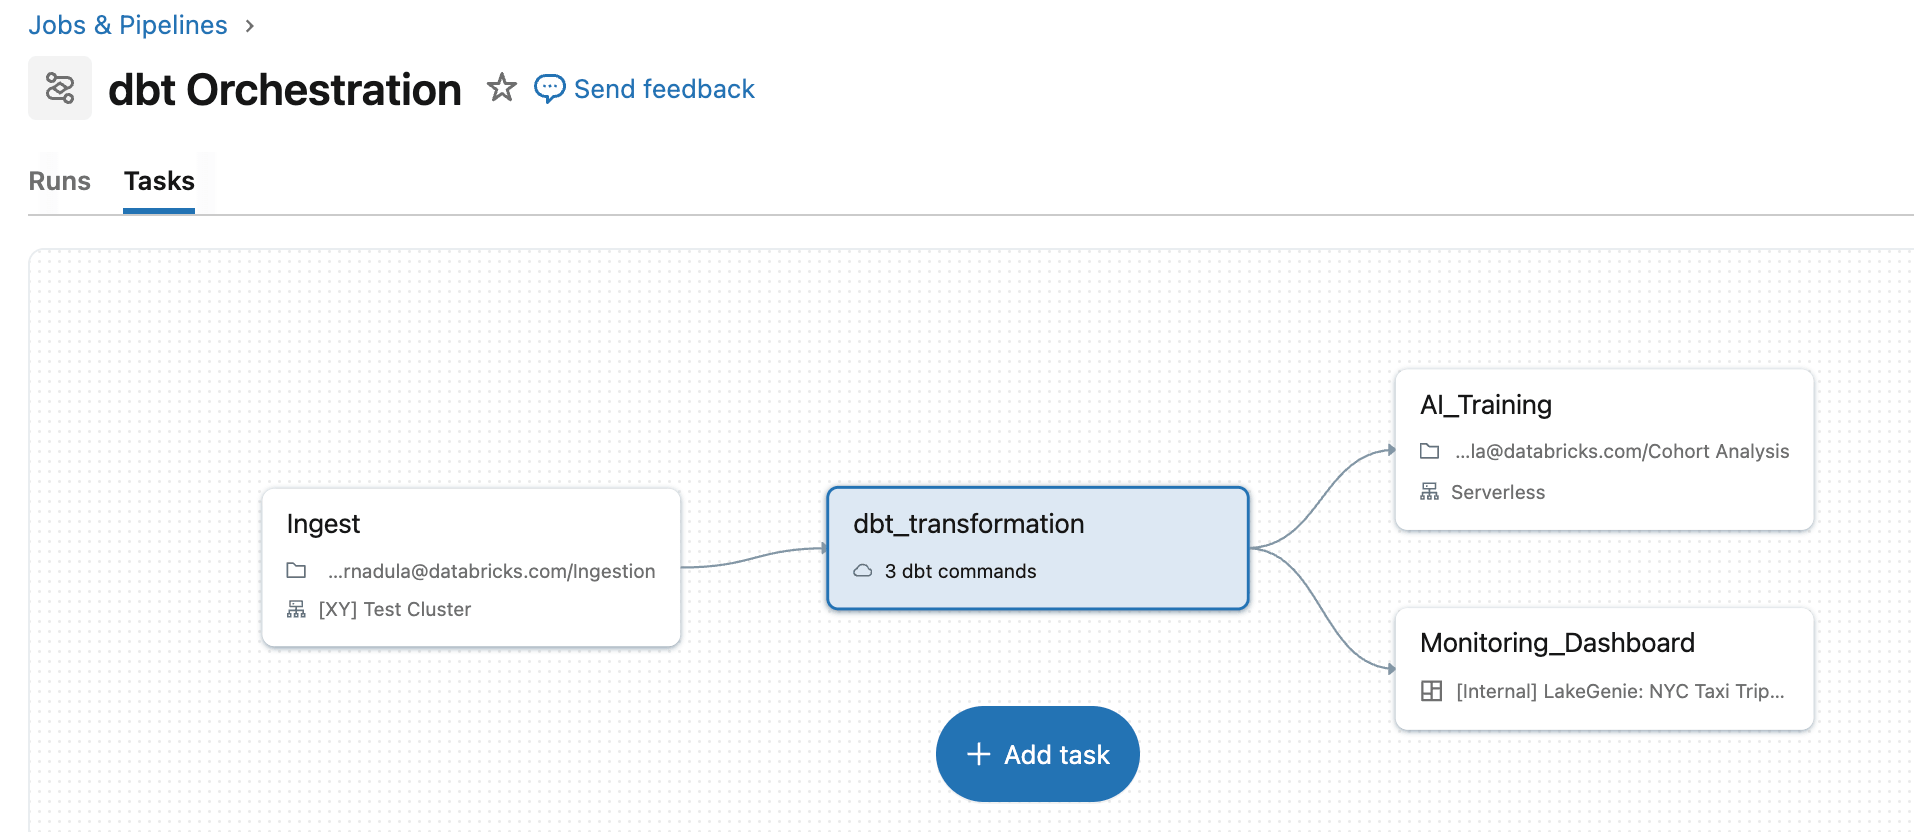
3. Orquesta dbt de forma nativa con Lakeflow Jobs
Una ejecución de dbt rara vez constituye todo el pipeline. Cuando los pasos ascendentes y descendentes residen en herramientas distintas, el costo operativo se acumula: herramientas adicionales que gestionar, pagar y proteger, además de un linaje disperso.
Lakeflow Jobs simplifica todo esto en un único gráfico acíclico dirigido (DAG) con dbt como una tarea nativa. Una tarea de ingesta alimenta la tarea de dbt y las tareas descendentes se activan al finalizar, con dependencias gestionadas por la plataforma. La capa operativa viene integrada con programación, reintentos automáticos, historial de ejecuciones y alertas, sin infraestructura adicional que mantener. Jobs admite dbt Core y dbt Platform, y la compatibilidad con dbt Core v2.0 llegará pronto.
4. Despliega como código con Declarative Automation Bundles
Un trabajo montado a mano en la interfaz de usuario es difícil de versionar, revisar o reproducir. Declarative Automation Bundles (DAB) solucionan esto haciendo que la definición del trabajo forme parte del repositorio de código. El trabajo de Lakeflow, su programación, la configuración de computación y el proyecto de dbt se declaran en YAML y se despliegan como un solo paquete.
Desplegar con --target dev crea una copia aislada de todo el pipeline; --target prod lo promueve.
No todos los modelos de un proyecto necesitan ejecutarse en cada programación. Etiqueta los modelos por cadencia en el archivo YAML de dbt y asigna a cada cadencia su propio trabajo que cree solo los modelos que contengan su etiqueta. Cambiar un modelo de diario a por hora se convierte en un cambio de una sola línea:
5. Define la gobernanza en el proyecto
La gobernanza se suele configurar después de ejecutar los modelos, de forma independiente del proyecto de dbt que genera los datos. Como la gobernanza se encuentra fuera de tu proyecto de dbt, puede dessincronizarse de las ejecuciones de dbt.
Define la gobernanza en el proyecto de dbt en el que ya viven los modelos. Al ser parte de la configuración del proyecto, se distribuye con el código, se revisa como el código y Unity Catalog la aplica en cada consulta.
Las etiquetas, las concesiones (grants) y la protección a nivel de filas y columnas se pueden definir en la configuración general del proyecto en dbt_project.yml. databricks_tags gestiona la clasificación y las directivas, grants controla quién puede leer la tabla, y row_filters y column_masks controlan lo que ve cada usuario:
A escala, el control de acceso basado en atributos (ABAC) elimina la repetición. Defina una directiva en una etiqueta gobernada y esta aplicará los filtros de filas y las máscaras de columnas adecuados a cada tabla que lleve esa etiqueta, de modo que un nuevo modelo etiquetado como pii quede cubierto en cuanto se cree. Recurra a los filtros y máscaras por modelo solo cuando la lógica sea verdaderamente específica del modelo, como el aislamiento multinquilino.
El hilo conductor de estas prácticas es delegar el trabajo operativo a la plataforma: procesamiento incremental, distribución de datos, mantenimiento de tablas, aplicación de la gobernanza y orquestación. Lo que permanece en su proyecto de dbt es su lógica de transformación probada y con control de versiones. Elija la práctica que resuelva la dificultad actual de su proyecto y empiece por ahí.
Únase a las más de 3000 organizaciones que ya ejecutan dbt en Databricks. Comience hoy mismo con el adaptador dbt-databricks.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.