Postgres administrado: lo que Lakebase realmente te quita de encima
Descubra qué automatiza realmente Lakebase en Postgres administrado —aplicación de parches, escalado, conmutación por error y copias de seguridad— y dónde sigue recayendo la responsabilidad en usted.
- Postgres administrado debería liberar al equipo de bases de datos de las operaciones rutinarias, como la aplicación de parches, el escalado, la conmutación por error y las copias de seguridad.
- Lakebase ejecuta PostgreSQL en una infraestructura serverless con escalado automático, escalado a cero, recuperación en un punto en el tiempo, ramificación, pgvector y PostGIS.
- Lakebase gestiona la mayoría de las operaciones de Postgres administrado dentro de una región, mientras que la recuperación ante desastres entre regiones sigue requiriendo procedimientos de recuperación gestionados por el cliente.
Cada proveedor de Postgres se autodenomina "administrado". Pocos están de acuerdo con lo que cubre esa palabra. Algunos se refieren a que aplican parches al sistema operativo (OS) y dejan el resto en manos del equipo de la base de datos. Otros se refieren a que la base de datos escala, gestiona fallos y realiza copias de seguridad por sí misma sin que nadie del equipo tenga que tocar un archivo de configuración.
Postgres administrado es un servicio de base de datos en el que el proveedor opera la infraestructura subyacente y se encarga de las operaciones principales de la base de datos, como el parcheo, el escalado, la conmutación por error y las copias de seguridad, de modo que el equipo de la base de datos dedica menos tiempo al mantenimiento y más tiempo a crear la aplicación que se ejecuta sobre ella. Cuantas más de estas operaciones asuma el proveedor, menos administración de la base de datos recaerá en el cliente.
Esta distinción cobra más importancia a medida que Postgres se introduce en las aplicaciones de AI. Ahora, la base de datos puede albergar el estado de la aplicación, el historial de conversaciones, los embeddings y los datos de los agentes, junto con las cargas de trabajo transaccionales tradicionales, por lo que la superficie operativa se extiende más allá de mantener la base de datos en funcionamiento.
Lakebase Postgres lleva ese enfoque administrado a Postgres serverless, combinando el escalado automático, la compatibilidad con PostgreSQL, la recuperación y las integraciones de Databricks. La pregunta es cuánto trabajo operativo elimina realmente.
TL;DR
- Postgres administrado debería liberar al equipo de la base de datos de las operaciones rutinarias, como el parcheo, el escalado, la conmutación por error y las copias de seguridad.
- Lakebase ejecuta PostgreSQL en una infraestructura serverless con escalado automático, escalado a cero (scale-to-zero), instantáneas automáticas, recuperación a un punto en el tiempo, ramificación (branching) y soporte para extensiones populares como pgvector y PostGIS.
- Lakebase gestiona la mayoría de las operaciones de Postgres administrado dentro de una región.
Qué significa realmente Postgres administrado
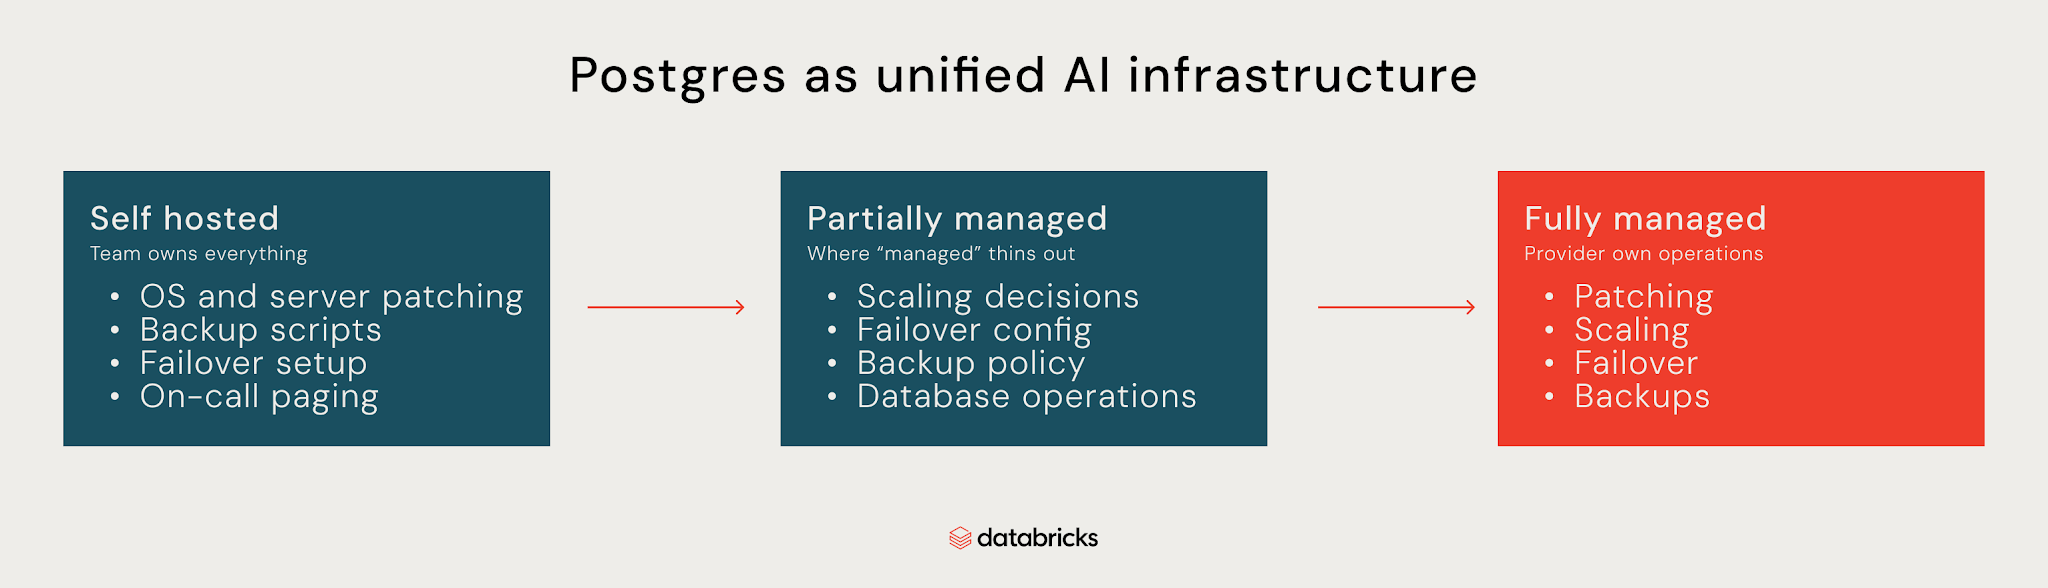
Piense en el Postgres administrado como si entregara las llaves de una base de datos. La cantidad de responsabilidades que un equipo transfiere depende del proveedor. En un extremo, el equipo de la base de datos sigue encargándose del servidor, las copias de seguridad, la conmutación por error y el escalado. En el otro, un servicio totalmente administrado se encarga del trabajo operativo para el equipo, no solo de la infraestructura subyacente. La mayoría de los proveedores se sitúan en un punto intermedio, gestionando la VM y la red, mientras dejan en manos del equipo algunas operaciones de la base de datos, las decisiones de escalado, la configuración de la conmutación por error y las políticas de copia de seguridad.
Un proveedor puede aplicar parches al OS y decir que la base de datos está administrada, mientras que el equipo sigue siendo responsable del trabajo que la mantiene disponible y recuperable.
El parcheo, el escalado, la conmutación por error y las copias de seguridad son un buen punto de partida para trazar esa línea. Un servicio administrado también determina qué parte de la seguridad, la recuperación, la migración, las cargas de trabajo de AI y las herramientas de desarrollo en torno a Postgres debe seguir asumiendo su equipo.
Postgres administrado es un servicio en el que el proveedor opera la infraestructura de la base de datos y se encarga de las tareas operativas principales, como el parcheo, el escalado, la conmutación por error y las copias de seguridad. Un servicio totalmente administrado asume la responsabilidad de esas operaciones, de modo que su equipo pueda concentrarse en desarrollar sobre Postgres en lugar de ejecutarlo.
Qué debería gestionar Postgres administrado
La prueba más clara de en qué parte de ese espectro se encuentra un servicio es si libera al equipo de estas cuatro tareas operativas:
Mantenimiento y parcheo
Un proveedor administrado debería aplicar parches de OS, versiones secundarias de PostgreSQL y realizar tareas de mantenimiento rutinarias como el ajuste de vacuum (vacuum tuning) sin que el equipo de la base de datos tenga que programar o ejecutar nada de esto manualmente, a diferencia de un Postgres autohospedado, donde todo eso recae sobre ellos. Las actualizaciones de versiones principales siguen requiriendo planificación, ya que las extensiones y el comportamiento de la aplicación pueden cambiar, pero un buen proveedor reduce al mínimo esa intervención y ofrece una ruta de actualización clara.
Escalado
La capacidad debería ajustarse a la carga de trabajo sin que los ingenieros de plataforma tengan que redimensionar la infraestructura manualmente: escalado vertical para obtener más cómputo o memoria, réplicas de lectura para el tráfico de lectura e, idealmente, un escalado serverless que elimine por completo esa decisión. El escalado automático de Lakebase es un ejemplo en producción, que permite realizar escrituras en Postgres 5 veces más rápidas que el Postgres estándar. La verdadera prueba es un pico de tráfico: si el equipo de la base de datos está vigilando la utilización y esperando un redimensionamiento, el escalado sigue siendo su trabajo.
Alta disponibilidad y conmutación por error
La base de datos debería permanecer activa cuando la infraestructura falle, sin que un ingeniero de guardia tenga que promover manualmente una réplica a las 2 de la mañana. Algunos proveedores gestionan esto con instancias en espera (standby) que asumen el control automáticamente; otros, como Lakebase, reemplazan por completo el cómputo fallido, ya que no contiene un estado local duradero. Aun así, no todos los proveedores realizan la conmutación por error a la misma velocidad o con la misma pérdida de datos. Algunos pierden segundos de escrituras en el proceso; otros no pierden nada. Ese es el detalle que vale la pena verificar antes de confiar en la etiqueta, incluyendo si existe la conmutación por error y qué sucede con las escrituras en curso cuando esta se activa.
Copias de seguridad y recuperación
Las copias de seguridad automáticas y un proceso de restauración que los equipos puedan ejecutar sin necesidad de un ticket de soporte son el punto de partida. La recuperación a un punto en el tiempo (PITR), que permite restaurar a un momento específico en lugar de solo a la última instantánea (snapshot), es fundamental cuando una mala migración corrompe los datos a media tarde. La caída de una región completa es un problema mayor, medido por el objetivo de tiempo de recuperación (RTO), que indica cuánto tiempo se está inactivo, y el objetivo de punto de recuperación (RPO), que define cuántos datos se puede permitir perder; un proveedor que no tenga números definidos para ambos no tiene un plan de recuperación ante desastres, solo una suposición.
Cómo protege sus datos Postgres administrado
Una base de datos administrada debe cifrar los datos en reposo y en tránsito, controlar quién puede acceder a ellos y ofrecer a los equipos de datos visibilidad sobre la actividad de la base de datos. Eso significa:
- Cifrado: Los datos necesitan protección en reposo y en tránsito, tanto en el disco como al moverse entre su aplicación y la base de datos. El detalle que vale la pena verificar es quién controla las claves, ya que algunos proveedores gestionan el cifrado por completo de su lado, lo que se convierte en un problema en el momento en que un requisito de cumplimiento o una política interna exige que la organización las posea. Las claves administradas por el cliente le otorgan ese control, al tiempo que dejan las operaciones subyacentes de la base de datos en manos del proveedor.
- Control de acceso: El control de acceso basado en roles se encarga de lo básico (diferentes usuarios y servicios obtienen diferentes privilegios), pero los sistemas de producción a menudo necesitan más, y las industrias que manejan datos de pago deben cumplir además con estándares como el Estándar de Seguridad de Datos para la Industria de Tarjetas de Pago (PCI DSS). El control de acceso basado en atributos a través de Unity Catalog amplía aún más esas políticas al considerar las propiedades del usuario, el recurso o la solicitud, en lugar de depender únicamente de los roles.
- Registro de auditoría: Sin visibilidad sobre quién hizo qué y cuándo, investigar un incidente se vuelve más difícil, al igual que demostrar el cumplimiento normativo. El registro de auditoría debería ofrecer a los equipos de datos visibilidad sobre la actividad administrativa y de la base de datos de forma predeterminada, en lugar de ser algo que tengan que configurar, operar y mantener como un pipeline independiente sobre la base de datos.
Qué tener en cuenta al migrar una base de datos PostgreSQL existente
Una migración puede parecer sencilla hasta que la nueva base de datos no admite una extensión, configuración o función de PostgreSQL de la que depende una aplicación. Verifique de qué depende la aplicación antes de mover nada. Estos son los aspectos clave que debe tener en cuenta al migrar una base de datos PostgreSQL existente:
- Compatibilidad: Verifique si la configuración actual se comporta de la misma manera en la nueva plataforma: soporte de versiones de PostgreSQL, configuración personalizada y suposiciones a nivel de aplicación que podrían no cumplirse una vez que cambie la infraestructura. La compatibilidad estándar con el protocolo de comunicación (wire protocol) de Postgres significa que las cadenas de conexión existentes, los mapeadores objeto-relacional (ORM), los controladores (drivers) y las herramientas tienen una posibilidad real de funcionar sin cambios en el código.
- Extensiones: La migración es el momento en que los equipos descubren si todas las extensiones de las que depende la base de datos completaron el viaje, así que verifique la lista de extensiones compatibles del proveedor con las que realmente están en uso antes de comprometerse con nada. Vale la pena verificar pgvector para cargas de trabajo de AI o embeddings, PostGIS es importante para datos geoespaciales, y vale la pena comprobar individualmente cualquier otra extensión de la que dependa una aplicación en lugar de asumir que una popular estará disponible.
- Métodos de migración: La migración basada en volcados (dump-based), que consiste en exportar y restaurar en la nueva plataforma, es sencilla y funciona para bases de datos más pequeñas o ventanas de mantenimiento planificadas. La replicación lógica mantiene el origen activo mientras transmite los cambios al destino, lo que permite a los equipos realizar la transición con una interrupción mucho menor una vez que ambos están sincronizados; la elección correcta depende del tamaño de la base de datos, el volumen de escritura y la cantidad de tiempo de inactividad que la empresa pueda asumir.
- Validación y transición: Una migración no termina solo porque los datos se hayan movido. Ejecute la carga de trabajo de consultas real en la nueva base de datos y compare los resultados y el rendimiento con el origen, ya que no basta con que coincida el número de filas; los planes de consulta, los tiempos de respuesta y el comportamiento de la aplicación deben mantenerse. Planifique la transición teniendo en cuenta un plan de rollback, de modo que el equipo sepa cómo volver a dirigir el tráfico si algo sale mal, en lugar de tener que resolverlo en medio de un incidente.
La guía de IA agéntica para la empresa

¿Es Postgres adecuado para aplicaciones de IA?
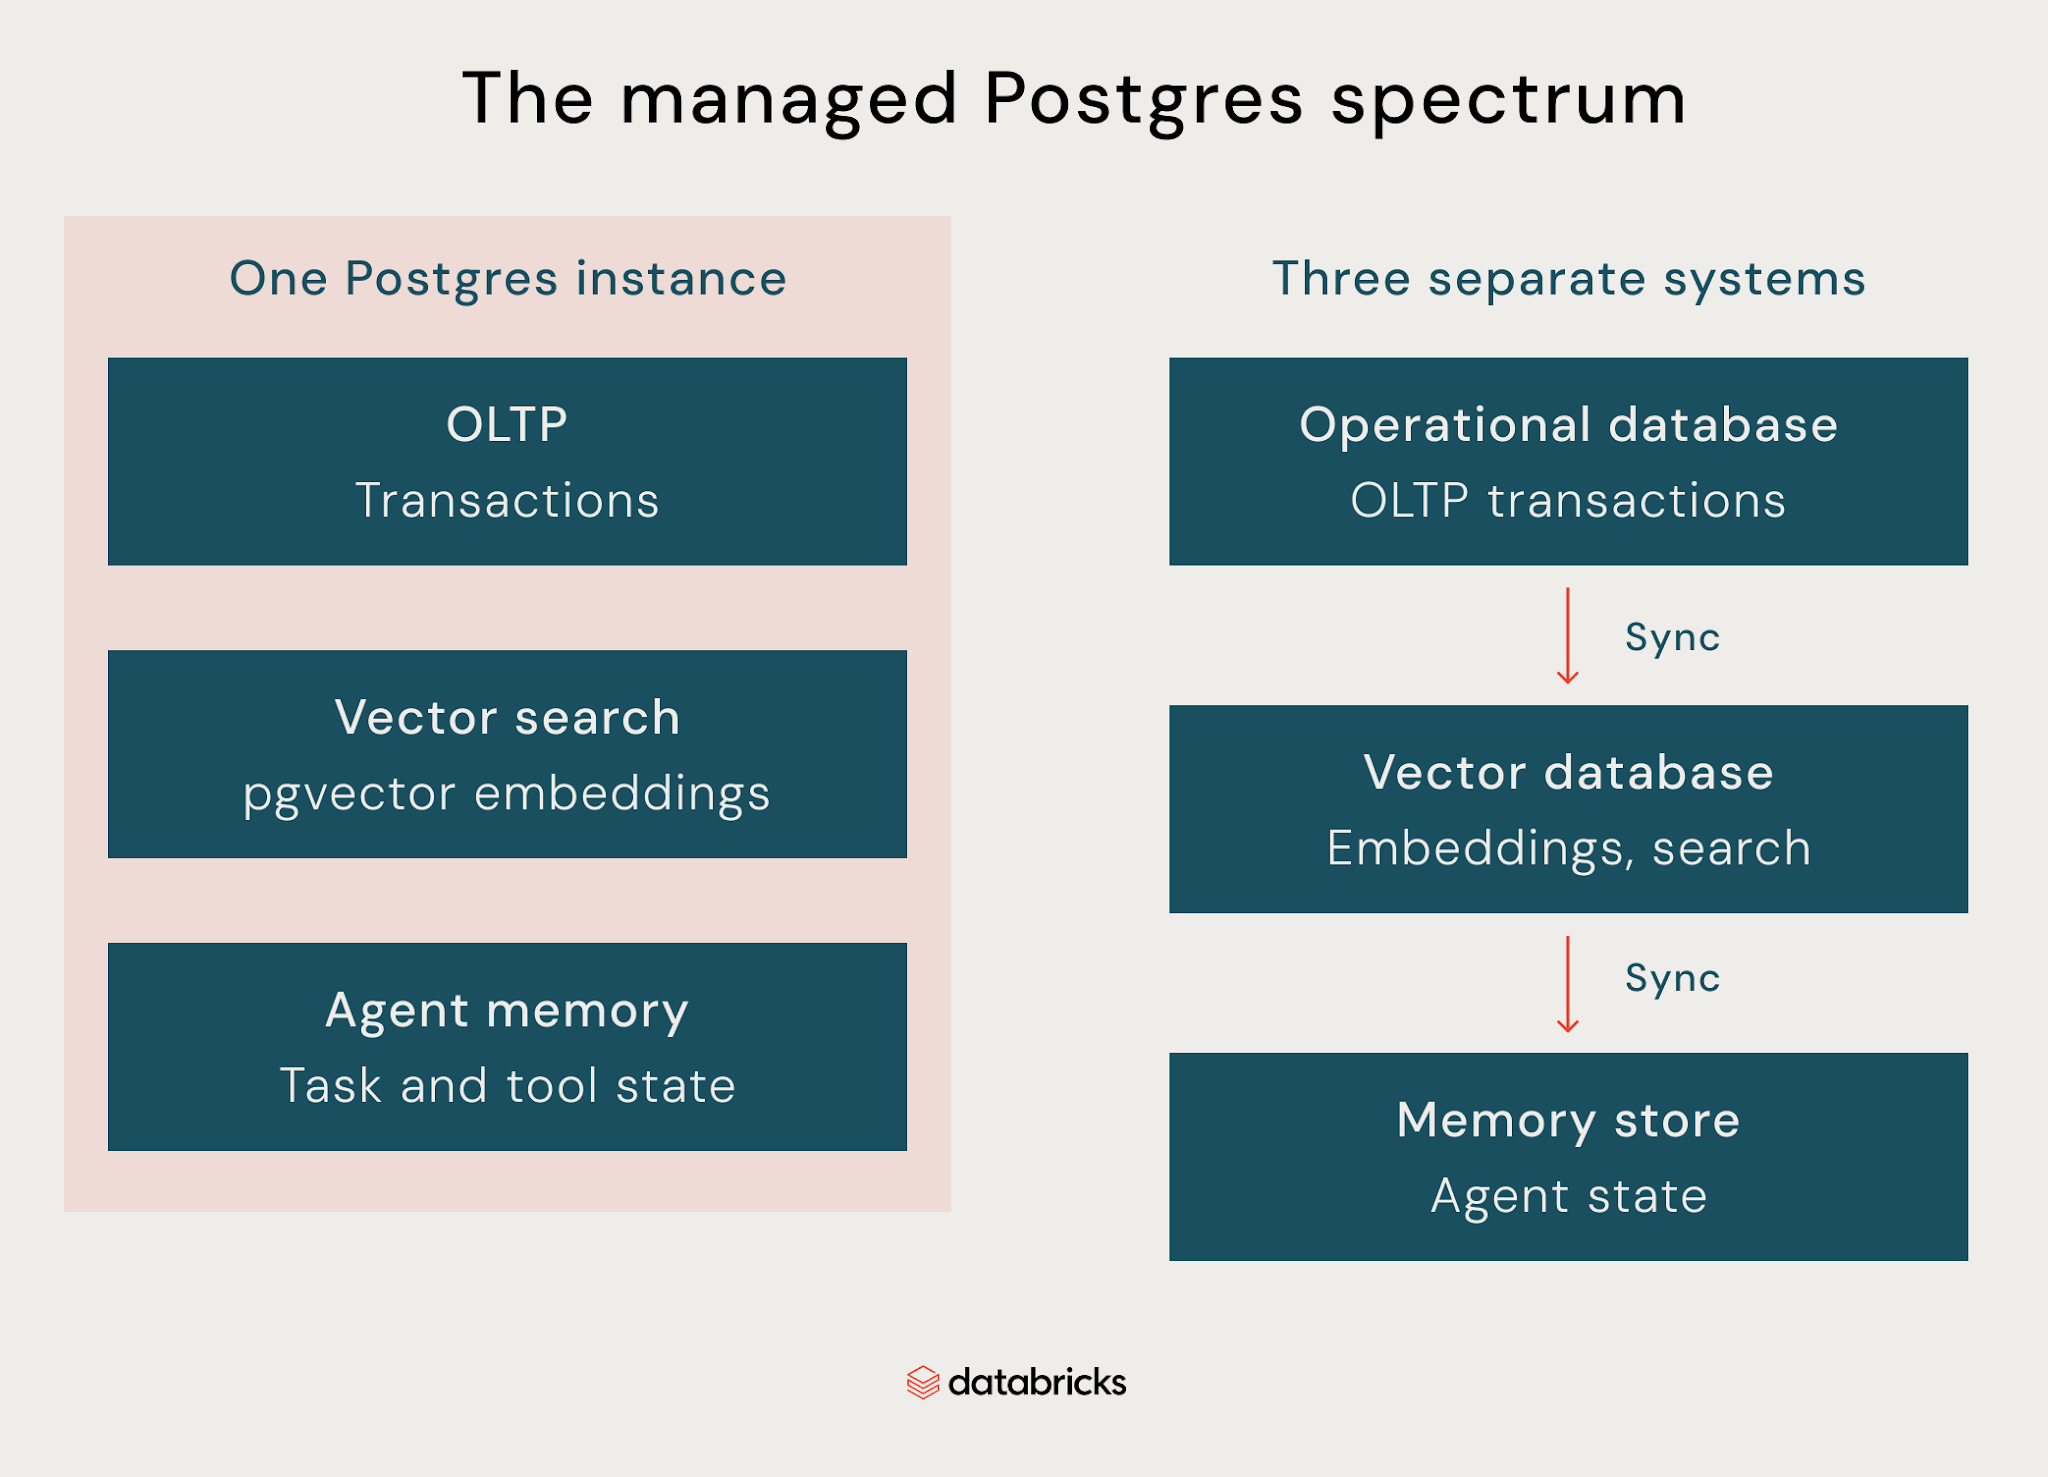
Postgres puede ser una excelente opción para aplicaciones de IA cuando una aplicación necesita un estado transaccional y búsqueda vectorial en el mismo sistema. Esto se reduce a cuatro aspectos: pgvector como la extensión que lo hace posible, la búsqueda vectorial para la recuperación, la memoria de los modelos de lenguaje grande (LLM) para persistir el estado entre solicitudes y las cargas de trabajo de agentes que necesitan ambos a la vez.
pgvector
pgvector añade un tipo de datos vectoriales y un índice de búsqueda de similitud directamente dentro de Postgres, de modo que los embeddings residen junto al resto de los datos de su aplicación en lugar de en un sistema propio. La desventaja es que una base de datos vectorial independiente implica que mantener sincronizados los embeddings y los datos operativos se convierte en su propio problema de ingeniería, algo que pgvector elimina para las cargas de trabajo que no necesitan un almacenamiento vectorial dedicado.
Búsqueda vectorial y búsqueda semántica
pgvector le permite almacenar embeddings y utilizar índices de vecino más próximo aproximado (ANN) para encontrar vectores similares de manera eficiente a medida que crece el conjunto de datos, lo que hace posible la búsqueda semántica, la generación aumentada por recuperación y la coincidencia basada en el significado dentro de Postgres. La estrategia de indexación adecuada sigue dependiendo del tamaño del conjunto de datos y de los patrones de consulta, por lo que pgvector no elimina la necesidad de evaluar el rendimiento para su carga de trabajo específica.
Memoria de LLM
Las aplicaciones de LLM necesitan un lugar donde mantener el estado entre las solicitudes, lo que incluye el historial de conversaciones, las preferencias del usuario, los documentos recuperados y los resultados de las herramientas. Postgres puede almacenar ese estado como datos relacionales comunes, mientras que pgvector gestiona los embeddings en la misma base de datos. Para las cargas de trabajo que requieren una recuperación vectorial especializada a gran escala, una base de datos vectorial dedicada aún puede tener sentido, pero muchas aplicaciones de IA pueden mantener juntos el estado operativo y la recuperación.
Cargas de trabajo de agentes
Los agentes leen y actualizan el estado continuamente a medida que se ejecutan. Realizan un seguimiento de las conversaciones, almacenan resultados intermedios y registran las llamadas a herramientas, lo que convierte a la base de datos en parte de la capa de ejecución del agente, en lugar de ser solo un lugar para recuperar el contexto. Una base de datos diseñada para cargas de trabajo de agentes de IA debe admitir tanto ese estado transaccional en constante cambio como la recuperación que el agente utiliza para encontrar el contexto relevante, todo en un solo sistema.
Postgres para el desarrollo de aplicaciones
Más allá de ejecutar cargas de trabajo de producción, Postgres debe dar soporte a la forma en que su equipo realmente desarrolla. Esto significa que las conexiones no se conviertan en un cuello de botella a medida que escala, y que probar los cambios de esquema no implique poner en riesgo los datos de producción.
Gestión de conexiones
Postgres tiene un límite finito de conexiones que puede mantener a la vez, y las instancias de la aplicación que se escalan horizontalmente pueden alcanzar ese límite antes de que el cómputo o el almacenamiento se conviertan en el cuello de botella. La agrupación de conexiones (connection pooling) reutiliza las conexiones de base de datos establecidas en todas las solicitudes en lugar de abrir una nueva conexión para cada una. En un servicio gestionado, lo que importa es si la agrupación está integrada o si es algo que su equipo debe operar por separado.
Ramificación de bases de datos
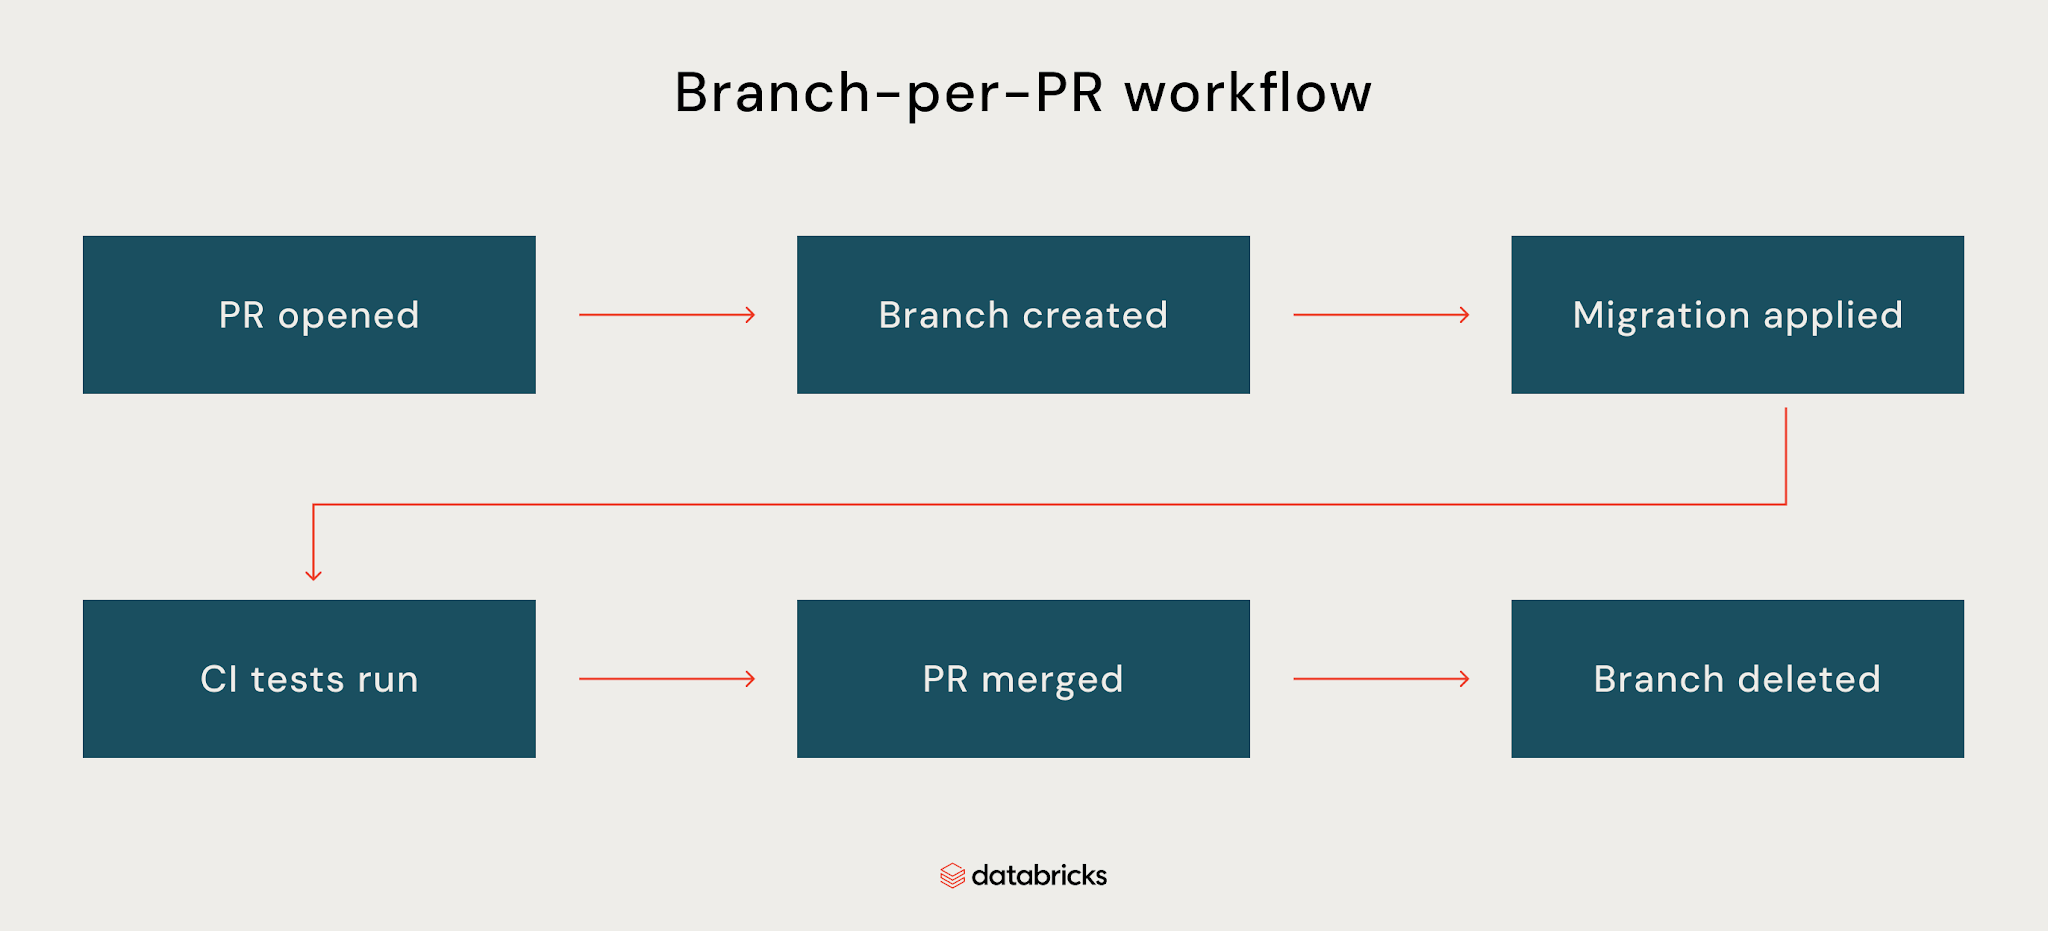
Probar los cambios de esquema con datos de producción significa arriesgar la producción o mantener una base de datos de pruebas (staging) que se desincronice con el tiempo. La ramificación de bases de datos (database branching) crea un entorno aislado a partir del estado de una base de datos existente o de una instantánea en un momento dado, para que los desarrolladores puedan probar las migraciones con datos realistas, trabajar de acuerdo con el desarrollo evolutivo de bases de datos y eliminar la rama una vez que ya no sea necesaria.
Por qué elegir Lakebase en Postgres gestionado
El enfoque de Lakebase se vuelve más claro cuando se compara con las tareas principales que debe gestionar Postgres:
- Serverless: Lakebase ejecuta PostgreSQL en cómputo serverless que se escala automáticamente con la demanda, incluso a cero cuando está inactivo, por lo que no es necesario dimensionar una instancia por adelantado ni pagar por la capacidad no utilizada. Databricks reporta un rendimiento de escritura de Postgres hasta 5 veces mayor con Lakebase en sus pruebas, aunque el resultado depende de la carga de trabajo y la configuración.
- Compatibilidad con PostgreSQL: Lakebase utiliza conectividad estándar de PostgreSQL, por lo que los controladores existentes, los ORM y herramientas como psql, pgAdmin y DBeaver se conectan de la misma manera que lo harían a cualquier otra instancia de Postgres, sin ningún protocolo propietario entre la aplicación y la base de datos.
- Fiabilidad: Lakebase ejecuta cómputo secundario en zonas de disponibilidad independientes y lo promueve automáticamente si el primario falla, manteniendo el punto de conexión (endpoint) sin cambios. El equipo de la base de datos no tiene que promover manualmente una réplica ni reconfigurar la aplicación durante el incidente.
- Precios: El cómputo se escala con la carga de trabajo en lugar de una instancia aprovisionada permanentemente, y los cargos se detienen una vez que la base de datos se suspende. El almacenamiento se factura por separado.
- Integración con el lakehouse: Lakebase se conecta al resto de la plataforma Databricks en lugar de operar como un servicio de Postgres aislado. Las tablas sincronizadas hacen que los datos de Unity Catalog estén disponibles para las aplicaciones de Postgres sin necesidad de un pipeline de sincronización personalizado, y Change Data Feed, actualmente en Public Preview, expone los cambios de la base de datos para su procesamiento posterior en el lakehouse.
Qué tareas dejan de ser responsabilidad del equipo
La siguiente tabla muestra qué operaciones de la base de datos gestiona Lakebase y cuáles siguen siendo responsabilidad del equipo de base de datos:
| Dimensión | Qué gestiona Lakebase |
|---|---|
| Aplicación de parches (patching) | Actualizaciones automáticas de PostgreSQL, seguridad, OS y cómputo |
| Escalado | Escalado automático, incluido el escalado a cero cuando está inactivo |
| Conmutación por error (failover) | Conmutación por error (failover) automática al cómputo secundario dentro de una región |
| Copias de seguridad y recuperación | Restauración a un punto en el tiempo con un historial configurable de 2 a 30 días, además de instantáneas programadas para una protección adicional de las copias de seguridad |
| Recuperación ante desastres | Private Preview, solo para AWS. Replicación periódica con conmutación por error manual y procedimientos de recuperación gestionados por el cliente. |
| Cifrado | En reposo y en tránsito, con claves gestionadas por el cliente disponibles |
| Control de acceso | Roles y permisos de PostgreSQL, con integraciones de Unity Catalog para una gobernanza más amplia. |
| Extensiones | pgvector, PostGIS y otras extensiones de PostgreSQL compatibles |
| Agrupación de conexiones (connection pooling) | PgBouncer integrado |
| Ramificación (branching) | Copia en escritura (copy-on-write), sin almacenamiento duplicado |
| Integración con el lakehouse | Tablas sincronizadas y Change Data Feed |
| Precios | Serverless, se escala con la carga de trabajo, se suspende cuando está inactivo. El almacenamiento se factura por separado. |
La aplicación de parches, el escalado, la conmutación por error y las copias de seguridad se ejecutan automáticamente según la tabla anterior. La recuperación ante desastres es la excepción: aún se encuentra en Private Preview, solo para AWS, con conmutación por error manual y procedimientos de recuperación gestionados por el cliente. Ese es el detalle que vale la pena verificar antes de confiar en Lakebase para cualquier proceso que abarque varias regiones. Obtenga más información sobre Databricks Lakebase.
Conclusión
"Gestionado" significa algo diferente según quién lo venda, desde aplicar parches al OS y darlo por terminado, hasta asumir toda la responsabilidad de ejecutar una base de datos de producción: escalado, conmutación por error, copias de seguridad, seguridad, migración, cargas de trabajo de IA y la experiencia del desarrollador en torno a todo ello.
Lakebase supera ese estándar en la mayoría de los aspectos. La aplicación de parches, el escalado y la conmutación por error se ejecutan sin la intervención de su equipo; la recuperación a un punto en el tiempo está integrada, y la seguridad, las extensiones, la agrupación de conexiones y la ramificación vienen incluidas con el servicio. La recuperación ante desastres entre regiones es la única excepción, ya que aún está en Private Preview con conmutación por error manual, por lo que no ofrece la misma protección automática que Lakebase proporciona dentro de una región.
Para los equipos que evalúan Postgres gestionado, la pregunta clave es de cuánta carga de trabajo operativa se liberan realmente. Lakebase gestiona la mayor parte de ese trabajo dentro de una región, mientras que la recuperación ante desastres entre regiones sigue siendo un área en la que los equipos aún tienen responsabilidades.
Preguntas frecuentes
¿Cuál es la diferencia entre Postgres gestionado y autogestionado (self-hosted)?
Postgres autoalojado asigna todas las tareas operativas al equipo de la base de datos: parcheo, escalado, conmutación por error, políticas de copia de seguridad y recuperación ante desastres. El Postgres administrado traslada parte o la totalidad de estas tareas al proveedor, pero la cantidad transferida varía mucho. Los servicios parcialmente administrados se encargan de la infraestructura y dejan el resto en manos del cliente. Algunos servicios totalmente administrados también incluyen herramientas de seguridad, asistencia para la migración y flujos de trabajo de desarrollo como la ramificación de bases de datos.
¿Qué es Postgres serverless?
Postgres serverless es un modelo de base de datos administrada en el que el cómputo se escala automáticamente según la demanda, lo que elimina la necesidad de aprovisionar un tamaño de instancia fijo. Algunos proveedores reducen el cómputo a cero cuando la base de datos está inactiva, mientras que otros mantienen una capacidad base. Los precios generalmente se basan en el cómputo utilizado en lugar de una instancia aprovisionada de forma permanente.
¿Cómo funciona la ramificación de bases de datos en Postgres?
La ramificación de bases de datos crea una rama aislada de copia en escritura (copy-on-write) de una base de datos sin duplicar el almacenamiento subyacente. Cada rama puede tener su propio cómputo y cambios de datos sin afectar a la producción. Los equipos la utilizan para probar migraciones de esquemas con datos reales, crear una rama por cada pull request o restaurar una rama a un punto específico en el tiempo, para luego eliminarla una vez finalizado el trabajo.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.