Databricks for Good y Virtue Foundation: colaborando para conectar a voluntarios médicos con servicios de salud críticos en 72 países
por Priyanka Mehta y Shaunak Sen
- La Virtue Foundation se asoció con Databricks for Good para aprovechar la AI y mejorar los resultados de la salud global.
- Como resultado, la Virtue Foundation ahora puede conectar mejor las habilidades del personal clínico con las oportunidades de voluntariado en los países en desarrollo donde más se necesitan.
- Juntos, los equipos de Databricks y la Virtue Foundation están proporcionando conjuntos de datos centrales actualizados en un formato fácilmente accesible y procesable.
Introducción
Virtue Foundation es una organización sin fines de lucro centrada en la prestación de salud global y en la creación de un mercado eficiente para la atención médica filantrópica global. Hasta la fecha, han brindado atención a más de 50 000 pacientes, con un enfoque especial en Ghana y Mongolia. La columna vertebral de este mercado es la curación de datos de instalaciones sanitarias globales a través de VF Match, una plataforma que conecta a profesionales médicos con oportunidades de voluntariado en 72 países de ingresos bajos y medios-bajos. Databricks for Good ha estado colaborando estrechamente con Virtue Foundation desde 2024 para aprovechar la IA con el fin de agregar datos de estos países y hacerlos accionables.
Una POC inicial demostró que los LLM podían extraer información estructurada de fuentes de datos web dispares para crear un mapa de la infraestructura sanitaria y, lo que es más importante, de las brechas en los servicios en áreas con recursos limitados. Sin embargo, escalar esta funcionalidad y llevarla a producción planteó muchos desafíos. Desde esa primera iteración, hemos creado una plataforma basada en Databricks que ha transformado la POC en un sistema de nivel de producción que agrega datos de miles de instalaciones sanitarias y organizaciones sin fines de lucro en todo el mundo.
En este artículo, explicamos cómo mejoramos nuestro trabajo anterior para permitir que Virtue Foundation conecte aún mejor a su comunidad de voluntarios médicos con las necesidades críticas de estos países.
Construyendo las bases: datos de atención médica de 72 países
El núcleo de VF Match es el Foundational Data Refresh (FDR): un conjunto de datos completo de instalaciones sanitarias y organizaciones sin fines de lucro creado desde cero a partir de varias fuentes web. Ingerimos y actualizamos sistemáticamente datos de 72 países de ingresos bajos y medios-bajos de todo el mundo.
Dos fuentes de datos complementarias impulsan esta actualización:
- Overture Maps: un conjunto de datos geoespaciales de código abierto de Meta y Microsoft que proporciona ubicaciones oficiales de instalaciones sanitarias.
- Bright Data: infraestructura de web scraping industrial que captura información en tiempo real de todo internet.
El corazón de FDR es un pipeline de extracción de información impulsado por los modelos GPT de OpenAI. Procesar más de 25 millones de páginas web a través de LLM con garantías de producción requirió replantear los pipelines tradicionales de inferencia de LLM. En lugar de intentar una extracción de un solo intento (one-shot), nuestro pipeline divide la tarea en pasos específicos: clasificar la relevancia médica, identificar el tipo de organización (ya sea una instalación médica o una NGO) y extraer especialidades, equipos y procedimientos.
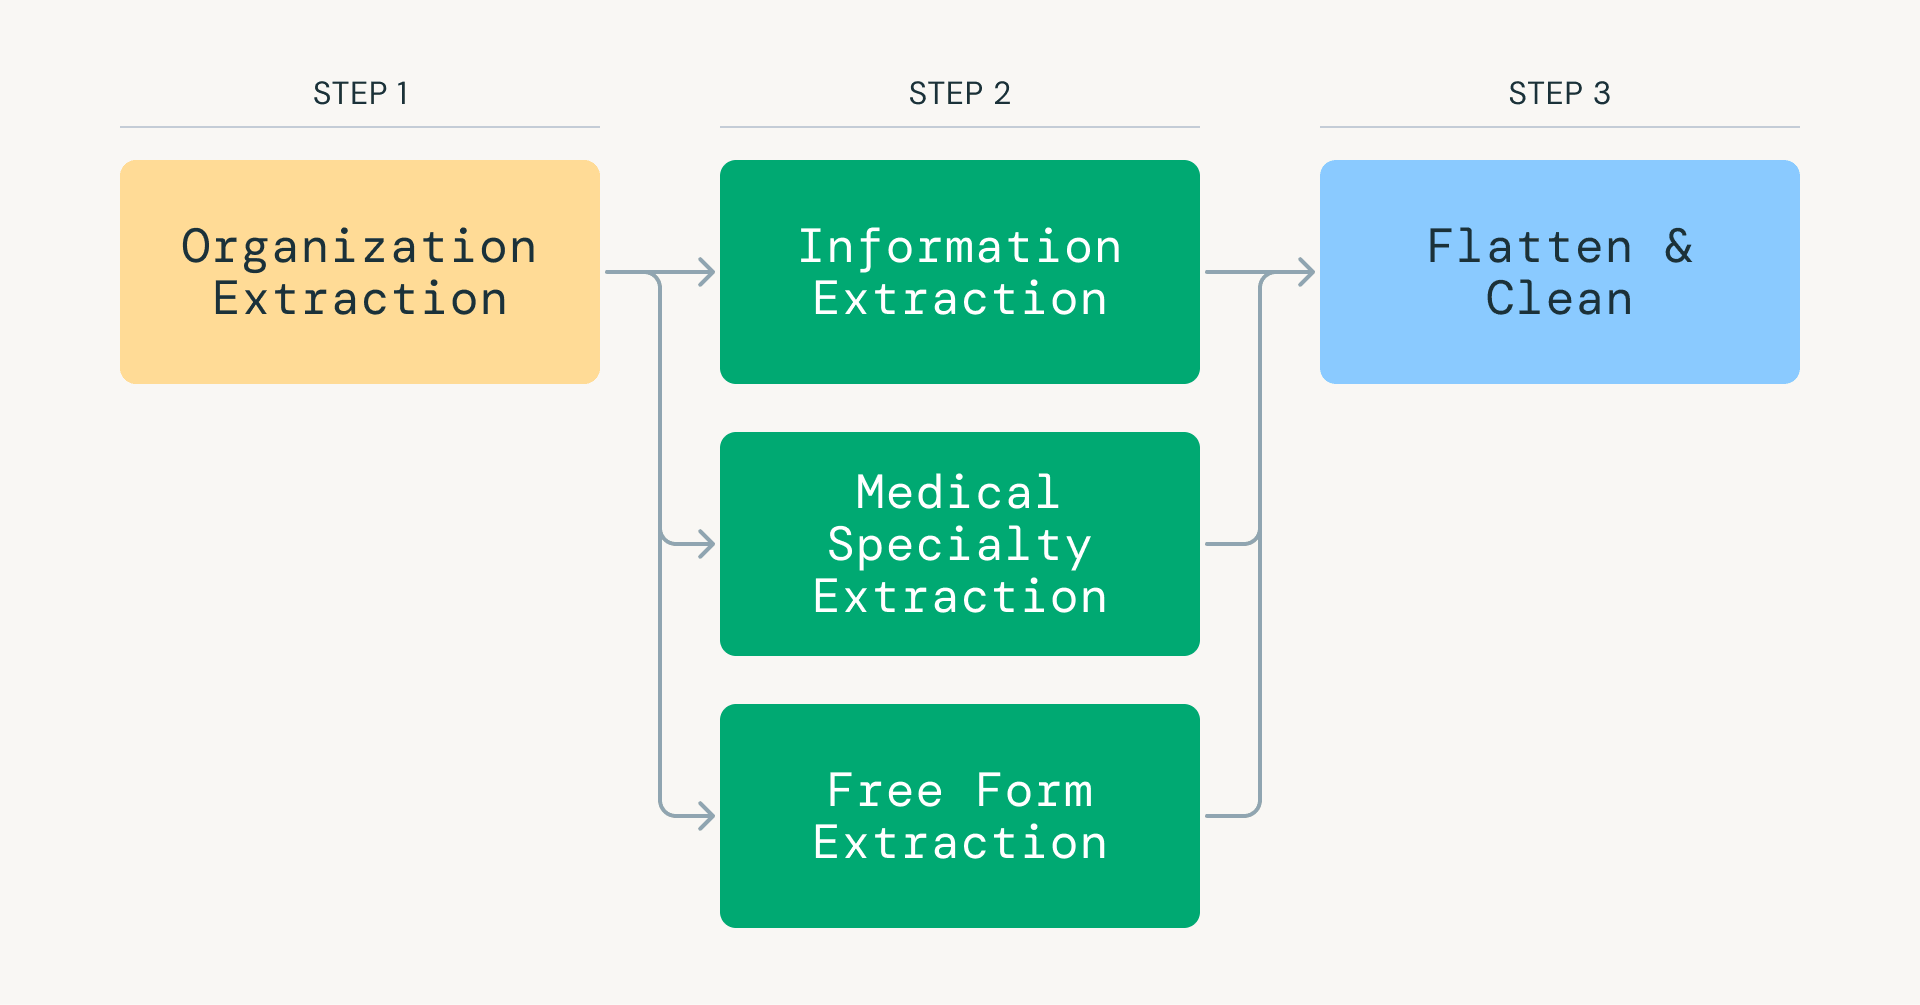
Este enfoque reduce drásticamente el consumo de tokens al tiempo que centra cada invocación del modelo en una tarea específica y de alta precisión. Databricks y Apache Spark se utilizan para orquestar y paralelizar de manera eficiente los datos extraídos, distribuyendo las cargas de trabajo entre miles de ejecutores y permitiendo una inferencia de LLM de alto rendimiento.
Una serie de características críticas hacen que este pipeline sea escalable y esté listo para producción:
- Modelado de datos extensible: los datos de cada paso se almacenan en un esquema en estrella, lo que simplifica el análisis posterior y mejora el rendimiento de las consultas.
- Puntos de control basados en el estado (checkpointing): cada registro realiza un seguimiento de su estado de procesamiento, lo que permite que los pipelines se reanuden desde cualquier punto sin tener que volver a procesar filas con costosas llamadas a LLM.
- Registro de extracción configurable: cada método de extracción está controlado por un objeto estructurado que especifica el prompt del sistema, lo que hace que la lógica de extracción sea modular, reproducible y extensible.
- Procesamiento distribuido escalable: el sistema procesa cargas de trabajo sesgadas de varios terabytes utilizando Spark para el paralelismo, Photon para el rendimiento a escala y una orquestación de nivel de producción.
Estas garantías se aplican a través de Lakeflow Jobs, que orquestan más de 15 tareas interdependientes con ramificación condicional, ejecución paralela y políticas de reintento inteligentes. El resultado es un sistema que procesa datos de instalaciones sanitarias a escala con la precisión de expertos médicos.
Resolución de entidades a escala
Una de las dificultades clásicas que surge una vez que los datos de las instalaciones y de las organizaciones sin fines de lucro se extraen mediante web scraping y se procesan con un LLM es la resolución de entidades. La misma instalación puede aparecer en múltiples fuentes de datos con variaciones en el nombre, direcciones inconsistentes o detalles de contacto faltantes. La deduplicación tradicional falla en estos escenarios debido a la inconsistencia de los datos, por lo que utilizamos Splink, un marco de vinculación probabilística de registros de código abierto. Utilizando la información obtenida en nuestro paso de IE, Splink evalúa los pares de coincidencia mediante comparaciones ponderadas en campos como el número de teléfono, la dirección postal y más. El resultado es una clave unificada por instalación, lo que garantiza que los usuarios finales vean un único registro autorizado para cada instalación médica y NGO.
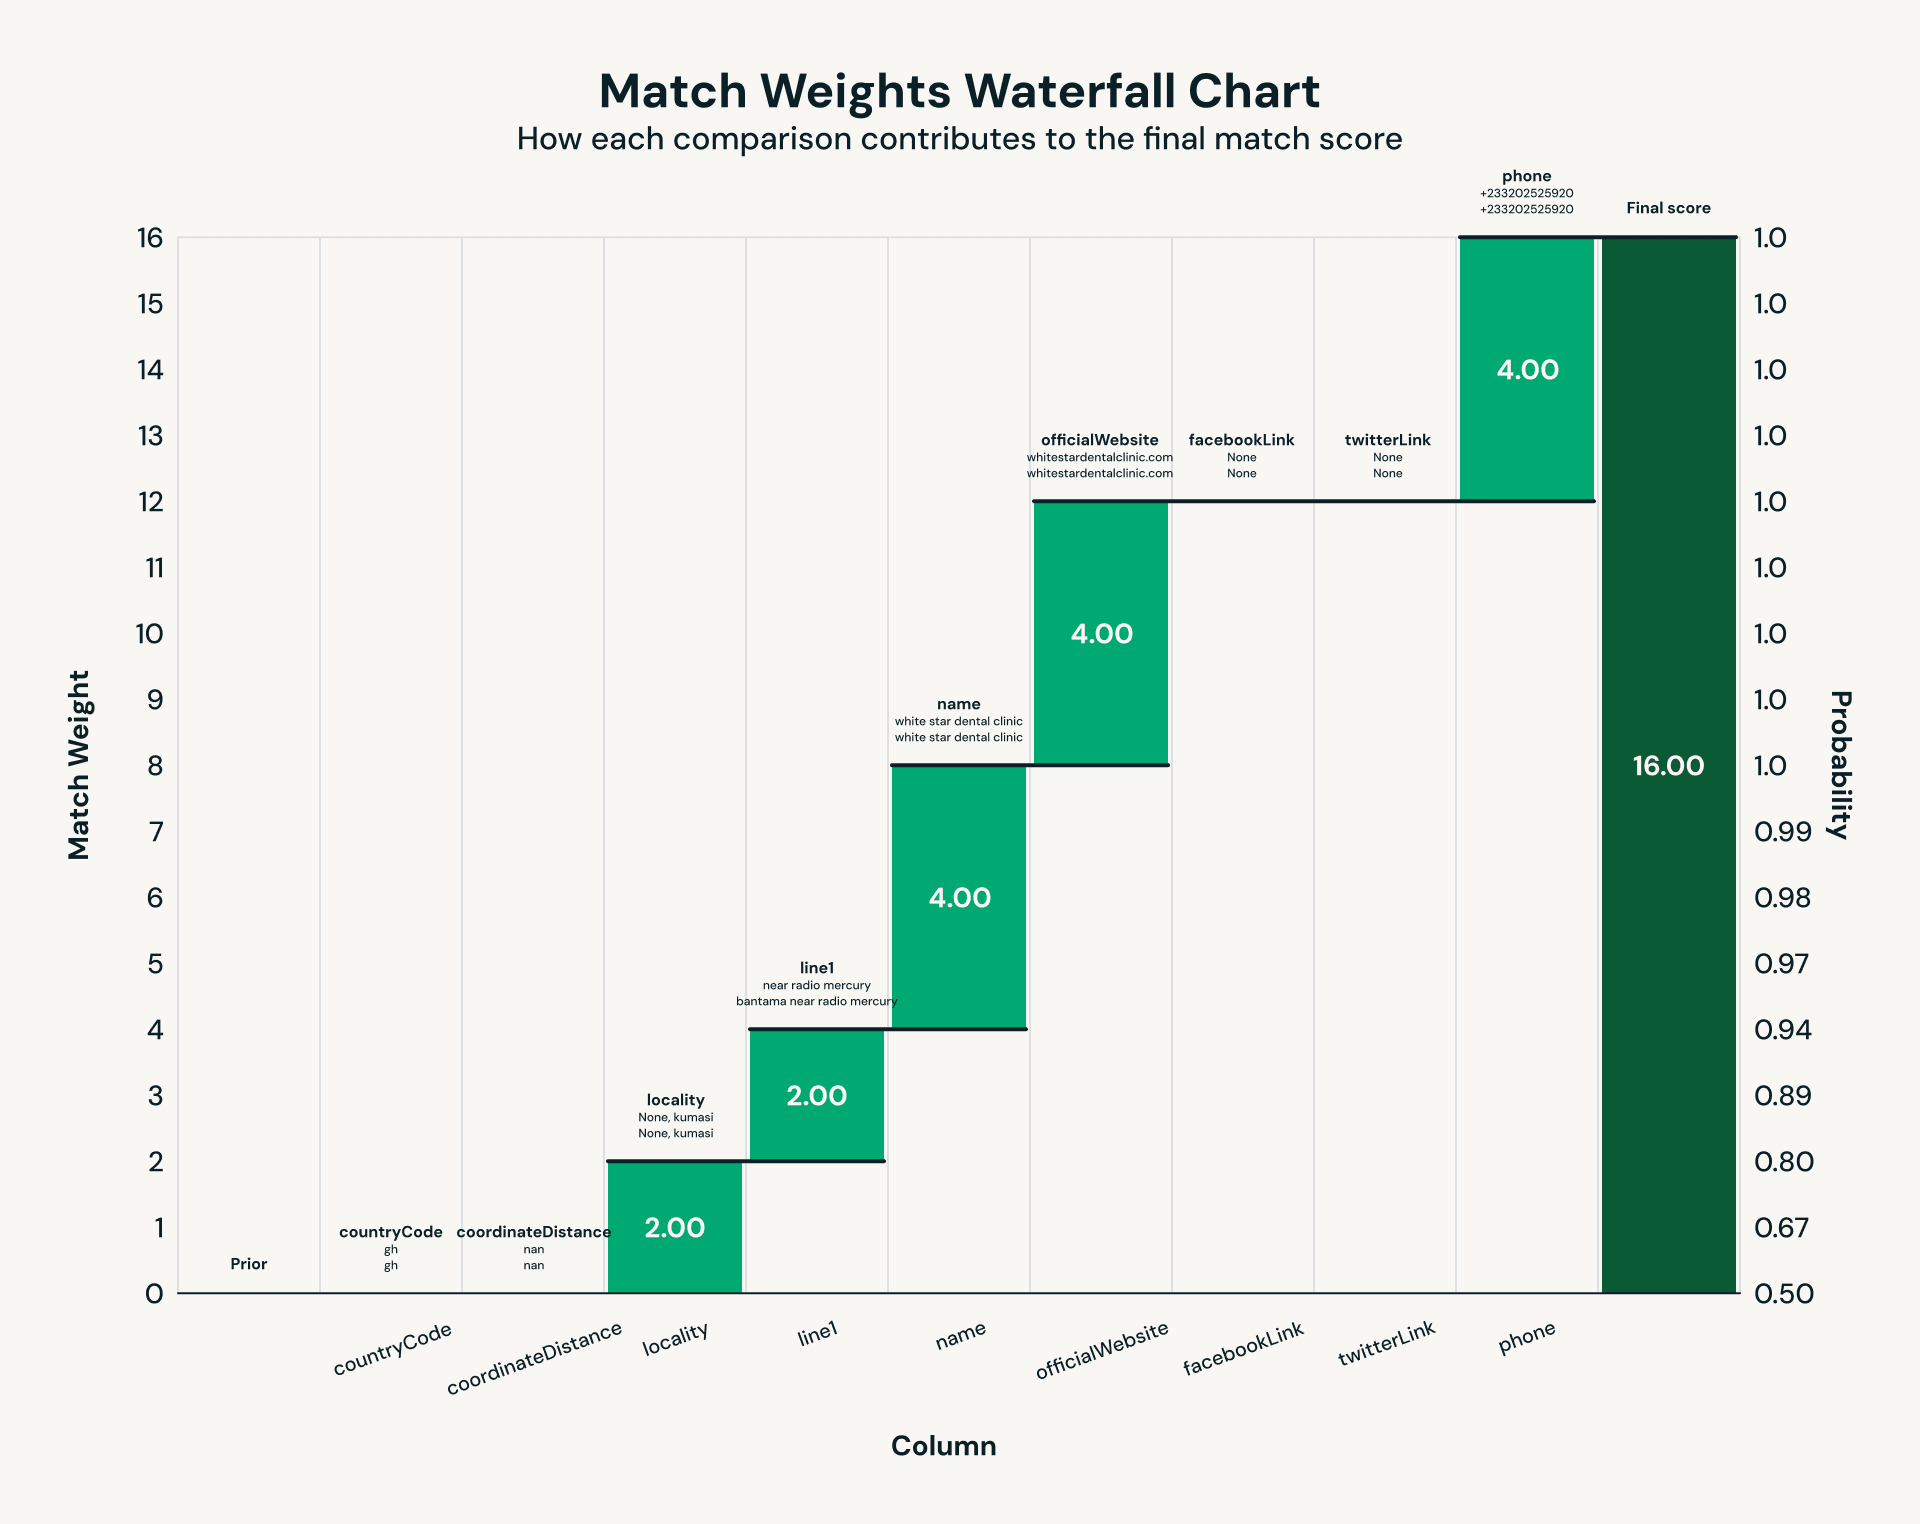
Ejecutar la coincidencia probabilística en miles de instalaciones sanitarias y organizaciones sin fines de lucro reveló los clásicos cuellos de botella de rendimiento que surgen a escala de terabytes. El núcleo de la vinculación de registros es la comparación por pares, lo que crea cargas de trabajo inherentemente sesgadas: las comparaciones comunes producen particiones masivas, mientras que la mayoría de las demás siguen siendo mucho más pequeñas. Las primeras ejecuciones lo dejaron muy claro: una partición de Spark tardó 30 minutos en ejecutarse, mientras que la mediana se completó en 52 segundos, un caso de manual de tareas rezagadas (la "maldición del último reductor") que degrada el rendimiento del trabajo. Habilitar Photon, el motor de consultas vectorizado de Databricks, redujo las particiones de datos en el peor de los casos de 30 minutos a aproximadamente 2 minutos: una mejora de 15 veces.
VF Agent: el lenguaje natural se une a los datos de atención médica
Mirando hacia el futuro, hemos desarrollado un prototipo de un agente que permite a los expertos analizar datos utilizando lenguaje natural. Utilizamos una arquitectura multiagente construida en LangGraph y aprovechamos Databricks Model Serving, AI Search y Genie.
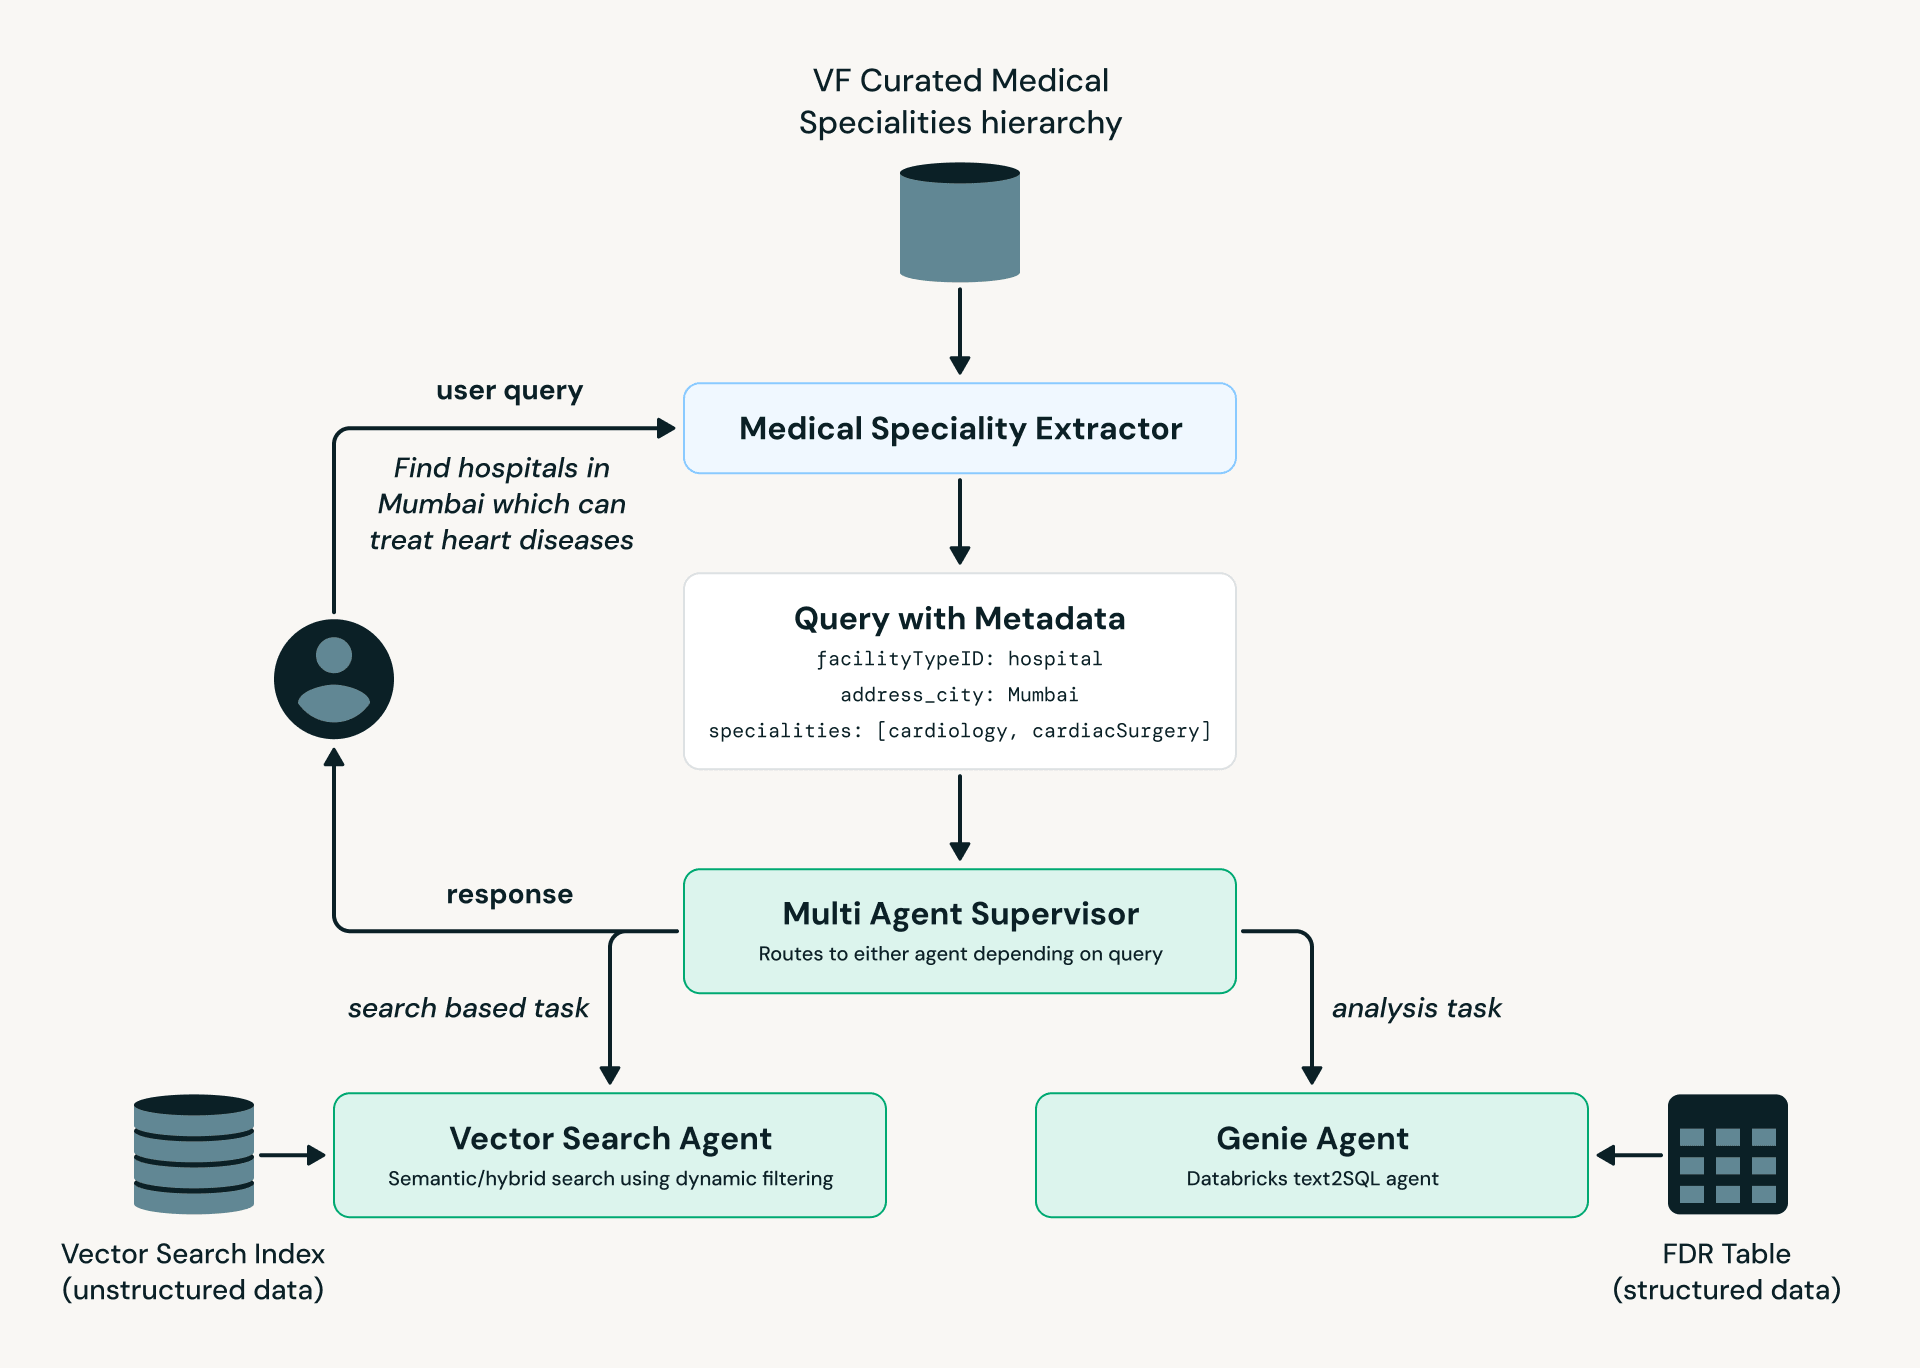
Como se ilustra en el diagrama anterior, el Medical Specialty Extractor convierte el lenguaje del usuario en terminología médica estandarizada, que luego se pasa al Multi-Agent Supervisor. Según la intención y la complejidad de la consulta, esta se dirige al AI Search Agent (descubrimiento y búsqueda de instalaciones) o al Genie Agent (consultas analíticas sobre datos estructurados).
Resumen
Los profesionales de la salud ahora pueden descubrir oportunidades actualizadas más rápido, encontrar coincidencias con sus especialidades médicas y acceder a datos globales sobre miles de instalaciones en todo el mundo. El viaje de Virtue Foundation desde la prueba de concepto hasta la producción demuestra lo que es posible cuando los sistemas de IA avanzados se combinan con una plataforma de datos unificada.
El resultado final es una visión global de la infraestructura sanitaria, que revela dónde se necesitan más los voluntarios médicos.
Si desea obtener más información sobre este proyecto, consulte:
- Descripción general del proyecto Databricks x Virtue Foundation - YouTube
- Entrevista de UN Bloomberg (YouTube) - alrededor del minuto 38:00
- Testimonio en video: Bright Initiative x Virtue Foundation x Databricks
Lea más sobre algunos de nuestros otros proyectos de Databricks for Good a continuación:
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.