Qué buscar en un servicio administrado de Postgres: una lista de verificación para compradores técnicos
El Postgres administrado tradicional destaca en cargas de trabajo transaccionales, pero se queda corto en consultas analíticas, y la mayoría de las listas de evaluación pasan por alto esta deficiencia. Si estás evaluando Postgres como un motor híbrido...
- Un servicio de Postgres administrado debe evaluarse por su rendimiento ante fallas, recuperación y carga de producción, y no solo por las funciones que anuncia.
- Las verificaciones clave incluyen alta disponibilidad, recuperación ante desastres, compatibilidad con PostgreSQL, seguridad, escalado, costo total, control operativo y portabilidad.
- Un flujo de trabajo de producción debe poner a prueba las afirmaciones del proveedor mediante pruebas de conmutación por error, recuperación en un momento dado, carga y migración antes de adoptar el servicio.
- Lakebase Postgres ofrece un servicio administrado y sin servidor de Postgres con alta disponibilidad automática, escalado automático y las capacidades de seguridad y gobernanza de Databricks.
Managed es una etiqueta, no una especificación. Evalúa un servicio de base de datos administrada en la nube según lo que demuestra ante fallas y recuperaciones, y no por lo que su página de características enumera.
Un servicio administrado de Postgres es una base de datos PostgreSQL en la que el proveedor opera la infraestructura subyacente y automatiza la administración de la base de datos, como la aplicación de parches, las copias de seguridad, la conmutación por error y el escalado. El nivel de administración que realiza el proveedor varía según el servicio, lo que hace que "administrada" sea una etiqueta más que una especificación completa. Los principales proveedores de la nube, incluidos AWS, Microsoft Azure y Google Cloud, ofrecen servicios administrados de PostgreSQL, al igual que los proveedores especializados en bases de datos.
Un proveedor puede anunciar alta disponibilidad, copias de seguridad automatizadas o seguridad empresarial, pero esas afirmaciones no le dicen a los ingenieros de plataforma ni a los DBA qué sucede cuando falla un nodo principal, qué tan rápido se puede restaurar una base de datos o si se admite una extensión de PostgreSQL necesaria. Cuando surge un problema en producción, lo que importa es la rapidez con la que el equipo puede encontrarlo y resolverlo.
Ingenieros de plataforma, DBA, arquitectos de datos y gerentes de ingeniería que evalúan un servicio administrado de Postgres para producción. Abarca las áreas que suelen causar problemas después de la migración, como el control operativo, la alta disponibilidad, la recuperación ante desastres, el escalado, etc. Cada sección analiza lo que el proveedor debe admitir, las preguntas que vale la pena hacer durante una evaluación y cómo probar las respuestas en una fase piloto. Si eres DBA o ingeniero de plataforma y planeas hacer un cambio, usa este artículo como una lista de verificación práctica en lugar de una lectura de una sola vez.
Un vistazo a la lista de verificación del servicio administrado de Postgres
Una evaluación de un servicio administrado de Postgres debe cubrir más que el aprovisionamiento de la base de datos y la administración diaria. La tabla a continuación ofrece a los equipos un punto de partida para conocer las capacidades que deben verificar y las respuestas que deberían motivar una revisión más detallada.
| Área | Qué verificar | Señales de alerta |
|---|---|---|
| Alcance operativo | Quién se encarga de la aplicación de parches, las actualizaciones y el ajuste, y qué controles de la base de datos siguen disponibles | "Administrada" solo cubre la máquina virtual y el sistema operativo |
| Alta disponibilidad | Conmutación por error automática, garantías de transacciones confirmadas y si la conmutación por error funciona entre zonas de disponibilidad | Sin objetivo de punto de recuperación (RPO) establecido ni promoción manual |
| Copias de seguridad y recuperación ante desastres | Recuperación a un momento dado (PITR), opciones de restauración, retención, recuperación entre regiones y objetivos de recuperación | La recuperación ante desastres solo está disponible mediante una solicitud de soporte sin un RPO o un objetivo de tiempo de recuperación (RTO) establecidos |
| Escalado y rendimiento | Comportamiento de redimensionamiento, réplicas de lectura, agrupación de conexiones, almacenamiento y el modelo de operaciones de entrada/salida por segundo (IOPS) | El escalado vertical requiere un tiempo de inactividad prolongado |
| Seguridad y cumplimiento | Conectividad privada, controles de identidad y acceso, claves administradas por el cliente, registros de auditoría y alcance de cumplimiento | Se requiere conectividad pública o las claves de cifrado solo pueden ser controladas por el proveedor |
| Compatibilidad y extensiones | Versiones de PostgreSQL compatibles, extensiones, controladores, parámetros y restricciones de superusuario | No se admite una extensión crítica o una capacidad de PostgreSQL necesaria |
| Migración | Rutas de migración compatibles, replicación lógica y opciones de captura de datos modificados (CDC) | Las grandes bases de datos solo se pueden migrar mediante volcado y restauración |
| Precios y costo total | Costos de cómputo, almacenamiento, IOPS, copias de seguridad, réplicas, salida de red y soporte extendido | Solo el precio del cómputo está claro |
| Operaciones | Métricas de la base de datos, registros, alertas y acceso a soporte a nivel de PostgreSQL | Observabilidad limitada de la base de datos o sin escalamiento a expertos en PostgreSQL |
| Portabilidad y salida | Exportaciones estándar y replicación lógica a otro entorno de PostgreSQL | Los datos solo pueden salir a través de un formato propietario o una solicitud de soporte |
1. Alcance y control operativo
Lo primero que se debe verificar es dónde termina la responsabilidad del proveedor y dónde comienza la del equipo de bases de datos. Un servicio administrado debe encargarse de la infraestructura y de las operaciones rutinarias de la base de datos sin quitar los controles de PostgreSQL de los que depende una carga de trabajo de producción. Los proveedores que se refieren a un servicio como completamente administrado no siempre se refieren a lo mismo.
Comienza con el mantenimiento. Pregunta si las actualizaciones de versiones menores son automáticas, si los equipos pueden elegir una ventana de mantenimiento, con cuánta anticipación los proveedores avisan antes de los cambios y si las actualizaciones requieren un reinicio o una conmutación por error. Las actualizaciones de versiones principales merecen una atención independiente. PostgreSQL admite cada versión principal durante cinco años, por lo que los equipos deben comprender durante cuánto tiempo el proveedor admite cada versión y qué sucede cuando finaliza dicho soporte. Solicita la fecha de fin de vida útil que utiliza el proveedor para cada versión. Por lo general, cuanto menos aviso dé un proveedor antes de actualizar una base de datos, más difícil será planificar en torno a ello.
El acceso a la configuración es otra fuente común de sorpresas. Los servicios administrados a menudo restringen el acceso de superusuario y limitan los parámetros o comandos que podrían afectar la infraestructura subyacente. Antes de migrar, verifica qué roles están disponibles, qué parámetros se pueden cambiar, si ALTER SYSTEM es compatible y qué comandos de PostgreSQL están restringidos. Por ejemplo, algunos servicios te permiten editar un conjunto de parámetros a través de una consola o API, pero bloquean por completo el comando ALTER SYSTEM.
- Pregunta cómo funcionan las actualizaciones de versiones menores y principales, incluidas las ventanas de mantenimiento, las notificaciones y las políticas de fin de soporte.
- Pregunta qué roles, parámetros y comandos de PostgreSQL están restringidos.
- Pruébalo aplicando una actualización menor en la fase piloto y midiendo el efecto en las conexiones activas y el tráfico de la aplicación.
- Una señal de alerta es un servicio que se autodenomina completamente administrado mientras deja la aplicación de parches, las actualizaciones o las tareas de mantenimiento crítico al equipo de bases de datos, o uno que no puede documentar claramente su configuración y límites de actualización.
2. Alta disponibilidad y conmutación por error automática
La conmutación por error automática en las bases de datos Postgres significa que el servicio puede promover automáticamente una instancia en espera en otra zona de disponibilidad y declarar claramente qué sucede con las transacciones confirmadas durante la conmutación por error. La alta disponibilidad protege contra fallas dentro de una región, pero no es lo mismo que la recuperación ante desastres.
Pregunta si la instancia en espera utiliza replicación sincrónica o asincrónica, qué punto de recuperación admite el proveedor y si el punto de conexión de la base de datos sigue siendo el mismo después de la promoción. Por lo general, las aplicaciones deberán reconectarse después de que se caigan las conexiones existentes, por lo que el proveedor debe documentar el comportamiento esperado. En un clúster de varios nodos, confirma qué nodos se pueden promover y cómo las aplicaciones encuentran el nuevo nodo principal. Asegúrate de que tus grupos de conexiones y controladores, ya sea en Java, Python u otro lenguaje, manejen las reconexiones de forma limpia.
- Pregunta si la alta disponibilidad utiliza replicación sincrónica y si la instancia en espera se ejecuta en una zona de disponibilidad independiente.
- Pregunta cuánto suele tardar la conmutación por error y si se conservan las transacciones confirmadas.
- Pruébalo activando una conmutación por error, cronometrando la recuperación y comprobando los errores de la aplicación, las escrituras confirmadas y el comportamiento de la replicación.
- Una señal de alerta es la promoción manual o la ausencia de una garantía clara sobre las transacciones confirmadas.
3. Copias de seguridad, recuperación a un momento dado y recuperación ante desastres
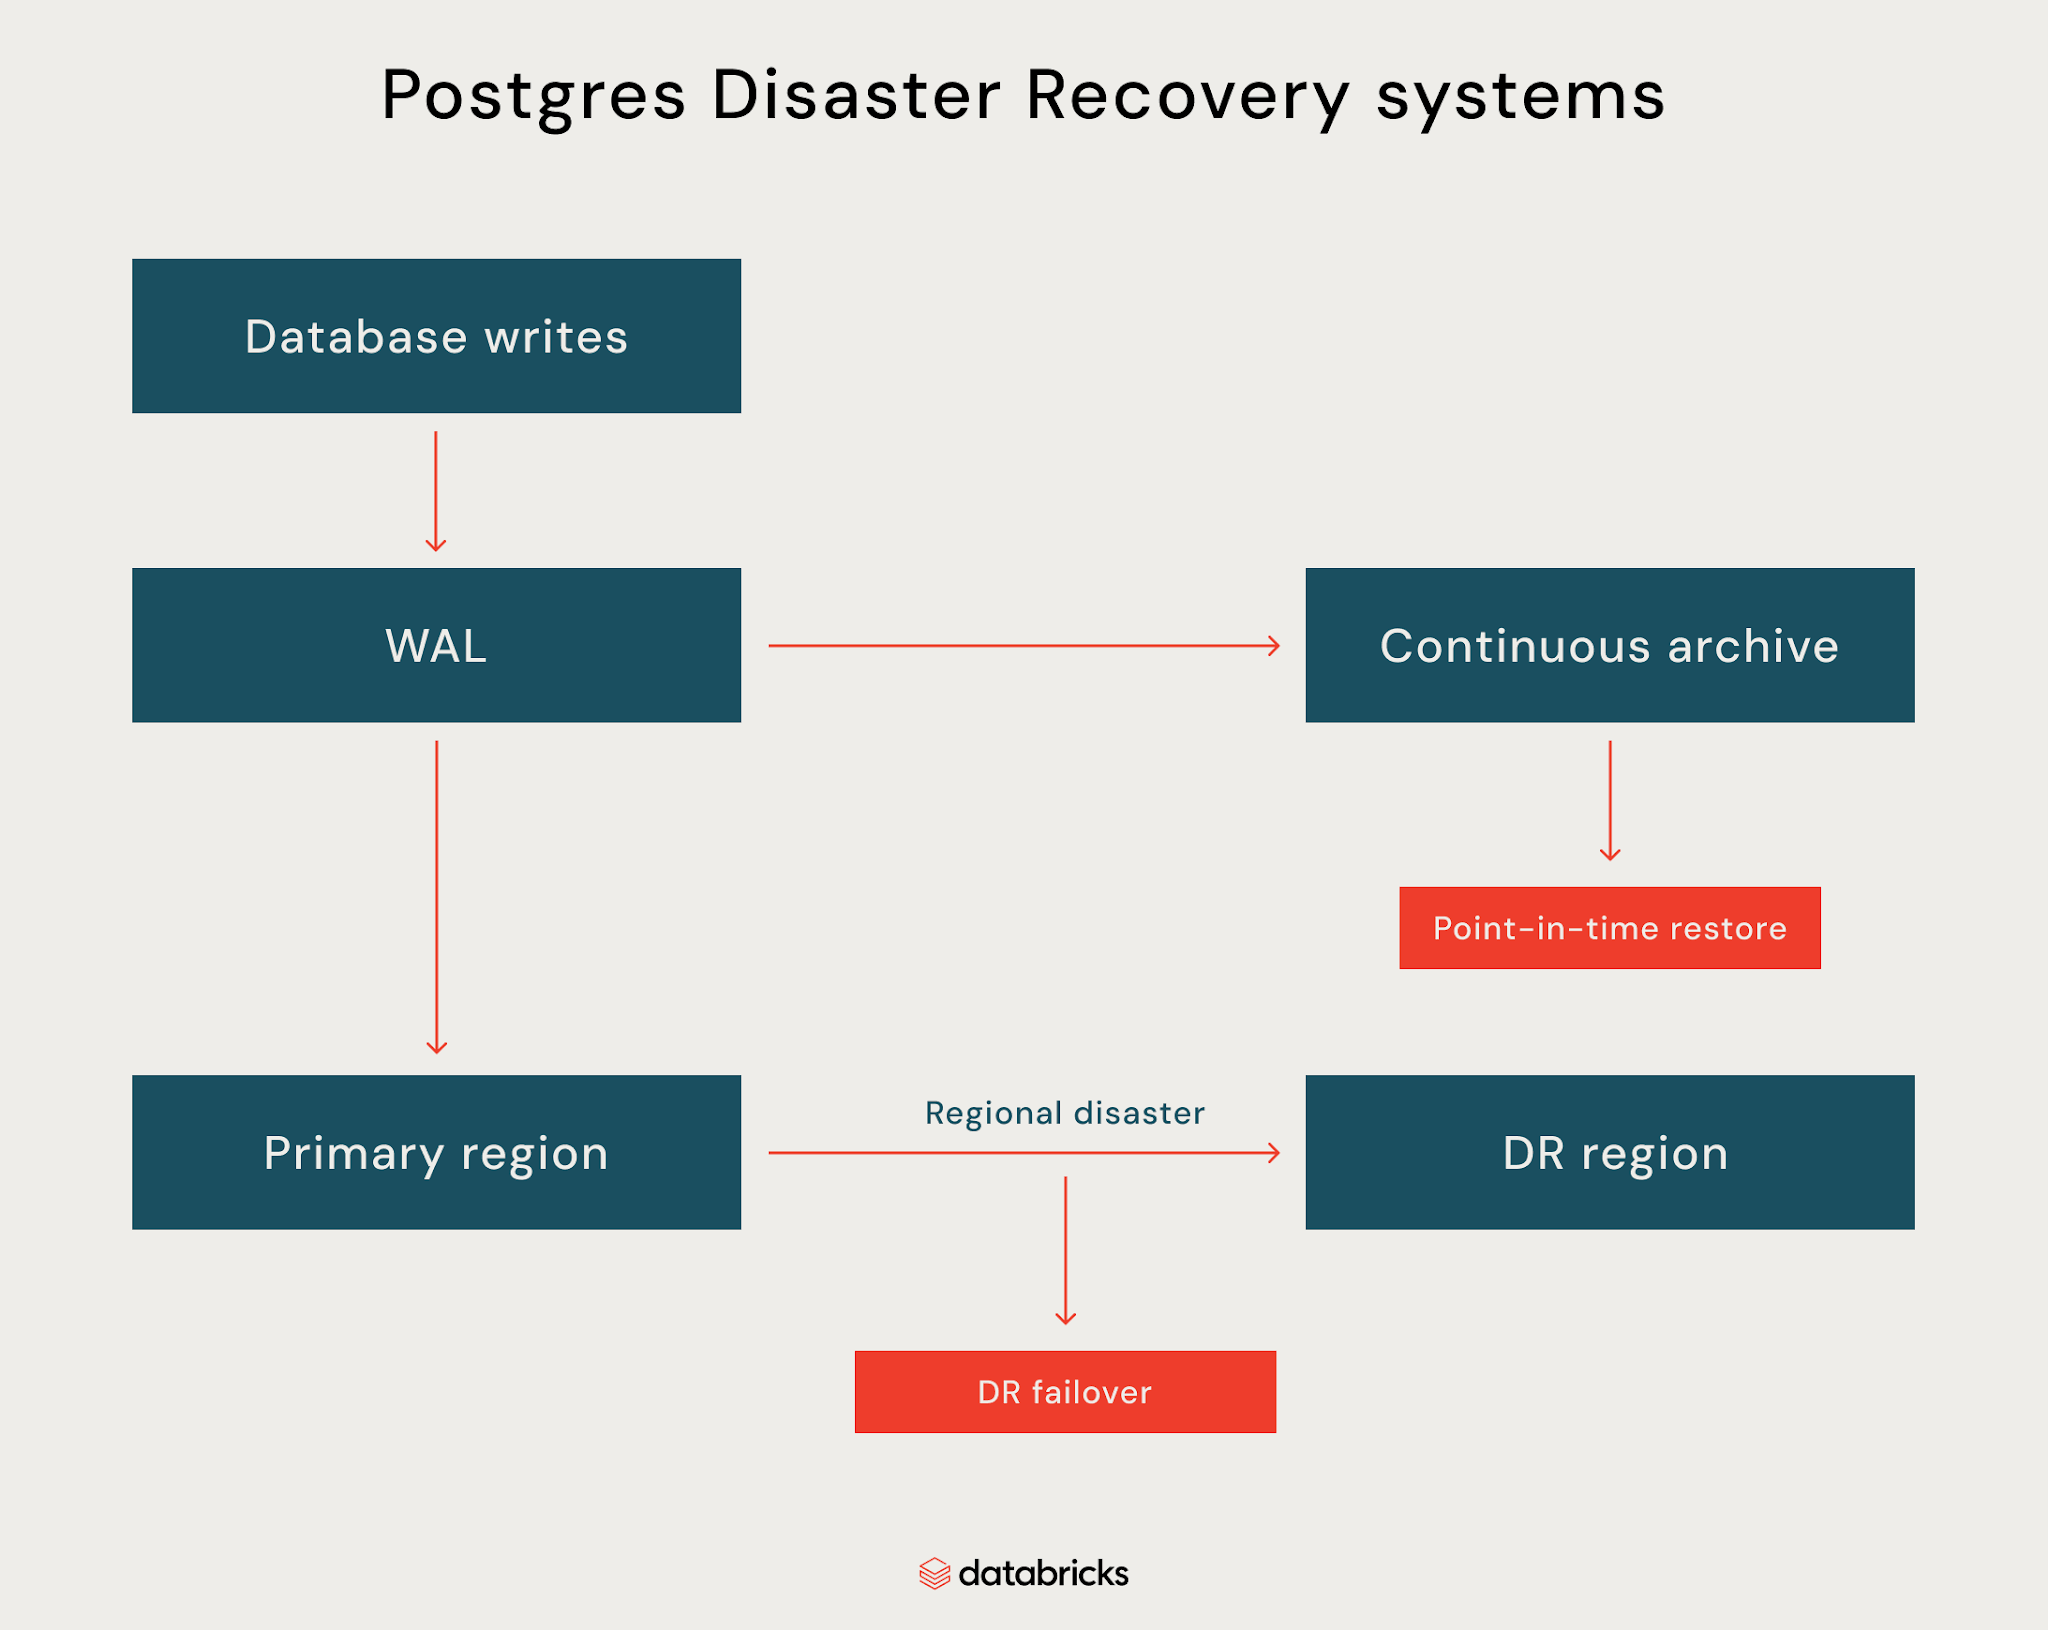
Las copias de seguridad y la recuperación ante desastres (DR) son importantes en las bases de datos. Verifica que las copias de seguridad puedan restaurar la base de datos a un punto específico en el tiempo y que el proveedor declare claramente sus objetivos de recuperación. El RPO define cuánta carga de trabajo se puede permitir perder. El RTO define cuánto tiempo puede permanecer no disponible la base de datos.
Pregunta si el servicio archiva continuamente el registro de escritura adelantada (WAL), cuánto tiempo permanece disponible la recuperación a un momento dado y si las restauraciones son de autoservicio. Para la recuperación ante desastres, comprueba si la replicación entre regiones es continua o periódica, si la conmutación por error es automática o manual, y si el proveedor publica objetivos de RPO y RTO. Las copias de seguridad automatizadas combinadas con el archivado continuo de WAL son lo que hace posible la recuperación a un momento dado y la restauración confiable de datos.
- Pregunta si puedes restaurar la base de datos a una marca de tiempo específica y cuánto suele tardar el proceso.
- Valida los registros críticos y las lecturas de la aplicación después de la restauración.
- Ejecuta un simulacro de recuperación ante desastres si el proveedor ofrece uno y documenta los pasos de recuperación.
- Una señal de alerta es que la recuperación ante desastres solo esté disponible mediante una solicitud de soporte o no tenga un RPO o RTO publicado.
4. Escalado y rendimiento
Verifica cómo el servicio maneja el crecimiento en computación, almacenamiento, conexiones y tráfico de lectura. El escalado no debe introducir tiempo de inactividad inesperado ni requerir que administres la infraestructura manualmente.
Pregunta si la computación puede escalar verticalmente, si hay réplicas de lectura disponibles, cómo escalan el almacenamiento y las operaciones de entrada/salida por segundo (IOPS), y si el agrupamiento de conexiones está integrado. En el caso de los servicios con autoescalado, comprueba qué activa el escalado, con qué rapidez cambia la capacidad y si el escalado afecta a las conexiones o transacciones activas. En la mayoría de los servicios administrados, escalar la CPU y la RAM suele requerir unos pocos clics o una única llamada a la API, lo que permite a los equipos adaptar la capacidad al crecimiento de los usuarios en lugar de lanzar nueva infraestructura.
- Pregunta si el escalado vertical requiere un reinicio o una conmutación por error.
- Pregunta cómo crece el almacenamiento y si existen límites en las conexiones, las IOPS o las réplicas.
- Compruébalo ejecutando una carga de producción representativa y probando un escalado vertical durante el tráfico activo.
- Mide la latencia de las consultas, los errores de conexión y el comportamiento de la aplicación antes y después del escalado.
- Una señal de alerta es un escalado que requiere un tiempo de inactividad prolongado o tiene límites de capacidad no documentados.
5. Seguridad, cumplimiento normativo y control de acceso
Valida cómo protege el servicio los datos en tránsito y en reposo, controla el acceso a la base de datos y se conecta a la red. Las características de seguridad deben coincidir con los requisitos de identidad y cumplimiento existentes de la organización en lugar de requerir un modelo operativo separado.
Pregunta si se admite la conectividad privada, cómo se integra la gestión de identidades y accesos (IAM) con los roles de la base de datos y si hay claves gestionadas por el cliente (CMK) disponibles. Comprueba también el registro de auditoría, los controles de cifrado y el ámbito de cumplimiento del proveedor. Pregunta si las aplicaciones pueden conectarse a través de una dirección IP privada, una pública o ambas. La mayoría de los proveedores administrados aplican el cifrado en reposo y en tránsito y aplican parches rutinarios del sistema operativo y actualizaciones de seguridad automáticamente, así que confirma qué marcos de cumplimiento, como HIPAA o GDPR, admite el servicio.
- Pregunta si las bases de datos pueden ejecutarse sin acceso a internet público.
- Pregunta cómo se registran la actividad de la base de datos, las acciones administrativas y los eventos de autenticación.
- Verifica que las claves de cifrado se puedan rotar o revocar sin interrumpir la base de datos.
- Compruébalo conectándote a través de la ruta de red privada prevista y probando el acceso con diferentes roles.
- Una señal de alerta es un servicio que requiere conectividad pública, ofrece una visibilidad de auditoría limitada o no admite los controles de seguridad requeridos por la organización.
6. Compatibilidad y extensiones de Postgres
Debes comprobar que el servicio es compatible con las versiones de PostgreSQL, extensiones, controladores y opciones de configuración de las que depende la carga de trabajo. La compatibilidad debe probarse con la aplicación real en lugar de inferirse de la afirmación del proveedor de que admite PostgreSQL.
Verifica qué versiones de PostgreSQL están disponibles, con qué rapidez se vuelven compatibles las nuevas versiones principales y qué extensiones están habilitadas. Comprueba la compatibilidad con extensiones como pgvector, PostGIS y cualquier dependencia específica de la aplicación. Confirma también qué parámetros, roles y comandos de PostgreSQL están restringidos. Comprueba si las restricciones de superusuario afectan a las tablas, funciones o extensiones existentes, y si los objetos que existen en tu base de datos actual necesitarían cambiar. Los equipos autogestionados a menudo ejecutan PostgreSQL en Ubuntu u otra distribución de Linux con acceso completo al sistema operativo, por lo que las dependencias del sistema operativo deben identificarse con antelación.
- Solicita la lista completa de extensiones compatibles y las limitaciones específicas de cada versión.
- Pregunta si los controladores de aplicaciones, los ORM y las herramientas estándar de PostgreSQL funcionan sin modificaciones.
- Prueba las extensiones necesarias y los parámetros de la base de datos antes de la migración.
- Compruébalo restaurando un esquema representativo y ejecutando las migraciones y pruebas de integración de la aplicación.
- Una señal de alerta es que una extensión crítica no sea compatible o que la compatibilidad dependa de soluciones alternativas no documentadas.
Para las cargas de trabajo de IA, la compatibilidad con pgvector es importante para la búsqueda de vectores junto con las cargas de trabajo transaccionales.
La guía de IA agéntica para la empresa

7. Rutas de migración desde Postgres y otras bases de datos
Verifica cómo el proveedor admite tanto la migración de datos inicial como la transición final. Un método de migración que funciona para una base de datos pequeña puede no ser práctico para un sistema de producción que debe seguir ofreciendo servicio durante el traslado.
Pregunta si el servicio admite la replicación lógica, la captura de datos modificados (CDC), las herramientas nativas de PostgreSQL y los servicios de migración de terceros. Para las migraciones desde otros motores de bases de datos, comprueba qué sistemas de origen son compatibles y cómo se gestionan la conversión de esquemas, la validación de datos y los cambios en las aplicaciones. Mover una base de datos de producción desde otras bases de datos, como Oracle o SQL Server, también requiere la conversión de esquemas y pruebas de aplicaciones.
- Pregunta si las bases de datos grandes se pueden migrar sin un tiempo de inactividad prolongado.
- Pregunta cómo se replican los cambios continuos durante la ventana de migración.
- Compruébalo migrando un conjunto de datos representativo, ejecutando comprobaciones de validación y midiendo el tiempo de transición final.
- Una señal de alerta es un proceso de migración que depende enteramente del volcado y la restauración o que requiere un tiempo de inactividad prolongado de la aplicación.
Tu solución de migración debe tener en cuenta las dependencias de tu entorno de datos y minimizar las interrupciones.
8. Precios y coste total de propiedad
Un servicio administrado puede añadir costes de almacenamiento, copias de seguridad, alta disponibilidad, réplicas, transferencia de red y otros recursos basados en el uso. Gran parte del ahorro en comparación con las implementaciones autogestionadas proviene de evitar el hardware y el mantenimiento locales, así que averigua qué características se incluyen en el precio base y cuáles son complementos de pago.
Comprueba cómo se tarifican la computación, el almacenamiento, las IOPS, las copias de seguridad, las réplicas y la salida de red. Comprueba si los precios cambian con el autoescalado, la capacidad en espera o las configuraciones de mayor disponibilidad.
- Modela tanto el uso normal como el máximo, incluido el crecimiento del almacenamiento y la retención de copias de seguridad.
- Calcula el coste total de propiedad (TCO) durante el periodo de contrato previsto.
- Compruébalo creando un modelo de TCO de 12 meses que cubra la computación, la capacidad de espera de alta disponibilidad, las IOPS, las copias de seguridad, las réplicas y la salida de red para tu carga de trabajo prevista. No utilices únicamente la línea de computación.
- Una señal de alerta es un precio que solo muestra la computación de la base de datos mientras deja sin aclarar los costes de almacenamiento, copias de seguridad, réplicas o red.
Los precios basados en el uso pueden facilitar la alineación de los costes con la demanda de la carga de trabajo, pero los equipos deben modelar patrones de tráfico realistas antes de comprometerse.
9. Operaciones, monitorización y solución de problemas
Un servicio de producción necesita la suficiente visibilidad para que los equipos de bases de datos entiendan qué está sucediendo cuando el rendimiento o la fiabilidad se degradan. Las métricas de infraestructura por sí solas rara vez son suficientes para diagnosticar problemas de PostgreSQL.
Pregunta si el servicio ofrece métricas de bases de datos, registros e información a nivel de consulta, y si los equipos pueden configurar alertas para condiciones importantes. Averigua qué acceso tienen los ingenieros de soporte durante los incidentes y si hay especialistas de PostgreSQL disponibles para las escalaciones. Busca paneles con visibilidad en tiempo real de las métricas del sistema, y comprueba si los registros se pueden filtrar por base de datos o usuario y si puedes ordenar los eventos por hora o gravedad. También considera si tu cuenta con las habilidades para solucionar problemas de PostgreSQL usando solo las herramientas del proveedor.
- Pregunta qué métricas, registros y estadísticas de consultas de PostgreSQL están disponibles.
- Pregunta si los datos de monitoreo se pueden exportar a la plataforma de observabilidad existente de la organización.
- Pruébalo generando un problema de rendimiento controlado y usando las herramientas disponibles para identificar la causa raíz.
- Una señal de alerta es una visibilidad limitada a nivel de base de datos o un modelo de soporte que no puede investigar problemas específicos de PostgreSQL.
Para implementaciones grandes, pregunta si las herramientas del proveedor pueden mostrar patrones en todas tus bases de datos, y no solo métricas por instancia.
10. Portabilidad y salida
Un servicio de Postgres administrado debe hacer posible mover datos y aplicaciones a otro entorno de PostgreSQL sin depender de procesos de exportación propietarios.
Pregunta si se pueden usar herramientas estándar de PostgreSQL y replicación lógica para exportar los datos. Averigua si alguna extensión, API o formato de almacenamiento específico del proveedor dificultaría una salida. Cuantas más características únicas y específicas del proveedor dependa una aplicación, más difícil será la salida.
- Pregunta cómo funciona una exportación completa de la base de datos y si se puede ejecutar sin el soporte del proveedor.
- Pregunta si la replicación lógica puede transmitir datos a otro entorno de PostgreSQL.
- Pruébalo restaurando una exportación en un entorno de PostgreSQL separado y ejecutando pruebas de la aplicación.
- Una señal de alerta son los datos que solo se pueden exportar mediante una solicitud de soporte o un formato propietario.
Cómo ejecutar una prueba piloto antes de comprometerte
Una prueba piloto debe comprobar las afirmaciones del proveedor frente a una carga de trabajo que se asemeje a la de producción. Una lista de verificación de características puede mostrar lo que ofrece un servicio, pero las pruebas controladas de fallas y recuperación muestran si esas capacidades funcionan cuando importan.
Comienza con una base de datos representativa, tráfico de aplicaciones y las extensiones de PostgreSQL que requiere el sistema de producción. Luego, prueba las áreas con más probabilidades de afectar la decisión. Si prefieres un enfoque por fases, comienza con una carga de trabajo no crítica y amplía el piloto poco a poco.
- Ejecuta una conmutación por error y mide el tiempo de recuperación, la recuperación de conexiones y las transacciones perdidas.
- Restaura la base de datos a un punto específico en el tiempo y compara el resultado con los objetivos RPO y RTO esperados.
- Aplica una carga máxima representativa y prueba el escalado mientras la aplicación permanece activa.
- Ejecuta pruebas de migración y reversión, incluyendo cualquier extensión requerida y cambios en la aplicación.
- Prueba el monitoreo y la escalación de soporte.

Registra los resultados frente a los requisitos originales y trata las pruebas fallidas como puntos de decisión. La ramificación de bases de datos también puede ayudar a los equipos a crear entornos aislados para la migración y las pruebas de aplicaciones. Captura los resultados de manera uniforme para que la discusión posterior al piloto entre los equipos de ingeniería, seguridad y finanzas se mantenga objetiva.
Cómo se relaciona Lakebase con esta lista de verificación
Lakebase se alinea bien con varias de las áreas cubiertas en esta lista de verificación. La siguiente tabla muestra dónde coinciden sus capacidades con los requisitos comunes de producción, junto con las áreas que aún necesitan una evaluación más detallada.
| Área de la lista de verificación | Cómo se alinea Lakebase |
|---|---|
| Operaciones | Postgres administrado y sin servidor con operaciones de infraestructura automatizadas. |
| Alta disponibilidad | Promoción automática entre zonas de disponibilidad mientras se preservan las transacciones confirmadas. Las conexiones existentes deben reconectarse después de la conmutación por error. |
| Escalado | Autoescalado con procesamiento separado del almacenamiento, lo que permite ajustar la capacidad a la demanda de la carga de trabajo. |
| Seguridad | Es compatible con redes privadas y claves administradas por el cliente, junto con las capacidades de gobernanza de Databricks. |
| Compatibilidad con PostgreSQL | Es compatible con herramientas y extensiones de PostgreSQL, incluido pgvector. |
| Recuperación ante desastres | La recuperación ante desastres entre regiones se encuentra actualmente en Vista previa privada en AWS con conmutación por error manual. Si la recuperación regional es un requisito estricto, ponte en contacto con tu equipo de cuenta para obtener más información. |
| Costo | Los precios basados en el uso pueden alinear los costos con la demanda de la carga de trabajo, pero los equipos deben modelar su carga de trabajo esperada y sus patrones de uso. |
| Portabilidad | La compatibilidad estándar con PostgreSQL proporciona una base para las pruebas de migración y salida, pero aún se deben evaluar las dependencias específicas del proveedor. |
La lista de verificación ofrece a los equipos una forma coherente de comparar Lakebase, otros servicios de Postgres administrados y las implementaciones autoadministradas frente a sus requisitos de producción.
Para los equipos que evalúan Postgres administrado, la pregunta importante es cuánto del trabajo operativo realmente se elimina de su carga. Lakebase maneja la mayor parte de ese trabajo dentro de una región, mientras que la recuperación ante desastres entre regiones sigue siendo un área donde los equipos aún tienen responsabilidades.
Lakebase Postgres promueve automáticamente el procesamiento secundario entre zonas de disponibilidad mientras preserva las transacciones confirmadas y mantiene sin cambios la cadena de conexión. Las conexiones existentes aún deben reconectarse.

Lakebase documenta la recuperación ante desastres entre regiones como una Vista previa privada en AWS con conmutación por error manual, lo cual debe tenerse en cuenta cuando la recuperación regional sea un requisito de producción.
Lakebase también separa el procesamiento del almacenamiento y admite el autoescalado, lo que permite que la capacidad se ajuste a la demanda de la carga de trabajo en lugar de depender únicamente de un tamaño de base de datos fijo.
Para los equipos que utilizan Databricks, las redes privadas y las claves administradas por el cliente proporcionan controles adicionales para asegurar las implementaciones de Lakebase.
Preguntas frecuentes
¿Qué debo buscar en un servicio de Postgres administrado?
Concéntrate en las capacidades que afectan la confiabilidad y las operaciones de producción. La alta disponibilidad, las copias de seguridad, la recuperación en un punto en el tiempo, la recuperación ante desastres, el escalado, la seguridad, la compatibilidad con PostgreSQL, la migración, el costo y la portabilidad deben tener respuestas claras. Los proveedores también deben poder demostrar afirmaciones importantes mediante documentación y una prueba piloto similar a la de producción. Cada tema de esta lista de verificación debe tener una respuesta documentada antes de que te comprometas.
¿Cuáles son los beneficios de un servicio de Postgres administrado?
Un servicio administrado puede reducir el trabajo operativo que implica ejecutar PostgreSQL al hacerse cargo de la infraestructura, el mantenimiento, las copias de seguridad y otras tareas rutinarias. También puede proporcionar capacidades integradas de disponibilidad, escalado, seguridad y monitoreo. El valor depende de cuánta responsabilidad operativa asuma realmente el proveedor y de si el servicio sigue ofreciendo los controles que requiere la carga de trabajo.
¿Cuál es la diferencia entre Postgres administrado y Postgres autoadministrado?
Postgres administrado transfiere gran parte del trabajo de administración de bases de datos e infraestructura al proveedor. Postgres autoadministrado brinda a los equipos de ingeniería un mayor control sobre la infraestructura, la configuración, las extensiones y las actualizaciones, pero también los hace responsables de operar esos componentes. La elección correcta depende de la capacidad operativa de la organización, los requisitos de control y la carga de trabajo.
¿Cómo debo probar un servicio de Postgres administrado antes de la migración?
Usa una carga de trabajo representativa y prueba las capacidades que más importan para la producción. Ejecuta pruebas de conmutación por error, recuperación en un punto en el tiempo, escalado, migración y reversión. Mide los tiempos de recuperación, el comportamiento de las conexiones, la integridad de los datos y el rendimiento de la aplicación. El piloto también debe cubrir el monitoreo, la escalación de soporte y la exportación de datos. Cualquier capacidad que no se pueda demostrar debe seguir siendo un riesgo abierto.
(Esta entrada del blog ha sido traducida utilizando herramientas basadas en inteligencia artificial) Publicación original
Recibe las últimas publicaciones en tu bandeja de entrada
Suscríbete a nuestro blog y recibe las últimas publicaciones directamente en tu bandeja de entrada.