En imagerie biomédicale, le vrai goulot d'étranglement réside dans les données, pas dans le modèle
Des silos PACS à la multi-omique : pourquoi l'AI en imagerie bloque sur les données, et comment bâtir les fondations pour débloquer son potentiel.
par Parastou Eslami et Douglas Moore
- Ce dont il s'agit : Une perspective de terrain sur les raisons pour lesquelles l'IA d'imagerie médicale s'avère décevante dans les hôpitaux, le milieu académique, la medtech et la pharma ; à quoi ressemble une fondation de données plus solide pour la R&D.
- Le défi : L'imagerie constitue la donnée la plus riche de la médecine, mais aussi la moins exploitable : cloisonnée entre les PACS, les CRO et les laboratoires centraux, difficile à anonymiser et rarement liée aux autres modalités de données qui alimentent les biomarqueurs et la stratification des patients. Le plus difficile, ce sont les données, pas le modèle.
- À retenir : La priorité n'est pas d'avoir un meilleur modèle, mais la fondation de données sous-jacente. Gouvernez l'imagerie en un seul endroit, rendez-la interrogeable, anonymisez-la à grande échelle et liez-la aux données d'EHR, d'omique et d'essais cliniques (via des modèles de lakehouse gouvernés). Structurez correctement les données, et le modèle deviendra la partie la plus simple.
Partie I — Le problème
Quatre secteurs, un même goulot d'étranglement
Les hôpitaux et les systèmes de santé génèrent la matière première. La radiologie est le domaine de l'IA médicale le plus fortement réglementé : sur les quelque 950 dispositifs dotés d'IA/ML autorisés par la FDA à la mi-2024, environ 723 (près de 76 %) étaient des outils de radiologie. Presque tous sont spécialisés et supervisés par l'humain, effectuant du tri, des mesures, de la reconstruction ou de la priorisation des listes de travail. La vraie difficulté dans un hôpital réside rarement dans le modèle. Elle tient au fait que les données restent verrouillées au sein des PACS et des archives neutres (VNA) conçus pour afficher des images dans une visionneuse, et non pour répondre à des questions de recherche. Constituer une cohorte implique d'extraire les images des systèmes cliniques, de les anonymiser (les PHI se cachent dans les en-têtes DICOM et sont incrustées dans les pixels) et de trouver la puissance de calcul nécessaire à leur exploitation. Le modèle ne représente que les 10 % les plus faciles.
C'est dans les centres médicaux universitaires que se déroule la majeure partie de la science ouverte. Le domaine doit une grande partie de ses progrès à des jeux de données partagés comme MIMIC-CXR (377 110 radiographies thoraciques), The Cancer Imaging Archive, fastMRI et le volet imagerie de la UK Biobank, ainsi qu'à des outils open source comme MONAI, nnU-Net et 3D Slicer. Le monde académique met également en évidence le problème de crédibilité du secteur. Une revue réputée du BMJ (Nagendran et al., 2020) portant sur des études comparant le deep learning aux cliniciens en imagerie a révélé que sur 81 études, seule une poignée était prospective ou testée en situation clinique réelle, et que le code et les données n'étaient pas disponibles dans 93 % et 95 % des cas. Cette dette de reproductibilité découle directement de la difficulté à partager et à réexploiter les données d'imagerie.
Les entreprises de medtech et de dispositifs médicaux (GE HealthCare, Siemens Healthineers, Philips, Canon) intègrent l'IA directement dans les scanners : reconstruction par deep learning qui raccourcit la durée des examens, réduction des doses d'exposition, tri embarqué sur l'appareil. Leur plus grand défi est la généralisation. Un algorithme entraîné sur le scanner, l'intensité de champ et le protocole d'un constructeur peut discrètement perdre en performance sur ceux d'un autre. Constituer des jeux de données d'entraînement multisites représentatifs du monde réel, puis en apporter la preuve aux organismes de réglementation via les voies 510(k) et PMA, constitue à la fois un avantage concurrentiel et un coût majeur.
Les secteurs pharmaceutique et biotechnologique considèrent l'imagerie comme un instrument de mesure. Les essais en oncologie reposent sur des critères de réponse standardisés comme RECIST, iRECIST et RANO, analysés de manière centralisée et en aveugle pour éliminer les biais liés aux sites, et les biomarqueurs d'imagerie quantitative peuvent détecter la réponse au médicament plus tôt que les mesures basées sur la taille. Tout cela ne fonctionne que si une mesure a exactement la même signification d'un site, d'un scanner ou d'une époque à l'autre ; c'est pourquoi la QIBA de la RSNA établit des profils fixant l'acquisition et l'analyse avec une précision définie. La variabilité est l'ennemie numéro un des critères d'évaluation des essais.
Quatre métiers différents, un même goulot d'étranglement. Les pixels sont partout, mais interrogables nulle part.

Pourquoi la collaboration est la clé du succès, et pourquoi elle est si difficile
Aucune institution ne détient à elle seule suffisamment de données variées pour concevoir un modèle généralisable. L'étude collaborative la plus aboutie à ce jour en apporte la preuve. Dans l'étude EXAM (Nature Medicine, 2021), 20 institutions ont entraîné un modèle partagé pour prédire les besoins en oxygène liés à la COVID-19 à partir de radiographies thoraciques et de données du dossier patient informatisé (DPI), sans échanger aucune donnée patient. Seuls les poids du modèle ont circulé, et le modèle fédéré a gagné en moyenne 16 % en AUC et 38 % en généralisabilité par rapport aux modèles monosites. La mécanique est moins complexe qu'il n'y paraît : chaque site s'entraîne localement, un coordinateur calcule la moyenne des poids du modèle plutôt que celle des données (la formule classique de federated averaging), tandis que l'agrégation sécurisée et la confidentialité différentielle empêchent la reconstruction des dossiers d'un site à partir de ces poids.
Telle est la promesse. En réalité, la collaboration s'avère particulièrement complexe pour des raisons structurelles plutôt que techniques :
- Hétérogénéité des données. Des scanners, des protocoles et des conventions d'annotation différents font qu'un examen considéré comme « identique » ne l'est souvent pas. Les modèles fédérés voient leurs performances se dégrader sur ces données non-IID présentant des biais d'acquisition, à moins d'adapter la conception via des techniques comme la moyenne de normalisation par lots (batch-normalization averaging) ou l'harmonisation adaptée au site.
- Confidentialité et gouvernance. Chaque étude multi-institutionnelle implique des approbations de comités d'éthique (IRB) par site, des accords d'utilisation des données et des processus d'anonymisation irréprochables.
- Absence de socle commun. Des consortiums comme MIDRC (co-dirigé par l'ACR, la RSNA et l'AAPM) existent précisément parce que l'ingestion, la curation, l'anonymisation, l'annotation et le partage sont si difficiles qu'ils nécessitent un effort national dédié.
En imagerie, la collaboration n'est pas un simple atout : c'est la seule voie pour créer des modèles efficaces en dehors de l'établissement où ils ont été entraînés. Son succès dépend quasi exclusivement de l'infrastructure de données et de sa gouvernance.
La complexité invisible pour les personnes extérieures au domaine
Lorsque l'on parle d'« images médicales », on pense généralement à une radiographie pulmonaire. En réalité, il existe une véritable jungle de formats et d'échelles qui fait fléchir les outils de données génériques.
| Type d'imagerie | Formats | Dimensions et échelle | Pourquoi les outils génériques fléchissent |
|---|---|---|---|
| Radiologie — Radiographie, TDM (CT), IRM | DICOM, encodable dans une douzaine de syntaxes de transfert (non compressé → JPEG 2000 → HTJ2K) | Radiographie 2D → volumes 3D CT/IRM → imagerie cardiaque dynamique 4D | Conçu pour transférer des examens entre machines, non pour des analyses de masse ; les décodeurs (pydicom, GDCM, pylibjpeg) fonctionnent sur un seul thread — traiter quelques examens est simple, en traiter plusieurs millions relève des systèmes distribués. |
| Pathologie numérique — images de lames entières (WSI) | Formats propriétaires : Aperio .svs, Hamamatsu .ndpi, Philips iSyntax (via OpenSlide) ; quasi aucun DICOM | Gigapixel — plusieurs Go, des dizaines de milliers de tuiles, lues en pyramide à différents grossissements | Trop volumineuses pour être chargées en mémoire ; la coloration et la colorimétrie des scanners varient d'un laboratoire à l'autre, devenant une source d'erreur propre au modèle. |
| Ophtalmologie, dermatologie et autres | Volumes OCT, photographie clinique, chacun avec ses propres conventions | 2D et 3D, spécifiques à chaque modalité | Un ensemble supplémentaire de formats qu'un outil conçu pour gérer un simple dossier de fichiers JPEG ne peut absolument pas prendre en charge. |
L'« imagerie médicale » n'est pas un bloc homogène, mais un vaste ensemble de formats et d'échelles. Les archives de recherche atteignent plusieurs pétaoctets, à tel point que leur anonymisation à grande échelle constitue un domaine de recherche publié à part entière.
Il existe un second type de complexité qui compromet silencieusement les études : les chiffres eux-mêmes ne sont pas comparables d'un site à l'autre. Une valeur de fixation normalisée (SUV) ou un volume tumoral mesuré sur deux scanners avec deux protocoles différents ne constituent pas la même mesure. C'est pourquoi l'imagerie quantitative s'appuie sur des standards tels que les profils QIBA et les définitions de l'IBSI pour les caractéristiques radiomiques, et pourquoi c'est généralement la reproductibilité, plutôt que la précision brute, qui fait défaut.
Un outil conçu pour traiter un dossier de fichiers JPEG ne peut rien gérer de tout cela, ce qui explique en grande partie pourquoi l'imagerie a pris du retard par rapport à la génomique et aux données du DPI pour devenir prête à l'analyse.
L'imagerie est la partie la plus critique d'un problème bien plus vaste
Ce qu'il est facile de négliger lorsqu'on se concentre uniquement sur les images : tout ce qui précède s'applique également au reste de la R&D. L'imagerie est simplement le domaine où la difficulté émerge en premier, car les données y sont les plus volumineuses et les plus atypiques.
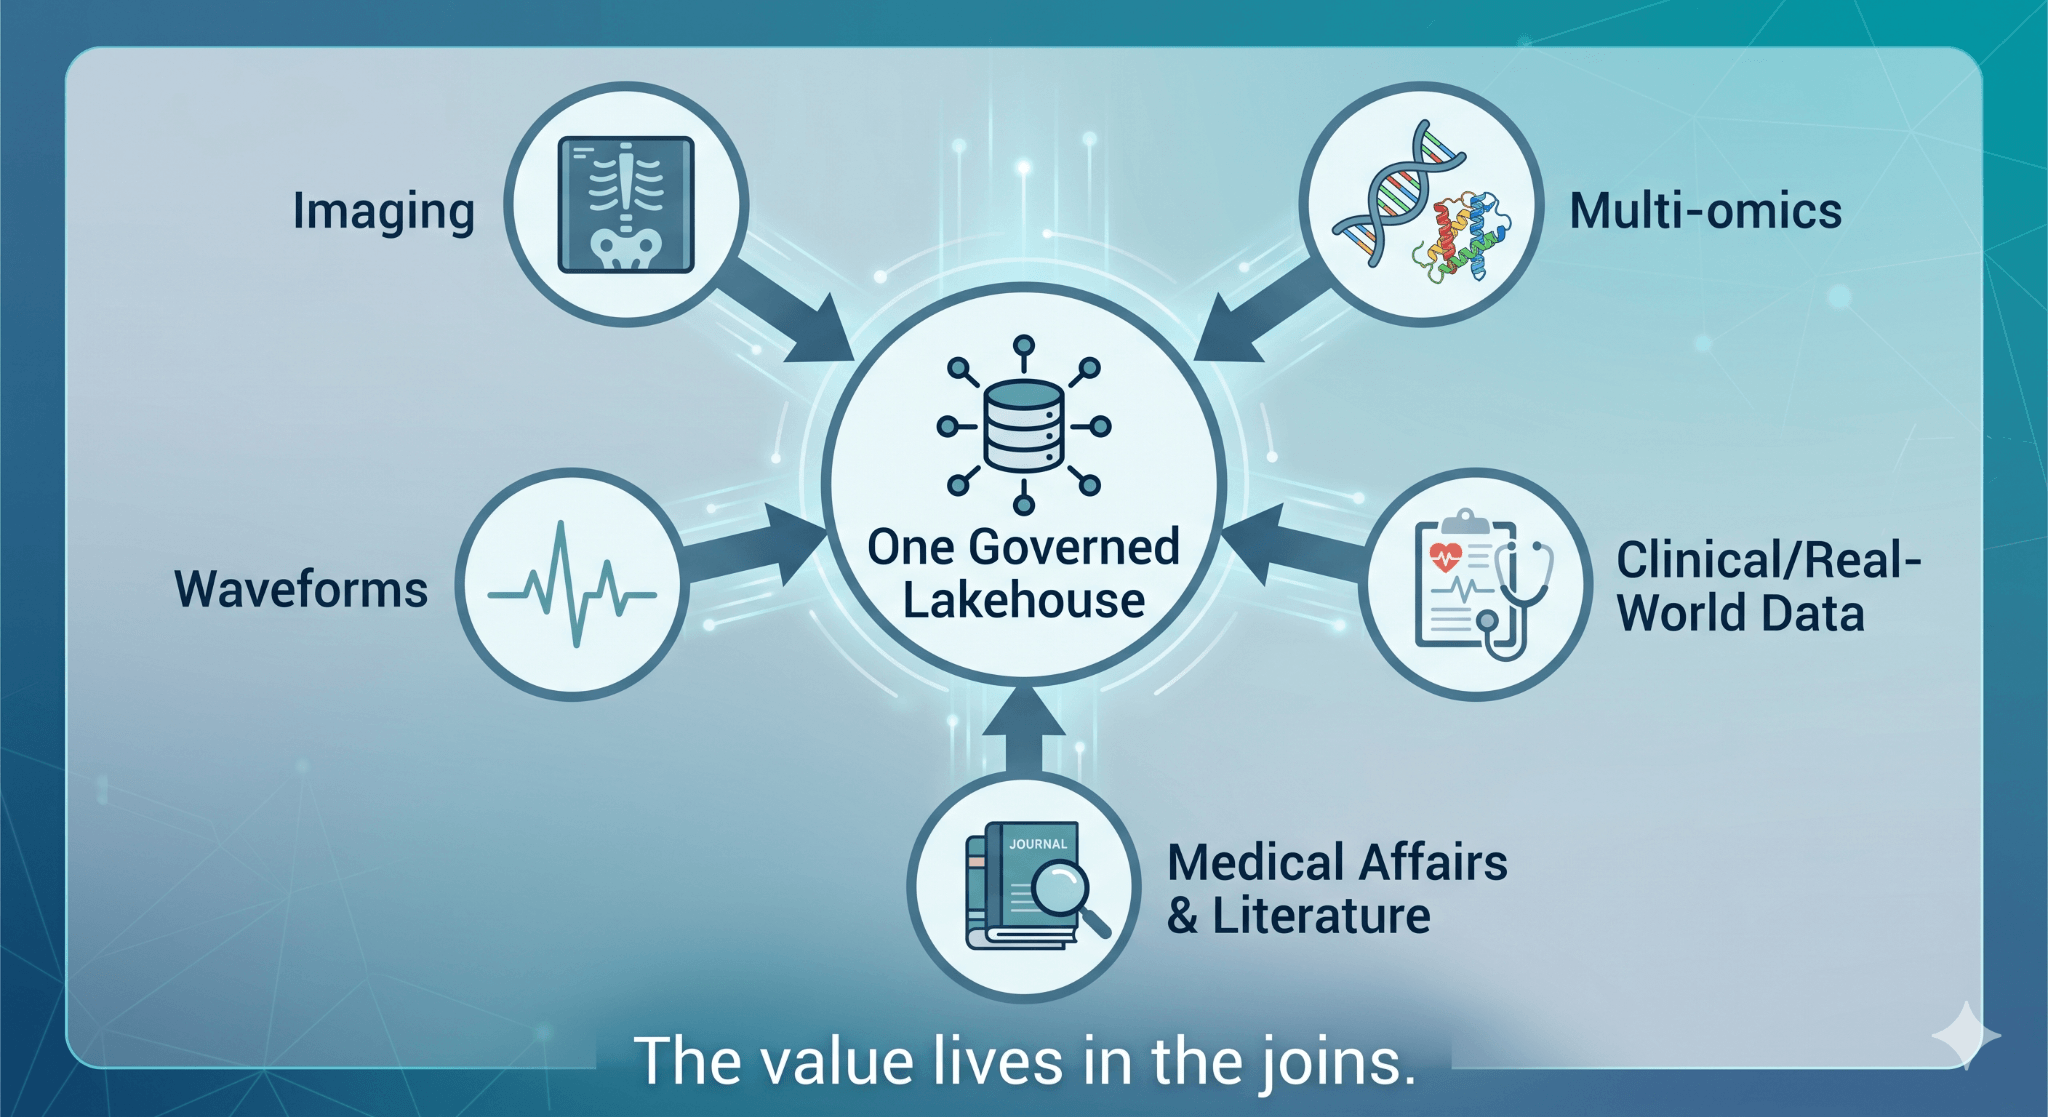
Visitez aujourd'hui une organisation de R&D en sciences de la vie et vous verrez que le véritable défi ne réside dans aucun type de données pris isolément. Il réside dans la multi-omique : la génomique, la transcriptomique, la protéomique et la métabolomique, qui arrivent chacune avec leurs propres formats et silos. Il réside dans les données du monde réel et des essais cliniques, les DPI, les registres et les signaux physiologiques. Il réside dans les affaires médicales et la littérature scientifique. Les questions qui font réellement avancer un programme — quels patients répondent au traitement et pourquoi, ce que révèlent conjointement l'image, la signature moléculaire et le résultat clinique — se trouvent au croisement de ces domaines, et non au sein d'un seul d'entre eux.
Chacun de ces types de données souffre des mêmes maux que l'imagerie. Elles sont riches, de grande dimension, majoritairement non structurées, bloquées dans des systèmes métiers, difficiles à gouverner et plus difficiles encore à lier entre elles. Une image de lame entière, un variant génomique et un critère d'évaluation d'essai clinique posent chacun leurs propres défis. Toute la valeur réside dans la capacité à les faire converger. C'est un problème de socle de données avant d'être un problème d'IA, et c'est celui que les équipes sous-estiment le plus.
Ce constat ne s'applique pas uniquement à la santé. Une étude récente de Bain analysant pourquoi les budgets consacrés à l'IA augmentent sans que les retours ne suivent a révélé que l'accès aux données et leur intégration constituent le principal obstacle à l'adoption de l'IA, cité par 41 % des entreprises et mentionné encore plus fréquemment par les leaders que par les retardataires. Leur conclusion sans détours : la plupart des organisations ne parviennent toujours pas à accéder de manière fiable à leurs propres données. Le secteur médical rend simplement ce constat impossible à ignorer.
Partie II — Le socle
C'est ici que le sujet devient plus concret et technique. Pour les lecteurs qui ne développent pas la plateforme, la version courte est simple : gouverner l'ensemble au même endroit, rendre les pixels interrogables, anonymiser à grande échelle et lier l'imagerie au reste des données du patient. La suite de cette section explique comment y parvenir.
Ce que le socle de données doit concrètement accomplir
En faisant abstraction des spécificités sectorielles, les exigences restent les mêmes. La plateforme doit :
- Gouverner les fichiers d'imagerie non structurés et leurs métadonnées extraites en un seul endroit, avec un contrôle d'accès, une traçabilité et une auditabilité répondant aux exigences des organismes de réglementation.
- Traitez des données à l'échelle du pétaoctet, gigapixel et multidimensionnelles (radiographies 2D, volumes scanner/IRM 3D, études dynamiques 4D, lames de pathologie gigapixel) sans jamais flancher.
- Anonymisez à grande échelle, aussi bien dans les en-têtes que dans les pixels.
- Liez l'imagerie au EHR, à la génomique, aux signaux physiologiques et au texte, pour qu'une seule question de recherche puisse traiter l'ensemble de ces données.
- Faites du partage inter-établissements une simple étape de configuration, plutôt qu'une négociation de six mois.
C'est toute la puissance d'un lakehouse. Voici comment cela se traduit en pratique, en utilisant des modèles qui fonctionnent sur Databricks.
Une architecture médaillon pour Pixels
Le modèle mental qui rend l'imagerie exploitable est le même schéma médaillon que les équipes utilisent déjà pour les données tabulaires, adapté aux fichiers binaires.
- Bronze : les études brutes arrivent d'abord dans un stockage d'objets cloud à accès restreint ou un Volume, où un traitement d'anonymisation s'exécute sur les en-têtes et les pixels avant toute autre chose ; les fichiers anonymisés forment ensuite la couche bronze gouvernée dans Unity Catalog Volumes, avec une ligne de catalogue par fichier, Auto Loader gérant l'arrivée incrémentielle pour que les nouvelles études arrivent en continu plutôt que par paquets nocturnes fragiles.
- Silver : les balises DICOM au format texte sont extraites dans des tables Delta (les objets binaires comme les données de pixels restent dans le fichier), ce qui permet d'interroger en SQL simple les métadonnées qui étaient prisonnières des fichiers. C'est l'étape qui transforme « une visionneuse peut l'ouvrir » en « un analyste peut l'interroger ». L'accélérateur open-source Pixels fait exactement cela : il catalogue les fichiers en parallèle et extrait les balises à grande échelle.
- Gold : des cohortes structurées et prêtes pour l'analyse, jointes aux tables cliniques et omiques, prêtes pour l'entraînement, la BI ou une étude destinée aux autorités réglementaires.
Ce qui rend cela complexe, c'est le débit. Les bibliothèques de traitement DICOM fonctionnent sur un seul cœur ; l'astuce consiste à les distribuer. En pratique, cela signifie utiliser des UDF pandas et mapInPandas pour répartir le traitement sur un cluster, ou une source de données Spark personnalisée. Dans les travaux publiés par l'équipe Pixels, une source de données zipdcm lit les métadonnées DICOM directement depuis les archives zip en mémoire, en laissant les fichiers d'origine compressés sur place : elle a catalogué plus de 107 000 fichiers DICOM en environ 3,5 minutes sur deux nœuds workers à 8 cœurs, soit environ 7 fois plus vite que les approches précédentes. Le goulot d'étranglement passe ainsi du disque et des E/S réseau à une pure analyse CPU, ce pour quoi un cluster est idéalement conçu.

Une gouvernance à l'épreuve des audits
L'imagerie représente le défi ultime en matière de gouvernance des données non structurées, et c'est l'exigence sur laquelle la plupart des plateformes échouent en silence. Unity Catalog Volumes gouverne les fichiers bruts dans S3, ADLS ou GCS sous un espace de noms à trois niveaux, tandis que les métadonnées extraites arrivent dans Delta. Les deux reposent sur un modèle unique de contrôle d'accès et de traçabilité qui s'étend jusqu'aux modèles entraînés sur ces données. C'est ce qui permet de répondre des mois plus tard à la question : « qui a manipulé cette cohorte et qu'a-t-on créé à partir d'elle ? ». La sécurité au niveau des lignes et des colonnes, ainsi que les règles basées sur les attributs, permettent à une organisation d'exposer largement des métadonnées anonymisées tout en conservant un accès restreint aux pixels sous-jacents.
L'anonymisation est le moment où les choses deviennent concrètes. L'IIP de l'en-tête est gérée avec un chiffrement préservant le format afin que le même identifiant de patient corresponde toujours au même pseudonyme. Ce détail est plus important qu'il n'y paraît : cela signifie que le scanner d'un patient peut toujours être lié à sa pathologie et à ses analyses de laboratoire dans tous les jeux de données, sans jamais exposer son identifiant réel. Les profils de confidentialité de la norme DICOM définissent ce qu'il faut supprimer et ce qu'il faut conserver. Le problème le plus difficile concerne l'IIP incrustée dans les pixels, comme le nom du patient imprimé sur une échographie ou un formulaire numérisé. Les outils classiques comme Presidio gèrent très bien le texte libre, mais manquent les images. La suppression de ces IIP incrustées est un sujet de recherche actif : des travaux récents montrent que les modèles vision-langage surpassent désormais les pipelines basés uniquement sur l'OCR pour la détection et le masquage (Lee et al., Radiology 2025), et des méthodes d'anonymisation en production qui associent le nettoyage des métadonnées DICOM à un OCR ciblé sur le texte incrusté ont été validées sur des centaines de milliers d'images couvrant dix modalités (Macdonald et al., 2024). Pour les pixels, l'équipe Pixels a publié un pipeline basé sur un modèle vision-langage qui combine l'OCR avec un VLM et s'exécute de façon distribuée avec des UDF pandas. Sur un échantillon équilibré du benchmark MIDI-B, GPT-4o et Claude 3.7 Sonnet ont atteint près de 100 % de rappel et de précision, le modèle ouvert Llama 4 Maverick a atteint 100 % de rappel pour une fraction du coût, et Spark a réduit l'anonymisation de 1 000 images de 105 minutes à seulement 6. L'équipe explore également une approche VLM pure, plus légère, pour aller encore plus loin.
Entraînement et mise en service sur les mêmes données gouvernées
Une fois les pixels interrogables et gouvernés, la couche ML cesse d'être la partie difficile. Les modèles de segmentation et de classification s'enregistrent dans le même catalogue en tant que modèles MLflow, avec leur traçabilité liée à la cohorte exacte sur laquelle ils ont été entraînés. Pour l'imagerie spécifiquement, NVIDIA MONAI et VISTA-3D (un modèle de fondation de segmentation couvrant 127 classes anatomiques) s'intègrent pour l'auto-segmentation et l'ajustement fin, avec une visionneuse OHIF intégrée dans une Databricks App pour qu'un radiologue ou un pathologiste puisse réviser, corriger et réétiqueter les données sous le modèle de sécurité de la plateforme.
La boucle d'apprentissage actif de MONAI Label signifie que chaque correction améliore le lot suivant, ce qui permet aux équipes de sortir de l'impasse consistant à devoir disposer d'un jeu de données entièrement annoté avant de pouvoir commencer. L'inférence s'exécute soit sous forme de service de modèle sur GPU en temps réel (avec mise à l'échelle jusqu'à zéro pour qu'un modèle rarement utilisé ne consomme pas un GPU), soit sous forme d'inférence par lots distribuée sur des millions d'études. Et parce que les récents travaux sur Pixels intègrent un service DICOMweb (QIDO-RS, WADO-RS, STOW-RS), le lakehouse peut s'insérer directement dans un flux de travail clinique ou PACS/VNA plutôt que de rester à l'écart.
Prouver la sécurité : validation, dérive et parcours réglementaire
Entraîner un modèle n'est que le début, pas la fin. Un modèle parfait sur le scanner d'un site peut silencieusement se dégrader sur celui d'un autre ; le vrai travail consiste donc à procéder à une validation externe sur plusieurs sites, fournisseurs et protocoles, puis à surveiller les dérives au fur et à mesure que les scanners sont mis à niveau et que les protocoles évoluent en production. MLflow gère l'évaluation et le suivi ; la discipline la plus exigeante consiste à traiter chaque modèle comme une ressource versionnée associée à sa cohorte, ses métriques et ses approbations. Pour tout ce qui touche au domaine clinique, les autorités réglementaires ont commencé à faire un pas vers l'IA adaptative. Le Predetermined Change Control Plan (PCCP) de la FDA permet aux équipes de prédéterminer comment un modèle peut être réentraîné et mis à jour sans nécessiter une nouvelle soumission à chaque fois, et les Good Machine Learning Practice (GMLP) définissent les attentes relatives aux données, à la validation et à la surveillance. Intégrer ces garde-fous directement dans le socle de données, plutôt que de les ajouter après coup, est ce qui distingue une simple démonstration d'une solution déployable à l'hôpital.
Collaborer sans déplacer les données
Il existe deux façons complémentaires d'obtenir la diversité inter-établissements dont l'étude EXAM a démontré la nécessité, et elles répondent à des problèmes différents.
L'apprentissage fédéré conserve physiquement les données sur place et ne déplace que les poids des modèles, en utilisant la moyenne fédérée pour les combiner, ainsi qu'une agrégation sécurisée et la confidentialité différentielle pour éviter toute fuite des données d'un site. C'est le bon outil lorsque les données ne peuvent légalement pas être déplacées.
Le lakehouse apporte une seconde option souvent plus simple en pratique : Delta Sharing et Clean Rooms permettent aux institutions de partager des tables et des fichiers gouvernés (ou de mener des analyses conjointes sur des cohortes anonymisées) sans rien copier, en utilisant la distribution d'identifiants plutôt que l'exportation de données. Pour de nombreuses recherches multi-sites, « partager une vue gouvernée de la cohorte » est bien plus simple que de mettre en place un réseau d'entraînement fédéré, et les deux approches peuvent tout à fait être combinées.
Rendre l'imagerie multimodale
C'est l'exigence qui transforme l'imagerie d'une modalité isolée en une composante intégrée du parcours du patient. Comme les métadonnées reposent tout simplement sur Delta, l'imagerie peut être jointe aux flux FHIR et HL7 du EHR, aux tables de variants génomiques, aux signaux physiologiques et aux textes cliniques, l'identité du patient étant résolue grâce à la couche de pseudonymisation. Des modèles de données communs comme OMOP offrent un schéma partagé pour accueillir ces données d'observation. De plus, Vector Search indexe les embeddings pour la recherche sémantique (Pixels propose même une fonction qui associe un terme en langage naturel à la bonne balise DICOM), et des outils en langage naturel comme Genie permettent à un chercheur de générer une cohorte par une simple requête, sans avoir à écrire du SQL.
Les signaux physiologiques constituent une catégorie de données à part entière. Un ECG, un tracé de pression artérielle ou un retrait d'IVUS ou d'OCT est une série temporelle haute fréquence échantillonnée des centaines ou des milliers de fois par seconde, généralement stockée dans des formats comme WFDB plutôt que DICOM. Le défi technique réside dans l'alignement : une image de retrait ou un battement d'ECG n'a de sens que s'il est synchronisé dans le temps avec l'image et l'événement clinique auquel il appartient. Réussir cet alignement, rééchantillonner, réconcilier les horodatages et stocker la série à côté de l'étude est exactement le type de jointure rentable lorsqu'il s'agit de comprendre pourquoi un patient a répondu, et pas seulement s'il a répondu.
Les embeddings débloquent également des fonctionnalités bien plus puissantes que la simple recherche. Les modèles image-texte entraînés sur des paires d'imageries et de comptes rendus (dans la lignée de BiomedCLIP et CheXzero) placent les images et le langage dans un espace vectoriel partagé. Ainsi, les systèmes peuvent rechercher des cas similaires, signaler des anomalies sans étiquette explicite ou ancrer un modèle génératif dans les images réelles et les rapports antérieurs d'un patient plutôt que dans ses seules données d'entraînement. Ce dernier modèle, la génération augmentée par récupération (RAG) sur des images et des rapports, est ce qui rend la rédaction de comptes rendus et la synthèse de cas suffisamment fiables pour être présentées à un clinicien : le modèle peut indiquer ce qu'il a vu. Cela ne fonctionne que si les images, les rapports et leurs embeddings sont réunis sous un même toit gouverné, ce qui résume parfaitement cet article.
C'est aussi ce dont la nouvelle vague de modèles fondateurs a besoin. Prov-GigaPath (Nature, 2024), préentraîné par auto-supervision sur 1,3 milliard de tuiles issues de 171 189 images de lames entières, ne fonctionne qu'avec des données volumineuses, diverses, gouvernées et multimodales. Les silos ne peuvent pas l'alimenter. Un lakehouse le peut.
Le bénéfice : un co-chercheur pour le scientifique, un compagnon pour le clinicien
La version concrète de tout cela n'est pas un système autonome destiné à remplacer qui que ce soit. C'est un compagnon, un co-chercheur IA pour le scientifique et un copilote pour le clinicien, ancré dans les données gouvernées propres à l'institution plutôt que sur l'internet ouvert.
Pour un chercheur, un agent co-chercheur transforme une question en plan de travail. Demandez-lui de "trouver les patients atteints de CPNPC naïfs de traitement avec une TDM initiale, une anatomopathologie appariée et le statut EGFR, puis de résumer l'évolution des lésions lors du suivi", et il planifie les étapes, interroge les tables d'imagerie et cliniques via un espace Genie, recherche des cas similaires avec Vector Search, appelle un endpoint de segmentation pour mesurer les lésions et ancre son résumé dans la littérature pertinente, chaque affirmation étant traçable jusqu'aux données utilisées.
La nouvelle catégorie de systèmes de "co-chercheur IA" vise exactement cet objectif : aider à générer et à trier des hypothèses, et pas seulement répondre à des requêtes. Ce qui distingue un prototype d'un collaborateur de confiance, c'est sa capacité à s'appuyer sur des données gouvernées et multimodales.
Pour un clinicien, ces mêmes mécanismes deviennent un compagnon qui accomplit le travail préparatoire qu'un radiologue ou un oncologue ferait autrement à la main : récupérer les antécédents du patient, mesurer et comparer les lésions, faire ressortir les critères des recommandations applicables et rédiger le projet de compte rendu pour révision. Il ne valide jamais ; l'humain le fait. Ce n'est pas une limitation, c'est la conception même du système. Pratiquement toutes les IA d'imagerie homologuées aujourd'hui sont supervisées par l'humain, et un compagnon qui montre son travail et cite ses sources rend cette supervision réelle au lieu d'une simple validation de principe.
Ce qui garantit la sécurité de l'un ou l'autre, c'est le socle sur lequel ils reposent. Chaque outil appelé par l'agent est un objet gouverné — une fonction Unity Catalog, un endpoint de serving de modèle, un index Vector Search, un espace Genie —, de sorte que les mêmes contrôles d'accès, la même traçabilité et la même identité déléguée qui protègent les pixels limitent également ce que l'agent peut voir et faire. Assemblez des spécialistes (un agent en radiologie, un agent en génomique, un agent en affaires médicales) sous la direction d'un superviseur, et l'équipe d'agents reflète les jointures multimodales que la plateforme de données rend déjà possibles. Le compagnon est la partie facile, une fois que les fondations sont solides.
Au-delà de l'imagerie : le même socle prend en charge le reste de la R&D
Si cela dépasse le cadre de la radiologie, c'est parce que la même architecture absorbe l'ensemble du patrimoine de données de R&D. La multi-omique (génomique, transcriptomique, protéomique, métabolomique) arrive dans le même Unity Catalog aux côtés des données d'imagerie et cliniques. Elle apporte ses propres formats complexes et standards — VCF pour les variants, BAM et CRAM pour les lectures de séquençage alignées, les spécifications GA4GH qui garantissent leur interopérabilité, et des moteurs comme Glow et Hail pour l'analyse à l'échelle des populations —, mais le modèle lakehouse reste identique : gouverner les fichiers, extraire la couche interrogeable, la joindre à tout le reste.
C'est également là que s'intègre la suite NVIDIA, comme BioNeMo et NIMs, pour les modèles de séquences et de structures. Les données du monde réel, les données d'essais cliniques, les registres et les signaux physiologiques rejoignent les cohortes d'imagerie sans export nécessaire. Les affaires médicales et la littérature scientifique deviennent des textes interrogeables sous la même gouvernance et la même interface AI/BI et Genie. Les programmes qui progressent, ceux qui permettent de comprendre quels patients répondent aux traitements et pourquoi, reposent sur les jointures entre ces domaines, et le lakehouse est la rare architecture capable de rassembler une lame gigapixel, un appel de variant et un critère d'évaluation d'essai clinique sous un seul modèle de gouvernance pour les interroger ensemble.
En résumé

Les équipes qui développent des applications d'IA et d'IA générative sur ce type de données tirent toujours la même leçon. Un modèle peut donner d'excellents résultats en démonstration en une semaine. Mais ce qui prend des mois par la suite, c'est de nettoyer, lier, anonymiser et gouverner les données de manière à pouvoir leur faire confiance devant un chercheur ou un organisme de réglementation. Le problème des données n'est pas la partie ingrate du projet. C'est le projet lui-même.
Si l'on examine les données d'imagerie, d'omique, cliniques et d'affaires médicales au sein des mêmes organisations, la conclusion est simple. La véritable avancée en imagerie médicale ne réside pas dans une meilleure architecture, mais dans un meilleur socle. Les algorithmes existent. Les données existent quelque part. Ce qui manquait, c'était un moyen de rendre l'imagerie gouvernée, interrogeable, liable, partageable et connectée à tous les autres éléments touchant à une question de recherche, sans sacrifier la confidentialité et la rigueur exigées par la médecine.
Les équipes qui réussiront en R&D ne seront pas celles qui chercheront à développer le meilleur modèle en premier. Ce seront celles qui structureront correctement leurs données en premier et laisseront l'IA suivre. Résolvez ce problème, et le modèle deviendra la partie facile, comme cela a toujours été le cas.
Par où commencer
Le moyen le plus rapide de tester cela est de l'essayer sur vos propres données.
- Commencez avec l'accélérateur open source Pixels (databricks-industry-solutions/pixels) pour transformer un dossier de fichiers DICOM en tables Delta gouvernées et interrogeables, et découvrez l'architecture médaillon en action.
- Exécutez-le sur Databricks. Créez un espace de travail, pointez les volumes Unity Catalog vers un jeu de données public comme TCIA ou MIMIC-CXR, et mettez en place l'ingestion, l'anonymisation et un visualiseur OHIF de bout en bout avant d'intégrer des données protégées.
- Approfondissez l'ingénierie derrière ces chiffres : consultez les articles détaillés ci-dessus sur l'ingestion 7x plus rapide, l'anonymisation par VLM et MONAI/VISTA-3D.
- Passez d'une seule cohorte à l'ensemble du patrimoine de données. Une fois qu'un type d'étude est ingéré, anonymisé et joint à une table clinique, le même modèle s'étend à la multi-omique, aux données du monde réel et à la couche d'agents au-dessus.
Si votre équipe développe des projets d'imagerie médicale ou de R&D multimodale sur Databricks, les auteurs aimeraient savoir comment vous l'abordez. Contactez-nous ou laissez un commentaire, et lorsque vous serez prêt à passer du pilote à la production, l'équipe Databricks Healthcare and Life Sciences sera là pour vous accompagner.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.