Comment j'ai développé des revues de sécurité basées sur des agents sur Databricks
Comment un ensemble gouverné d'agents ciblés a réduit le travail de révision de routine, amélioré la qualité de la collecte et préservé le jugement humain pour les décisions à plus haut risque
par Angel De Leon
- Une couche d'évaluation basée sur des agents sur Databricks automatise les tâches de sécurité prévisibles tout en orientant les cas inédits, à haut risque ou ambigus vers des réviseurs humains.
- Unity Catalog, les modèles de fondation hébergés par Databricks, Lakeflow Jobs et Databricks Apps fournissent une pile gouvernée pour la collecte, le raisonnement, les flux de travail, les preuves et les métriques.
- Des décisions basées sur des preuves, une escalade prudente et des tableaux de bord opérationnels améliorent le temps de cycle et la cohérence sans supprimer l'autorité humaine.
Nous disposions déjà d'une automatisation dans certaines parties de notre processus d'évaluation de la sécurité. C'était utile, mais cela ne réduisait pas suffisamment le travail manuel.
Je voyais constamment le même schéma dans la file d'attente : une intégration de routine utilisant une conception familière pouvait se retrouver à côté d'une architecture véritablement nouvelle et à haut risque, toutes deux en attente de la même ressource rare, un évaluateur expérimenté.
Le problème n'était pas que notre automatisation existante avait échoué. Elle avait simplement atteint ses limites. Nous consacrions encore du temps d'expert à des tâches prévisibles, ce qui laissait moins de place aux décisions qui nécessitaient réellement un jugement d'expert.
J'ai donc conçu une couche basée sur des agents pour étendre ce que nous avions déjà. L'objectif n'était pas de remplacer le processus ou les personnes qui le gèrent. Il s'agissait d'aider le système à comprendre une demande, à appliquer nos normes, à demander les informations manquantes et à identifier le moment où une intervention humaine était nécessaire.
La première version basée sur des agents se concentrait sur un seul parcours d'évaluation. Mon équipe a identifié un schéma plus large et l'a étendu à un ensemble d'agents qui prennent désormais en charge d'autres étapes de notre processus de réception et d'évaluation de la sécurité. J'ai entièrement construit cette première version sur Databricks, la plateforme même qu'utilisent nos clients.
Pourquoi la plateforme était essentielle
J'ai pu avancer rapidement car les éléments clés étaient déjà disponibles dans un seul et même environnement.
Unity Catalog offrait un espace gouverné pour nos normes de sécurité, les données de demande, les preuves de support, les décisions et les résultats du système. Les modèles de fondation hébergés par Databricks fournissaient la couche de modèle pour la classification et le raisonnement. Lakeflow Jobs orchestrait les flux de travail basés sur des notebooks sur du calcul serverless. Databricks Apps gérait l'expérience de réception et le tableau de bord exécutif.
Comment les pièces s'assemblent
De manière générale, une demande suit un parcours continu à travers la plateforme, chaque étape lisant et écrivant dans les mêmes tables gouvernées :
- Réception - Une application conversationnelle construite sur Databricks Apps transforme une description en langage naturel en une demande structurée et y joint tous les documents de conception justificatifs.
- Raisonnement - Les modèles de fondation hébergés par Databricks (Claude Haiku, Sonnet et Opus) classifient la demande, évaluent les risques et rédigent les exigences, en se basant toujours sur nos normes de sécurité. Haiku gère la classification légère, Sonnet s'occupe de la majeure partie du travail d'évaluation, et Opus est réservé aux tâches de raisonnement les plus complexes.
- Orchestration - Lakeflow Jobs exécute les agents d'évaluation sur du calcul serverless, faisant progresser chaque demande à travers ses différentes étapes selon un calendrier planifié.
- Système d'enregistrement - Unity Catalog conserve les normes, les données de demande, les preuves, les résultats des modèles et les décisions sous forme de tables gouvernées, avec un modèle unique d'autorisation et de traçabilité pour l'ensemble.
- Observabilité - Une deuxième application Databricks Apps lit ces mêmes tables pour générer des rapports sur le volume, la répartition des risques, le taux d'automatisation et le temps gagné.
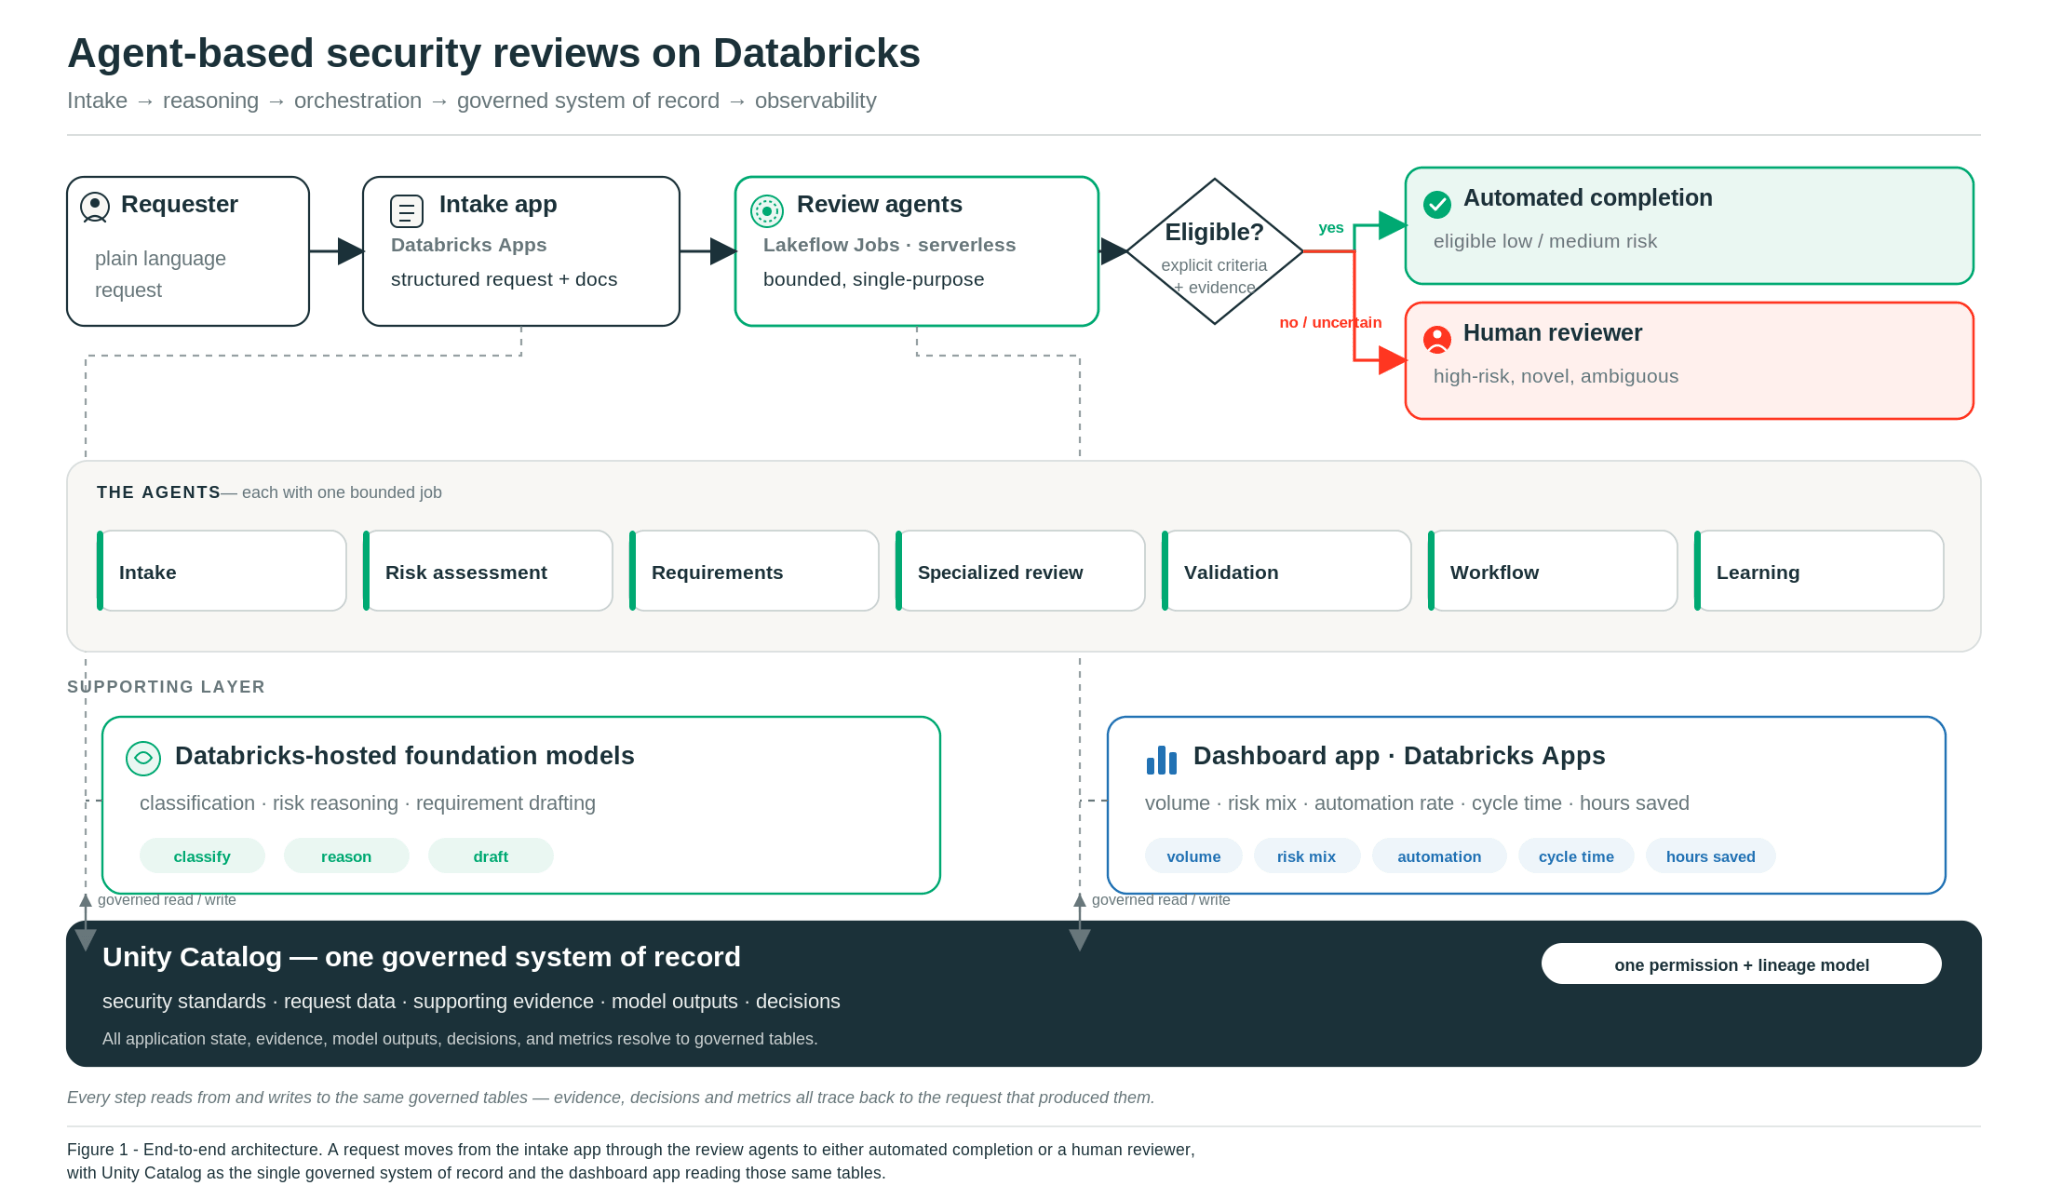
Cela nous a permis de disposer d'un modèle de gouvernance et d'exploitation cohérent pour l'ensemble des données, des modèles, des flux de travail et des applications. Au lieu d'assembler des services distincts avec des autorisations, des journaux et des chemins de données différents, j'ai pu me concentrer sur la logique d'évaluation et l'expérience utilisateur.
La différence concrète résidait dans la vitesse. J'ai obtenu un système fonctionnel en moins de deux heures. Faire la même chose en connectant des services distincts aurait pris des semaines.
Toutes les évaluations ne nécessitent pas le même parcours
La plupart des files d'attente de sécurité contiennent à la fois des demandes prévisibles et de véritables exceptions.
Une intégration qui utilise un schéma d'authentification unique (SSO) approuvé et ne traite aucune donnée sensible ne relève pas de la même décision qu'un service exposé sur Internet qui traite des informations sensibles avec un large accès administratif. Pourtant, une file d'attente traditionnelle peut orienter ces deux cas vers le même parcours manuel.
Mon but n'était pas d'automatiser chaque évaluation. J'ai automatisé les parties répétitives et préservé le jugement humain là où le risque ou l'incertitude était plus élevé.
Cela a conduit à une règle simple : l'automatisation pour les cas bien compris respectant des critères explicites ; l'intervention humaine pour les décisions nouvelles, à haut risque ou ambiguës.
Un meilleur point d'entrée
La qualité de l'évaluation dépend des informations disponibles au départ.
Les formulaires statiques supposent que les demandeurs sachent de quelle évaluation ils ont besoin, comprennent la terminologie de la sécurité et anticipent les preuves qu'un évaluateur demandera. Lorsque ce n'est pas le cas, la demande arrive incomplète et l'évaluation commence par une nouvelle série de questions.
J'ai construit une application de réception conversationnelle avec Databricks Apps. Un demandeur décrit ce qu'il essaie de faire en langage naturel. L'application identifie le parcours d'évaluation probable, pose des questions de suivi dépendantes du contexte et peut utiliser un document de conception intégré comme contexte de support. Elle met en évidence les informations manquantes et fournit une indication préliminaire du risque avant la création d'une demande formelle.
Une fois qu'elle dispose de suffisamment de contexte, elle crée une demande structurée pour l'équipe de sécurité.
L'application dispose également d'un mode de consultation basé sur nos normes de sécurité. Toutes les questions n'ont pas besoin de devenir un ticket. Les équipes peuvent obtenir des conseils pendant qu'elles élaborent encore une conception et n'ouvrir une évaluation formelle que lorsque cela est justifié.
C'est devenu l'une des parties les plus utiles du système. Cela permet aux équipes de progresser plus rapidement, plutôt que de considérer la file d'attente comme le seul moyen de solliciter la sécurité.
Comment fonctionnent les agents
Derrière l'application de réception se trouve une collection d'agents spécialisés implémentés dans des Databricks Notebooks et orchestrés avec Lakeflow Jobs.
J'ai délibérément évité de concevoir un agent unique doté d'une large autorité pour agir en tant qu'évaluateur de sécurité. Chaque agent a une responsabilité limitée : collecter le contexte, évaluer les risques, associer la demande aux normes applicables, rédiger les exigences, gérer le suivi ou préparer le transfert à un humain.
Sept agents spécialisés, chacun ayant une seule tâche
Il s'agit d'un ensemble d'agents spécialisés (et non d'un seul agent généraliste, ni d'un simple script), chacun ayant une tâche précise, orchestrés sous forme de tâches planifiées derrière l'application de réception :
- Agent de réception - Gère le point d'entrée conversationnel : il identifie le parcours d'évaluation, pose des questions dépendantes du contexte et assemble une demande structurée.
- Agent d'évaluation des risques - Attribue un niveau de risque avec des preuves à l'appui, et applique par défaut un niveau supérieur lorsque la situation est incomplète.
- Agent d'exigences - Associe une demande aux normes applicables et rédige des exigences spécifiques à l'implémentation pour les cas bien compris.
- Agents d'évaluation spécialisés - Gèrent les types de demandes nécessitant une logique dédiée, comme la modélisation des menaces liées aux extensions de navigateur et l'évaluation des fournisseurs tiers.
- Agent de validation - Crée une liste de contrôle de validation par élément pour les demandes à risque plus élevé avant toute clôture.
- Agent de flux de travail - Gère le travail de suivi : clarifications, rappels, suivi des accusés de réception et escalades vers un humain.
- Agent d'apprentissage - Compare périodiquement les modifications apportées par les évaluateurs aux résultats d'origine afin de suggérer des améliorations pour les prompts et les normes.
Chaque agent a une responsabilité limitée, de sorte que son comportement reste inspectable et testable, et qu'une modification apportée à l'un d'eux n'affecte pas silencieusement un autre.
Le système évalue d'abord le risque de la demande et enregistre les preuves étayant cette évaluation. Une simple étiquette de risque ne suffit pas.
Lorsque des informations sont manquantes ou contradictoires, le système demande des clarifications ou oriente la demande vers un évaluateur. Il ne procède pas par déduction pour accorder une approbation.
Pour les demandes de routine, les agents génèrent exigences basées sur l'architecture réelle et les normes applicables, plutôt que de renvoyer des modèles génériques. Le demandeur valide ces exigences et fournit les preuves nécessaires. Les demandes éligibles à risque faible et moyen peuvent être traitées via le parcours automatisé une fois que les critères et validations définis sont satisfaits.
Un exemple
Prenons un cas courant : une intégration interne qui utilise un schéma d'authentification unique (SSO) approuvé et ne traite aucune donnée sensible. Au lieu d'un modèle générique, l'agent d'exigences produit des éléments spécifiques et vérifiables liés à cette architecture, par exemple :
- S'authentifier via le fournisseur d'identité approuvé et désactiver tous les identifiants locaux ou partagés.
- Restreindre l'intégration aux périmètres d'accès minimaux nécessaires, et les documenter.
- Envoyer les journaux d'application et d'accès vers le pipeline de journalisation centralisé.
- Confirmer le niveau de classification des données et procéder à une nouvelle évaluation avant l'introduction de toute donnée sensible.
Le demandeur valide ces éléments et joint les preuves. Si tout est conforme et que le cas remplit les critères d'éligibilité, il peut être finalisé via le parcours automatisé.
Les demandes à haut risque, critiques, inhabituelles ou ambiguës sont orientées vers un humain. À ce stade, le réviseur reçoit un résumé structuré, des preuves à l'appui, les normes applicables et toutes les questions en suspens.
Les agents gèrent également une grande partie des tâches administratives liées à une révision : collecte des détails manquants, envoi de rappels, suivi des accusés de réception et escalade lorsque quelqu'un demande de l'aide. Un réviseur intervient lorsqu'une demande devient ambiguë ou nécessite un arbitrage.
L'automatisation fonctionne selon des règles que nous définissons. Les humains gardent le contrôle des exceptions et des décisions importantes.
Rendre le système digne de confiance
Le plus difficile n'était pas d'obtenir une réponse d'un modèle. C'était de faire en sorte que cette réponse soit encadrée, vérifiable et exploitable.
Les agents s'appuient sur nos normes de sécurité. Les évaluations des risques doivent inclure des preuves à l'appui. Un manque de contexte déclenche un suivi ou une escalade, et non une hypothèse optimiste. La validation automatisée est limitée à des classes de demandes et des critères prédéfinis. Le workflow enregistre les entrées, les sorties, les preuves et les décisions associées à chaque demande.
Ce que cela donne en pratique
Trois éléments permettent de valider une décision automatisée en toute sécurité :
- Des classes de demandes prédéfinies. Seules les catégories bien comprises et à faible risque sont éligibles à une validation automatisée – par exemple, une intégration interne de routine sur un modèle approuvé qui ne traite aucune donnée sensible. Tout ce qui sort de ces classes est orienté par défaut vers un humain.
- Des preuves acceptables. Une décision ne vaut que par ce qui l'appuie. Par preuves, on entend des éléments concrets et vérifiables : un document de conception lié, un niveau de classification des données déclaré, ou une configuration et des références démontrant qu'un contrôle approuvé est en place. Une affirmation sans preuve est traitée comme une information manquante.
- Une évaluation rejetée ou incertaine. Lorsque des preuves sont manquantes ou contradictoires, le système ne devine pas. Il applique par défaut le niveau de risque le plus conservateur, publie une demande de clarification spécifique ou transmet la demande à un réviseur avec les questions en suspens. Elle ne peut pas être approuvée ainsi.
Les retours des réviseurs nous aident à identifier les lacunes et à améliorer le système au fil du temps. Nous utilisons ces corrections pour affiner nos normes, nos prompts et la logique de nos workflows, plutôt que de laisser les agents modifier d'eux-mêmes leur comportement en production.
Ces contrôles importent plus que le modèle lui-même. Un modèle performant peut améliorer le raisonnement, mais la confiance vient du système qui l'entoure : un périmètre clair, des preuves explicites, une escalade prudente et une autorité humaine qui donne un réel poids au risque.
Là où mon équipe l'a emmené
J'ai conçu la première version basée sur des agents pour améliorer un parcours de révision. Mon équipe a compris que ce même modèle pouvait servir à bien plus.
Ils ont étendu l'architecture à d'autres types de demandes, renforcé les workflows, amélioré la façon dont les agents appliquent nos normes et ajouté les contrôles nécessaires à une utilisation quotidienne. Ce qui a commencé comme un simple workflow basé sur des agents est devenu un système partagé que l'équipe continue de développer.
J'ai initié le projet, mais le système a pris de la valeur parce que l'équipe l'a rendu opérationnel et se l'est approprié.
En tant que concepteur, je suis fier que la première version ait fonctionné. En tant que leader, je suis encore plus fier que l'équipe y ait vu une base qui valait la peine d'être développée.
Mesurer les résultats
Il est facile de revendiquer des gains d'efficacité, mais difficile d'y croire sans preuves.
J'ai créé un tableau de bord pour la direction sous la forme d'une autre Databricks App. Il lit les mêmes données Unity Catalog générées par les workflows de révision et suit le volume de demandes, la répartition des risques, la validation automatisée, l'escalade vers des humains, le temps de cycle et le temps estimé gagné par les réviseurs.
Comme les métriques proviennent de registres opérationnels, nous pouvons remonter jusqu'aux demandes et aux décisions qui les ont générées, plutôt que de devoir rapprocher manuellement des exports de différents systèmes.
Cela a changé la donne avec la direction. Nous pouvions montrer où l'automatisation réduisait l'effort manuel, où les réviseurs restaient impliqués et comment cette répartition évoluait au fil du temps.
Les chiffres
Le tableau de bord suit un ensemble cohérent de mesures, toutes issues des mêmes registres opérationnels.
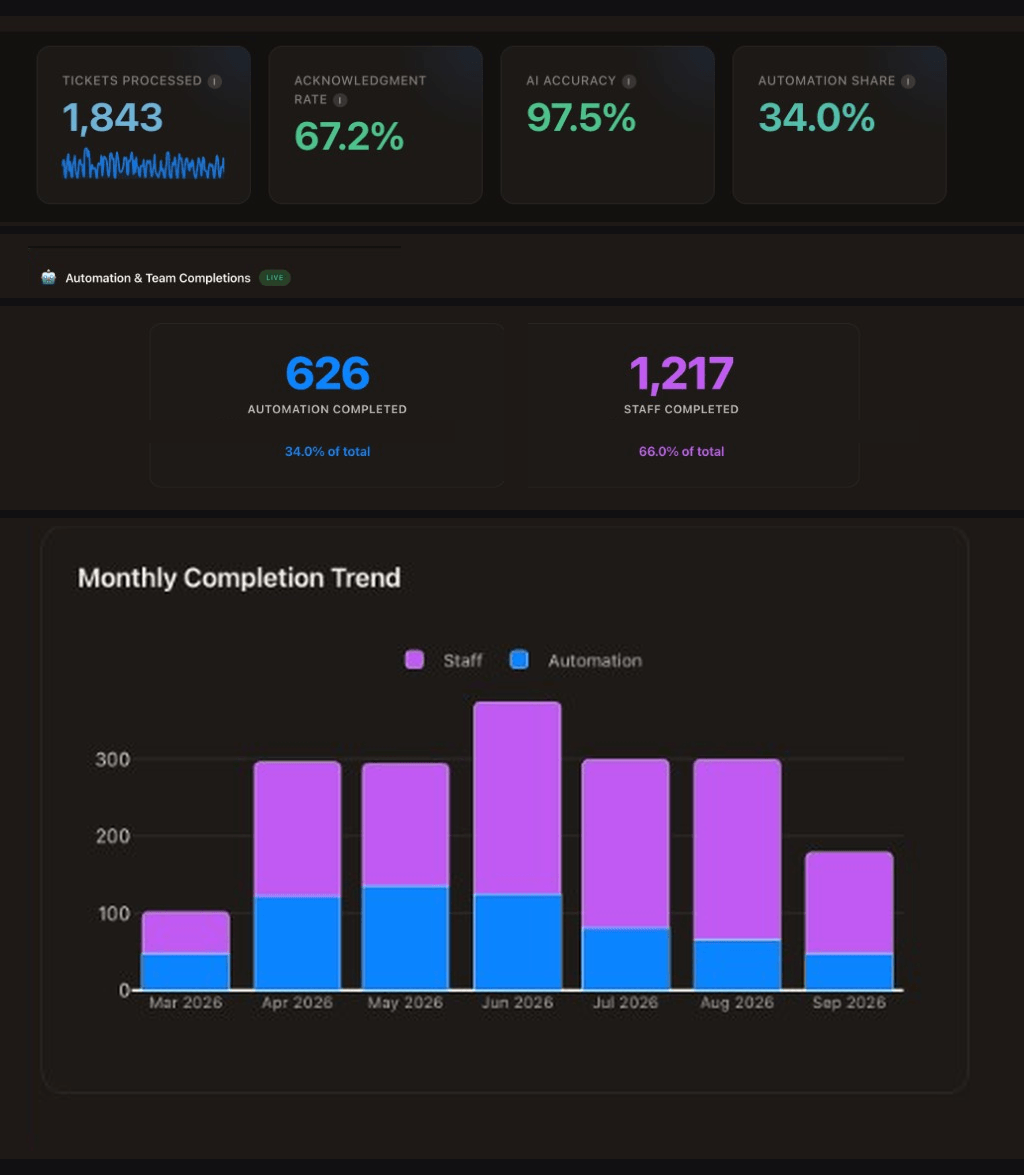
Ce qui a changé
Les demandes de routine éligibles qui attendaient autrefois des jours dans la file d'attente peuvent désormais être traitées en quelques minutes. Les équipes peuvent obtenir des conseils avant d'ouvrir un ticket, et les demandes qui parviennent à un réviseur arrivent avec un meilleur contexte.
Nos ingénieurs en sécurité peuvent consacrer plus de temps aux conceptions inédites, aux risques importants et aux décisions qui requièrent de l'expérience. Le premier niveau d'analyse est également plus cohérent, car les demandes sont évaluées par rapport aux mêmes normes et exigences de preuves. Lorsque le système a un doute, il escalade.
Il ne s'agit pas d'une sécurité sans humains. C'est un système conçu pour mobiliser l'attention des experts là où elle a le plus de valeur.
Ce que je retiens de cette expérience
Ajouter des réviseurs peut augmenter la capacité de traitement, mais cela ne supprime pas les tâches répétitives.
La première étape consiste à séparer le processus du jugement. N'automatisez les étapes répétitives que lorsque les critères sont explicites, que le système s'appuie sur de vraies normes, que des preuves sont requises, que l'incertitude fait l'objet d'une escalade et que les résultats peuvent être mesurés.
N'automatisez pas une décision simplement parce qu'un modèle peut générer une réponse. N'automatisez que lorsque le processus définit ce qu'est une réponse acceptable, quelles preuves l'appuient et ce qui se passe lorsque le système a un doute.
Laissez les humains garder le contrôle des décisions importantes et des exceptions.
Mon intention n'était pas de retirer les humains de la révision de sécurité. Je voulais réduire le temps qu'ils passent sur des tâches qu'un système contrôlé peut gérer de manière cohérente. Développer sur Databricks nous a fourni la plateforme idéale pour y parvenir. Voir mon équipe s'emparer de la première version, la renforcer et se l'approprier a été la plus belle partie de l'aventure.
Commencez par le guide multi-agent de Databricks, puis adaptez le modèle présenté dans cet article – des données gouvernées dans Unity Catalog, des agents ciblés sur Lakeflow Jobs et une Databricks App comme point d'entrée – pour créer votre propre workflow de révision reproductible et basé sur des preuves.
Créez un système multi-agent sur Databricks Apps
Commencez par le guide multi-agent de Databricks, puis adaptez le modèle présenté dans cet article – des données gouvernées dans Unity Catalog, des agents ciblés sur Lakeflow Jobs et une Databricks App comme point d'entrée – pour créer votre propre workflow de révision reproductible et basé sur des preuves.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.