Présentation de la mémoire d'agent sur Databricks
par Sirui Sun et Nihit Desai
Aujourd'hui, nous présentons la mémoire d'agent sur Agent Bricks, la plateforme de développement d'agents de Databricks. La mémoire d'agent améliore la qualité des agents tout en réduisant les coûts et la latence en stockant les faits essentiels, les préférences et les workflows qu'un agent doit garder en mémoire. Disponible dès aujourd'hui en version Bêta, elle fonctionne sur Lakebase pour offrir une fiabilité élevée et une faible latence, et s'appuie sur les dernières recherches de Databricks en matière de mémoire.
Sans mémoire, les agents risquent de devoir redécouvrir des faits clés, d'oublier les préférences de l'utilisateur et de répéter des erreurs déjà corrigées. Pour y remédier, de nombreux développeurs créent leurs propres solutions de mémoire, mais se heurtent à de nombreuses questions de conception : par exemple, où les souvenirs doivent-ils être stockés ? Comment doivent-ils être synthétisés ? Et une fois générés, comment les récupérer ?
Pour répondre à cela, Databricks Agent Memory repose sur l'architecture MemCurrent, pionnière de Databricks Research. MemCurrent combine trois schémas d'accès : des plugins pour enregistrer et charger le contexte automatiquement, des outils que l'agent appelle à la demande, et un pipeline hors ligne (« dreaming ») qui consolide la mémoire en arrière-plan. Le tout est servi avec une latence extrêmement faible via Lakebase. Dans nos benchmarks internes, la mise en œuvre de cette architecture de mémoire a triplé le taux de réussite des agents sur des tâches d'entreprise réelles, tout en utilisant 31 % de tokens en moins.
Agent Memory rejoint les autres fonctionnalités d'Agent Bricks, notamment l'hébergement d'agents, Databricks Sandbox, Unity Gateway, les serveurs MCP préintégrés, ainsi que le traçage et l'évaluation, offrant aux développeurs toutes les capacités d'infrastructure nécessaires pour créer des agents prêts pour la production.
Problème : les agents sans état paient deux fois pour le même contexte
Deux problèmes apparaissent dès qu'un agent passe d'une démonstration à une utilisation quotidienne.
- Les coûts augmentent à chaque redécouverte. Un agent sans état déduit à nouveau ce qu'il avait compris la veille : quelle table contient les données d'utilisation, ce que signifie un acronyme interne, quelle jointure fonctionne réellement. Lors d'une session réelle issue de nos recherches, un agent a effectué 11 appels d'outils, utilisé 8 sous-agents et pris près de six minutes pour répondre à une question sur les meilleurs clients d'un produit. Le lendemain, il aurait dû tout recommencer.
- Les agents ne personnalisent jamais l'expérience. Un utilisateur indique une préférence, corrige une erreur ou explique comment son équipe définit une métrique, mais l'agent l'oublie dès la fin de la session. L'utilisateur doit alors se répéter, ou l'agent répète l'erreur.
Les développeurs d'agents et les équipes de plateforme qui les exécutent utilisent généralement deux solutions de contournement. Chacune remplace un problème par un autre :
- Réinjecter l'historique complet dans le contexte fonctionne jusqu'à ce que l'historique devienne trop long. Sur les benchmarks de mémoire open source, le contexte complet a utilisé environ 12 fois plus de tokens d'entrée par question qu'une mémoire bien conçue pour une précision équivalente. Et sur les historiques les plus longs, les résultats étaient pires, car les échanges irrelevants ont induit l'agent en erreur.
- Créer votre propre mémoire sur un stockage d'objets ou une base de données vectorielle implique de gérer l'extraction, la déduplication, la recherche et le contrôle d'accès. Les informations deviennent obsolètes, les faits contradictoires s'accumulent et personne ne peut déterminer quelle information a provoqué une mauvaise réponse.
Ce dont les équipes ont besoin, c'est d'une mémoire qui rende les agents à la fois plus économiques et plus personnalisés, sans avoir à déployer un système supplémentaire.
Comment fonctionne Agent Memory sur Databricks
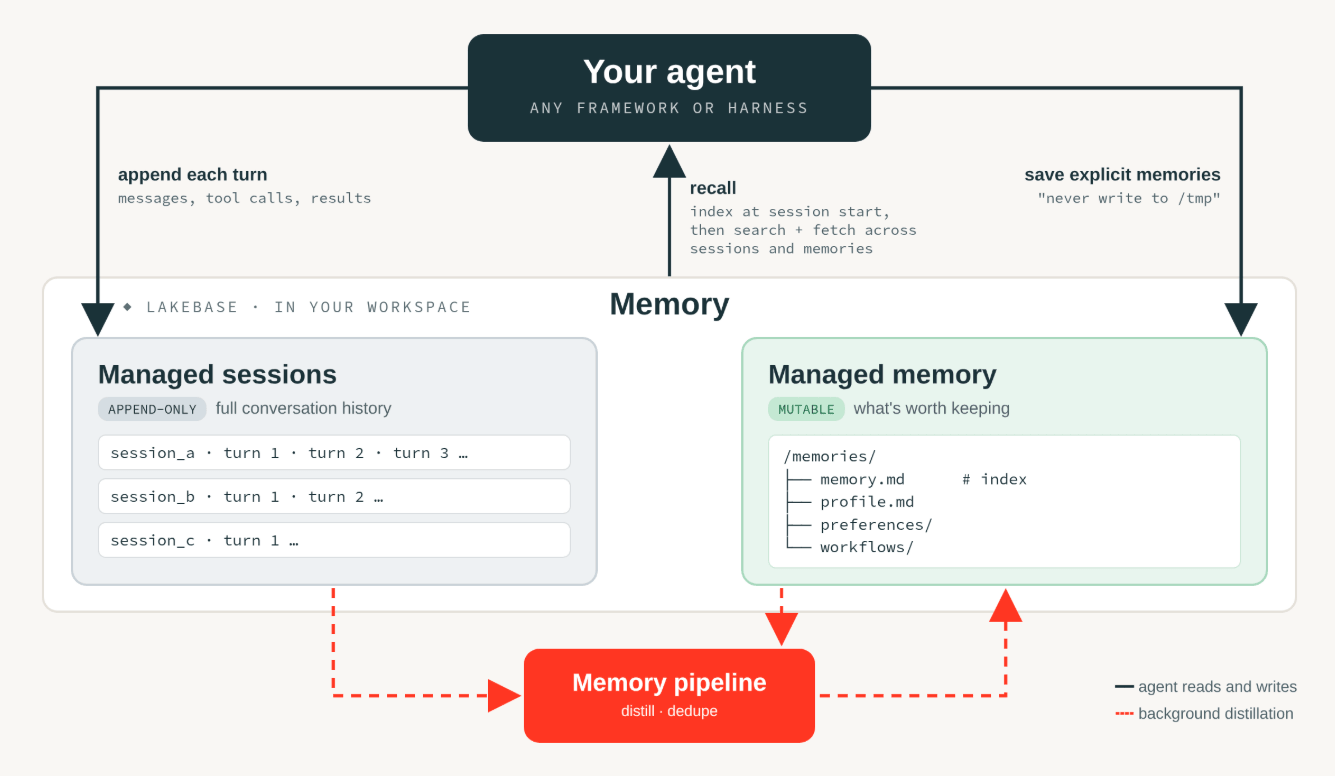
Figure 1. Agent Memory sur Agent Bricks. L'agent ajoute chaque échange aux sessions gérées, rappelle et sauvegarde les éléments de mémoire directement, et un pipeline de mémoire consolide les sessions dans la mémoire à long terme en arrière-plan.
Agent Memory comprend trois parties :
- Sessions gérées : elles enregistrent chaque conversation sous la forme d'un historique ordonné de messages, d'appels d'outils et de résultats, au format natif de votre framework.
- Mémoire gérée : elle conserve ce qui mérite d'être retenu : profil, préférences, connaissances du domaine et workflows. Au début d'une session, l'agent charge un index de ce qui est connu en mémoire. Pendant la session, il retrouve les détails grâce à une recherche hybride (mots-clés et sémantique).
- Pipelines de mémoire : ils synthétisent les sessions pour les intégrer à la mémoire à la demande ou de manière régulière en arrière-plan. Ils extraient les faits et préférences durables, suppriment les doublons et remplacent les faits contredits par des conversations plus récentes.
Tout fonctionne sur Lakebase, le service Postgres serverless de Databricks, provisionné dans votre espace de travail et géré par Databricks. Cela garantit que le stockage et la récupération des informations en mémoire sont ultra-rapides, et que vos espaces de stockage s'adaptent à l'évolution du trafic de vos agents.
Développé à partir de nos recherches sur la mémoire
Agent Memory est une mise en œuvre de production de MemCurrent, le système de mémoire décrit dans MemCurrent : concevoir une mémoire pour les agents d'entreprise. La conclusion principale de nos chercheurs est que la mémoire fonctionne le mieux en deux couches : un enregistrement brut de ce qui s'est passé et un enregistrement synthétisé de ce qui mérite d'être retenu, tenu à jour par un processus en arrière-plan plutôt qu'écrit de façon ad hoc par l'agent en cours de tâche.
Conçue ainsi, la mémoire améliore simultanément la qualité et l'efficacité. Les agents ont réussi environ trois fois plus de tâches que les agents sans mémoire, ont terminé plus rapidement et ont utilisé moins de tokens. La même infrastructure alimente déjà la mémoire dans Genie, l'expérience en langage naturel de Databricks pour les utilisateurs métier.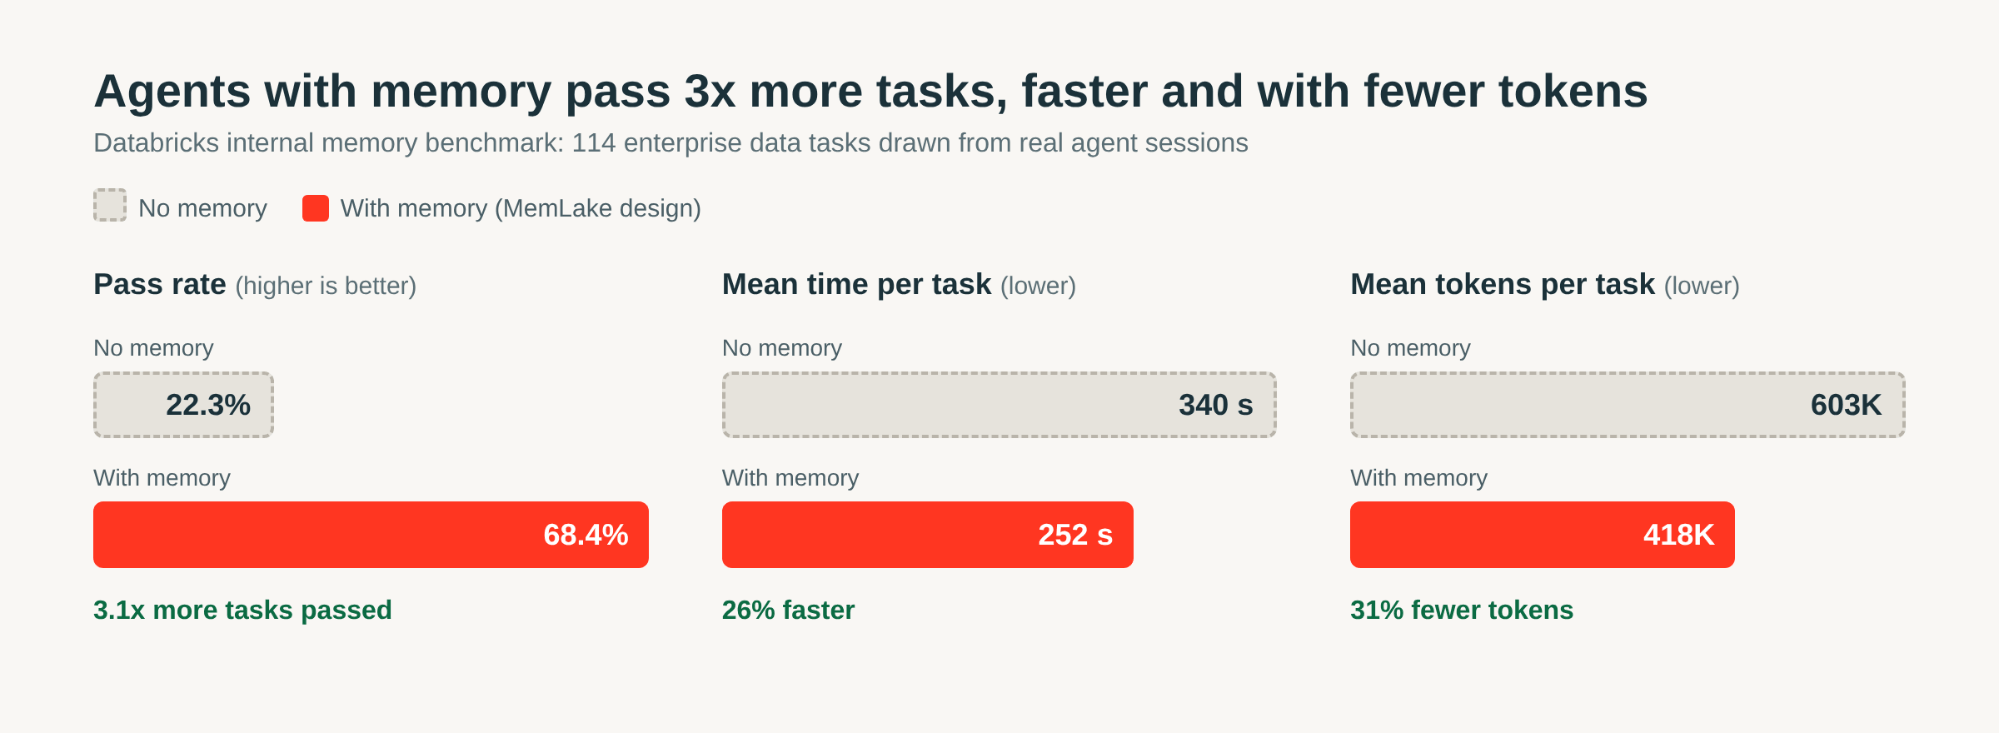
Figure 2. Agents avec et sans mémoire sur le benchmark de mémoire interne de Databricks pour les tâches de données d'entreprise. Source : recherche MemCurrent.
Ce qui change pour vos agents
- Coût réduit par tâche. Les agents ne répètent pas le travail déjà effectué. Dans l'exemple ci-dessus, une fois le workflow enregistré en mémoire, l'agent a répondu à une question de suivi associée en 2 appels d'outils et 41 secondes, contre 11 appels d'outils et près de six minutes auparavant.
- Une personnalisation durable. Les préférences, les corrections et les définitions propres à l'équipe sont conservées d'une session à l'autre et associées à chaque utilisateur, afin que les personnes n'aient plus à se répéter.
- Des erreurs définitivement corrigées. Les agents se souviennent de leurs erreurs et évitent de les répéter, ce qui permet d'économiser un temps précieux et des tokens.
- Une mémoire dont vous êtes propriétaire et que vous contrôlez. Les sessions et les éléments de mémoire résident dans votre projet Lakebase, indépendamment de tout framework d'agent spécifique. Les développeurs peuvent lire, exporter et supprimer les entrées qu'un agent conserve pour chaque utilisateur, et donner des instructions au pipeline de mémoire pour orienter ce qu'il conserve, comme « conserver les préférences client durables ; ignorer les notes de débogage ponctuelles ».
- Une plateforme unique pour l'ensemble de la boucle. Le même agent utilise des modèles via Unity Gateway, se déploie avec la CLI d'Agent Bricks, et est tracé et évalué avec le traçage d'Agent Bricks, mémoire incluse.
Pour commencer
Rien de tout cela ne nécessite de nouvelle infrastructure de votre côté. La CLI d'Agent Bricks vous permet de déployer un agent avec mémoire et sessions en quelques minutes.
Dès lors, la prochaine conversation de votre agent avec chaque utilisateur commence par ce qu'il a appris des précédentes. Pour plus d'informations, consultez le guide de démarrage rapide pour créer un nouvel agent doté d'une mémoire, ou notre tutoriel pour ajouter de la mémoire à un agent existant.
Agent Memory fait partie d'Agent Bricks, la plateforme de développement d'agents de Databricks permettant de créer, d'exécuter et d'améliorer des agents personnalisés à grande échelle, quel que soit le modèle, le framework ou le harness. Explorez Agent Bricks pour découvrir le reste de la plateforme.
Ressources complémentaires
- Créez un agent avec état en moins de 10 minutes grâce à la documentation sur la CLI Agent Bricks.
- Ajoutez de la mémoire et des sessions à un agent existant grâce à la documentation sur la mémoire et les sessions d'agent.
- Découvrez les recherches associées dans l'article MemCurrent: Designing Memory for Enterprise Agents.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.