Restaurations basées sur les branches Lakebase Postgres pour une récupération rapide à grande échelle
Comment Lakebase Postgres remplace les restaurations lentes de bases de données par des restaurations quasi instantanées basées sur les branches pour récupérer 100 TB en quelques secondes.
par Cassie Murray et Carlota Soto
- La récupération traditionnelle de bases de données est extrêmement lente et passe mal à l'échelle, entraînant souvent des heures d'indisponibilité pour provisionner de nouvelles ressources de calcul, télécharger de volumineux snapshots et rejouer les fichiers journaux.
- Lakebase Postgres introduit des restaurations basées sur les branches, une opération de métadonnées qui récupère instantanément une base de données en pointant vers un historique immuable dans un stockage découplé plutôt qu'en copiant des données.
- Restaurer une base de données de 100 TB prend quelques secondes, rendant la récupération quasi instantanée et permettant aux agents AI de gérer de manière transparente les flux de travail de branchement et d'annulation.
Dans les systèmes OLTP gérés, les restaurations ont toujours été d'une lenteur exaspérante, et cela empire à grande échelle. Cela signifie souvent que les grandes bases de données de production, où les temps d'arrêt coûtent le plus cher, sont celles qui attendent le plus longtemps pour être restaurées.
Les solutions de contournement habituelles sont complexes, coûteuses et risquées. Elles impliquent des réplicas supplémentaires, des environnements additionnels et même l'intervention d'un DBA lors de la restauration, ce qui ne garantit pas totalement votre protection. Le basculement vers un réplica sain est utile lorsqu'une machine tombe en panne, mais il est inefficace si la mauvaise écriture a déjà été propagée sur le standby. Cela nécessite tout de même une restauration, et une restauration peut signifier des heures d'interruption de service.
Cette difficulté est liée à l'architecture des systèmes OLTP gérés traditionnels. Le calcul (compute) et le stockage sont livrés comme une seule machine ; une restauration commence par le provisionnement d'une nouvelle instance (et l'attente commence déjà) ; les instantanés (snapshots) résident dans le stockage d'objets tandis que Postgres s'exécute sur ce volume, l'instantané doit donc être rapatrié sur le disque (encore de l'attente) ; la relecture des journaux WAL doit ensuite combler l'écart entre le moment de l'instantané et l'horodatage exact de la récupération (toujours plus d'attente). À mesure que la base de données grandit, ce processus devient plus lent et plus coûteux.
L'architecture de Lakebase Postgres brise ce monolithe et transforme le mécanisme de restauration. Dans Lakebase, le calcul et le stockage sont découplés, et l'historique de la base de données est déjà conservé dans le stockage d'objets de manière à être immédiatement accessible. Avec cette architecture, une restauration ne copie pas de données sur un nouveau disque. À la place, elle crée simplement une branche à un horodatage précis, ce qui est une simple opération de métadonnées, et non une tâche de copie et de relecture de plusieurs heures.
En pratique, le temps de restauration tombe à quelques secondes, même si la base de données fait 100 To. Et c'est si simple qu'un agent peut s'en charger.
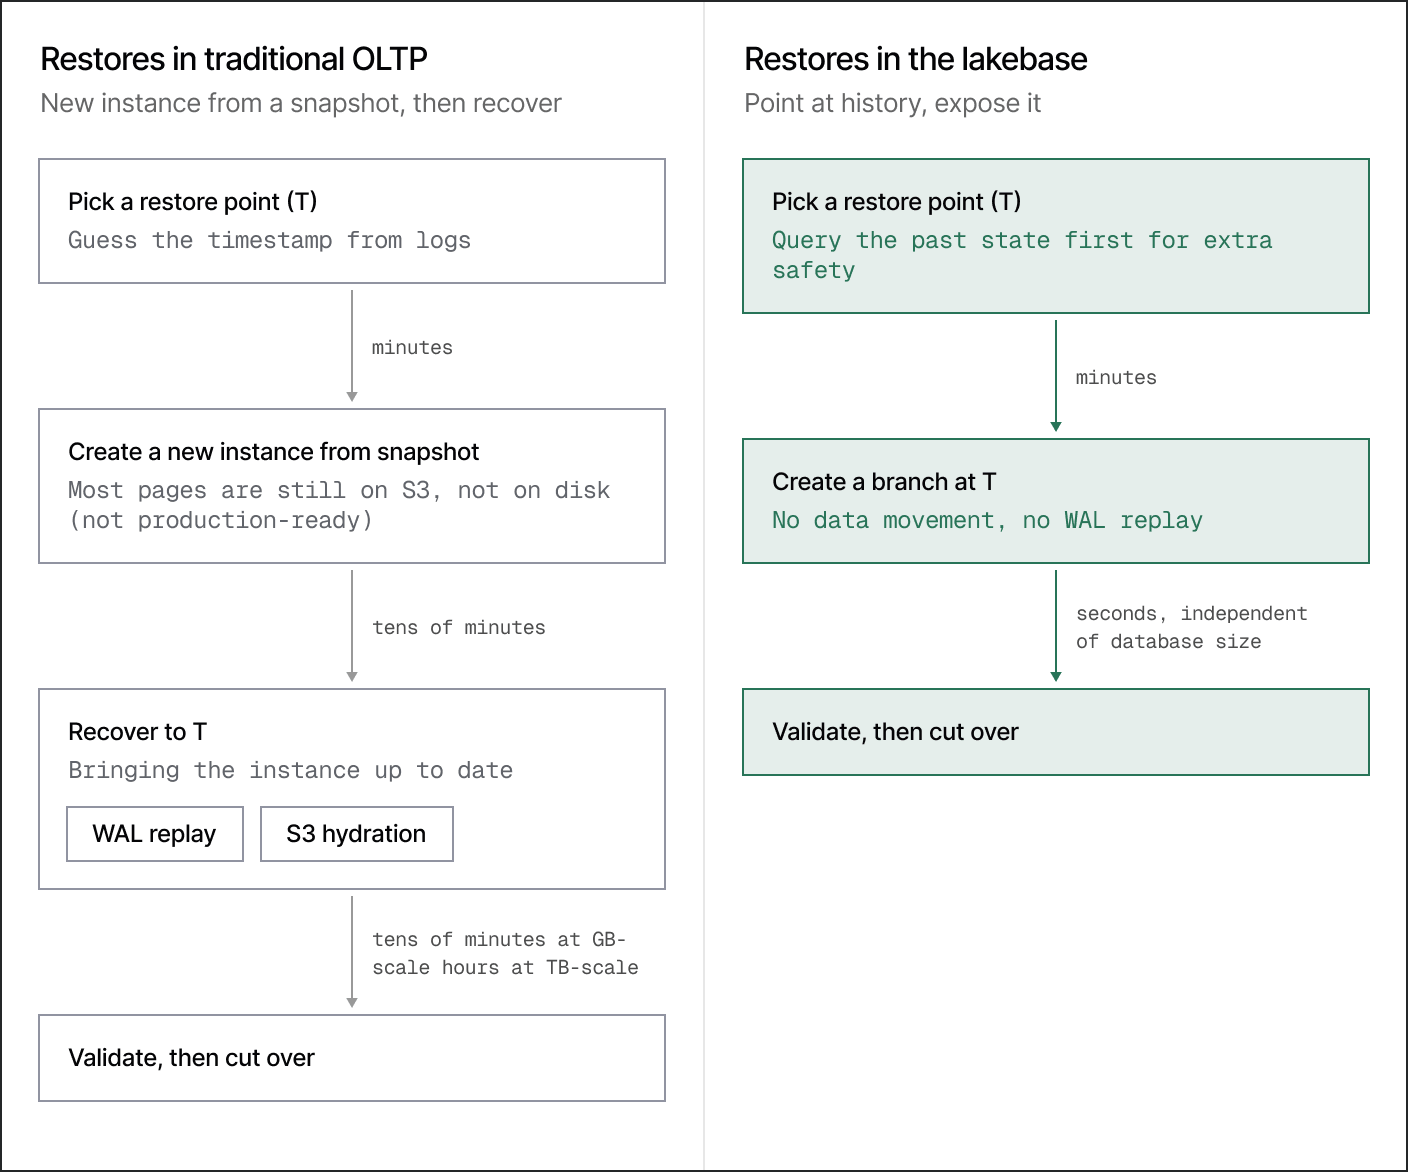
Le parcours de restauration OLTP traditionnel (et ses limites)
La récupération à un instant dans le passé (PITR) traditionnelle de Postgres repose sur deux éléments : une sauvegarde de base des fichiers et les journaux WAL archivés pour tout ce qui suit cette sauvegarde. Dans un environnement Postgres géré, comme Amazon RDS, cette sauvegarde est généralement un instantané (snapshot) stocké dans un stockage d'objets.
La « restauration à partir d'une sauvegarde » à un instant T précis est en réalité un processus qui comprend trois étapes :
- Déployer une nouvelle instance
- Restaurer le dernier instantané utilisable avant T
- Rejouer les journaux WAL depuis cet instantané jusqu'à T
1. Déployer une nouvelle instance
Cela implique de déployer des volumes de calcul et de stockage (couplés) d'une capacité au moins équivalente à celle de l'instance principale. Une petite instance peut démarrer en quelques minutes, mais une grande instance dotée de volumes EBS volumineux prend généralement plus de temps, ce qui vous oblige à attendre avant même de pouvoir lancer le processus de restauration.
2. Restaurer à partir de l'instantané
Les instantanés RDS résident dans S3, donc « restaurer » signifie extraire cet instantané du stockage d'objets pour le copier sur le disque de Postgres.
Ce processus est lent pour les volumes importants, c'est pourquoi RDS n'attend pas qu'il soit terminé pour rendre l'instance restaurée available. Pour les volumes importants, cela se produit alors que la plupart des pages de tables et d'index sont encore dans S3. Mais « disponible » ne signifie pas que l'ensemble de données actif (working set) se trouve sur le volume Postgres. Si une requête touche un bloc qui n'est pas encore local, le volume le récupère directement dans S3 à la volée, tandis que le reste continue de se charger en arrière-plan.
Ces types de requêtes entraînent une latence acceptable pour une vérification interne, mais pas pour la production. La restauration n'est véritablement terminée que lorsque les données dont vous avez réellement besoin se trouvent sur le volume, ce qui n'est pas rapide pour une grande base de données. Plus la base de données est grande, plus cela prendra de temps (en heures).
3. Rejouer les journaux WAL jusqu'à T
L'instantané n'est cohérent qu'au moment précis où il a été pris. Pour atteindre T, Postgres doit encore rejouer les journaux de transactions archivés après cet instantané. La durée de cette relecture dépend du volume d'activité enregistré entre l'instantané et T. Un instantané datant d'une heure sera beaucoup plus rapide à traiter qu'un instantané de la veille au soir. De plus, si vous avez eu une journée chargée en écritures, il y aura énormément de journaux WAL à rejouer. Une fois de plus, cela implique une longue attente (qui s'ajoute au chargement en cours de l'instance depuis S3).
Des fenêtres d'interruption de service importantes
À moins que la base de données ne soit petite, la PITR est presque toujours une opération de plusieurs heures. Vous devez provisionner le monolithe, extraire un instantané de S3, rejouer les journaux WAL et attendre qu'une partie suffisante du volume soit locale pour accepter du trafic.
Pendant toute cette période, vous risquez de subir une interruption de service. Un réplica sain et hautement disponible (HA) peut vous sauver si l'instance principale tombe en panne et que le réplica contient toujours des données correctes. Cependant, il ne vous protègera pas contre le besoin d'une PITR, car les tables supprimées et les mauvaises écritures peuvent déjà se trouver sur le standby.
La lenteur des restaurations de bases de données est un problème majeur
Dans le cadre d'une enquête, 50 développeurs gérant des bases Postgres de production de plus de 1 To ont été interrogés sur leur expérience en matière de restauration :
- 59 % ont connu une panne de production critique au cours des 12 derniers mois
- 30 % ont subi une interruption de plus de 3 heures, certains dépassant même la demi-journée
- seulement 21 % ont pu rétablir le service en moins de 60 minutes
Cela a entraîné des conséquences potentiellement négatives pour l'activité :
- 40 % ont signalé une interruption d'activité importante
- 52 % ont reçu des retours clients négatifs suite à l'incident
- 72 % ne se sentaient que « moyennement confiants » dans leur capacité à récupérer rapidement si une nouvelle panne survenait
Les restaurations basées sur des branches ouvrent une nouvelle voie
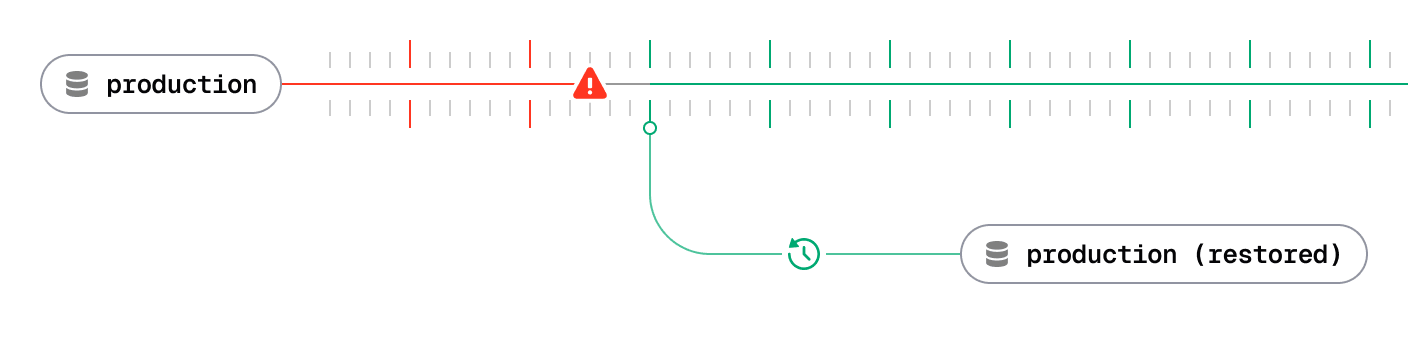
Dans Lakebase Postgres, une architecture moderne permet d'envisager la restauration d'une tout autre manière.
Le calcul et le stockage sont séparés
Le calcul (compute) et le stockage durable sont séparés et reliés par les journaux WAL. Le calcul exécute Postgres, ce qui signifie qu'il traite le SQL, planifie les requêtes, applique le MVCC, gère les verrous et génère les journaux WAL (toutes les tâches habituelles de Postgres). Ce qu'il ne fait pas, en revanche, c'est héberger la copie durable de vos données.
Le stockage assure la durabilité et conserve l'historique. Cette tâche est divisée en trois parties exécutées par trois composants distincts :
- Les safekeepers reçoivent les journaux WAL de la partie calcul. Une transaction est durable dès qu'un quorum de safekeepers a accusé réception de son enregistrement WAL.
- Le pageserver transforme les journaux WAL en pages lues par Postgres. Il peut reconstruire n'importe quelle page pour une clé donnée à un LSN donné.
- Le stockage d'objets conserve l'historique immuable à long terme. Le calcul ne le lit jamais directement ; le pageserver sert d'intermédiaire.
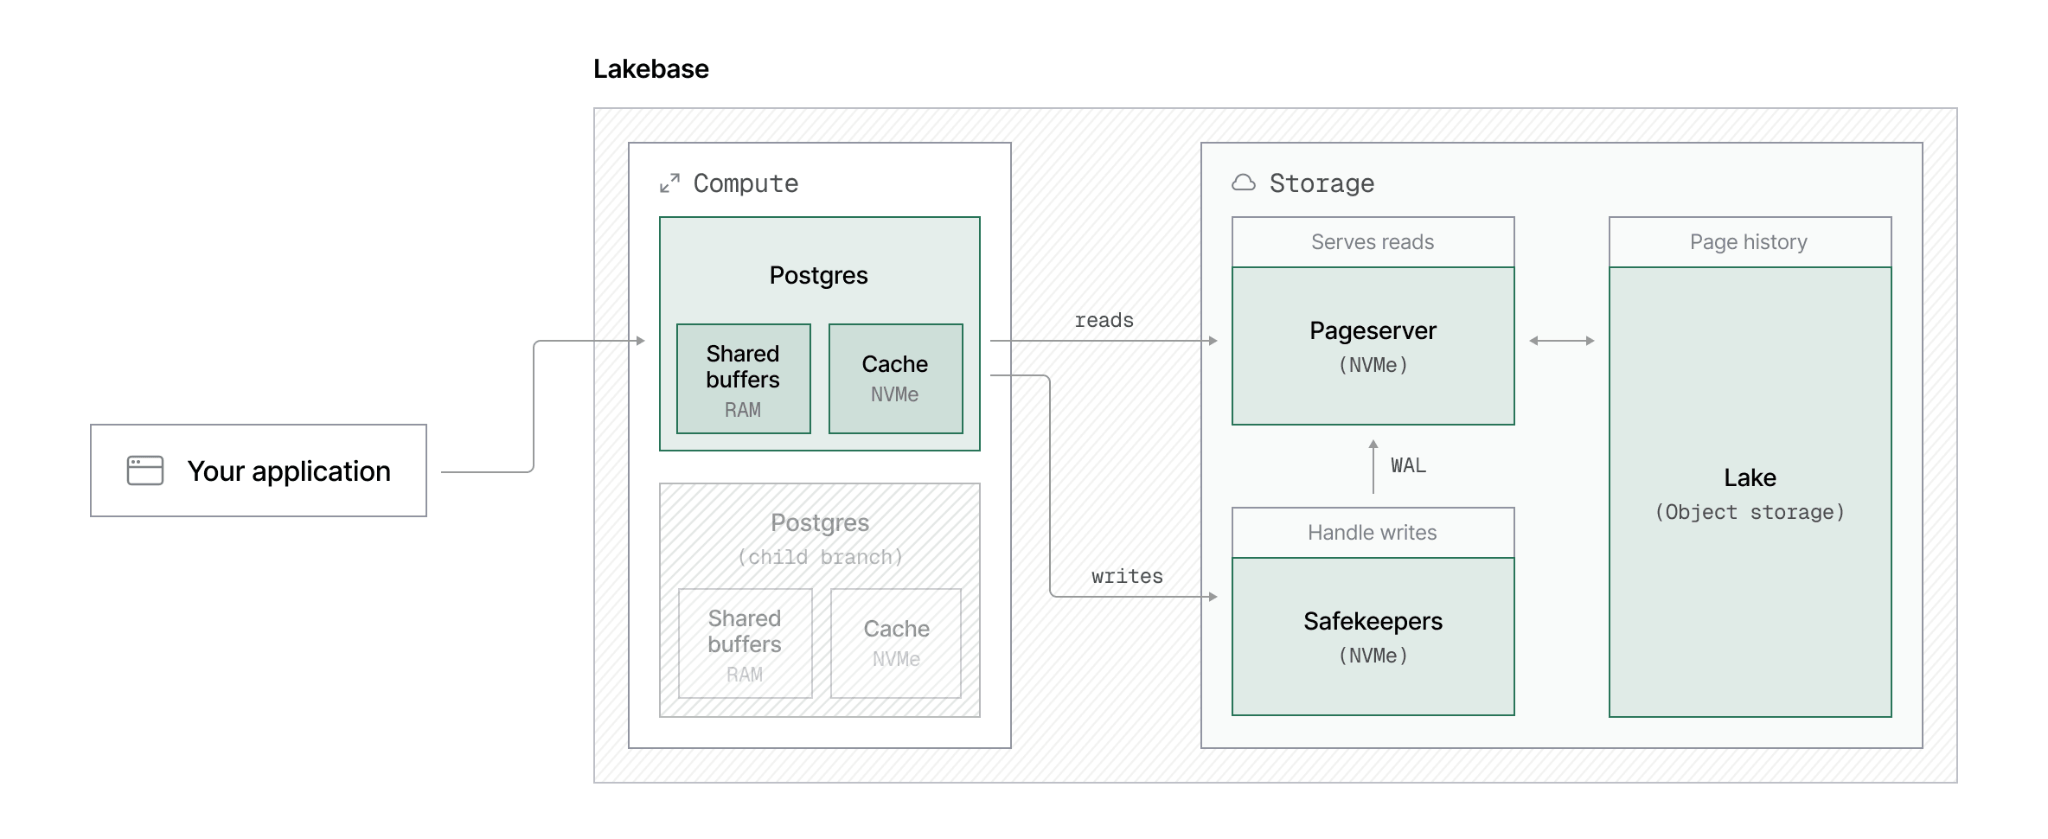
Lorsqu'une écriture arrive :
- Postgres modifie les lignes en mémoire et génère les journaux WAL
- Le calcul transmet ces journaux WAL en continu aux safekeepers
- Un quorum en accuse réception, et la transaction est désormais durable
- Le pageserver transforme ensuite ces journaux WAL en versions de pages
- Ces versions sont stockées dans le stockage d'objets en tant qu'historique immuable
L'historique est stocké sous forme de chronologie adressable
Dans cette configuration, le parcours d'écriture prend une forme intéressante. L'architecture ci-dessus sépare la validation d'une transaction de la matérialisation des pages, ce qui signifie plus simplement que les anciennes versions de pages ne sont jamais écrasées. L'historique de votre base de données s'accumule sous la forme d'une chronologie que vous pouvez cibler, plutôt que d'une copie unique que vous modifiez.
Dans Lakebase, une restauration est une branche créée à un instant précis
Dans le parcours traditionnel, une restauration consiste principalement à reconstruire cet état passé dans une instance distincte. Mais avec Lakebase, il existe un historique de stockage immuable auquel se référer. Cette étape est donc inutile et est remplacée par une autre primitive : une branche.
Alors que les restaurations traditionnelles provisionnent une nouvelle instance et y copient les données, une restauration dans Lakebase est une branche à un point précis de l'historique. Cette nouvelle branche dispose de ses propres ressources de calcul indépendantes, de sa propre chaîne de connexion et peut être interrogée de manière totalement indépendante de la production. Ce n'est pas un réplica de l'instance d'origine, mais elle se comporte exactement de la même manière.
Voici comment utiliser cette primitive pour effectuer une restauration :
- En cas de défaillance sur la branche principale, vous choisissez un horodatage dans le passé (vous pouvez d'ailleurs inspecter cet horodatage avant de valider la restauration, par exemple en exécutant des requêtes).
- Une fois validé, le plan de contrôle (control plane) associe cet horodatage au point exact de l'historique de stockage (le bon LSN), crée cette branche et y associe les ressources de calcul.
Puisqu'il s'agit du concept clé, répétons-le :
La branche ne copie pas la base de données
Cette méthode de restauration élimine complètement les copies de données. La branche restaurée n'a pas besoin de copier les données ; elle pointe simplement vers l'image et les couches delta qui existent déjà à ce moment précis.
- Dans un système de copie et de relecture, une restauration est une tâche de transfert de données. La base de données n'est pas « là » tant que la copie et la relecture du WAL ne sont pas terminées
- Dans Lakebase, la « base de données » est déjà là. Une restauration est une métadonnée : un pointeur vers un point de l'historique. Il ne reste plus qu'à exposer ce point sous forme de branche, avec sa propre ressource de calcul
Le résultat : restaurer 100 TB est aussi rapide que restaurer 10 GB
L'avantage est que la mise à l'échelle n'est plus une source d'inquiétude sur le plan opérationnel. Si une restauration est un travail sur les métadonnées, sa durée ne dépend pas de la taille de vos données, et le mécanisme reste le même.
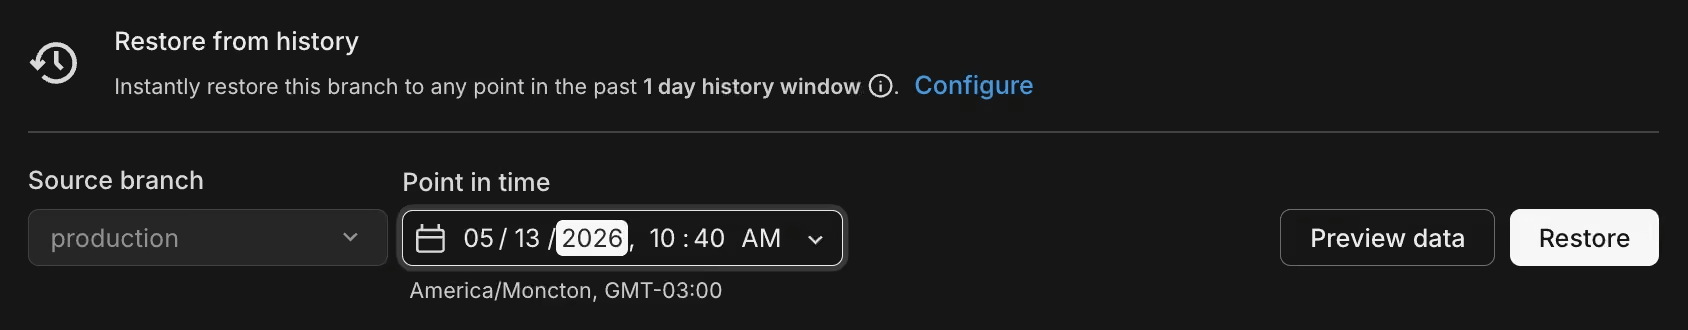
Quelle que soit la taille de votre base de données :
- Atteindre un état passé adressable est quasi-instantané
- La validation de cet état ne prend que le temps nécessaire aux vérifications et à la lecture des données que vous choisissez de consulter
Un humain ou un agent peut toujours accéder immédiatement à un état passé interrogeable après un incident, même sur une base de données Postgres volumineuse.
Les agents peuvent s'appuyer sur les restaurations
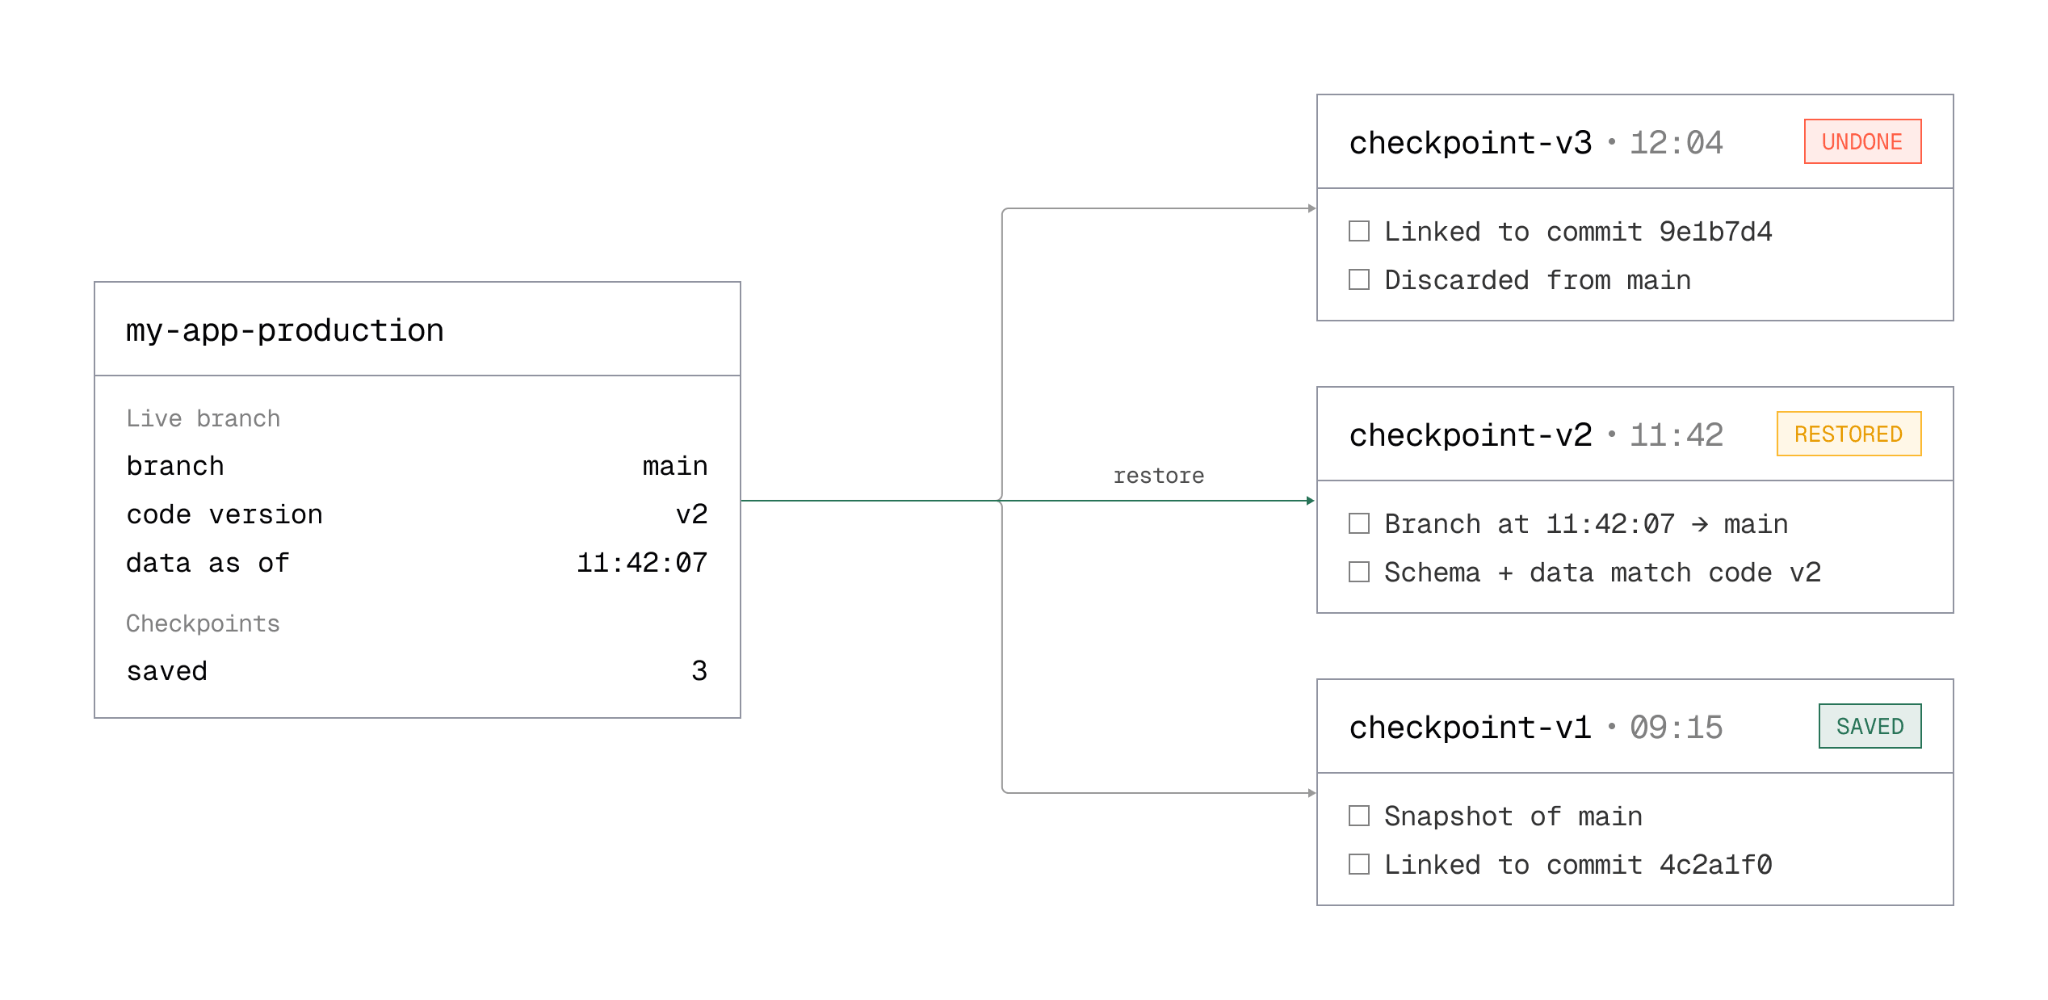
Les restaurations dans Lakebase sont une opération simple : créer une branche à un instant donné. La boucle est suffisamment courte pour que les agents puissent la traiter comme un simple appel d'outil classique, et pas seulement pour résoudre des incidents.
C'est précisément ce que les plateformes d'agents comme Replit ou v0 intègrent dans leurs produits pour créer des fonctionnalités de versioning ou d'annulation. Une boucle typique ressemble à ceci :
- L'agent modifie l'application, ce qui modifie la base de données
- La plateforme enregistre un point de contrôle sous forme de snapshot de la branche principale. Elle stocke l'ID du point de contrôle à côté de la version du code
- L'utilisateur clique sur annuler, ou choisit une version plus ancienne dans l'UI
- La plateforme recherche ce point de contrôle et le restaure sur la branche active
- Le schéma et les données reviennent instantanément à la version de la base de données qui correspond à l'« ancien code »
Le PITR traditionnel est trop lent et trop lourd pour prendre en charge des flux de travail en direct, mais une branche à un instant donné est suffisamment rapide et économique pour faire partie intégrante du produit.
L'architecture de Lakebase change la donne pour la restauration
Les restaurations traditionnelles deviennent plus lentes et plus lourdes à mesure que la base de données grandit. Ce n'est pas le cas des restaurations basées sur des branches. L'historique résidant déjà en dehors des ressources de calcul, un point passé est un élément que vous pouvez ouvrir en tant que branche, et non quelque chose que vous devez reconstruire. Que vous ayez 10 GB ou 100 TB, les restaurations fonctionnent de la même manière. Choisissez un instant donné, créez la branche et associez-y des ressources de calcul. Les pannes à grande échelle ne sont plus aussi redoutables.
Découvrez-le par vous-même : créez une base de données Postgres Lakebase, chargez un bon volume de données, lancez une restauration et demandez-vous comment vous avez pu vous en passer pendant si longtemps.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.