Lakebase Search : recherche plein texte et vectorielle de pointe pour Postgres
Recherche rapide, évolutive et serverless dans Postgres, désormais en disponibilité générale
par Zhou Sun, Jinjing Zhou, Keming Yang, Usamoi Cui, Pranav Aurora et Junyu Chen
- Lakebase Postgres inclut désormais un moteur de recherche intégré (GA sur AWS/Azure). Deux extensions, lakebase_vector (recherche ANN) et lakebase_text (BM25), vous permettent d'exécuter des recherches sémantiques, par mots-clés et hybrides directement dans Postgres aux côtés des données opérationnelles, éliminant ainsi le besoin d'un système de recherche distinct et d'un pipeline ETL.
- Il surpasse pgvector et les moteurs de recherche dédiés à grande échelle. Sur un benchmark de 100 millions de vecteurs, Lakebase offre un débit 2 fois supérieur à celui du deuxième meilleur système, un coût 4 fois inférieur à celui de Postgres dans le cloud avec pgvector, et un taux de rappel de 97 % avec une latence P99 de 71 ms. Il y parvient en découplant le stockage du calcul et en utilisant le clustering IVF hiérarchique et la quantification binaire (RaBitQ) afin que les requêtes ne touchent que les données dont elles ont besoin.
- L'architecture est serverless et se réduit à zéro. Vous payez pour l'utilisation des requêtes, pas pour le volume de données. La création d'index est déchargée de la base de données principale, les démarrages à froid prennent environ 1 seconde, et 100 millions de vecteurs peuvent être servis sur une seule unité de calcul, ce qui le rend parfaitement adapté aux modèles de récupération par rafales des agents AI.
Les systèmes OLTP traditionnels n'ont pas été conçus pour répondre aux exigences de recherche des agents d'AI. Ils nécessitent une récupération à faible latence et de haute précision sur l'ensemble de vos données, et exécutent souvent des recherches parallèles massives. Jusqu'à présent, pour résoudre ce problème, il fallait bricoler un moteur de recherche autonome connecté à votre base de données principale à l'aide d'un pipeline ETL.
Mais et si votre base de données OLTP pouvait simplement exécuter la charge de travail de recherche de manière efficace ?
Aujourd'hui, nous apportons un moteur de recherche rapide et évolutif à Lakebase Postgres via deux extensions : lakebase_vector (recherche évolutive de voisins approximatifs) et lakebase_text (recherche plein texte bm25). Les deux extensions sont généralement disponibles sur AWS et Azure.
Avec lakebase_vector, Postgres est désormais à la pointe de la recherche vectorielle. Il surpasse l'efficacité et l'évolutivité d'un moteur de recherche dédié. Sur le benchmark VectorDBBench 100M, il offre un débit deux fois supérieur à celui du deuxième meilleur système et est 4 fois moins cher qu'un fournisseur Postgres cloud utilisant pgvector, et ce avant même de prendre en compte les économies supplémentaires liées à la mise à l'échelle automatique.
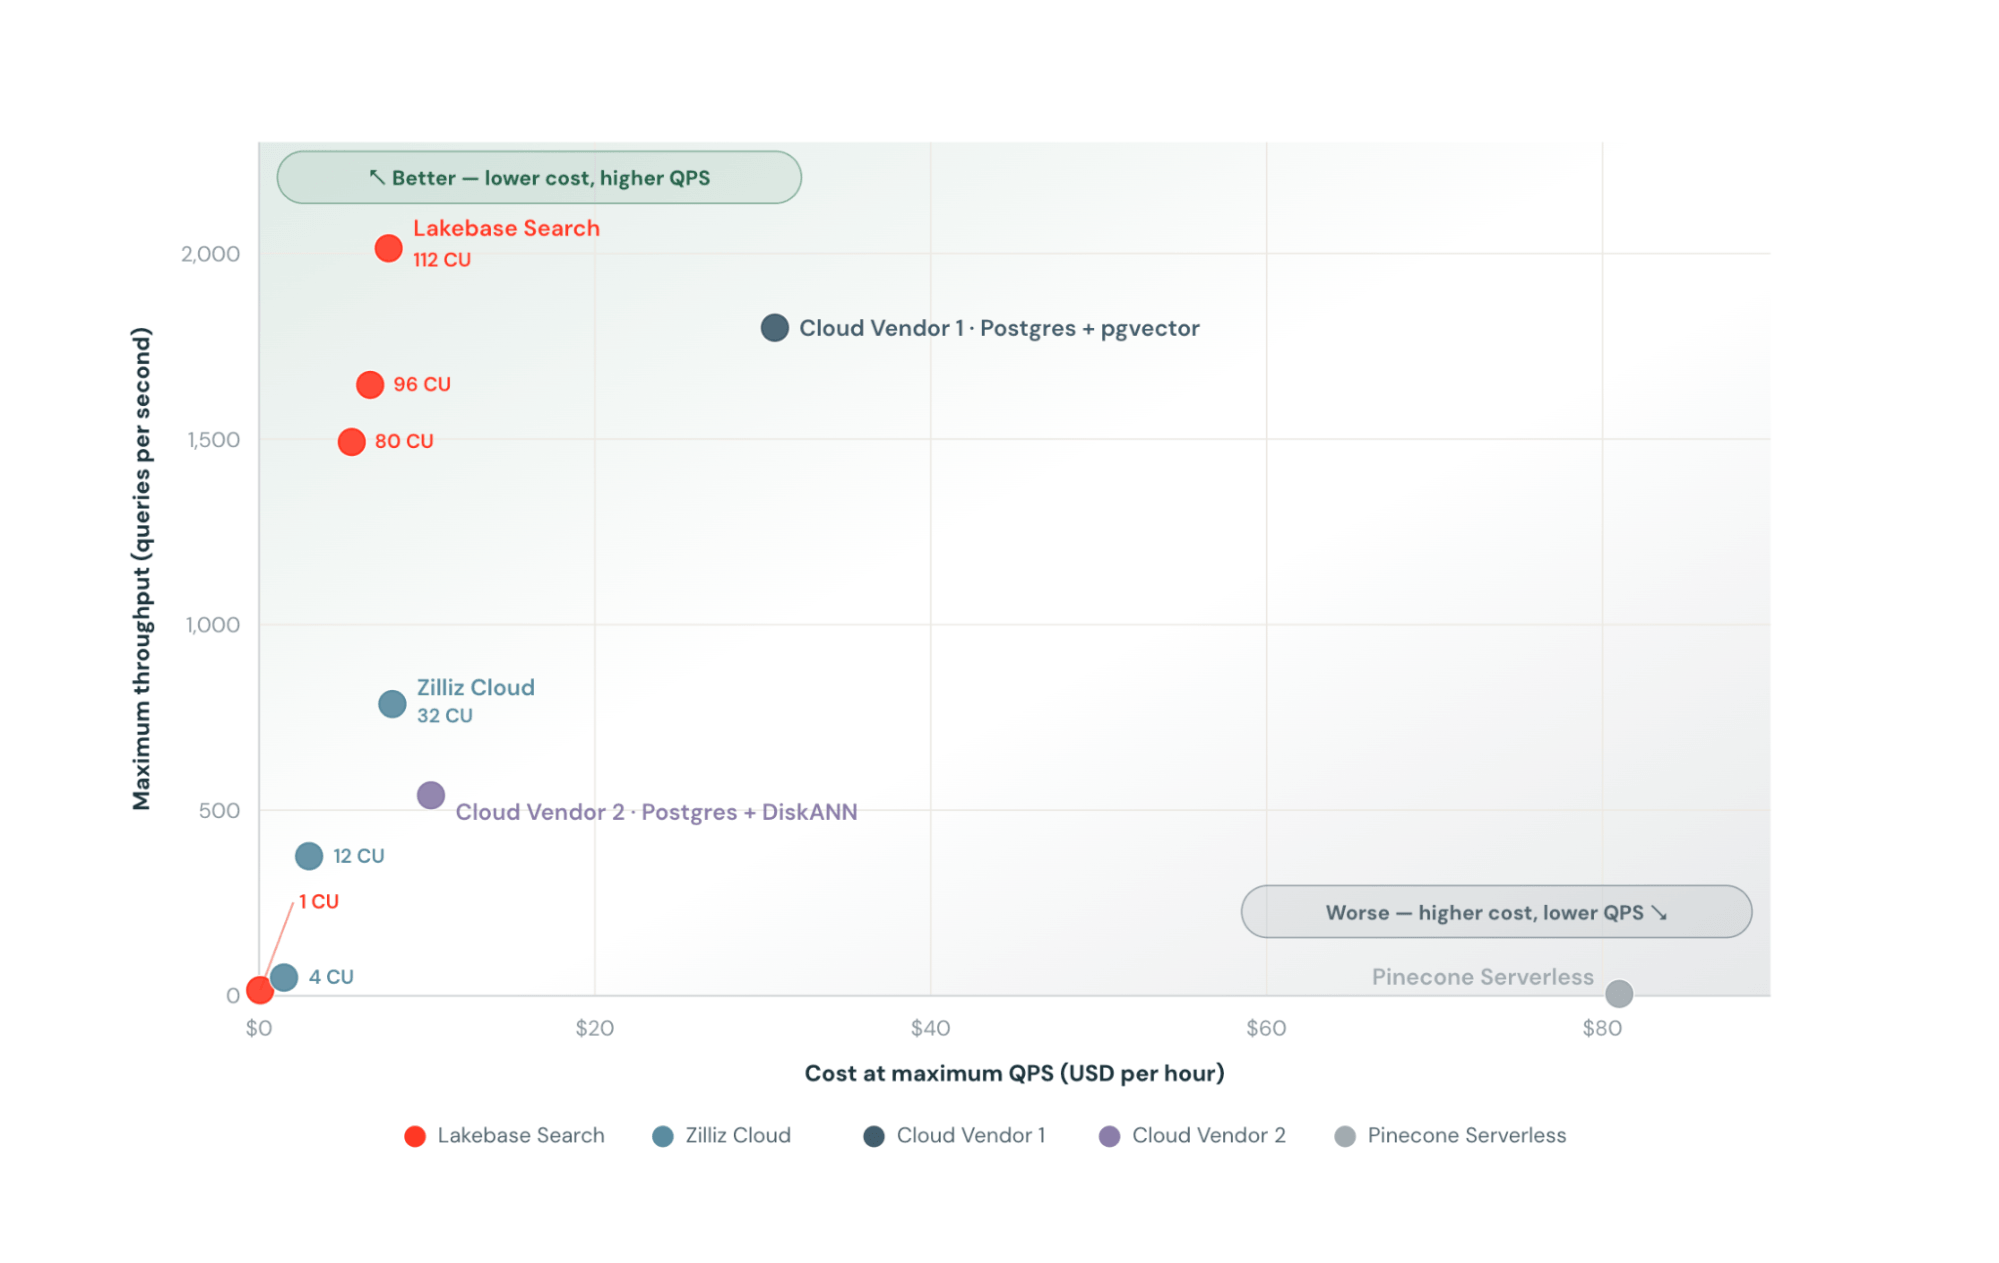
Il maintient ces performances sans sacrifier la précision. Dans nos tests, lakebase_vector a affiché une latence P99 de 71 millisecondes avec un taux de rappel de 97 % (récupérant avec succès les véritables plus proches voisins 97 % du temps).

Lakebase Postgres dispose désormais de capacités de recherche de pointe, et nous avons vu des clients comme Conexiom exécuter des recherches hybrides avec BM25 sur plus de 100 millions de lignes avec la moitié de l'empreinte de calcul de leur configuration pgvector précédente. Ils disposent désormais d'une base de données pour toutes les charges de travail OLTP et de recherche, entièrement serverless et qui s'adapte à leurs besoins.
Lakebase Search nous offre un tout autre niveau d'évolutivité par rapport à pgvector, et débloque BM25 dans la même base de données serverless. Nous utilisons Lakebase pour connecter les données à nos agents à grande échelle. —Jordan Voves, Architecte AI/ML @ Conexiom
Pourquoi pgvector se heurte à un mur à grande échelle
Pour la plupart des utilisateurs de Postgres, la recherche commence par pgvector. Il permet la recherche de similarité vectorielle via des algorithmes d'indexation comme HNSW et IVFFlat sur des données natives dans Postgres, évitant ainsi la complexité d'un magasin de vecteurs distinct. En fait, pgvector est l'extension la plus installée dans Lakebase Postgres. Nous avons constaté 3 points de friction courants chez les clients qui utilisent pgvector à grande échelle.
Premièrement, les coûts évoluent avec le volume de données, pas avec l'utilisation.
pgvector conserve son index dans la mémoire de votre base de données pour être rapide. Comme la recherche HNSW repose sur le parcours de graphes à accès aléatoire, les requêtes ne s'exécutent en quelques millisecondes que si tout tient parfaitement en RAM. Dès que l'index déborde sur le disque, les requêtes se transforment en chaînes de lectures aléatoires, et les performances chutent d'un facteur 10 à 50.
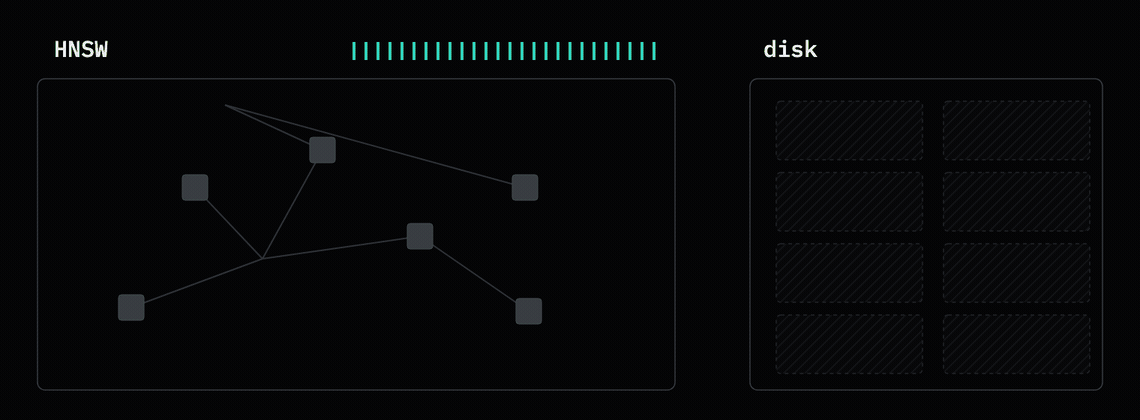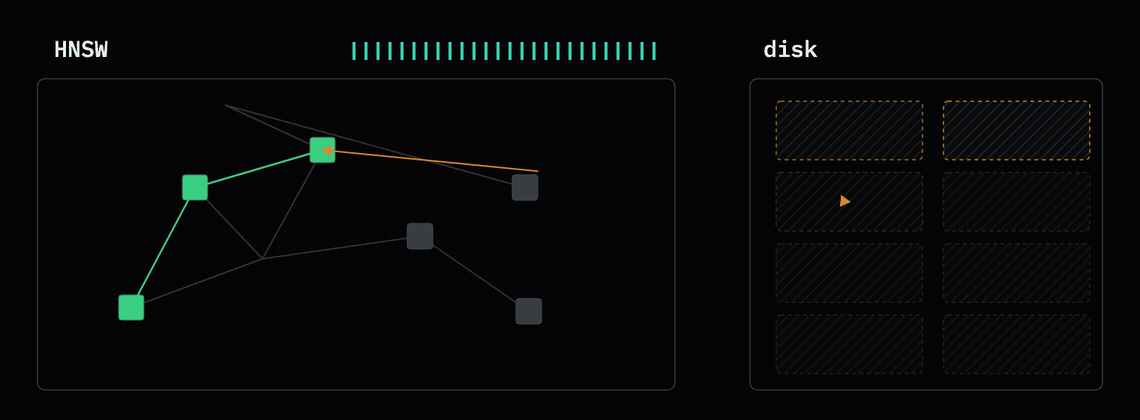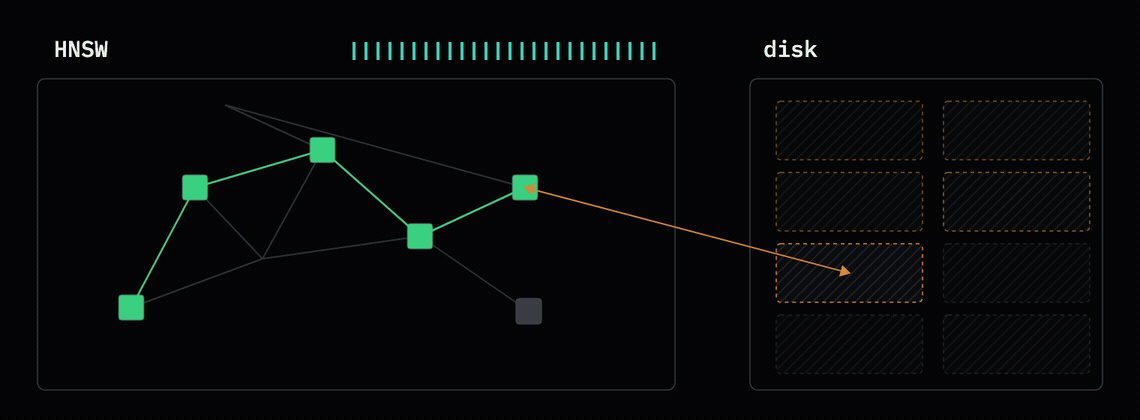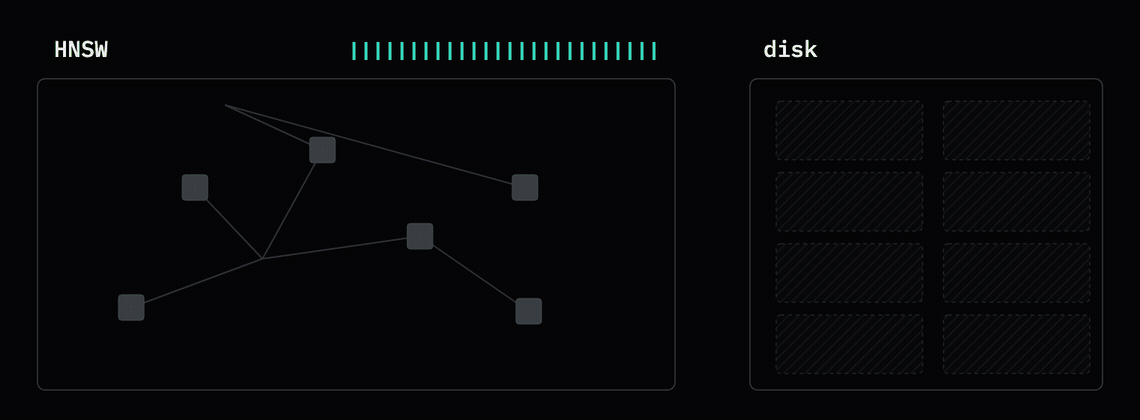
Un vecteur float32 à 768 dimensions nécessite environ 3,3 Ko de mémoire après prise en compte des liaisons de graphe et de la surcharge Postgres. À 100 millions de lignes, vous avez besoin d'environ 330 Go de RAM pour maintenir l'index résident pour des requêtes en millisecondes. Il n'y a pas de notion d'« ensemble de travail ». Vous provisionnez pour l'index complet, que vous l'interrogiez en totalité ou pas du tout.
Deuxièmement, la maintenance de l'index est coûteuse et bloque votre base de données.
Les index pgvector sont limités par la mémoire car le graphe HNSW repose sur un accès aléatoire continu. Lorsqu'une construction déborde sur le disque, des millions d'opérations d'I/O aléatoires paralysent les performances - prenant près de 50 heures pour créer un index pgvector sur une instance cloud standard.
L'ingestion souffre du même goulot d'étranglement. L'insertion de nouveaux vecteurs est lente et coûteuse car chaque écriture oblige pgvector à naviguer et à modifier plusieurs couches du graphe à l'aide de recherches à accès aléatoire.
Deuxièmement, l'ingestion devient lente et coûteuse car HNSW repose sur une navigation continue dans le graphe à accès aléatoire. Il doit également modifier chaque couche du graphe. Ainsi, l'index hnsw
La maintenance continue aggrave le problème. Comme HNSW manque de rééquilibrage global, la restauration de la qualité de la recherche nécessite un REINDEX complet, ce qui verrouille la table et bloque les écritures en production.
Troisièmement, vous sacrifiez la qualité de la recherche au profit des performances
Chaque requête pgvector s'exécute sur un seul processus d'arrière-plan Postgres, ce qui signifie que le scan de l'index HNSW n'est jamais parallélisé.
Pour obtenir un rappel plus élevé, le moteur doit visiter plus de nœuds du graphe, ce qui déclenche plus de lectures mémoire aléatoires et de comparaisons de distances. Cela augmente la latence et fait chuter vos QPS. Comme une seule recherche ne peut pas être parallélisée sur plusieurs cœurs, votre seule option pour obtenir un débit plus élevé est d'ajouter plus de connexions ou de réplicas de lecture.
lakebase_vector apporte la recherche vectorielle évolutive à Postgres
Le principal goulot d'étranglement de pgvector est que l'index entier doit tenir dans la RAM d'une seule machine pour être rapide. Et s'il n'en était pas ainsi ?
Lakebase Postgres nous offre un excellent point de départ, car il sépare le stockage du calcul. Les données durables reposent dans un stockage d'objets cloud bon marché, tandis que la RAM et le NVMe local agissent comme des caches éphémères en amont pour des lectures rapides de l'ensemble de données de travail. Avec cette architecture, un cache HNSW implique une série de lectures aléatoires dans le stockage d'objets.
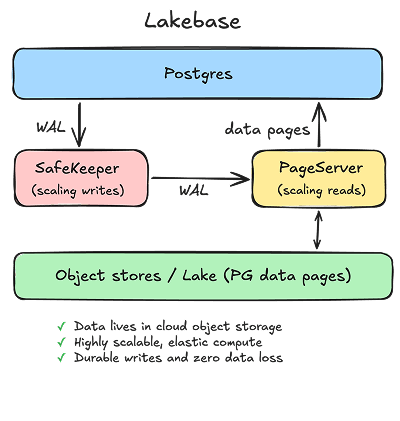
Nous avons besoin d'un index rapide à la fois lorsqu'il est mis en cache dans la RAM et lorsqu'il est froid sur le stockage d'objets. Nous exploitons deux idées :
- Le clustering IVF hiérarchique. Les vecteurs sont regroupés en clusters stockés sous forme de blocs contigus. Une requête évalue les centroïdes de clusters en mémoire, puis ne lit que les quelques blocs prometteurs, transformant des centaines de sauts aléatoires en une poignée de grandes lectures séquentielles.
- La quantification binaire (RaBitQ). Chaque vecteur est compressé à environ 1 bit par dimension, soit environ 32 fois plus petit que float32. Les requêtes scannent les codes compacts pour présélectionner des candidats, puis reclassent cette liste restreinte par rapport aux vecteurs de pleine précision.
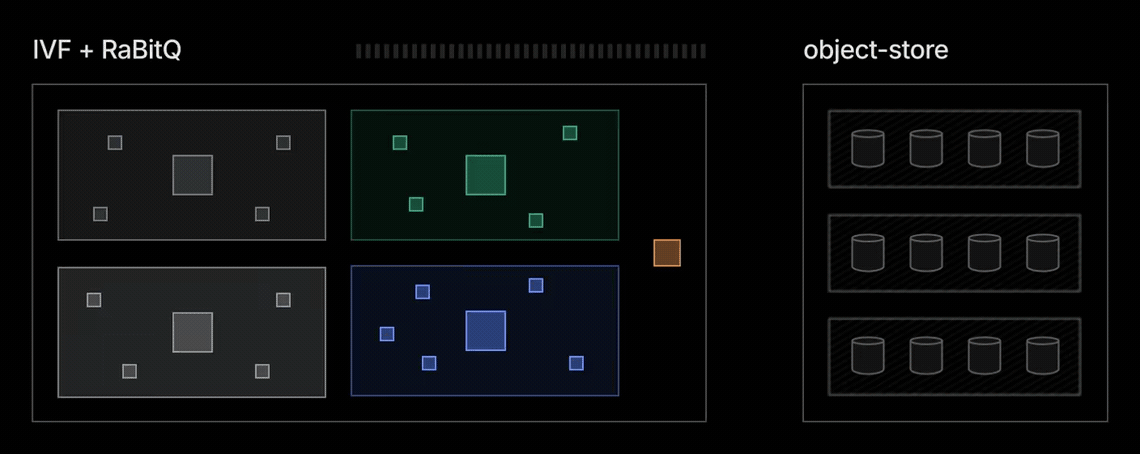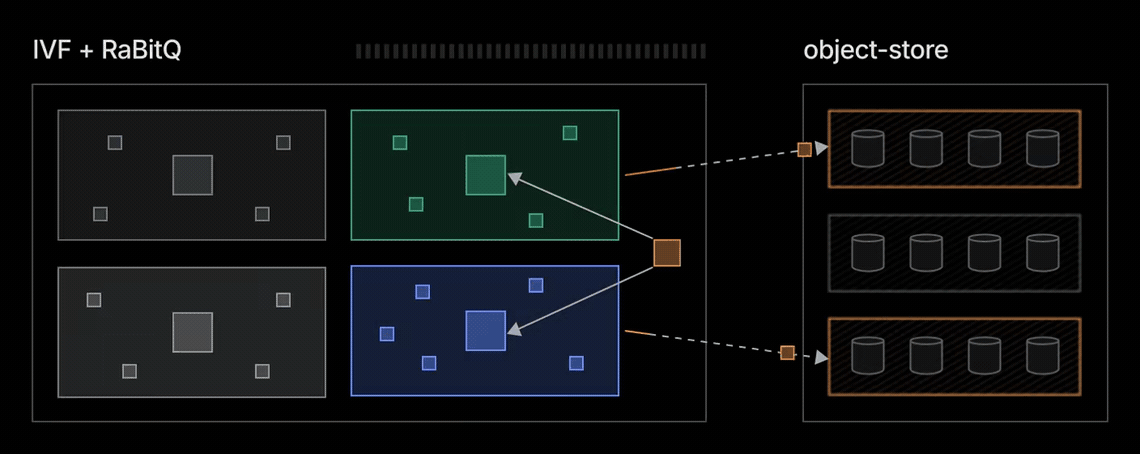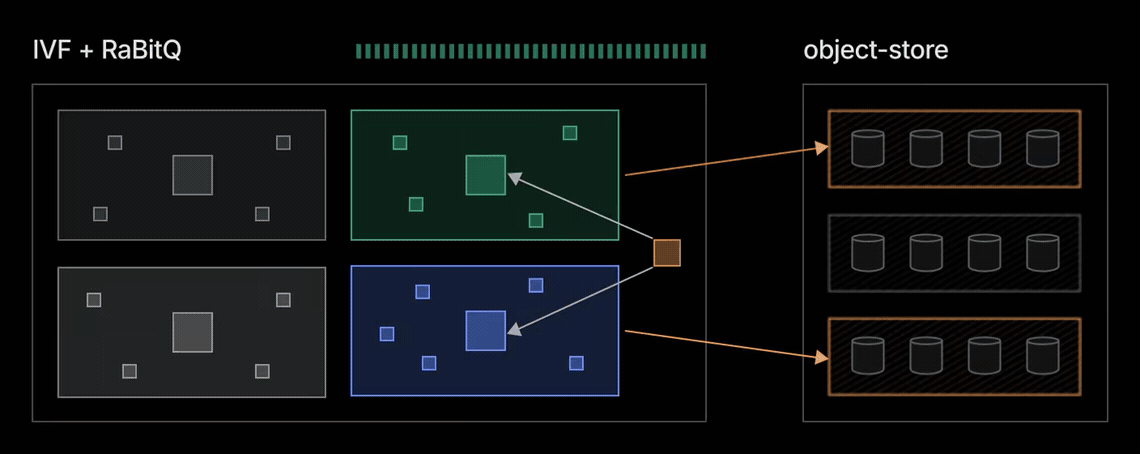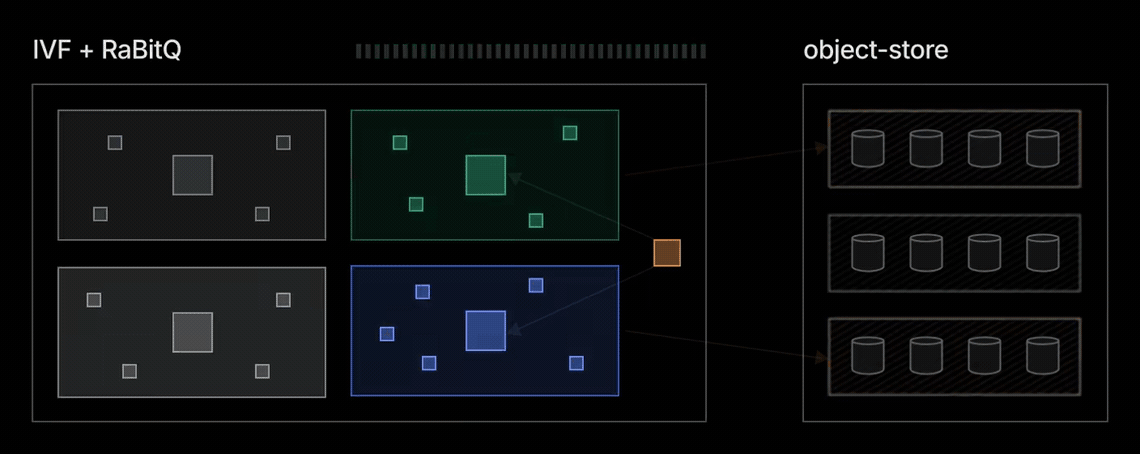
Lorsqu'elle est mise en cache, la recherche s'effectue sur une empreinte minuscule à l'aide de vecteurs quantifiés. À froid, les requêtes ne récupèrent que les blocs dont elles ont besoin et n'ont pas besoin de parcourir tout l'index. Lakebase_vector offre :
Ne payez que pour ce que vous utilisez, et réduisez à zéro
Le découplage du stockage et du calcul rend lakebase_vector complètement sans état : un nœud met en cache les données chaudes à la demande, se suspend à zéro lorsqu'il est inactif et reprend lors de la requête suivante.
- Au repos, vous ne payez que pour le stockage, ce qui vous garantit un coût de base faible pour maintenir les vecteurs indexés dans Lakebase.
- Les démarrages à froid sont peu coûteux car seuls les codes quantifiés et les blocs spécifiques touchés par une requête s'hydratent. Notre P90 mesuré pour la première requête après une réduction à zéro est de seulement 1,13 seconde (100M × 768-dim).
- Il est même possible de servir 100M de vecteurs sur seulement 1 unité de calcul Lakebase (CU). Seul l'ensemble de données de travail actif doit être mis en cache dans les nœuds de calcul, ce qui vous offre un modèle de tarification qui reflète fidèlement l'utilisation réelle et l'activité des requêtes.

Créations d'index rapides et déchargées
lakebase_vector construit des index de manière plus parallèle. Nous entraînons les centroïdes une seule fois sur un petit échantillon aléatoire. C'est la seule étape qui parcourt l'ensemble du jeu de données. Après cela, chaque vecteur est assigné indépendamment à son centroïde le plus proche, quantifié et écrit dans le bloc de son cluster. Ce processus peut se répartir sur autant de cœurs que vous possédez, s'adaptant ainsi à votre puissance de calcul.

Nous allons encore plus loin en déchargeant complètement la construction des index de votre base de données principale. Le stockage des données dans des formats ouverts permet à notre architecture LTAP de déléguer l'indexation et la maintenance à des moteurs distribués comme Spark, réduisant les temps de construction à quelques minutes seulement grâce au calcul parallèle. Restez à l'écoute.
Recherche rapide et précise
lakebase_vector élargit la recherche de candidats à moindre coût en utilisant des codes compacts de 1 bit, ne reclassant qu'une liste restreinte à pleine précision. Comme les blocs d'index sont indépendants, une seule requête est parallélisée sur les cœurs CPU, offrant simultanément un rappel élevé et une faible latence.
Le filtrage s'effectue directement lorsque lakebase_vector parcourt les blocs de clusters. L'application de prédicats en ligne évite la récupération excessive de candidats et maintient un rappel élevé sur les requêtes filtrées.
lakebase_text : recherche BM25 native dans Postgres
La recherche textuelle standard de Postgres (tsvector) manque de contexte de pertinence à l'échelle du corpus. lakebase_text apporte le BM25 natif à Postgres en évaluant les termes avec la fréquence inverse de document (IDF) globale : en attribuant un poids important aux termes rares et à forte intention, tout en pénalisant les mots de liaison courants.
Il est également plus rapide que les index traditionnels tsvector + GIN. En évaluant les limites supérieures des scores lors du parcours, le moteur ignore des blocs entiers d'occurrences qui ne peuvent pas atteindre les résultats du top-K.
Combiner lakebase_text avec lakebase_vector déverrouille la recherche hybride native dans Postgres. En une seule requête, vous pouvez fusionner la recherche vectorielle sémantique avec la pertinence des mots-clés BM25, appliquer des prédicats de filtrage SQL standard et effectuer des jointures directement sur des tables opérationnelles actives.
Lakebase Postgres est conçu pour l'ère des agents
Les agents ont poussé les moteurs de recherche traditionnels au-delà de leurs limites. Ils ont fait de la recherche vectorielle une exigence fondamentale de la pile de données et ont introduit des pics d'activité extrêmes, où un seul flux de travail peut déclencher des milliers de requêtes de récupération simultanées en quelques secondes.
Nous avons conçu Lakebase Search spécifiquement pour cette nouvelle réalité. Lakebase Postgres peut désormais gérer toutes vos charges de travail opérationnelles et de recherche, grâce à une architecture serverless qui évolue de manière transparente de 1 ligne à 1 milliard de vecteurs, et de 1 QPS à des milliers, sans reprovisionnement manuel ni gestion d'infrastructure.
Nous avons développé Lakebase Search en nous appuyant sur les retours de centaines de clients bêta, et les résultats parlent d'eux-mêmes :
- Des dépenses de base de données 3 fois inférieures : Conexiom a réduit ses coûts d'infrastructure par 3 tout en obtenant un débit 5 fois supérieur à celui de pgvector.
- Un seul appel d'outil SQL pour les agents : les développeurs remplacent les pipelines de récupération complexes multi-systèmes par un seul appel SQL pour la recherche hybride native, régie par les règles standard de la base de données.
- OLTP et recherche unifiés : les équipes consolident les tables opérationnelles actives et les clusters de recherche dédiés dans un seul backend facturé à l'usage.
Lakebase Search est disponible de manière générale aujourd'hui sur AWS and Azure. Si vous construisez déjà une application ou un agent sur Lakebase, activez simplement les extensions. Si vous n'avez pas encore essayé Lakebase, commencez dès aujourd'hui.
▎ 📝 Note : Databricks AI Search est un moteur de recherche géré pour une récupération de haute qualité prête à l'emploi — il peut être le meilleur choix lorsque vous souhaitez d'excellents résultats sans réglage manuel. Lakebase Search est le meilleur choix lorsque vous souhaitez regrouper toutes vos données opérationnelles et de recherche dans une seule base de données.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.