Jointure NEAREST BY : mise à l'échelle de la recherche vectorielle dans Databricks Runtime
Comment nous avons intégré la recherche vectorielle à Databricks sous forme de jointure SQL de premier ordre, avec des optimisations profondes du noyau dans Photon et un index vectoriel dans un format de stockage ouvert.
par Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu et Sergei Tsarev
- NEAREST BY est une nouvelle jointure SQL pour la recherche vectorielle par lots : pour chaque ligne de requête, trouvez les k lignes les plus proches par similarité ou distance vectorielle — exacte ou approximative.
- Un opérateur Photon fusionné avec un noyau GEMM personnalisé par blocs pousse le calcul du score de distance vers le débit arithmétique maximal offert par le matériel.
- Votre Lakehouse est également votre magasin de vecteurs, sans système distinct à synchroniser ou à gérer : l'index vectoriel IVF est une table Delta ordinaire avec clustering liquide qui élimine la plupart des partitions lors de la lecture.
La recherche vectorielle a vu le jour en tant que problème de serving. Le cas d'usage classique est un chatbot ou une barre de recherche : un embedding de requête arrive, et le système est optimisé pour renvoyer les top-k documents les plus proches en quelques dizaines de millisecondes.
Cependant, une grande partie des workloads de recherche vectorielle sur notre plateforme sont intrinsèquement orientés batch — ils précalculent les voisins les plus proches exacts ou approximatifs hors ligne plutôt que de les rechercher au moment de la requête. Une entreprise de paiement associe plus de 100 millions de transactions quotidiennes à 140 millions d'embeddings de commerçants pour la résolution d'entités ; une entreprise de données enrichit des dizaines de millions de données historiques chaque nuit ; un fonds quantitatif exécute des lots de millions de requêtes sur un corpus de 50 millions de vecteurs pour l'étiquetage taxonomique.
La résolution d'entités, la déduplication, l'étiquetage sémantique, la classification, l'enrichissement de données, les recommandations en batch — ce sont fondamentalement des workloads batch : des millions de requêtes sur des millions, voire des milliards de vecteurs planifiés, mesurés par la capacité du job à se terminer dans le respect de son SLA à un coût raisonnable, plutôt que par la latence d'une recherche unique. Ces workloads méritent une architecture très différente pour une meilleure performance, fiabilité et rentabilité — nous sommes donc revenus aux principes fondamentaux.
Exigences
- Le débit global plutôt que la latence par requête. L'indicateur de réussite est la finalisation de l'ensemble du job batch dans le respect de son SLA à un coût raisonnable. L'architecture doit donc privilégier le débit au détriment de la latence par requête dès que possible.
- Mise à l'échelle des deux côtés de la jointure. Jusqu'à des centaines de millions de vecteurs de requête face à des milliards de vecteurs de base. Le système doit gérer toutes les configurations de cardinalité de requête et de base.
- Parallélisme élastique. Le débit du batch provient de la mise à l'échelle horizontale. Le travail doit être partitionné proprement sur des centaines ou des milliers de cœurs, et le calcul doit s'adapter au job : monter en charge (scale out) pour l'exécution, et redescendre à zéro (scale down) après celle-ci.
- Performance arithmétique maximale par cœur. Le calcul des scores de distance est coûteux en ressources informatiques. La mise à l'échelle horizontale ne fait que multiplier ce qu'un seul cœur accomplit, les boucles internes doivent donc s'exécuter au plus près du maximum théorique défini par la bande passante arithmétique du matériel sous-jacent (FLOPs/s) et sa bande passante mémoire (octets/s).
- Tolérance aux pannes. Un job qui s'exécute pendant des heures doit survivre à la perte de workers, aux échecs de tâches transitoires et à la pression sur la mémoire grâce à l'écriture sur disque (spilling). Ce sont des propriétés d'un moteur d'exécution, et non des fonctionnalités que l'on peut greffer autour d'un point de terminaison de serving en temps réel.
Le Databricks Runtime répond parfaitement à ces exigences — un moteur d'exécution distribué, tolérant aux pannes et élastique, construit sur Apache Spark et Photon, un moteur de requête C++ natif vectorisé. C'est précisément pourquoi nous avons décidé d'intégrer la recherche vectorielle directement en tant que fonctionnalité native du moteur, plutôt que de nous appuyer sur une infrastructure distincte.
Architecture
Notre première version de la fonction SQL VECTOR_SEARCH était conçue pour fédérer les requêtes vers un point de terminaison de recherche vectorielle externe en temps réel. Elle était implémentée sous la forme d'un nœud Generate diffusant en continu (streaming) une ligne de requête à la fois : chaque ligne entraînait une requête réseau, une réponse à désérialiser et potentiellement des tentatives de rejeu. Cela fonctionnait, mais révélait un plafond de performance — le débit était limité par la taille du point de terminaison en temps réel plutôt que par la taille du cluster d'exécution, le moteur d'exécution étant réduit à un simple répartiteur. De plus, cela ne correspondait pas à la véritable nature de la requête. Une recherche vectorielle en batch n'est pas un million de petites recherches. C'est une seule grande requête : pour chaque ligne de gauche, trouver les k lignes les plus proches à droite — une jointure de classement top-k. L'exécution de jointures gigantesques est précisément ce dans quoi le moteur d'exécution excelle.
L'implémentation native de la recherche vectorielle dans le moteur d'exécution est payante à double titre.
- Une seule copie des données. Les embeddings restent dans des tables Delta sur le Lakehouse — pas de stockage vectoriel distinct, pas de pipeline de synchronisation à maintenir cohérent, pas de second système à exploiter et à payer.
- Un seul moteur pour l'exécution. La recherche s'exécute dans un seul moteur qui s'adapte de manière élastique à la charge de travail, avec des kernels spécialement conçus pour les types de requêtes batch — poussant chaque cœur vers ses FLOPs maximaux, la mise à l'échelle horizontale se chargeant de multiplier le reste. Le moteur gère déjà la tolérance aux pannes : les tâches sont relancées automatiquement et la pression sur la mémoire est évacuée sur disque. Pas de contrôle de concurrence côté client, de limitation de débit ou de boucles de relance.
Cela a donné naissance à une pile délibérément restreinte mais profonde : une nouvelle syntaxe de jointure, NEAREST BY, qui fait de la jointure de classement top-k une opération relationnelle de premier ordre ; une réécriture qui la décompose en trois primitives — des fonctions de distance accélérées par SIMD et un agrégat top-k borné ; un opérateur Photon fusionné qui remplace toute la partie centrale du plan par un noyau GEMM personnalisé ; et un index IVF optionnel construit comme une table Delta ordinaire avec clustering liquide (liquid-clustered), qui permet aux requêtes APPROX d'évaluer une fraction des vecteurs de base avec les mêmes noyaux.
La syntaxe : une jointure de classement top-k
Les moteurs existants ont convergé vers deux types d'interfaces. Postgres avec pgvector et Snowflake composent des opérateurs de distance avec ORDER BY … LIMIT — le batch nécessite alors une sous-requête LATERAL par ligne conductrice, et l'optimiseur manque d'un modèle à reconnaître pour différencier les requêtes KNN et ANN. Cette reconnaissance est également fragile : s'écarter de la forme de requête attendue fait disparaître silencieusement le chemin d'accès rapide. BigQuery expose une fonction de table — le batch est de premier ordre, mais les références de colonnes sont des chaînes que l'analyseur ne peut pas valider.
Structurellement, la recherche vectorielle en batch est une opération relationnelle binaire : deux tables en entrée, une sortie combinant les deux, et un top-k par ligne de gauche pour les connecter. La syntaxe encode cette structure sous la forme d'une jointure de classement top-k native :
La jointure est asymétrique, similaire à LATERAL : le côté gauche pilote, le côté droit est recherché. La direction du classement est explicite : BY SIMILARITY décroissant, BY DISTANCE croissant. LEFT OUTER conserve les lignes de requête sans candidats, et l'expression BY est modulable : n'importe quel scalaire ordonnable sur les deux côtés fonctionne, de sorte que d'autres expressions de score peuvent réutiliser la même clause plus tard.
APPROX et EXACT encodent un contrat sémantique. EXACT garantit le véritable top-k par évaluation exhaustive ; APPROX permet à l'optimiseur de substituer une stratégie approximative, telle qu'un index ANN, lorsqu'elle s'applique. Ainsi, la création ou la suppression d'un index ne peut jamais modifier silencieusement les résultats de la requête : seules les requêtes qui spécifient APPROX consentent à l'approximation.
La réécriture de la requête
NEAREST BY est analysé en un nœud de jointure logique, que l'optimiseur convertit en opérateurs relationnels standards : la réécriture attribue à chaque ligne de requête un identifiant généré, évalue chaque paire (requête, base), conserve les k meilleurs par identifiant avec un top-k groupé, et réintègre les lignes conservées :
Sémantiquement, cela englobe l'intégralité de la fonctionnalité : une jointure croisée (cross join), une expression de score scalaire et un agrégat top-k groupé. Comme chaque opérateur est un opérateur relationnel ordinaire, le plan se distribue, s'écrit sur disque et se relance comme n'importe quel autre — la correction et la tolérance aux pannes sont acquises d'office. Ce que la réécriture isole réellement, ce sont les deux primitives par lesquelles transite tout le temps d'exécution : la fonction de distance qui évalue une paire, et l'agrégat qui conserve les k meilleurs de chaque groupe.
Nous avons implémenté chaque opérateur de ce plan de manière native dans Photon, plus un opérateur fusionné supplémentaire, spécialement conçu pour la recherche vectorielle, qui réduit entièrement la section centrale du plan grâce à un noyau plus performant et adapté au batch.
Les kernels Photon
Les fonctions vectorielles
Les blocs de construction de base sont une famille de fonctions SQL vectorielles sur des colonnes ARRAY<FLOAT>. Trois d'entre elles sont responsables du calcul de la similarité et de la distance :
| Fonction SQL | Calcule | Plus proche signifie |
|---|---|---|
| vector_inner_product(a, b) | 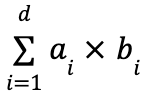 | Plus élevé (BY SIMILARITY) |
| vector_cosine_similarity(a, b) | 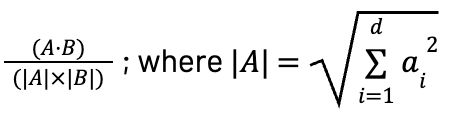 | Plus élevé (PAR SIMILARITÉ) |
| vector_l2_distance(a, b) | 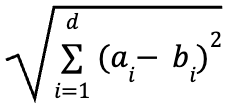 | Plus bas (PAR DISTANCE) |
En plus des fonctions de similarité et de distance, nous avons intégré deux assistants de norme — vector_norm et vector_normalize, et deux agrégats, vector_sum et vector_avg. Ensemble, ils couvrent à la fois la construction de requêtes et d'index : les fonctions de distance évaluent les requêtes et attribuent les lignes à leur centroïde le plus proche, tandis que les agrégats et les normalisateurs recalculent ces centroïdes pendant le k-means.
Photon exécute toute la famille sous forme de noyaux SIMD natifs. Chaque métrique repose fondamentalement sur des opérations de multiplication-addition, et une seule instruction de multiplication-addition fusionnée (FMA) calcule 𝑎 · 𝑏 + 𝑐 sur l'ensemble d'un registre vectoriel par émission. Les noyaux sont implémentés sur la base de quatre choix de conception délibérés.
- Portables par construction. Les mêmes noyaux doivent s'exécuter sur chaque cloud (AWS, Azure, GCP) et chaque architecture de processeur (x86, ARM) que nous prenons en charge. Comme la largeur SIMD et le jeu d'instructions diffèrent d'une architecture à l'autre, chaque noyau est compilé en plusieurs clones spécifiques à l'ISA, et le meilleur pris en charge par le processeur est sélectionné au moment de l'exécution (AVX-512 sur un cœur Intel moderne, SVE2 sur Graviton).
- Entrée sans copie. Un ARRAY<FLOAT> est contigu au sein d'une ligne, de sorte que chaque vecteur est lu comme un pointeur brut dans le tampon de support de la colonne, sans copie ni indexation par élément à l'intérieur de la boucle critique.
- Sémantique des flottants assouplie. L'abandon de l'ordonnancement strict IEEE permet au compilateur de fusionner les multiplications-additions en instructions FMA et de diviser la réduction en chaînes d'accumulateurs parallèles, de sorte que la boucle n'est pas sérialisée sur une seule somme courante.
- Rien de scalaire dans la boucle. Les boucles critiques sont de pures réductions de multiplication-addition vectorisées ; les opérations scalaires comme la racine carrée (sqrt) et la division sont effectuées une seule fois, en dehors de la boucle.
L'agrégat top-k
En SQL standard, le top-k groupé est une fonction de fenêtre : ROW_NUMBER() OVER (PARTITION BY query ORDER BY score). Cela trie entièrement chaque partition, puis élimine tout sauf les k premiers rangs. À la place, nous avons étendu les agrégats max_by / min_by existants avec une surcharge pour un troisième paramètre K. L'implémentation repose sur quatre propriétés clés.
- Sélection par comparaison unique. L'état d'agrégation par groupe est un tas borné dont la racine représente le candidat à l'éviction et le seuil d'admission. Une fois plein, chaque candidat est accepté ou rejeté à l'aide d'une seule comparaison. Aucun tri n'est jamais exécuté sur le flux de candidats.
- État en O(k). La mémoire par groupe est indépendante de la taille de l'entrée. Une requête évaluée par rapport à un milliard de lignes ne conserve que k lignes d'état, et k peut aller jusqu'à 100 000.
- Matérialisation tardive. Le tas stocke des indices, et non des copies entièrement matérialisées. Un candidat reste un pointeur vers le lot colonnaire actif et n'est copié dans l'état d'agrégation que s'il survit encore lors du recyclage du lot.
- Distribuable. Les agrégats ont un contrat de type partiel/fusion. Chaque partition émet son top-k local, le shuffle déplace ces tableaux de k éléments au lieu de paires brutes, et la fusion les réinsère. Le résultat est exact car le top-k global est toujours un sous-ensemble de l'union des résultats partiels.
Le modèle roofline
Avec tous les noyaux natifs ci-dessus, le plan de requête est entièrement optimisé pour Photon, mais reste encore loin d'être optimal à l'échelle du traitement par lots. La raison est théorique et non liée à l'implémentation, et le modèle roofline est un moyen simple et efficace de la visualiser.
𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 = 𝑚𝑖𝑛(𝑃𝑝𝑒𝑎𝑘, 𝐴𝐼 × 𝐵𝑊)
𝑃𝑝𝑒𝑎𝑘 est le débit de calcul maximal du matériel (FLOPs/s), BW est la bande passante mémoire (octets/s), et 𝐴𝐼 est l'intensité arithmétique du noyau (FLOPs effectués par octet déplacé). En traçant 𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 en fonction de 𝐴𝐼, on obtient la courbe roofline : un plafond mémoire diagonal qui rejoint un plafond de calcul horizontal au point de crête — l'intensité arithmétique minimale à laquelle un noyau peut être limité par le calcul. À gauche de la crête, seul le fait de déplacer moins d'octets par FLOP est utile ; à droite, le noyau est limité par le calcul et les unités arithmétiques elles-mêmes constituent la limite. Concrètement, sur une machine de référence m6i.2xlarge (à titre illustratif, les constantes varient selon le matériel) :
| Par cœur | |
|---|---|
| Plafond du débit de calcul | 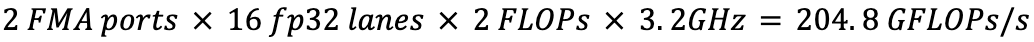 |
| Plafond de la bande passante DRAM | 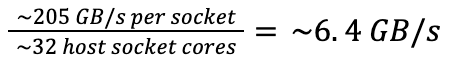 |
| Point de crête | 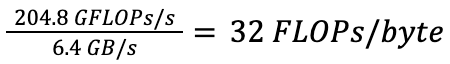 |
*Les plafonds de cache L1/L2 se situent 30 à 60 fois au-dessus de la part équitable de la DRAM, mais la table de base est bien plus grande que n'importe quel cache, de sorte que chaque octet de base franchit la limite de la DRAM au moins une fois.
*Le plafond du débit de calcul évolue linéairement avec le nombre de cœurs. Un cluster de 64 exécuteurs m6i.2xlarge (4 cœurs physiques chacun) atteint un pic de 64 x 4 x 204,8 GFLOP/s ≈ 52,5 TFLOP/s de FMA fp32.
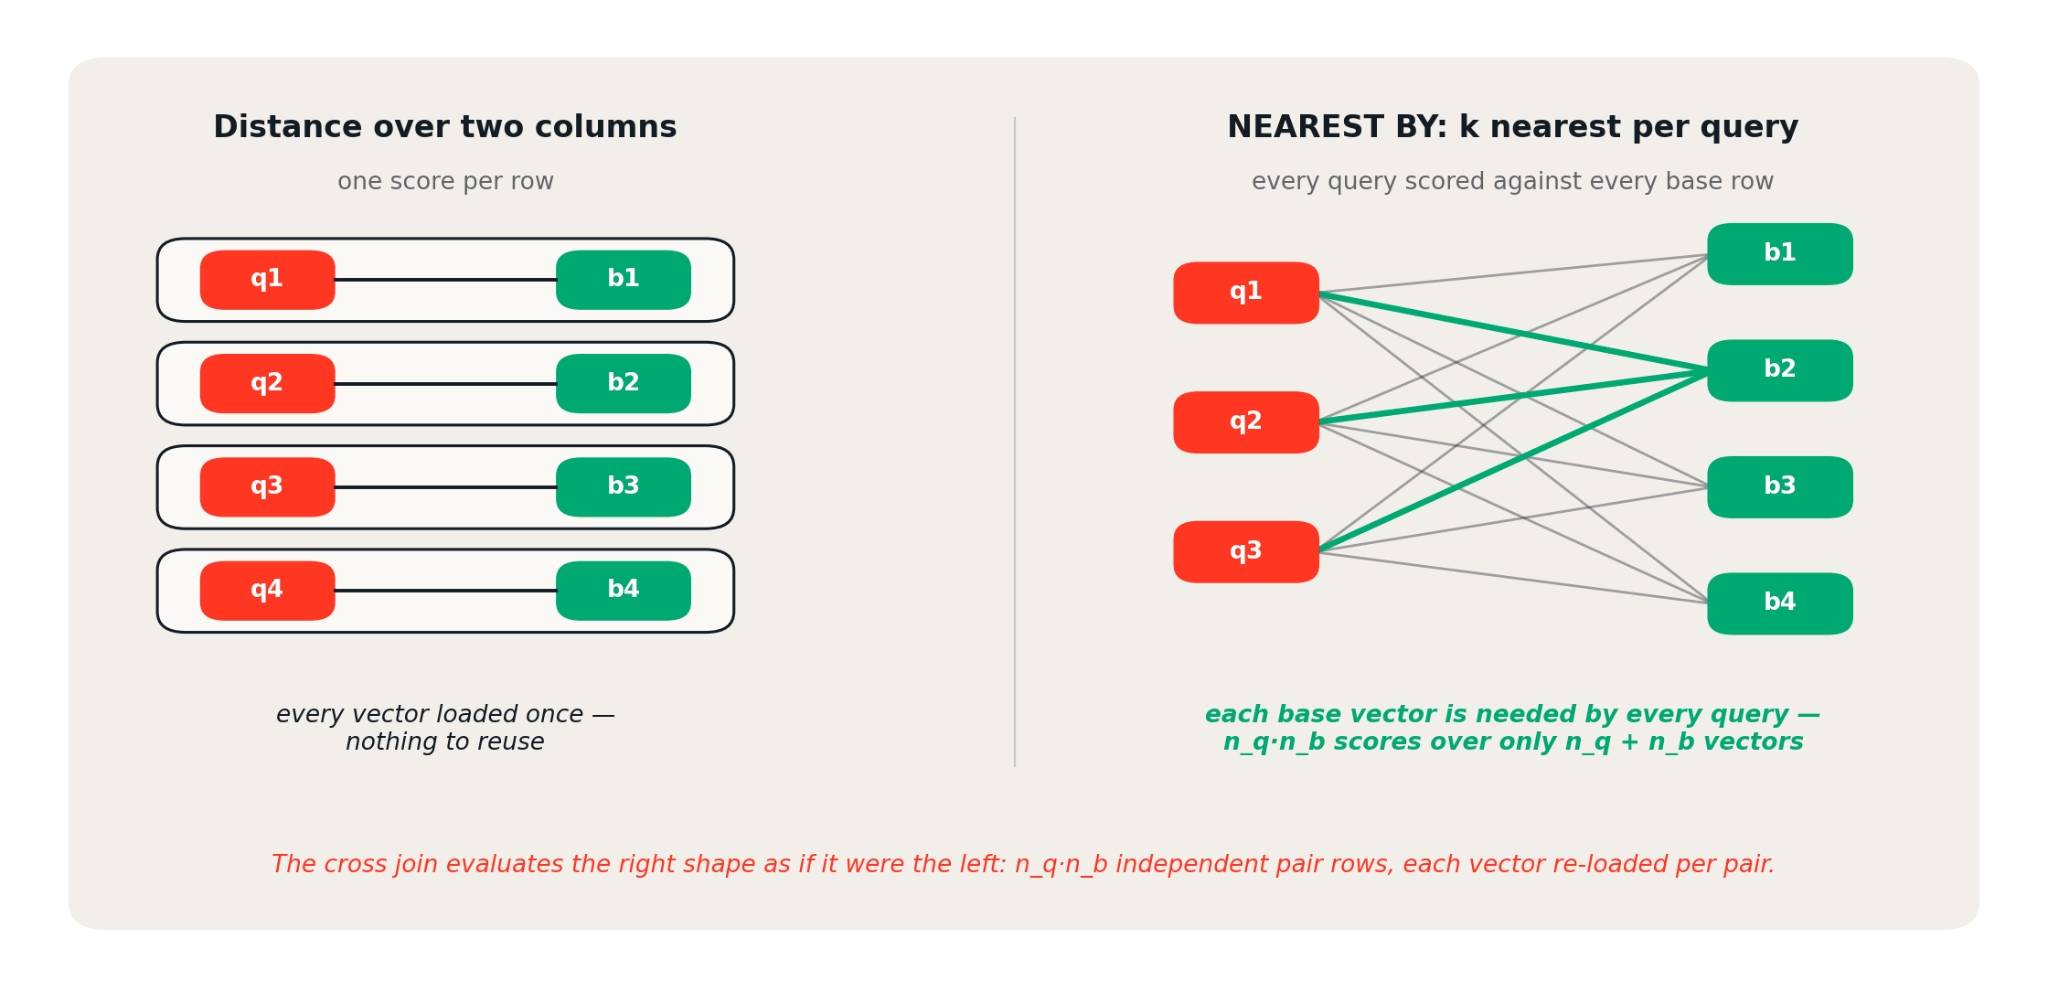
L'évaluation de deux colonnes alignées produit un score par ligne — chaque vecteur est utilisé une seule fois, et il n'y a pas de réutilisation. La forme NEAREST BY produit 𝑛𝑞 × 𝑛𝑏 scores à partir de seulement 𝑛𝑞 + 𝑛𝑏 vecteurs distincts, puisque chaque vecteur de base est requis par chaque requête.
Comparez maintenant ce que la recherche vectorielle déplace dans le cadre d'un plan naïf par rapport à un plan prenant en compte la réutilisation. Les FLOPs sont identiques dans les deux cas : 2 × 𝑑 × 𝑛𝑞 × 𝑛𝑏, où 𝑛𝑞 et 𝑛𝑏 représentent la cardinalité côté requête et côté base, et est la dimension d'intégration.
| Plan | Octets déplacés | Intensité arithmétique (AI) | Mise à l'échelle |
|---|---|---|---|
| Jointure croisée par paires — chaque opérande est chargé à neuf, utilisé une seule fois | 2 × 4 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 | 1/4 | 0(1) |
| GEMM fusionné — mis en mémoire tampon, diffusé une seule fois | 4 × 𝑑 × 𝑛𝑏 | 𝑛𝑞/2 | 0(𝑛𝑞) |
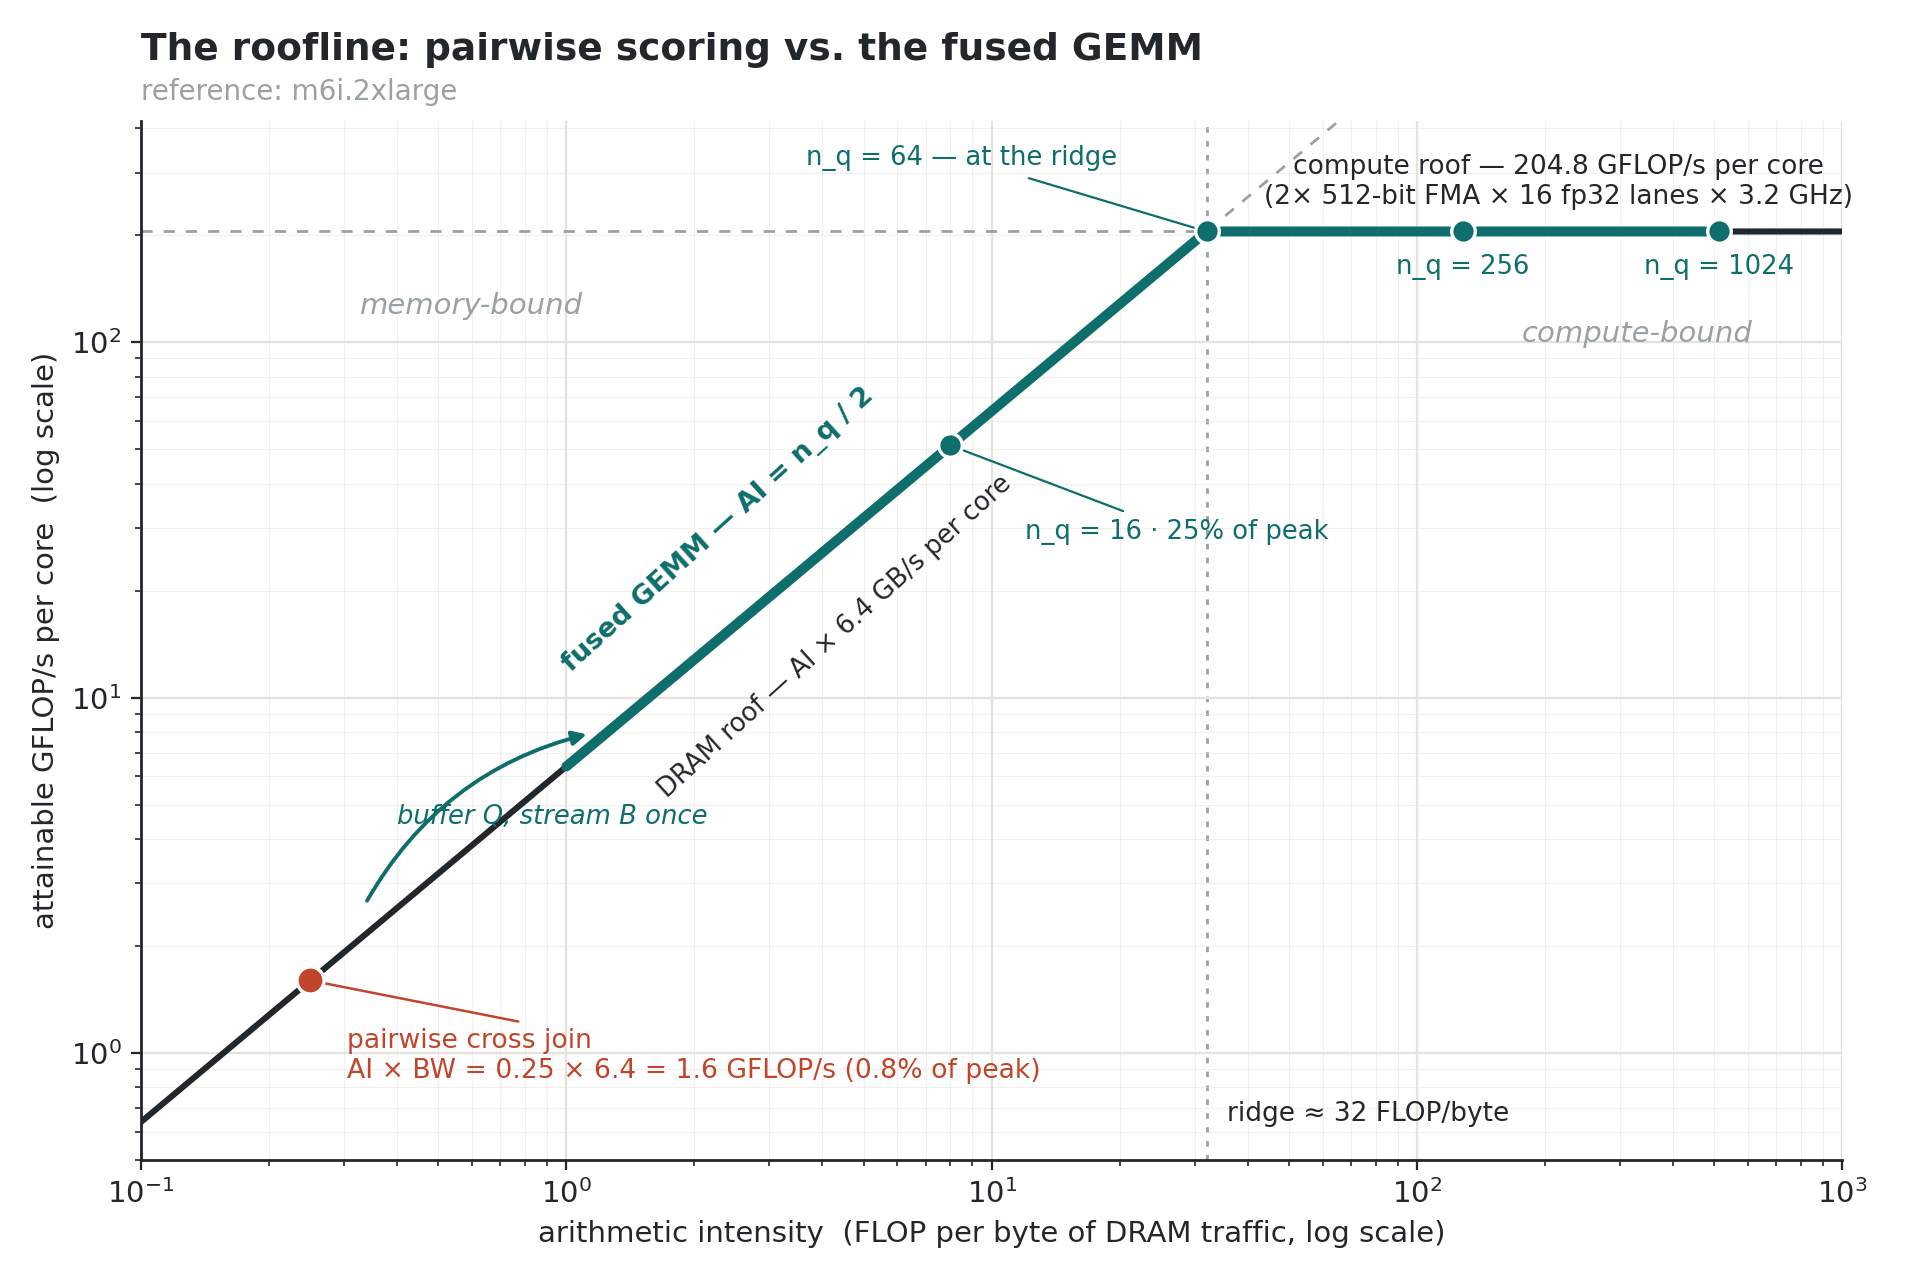
L'évaluation par paires est bloquée sur la pente de la DRAM à 0,8 % du pic, tandis que l'intensité arithmétique du noyau GEMM fusionné augmente avec la taille du lot : 𝐴𝐼 = 𝑛𝑞/2 — ce qui lui permet de franchir la crête à 𝑛𝑞 = 64 et de suivre le plafond de calcul pour des lots plus importants. Les noyaux de distance vectorielle et de similarité sont quasi-optimaux pour leur forme d'entrée, mais la forme du plan naïf ne présente aucune réutilisation de données à exploiter, et le traitement par lots ne peut pas l'aider : l'explosion des paires multiplie les FLOPs et les octets de manière égale. La solution consiste à utiliser un plan d'opérateur fusionné, à laisser le noyau exploiter la réutilisation des données, et l'intensité arithmétique suivra.
L'opérateur fusionné et le noyau GEMM
L'opérateur fusionné est un nœud d'exécution Photon unique qui remplace la jointure croisée, la projection de distance / similarité et, facultativement, le top-k partiel. Il met en mémoire tampon l'entrée la plus petite, diffuse l'autre par lots, évalue les tuiles requête-base avec un noyau GEMM personnalisé et maintient l'état du top-k par requête à travers les tuiles lorsque k est suffisamment petit. Avec le top-k fusionné, sa sortie est d'au plus 𝑛𝑞 × 𝑘 lignes candidates plutôt que 𝑛𝑞 × 𝑛𝑏 paires, consommées en aval par le noyau de fusion max_by / min_by. La mémoire de crête par tâche correspond au côté mis en mémoire tampon + un lot en cours de traitement + l'état de sélection 0(𝑛𝑞 × 𝑘). La distribution suit les stratégies de jointure standard — faire un broadcast du côté le plus petit lorsqu'il y a de la place, sinon partitionner les deux côtés et exécuter un produit cartésien par blocs.
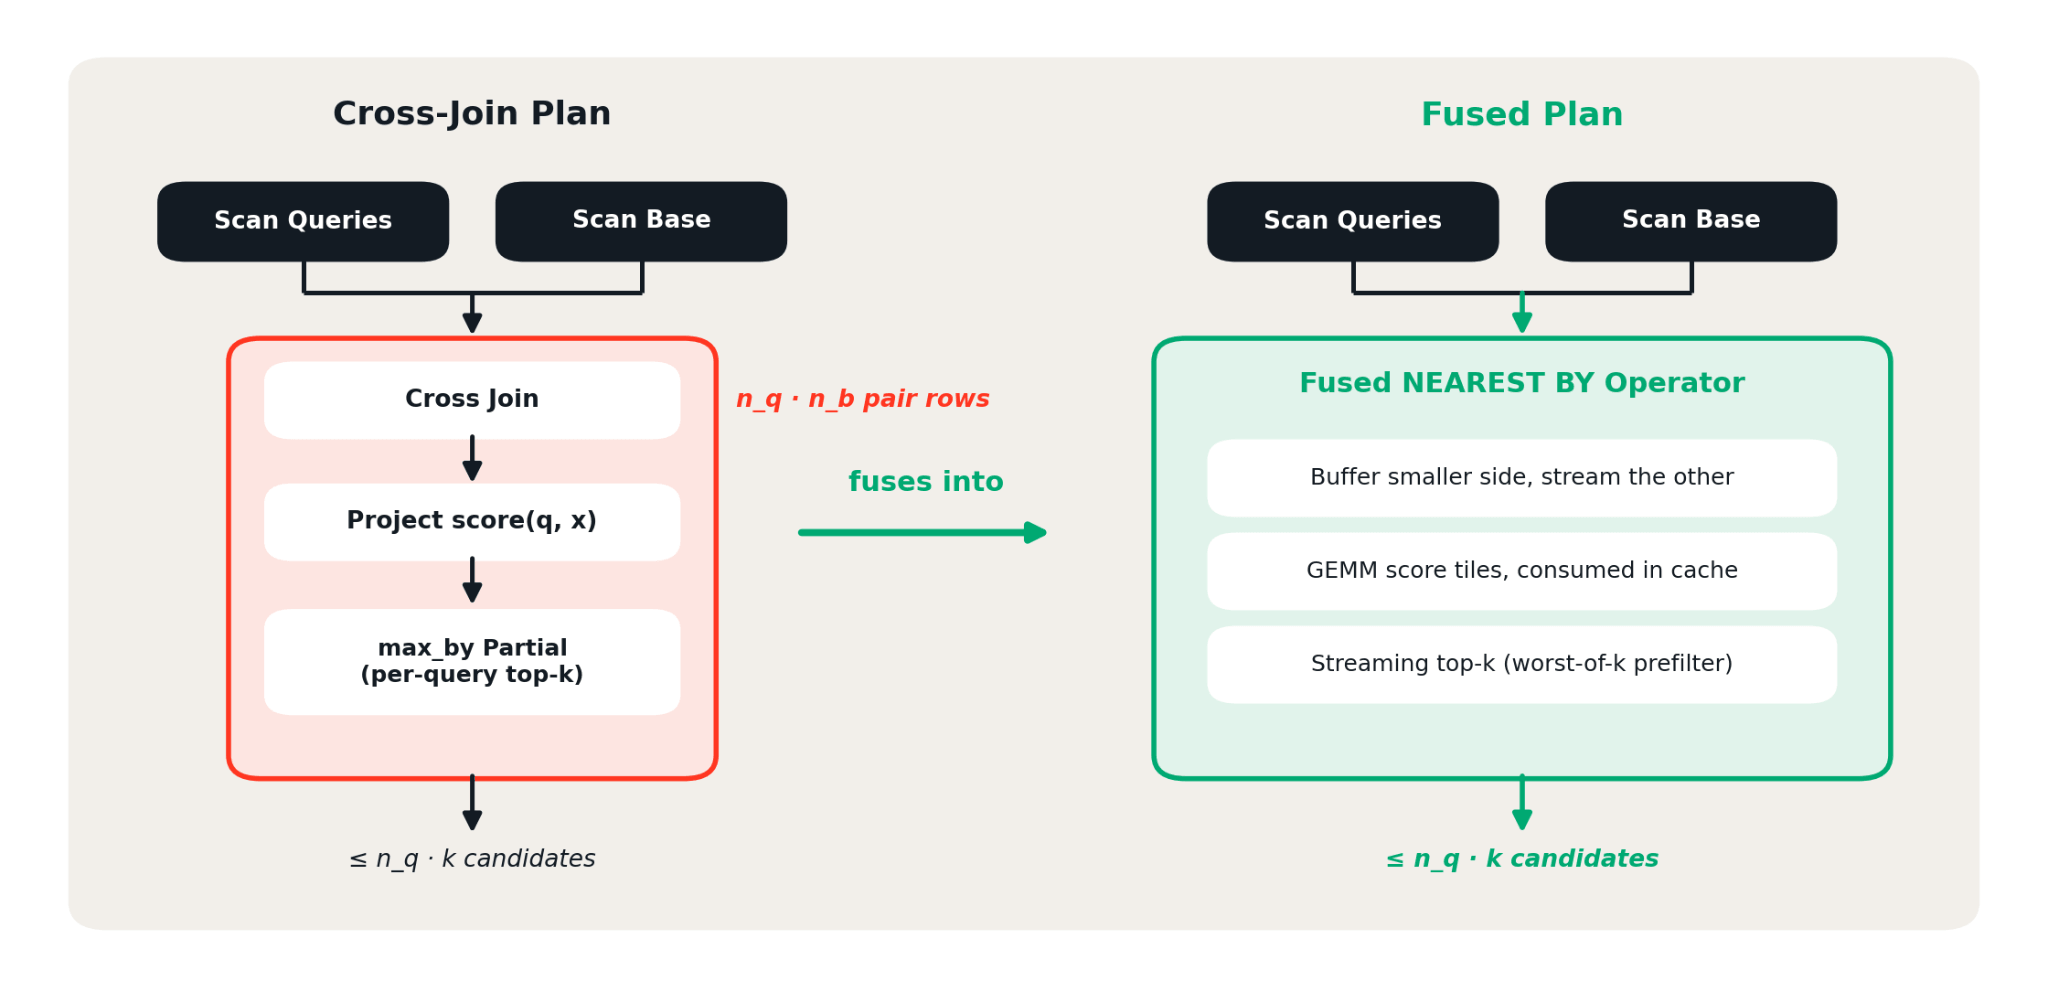
Comme le montre le modèle roofline, la fusion modifie les octets que nous déplaçons en mémoire, et non les FLOPs que nous exécutons. Chaque vecteur de base est évalué par rapport à toutes les requêtes en mémoire tampon une fois chargé, de sorte que l'intensité arithmétique augmente de manière linéaire avec le lot et franchit le point de crête de référence à 𝑛𝑞 = 64 — bien en dessous des tailles de lots des charges de travail de production typiques. Il en va de même lorsque le côté de base est plus petit, l'intensité arithmétique s'adaptant au côté qui reste résident.
Franchir la crête est nécessaire, mais pas suffisant. Le nombre d'octets 𝑛𝑞/2 est le résultat direct du noyau GEMM par blocs ci-dessous. Dépasser la limite de la DRAM ne fait que déplacer le goulot d'étranglement vers le bas, vers la bande passante du cache, puis vers la latence FMA.
Concretement, le noyau est un GEMM par blocs classique sur la matrice de score 𝐷 = 𝑄 · 𝐵𝑇. La boucle externe progresse sur la base un panneau de vecteurs à la fois et compacte chaque panneau par dimension majeure pour réutilisation à travers les tuiles de requête. Comme la dimension d'intégration est elle-même divisée en panneaux, la boucle intermédiaire balaie chaque tuile de requête en mémoire tampon par rapport au panneau compacté avant que le suivant ne soit récupéré. La boucle la plus interne accumule une petite tuile de sortie dans des registres à travers un panneau de dimension ; pour les intégrations plus larges qu'un seul panneau, les résultats partiels en cours sont stockés dans le tampon de score et relus pour continuer le panneau suivant. Chaque tuile terminée est écrite dans un tampon de score limité et recyclé que le top-k en continu consomme sur place, de sorte que la matrice de score complète 𝑛𝑞 × 𝑛𝑏 n'est jamais écrite dans la DRAM.
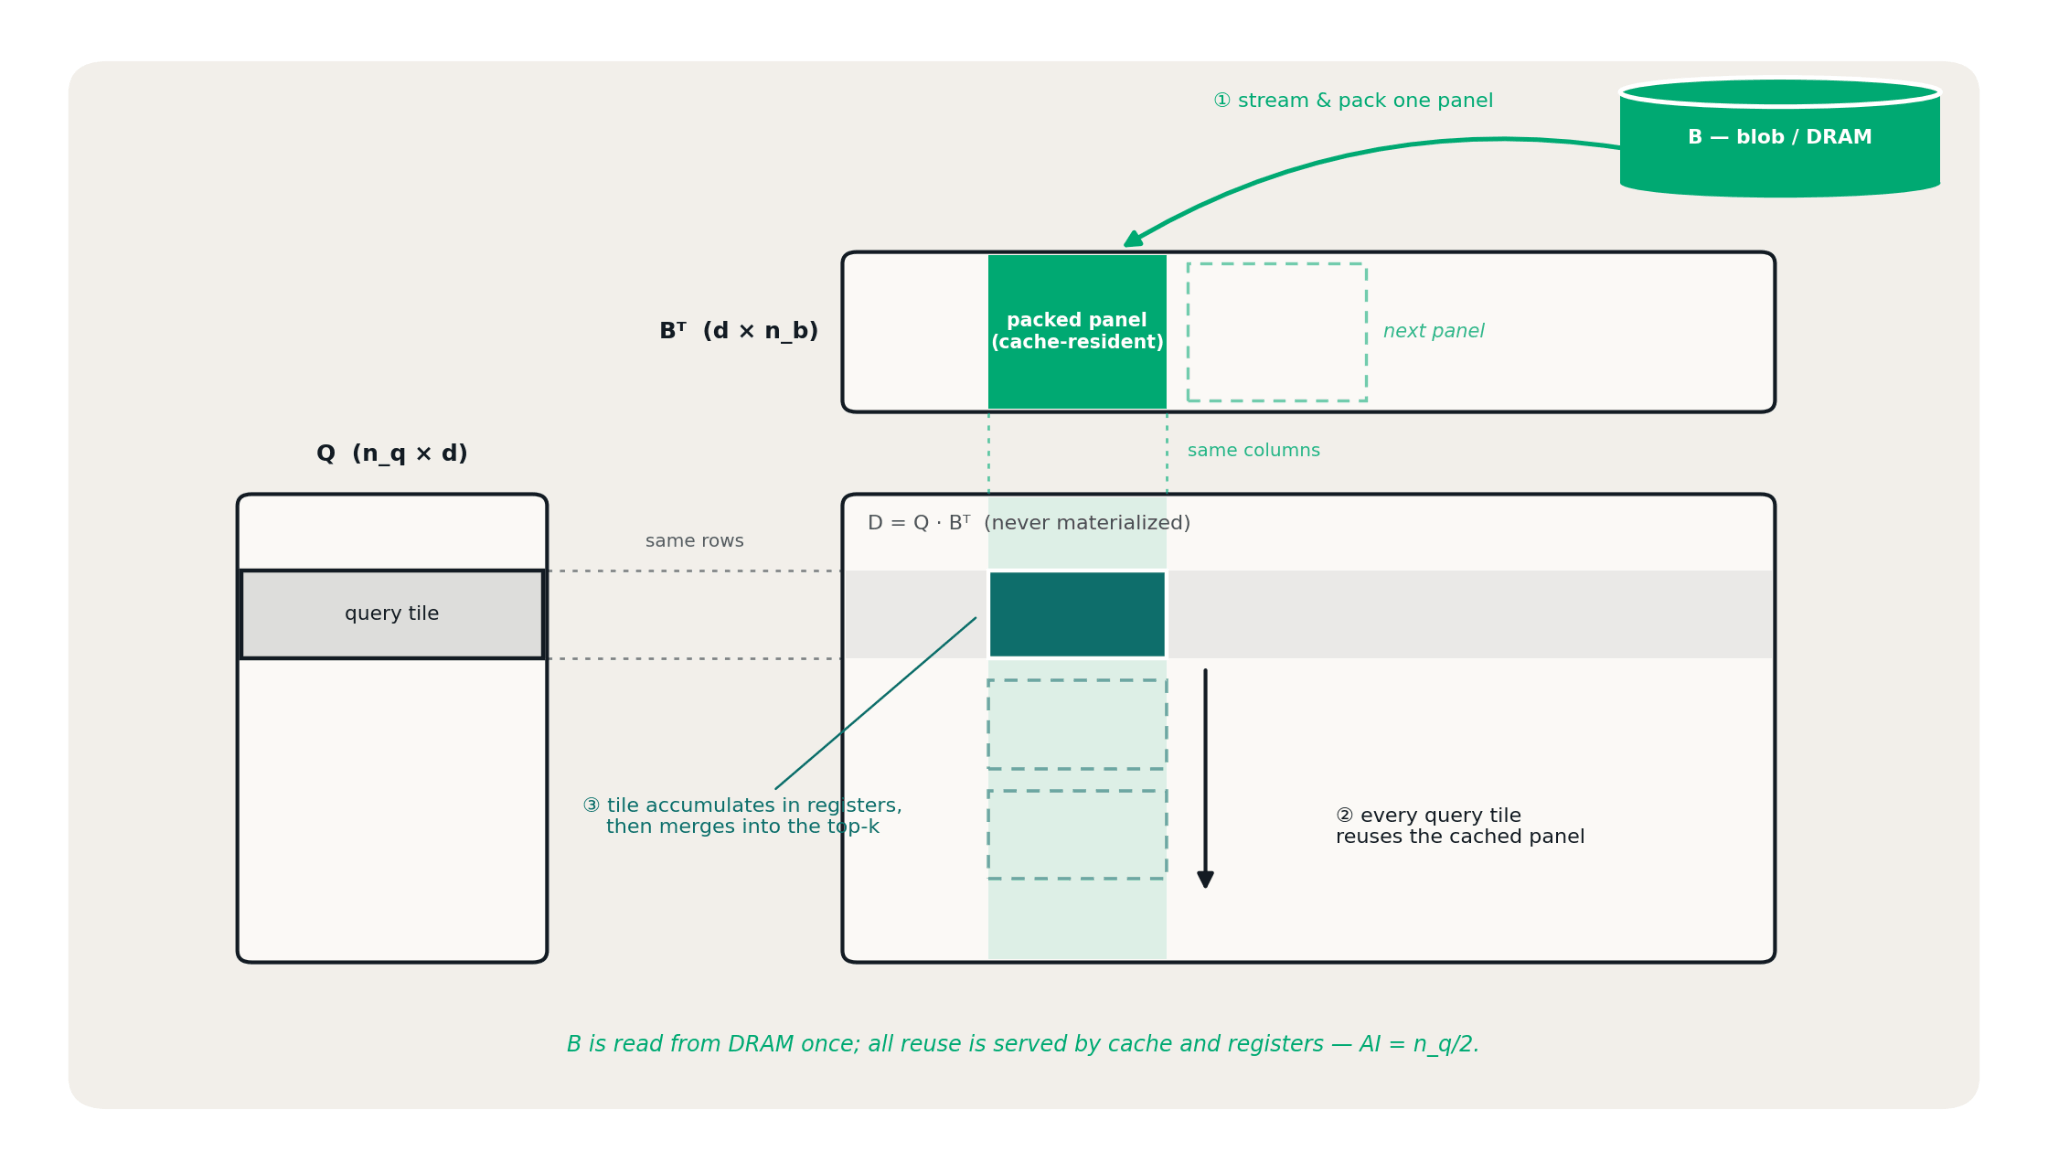
Il existe deux niveaux de blocage pour améliorer la réutilisation des données. Les panneaux de base compactés sont réutilisés à travers les tuiles de requête pour favoriser les accès réussis au cache CPU, tandis que le blocage des registres permet à chaque valeur chargée de contribuer à plusieurs FMAs. Chaque taille de tuile équilibre deux considérations concurrentes :
- Taille du panneau compacté : Le panneau doit être suffisamment petit pour tenir confortablement dans le cache, mais assez grand pour limiter la surcharge liée à la sauvegarde et au rechargement des résultats partiels. Chaque frontière le long de la dimension d'intégration nécessite un aller-retour via le tampon de score. Des panneaux plus grands réduisent ce trafic, mais peuvent augmenter les échecs de cache.
- Taille de la tuile de registre : Les accumulateurs et les opérandes doivent tenir dans les registres vectoriels disponibles, tout en fournissant suffisamment d'accumulations indépendantes pour chevaucher la latence FMA. Des tuiles plus grandes augmentent la réutilisation des données et exposent davantage de travail indépendant, mais augmentent également la pression sur les registres et le risque de débordement en mémoire.
La plupart des charges de travail de production s'exécutent avec un k relativement petit, nous avons donc optimisé le top-k en continu pour ce cas de figure. L'état de sélection par requête reste à l'intérieur de l'opérateur fusionné, chaque tuile de score fusionne avec les sélections alors qu'elle est encore dans le cache, et la matrice complète 𝑛𝑞 × 𝑛𝑏 n'atteint jamais la DRAM. Dès qu'une requête contient k entrées, son pire score devient le seuil d'admission, permettant à la fusion de rejeter plusieurs scores par comparaison vectorisée. Seules les lignes survivantes sont rassemblées pour la sortie. Lorsque k est suffisamment grand pour que cet état génère une pression sur la mémoire, l'opérateur exécute le GEMM par blocs seul et transmet les tuiles évaluées au traitement partiel max_by / min_by existant. Sous ce mode de repli, l'émission d'un score 𝑓𝑝32 par paire coûte 4 𝑏𝑦𝑡𝑒𝑠 contre 2𝑑 𝐹𝐿𝑂𝑃𝑠, de sorte que 𝐴𝐼 = 𝑑/2 — ce qui reste bien au-delà de la crête pour toute dimension réaliste.
L'index vectoriel
Tout ce qui a été présenté jusqu'ici accélère la recherche exhaustive KNN (k-nearest-neighbor) ; rien de tout cela ne change le fait que la recherche exhaustive est en 0(𝑛𝑞 × 𝑛𝑏) — un million de requêtes par rapport à un milliard de lignes représente 1015 produits scalaires, et aucune tuile de registre ne permet d'amortir un exposant. C'est précisément à cela que servent APPROX et l'index vectoriel.
L'index repose sur une conception classique d'IVF (inverted file). L'indexation entraîne k-means sur un échantillon du corpus pour produire un ensemble de centroïdes. Chaque ligne de base est attribuée à son centroïde le plus proche, et lors de la requête, chaque requête évalue uniquement les vecteurs de ses clusters les plus proches. L'élagage se combine avec 𝑛𝑏 : à l'échelle de milliards de lignes, une requête sonde ≤ 0,1 % du corpus, ce qui représente des ordres de grandeur de travail de distance en moins par rapport à la force brute. Nous avons choisi IVF plutôt que des index de graphes car les balayages de clusters indépendants se parallélisent sur les exécuteurs et la disposition est naturellement en stockage colonnaire, tandis que le parcours de graphe est une chaîne de recherches séquentielles.
Physiquement, l'index est une table Delta ordinaire. Les lignes d'attribution portent le vecteur à côté de son centroid id, et la table fait l'objet d'un clustering liquide par centroid id. Les candidats de chaque cluster se trouvent de manière contiguë sur le stockage blob, et les fichiers dont les clusters n'ont fait l'objet d'aucune requête sondée sont élagués avant d'être lus. L'actualisation est transactionnelle et incrémentielle.
Une requête APPROX se réécrit sur les mêmes primitives : sonder les centroïdes avec la même jointure top-k NEAREST BY, effectuer une équi-jointure sur centroid id pour restreindre chaque requête à ses clusters sondés, évaluer et appliquer le top-k, puis fusionner. Les fichiers ajoutés depuis la dernière actualisation sont traités par force brute dans une branche de compensation et combinés dans la même fusion, de sorte qu'un index obsolète élague moins, mais ne dégrade jamais la qualité de la recherche.
L'exécution des requêtes est façonnée par les cardinalités des requêtes et de la base.
| Scénario | Stratégie de jointure | Caractéristiques clés |
|---|---|---|
| Petite table d'index, petite table de requêtes | BNLJ, broadcast de l'index | Tout en mémoire |
| Petite table d'index, grande table de requêtes | BNLJ, broadcast de l'index | Les requêtes restent partitionnées et sont diffusées en continu, broadcast de l'index à tous |
| Grande table d'index, petite table de requêtes | BNLJ, broadcast des requêtes | Les partitions d'index sont diffusées en continu, broadcast des requêtes sondées |
| Grande table d'index, grande table de requêtes | Équi-jointure par ID de centroïde, avec shuffle sur place pour l'index | Faire un shuffle des requêtes sondées par ID de centroïde ; exploiter le clustering liquide de l'index pour éviter un shuffle complet de l'index |
Le cas grand-grand est celui où le clustering liquide est le plus avantageux : seul le côté requête se déplace ; chaque requête sondée fait l'objet d'un shuffle vers les partitions de ses clusters, tandis que le côté index analyse directement les fichiers pour trouver les centroid ids correspondants. Chaque partition sonde exactement les candidats de ses propres clusters.
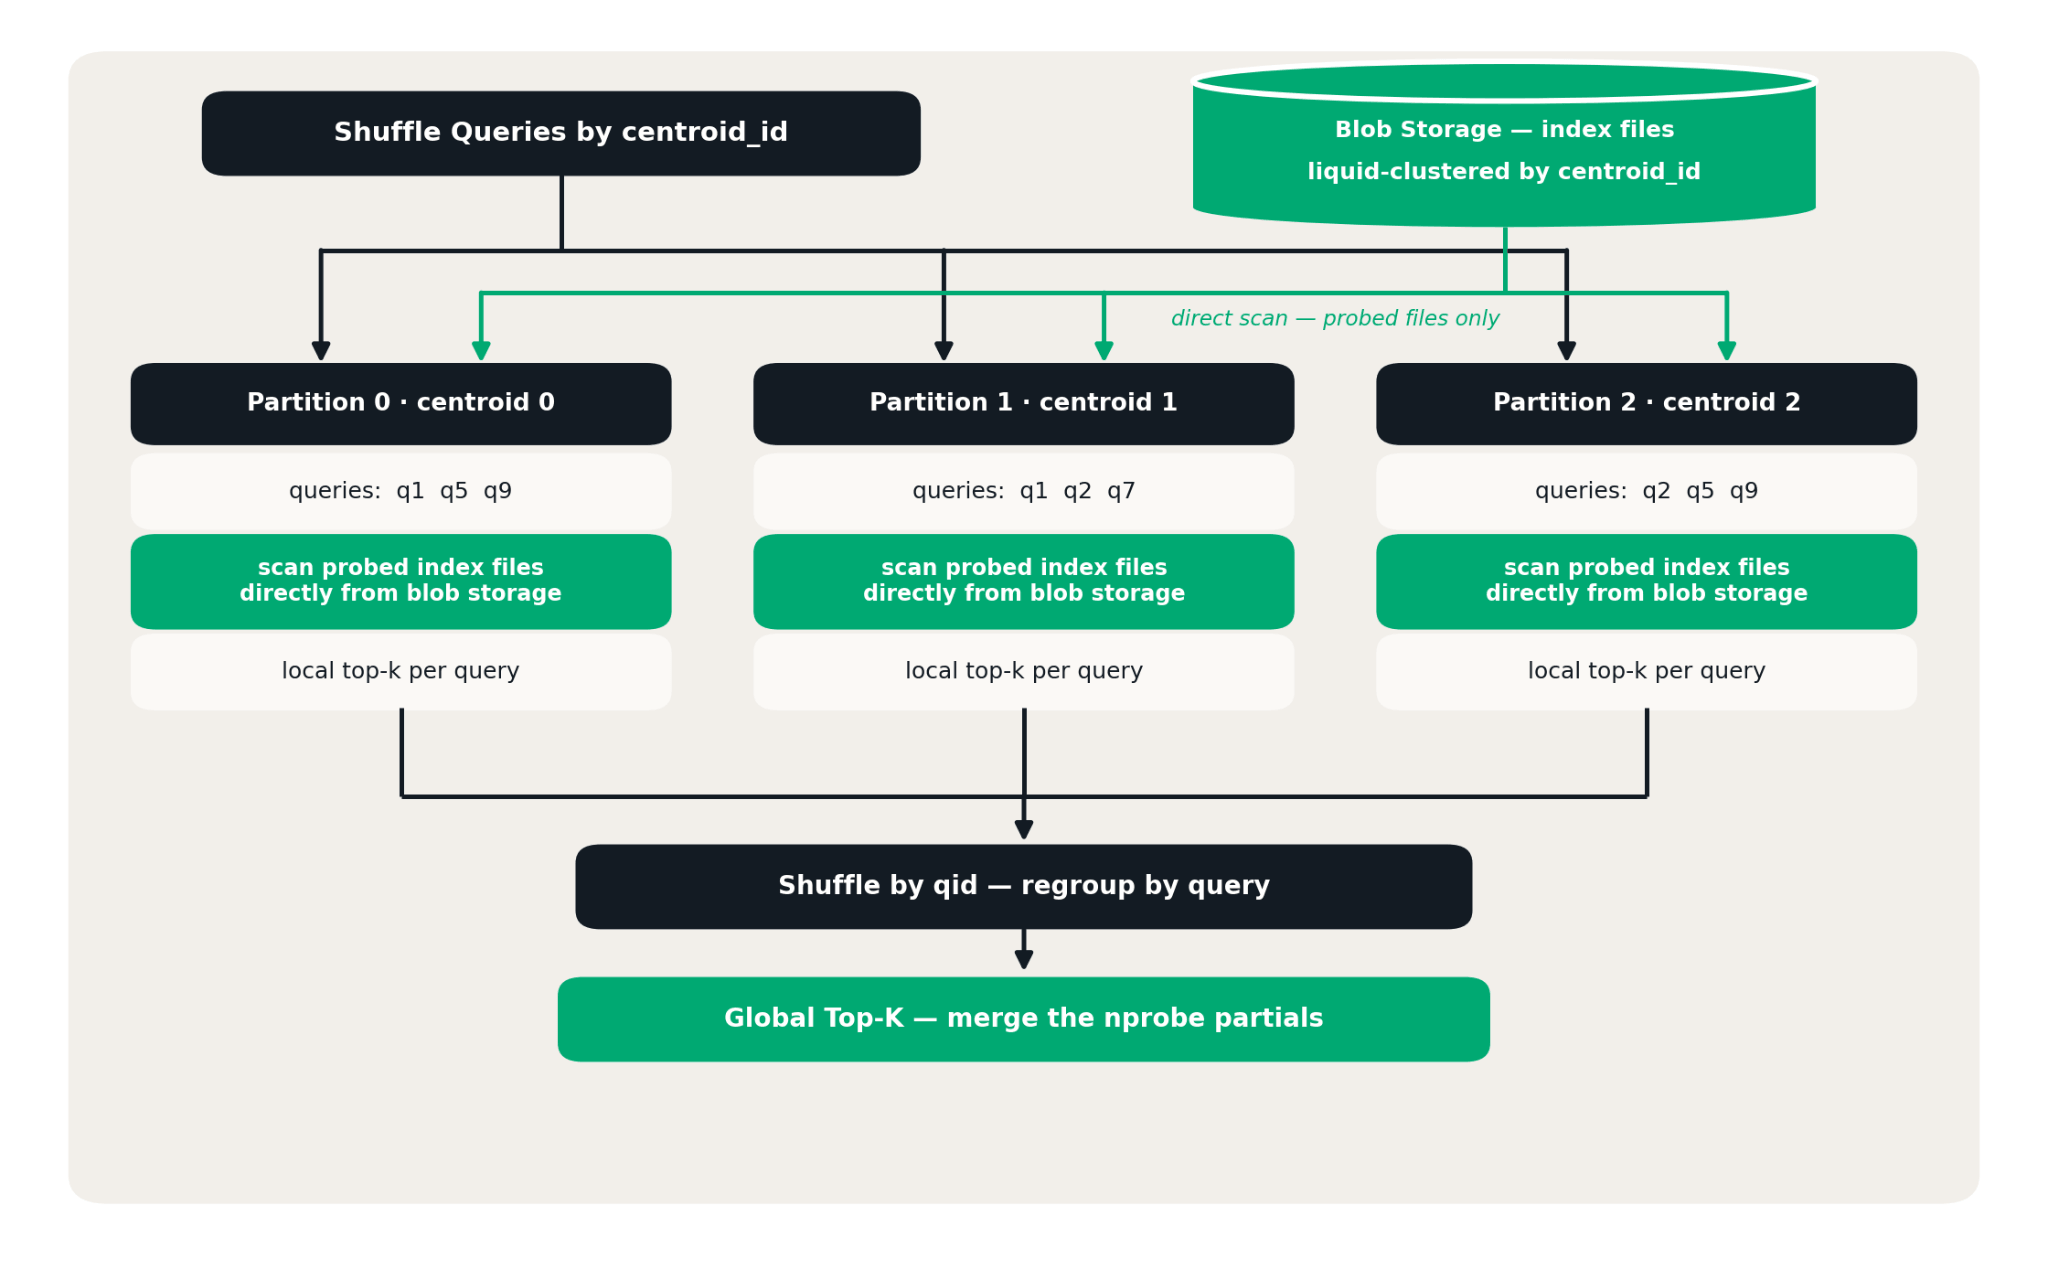
Au sein d'une partition, les candidats de chaque cluster arrivent sous forme de bloc contigu dense, de sorte que le même noyau GEMM s'applique. Le chemin exact l'exécute une fois globalement ; le chemin approximatif l'exécute une fois par cluster. Top-k local par requête, regroupement, fusion des résultats partiels : le contrat partiel/fusion de l'agrégat fait exactement ce pour quoi il a été conçu.
Le résultat
Nous avons évalué NEAREST BY sur des charges de travail canoniques observées chez nos clients, avec des tables de base allant de 100 000 à 5 milliards de vecteurs et des lots de requêtes allant jusqu'à 10 millions de vecteurs, en ciblant un rappel@K d'au moins 96 %. En utilisant l'ANN indexé :
- Dédoublonnage sémantique : Une auto-jointure d'une table de 10 millions d'enregistrements s'est terminée en quelques minutes, récupérant les correspondances candidates pour la détection des doublons.
- Classification et étiquetage : La recherche de 10 millions de requêtes par rapport à 100 000 vecteurs de référence a pris moins d'une minute, facilitant la classification grâce à des exemples étiquetés similaires.
- Actualisations des recommandations : Un lot de 1 million de requêtes par rapport à 10 millions de vecteurs de catalogue a généré des candidats de recommandation en quelques minutes.
- Résolution d'entités et enrichissement : La recherche de 1 million de requêtes par rapport à 1 milliard de vecteurs de référence s'est terminée en quelques minutes, fournissant des correspondances candidates pour lier les enregistrements et récupérer du contexte supplémentaire.
Conclusion
La recherche vectorielle par lots n'avait pas besoin d'un nouveau système — elle devait devenir un citoyen de première classe de celui qui contient déjà les données. NEAREST BY exprime la charge de travail pour ce qu'elle est structurellement : une jointure de classement top-k. Le modèle roofline explique pourquoi le plan naïf est limité par la mémoire et ce que tout noyau plus rapide doit faire pour y remédier. L'opérateur fusionné et son GEMM par blocs transforment cette analyse en intensité arithmétique, et l'index vectoriel lui permet de monter en charge encore davantage tout en restant une table Delta ordinaire à clustering liquide. Les nouveaux mécanismes sont délibérément conçus pour être simples, ciblés, mais profonds et efficaces : une clause de jointure, sept fonctions vectorielles, une surcharge d'agrégation, un opérateur fusionné et une décision de disposition du stockage. Tout le reste, des shuffles et spills à la gouvernance et à la mise à l'échelle automatique, est fourni avec le moteur d'exécution, conçu et renforcé depuis plus d'une décennie.
Si concevoir des systèmes informatiques complexes pour des charges de travail AI/ML à grande échelle chez Databricks vous intéresse, venez construire avec nous !
Télécharger maintenant Essayez NEAREST BY — lisez la documentation
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.