PostgreSQL 19 est disponible sur Lakebase
Essayez les nouvelles fonctionnalités : REPACK, conseils de plan de requête, WAIT FOR LSN, et plus encore
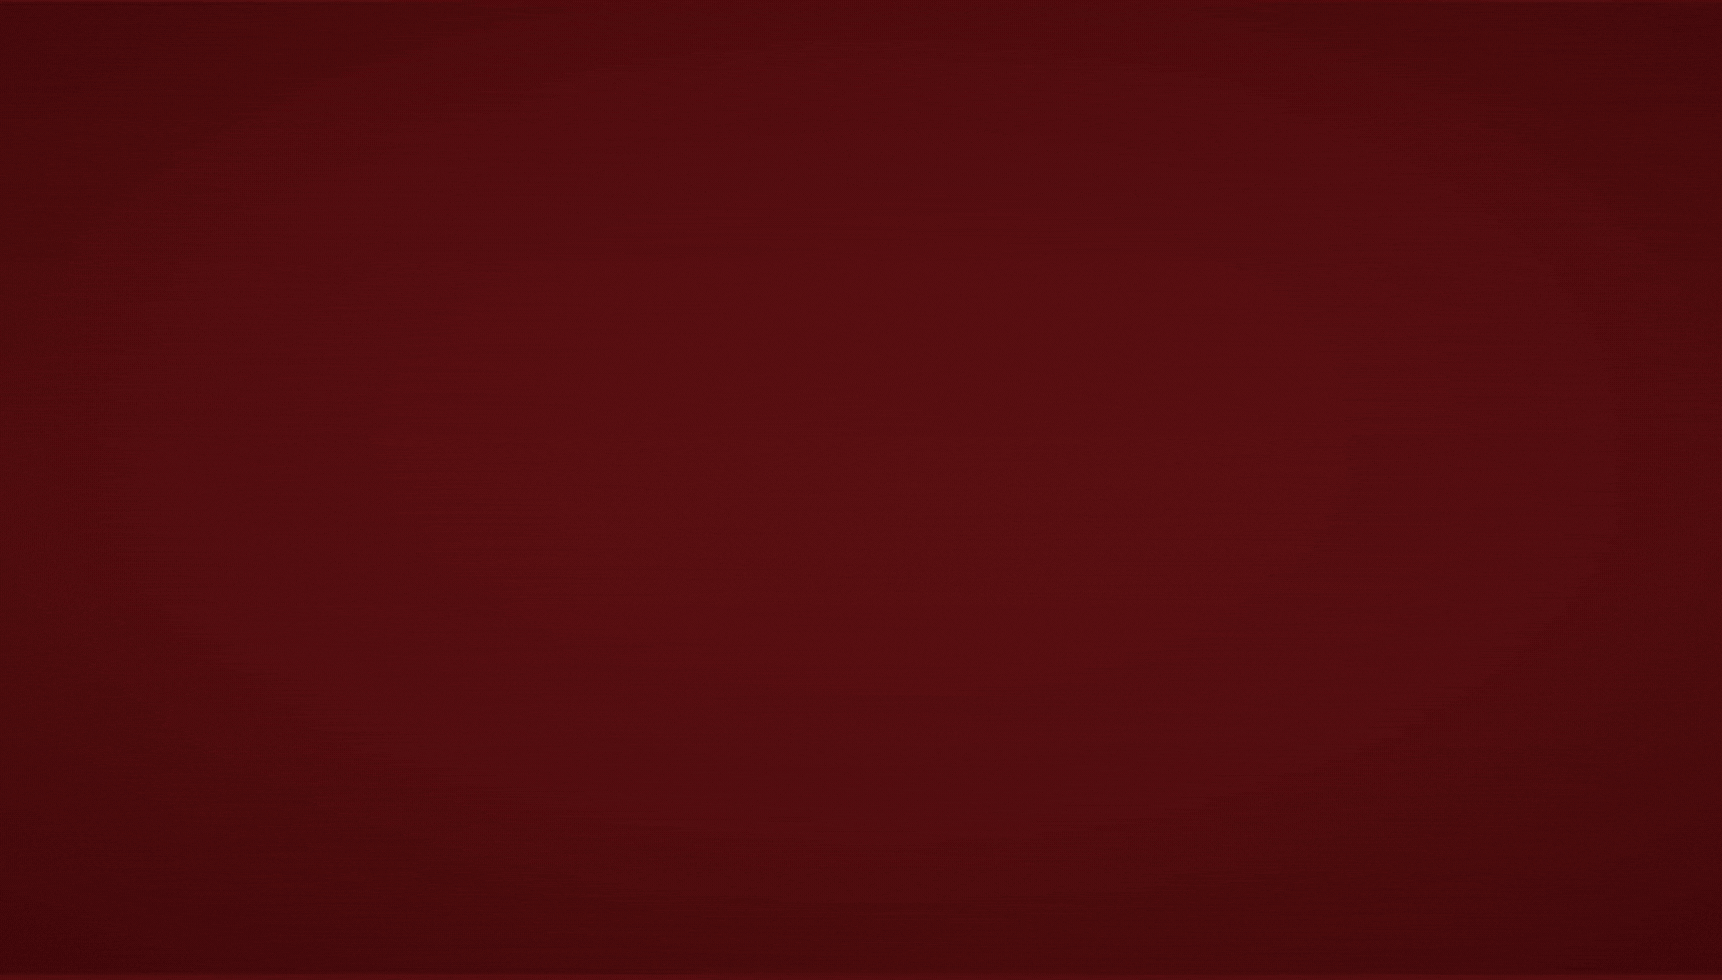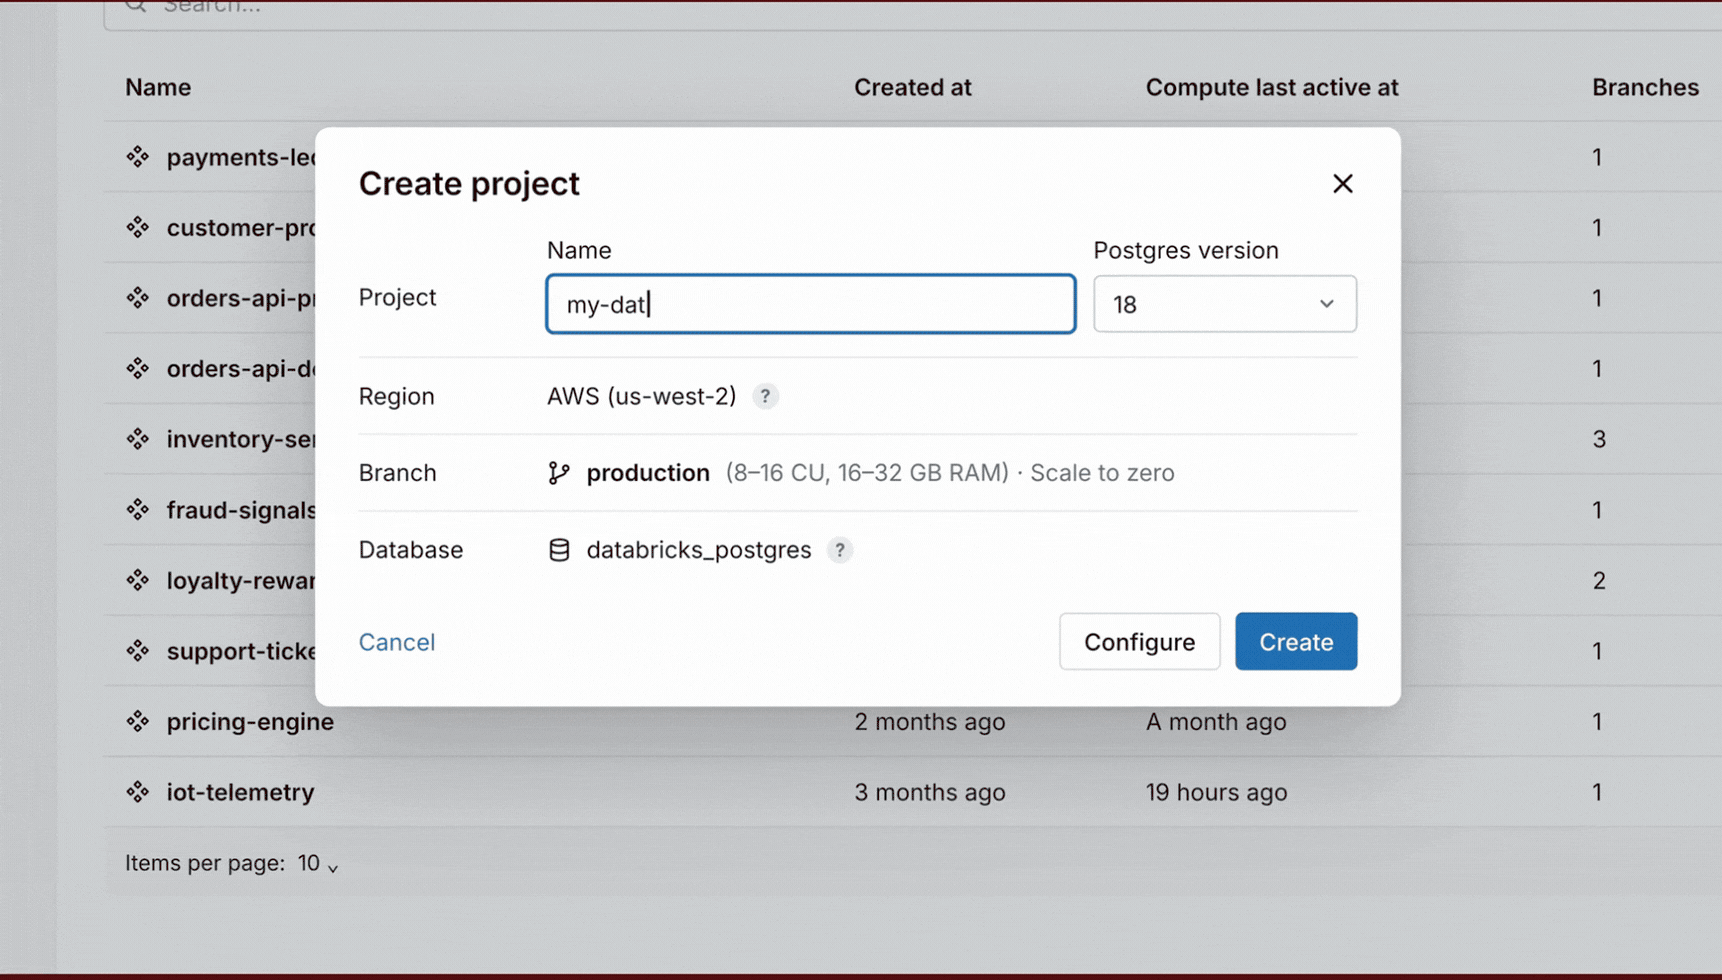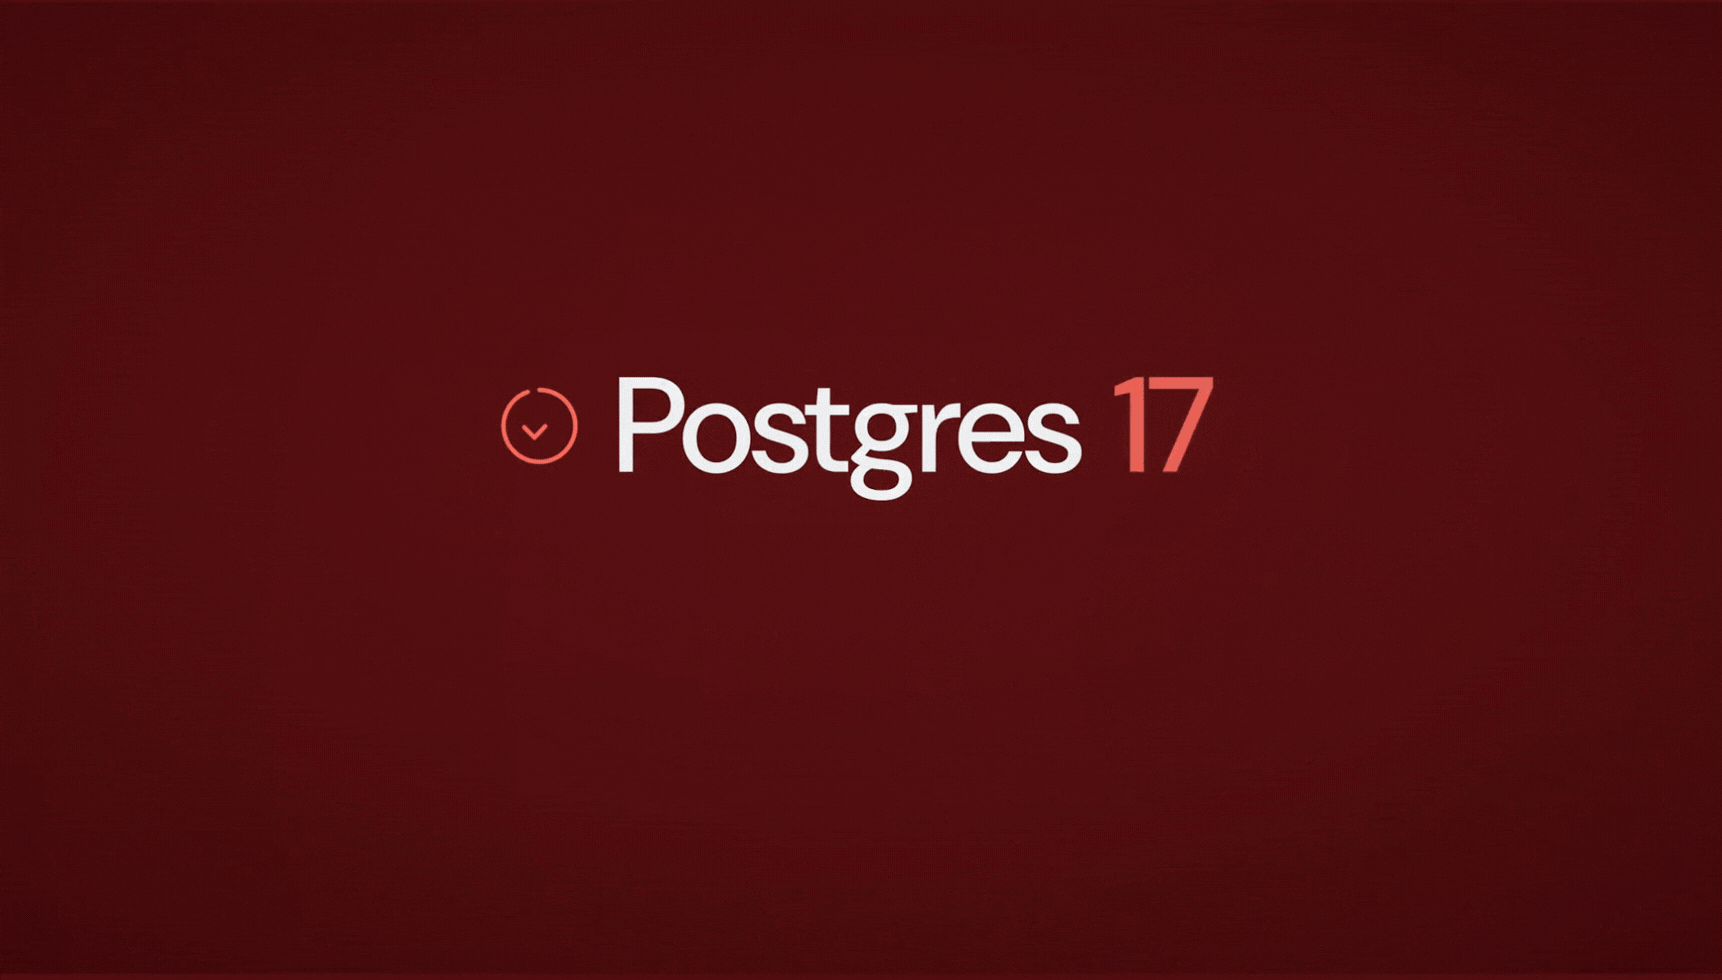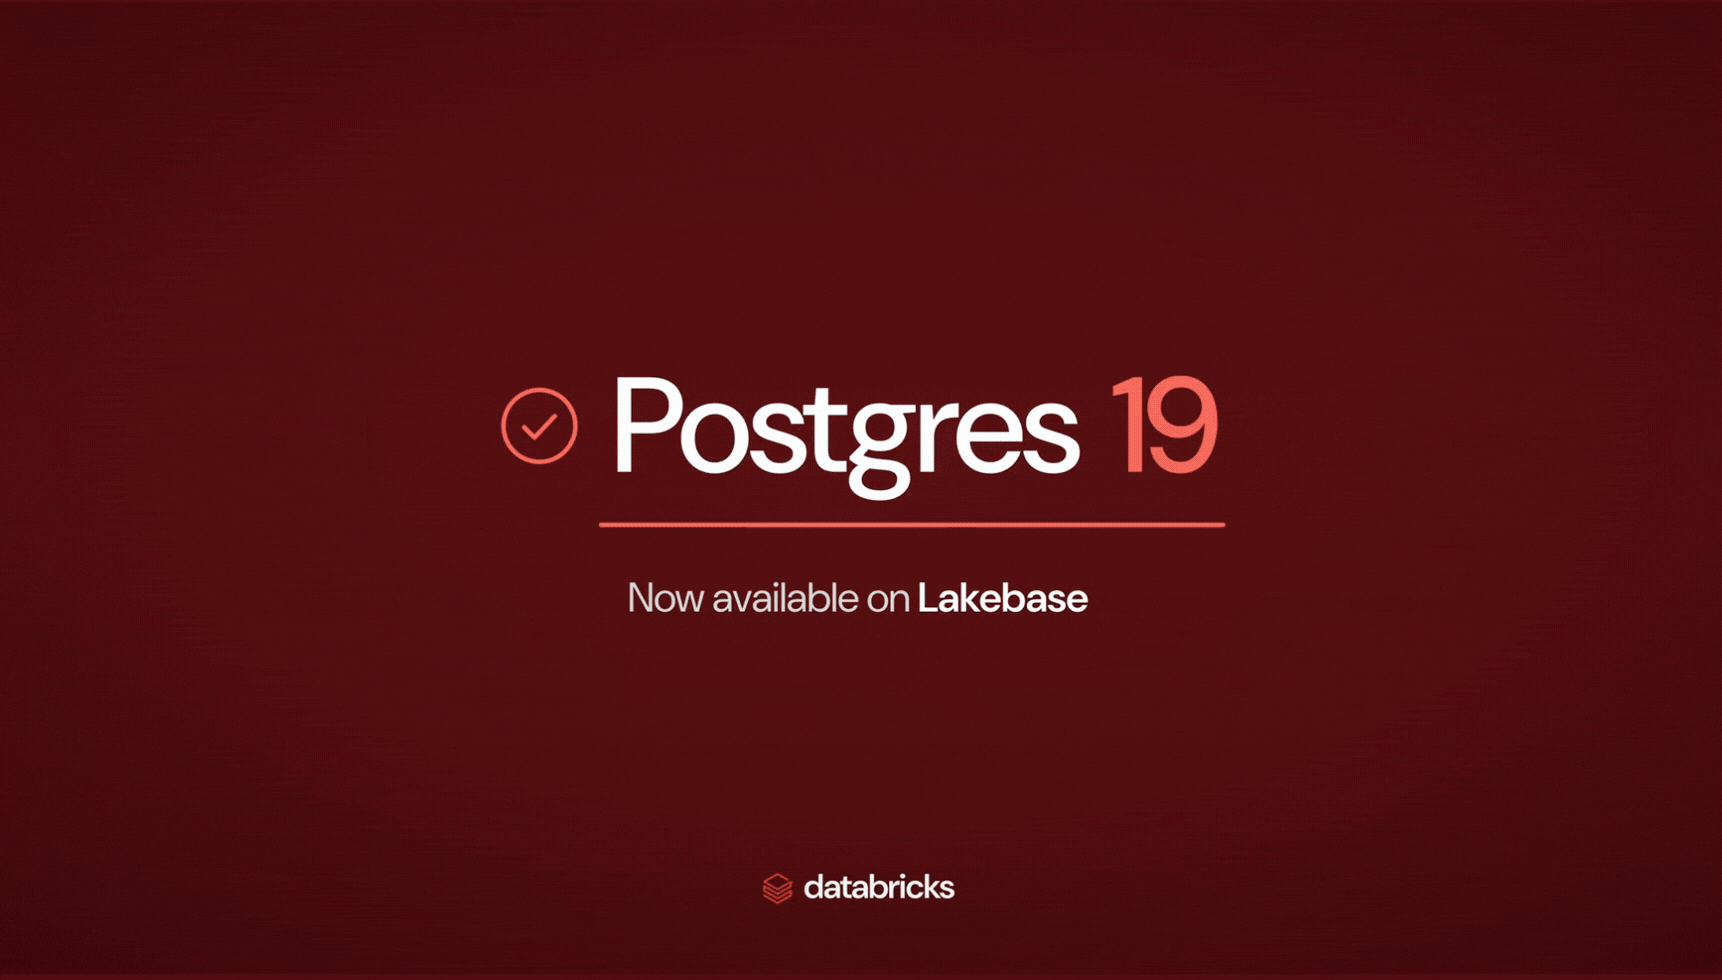
- PostgreSQL 19 est disponible sur Lakebase le jour même de sa sortie par la communauté. Pour l'essayer, créez un nouveau projet Lakebase et sélectionnez PostgreSQL 19.
- Cette version de PostgreSQL met l'accent sur le contrôle opérationnel. REPACK récupère de l'espace pendant que les lectures et écritures continuent, les conseils de plan de requête vous permettent de stabiliser les plans défectueux, et WAIT FOR LSN vous garantit de lire vos propres écritures sur les réplicas. La réplication logique bénéficie également de plusieurs améliorations.
- Plusieurs ingénieurs de Lakebase sont des contributeurs et des « committers » de PostgreSQL qui ont travaillé sur cette version, allant des conseils de plan de requête à la mémoire partagée et à la gestion des versions.
PostgreSQL 19 est arrivé aujourd'hui en version GA et est déjà disponible sur Lakebase. Les nouvelles versions majeures prennent souvent des semaines pour arriver sur d'autres services PostgreSQL gérés. Nous avons préféré donner l'accès à nos clients le jour même.
Plusieurs ingénieurs de l'équipe Lakebase sont des contributeurs et committers PostgreSQL, et ils ont travaillé directement sur cette version, de l'analyse des plans de requête à la mémoire partagée, la gestion des paramètres régionaux et la gestion des versions. Pour l'essayer, créez un nouveau projet Lakebase et sélectionnez PostgreSQL 19 comme version.
Nouveautés de PostgreSQL 19
PostgreSQL 19 est une version pratique. Il n'y a pas de fonctionnalité phare unique qui change la nature de PostgreSQL. À la place, la version 19 s'attaque aux problèmes opérationnels que les équipes de bases de données connaissent bien : les tables fragmentées, les plans de requête instables, le décalage de réplication, les statistiques incomplètes et les tâches de maintenance qu'il est difficile d'exécuter en toute sécurité en production.
Le fil conducteur est le contrôle. PostgreSQL 19 vous offre davantage de moyens d'intervenir lorsque les paramètres par défaut ne suffisent pas, sans renoncer à la fiabilité et au comportement prévisible du projet.
La liste complète des modifications se trouve dans les notes de version de PostgreSQL 19.
REPACK
PostgreSQL utilise le contrôle de concurrence multiversion, de sorte qu'un UPDATE crée une nouvelle version de ligne et un DELETE laisse un tuple mort derrière lui. Un nettoyage régulier permet de réutiliser cet espace, mais cela ne restitue pas nécessairement l'espace au système d'exploitation et ne restaure pas un ordre physique des lignes utile. Avec le temps, les tables lourdement mises à jour peuvent devenir fragmentées et mal regroupées.
Les correctifs habituels ont été VACUUM FULL, CLUSTER, ou des outils externes tels que pg_repack. Les commandes intégrées fonctionnent, mais elles prennent un verrou ACCESS EXCLUSIVE pour toute l'opération, bloquant l'accès normal à la table.
PostgreSQL 19 ajoute REPACK, qui récupère de l'espace pendant que les lectures et écritures normales se poursuivent pendant la majeure partie de l'opération. Par exemple, une application de chat peut reconstruire sa table messages tout en regroupant les lignes par conversation et heure d'envoi à l'aide d'un index existant :
REPACK récupère de l'espace comme VACUUM FULL ; avec USING INDEX, il ordonne également physiquement les lignes comme CLUSTER. Avec CONCURRENTLY, PostgreSQL reconstruit la table pendant que les lectures et écritures normales se poursuivent, en capturant les modifications en cours grâce au décodage logique. Il prend ensuite un verrou ACCESS EXCLUSIVE pour appliquer les modifications capturées restantes et remplacer les fichiers de la nouvelle table et des index. Cette phase est généralement brève, mais peut prendre plus de temps sur une table très sollicitée.
Il existe des contraintes opérationnelles. Le réempaquetage concurrent crée un emplacement de réplication supplémentaire pour la durée de l'opération, il nécessite donc une capacité libre sous max_repack_replication_slots et une table dotée soit d'une clé primaire non différable, soit d'une identité de réplica basée sur un index adaptée. Il nécessite également un espace disque temporaire pour une copie de la table et de tous ses index, potentiellement plus un fichier de tri pouvant atteindre la taille de la table. Les tables subissant un trafic important de mises à jour et de suppressions font face à une limite supplémentaire : l'implémentation actuelle en amont de PostgreSQL 19 échoue si plus de 104 millions de tuples environ dans la table cible sont mis à jour ou supprimés pendant l'exécution de REPACK (CONCURRENTLY). Cela compte les modifications apportées pendant le réempaquetage, et non les lignes déjà présentes dans la table.
Tous les types de relations ne sont pas éligibles. Les transactions de longue durée peuvent retarder le verrou final. Le réempaquetage concurrent n'est pas non plus sûr pour le MVCC : après sa validation, les transactions utilisant des instantanés pris avant le début du réempaquetage peuvent voir la table comme vide. Le regroupement physique se dégrade également à mesure que les écritures ultérieures arrivent.
REPACK CONCURRENTLY nécessite toujours de la planification, mais il intègre au noyau une tâche qui nécessitait auparavant plus de temps d'arrêt ou une extension.
Conseils sur les plans de requête
L'optimiseur basé sur les coûts de PostgreSQL utilise les statistiques de table et les estimations de coûts pour choisir un plan d'exécution. La plupart du temps, cela fonctionne bien.
Les statistiques décrivent bien les tables individuelles, mais les jeux de données réels contiennent souvent des relations plus difficiles à capturer. Imaginez que les clients entreprises représentent 0,1 % des clients mais génèrent 30 % des commandes. Les statistiques par table ne peuvent pas capturer cette corrélation inter-table.
Avec un index sur orders.customer_id, le planificateur peut estimer que chaque client entreprise n'a que peu de commandes et choisir une boucle imbriquée qui sonde l'index à plusieurs reprises. Si ces clients représentent en réalité 30 % des commandes, chaque recherche renvoie beaucoup plus de lignes que prévu, et une jointure par hachage peut être plus appropriée.
PostgreSQL 19 ajoute pg_plan_advice et pg_stash_advice pour ces situations :
pg_plan_advicedécrit les décisions du planificateur sous forme de conseils, applique les conseils fournis et indique s'ils ont été suivis.pg_stash_advicestocke les conseils par ID de requête et les applique automatiquement lorsqu'une requête correspondante est planifiée.
Ces composants n'ajoutent pas de statistiques inter-tables et ne remplacent pas le planificateur. Au lieu de cela, ils vous permettent d'intervenir lorsqu'une estimation imprécise produit un mauvais plan.
Considérons une requête qui compte les commandes des clients entreprises :
Ici, c est l'alias de la table des clients filtrés. Le conseil suivant demande à PostgreSQL de placer ces clients du côté interne d'une jointure par hachage :
Lorsque PostgreSQL peut appliquer le conseil, EXPLAIN renvoie un retour similaire à :
matched signifie que le plan résultant est conforme au conseil. Cela ne signifie pas que le nouveau plan est nécessairement meilleur ; vous devez toujours l'évaluer par rapport à votre charge de travail réelle.
Contrairement aux indications de l'optimiseur en ligne, les conseils de plan vivent en dehors du texte de la requête de l'application. Vous pouvez inspecter le plan actuel, tester des conseils ciblés, puis les stocker par ID de requête.
pg_stash_advice est le composant qui applique automatiquement les conseils stockés. Créez l'extension dans chaque base de données avant d'utiliser ses fonctions de gestion du stockage :
Créez un stockage et associez le conseil testé à l'ID de requête renvoyé par EXPLAIN (VERBOSE). Remplacez <query_id> par l'identifiant de votre plan :
Configurez la base de données pour utiliser le stockage pour les nouvelles connexions :
Remplacez appdb par le nom de votre base de données.
Traitez les conseils de plan comme un moyen de stabilisation une fois que vous avez diagnostiqué le problème. Les distributions de données changent, les instructions préparées mises en cache peuvent continuer à utiliser un ancien plan pendant un certain temps, et l'optimiseur a encore raison plus souvent qu'il n'a tort.
Lorsque l'optimiseur bascule de manière inattendue une requête critique vers un plan moins performant, PostgreSQL 19 vous offre une méthode prise en charge pour stabiliser le tout.
Autovacuum parallèle et nouvelles vues de statistiques
L'autovacuum peut désormais utiliser des processus parallèles lors du nettoyage des index, contrôlé par autovacuum_max_parallel_workers. Un nouveau système de notation priorise les tables éligibles selon l'urgence de leur nettoyage ou de leur analyse.
De nouvelles vues de statistiques révèlent plus d'informations sur l'activité du serveur :
pg_stat_lockrapporte les statistiques par type de verrou.pg_stat_recoveryaffiche l'état de la récupération.pg_stat_autovacuum_scoresmontre comment l'autovacuum priorise les tables.
Les diagnostics au niveau des requêtes s'améliorent également. EXPLAIN (ANALYZE, IO) rapporte l'activité d'E/S asynchrones, et auto_explain.log_io peut inclure ces mêmes informations dans les plans enregistrés.
PostgreSQL 19 rapporte également les octets écrits pour les images de pages complètes dans pg_stat_wal, EXPLAIN (ANALYZE, WAL), ainsi que dans les journaux de nettoyage et d'analyse.
Ensemble, ces éléments rendent l'analyse des performances moins dépendante des suppositions. Vous pouvez voir pourquoi le travail de maintenance a été priorisé, où les E/S asynchrones se sont produites et combien d'octets WAL proviennent des images de pages complètes.
Réplication logique
La réplication logique est devenue une infrastructure essentielle pour la capture de données modifiées, les migrations, la diffusion en temps réel et les pipelines ETL. PostgreSQL 19 comble plusieurs lacunes de longue date :
- Le décodage logique peut être activé sans redémarrage lorsque
wal_levelestreplica. La création du premier emplacement de réplication logique valide élèveeffective_wal_levelàlogical, affichant le niveau WAL actuellement actif. - Les valeurs de séquence peuvent être synchronisées des éditeurs vers les abonnés.
- Les publications peuvent inclure toutes les séquences avec
FOR ALL SEQUENCES. CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...)publie toutes les tables à l'exception d'un ensemble nommé.- Les abonnements peuvent réutiliser les détails de connexion d'un serveur
postgres_fdwavecCREATE SUBSCRIPTION ... SERVER. - L'option d'abonnement
retain_dead_tuplesconserve suffisamment d'informations pourdetect update_deletedles conflits, lorsqu'une mise à jour répliquée cible une ligne supprimée par une autre origine. La détection nécessite égalementtrack_commit_timestampsur l'abonné, etpg_stat_subscription_statscompte ces conflits.
La synchronisation des séquences élimine un cas particulier de migration délicat, en particulier lors des mises à niveau de version majeure utilisant la réplication logique. Copier les lignes de table sans avancer leurs séquences peut amener un abonné promu à générer des valeurs qui existent déjà, provoquant des erreurs de clé en double.
PostgreSQL copie les valeurs de séquence initiales lorsque l'abonnement est créé avec copy_data = true, qui est la valeur par défaut. Les modifications de séquence ultérieures ne sont pas diffusées en continu, pensez donc à les actualiser juste avant le basculement :
Cela met à jour les séquences déjà connues de l'abonnement à leurs valeurs actuelles sur l'éditeur. Si la publication a gagné de nouvelles séquences, utilisez ALTER SUBSCRIPTION ... REFRESH PUBLICATION pour les ajouter et synchroniser leurs valeurs avant le basculement.
WAIT FOR LSN
Les réplicas de lecture asynchrones augmentent la capacité de lecture sans obliger les validations principales à attendre. Le compromis est le décalage de réplication. Une application peut valider une écriture sur le principal, lire immédiatement depuis un réplica et ne pas trouver la ligne car le réplica n'a pas encore rejoué le WAL correspondant.
PostgreSQL 19 ajoute un moyen direct de coordonner ce transfert. Un LSN identifie une position dans le WAL de PostgreSQL, et WAIT FOR LSN bloque le serveur de secours jusqu'à ce que la relecture atteigne au moins la position demandée :
Par défaut, WAIT FOR LSN attend indéfiniment que le serveur de secours rejoue le LSN demandé. D'autres modes permettent d'attendre que le WAL soit écrit ou vidé, et vous pouvez définir un délai d'attente.
Le client ou le répartiteur de connexions doit toujours acheminer le LSN du principal vers le réplica. La base de données fournit désormais l'étape de synchronisation manquante, de sorte que le comportement de lecture après écriture ne nécessite plus de scrutation ni de pauses arbitraires.
ON CONFLICT DO SELECT
INSERT ... ON CONFLICT DO SELECT vous offre un modèle propre de récupération ou de création qui renvoie à la fois les lignes existantes et les lignes nouvellement insérées :
Il remplace l'alternative DO UPDATE SET col = EXCLUDED.col, qui effectue une mise à jour même si aucune valeur ne change. Cela crée une nouvelle version de ligne et laisse un tuple mort à chaque conflit.
Sortie JSON pour COPY TO
COPY TO peut désormais émettre du JSON directement. Par défaut, il écrit un objet par ligne, tandis que FORCE_ARRAY enveloppe la sortie dans un seul tableau JSON :
Le nouveau format JSON est réservé à l'exportation, donc COPY FROM ne l'accepte pas.
SQL allégé et modifications de performance
Enfin, quelques modifications compactes pour un meilleur confort d'utilisation :
- Les expressions de chemin JSON s'enrichissent de méthodes de chaîne familières telles que
btrim(),lower(),replace()etsplit_part(). - La famille
random(min, max)prend désormais en chargedate,timestampettimestamptz, ce qui aide pour les tests et les jeux de données synthétiques. - Cinq fonctions de fenêtrage acceptent
IGNORE NULLSetRESPECT NULLS. - Lorsque
io_method = worker, les processus d'E/S s'ajustent automatiquement entreio_min_workersetio_max_workers. Les vérifications de clés étrangères sont plus rapides, et l'optimiseur ainsi que l'exécuteur bénéficient d'une nouvelle série d'optimisations ciblées.
Nous avons également retiré quelques fonctionnalités
Plusieurs fonctionnalités majeures ont été intégrées lors du développement de PostgreSQL 19, mais ont été supprimées avant la version finale. Les relecteurs ont détecté des problèmes d'exactitude ou de conception trop risqués à résoudre tard dans le cycle, de sorte que la communauté a reporté ces fonctionnalités pour une version ultérieure.
Parmi les fonctionnalités qui ne seront finalement pas livrées dans la version 19 :
SQL/PGQrequêtes sur les graphes de propriétés.CREATE PROPERTY GRAPHetGRAPH_TABLEont intégré la mise en correspondance de motifs de graphes sur des tables régulières dans SQL. Annulé le 7 septembre 2026.UPDATE and DELETE ... FOR PORTION OF.Mises à jour temporelles et suppressions qui divisent les lignes pour préserver l'historique en dehors de la plage temporelle ciblée. Annulé le 15 septembre 2026.ALTER TABLE ... MERGE PARTITIONSetSPLIT PARTITION. Commandes intégrées pour combiner ou diviser des partitions. Annulé le 27 août 2026.GROUP BY ALL. Raccourci pour regrouper par chaque expression non agrégée de la liste de sélection. Annulé le 17 juillet 2026.- Formats de sortie non textuels pour
pg_dumpall. Annulé le 18 juin 2026. - Fonctions d'extraction DDL.
pg_get_role_ddl(),pg_get_tablespace_ddl()etpg_get_database_ddl()ont été Annulés le 13 septembre 2026.
Merci aux contributeurs de PostgreSQL
PostgreSQL est créé par ses contributeurs : merci aux centaines de contributeurs de la communauté mentionnés dans les notes de version. Un remerciement particulier aux ingénieurs de l'équipe Lakebase qui ont travaillé sur cette version de PostgreSQL :
- Robert Haas a écrit pg_plan_advice et pg_stash_advice (ce dernier avec Lukas Fittl)
- Heikki Linnakangas a travaillé sur un nouveau mécanisme d'enregistrement de mémoire partagée, une refonte de la manière dont les sous-systèmes l'allouent, des corrections multixact et la nouvelle valeur par défaut de 128 pour max_locks_per_transaction
- Jeff Davis a écrit la modification qui permet à CREATE SUBSCRIPTION de réutiliser les détails de connexion d'un serveur postgres_fdw, et a effectué un travail de longue haleine sur les paramètres régionaux et la gestion des caractères
- Jonathan Katz a travaillé sur le communiqué de presse de PostgreSQL 19 et a assuré le suivi de la version
- Matthias van de Meent a travaillé sur plusieurs validations (commits), notamment la modification des routines de méthodes d'accès aux index statiques
- Alexander Lakhin a trouvé et signalé plusieurs bugs
Mise à niveau vers PostgreSQL 19
Comme pour toute nouvelle version majeure de PostgreSQL, nous recommandons une approche mesurée pour son adoption. Avant de migrer les charges de travail de production vers la version 19.0, nous vous suggérons de :
- Tester d'abord vos propres charges de travail, requêtes et extensions sur PostgreSQL 19 dans un environnement de développement ou de staging
- Comparer les performances et le comportement par rapport à votre version actuelle, car les versions majeures peuvent modifier les plans de requête et les valeurs par défaut
- Vérifier que les extensions dont vous dépendez sont disponibles sur PostgreSQL 19 (voir ci-dessous).
- Maintenir la production sur votre version actuelle jusqu'à ce que vous soyez satisfait des résultats
PostgreSQL 19 modifie également plusieurs valeurs par défaut et comportements de compatibilité. Vérifiez ces points avant de procéder à la mise à niveau :
- La compilation JIT est désactivée par défaut
- La compression TOAST utilise LZ4 par défaut au lieu de pglz
- L'authentification par mot de passe MD5 émet des avertissements de dépréciation plus stricts
- La prise en charge de l'authentification RADIUS est supprimée
- standard_conforming_strings est toujours activé
- pg_upgrade rejette les clusters comportant des index btree_gist affectés sur inet ou cidr
- Les noms de bases de données, de rôles et de tablespaces ne peuvent plus contenir de retours chariot ou de sauts de ligne
Remarque sur les extensions
Nous avons couvert la plupart des extensions prises en charge dans notre version PostgreSQL 18, mais certaines ne sont pas encore disponibles sur PostgreSQL 19. Nous en ajoutons d'autres au fur et à mesure de leur mise à disposition par les fournisseurs d'extensions. Si votre charge de travail dépend d'une extension spécifique, confirmez qu'elle est disponible sur PostgreSQL 19 avant de planifier une migration.
La communauté publie généralement sa première version mineure quelques mois après une version majeure, à mesure que l'utilisation réelle met en évidence des correctifs et des améliorations. PostgreSQL 19.1 est attendu en février, et de nombreuses équipes planifient leurs mises à niveau de production autour de cette version. C'est un schéma courant et judicieux pour toute version .0, et cela s'applique tout autant ici.
Quel que soit votre calendrier, nous sommes là pour vous aider. Si vous souhaitez discuter de la planification de la mise à niveau ou des tests, contactez votre équipe de compte ou le support Databricks.
Essayez-le
PostgreSQL 19 est disponible dès aujourd'hui sur Lakebase. Créez un projet PostgreSQL 19 dans votre espace de travail pour l'essayer, ou découvrez Lakebase si vous débutez.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.