CDC basé sur le push dans Unity Catalog avec Zerobus Ingest et Debezium
Envoyez des événements de modification du serveur open-source Debezium directement vers les tables Delta, sans aucun broker à gérer
par Victoria Bukta, Omkar Mehta et Wagner Santos
- Debezium Server et Databricks Zerobus Ingest s'associent pour diffuser en continu des événements CDC directement dans les tables Delta de Unity Catalog grâce à une architecture basée sur le push.
- Les réseaux privés sécurisés qui bloquent les connexions entrantes peuvent désormais répliquer les données vers l'extérieur en toute sécurité, éliminant ainsi le besoin de brokers de messages Kafka intermédiaires ou de connecteurs basés sur le pull.
- Les organisations peuvent envoyer les modifications de bases de données brutes vers le lakehouse, ce qui simplifie considérablement l'infrastructure nécessaire pour créer des tables à jour pour les analyses en aval.
Les données des bases de données opérationnelles orientent les décisions commerciales, et une grande partie de cette analyse s'effectue dans le lakehouse. Transférer ces données s'avère complexe lorsque la base de données réside dans un réseau d'entreprise privé, un environnement contrôlé par le client ou un sous-réseau restreint dont les politiques bloquent les connexions entrantes provenant de services externes.
De nombreuses équipes ont besoin de leurs modifications PostgreSQL dans Databricks, mais l'équipe qui gère la base de données souhaite également contrôler la capture. Cette équipe exécute le processus qui lit le journal des transactions (write-ahead log) et détermine quelles connexions quittent son réseau. De l'autre côté, les modifications atterrissent dans des tables Delta gouvernées que les pipelines et les analystes peuvent exploiter.
Debezium est un outil open source courant dont les équipes peuvent assurer le déploiement complet pour extraire un flux de capture de données modificatives (change data capture) d'une base de données. Installé à proximité de la base de données, il lit son journal des transactions et pousse les événements vers l'extérieur. Zerobus Ingest constitue la destination, une interface de type push qui écrit les enregistrements directement dans les tables Delta de Unity Catalog. Le connecteur open source Debezium Server Zerobus relie les deux sans nécessiter de cluster Kafka traditionnel entre la capture et le lakehouse.
Des ingénieurs de NVIDIA et de Databricks ont uni leurs forces pour concevoir ce connecteur et l'ont intégré au projet Debezium open source. Databricks a développé le connecteur typé Zerobus Ingest. Ensuite, NVIDIA a apporté le mode enveloppe (envelope mode), qui intègre l'événement de modification Debezium complet ainsi que les garanties de livraison associées, telles que les clés d'idempotence et l'accusé de réception persistant avant l'avancement des décalages source. Le connecteur Zerobus Ingest est inclus dans la version 3.7 de Debezium Server.
Cet article présente les rôles respectifs de Debezium et de Zerobus, l'enveloppe de modification brute apportée par NVIDIA au connecteur, ainsi que la manière dont les événements reçus se transforment en tables d'état actuel ou historiques. Pour un guide pratique, incluant une exécution en direct depuis une table PostgreSQL locale vers une table d'état actuel, consultez le blog tutoriel associé sur la communauté Databricks.
Le défi
La réplication fiable des modifications d'une base de données opérationnelle vers le lakehouse implique de résoudre simultanément plusieurs problèmes :
- Capturer de manière fiable les insertions, les mises à jour et les suppressions. Une ligne créée, modifiée puis supprimée doit générer un flux fidèle pour chaque événement. Cela inclut les suppressions, que les approches de type « copier la table » par requêtes manquent régulièrement.
- Conserver les éléments nécessaires au tri. La logique en aval qui reconstitue l'état actuel doit appliquer les modifications dans l'ordre de la source pour répliquer correctement la table d'origine.
- Éviter de surcharger la base de données source. L'interrogation planifiée de la base de données (
SELECT ... WHERE updated_at > ?) génère une charge de requêtes et ne passe pas bien à l'échelle. - Fonctionner avec des réseaux privés ou contrôlés par le client. Lorsqu'une base de données se trouve derrière un périmètre hautement sécurisé, il peut s'avérer difficile de s'y connecter et d'ingérer les données.
- Éviter d'installer Kafka uniquement comme système de transport. Kafka est un bus d'événements puissant, mais exploiter un cluster uniquement pour acheminer des événements CDC d'une base de données vers un lakehouse représente une charge opérationnelle importante pour les équipes qui n'en ont pas l'utilité par ailleurs.
- Déposer les données de manière à faciliter leur traitement. Le flux de modifications doit arriver dans un format que le lakehouse peut traiter et interroger, et non dans un silo nécessitant une étape d'exportation supplémentaire.
Ces exigences posées, nous devons nous intéresser à l'architecture régissant le flux des données de la source vers la destination.
Architecture cible globale
Dans ce blog, nous explorerons une architecture de bus de messages traditionnelle par rapport à une architecture utilisant Zerobus Ingest.
Architecture avec un bus de messages :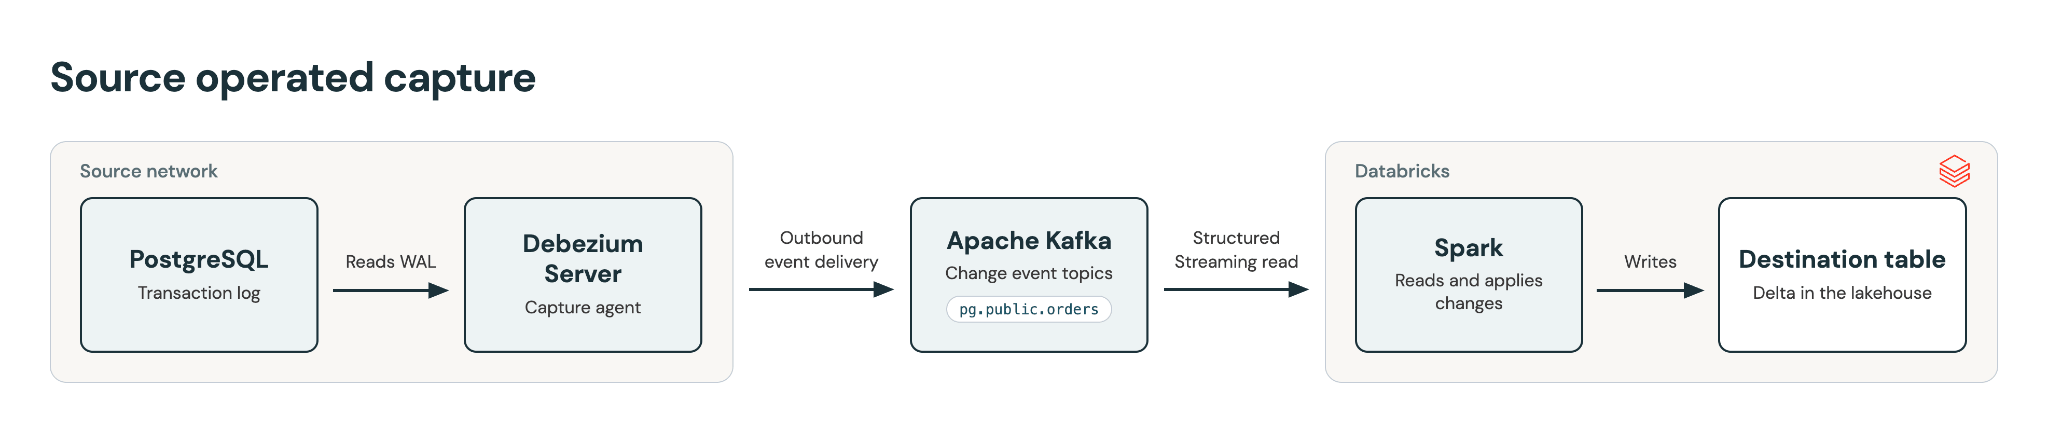
Dans de nombreux environnements d'entreprise, la connectivité sortante depuis l'intérieur d'un périmètre est beaucoup plus facile à autoriser que l'accès entrant. Lorsque votre équipe souhaite déployer l'agent d'extraction du flux de modifications, un modèle de type push local permet aux données de circuler vers l'extérieur. Dans une configuration classique, il s'agirait d'un bus de messages tel que Kafka. L'utilisation de Kafka nécessite des ressources de planification de capacité pour anticiper le nombre de courtiers (brokers) nécessaires pour absorber la charge de pointe en cas de mise à l'échelle physique, et pour estimer le nombre de partitions pour la mise à l'échelle logique, que les consommateurs doivent suivre au rythme de la production. Cela requiert une équipe dédiée expérimentée dans le déploiement et la gestion de Kafka.
Une fois les données arrivées dans Kafka, une autre tâche vous attend : répliquer ces événements dans le lakehouse. Cela peut se faire via le déploiement de tâches d'ingestion telles que Spark, Kafka Connector ou d'autres outils. Il en résulte une architecture à deux sauts entre Debezium et le lakehouse.
Architecture avec Zerobus Ingest :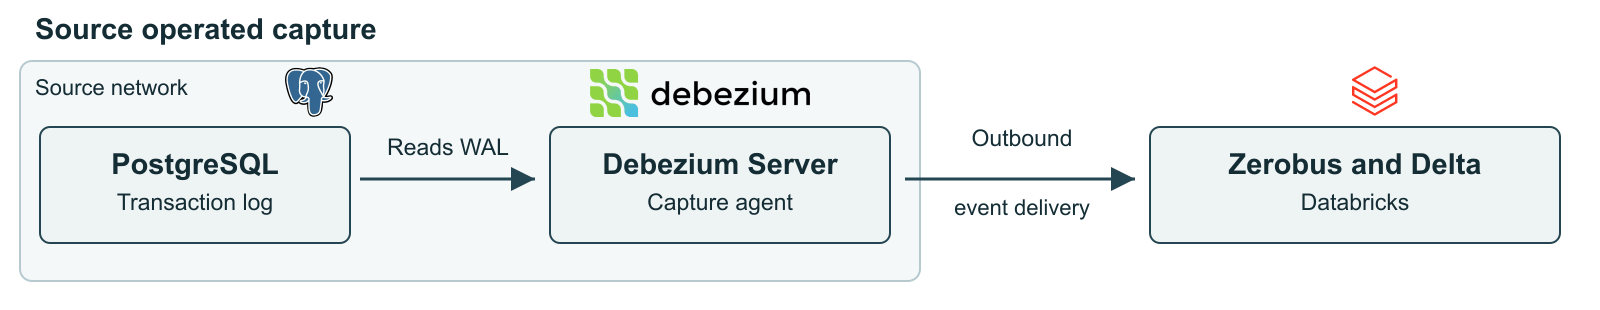
Lorsque votre unique destination est le lakehouse, Zerobus vous permet de contourner les sauts intermédiaires comme le bus de messages. Cela simplifie votre architecture de bout en bout et supprime le besoin de déployer et de gérer une infrastructure Kafka pour le transit des données. Utilisé comme connecteur de destination avec Debezium, Zerobus continue de fonctionner sans réglage particulier pendant vos heures de pointe.
Qu'est-ce que Debezium ?
Debezium est une plateforme open source de capture de données modificatives basée sur les journaux. Plutôt que d'interroger des tables, elle lit le journal de transactions d'une base de données, tel que le journal des transactions (WAL) de PostgreSQL, le journal binaire (binlog) de MySQL ou les flux de modification de MongoDB. Elle émet ensuite chaque modification sous forme d'événement structuré. Lancé en 2015, le projet prend aujourd'hui en charge un vaste écosystème de connecteurs (PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, etc.).
Chaque événement de modification comporte une enveloppe cohérente :
before— l'état de la ligne avant la modification (null pour les insertions)after— l'état de la ligne après la modification (null pour les suppressions)\op— l'opération :c(création/insertion),u(mise à jour),d(suppression),r(lecture/instantané)source— métadonnées : base de données, schéma, table, numéro de séquence du journal WAL (LSN), ID de transaction, indicateur d'instantanéts_ms— horodatage de l'événement
Grâce à l'analyse des journaux (log tailing) plutôt qu'à l'interrogation par scrutation (polling), Debezium exerce une charge minimale sur la base de données principale tout en capturant les modifications à faible latence et en préservant l'ordre des validations.
Mode autonome (Debezium Server) par rapport au déploiement Kafka Connect
Debezium propose deux modes de fonctionnement : l'un s'exécute sur Kafka Connect, tandis que l'autre consiste en un « serveur autonome » (stand-alone server) qui peut être installé sur une infrastructure de calcul standard.
Debezium Server, le runtime autonome, fait office d'agent côté source qui lit les journaux de transactions et envoie les événements de modification directement à Zerobus Ingest de Databricks, sans qu'un cluster Kafka ne serve de transport.
La solution : Debezium + Zerobus Ingest
Nous avons donc identifié Debezium comme notre lecteur de journaux. Il s'agit maintenant d'acheminer les événements vers Databricks.
Zerobus Ingest est un service d'ingestion serverless basé sur le push qui écrit les données directement dans les tables Delta régies par Unity Catalog, sans nécessiter de gestionnaire de messages. Les producteurs se connectent à un point de terminaison Zerobus et diffusent des enregistrements qui atterrissent dans une table Delta au format ouvert. Il est conçu pour gérer des charges de travail à haut débit et fortement concurrentes. En évitant l'étape du gestionnaire de messages, nous simplifions l'architecture ainsi que la maintenance liée au dimensionnement et à l'exécution des pipelines d'ingestion pour transférer les données vers le lakehouse.
Combinés avec Debezium, vos pipelines CDC ressembleront à ceci :
- Debezium observe le journal de la base de données et convertit chaque modification en événement CDC.
- Zerobus Ingest transporte ces événements directement dans Databricks et les écrit dans une table Delta — sans cluster Kafka en tant que couche de transport intermédiaire.
- Databricks reçoit le flux de modifications dans une table Delta et peut le traiter pour alimenter des tables organisées en aval.
Zerobus Ingest fonctionne uniquement en ajout (append-only). Une fois les événements de modification enregistrés, l'étape suivante consiste à construire une table dimensionnelle de Type 1 en effectuant une fusion pour obtenir la dernière version de chaque combinaison de clés primaires.
La contribution de NVIDIA : le mode enveloppe (envelope mode)
La destination Zerobus dans Debezium propose deux contrats de table. Le mode Typed (typé), qui est le mode par défaut, associe chaque événement de modification à une table dotée des colonnes propres à la source. Le mode Envelope (enveloppe), auquel NVIDIA a contribué, enregistre l'événement de modification Debezium complet dans une table fixe de neuf colonnes :
- target_table
- destination
- partition
- operation
- idempotency_key
- key
- value
- source_position
- headers
Les enregistrements peuvent être encodés au format JSON (stockés dans les colonnes VARIANT) ou Protobuf.
Le mode enveloppe conserve les informations nécessaires au traitement en aval. source_position contient la partition et l'offset source, y compris le LSN PostgreSQL. idempotency_key correspond à une empreinte SHA-256 de chaque événement, dérivée de sa destination, de sa partition, de sa clé, de son opération et de sa position source, de sorte qu'un événement livré une seconde fois conserve la même clé. La clé identifie les événements ; elle ne sert pas à les trier ni à dédupliquer la table par elle-même.
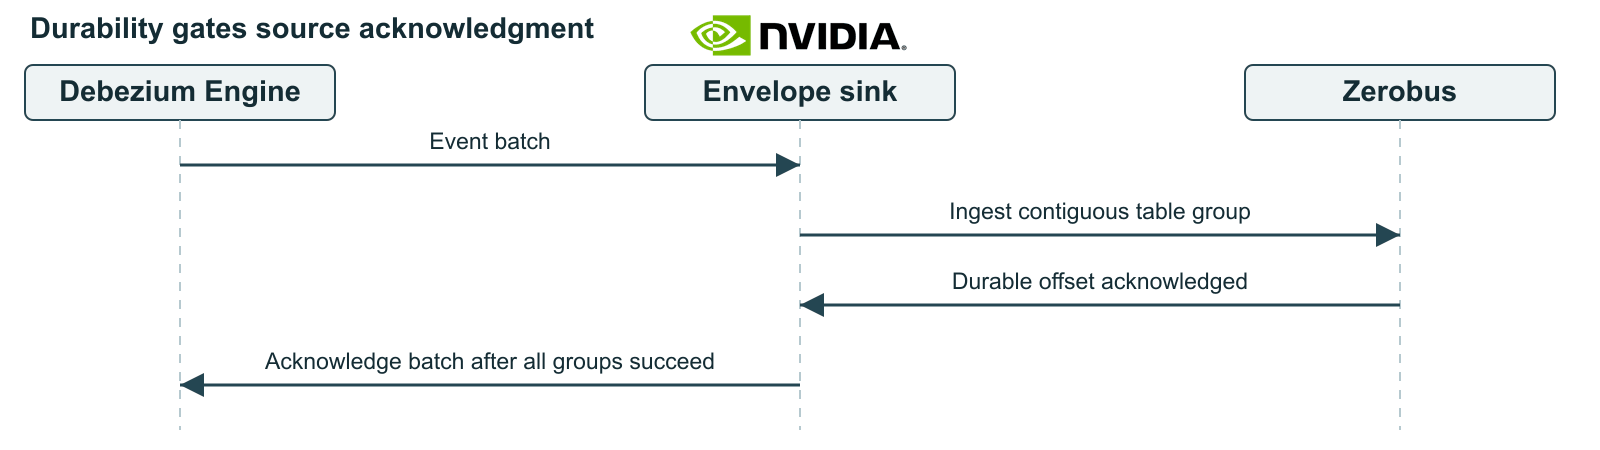
Si un groupe ultérieur échoue, un groupe persistant précédent peut être retransmis. La livraison est donc de type au moins une fois (at-least-once) et les doublons sont traités en aval avec idempotency_key. Le mode enveloppe permet également d'effectuer un filtrage par destination et par opération, et rejette les enregistrements trop volumineux avant l'ingestion afin que leur offset ne soit jamais validé.
Modélisation des données dans Databricks
Une fois que les événements CDC atterrissent dans Delta, un flux classique de type médaillon transforme le flux brut de modifications en données exploitables par les analystes et les applications :
- Bronze : Les événements de modification bruts, tels qu'ils sont reçus. Avec le mode enveloppe, cela correspond à une ligne par événement, contenant son opération, les images de la ligne avant/après, la position source (LSN) et
idempotency_key. - Silver : Enregistrements de modification analysés, dédupliqués par
idempotency_keyet triés par position source. Représentation utilisable des données source, avec les insertions/mises à jour/suppressions interprétées pour reconstituer l'état actuel. - Gold : Les données opérationnelles sont transformées avec les données métier pour les rapports, tels que les finances, les indicateurs de performance, etc.
Il est utile de mentionner brièvement deux façons de structurer le flux de modifications :
- Type-1 (état actuel) : regroupe le journal des modifications pour que chaque clé reflète sa valeur la plus récente, constituant ainsi une réplique de l'état actuel de la table source.
- Type-2 (historique) : conserve chaque version au fil du temps, ce qui vous permet d'interroger les données telles qu'elles apparaissaient à un moment donné.
L'article de blog explicatif associé sur la communauté Databricks présente une mise en œuvre de bout en bout avec une table PostgreSQL locale. Il configure Debezium Server avec le récepteur Zerobus, vérifie une insertion, une mise à jour et une suppression dans la table d'enveloppe, puis crée la table de Type-1 (état actuel) avec AUTO CDC, en séquençant les modifications par le LSN source.
Conclusion
Le choix de la bonne architecture CDC dépend en fin de compte des contraintes réseau de votre organisation, de vos préférences opérationnelles et de votre infrastructure existante.
En combinant Debezium Server avec Zerobus Ingest, vous pouvez déployer une architecture push locale qui diffuse les modifications directement dans les tables Delta sans nécessiter Kafka comme transport de messages intermédiaire ni s'appuyer sur des zones de staging dans le stockage d'objets cloud, ce qui simplifie le parcours d'ingestion de bout en bout.
Cela permet de maintenir la capture PostgreSQL sous le contrôle de l'équipe propriétaire de la base de données tout en chargeant les données dans Unity Catalog.
Pour commencer
Pour créer vous-même ce pipeline, suivez le guide étape par étape sur la communauté Databricks. Il achemine les modifications PostgreSQL via Debezium Server et Zerobus Ingest vers une table Unity Catalog, puis crée une table d'état actuel avec AUTO CDC. Pour la configuration de Zerobus Ingest et de ses autres interfaces d'ingestion, consultez la documentation Zerobus Ingest.
FAQ
Qu'est-ce que le récepteur Debezium Zerobus Ingest ?
Il s'agit d'un récepteur dans Debezium Server, le runtime Debezium autonome, qui envoie les événements de modification directement à Zerobus Ingest. Zerobus Ingest les écrit dans des tables Delta régies par Unity Catalog, de sorte qu'aucun cluster Kafka ne se trouve entre la capture et le lakehouse. NVIDIA et Databricks ont collaboré à cette contribution open source.
Qu'est-ce que le mode enveloppe ?
Le mode enveloppe enregistre chaque événement de modification Debezium complet dans une table fixe de neuf colonnes au lieu de le mapper sur les propres colonnes de la source. NVIDIA a contribué à ce récepteur. Il conserve l'opération, la clé, la valeur, la position source et une clé d'idempotence pour le traitement en aval. Le mode typé est le mode par défaut.
Le récepteur livre-t-il chaque modification exactement une fois ?
Non, la livraison s'effectue au moins une fois. Si un groupe d'enregistrements ultérieur échoue, un groupe durable antérieur peut être livré à nouveau. Chaque événement comporte un idempotency_key, ce qui vous permet de dédupliquer sur cette base en aval.
Comment transformer le flux de modifications en une table d'état actuel ?
Utilisez AUTO CDC pour créer une table de type 1 qui conserve la dernière version de chaque clé. Ordonnez les modifications par le LSN source pour qu'elles s'appliquent dans l'ordre source. Pour conserver chaque version au fil du temps à la place, créez une table de type 2.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.