RADAR : Détectez les pannes grises grâce à la détection d'anomalies
Comment la détection d'anomalies en temps réel repère les pannes partielles et silencieuses en quelques minutes — et comment concevoir le même système sur Databricks.
- Les défaillances grises échappent aux tableaux de bord au vert, vous coûtant discrètement des clients et du chiffre d'affaires avant que quiconque ne s'en aperçoive.
- RADAR est un modèle en quatre étapes, agnostique aux métriques — métriques de fiabilité, détection d'anomalies, alertes et analyse des causes racines — que Databricks applique à lui-même pour détecter ces défaillances en quelques minutes, avec une précision de plus de 90 % et une découverte 95 % plus rapide.
- Vous pouvez concevoir le même système sur Databricks pour n'importe quelle métrique — facturation, conversion ou performance de modèle — à l'aide de composants natifs et d'une structure d'agent AI.
Certaines des pannes les plus dommageables sont celles que votre système de surveillance ne signale jamais : une partie de vos clients subit un échec en silence alors que tous les contrôles de santé affichent un état normal. Ces « pannes grises » entraînent une perte d'utilisateurs et de revenus pendant des heures avant que quiconque ne fasse le lien. Cet article explique comment les détecter rapidement grâce à la détection d'anomalies — comment nous procédons chez Databricks avec un système appelé RADAR, et comment vous pouvez mettre en place la même solution pour la métrique qui compte le plus pour votre entreprise. Il s'adresse aux responsables de la fiabilité des services : SRE, ingénieurs plateforme et données, intervenants d'astreinte et responsables techniques auxquels ils rapportent.
Quand tout est au vert mais que rien ne va
Imaginez un mercredi ordinaire. Votre travail consiste à assurer la fiabilité d'un service client, et tous les tableaux de bord sur votre mur sont au vert : CPU correct, latence normale, serveurs opérationnels, base de données connectée. Selon tous les signaux surveillés par votre équipe, le système semble parfait.
Ce n'est pas le cas.
- 9 h 30 — Un déploiement de routine introduit un bug subtil dans votre parcours d'achat.
- 9 h 35 — Un client sur vingt payant par carte bancaire subit un échec silencieux. Après quelques tentatives, il abandonne et s'en va.
- 12 h 40 — Le premier ticket d'assistance arrive. Il ressemble à une simple erreur de saisie de numéro de carte, donc personne ne s'en inquiète.
- 14 h 20 — Deux autres tickets arrivent concernant le même problème.
- 14 h 25 — Votre responsable de l'assistance repère la tendance et fait remonter le problème.
- 16 h 00 — Les ingénieurs identifient le bug et déploient un correctif.
Pendant près de sept heures, votre système de surveillance a affirmé que tout allait bien alors que les clients s'en allaient et que vos revenus s'effondraient.
Qu'est-ce qu'une panne grise ?
Ce mercredi est un cas d'école de panne grise. En surface, tout semble correct ; en réalité, un élément spécifique a cessé de fonctionner en silence, ce qui nuit aux clients sans jamais déclencher d'alerte.
Deux éléments rendent les pannes grises particulièrement sournoises :
- Elles sont partielles. Tout le monde n'est pas touché, seulement une partie, comme un type spécifique de carte bancaire. Il n'y a pas de panne de serveur que vous détecteriez instantanément, juste une situation intermédiaire confuse où la plupart des utilisateurs n'ont aucun problème tandis qu'un groupe échoue systématiquement.
- Elles s'étendent. Ce qui commence par une poignée de clients touchés se propage. Si rien n'est fait, de plus en plus de personnes se heurtent au même problème.
Voyez cela comme de la fumée derrière un mur. De l'extérieur, la maison semble intacte, mais à l'intérieur, les dégâts se propagent — et plus vous attendez, plus la zone d'impact s'élargit. Les chercheurs ont également donné un nom à ce problème sous-jacent : l'étude de Microsoft Gray Failure: The Achilles’ Heel of Cloud-Scale Systems l'appelle l'observabilité différentielle — vos détecteurs de pannes ne remarquent aucun problème alors que vos utilisateurs le ressentent clairement.
Pourquoi attendre les rapports des clients est une erreur
La plupart des équipes gèrent les pannes grises exactement comme lors de ce fameux mercredi : elles attendent que les clients les signalent. Les rapports des clients sont importants — ils représentent une réelle frustration humaine — mais vos clients ne devraient pas vous servir de système de surveillance. S'appuyer uniquement sur ces rapports pose trois problèmes :
- C'est manuel. Quelqu'un doit remarquer la répétition d'une même plainte parmi une multitude de tickets. C'est facile à manquer.
- C'est tardif. Le temps que suffisamment de personnes se plaignent pour que quelqu'un fasse le lien, des heures ou des jours se sont écoulés.
- C'est silencieux. La plupart des clients concernés n'envoient jamais de ticket. Ils s'en vont, tout simplement.
La solution n'est pas d'arrêter de lire les tickets — continuez de le faire. Il s'agit plutôt d'ajouter une détection automatique qui fonctionne en continu et repère ce qui échappe aux humains. Concrètement, vous voulez un système qui se déclenche dès qu'un nombre de clients nettement supérieur à la normale commence à rencontrer le même problème au même moment.
| Rapports clients uniquement | Avec détection automatique |
|---|---|
| Manuel — facile à manquer | Repère ce qui échappe aux humains |
| Tardif — détecté en quelques jours | Rapide — détecté en temps réel |
| Les clients subissent en silence | Signale le pic — de nombreux utilisateurs à la fois |
Découvrez RADAR
C'est l'idée derrière RADAR — Reliability Anomaly Detection, Alerting, and Root-cause analysis. Nous l'avons conçu chez Databricks pour détecter les pannes grises en quelques minutes plutôt qu'en plusieurs heures. Ce nom est bien choisi : lorsque la visibilité est faible, vous n'attendez pas de subir un impact, vous recherchez activement les signaux faibles dès le départ.
Voici comment nous l'orientons vers un signal particulièrement utile : les erreurs utilisateur.
Une panne grise se manifeste souvent par un pic soudain d'erreurs qui semblent être de la responsabilité de l'utilisateur. Imaginez un groupe d'utilisateurs dans une région donnée qui ne parviennent soudainement plus à lancer un certain type de cluster. Chaque requête échoue avec l'erreur INVALID_ARGUMENT — une erreur qui indique poliment : « le problème vient de vous ».
Mais lorsque de nombreux utilisateurs rencontrent la même erreur « de leur faute » au même moment, ce n'est plus de leur faute. C'est de la nôtre. Ce pic correspond exactement au schéma que RADAR est conçu pour détecter.
Les quatre étapes de RADAR
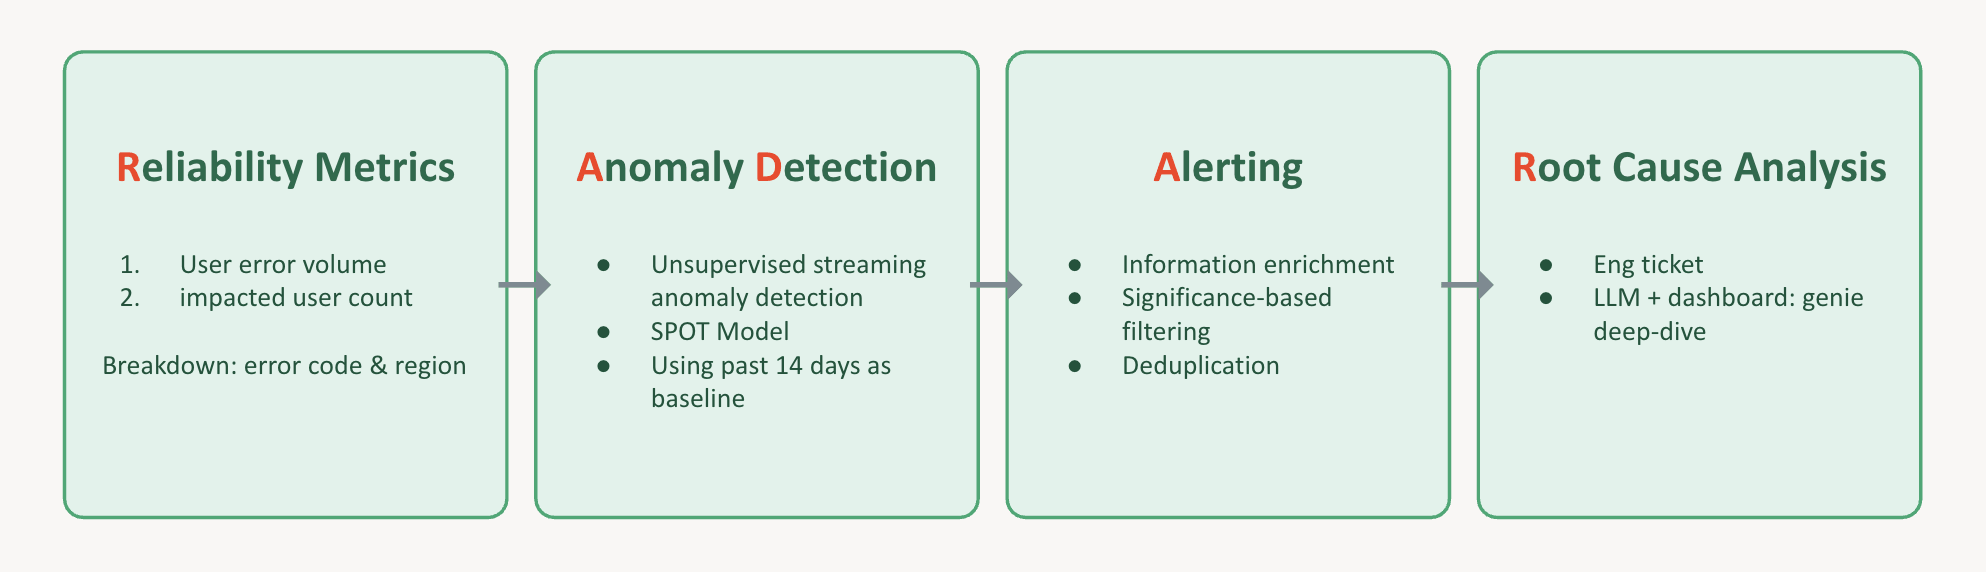
RADAR transforme cette intuition en un pipeline composé de quatre étapes :
- Métriques de fiabilité. À chaque instant, enregistrez deux éléments : le nombre d'erreurs qui se produisent et le nombre d'utilisateurs distincts touchés par chacune d'elles. Répartissez ces données par code d'erreur et par région. Vous disposez désormais d'un ensemble riche de séries temporelles décrivant l'état de santé de votre service.
- Détection d'anomalies. Exécutez une détection d'anomalies sur chacune de ces séries afin que le système signale tout ce qui semble anormal — sans que vous ayez à ajuster manuellement une multitude de seuils. Nous utilisons un modèle de streaming non supervisé appelé SPOT, qui apprend à quoi ressemble la « normale » à partir des 14 derniers jours et ne nécessite qu'un seul paramètre de risque au lieu de seuils manuels. (SPOT est issu de l'article de Siffer et al. Anomaly Detection in Streams with Extreme Value Theory, KDD 2017.)
- Alerte. Lorsque quelque chose se déclenche, la couche d'alerte prend le relais. Elle enrichit l'alerte avec du contexte, filtre ce qui n'est pas significatif et dédoublonne pour éviter que l'équipe d'astreinte ne soit submergée par des copies du même événement. Ensuite, elle crée un ticket dirigé vers l'équipe d'ingénierie compétente pour cette erreur.
- Analyse des causes racines. Chaque ticket arrive avec des détails approfondis sur l'anomalie et un lien vers un tableau de bord soutenu par un assistant AI, AI/BI Genie. La personne d'astreinte peut ainsi chercher directement à comprendre ce qui a réellement échoué, le plus rapidement possible.
Ce que nous avons accompli
L'utilisation de RADAR en interne a transformé la gestion de ces incidents. Auparavant, nous dépendions des tickets clients pour les découvrir, ce qui entraînait des jours de retard. Grâce à RADAR, nous avons obtenu une réduction de 95 % du temps de détection des incidents, avec une précision supérieure à 90 %, sans qu'aucune intervention humaine ne soit nécessaire pour repérer la tendance. Par conséquent, nous sommes en mesure de limiter la zone d'impact des pannes grises.
Orientez RADAR vers n'importe quelle métrique
Voici la partie la plus importante pour vous : le type de métrique importe peu pour RADAR. Nous l'appliquons ici aux erreurs utilisateur, mais le même schéma fonctionne partout où un chiffre peut dériver en silence :
- Services financiers — échecs de paiement et de transaction, anomalies de facturation, signaux de fraude
- Vente au détail et e-commerce — conversion lors du passage en caisse, erreurs de panier, délais de livraison
- Santé et sciences de la vie — flux de patients, traitement des demandes de remboursement
- Tout produit d'AI — performance des modèles et dérive de la distribution des données qui apparaissent avant qu'un modèle ne tombe visiblement en panne
Il s'agit du même schéma appliqué à des contextes différents. Partout où un problème peut survenir en silence, RADAR s'applique.
Construisez-le vous-même sur Databricks
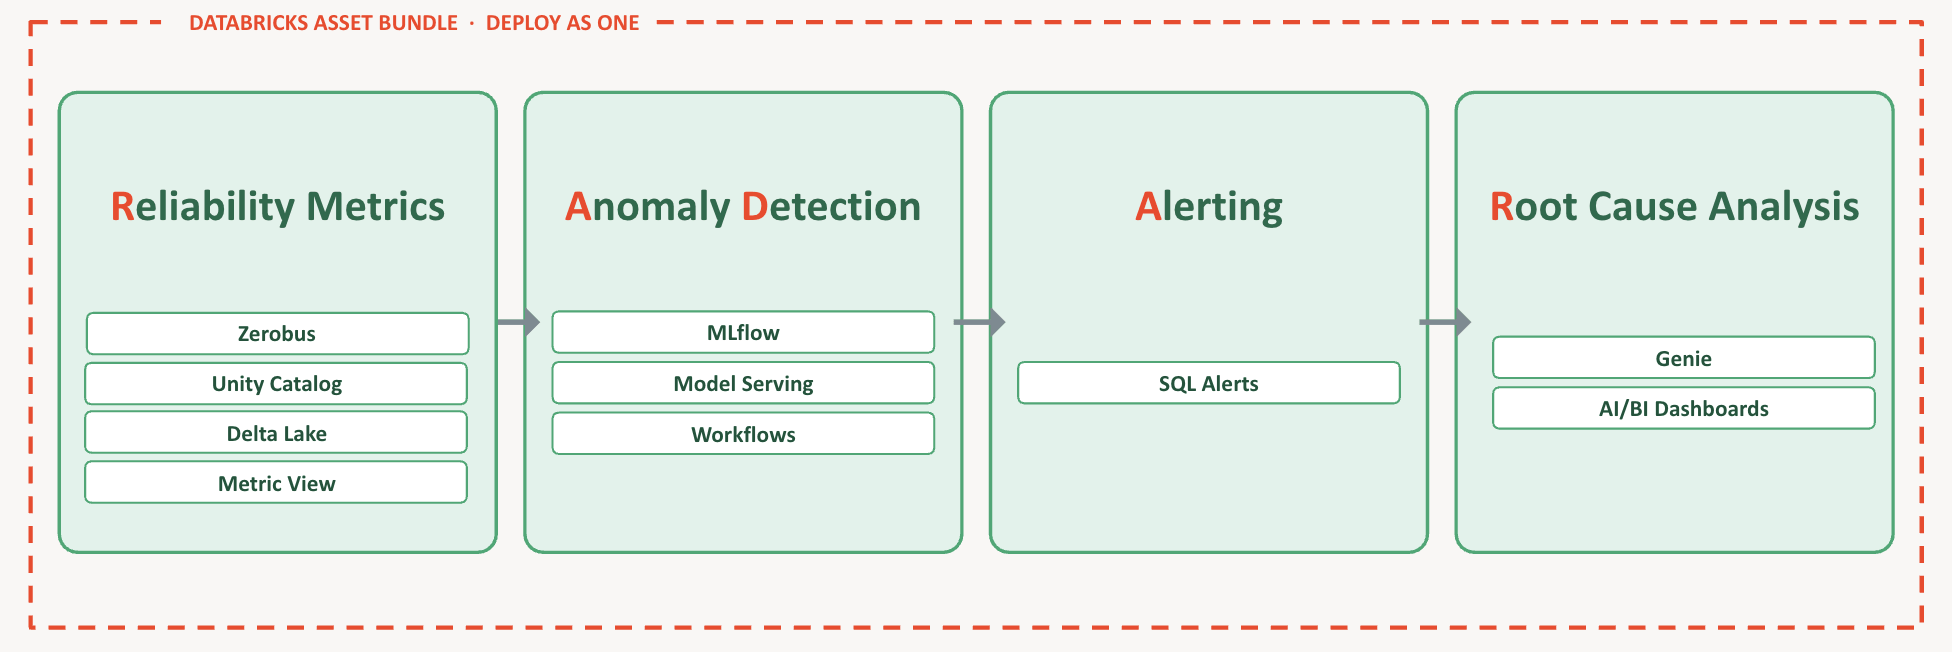
La meilleure nouvelle : tous les éléments dont vous avez besoin sont déjà disponibles sur Databricks. Associez les quatre étapes à la plateforme et voici ce que cela donne :
- Métriques de fiabilité — Zerobus pour l'ingestion à faible latence, Unity Catalog et Metric View pour la gouvernance, Delta Lake pour le stockage
- Détection d'anomalies — MLflow pour l'entraînement des modèles, Model Serving pour déployer le point de terminaison du modèle, et Workflows pour orchestrer les jobs récurrents
- Alertes — Databricks SQL Alerts pour déclencher les alertes
- Analyse des causes racines — AI/BI Genie et AI/BI Dashboards
Et le tout se déploie comme une seule unité via un Bundle d'actifs déclaratif (DAB).
Relier toutes ces pièces à la main est la partie fastidieuse — nous l'avons donc supprimée. Nous avons condensé l'intégralité du système interne RADAR en une structure unique : un seul fichier Markdown qui fonctionne comme une recette, associant chaque partie de RADAR à un composant Databricks spécifique (collecter et stocker → une table Delta ; détecter l'anomalie → un job ; alerter et dédupliquer → un ticket ; visualiser → un tableau de bord).
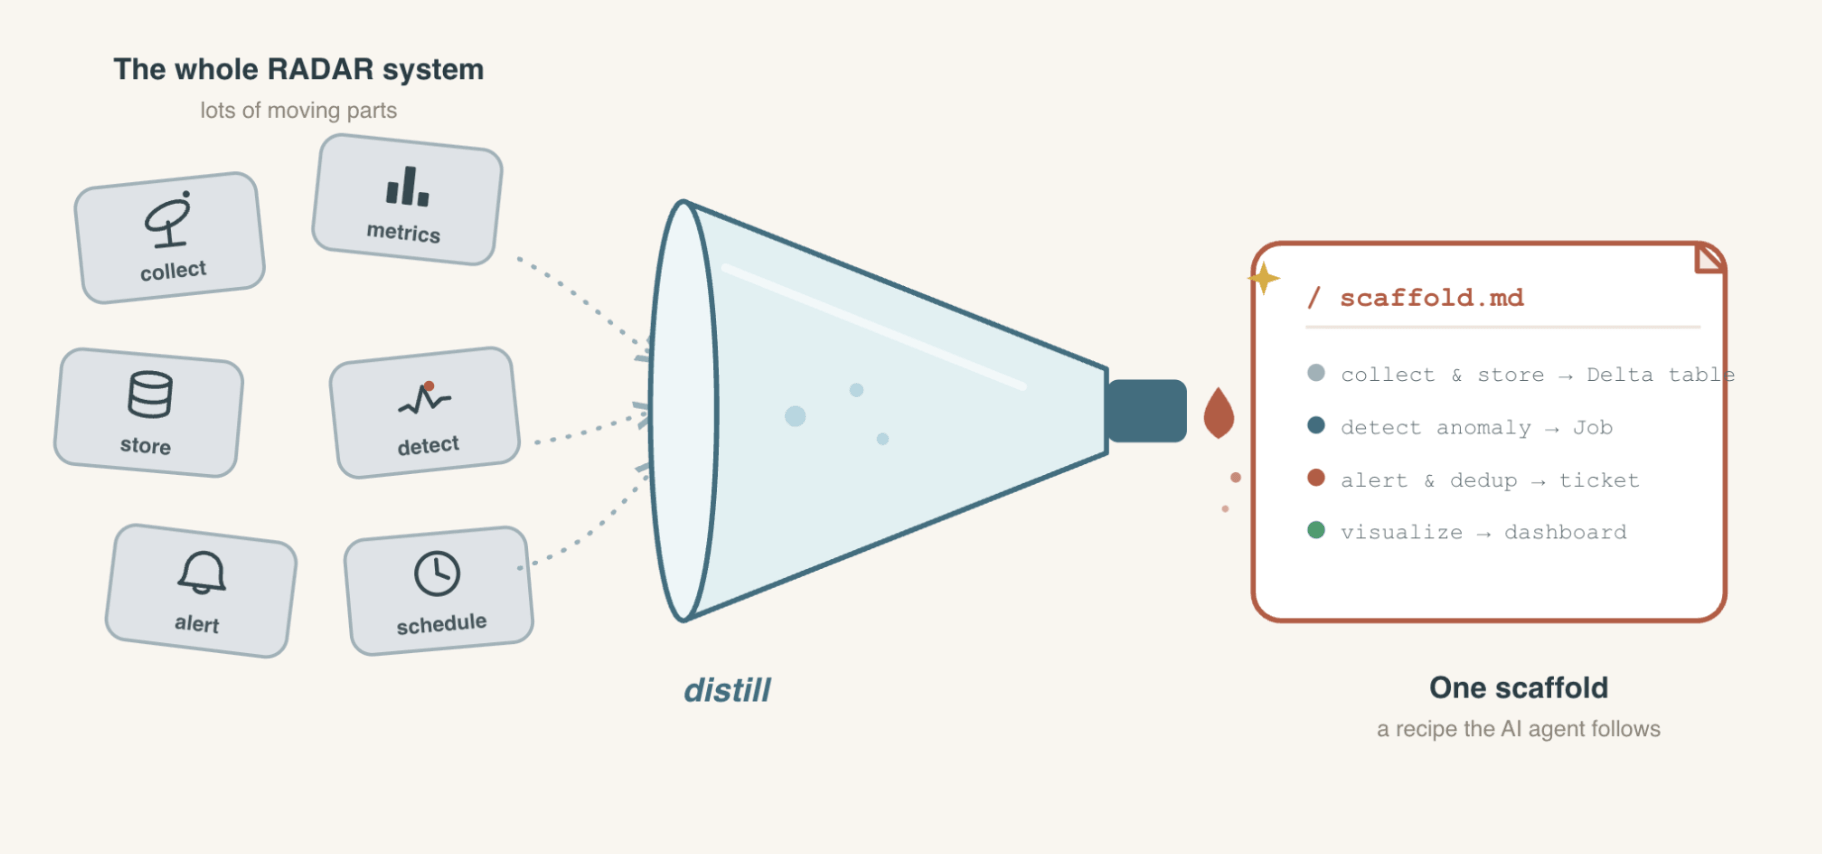
C'est là que vous en récoltez les fruits. Vous apportez votre propre métrique — peu importe où se trouve votre signal — et vous fournissez cette métrique, la structure et un court prompt à un agent IA. Il construit l'intégralité du système RADAR pour vous, en direct sur Databricks. Vous pouvez suivre les instructions GitHub pour savoir comment en créer un à partir d'un simple prompt.
Ce qu'il faut retenir
Deux points essentiels à retenir :
- Détectez les pannes grises avant qu'elles ne s'aggravent. Des tableaux de bord au vert ne prouvent pas que tout va bien pour vos clients. Ajoutez une détection d'anomalies en temps réel pour qu'une panne partielle et silencieuse soit signalée en quelques minutes, et non en plusieurs jours.
- Construisez RADAR sur Databricks pour n'importe quelle métrique importante pour vous. La structure, la démo et le prompt sont tous publics — servez-vous-en comme point de départ.
Obtenir la structure RADAR sur GitHub
Car le meilleur résultat n'est pas de répondre plus rapidement à des clients mécontents — c'est que vos clients n'aient jamais à découvrir vos incidents à votre place.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.