"Regex pour les lignes" : simplifier la détection de motifs en SQL avec MATCH_RECOGNIZE
Utilisez MATCH_RECOGNIZE chaque fois qu'une séquence compte, des tendances boursières aux pannes de capteurs, et bien plus encore.
par Kent Marten et Sergei Fedorov
- MATCH_RECOGNIZE est un nouvel opérateur SQL, disponible en aperçu public, qui vous permet de détecter des motifs et des séquences à partir de données d'événements.
- MATCH_RECOGNIZE utilise une correspondance de motifs de type regex.
- MATCH_RECOGNIZE est très utile dans de nombreux secteurs, notamment : les services financiers, la cybersécurité, l'e-commerce et la fabrication/IoT
Imaginez que vous travaillez dans la cybersécurité et que vous disposez d'une table qui suit les tentatives de connexion. Cette table indique si chaque tentative de connexion est une réussite ou un échec, ainsi que le moment où elle a eu lieu. Vous souhaitez identifier des schémas de connexion suspects. Vous pourriez donc vous poser la question suivante : « Quels utilisateurs ont connu des échecs de connexion consécutifs, suivis d'une réussite ? » Détecter ce type d'activité suspecte avec du SQL standard est un véritable défi. Le SQL traite les lignes comme des ensembles de faits non ordonnés, sans chronologie, et il n'existe aucun concept inhérent de séquence d'événements.
Vous pourriez compter les échecs de connexion par utilisateur, mais ces calculs ne vous aideront pas à savoir si ces tentatives se sont produites sur un intervalle de temps très court ou si elles se sont étalées sur un mois. De plus, cela ne vous indiquera pas si une connexion réussie a eu lieu immédiatement après les échecs. Pour y parvenir en SQL, vous vous retrouveriez avec une requête complexe qui enchaîne plusieurs expressions de table communes, en ancrant la fenêtre temporelle sur le premier échec, puis en vérifiant chaque ligne suivante.
MATCH_RECOGNIZE simplifie ce processus. Désormais disponible dans le moteur de calcul Databricks (y compris Lakehouse Real-Time), MATCH_RECOGNIZE vous permet de décrire directement la séquence qui vous intéresse, à la manière d'une expression régulière pour les lignes. Une seule clause SQL gère désormais la reconnaissance de formes, ce qui vous évite d'avoir recours à du code SQL excessivement complexe basé sur la logique des « écarts et îlots » (gaps and islands).
Voyons à travers des exemples concrets comment MATCH_RECOGNIZE simplifie la détection de séquences dans différents secteurs d'activité.
Cybersécurité : identifier les anomalies de connexion suspectes

Si vous recherchez des attaques par bourrage d'identifiants (credential stuffing) dans les journaux d'autorisation, le simple fait de compter les tentatives de connexion peut générer des faux positifs. Vous devez spécifiquement détecter les pics de haute fréquence, comme 5 tentatives de connexion échouées ou plus dans un intervalle de temps restreint, immédiatement suivies d'une connexion réussie.
Les fonctions de fenêtrage standard COUNT() OVER (PARTITION BY user_id ORDER BY event_time) peuvent vous indiquer le nombre d'échecs survenus dans un intervalle de temps, mais elles ne permettent pas d'ancrer facilement une fenêtre temporelle glissante sur le premier échec d'une séquence spécifique, ni d'isoler clairement la séquence dès qu'une réussite survient.
Avec MATCH_RECOGNIZE, vous pouvez utiliser FIRST(FAIL.event_time) directement dans le bloc DEFINE pour ancrer l'horodatage de la tentative initiale ayant échoué. Chaque événement FAIL ultérieur est vérifié de manière dynamique pour s'assurer qu'il se produit dans l'heure qui suit cette première tentative, avant de passer à l'état SUCCESS.
Analyse financière : détecter les tendances boursières en forme de V
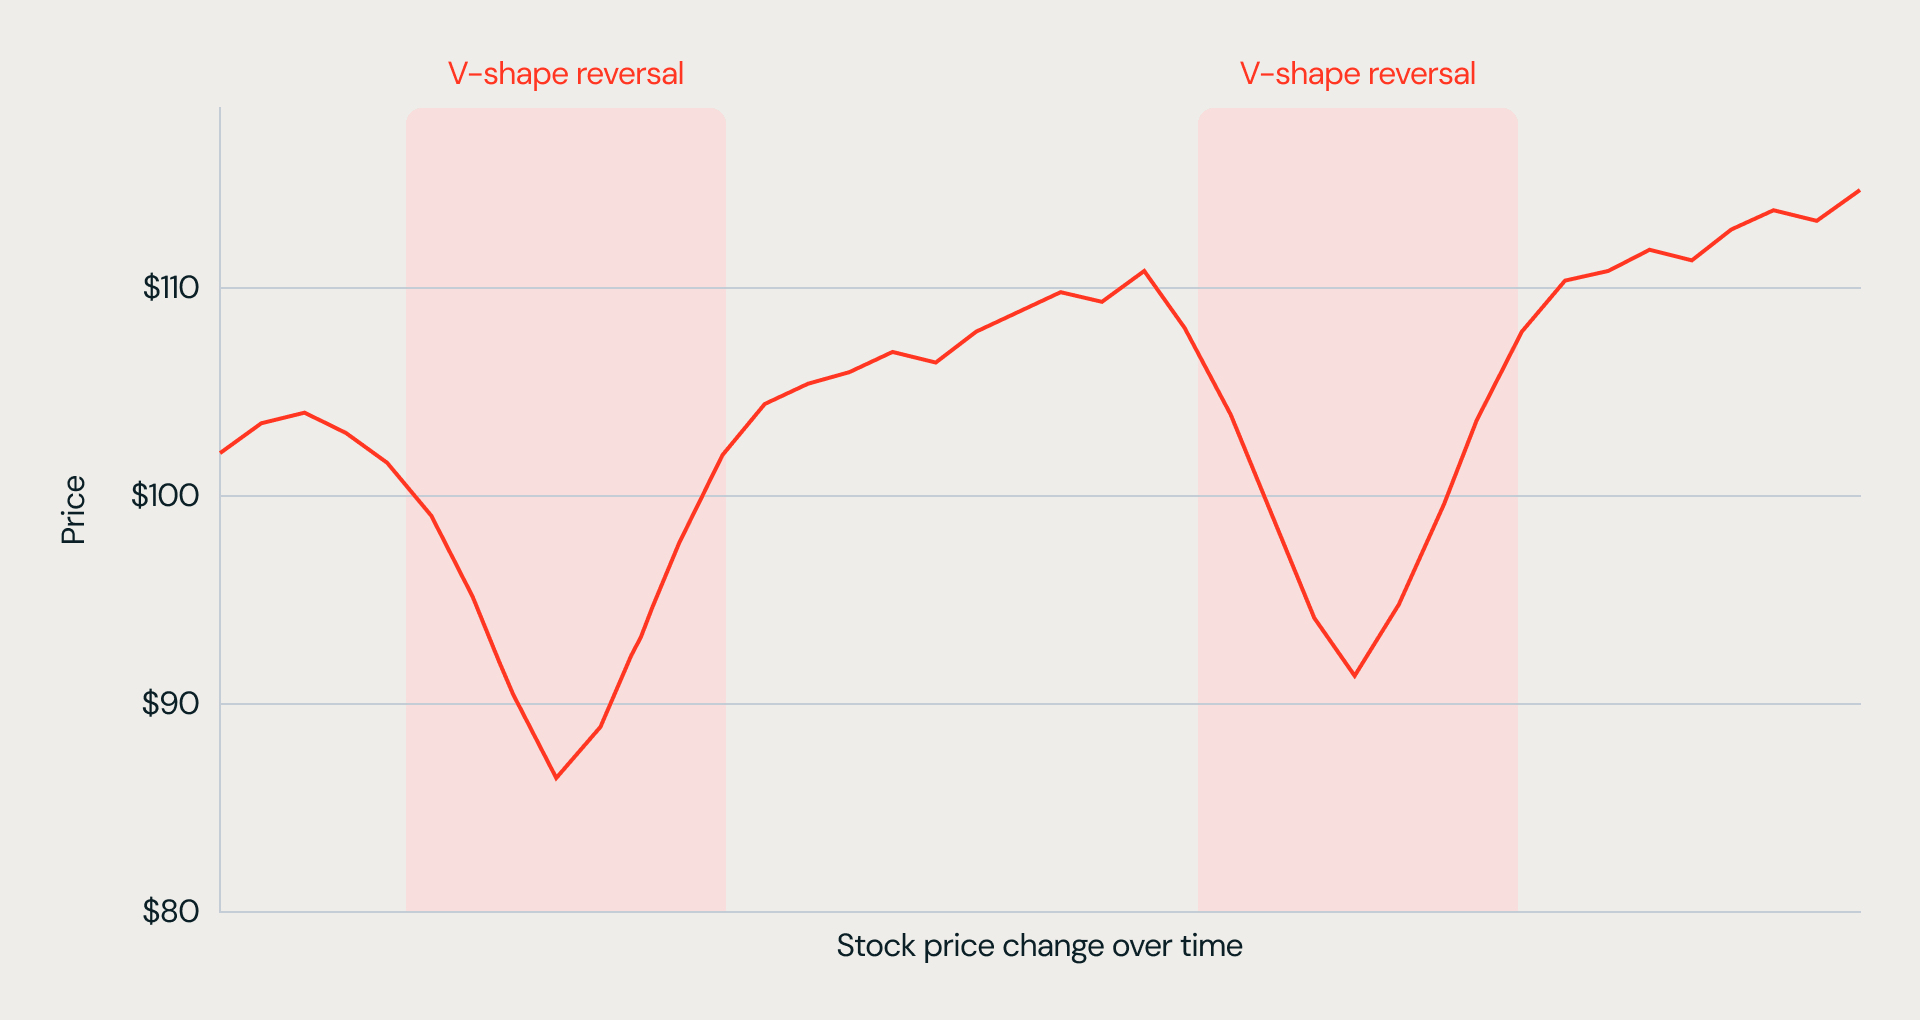
Tout analyste de données de marché s'intéresse aux retournements de tendance, ces moments où un titre perd de la valeur puis commence soudainement à en regagner. Cette courbe est appelée « forme en V ». Pour la trouver en SQL standard, il faut recourir à une technique appelée « écarts et îlots » (gaps and islands) : le SQL n'ayant pas de notion native de tendance, vous devez d'abord découper manuellement vos lignes en « îlots » (des périodes consécutives où le prix évolue dans la même direction) avant même de pouvoir identifier le début et la fin d'une forme en V.
En pratique, cela implique d'utiliser LAG et LEAD pour comparer chaque ligne à ses voisines, de construire un compteur cumulatif qui s'incrémente à chaque changement de direction (afin d'obtenir un ID de groupe pour chaque îlot), puis d'écrire des filtres HAVING pour confirmer la forme et les limites de chaque îlot. C'est une structure bien lourde simplement pour répondre à une question simple : « où le cours a-t-il chuté puis remonté ? »
La clause MATCH_RECOGNIZE élimine le besoin de cette structure complexe. Il vous suffit de partitionner les données par symbole, de les trier par heure et de définir la forme de la tendance en V comme une séquence d'états de type expression régulière.
E-commerce : détecter l'abandon de panier

Les chefs de produit cherchent à identifier les utilisateurs ayant une forte intention d'achat, mais qui ne finalisent jamais leur commande. Les utilisateurs qui manifestent un réel intérêt pour un achat, puis cessent toute activité, représentent un signal précieux. Identifier ce groupe d'utilisateurs permet de : déterminer à qui envoyer un rappel, mesurer facilement l'opportunité commerciale ainsi que le pourcentage récupérable grâce à des actions de suivi, et, par comparaison avec d'autres utilisateurs de cette cohorte, découvrir de nouvelles perspectives (comme le prix trop élevé d'un produit spécifique). Un entonnoir de conversion échoué à forte valeur suit les utilisateurs qui :
- Ont consulté une page produit deux fois ou plus (VIEW 2 fois ou plus, ce qui indique un intérêt élevé)
- Ont ajouté l'article à leur panier (ADD_TO_CART)
- Ont finalement abandonné la session (en utilisant un filtre temporel)
La dernière étape ne repose pas sur une valeur, mais sur un intervalle de temps basé sur l'activité de l'utilisateur. Il n'y a pas de ligne « abandon » à faire correspondre ni d'« erreur de paiement », l'utilisateur s'arrête simplement. En SQL traditionnel, vous devez prouver une absence à l'aide de sous-requêtes NOT EXISTS, d'auto-jointures et de fonctions de fenêtrage pour démontrer que rien ne s'est produit après l'ajout des articles au panier, et qu'un temps d'inactivité suffisant s'est écoulé pour considérer le panier comme abandonné.
MATCH_RECOGNIZE exprime directement l'idée que « rien ne s'est produit après cela » grâce à l'ancre de fin de partition $, qui impose que l'ajout au panier soit le dernier événement enregistré dans la session. Ajoutez un filtre temporel pour la fenêtre d'inactivité et vous obtenez une règle d'abandon basée sur le délai d'expiration, sans aucune auto-jointure.
Secteur manufacturier / IoT : Prédire les pannes d'équipement à partir des données de capteurs

La maintenance prédictive repose sur la détection de tendances et de motifs. Pour toute machine en cours d'utilisation, sa température interne a tendance à augmenter, mais une augmentation constante de la température suivie d'un pic de vibration pourrait signaler une panne imminente.
Le SQL traditionnel nécessite des comparaisons ligne par ligne successives pour tenter de détecter en continu une tendance dangereuse. MATCH_RECOGNIZE gère la logique ligne par ligne de manière native. Dans la clause DEFINE, vous pouvez utiliser les fonctions PREV et NEXT (qui fonctionnent de manière similaire à LAG et LEAD). Cela signifie que la configuration d'une règle de hausse de température est aussi simple que d'écrire temperature > PREV(temperature).
Essayez Match Recognize sur le Lakehouse dès aujourd'hui
Il est désormais plus facile que jamais de découvrir des motifs dans les données et de simplifier l'analyse des séquences d'événements. MATCH_RECOGNIZE vous permet d'écrire moins de code pour la reconnaissance de motifs de manière logique. Cette clause est plus facile à valider, plus facile à maintenir et simple à mettre à jour.
- Explorez la documentation : Plongez dans la documentation de référence SQL officielle pour en savoir plus sur la syntaxe avancée des motifs, les quantificateurs et les agrégats de mesures.
- Essayez-le dans votre espace de travail : Testez les exemples ci-dessus sur vos propres flux de journaux, sessions de parcours de navigation (clickstream) ou télémétrie de séries temporelles dans Databricks SQL ou Lakehouse//RT.
- Migrez les pipelines existants : Identifiez vos CTE de jointure réflexive (self-join) et de fonction de fenêtrage les plus complexes, et laissez Genie Code vous aider à les réécrire avec des requêtes MATCH_RECOGNIZE plus simples.
Le meilleur entrepôt de données est un Lakehouse. Nos capacités natives continuent de s'étendre et vous permettent de réaliser des analyses plus puissantes sur une plateforme unique et unifiée.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.