Mise à l'échelle et exploitation d'un grand projet dbt sur Databricks : l'équipe data d'IFCO s'exprime sur la performance, la visibilité et le débogage
par Fernando Muñoz, Ludwig Brummer et Maxim Hammer
- Optimisez les modèles incrémentiels dbt pour que chaque exécution n'écrive que les lignes modifiées, en utilisant le clustering liquide, une stratégie de fusion réfléchie et l'élagage dynamique de fichiers. Cela a permis de réduire de plus de 60 % le temps d'exécution des tâches principales d'IFCO et de supprimer l'actualisation complète nocturne.
- Diagnostiquez les modèles lents à partir du plan d'exécution réel de la requête, et non du SQL compilé, car c'est là que se trouvent les véritables causes. IFCO a intégré ce diagnostic dans un processus reproductible qui s'exécute sur chaque modèle.
- Exécutez le projet dbt sous forme d'une tâche par modèle sur Databricks Jobs avec l'outil open-source databricks-dbt-factory, et non comme une tâche opaque unique. Cela offre une visibilité par modèle, des réexécutions ciblées et des tests systématiques.
Résumé
IFCO gère l'un des plus grands parcs d'emballages réutilisables au monde, avec des centaines de millions de caisses et de palettes. Avec plus de 2 000 employés dans le monde, IFCO emploie plus de 350 personnes en Allemagne, dont la plupart travaillent à son siège mondial à Pullach, près de Munich. L'entreprise propose un service de mutualisation circulaire : des bacs plastiques réutilisables (RPC) transportent les produits frais des producteurs et emballeurs vers les centres de distribution et les détaillants, puis retournent dans les centres de service d'IFCO pour être lavés, triés et réexpédiés, dans plus de 50 pays.
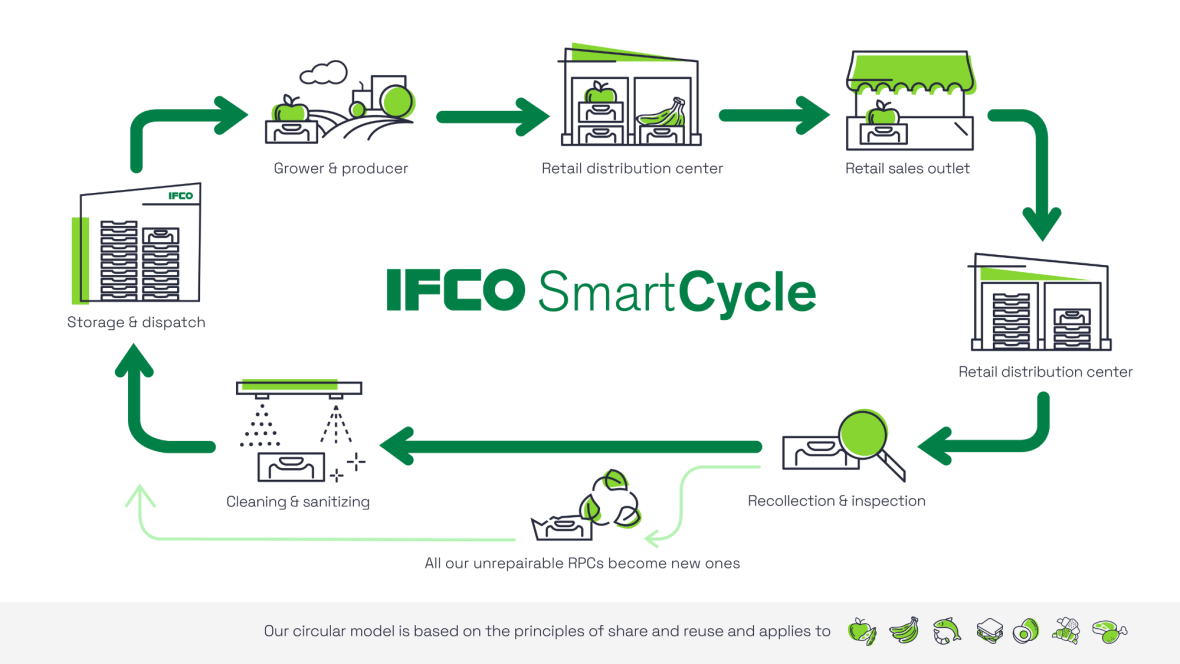
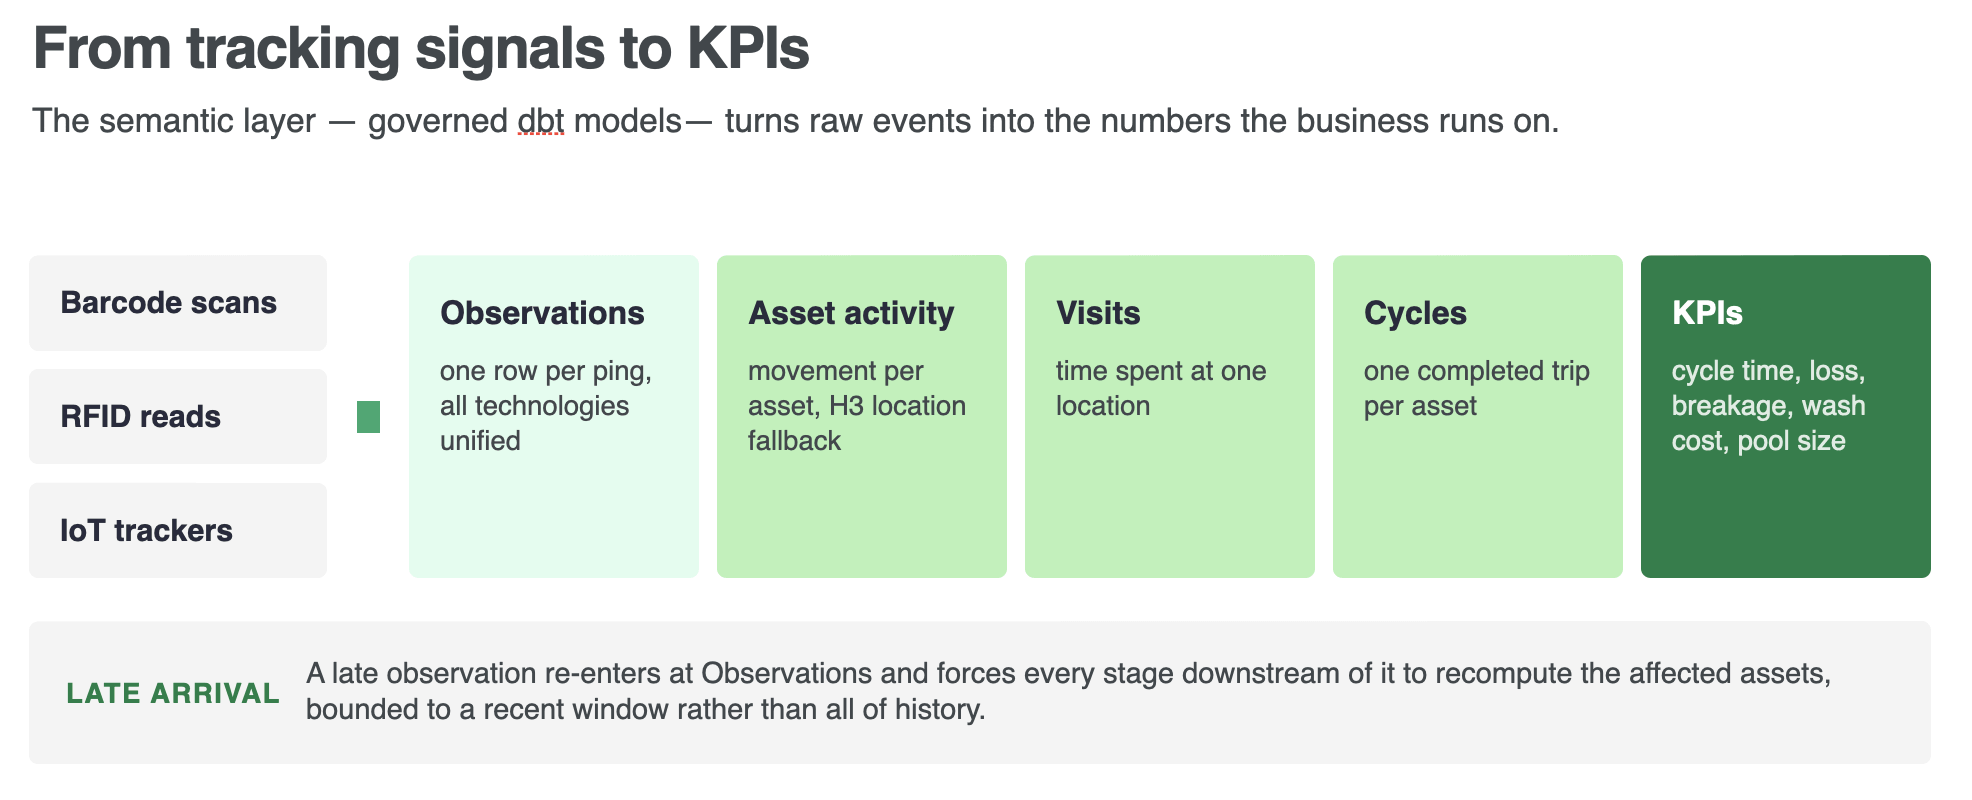
Chaque caisse et palette est suivie tout au long de son cycle de vie, alimentant les KPI qui guident l'activité : temps de cycle, perte, casse, coût de lavage et taille du parc. Transformer des milliards d'événements de suivi bruts en KPI fiables est difficile pour trois raisons : le volume de données est considérable, certaines données arrivent en retard de manière difficile à prévoir, et lorsqu'elles arrivent, elles obligent le pipeline à corriger l'historique qu'il a déjà généré.
Cet article montre comment l'équipe de la plateforme de données d'IFCO, en collaboration avec l'équipe Forward Deployed Engineering de Databricks, a rendu ce pipeline plus rapide et plus économique. La logique de transformation reste dans dbt. Elle s'exécute sur Databricks, où chaque paramètre incrémentiel correspond à un comportement d'écriture Delta Lake concret : quelles colonnes regroupent (cluster) les données, quelle proportion de la table cible une écriture doit affecter, et si les lignes sont fusionnées ou remplacées. Le fait de configurer correctement ces paramètres, au bon niveau de granularité des données, a permis de réduire de plus de 60 % le temps d'exécution quotidien du traitement de la couche sémantique principale et a permis à IFCO de supprimer une actualisation complète nocturne très coûteuse.
IFCO et la nature du problème de données
Une caisse est préparée, remplie, expédiée, retournée, lavée et réutilisée de nombreuses fois par an. IFCO doit donc savoir où se trouve chaque actif et ce qui lui est arrivé. IFCO a mis en place une couche sémantique qui rassemble de nombreux signaux de suivi différents dans une vue unique et gouvernée de l'activité des actifs : scans de codes-barres lors du passage des caisses sur la ligne de lavage, lectures RFID aux portes des quais, et traceurs sur batterie qui transmettent la position GPS, les balises Bluetooth à proximité et la température. (Tout au long de cet article, le terme « couche sémantique » désigne ces modèles d'administration dbt qui transforment les événements de suivi bruts en KPI métier.) Trois caractéristiques rendent cette tâche difficile.
- Volume. Des milliards d'événements de suivi affluent chaque jour. La consolidation réduit les pings répétés de chaque actif en un nombre de lignes d'activité bien inférieur, mais les tables lues par les KPI restent suffisamment volumineuses pour que leur reconstruction complète soit coûteuse.
- Arrivées tardives imprévisibles. La plupart des observations arrivent dans un intervalle prévu, mais certains flux accusent un retard de plusieurs semaines, voire de plusieurs mois, sans calendrier fixe. Un pipeline qui suppose que les données dont il dispose aujourd'hui représentent l'image complète de ce qui s'est passé hier fournira silencieusement un historique erroné.
- Rapprochement historique. L'activité des actifs est séquentielle, de sorte qu'une observation tardive ne se contente pas de combler un vide. Insérez un scan au milieu de la chronologie d'un actif, et cela modifie ce que le pipeline avait déjà déduit pour tout ce qui suit : la destination suivante de l'actif, le début de son cycle, la catégorie de KPI dans laquelle il s'est retrouvé. Une arrivée tardive oblige donc le pipeline à recalculer l'état qu'il a déjà publié, et pas simplement à ajouter une nouvelle ligne. L'objectif est de produire rapidement une estimation fiable et de la faire converger vers la réalité à mesure que les données tardives arrivent, sans avoir à tout retraiter chaque nuit.
Traitement incrémentiel à grande échelle
Sous le capot, un modèle incrémentiel dbt est un ensemble de comportements de lecture et d'écriture Delta, et l'essentiel du gain provient d'un principe simple : faire en sorte que chaque exécution touche le moins de lignes possible, et les éliminer le plus tôt possible. Le premier et principal levier est la lecture elle-même, en analysant uniquement les fichiers et les actifs modifiés dont une exécution a réellement besoin. En effet, chaque ligne que vous évitez de lire est une ligne qui n'atteindra jamais les opérations coûteuses de tri, de réorganisation (shuffle) et d'écriture par actif en aval. Chaque technique ci-dessous est une configuration d'dbt ordinaire qui se traduit par un comportement Delta spécifique.
Regroupez (cluster) sur les colonnes de filtrage et de jointure. Le Liquid clustering, indexé sur la granularité de requête de chaque modèle (pour l'activité des actifs, l'actif et la date de l'événement), permet au moteur d'ignorer des fichiers au lieu de les analyser. C'est ce qui permet aux deux techniques suivantes de fonctionner.
Choisissez délibérément votre stratégie incrémentielle. La stratégie détermine la manière dont chaque exécution écrit, et ce choix découle de deux questions : chaque ligne possède-t-elle une clé stable, et mettez-vous à jour les lignes sur place ou remplacez-vous un groupe de lignes d'un coup ? Pour les mises à jour/insertions (upserts) indexées et fortement sujettes à la déduplication, l'opération de fusion (merge) est l'option par défaut. Indexée sur la granularité réelle (pour l'activité des actifs, asset_id et event_date_time), elle réalise deux actions qu'une suppression et réinsertion en bloc ne peut pas faire :
Le prédicat d'équi-jointure active l'élagage dynamique des fichiers (dynamic file pruning) : les valeurs clés du lot entrant ignorent les fichiers cibles qui ne peuvent pas contenir de correspondance, de sorte que l'écriture ne touche que la partie qu'elle modifie. (DBT_INTERNAL_DEST and DBT_INTERNAL_SOURCE sont les alias de dbt pour la table cible et le lot entrant dans l'instruction qu'il génère.) Le clustering sur les mêmes clés que celles sur lesquelles la fusion s'aligne permet de maintenir cet élagage précis. Un garde de hachage de ligne, un matched_condition qui compare un hachage de substitution de chaque ligne, évite ensuite de réécrire les lignes qui n'ont pas réellement changé, ce qui économise des écritures et maintient propre le flux de modifications en aval.
delete+insert est l'alternative : elle supprime tout un groupe de lignes par clé et le réinsère. C'est plus simple lorsqu'une exécution recalcule un groupe comme une unité et que les lignes ne portent pas d'identité stable sur laquelle s'aligner, au prix de la réécriture du groupe même là où rien n'a changé. À de très grands volumes, il est préférable de comparer les deux approches par un benchmark plutôt que de faire des suppositions.
Limitez l'écriture à une fenêtre récente. Le même mécanisme de prédicat a un second usage. Au lieu d'une équi-jointure pour l'élagage des fichiers, une limite temporelle restreint l'écriture aux données récentes, de sorte que sur les modèles en amont à plus fort volume, le MERGE s'aligne sur une tranche récente de la destination plutôt que sur la table entière :
Parce que le prédicat s'appuie sur le moment où une ligne a été ingérée, et non sur le moment où l'événement s'est produit, un événement vieux de plusieurs mois est toujours capturé tant qu'il est arrivé récemment. La fenêtre doit simplement être assez large pour couvrir l'écart entre l'arrivée des données et leur traitement par cette tâche. Si vous la définissez de manière trop étroite, les données tardives seront ignorées en silence : cela ne génère pas d'erreur, mais elles ne seront tout simplement jamais traitées.
Ne recalculez que ce qui a changé. Les modèles limitent leur travail aux actifs touchés par des données nouvelles ou tardives, identifiées à partir d'un watermark d'ingestion, et lisent une fenêtre plus large que celle qu'ils écrivent, de sorte que les événements tardifs soient capturés sans actualisation complète.
Gardez Delta propre. Les tables incrémentielles volumineuses activent les écritures optimisées et l'auto-compaction, ou confient la maintenance des tables à Predictive Optimization, afin que les fusions fréquentes ne laissent pas derrière elles une pénalité de lecture liée aux petits fichiers.
La rigueur consiste à appliquer ces principes au bon niveau de granularité, puis à confirmer, à partir du plan de requête réel, que le moteur effectue réellement l'élagage plutôt qu'un balayage silencieux.
Un exemple concret : consolider les observations en activité d'actifs
Le modèle le plus sollicité de la couche sémantique est celui qui consolide les observations de chaque technologie de suivi en un flux unique et géolocalisé par actif. Il détermine le moment où un actif s'est réellement déplacé à l'aide de fonctions de fenêtrage (window functions) partitionnées par actif et triées par heure d'événement. Lorsqu'une observation ne comporte pas de localisation explicite, elle s'appuie sur les fonctions H3 intégrées de Databricks SQL, qui associent chaque latitude/longitude à une cellule de grille hexagonale, de sorte que « le même endroit » devienne une comparaison peu coûteuse d'identifiants de cellule et de leur distance sur la grille, plutôt que des calculs répétés de distance géographique. C'était, de loin, le plus grand consommateur de temps d'exécution.
La première étape n'a pas été d'optimiser, mais de voir ce qui s'exécutait réellement, et cette distinction est importante. dbt compile génère le SELECT d'un modèle avec ses références résolues, mais pour un modèle incrémentiel, ce n'est pas l'instruction que Databricks exécute. Derrière ce SELECT compilé, dbt génère et exécute une opération plus vaste : des vues temporaires, des analyses de la table de destination et l'écriture finale dans la table. La seule façon de savoir où passent le temps et la mémoire est de lire le plan de requête réellement exécuté, étape par étape, à partir de l'historique des requêtes, et non le SQL compilé.
Lu de cette façon, le plan était sans appel. Le modèle analysait des milliards de lignes, transférait des centaines de gigaoctets sur le disque et passait environ 85 % de son temps dans un seul tri de fenêtre et réorganisation (shuffle) par actif. En réalité, il reconstruisait l'intégralité de la table à chaque exécution. Trois facteurs en étaient la cause :
- L'ensemble des actifs « modifiés » ne diminuait jamais. Un horodatage en amont était régénéré à chaque exécution au lieu d'être transmis depuis la source, de sorte que presque tous les actifs semblaient nouveaux. Quand tout semble modifié, une exécution incrémentielle se transforme discrètement en une actualisation complète.
- Le recalcul par actif n'avait pas de limite. Les fonctions de fenêtrage remontaient tout l'historique de chaque actif, de sorte que même un ensemble de modifications très restreint entraînait des années d'historique dans le tri.
- L'étape de fenêtrage calculait des colonnes que la requête finale n'utilisait jamais, y compris une seconde fenêtre prospective dont l'intégralité du résultat était rejetée.
Chaque correction découle directement de sa cause : transmettre le véritable horodatage d'ingestion à travers les modèles en amont afin que l'ensemble modifié reflète des données réellement nouvelles, limiter le recalcul à une fenêtre récente, supprimer les colonnes inutilisées et la fenêtre prospective, effectuer le clustering selon le grain de requête du modèle, et enfin exécuter l'ensemble du graphe sous forme de tâches parallèles par modèle sur un calcul serverless (section suivante). Ensemble, ces mesures ont réduit le temps d'exécution de la tâche principale de plus de 60 %, soit près des deux tiers, et ont éliminé l'actualisation complète nocturne qui était nécessaire pour maintenir l'exactitude des KPI.
D'une session de débogage à une compétence reproductible
Le diagnostic ci-dessus (lire le plan d'exécution réel plutôt que le SQL compilé, vérifier le côté lecture et le côté écriture, associer chaque symptôme à une cause racine) n'est pas spécifique au modèle de consolidation. C'est une séquence que n'importe quel ingénieur exécuterait sur n'importe quel modèle incrémentiel lent sur Databricks. Cette séquence est ce qui est encapsulé sous forme de compétence : un guide (playbook) qu'un agent IA exécute à la demande, de sorte que le diagnostic s'adapte au nombre de modèles plutôt qu'au nombre d'ingénieurs qui se souviennent de la marche à suivre.
La compétence reproduit l'exemple pratique étape par étape. Elle extrait la famille d'instructions réelle de l'historique des requêtes, et non de la sortie de dbt compile, car pour un modèle incrémentiel, il s'agit d'instructions différentes. Elle lit les deux côtés de l'exécution : les métriques côté balayage (fichiers élagués, lignes lues, débordement) et les métriques côté écriture (lignes écrites par rapport aux lignes supprimées), car l'amplification n'apparaît que du côté écriture. Ensuite, elle recherche les trois mêmes classes de défaillance que celles trouvées dans le modèle de consolidation : un ensemble modifié qui ne diminue jamais (un horodatage en amont régénéré au lieu d'être transmis), un recalcul par actif illimité (une fenêtre sans limite de recherche en arrière) et du travail inutile (des colonnes ou des passages de fenêtre calculés mais jamais lus en aval). Chaque vérification repose sur une métrique ou un signal de plan, et non sur une intuition.
Le résultat est un rapport, pas une correction silencieuse : chaque constatation est présentée avec ses preuves (lignes balayées, octets de débordement, nœud de plan), associée à une proposition de modification, et rien n'est appliqué à un modèle sans approbation. Une fois approuvées, les mêmes métriques avant/après utilisées pour justifier la correction sont mesurées à nouveau lors de l'exécution suivante, de sorte que la compétence boucle la boucle au lieu de supposer que la correction a fonctionné.
Le gain réside dans la cohérence, pas dans la nouveauté. Les trois causes à l'origine du temps d'exécution du modèle de consolidation étaient ordinaires et faciles à manquer sous la charge (un horodatage régénéré, une fenêtre illimitée, des colonnes mortes). L'exécution d'une compétence pour les détecter ne coûte rien à répéter, et elle trouve le même type de problème sur le modèle suivant avant qu'il ne devienne un problème de temps d'exécution de 60 % que quelqu'un doit signaler.
Exécuter un grand projet dbt sur Databricks Jobs
Databricks Workflows (Lakeflow Jobs) traite dbt comme un type de tâche de premier ordre : un projet dbt peut être planifié, exécuté et surveillé aux côtés des étapes d'ingestion et d'aval dans un workflow gouverné unique, avec des mécanismes de nouvelle tentative et d'alerte partagés. La version la plus simple exécute l'ensemble du projet sous la forme d'une seule tâche dbt. Cela fonctionne, mais c'est une boîte noire : si un modèle échoue, toute la tâche échoue, sans aucun moyen de visualiser, de réexécuter ou de surveiller les modèles individuels. À cette échelle, cela représente un risque opérationnel.
La solution consiste à exécuter le graphe dbt sous forme de tâches Databricks individuelles, une par modèle, test, seed et snapshot. IFCO génère ce graphe avec databricks-dbt-factory, une bibliothèque open source autonome (sous licence MIT, sur GitHub and PyPI). Elle lit le manifeste dbt et un modèle de tâche, puis produit une tâche Databricks Asset Bundle avec une tâche par nœud. La granularité par tâche n'est rentable que si chaque tâche est peu coûteuse à démarrer, ce qui repose sur trois mécanismes :
- Type de tâche Notebook. Un petit notebook d'exécution partagé déclenche dbt via son API Python. dbt élabore le SQL et l'envoie au SQL warehouse, de sorte que le calcul du notebook ne traite aucune donnée.
- Environnements de base. Un environnement de base est un instantané d'environnement Python serverless pré-construit. Celui-ci contient déjà
dbt-databricks, de sorte que chaque tâche démarre à partir de lui et évite le pip install qu'une nouvelle tâche devrait autrement effectuer. - Injection de manifeste. Un manifeste pré-construit est transmis directement à dbt pour éviter l'analyse, et chaque tâche écrit des artefacts dans un répertoire local privé. Sur un grand projet exécuté par de nombreuses tâches à la fois, c'est ce qui fait la différence entre des minutes de relecture du projet et du travail utile.
Avec un surdébit réduit au minimum, la distribution (fan-out) offre aux opérations ce dont elles ont besoin : une visibilité au niveau des tâches, des réexécutions ciblées uniquement sur le modèle défaillant et ses dépendances, des journaux, des alertes et des tests par modèle, ainsi qu'un exécuteur extensible (charger des secrets, étiqueter une exécution avec un SHA git, ou publier sur Slack en quelques lignes). Tout se déploie sous forme de Databricks Asset Bundles via une matrice GitHub Actions prenant en compte les chemins, et le temps d'exécution ainsi que le coût par modèle sont suivis à partir des balises de requête et des tables système dans un tableau de bord avec des alertes, de sorte qu'une régression apparaît en un jour, et non sur une facture mensuelle.
Tests et qualité à l'échelle
L'efficacité ne vaut rien si elle fausse discrètement les chiffres, c'est pourquoi la qualité est imposée, et non simplement espérée. Chaque modèle comporte un propriétaire et un test d'unicité. Les clés primaires sont testées comme uniques et non nulles avec un niveau de gravité d'erreur. Les modèles dotés d'une logique réelle (fonctions de fenêtrage, jointures multiples, macros complexes) nécessitent des tests unitaires. dbt-bouncer bloque les commits qui enfreignent ces règles, aux côtés de sqlfluff sur le dialecte Databricks, et des contrats sont appliqués sur les couches lues par les consommateurs externes.
La même discipline s'applique au coût des tests eux-mêmes. Les vérifications sur les vues sont matérialisées ou regroupées en moins de passes, car une vérification basée sur une vue recalcule la vue à chaque exécution ; les vérifications de base deviennent des contraintes de colonne et les tests sont limités aux données incrémentielles. Localement, développeurs se réfèrent à un manifeste de production, de sorte que seuls les modèles modifiés sont construits tandis que les éléments en amont lisent depuis la production. Dans l'intégration continue (CI), des tests unitaires et de données échantillonnées sont exécutés sur les modèles modifiés avant la fusion.
Analyse comparative
| Mesure | Avant | Après |
|---|---|---|
| Temps d'exécution quotidien, tâche principale | ≈ 7 heures | 2 h 20 min, en baisse de ~66 % |
| Actualisation complète nocturne | requise pour maintenir l'exactitude des KPI | supprimée |
| Lignes balayées par exécution, modèle de consolidation | ≈ 25 milliards (et en croissance quotidienne) | -75 % de lignes balayées |
| Coût de calcul quotidien | Réduit de 58 % | |
| Actifs recalculés par exécution | presque la totalité du pool | ≈ 3 à 5 % du pool |
Prochaines étapes
Le pipeline actuel fonctionne par lots (batch) : l'ingestion a lieu une fois par jour, et la couche sémantique s'exécute par-dessus, émettant une estimation précoce qui converge à mesure que les données tardives arrivent. Trois chantiers recommandés au cours de la mission permettraient d'aller plus loin et d'ouvrir la voie à des KPI en quasi-temps réel.
- Consommer uniquement ce qui a changé, avec Change Data Feed. Le Change Data Feed de Delta permet à un modèle en aval de lire uniquement les lignes qui ont changé en amont, au lieu de balayer à nouveau ses entrées. Appliqué au modèle de consolidation et à ses dépendants, il réduit le travail de réconciliation de « balayer une fenêtre récente » à « traiter les lignes exactes qui ont été déplacées », ce qui constitue la suite logique après avoir limité le recalcul.
- Ingestion à plus faible latence. Le chargement quotidien peut être déplacé vers un chemin d'ingestion en streaming, Auto Loader ou un connecteur Lakeflow Connect à faible latence, sans réarchitecturer quoi que ce soit en aval. Cela suffit à faire passer la fraîcheur des données d'un jour à quelques minutes.
- Transformations en streaming déclaratives. La même logique de transformation peut s'exécuter en continu sous la forme d'un Lakeflow Declarative Pipeline lisant un flux, plutôt que sous la forme d'un lot nocturne, avec un traitement avec état (stateful) gérant la réconciliation par actif à mesure que les événements arrivent.
La question décisive relève du besoin métier, non de la technologie. Lorsqu'une métrique doit réellement être fraîche en quelques minutes plutôt que le lendemain matin, cette approche la fournit sur les mêmes tables gouvernées, avec la même logique définie par dbt. Lorsqu'une actualisation quotidienne suffit, le pipeline par lots reste la solution la plus économique.
Conclusion
La solution repose sur une répartition claire des tâches. La logique de transformation reste dans dbt, modulaire et testée, tandis que les données restent au format ouvert Delta Lake sous un modèle de gouvernance Unity Catalog unique, de sorte que le lignage et les contrôles d'accès persistent après chaque reconstruction de table et que rien ne soit lié à un seul moteur de requête. Cette logique dbt est compilée pour exploiter les fonctionnalités Databricks conçues pour le passage à l'échelle : le clustering liquide, les écritures incrémentielles Delta, l'élagage dynamique des fichiers et les fonctions géospatiales H3. Établissez vos diagnostics à partir du plan de requête réel plutôt que du SQL compilé, réduisez le nombre de lignes qui atteignent les opérations coûteuses de tri et de redistribution (shuffles), et exécutez le projet sous forme de graphique de tâches par modèle afin que les opérations bénéficient d'une visibilité accrue et de réexécutions sécurisées à faible coût. Les gains les plus importants ne proviennent pas de clusters plus grands, mais d'une réduction de la charge de travail : manipuler moins de lignes, recalculer moins d'actifs et reconstruire la table beaucoup moins souvent.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.