Unifier la gouvernance entre les moteurs et les catalogues au sein de l'Open Lakehouse
Comment deux nouvelles spécifications d'Apache Iceberg™ rendent la gouvernance aussi portable que vos données
par Daniel Weeks, Ryan Blue et Andrei Tserakhau
- Les restrictions de lecture et les étiquettes de catalogue sont deux nouvelles spécifications d'Apache Iceberg™ qui permettent de standardiser l'application des politiques entre les moteurs et les catalogues.
- Ces deux ajouts éliminent l'application fragmentée des politiques. Les restrictions de lecture délèguent les décisions aux moteurs de confiance ; les étiquettes de catalogue rendent les métadonnées de gouvernance portables entre les catalogues fédérés.
- Il existe désormais un modèle clair pour chaque modèle d'accès : une application centralisée pour les moteurs non approuvés, des restrictions de lecture pour les moteurs de confiance, et des étiquettes de catalogue pour la fédération de catalogue à catalogue.
Dans nos articles précédents, nous avons montré comment les formats de table ouverts, les API ouvertes et la gouvernance unifiée s'associent pour réaliser pleinement la vision de l'Open Lakehouse. Nous avons également présenté le contrôle d'accès basé sur les attributs multi-moteurs (ABAC), qui permet d'appliquer de manière cohérente les politiques définies dans Unity Catalog lorsque des moteurs externes accèdent à des données gouvernées.
Aujourd'hui, cette vision commence à se matérialiser au grand jour. La communauté Apache Iceberg™ a récemment proposé deux ajouts importants au catalogue REST Iceberg : les restrictions de lecture et les étiquettes de catalogue. Ensemble, ils répondent à deux défis distincts : déléguer l'application des règles à un moteur externe et rendre le contexte de gouvernance portable entre les catalogues.
Dans cet article, nous examinerons de plus près ces deux nouveaux ajouts à la spécification : leur fonctionnement, les principaux défis qu'ils relèvent, les futures opportunités d'innovation et le moment idéal pour les utiliser.
Restrictions de lecture : standardiser l'application déléguée
Les restrictions de lecture répondent à un scénario courant de communication entre moteur et catalogue : une organisation gouverne les données dans un catalogue et souhaite les interroger à partir de différents moteurs ou outils.
Pour toute requête gouvernée, trois étapes sont nécessaires :
- Le catalogue reçoit l'identité du demandeur et le contexte pertinent, tel que les sujets, les groupes, les rôles ou même des attributs d'identité comme la « région »
- Il évalue la politique pour décider si l'utilisateur peut lire la table et quels filtres de ligne ou masques de colonne s'appliquent.
- Une couche de calcul approuvée applique cette décision lors de la lecture des données.
Lorsque les données sont accessibles depuis un moteur, ces responsabilités peuvent être réparties de deux manières.
Avec l'application centralisée, les trois étapes restent au sein de l'environnement du catalogue. Par exemple, Databricks implémente un contrôle d'accès précis sur un calcul dédié en acheminant de manière transparente les requêtes via une flotte de filtrage sécurisée. Et la fonctionnalité d'ABAC multi-moteurs de Unity Catalog étend cette gouvernance à d'autres moteurs en plaçant la flotte de filtrage derrière les API de scan/plan du catalogue REST Iceberg afin de nettoyer les données avant qu'un moteur externe tel que Apache Spark1 ou DuckDB ne traite le résultat.
Avec l'application déléguée, le catalogue reçoit l'identité du demandeur et évalue la politique, puis renvoie les restrictions de ligne et de colonne résultantes à un moteur auquel il fait confiance pour les appliquer. Ici, la confiance signifie que le catalogue peut s'appuyer sur le moteur pour appliquer les restrictions et empêcher les utilisateurs de les contourner. Les moteurs tels que Apache Spark et DuckDB ne sont pas approuvés lorsque les utilisateurs contrôlent le runtime, car ces derniers peuvent exécuter du code arbitraire ou accéder directement aux données sous-jacentes. Un déploiement Trino configuré de manière sécurisée est un exemple de moteur approuvé, car il fournit une application native pour les filtres de ligne et les masques de colonne.
L'application déléguée nécessite un contrat commun entre le catalogue et le moteur. La communauté Iceberg a adopté les restrictions de lecture pour fournir ce contrat.
Fonctionnement des restrictions de lecture
Lorsqu'un lecteur charge une table via le catalogue REST Iceberg, le catalogue évalue les politiques applicables pour le principal demandeur et le contexte de la requête. Il peut renvoyer les actions de projection de colonnes et les expressions de filtrage de lignes requises, et le moteur approuvé doit appliquer ces restrictions lors de la lecture de la table.
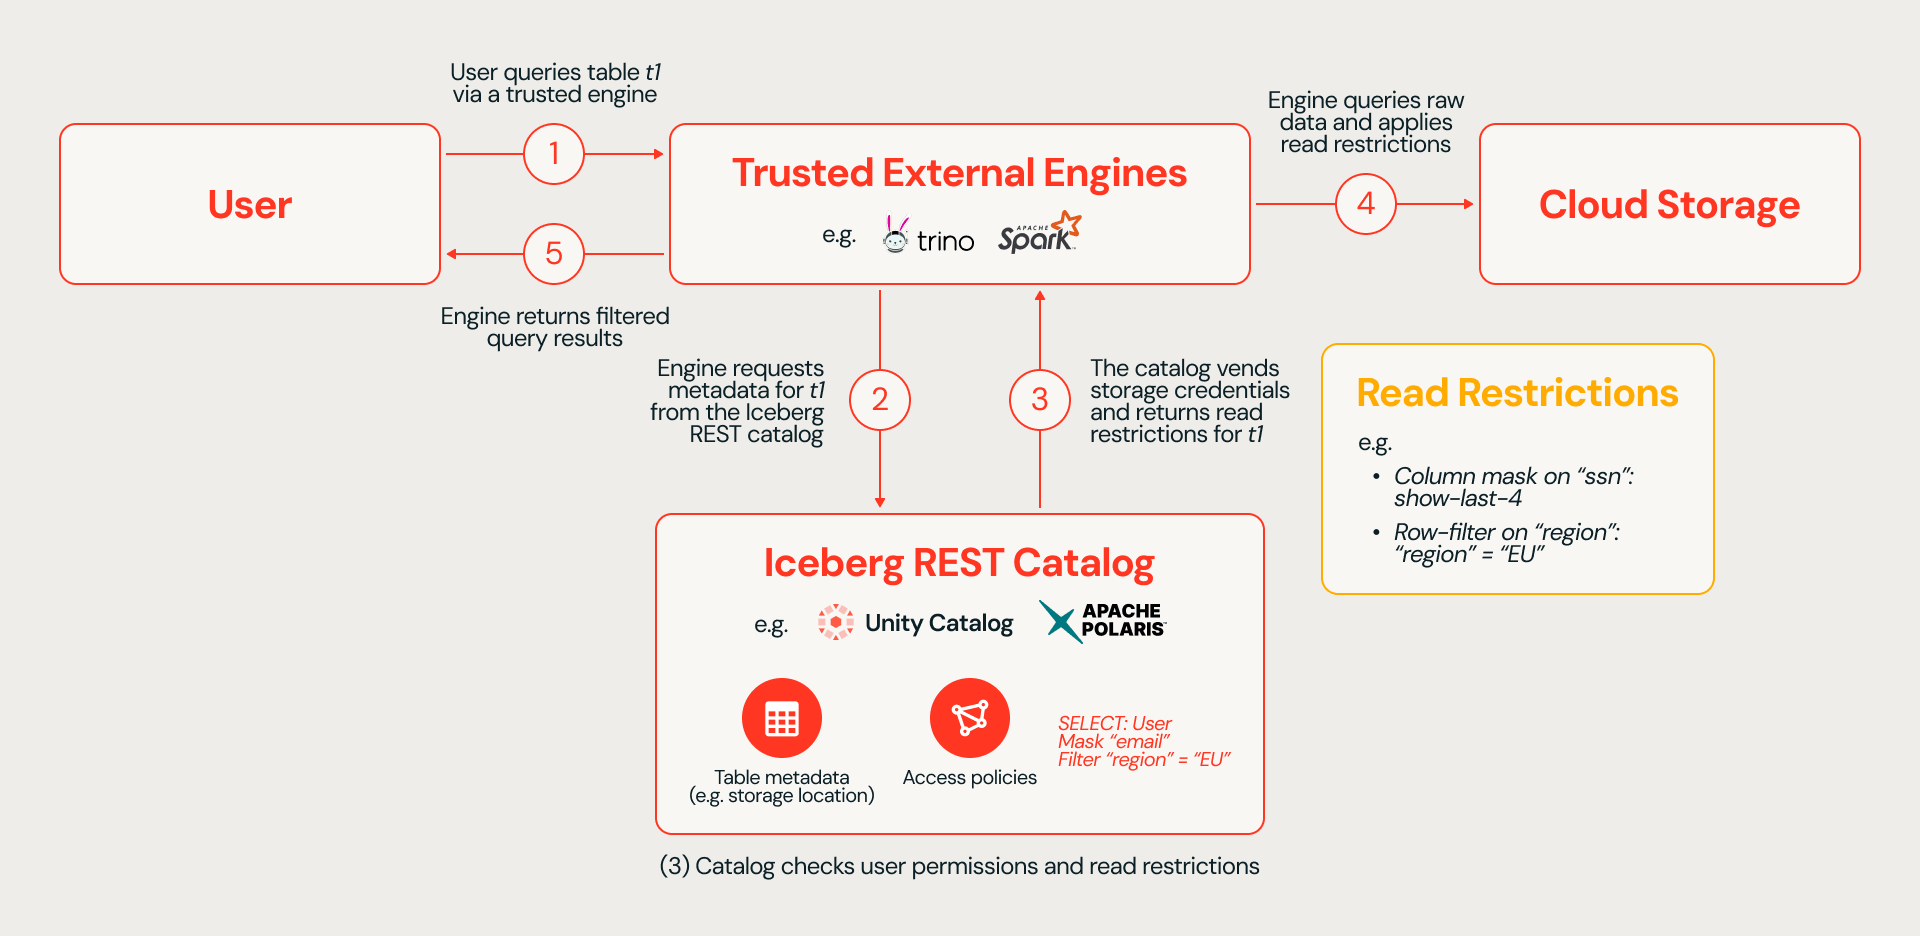
Deux décisions de conception sont importantes pour comprendre la portée actuelle de la proposition.
Tout d'abord, le moteur ne reçoit pas la politique telle que l'administrateur l'a définie. À la place, il reçoit le résultat pour un principal particulier, exprimé sous forme d'instructions de filtrage ou de masquage qu'il doit appliquer. Cela crée un contrat d'application commun entre le moteur et le catalogue. La spécification initiale définit un vocabulaire limité : neuf actions de projection de colonnes prédéfinies et des expressions de filtrage de lignes standardisées telles que les comparaisons ou l'appartenance à un ensemble. De nombreuses politiques d'entreprise réelles dépendent de sous-requêtes, de tables de correspondance ou d'UDF personnalisées, qui ne peuvent pas être exprimées dans le vocabulaire des restrictions de lecture. Cela a une implication importante : les politiques ne peuvent être représentées que lorsque le catalogue peut réduire leur résultat au vocabulaire défini par la norme, sinon vous perdez la sémantique de la politique.
Deuxièmement, la spécification définit ce qu'un moteur approuvé doit appliquer, mais pas la manière dont le catalogue établit cette confiance. Une simple déclaration du client ne suffit pas. Les administrateurs système et les implémentations doivent donc utiliser des mécanismes de sécurité adaptés à leur environnement. Les discussions au sein de la communauté Iceberg ont envisagé des mécanismes tels que mTLS et OAuth, mais la confiance reste en fin de compte en dehors du protocole (discussion de la communauté Iceberg).
Les restrictions de lecture sont particulièrement adaptées aux scénarios d'accès direct de moteur à catalogue, où les politiques du catalogue source sont simples et où un moteur approuvé peut appliquer la décision qui en résulte. De nombreuses questions d'implémentation subsistent, notamment sur la manière dont un moteur propage en toute sécurité l'identité et les attributs de l'utilisateur final, comment un catalogue distingue l'utilisateur du moteur agissant en son nom, et comment les informations d'identification sont liées à leur destinataire prévu. À mesure que les implémentations apparaissent, nous sommes ravis de collaborer avec la communauté Iceberg pour surmonter ces défis et faire évoluer la norme.
Étiquettes de catalogue : rendre le contexte de gouvernance portable
Les étiquettes de catalogue répondent à un scénario différent : la gouvernance à travers des catalogues fédérés.
De nombreuses entreprises connectent désormais plusieurs catalogues, tels que Unity Catalog, Snowflake, AWS Lake Formation et Google Cloud Knowledge Catalog, via la fédération et des API ouvertes. C'est plus complexe qu'une intégration de moteur à catalogue, car chaque catalogue dessert ses propres utilisateurs, applications et moteurs via des modèles d'identité, des langages de politique et des sémantiques distincts.
Toute solution de gouvernance unifiée fonctionnant à l'échelle de l'entreprise doit :
- Préserver l'expressivité des politiques. Les clients doivent pouvoir définir des règles sophistiquées, y compris des politiques basées sur des attributs et des sous-requêtes complexes, et les appliquer de manière cohérente sur des systèmes hétérogènes.
- Garantir une auditabilité et une responsabilité claires. Chaque catalogue doit pouvoir démontrer sa conformité de manière indépendante, sans que les administrateurs aient besoin de rapprocher les pistes d'audit entre plusieurs systèmes.
- Évoluer sans placer un autre service de catalogue sur le chemin critique. La découverte prenant en compte les autorisations dans le Catalogue A ne devrait pas nécessiter d'appel au Catalogue B pour chaque utilisateur et ressource. Par exemple, la plupart des expériences utilisateur dans Unity Catalog prennent en compte les autorisations, et le chargement de l'explorateur de catalogues ou la saisie semi-automatique pourraient sinon nécessiter des milliers de décisions par utilisateur qui sont difficiles à mettre en cache, ce qui ralentit l'expérience utilisateur et lie les performances et la disponibilité à un autre service.
Les étiquettes de catalogue, récemment adoptées par la communauté Iceberg, constituent la première étape vers cette vision. Les étiquettes permettent aux catalogues d'échanger des métadonnées clé-valeur légères au niveau des tables et des colonnes via des API ouvertes. Elles peuvent indiquer qu'un champ contient des PII, associer un jeu de données à un domaine métier ou fournir des indices sémantiques pour les modèles d'AI. La proposition étant générale, les étiquettes peuvent prendre en charge de nombreux cas d'usage au-delà du contrôle d'accès, notamment la découverte, la propriété, l'attribution des coûts, le contexte d'AI et la qualité des données.
Comment fonctionnent les étiquettes de catalogue
Lorsqu'un catalogue consommateur charge une table depuis un catalogue producteur via la fédération de catalogues, le catalogue producteur renvoie des étiquettes au niveau des tables et des colonnes.
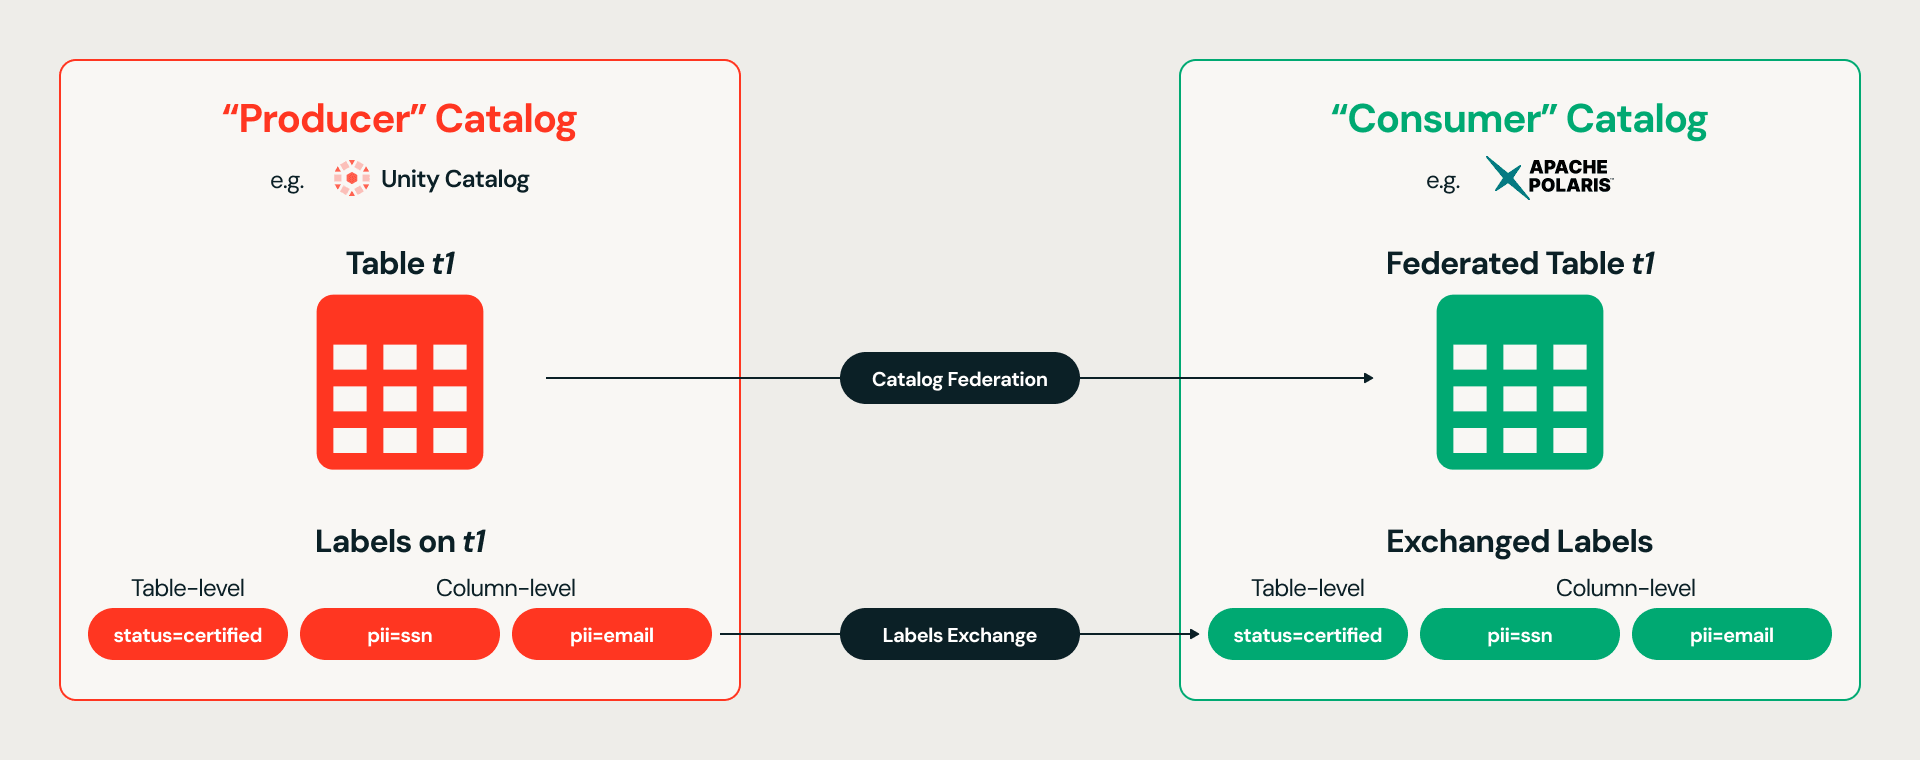
Le catalogue consommateur mappe ensuite les étiquettes dans ses propres classifications, attributs ou modèle de tags natif. Il évalue ensuite l'accès à l'aide de ses identités et politiques natives et applique les contrôles au sein de son propre runtime. Par exemple, si un catalogue producteur étiquette une colonne ssn avec pii=ssn, le catalogue consommateur peut appliquer une politique basée sur les tags qui masque les colonnes portant cette étiquette.
L'application des politiques restant locale, le catalogue consommateur préserve l'expressivité de ses politiques natives et évite d'appeler le catalogue producteur pour chaque décision d'accès. Chaque catalogue conserve également de manière indépendante ses registres d'application et sa piste d'audit.
Il convient de garder à l'esprit que les étiquettes sont des paires clé-valeur opaques. Le standard ne définit aucune sémantique partagée ni identifiant stable, et le lignage des étiquettes ne s'étend pas au-delà du catalogue source. Le catalogue consommateur reçoit uniquement la clé et la valeur résolues, sans savoir si l'étiquette était destinée à la découverte, au contrôle d'accès, à l'attribution des coûts ou à un autre usage. Les étiquettes rendent donc les métadonnées portables, mais pas leur signification ; les entreprises ont toujours besoin de conventions partagées ou de mappages explicites pour interpréter les étiquettes de manière cohérente.
Les étiquettes de catalogue sont particulièrement adaptées aux scénarios de catalogue à catalogue avec fédération entre systèmes hétérogènes, où le catalogue consommateur dispose de son propre système de gouvernance et a besoin d'un contexte réutilisable plutôt que d'une décision d'accès distincte pour chaque utilisateur et requête. L'idée fondamentale est que la gouvernance et le contexte métier, tout comme les métadonnées de table, doivent être ouverts et portables via les API Iceberg REST Catalog.
Choisir le bon modèle
Le bon modèle dépend de la destination : application centralisée pour un moteur non approuvé, restrictions de lecture pour un moteur approuvé, et étiquettes de catalogue pour un échange ouvert de métadonnées lorsque la destination est un autre catalogue disposant de son propre système de gouvernance.
Application centralisée via la planification du scan | Restrictions de lecture | Étiquettes de catalogue | |
Fonctionnement | Le catalogue source évalue et applique la politique via un service de filtrage sécurisé, ne renvoyant que les données autorisées | Au moment de la requête, le catalogue indique au moteur les restrictions à appliquer pour cet utilisateur et cette ressource spécifiques - par ex. « appliquer mask_alphanum sur la colonne 12 » | Les catalogues partagent des informations de gouvernance ou métier supplémentaires sur une table donnée - par ex. « la colonne 12 a la classification pii=ssn » |
Cas d'usage idéal | Accès direct depuis un moteur non approuvé, tel qu'un runtime Spark ou DuckDB contrôlé par l'utilisateur | Accès direct moteur-catalogue où la source évalue la politique et un moteur approuvé applique le résultat | Fédération entre systèmes hétérogènes disposant de leur propre identité, politique et runtime d'application |
Identité et sécurité | Le client doit traduire et transmettre les concepts d'identité (rôles, groupes, etc.) au catalogue. L'application reste dans la limite de confiance du catalogue, de sorte que les données non autorisées n'atteignent jamais le moteur. | Le client doit traduire les concepts d'identité (principaux, rôles, groupes, attributs utilisateur) en quelque chose que le catalogue comprend et transmettre ces attributs dans le cadre du contexte de la requête | La destination utilise les identités et les attributs qu'elle comprend déjà, ce qui réduit le contexte sensible échangé entre les systèmes |
Évolutivité, performances et disponibilité | La planification du scan côté serveur peut optimiser l'accès aux données, mais le routage des requêtes gouvernées via une flotte de filtres ajoute de la latence et une dépendance opérationnelle par rapport à une application dans le moteur consommateur. | Le catalogue de destination ne peut plus réutiliser une table mise en cache pour l'ensemble de ses utilisateurs, car les réponses de table deviennent spécifiques à chaque utilisateur. Par conséquent, des expériences telles que la navigation, la recherche et la saisie semi-automatique nécessitent un cache par utilisateur ou un appel distinct au catalogue source pour chaque action de l'utilisateur. | Le contexte de gouvernance peut être mis en cache et actualisé afin que la recherche, la navigation et d'autres expériences utilisateur soient alimentées de manière native |
Gouvernance et auditabilité | Le catalogue source conserve toute l'expressivité de sa politique native et enregistre l'évaluation et l'application de la politique au sein du même environnement de confiance | Les décisions sont limitées au vocabulaire partagé du standard. Les enregistrements d'audit sont répartis entre les systèmes source et de destination. | La destination utilise son moteur de politique natif et conserve un enregistrement de bout en bout de l'évaluation et de l'application |
En résumé | À utiliser lorsque le catalogue source doit garantir que les données non autorisées ne parviennent jamais à un moteur non approuvé | À utiliser lorsque la destination est un moteur approuvé et que les politiques sources peuvent être entièrement exprimées avec des restrictions de lecture | À utiliser lorsque la destination est un autre catalogue qui nécessite une gouvernance évolutive à vitesse native pour l'ensemble de ses utilisateurs et moteurs |
Et ensuite
Les restrictions de lecture et les étiquettes de catalogue résolvent deux problèmes distincts et importants pour la gouvernance multiplateforme. Les restrictions de lecture offrent aux catalogues un moyen standard de déléguer l'application des règles à des moteurs approuvés. Les étiquettes de catalogue rendent la gouvernance et le contexte métier portables d'un catalogue à l'autre, tout comme vos données. Associées à une application centralisée via Cross-Engine ABAC, elles offrent aux entreprises un ensemble d'options pratiques pour gouverner les données de manière cohérente à travers les moteurs et les catalogues.
Félicitations à la communauté Apache Iceberg pour avoir adopté ces deux propositions. Bien qu'il reste encore du travail, il s'agit d'une étape importante. Nous sommes ravis de voir une plus grande partie de l'écosystème adopter ces briques fondamentales, et de continuer à travailler avec la communauté pour faire de la gouvernance unifiée au sein du lakehouse ouvert une réalité.
1Les propres consignes de sécurité d'Apache Spark indiquent que le code soumis par l'utilisateur s'exécute sans restriction sur son comportement et donne aux utilisateurs le contrôle des ressources attribuées à leur application. Une extension Spark peut implémenter des restrictions de lecture, mais le déploiement n'est qualifié d'approuvé que lorsque les administrateurs contrôlent l'environnement d'exécution et éliminent toute possibilité de contourner l'application des règles, car il ne dispose pas d'une API de contrôle d'accès au niveau de la table, et encore moins d'une API pour le contrôle d'accès fin (discussion de la communauté Iceberg).
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.