Un guide pratique des applications sur Databricks
01 | Introduction à la création d'applications sur Databricks
À mesure que les capacités en IA et en analytique gagnent en maturité au sein des organisations, un nouveau défi a émergé : fournir des informations exploitables sous une forme que les gens peuvent réellement utiliser.
Les équipes data disposent aujourd'hui d'outils puissants pour l'exploration et l'analyse. Les notebooks permettent une itération rapide, les tableaux de bord offrent une large visibilité et les modèles pilotent la prédiction et l'automatisation. Mais lorsque les exigences métier évoluent vers une application interactive qui combine des données en temps réel avec des entrées utilisateur — comme un assistant IA intégré à un workflow ou un outil personnalisé adapté à un processus opérationnel spécifique — les équipes se heurtent souvent à un mur.
Historiquement, la création d'applications de production impliquait de sortir complètement de la plateforme de données. Le passage de l'analyse à l'application impliquait le provisionnement de l'infrastructure, la configuration des bases de données, la mise en œuvre de l'authentification, la configuration des pipelines de déploiement et la gestion des audits de sécurité. Chaque étape ajoutait des coûts, des risques et des délais — sans contribuer directement à la valeur commerciale de l'application. Pour de nombreuses organisations, ce défi du dernier kilomètre a retardé les applications de plusieurs mois ou a empêché leur mise en production.
Le problème n'est pas un manque de données ou de capacité d'IA. Le défi consiste à fournir ces fonctionnalités sous forme d'applications fiables et de qualité production que d'autres peuvent utiliser.
Ce guide est conçu pour vous aider à combler cet écart. Grâce à des guides pratiques, des exemples de code fonctionnels et des modèles concrets, vous apprendrez comment les applications Databricks Apps et Lakebase fonctionnent ensemble pour faire passer une application d'un prototype fonctionnel à une application de production sans quitter la plateforme.
Le défi du déploiement d’applications
Pour les équipes qui développent aujourd'hui des applications de données et d'IA, le chemin qui mène du prototype fonctionnel au déploiement en production est semé de tâches lourdes et indifférenciées. Que vous soyez un data engineer maîtrisant Python qui étend une analyse ou un développeur JavaScript qui développe sur des données lakehouse, vous rencontrez les mêmes obstacles :
- Provisionnement et gestion de l'infrastructure : chaque application a besoin d'un environnement d'exécution. Traditionnellement, cela implique le provisionnement de machines virtuelles ou de conteneurs, la configuration d'équilibreurs de charge, la mise en place de certificats SSL et la gestion des politiques de mise à l'échelle.
- Complexité de l'authentification et de la sécurité : les applications de production nécessitent des flux d'authentification sécurisés, une gestion des informations d'identification et des contrôles d'accès. Implémenter correctement l'autorisation ouverte (OAuth), assurer la rotation des secrets et garantir la conformité avec les politiques de sécurité exige des connaissances spécialisées. Une mauvaise mise en œuvre crée des vulnérabilités, tandis qu'une mise en œuvre correcte demande un effort d'ingénierie important.
- Synchronisation des données et latence : les applications interactives nécessitent un accès rapide aux données, mais les magasins de données analytiques ne sont pas optimisés pour les modèles d'accès à faible latence et à forte simultanéité que requièrent les applications orientées utilisateur. La création de pipelines pour déplacer les données des systèmes analytiques vers les bases de données opérationnelles et la conservation de ces données à jour ajoutent une couche supplémentaire de complexité et des points de défaillance potentiels.
- Automatisation du déploiement et gestion de l'environnement : le déplacement du code du développement à la préproduction, puis à la production, nécessite des pipelines d'intégration continue et de livraison continue (CI/CD), la configuration de l'environnement et une coordination minutieuse
- Gouvernance et conformité : les applications d'entreprise doivent respecter les politiques d'accès aux données, maintenir des pistes d'audit et appliquer des autorisations précises. L'implémentation de contrôles de gouvernance dans le code de l'application (distincte de la gouvernance déjà établie dans la plateforme de données) duplique le travail et crée des risques de drift des politiques.
Ces défis engendrent des coûts réels. La complexité du déploiement freine l'élan : lorsque vous ne pouvez pas livrer les modifications rapidement et en toute confiance, vous ralentissez l'itération et perdez du temps à vous coordonner entre les équipes. Par conséquent, des fonctionnalités précieuses restent verrouillées au sein de la plateforme de données, accessibles uniquement à certains utilisateurs techniques plutôt qu'à l'ensemble de l'organisation.
Applications Databricks et Lakebase : une plateforme d'applications unifiée
Databricks relève ces défis en intégrant l'hébergement d'applications et les bases de données opérationnelles directement dans la Data Intelligence Platform. Plutôt que de nécessiter une infrastructure distincte pour les applications, Databricks fournit une solution intégrée où les applications s'exécutent aux côtés des données et des capacités d'IA dont elles dépendent.
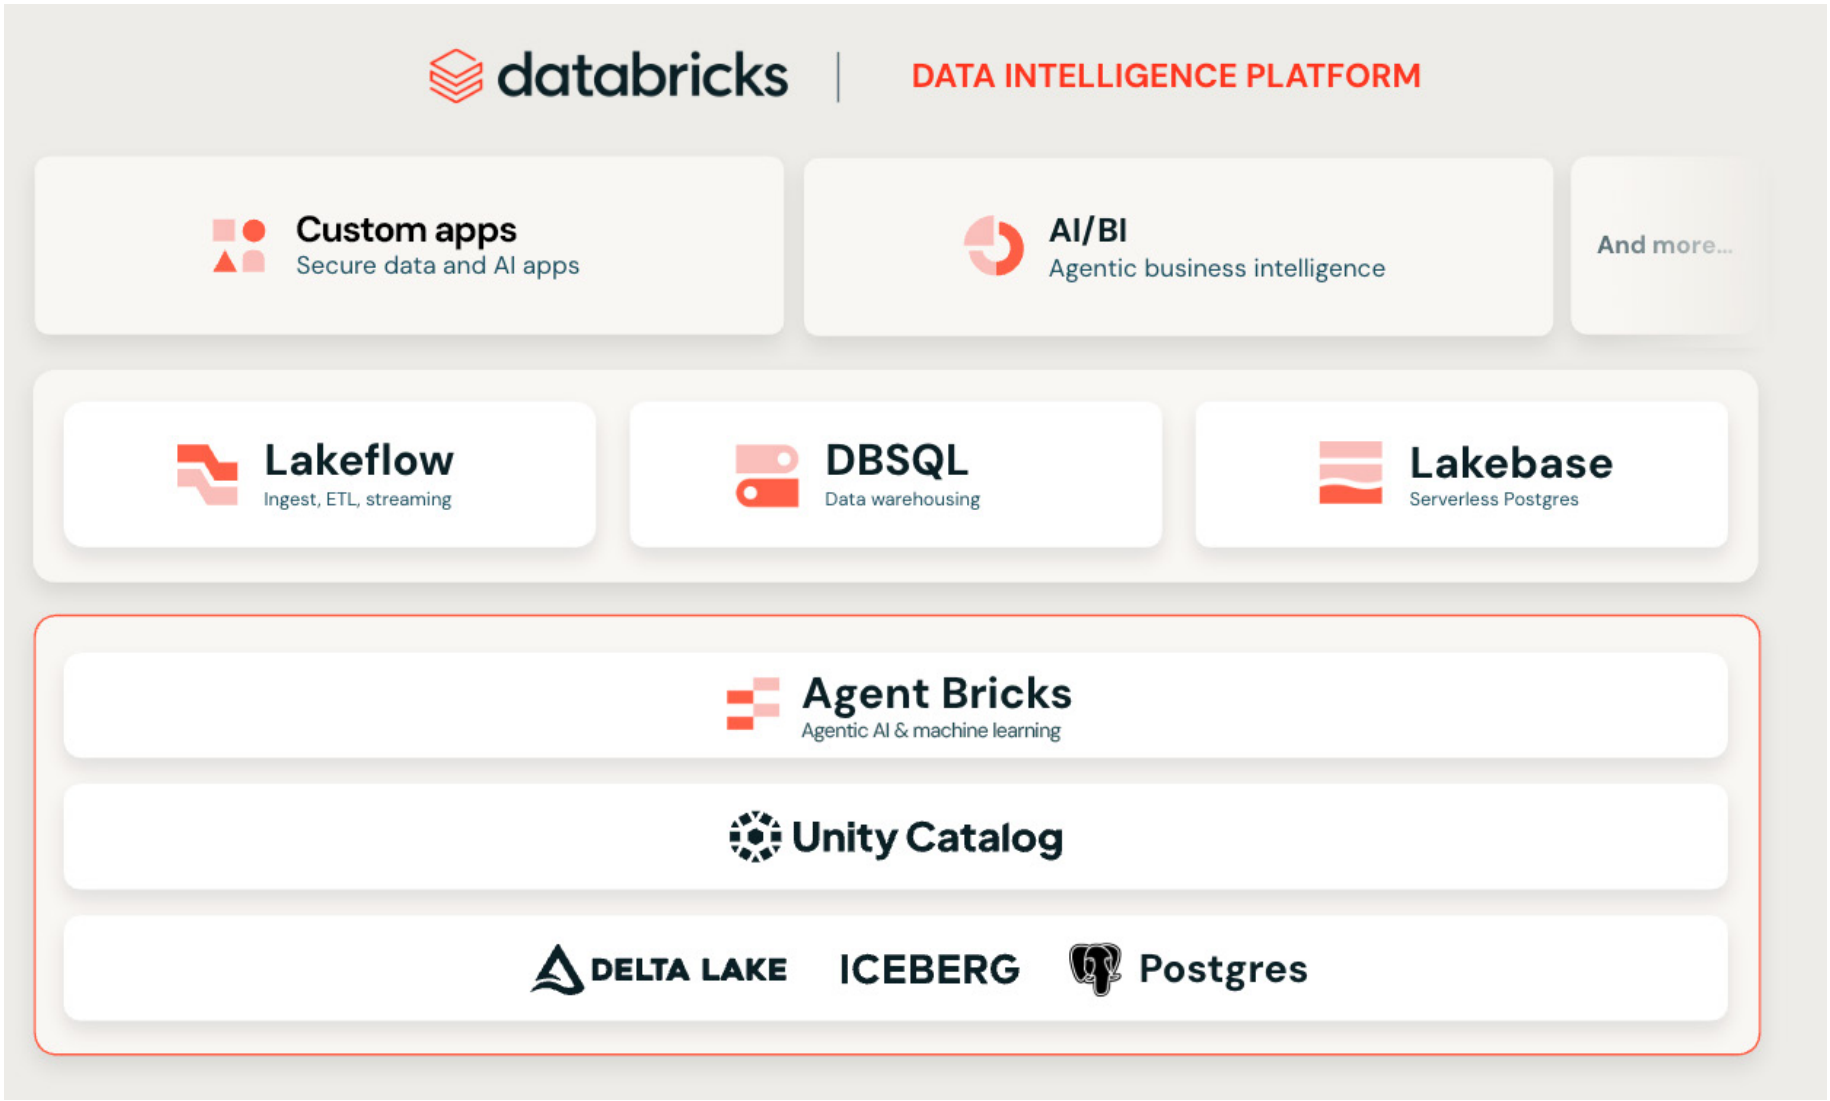
Databricks Apps fournit une plateforme d'hébergement d'applications Serverless pour exécuter des applications web créées avec des frameworks open source comme Streamlit, Dash, Flask, FastAPI et React. Les applications héritent des fonctionnalités intégrées de sécurité, de conformité et de gestion des ressources de la plateforme. Il n'y a aucune infrastructure à provisionner, aucun conteneur à gérer et aucune politique de mise à l'échelle à configurer. Les applications s'intègrent automatiquement à Unity Catalog pour la gouvernance et prennent en charge à la fois l'authentification par Service Principal pour l'accès au niveau de l'application et l'autorisation au nom de l'utilisateur pour les autorisations au niveau de l'utilisateur.
Lakebase est une base de données PostgreSQL entièrement managée et étroitement intégrée au lakehouse. Elle fournit l'accès transactionnel aux données à faible latence dont les applications interactives ont besoin, tout en synchronisant automatiquement les données des tables Unity Catalog. Avec Lakebase, vous pouvez :
- Fournir des informations analytiques aux applications en temps réel
- Stocker l'état de l'application et les entrées utilisateur
- Maintenir une prise en charge complète des transactions ACID (atomicité, cohérence, isolation et durabilité).
Tout cela est possible sans créer de pipelines ETL (extraction, transformation, chargement) personnalisés ni gérer d'infrastructure de base de données.
Ensemble, ces capacités transforment le champ des possibles :
| APPROCHE TRADITIONNELLE | APPLICATIONS DATABRICKS MODERNES ET APPROCHE LAKEBASE |
|---|---|
| Infrastructure d'hébergement distincte | Serverless compute et aucune gestion d'infrastructure |
| Systèmes d'authentification personnalisés | Intégration intégré d'OAuth et d'Unity Catalog |
| Pipelines de synchronisation manuelle des données | Tables synchronisées automatiquement depuis Unity Catalog |
| Gouvernance fragmentée entre les systèmes | Gouvernance unifiée via Unity Catalog |
| Déploiement complexe et multi-outils | Déploiement en une seule commande avec les Databricks Asset Bundles (DAB) |
Historiquement, faire le pont entre les systèmes OLTP et OLAP impliquait une ingénierie des données complexe et des couches d'intégration sur mesure. Le déploiement d'applications nécessitait des équipes DevOps distinctes, des pipelines CI/CD hétérogènes et des configurations de sécurité manuelles. Avec Lakebase et Databricks Apps, ces complexités sont considérablement réduites. Les développeurs peuvent accéder aux données analytiques en temps réel directement depuis la couche transactionnelle et déployer des applications interactives en quelques minutes plutôt qu'en plusieurs mois.
Contenu de ce guide
Ce guide fournit des instructions pratiques pour développer des applications de données et d'IA prêtes pour la production sur Databricks. Plutôt que de se concentrer sur des fonctionnalités isolées, chaque chapitre présente un modèle d'application complet à l'aide d'un code fonctionnel que vous pouvez adapter à vos propres cas d'utilisation.
Vous verrez comment :
- Passez des notebooks et des prototypes à de véritables applications
- Servir les données analytiques et l'état de l'application via une couche transactionnelle
- Créer des applications sécurisées et gouvernées sans infrastructure personnalisée
- Déployez et exploitez des applications à l'aide de modèles reproductibles et prêts pour la production
À la fin de ce guide, vous comprendrez clairement comment créer, déployer et gérer des applications intelligentes sur la Databricks Platform en toute confiance.
02 | Des notebooks aux applications en production
par Pascal Vogel, Evan Pandya et Christopher Pries
Le défi des applications de données de production
La création d'applications de données prêtes pour la production est complexe. Vous avez souvent besoin d'outils distincts pour héberger l'application, gérer la base de données et déplacer des données entre les systèmes. Chaque couche ajoute une surcharge de configuration, de maintenance et de déploiement.
La Databricks Data Intelligence Platform simplifie ce processus en regroupant tout sur une seule et même plateforme : la Databricks Data Intelligence Platform. Databricks Apps exécute des applications web sur un compute serverless. Lakebase fournit une base de données Postgres gérée qui se synchronise avec Unity Catalog, offrant aux applications un accès rapide aux données régies. Et avec les Databricks Asset Bundles (DABs), vous pouvez packager le code, l'infrastructure et les pipelines de données et les déployer avec une seule commande.
Ce chapitre montre comment ces trois éléments fonctionnent ensemble pour créer et déployer une véritable application de données, depuis la synchronisation des données Unity Catalog avec Lakebase jusqu'à l'exécution d'une application web sur la Databricks Platform et l'automatisation du déploiement avec les DAB.
Architecture et fonctionnement
Nous allons examiner une application de courses de taxi qui illustre l'ensemble du modèle : une application React et FastAPI qui lit les tables synchronisées de Lakebase, avec des mises à jour automatiques des données à partir des tables Delta d'Unity Catalog qui s'effectuent en quelques secondes.
Le diagramme suivant offre une vue simplifiée de l’architecture de la solution.
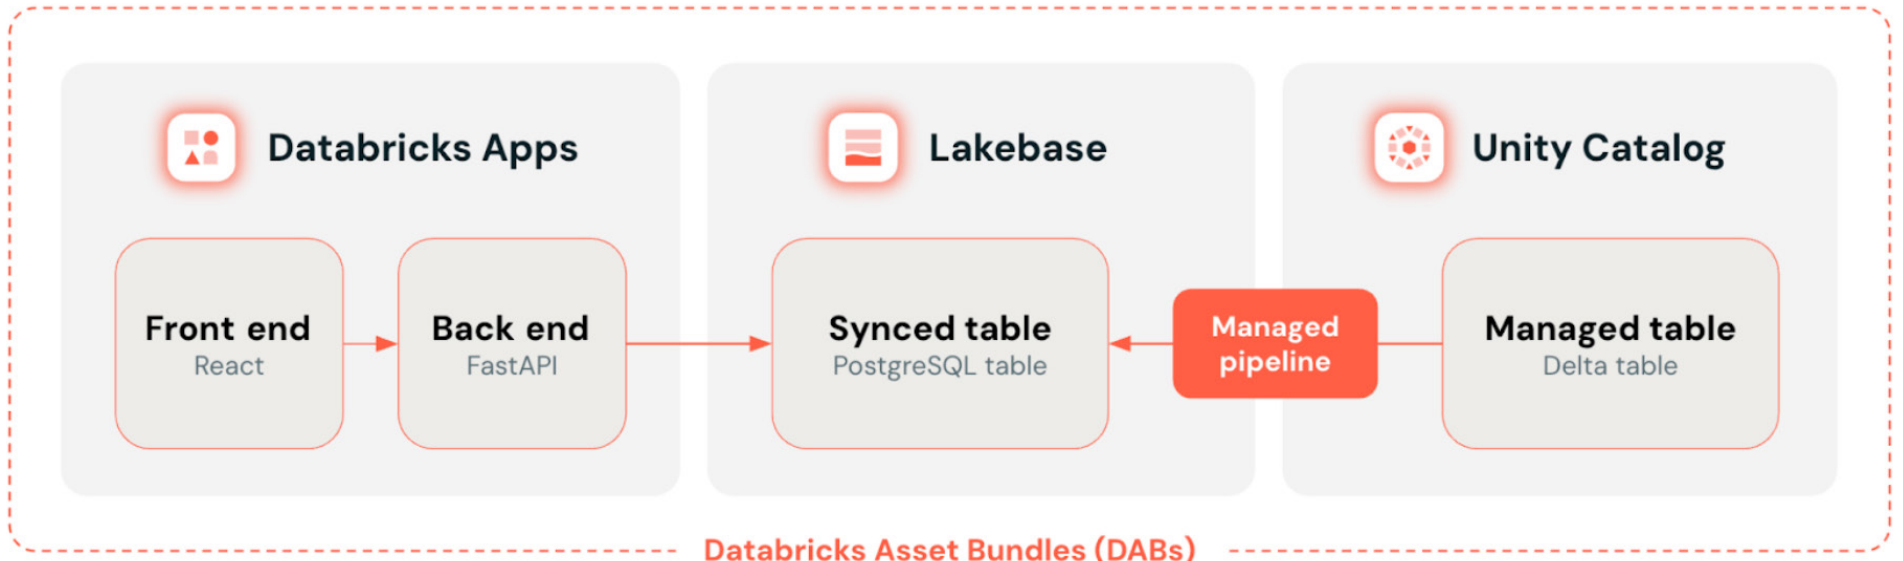
De manière générale, Databricks Apps sert de front-end où les utilisateurs explorent et visualisent les données. Lakebase fournit la base de données Postgres que l'application interroge, la maintenant au plus près des données en temps réel de Unity Catalog avec des tables synchronisées. Les DABs rassemblent tout en définissant et en déployant toutes les ressources (application, base de données et synchronisation des données) en une seule unité versionnée.
Principaux composants de la solution :
- Application Databricks: les utilisateurs interagissent avec une application web développée à l'aide de React, TypeScript, Vite et FastAPI. L'application lit les données d'une table synchronisée Unity Catalog stockée dans une base de données Postgres Lakebase.
- Table synchronisée Unity Catalog: Une table Postgres en lecture seule qui est automatiquement synchronisée avec une table Unity Catalog via un pipeline de synchronisation géré et s'exécute sur une instance de base de données Lakebase
- Instance de base de données Lakebase: Gère le stockage et le compute Lakebase et fournit des Endpoints Postgres pour que l’application Databricks puisse se connecter
- Unity Catalog table: une table Delta contenant des données sur les courses de taxi à New York, clonée depuis la table d'exemple disponible dans samples.nyctaxi.trips de chaque Workspace de base de données
- Databricks Asset Bundles (DABs): un ensemble dans lequel tous les éléments clés de l'architecture sont définis dans le code
L'application d'exemple affiche les trajets en taxi récents sous forme de tableau et de graphique, et recherche automatiquement les nouveaux trajets. Elle lit les données d'une table synchronisée Lakebase, qui est un miroir d'une table Delta dans Unity Catalog.
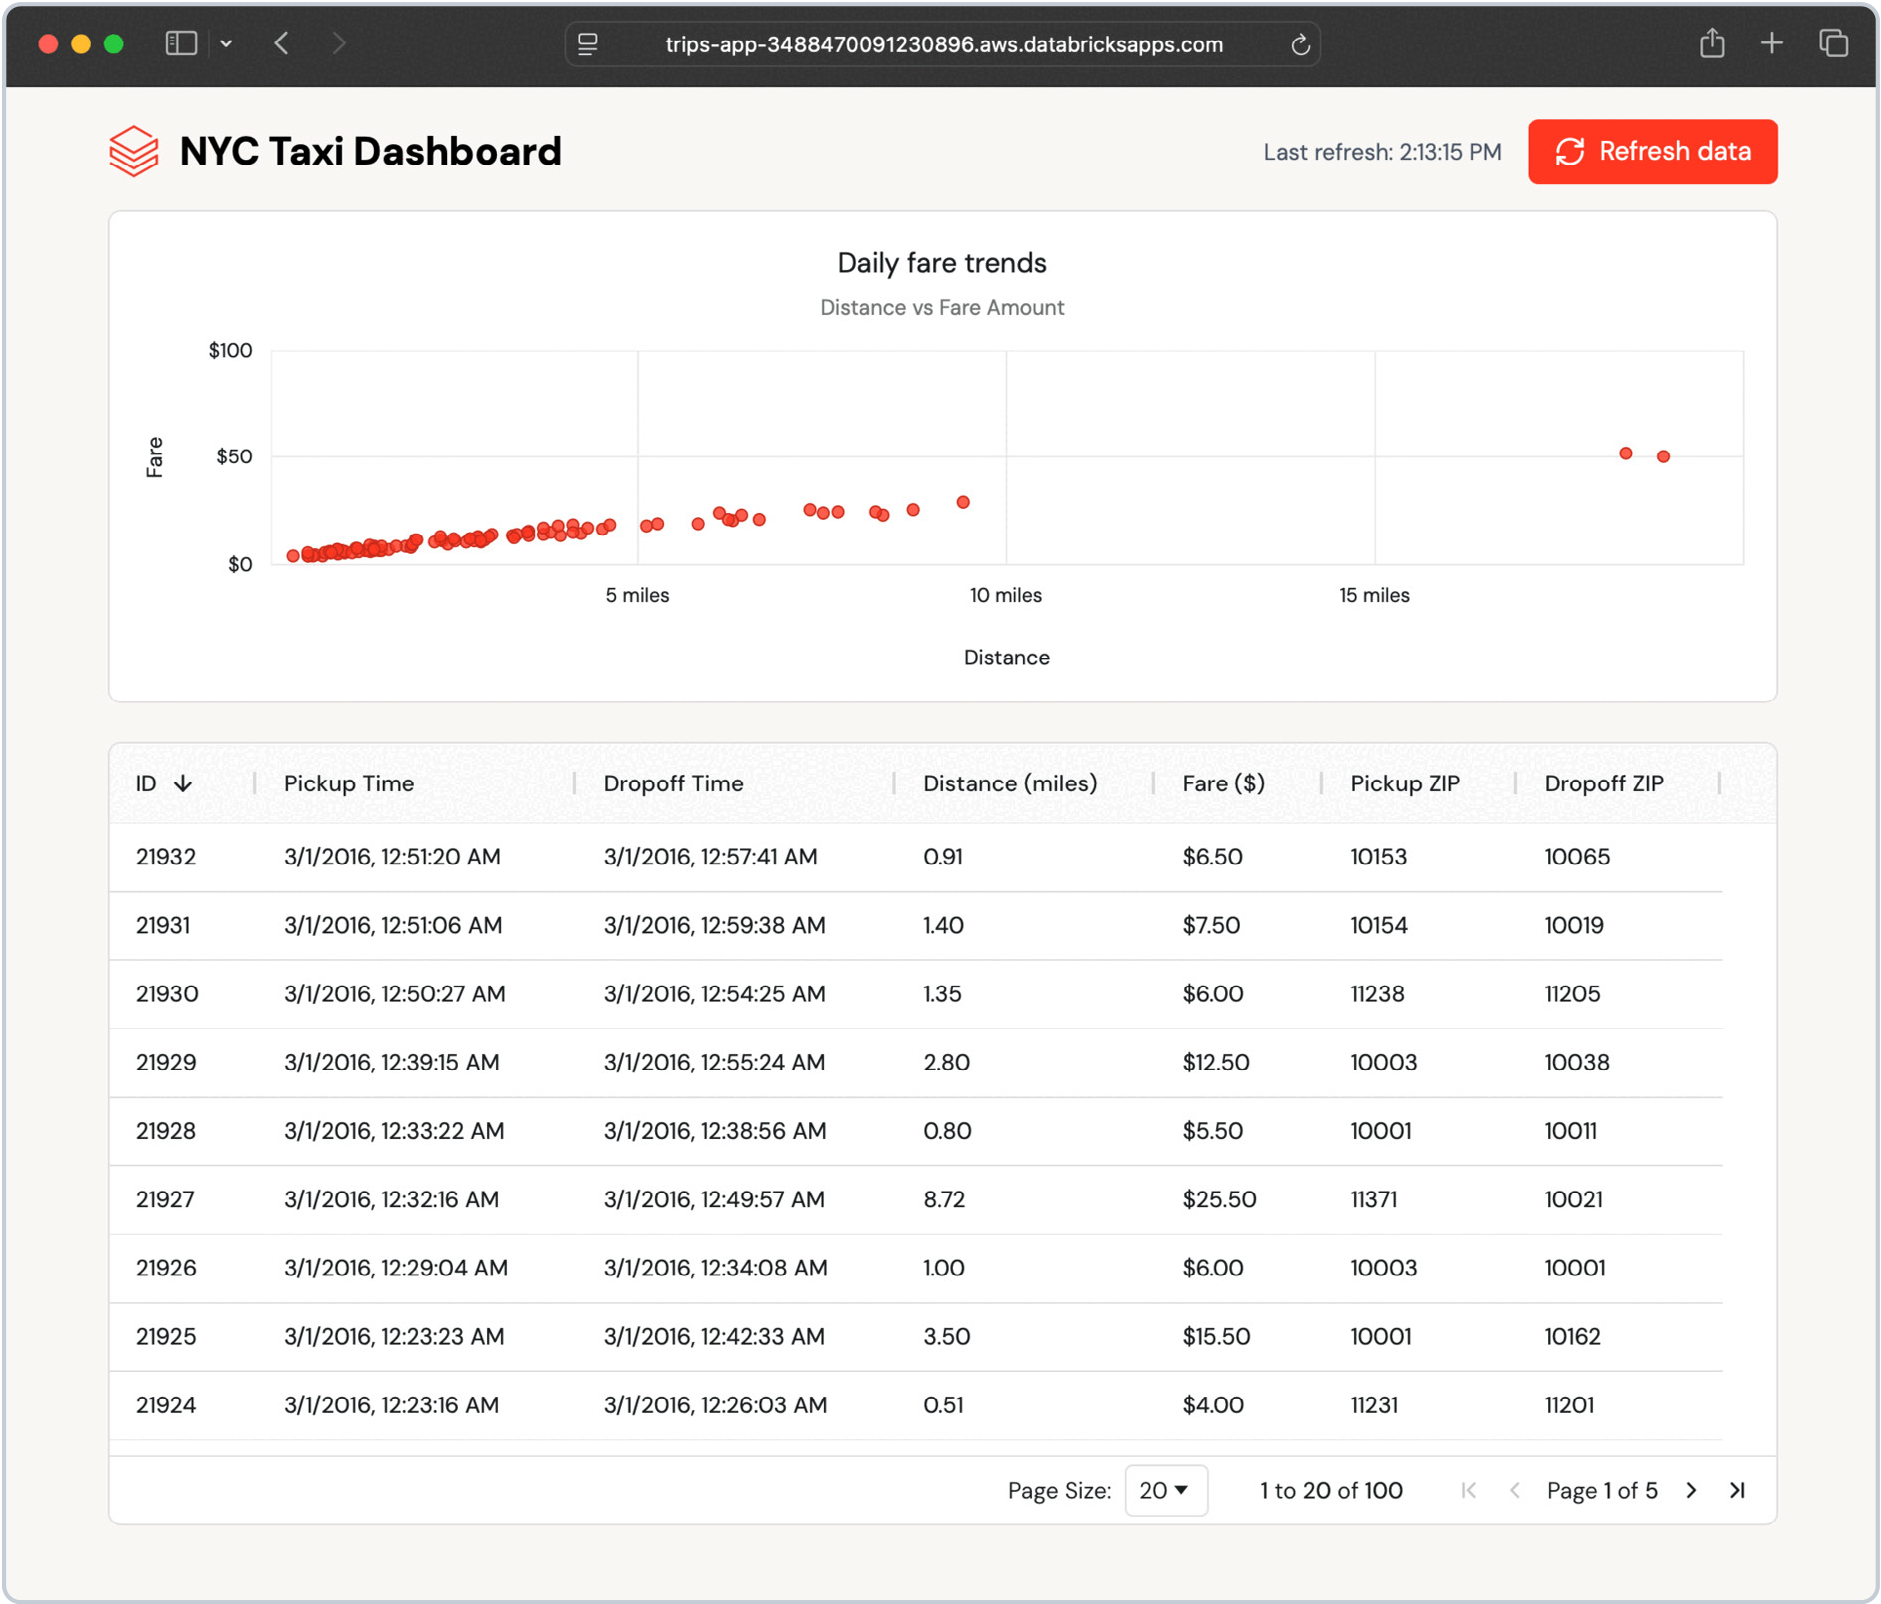
Comme la table synchronisée se met à jour automatiquement, toute modification dans la table Unity Catalog apparaît dans l'application en quelques secondes, sans qu'aucun ETL personnalisé ne soit nécessaire.
Vous pouvez tester cela en insérant de nouvelles données dans la table Delta source, puis en actualisant la table synchronisée :
Trigger ensuite une refresh de la table synchronisée trips_synced :
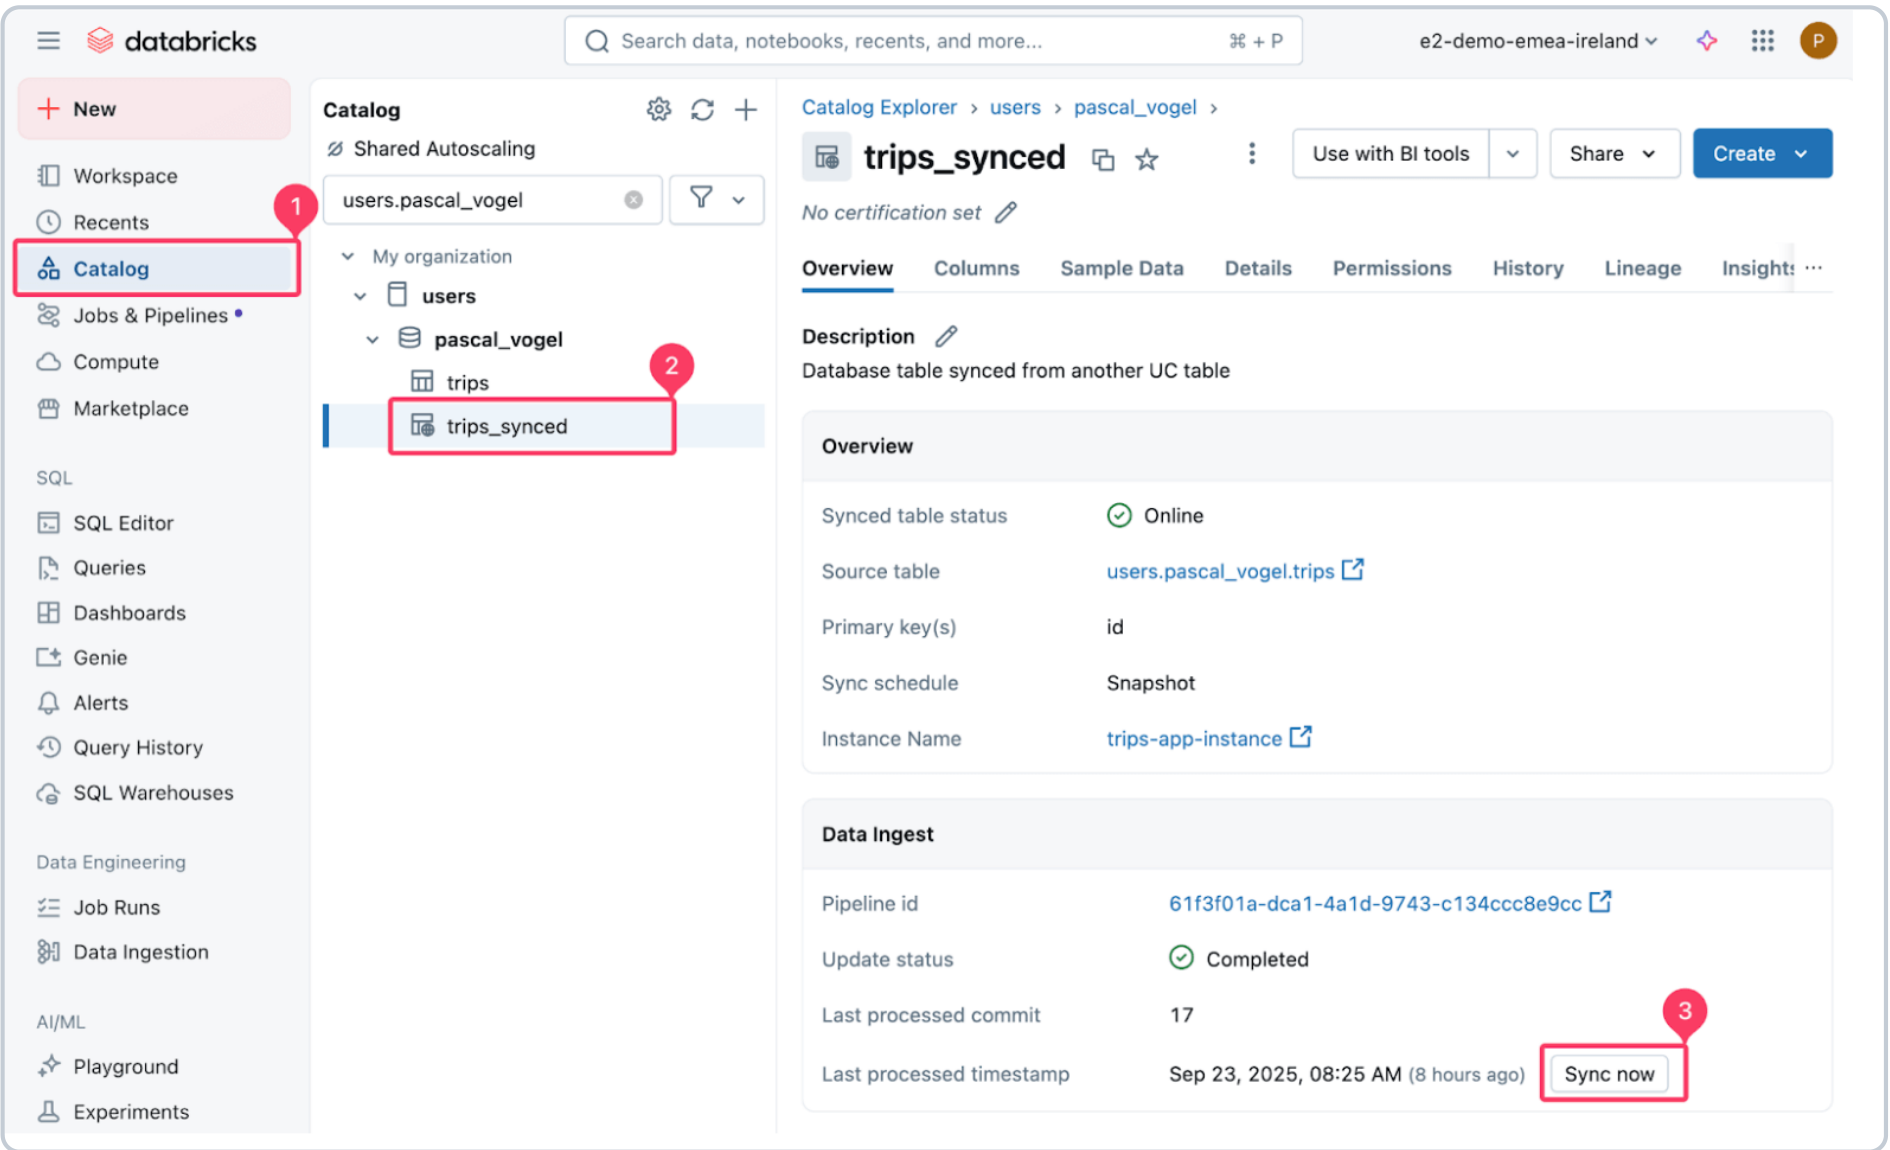
Le pipeline géré qui alimente la synchronisation crée une copie d'instantané de la table Delta source et l'écrit dans la table Postgres cible.
En quelques secondes, les nouveaux enregistrements apparaissent dans le tableau de bord. L'application recherche les mises à jour et permet aux utilisateurs de refresh à la demande, démontrant comment Lakebase maintient les données opérationnelles à jour sans nécessiter de Data Engineering supplémentaire.
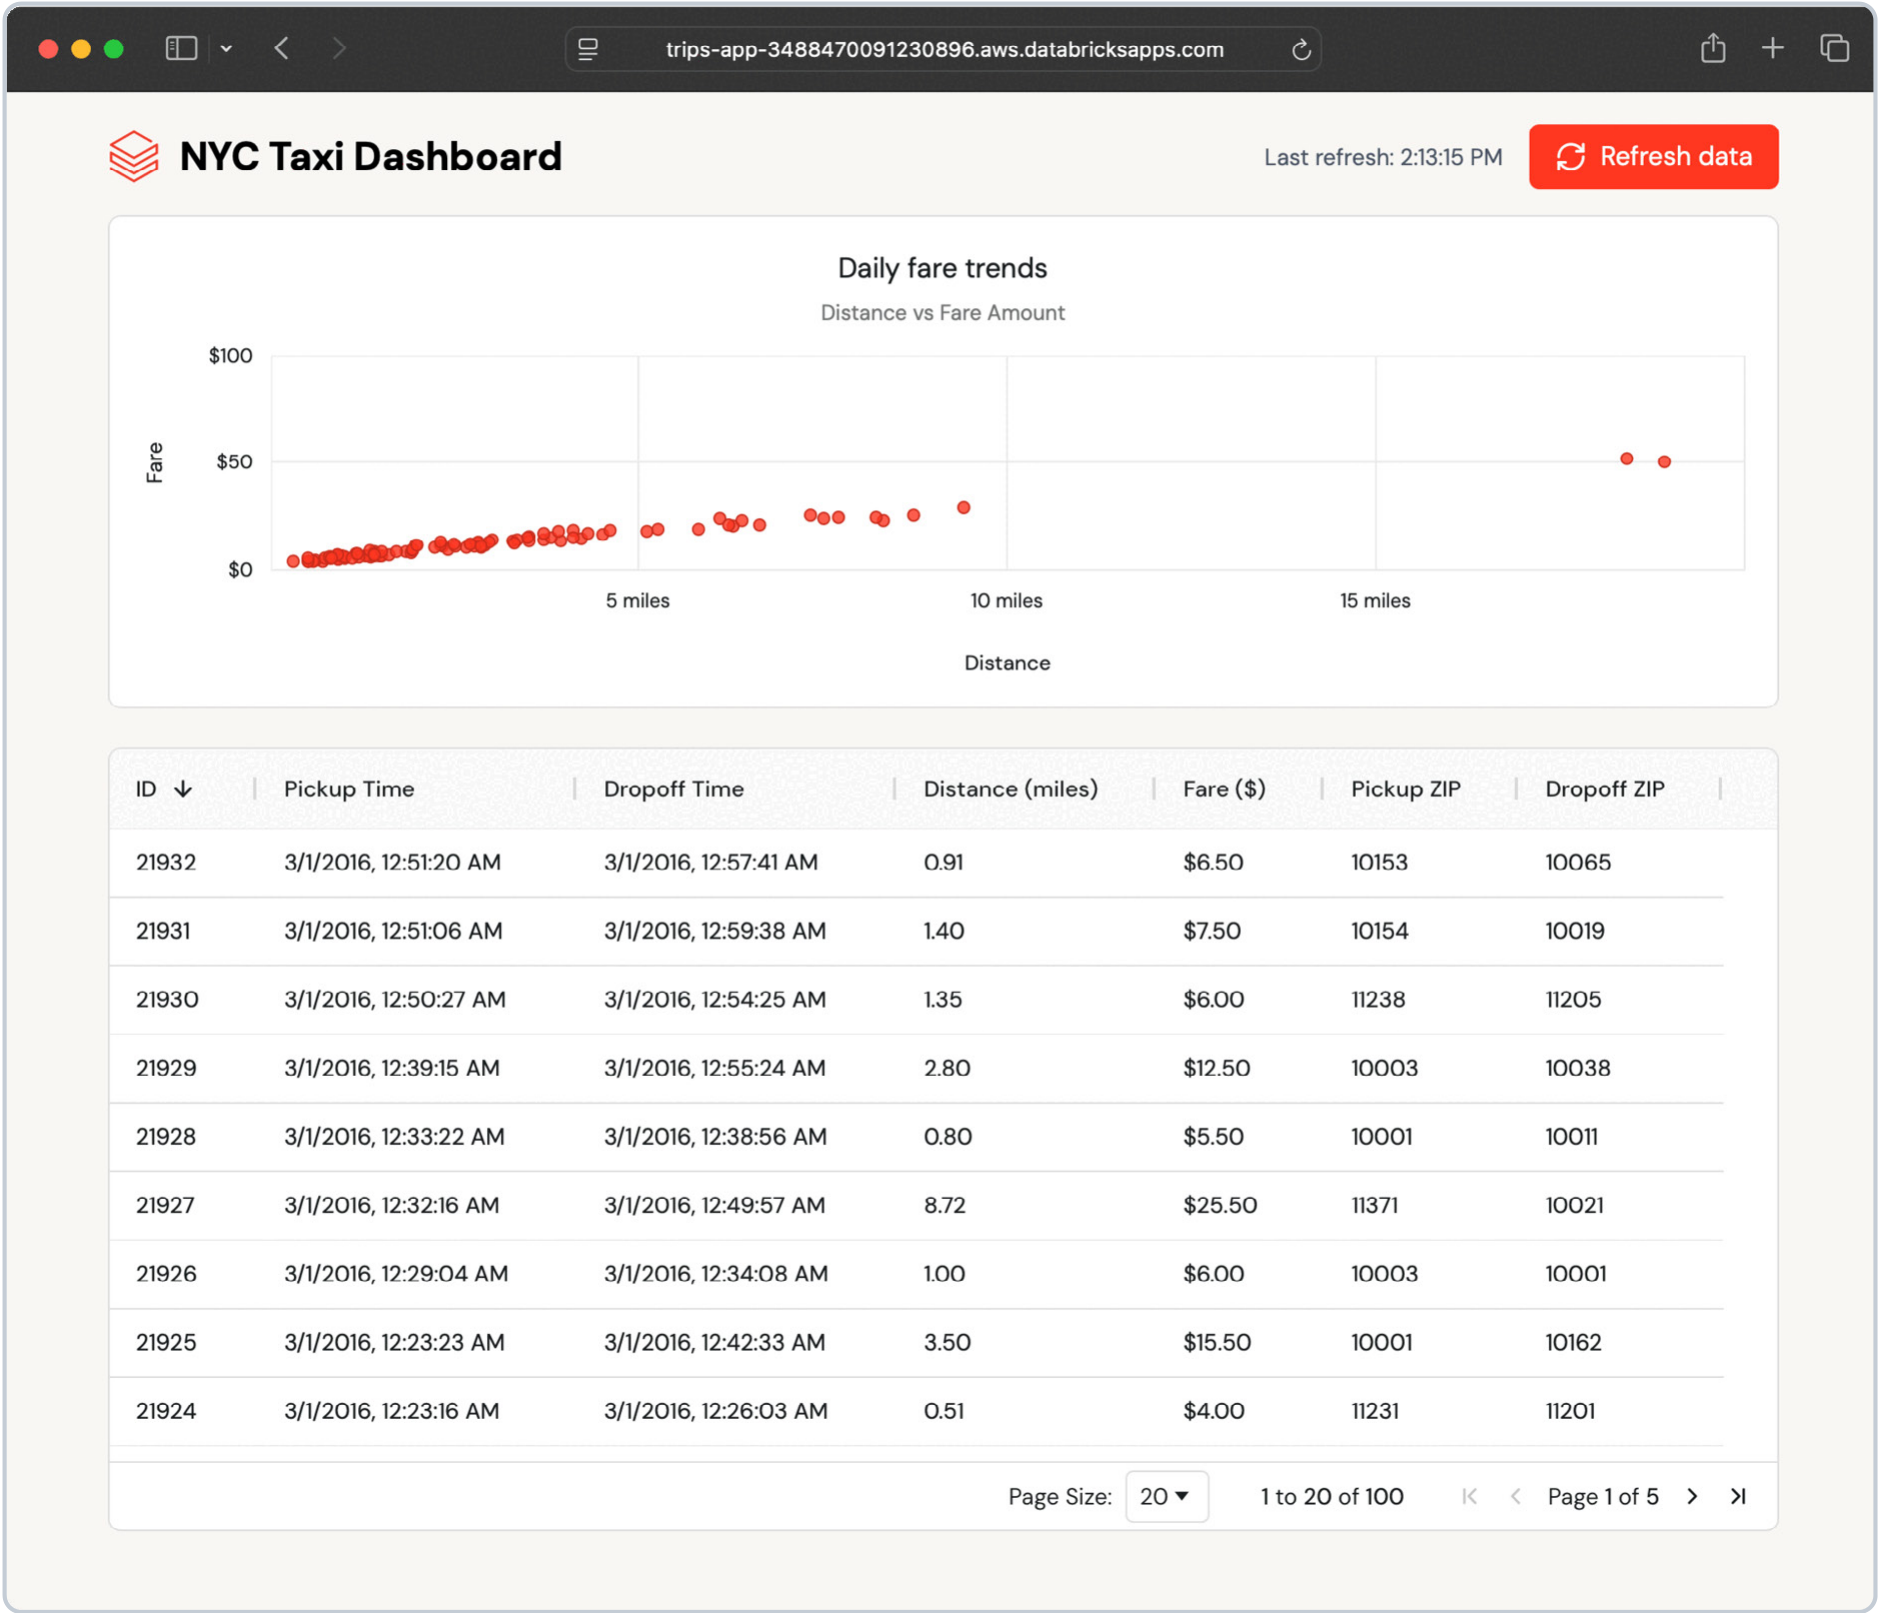
Ce flux de données fluide est possible, car les tables synchronisées Lakebase gèrent automatiquement toute la synchronisation.
Anatomie de l'application
Examinons comment les différents éléments de la solution s'articulent dans l'application Databricks.
Authentification et connexion à la base de données
Chaque application Databricks dispose d'une identité unique de Service Principal attribuée lors de sa création, qu'elle utilise pour interagir avec d'autres ressources Databricks, y compris Lakebase.
Lakebase prend en charge l'authentification OAuth de machine à machine (M2M). Une application peut obtenir un jeton valide en utilisant le WorkspaceClient dans le Databricks SDK pour Python avec ses informations d'identification de Service Principal. Le WorkspaceClient gère l'actualisation du jeton OAuth à courte durée de vie, qui expire au bout d'une heure.
L'application utilise ensuite ce jeton lors de l'établissement d'une connexion à Lakebase à l'aide de l'adaptateur Psycopg Python Postgres :
L'hôte Postgres et le nom de la base de données sont automatiquement définis comme variables d'environnement pour l'application Databricks lors de l'utilisation de la ressource Lakebase pour les applications.
L'utilisateur Postgres est soit le Service Principal — lorsqu'il est déployé sur Databricks Apps — soit le nom d'utilisateur Databricks de l'utilisateur qui exécute l'application localement.
Back-end RESTful FastAPI
Le backend FastAPI de l'application utilise cette connexion pour interroger Lakebase et récupérer les dernières données sur les trajets depuis la table synchronisée :
En plus de servir des Endpoint d'API, FastAPI peut également servir des fichiers statiques à l'aide de la classe StaticFiles. En regroupant notre front-end React à l'aide du processus de build de Vite, nous pouvons générer un ensemble de fichiers statiques que nous pouvons servir avec FastAPI.
Front end React
Le front-end React appelle le FastAPI Endpoint pour afficher les données :
L'application d'exemple utilise ag-grid et ag-charts pour la visualisation et vérifie automatiquement la présence de nouvelles données toutes les quelques secondes :
Définition des ressources Databricks Asset Bundles
Toutes les ressources Databricks et le code d'application présentés ci-dessus peuvent être gérés en tant que DAB dans un seul repository de code source. Cela signifie également que toutes les ressources peuvent être déployées dans un Databricks Workspace avec une seule commande. Consultez le GitHub repository pour obtenir des instructions de déploiement détaillées.
Cela simplifie le cycle de vie du développement logiciel et permet des déploiements via les meilleures pratiques CI/CD dans les environnements de développement, de préproduction et de production.
Les sections suivantes expliquent les fichiers de bundle plus en détail.
Configuration du bundle
Le fichier databricks.yml contient la configuration du bundle DABs sous la forme de paramètres de bundle et de ressources incluses :
Dans notre exemple, nous définissons uniquement un environnement de développement et un environnement de préproduction.
Pour un cas d'utilisation en production, envisagez d'ajouter des environnements supplémentaires. Consultez le Databricks DAB examples repositoryet la documentation DABs pour des exemples de configuration plus avancés.
Configuration de Lakebase et synchronisation avec Unity Catalog
Pour définir une instance Lakebase dans les DABs, utilisez la ressource database_instance. Au minimum, nous devons définir le champ de capacité de l'instance.
De plus, nous définissons une ressource synced_database_table , qui met en place un pipeline de synchronisation géré entre une table Unity Catalog et une table Postgres.
Pour ce faire, définissez une table source via source_table_full_name. La table source dans Unity Catalog nécessite une clé primaire unique (composite) pour traiter les mises à jour définies dans le champ primary_key_columns.
L'emplacement de la table cible dans Lakebase est déterminé par l'objet de base de données cible (logical_database_name) et le nom de la table (name).
Une table synchronisée est également un objet Unity Catalog. Dans cette définition de ressource, nous plaçons la table synchronisée dans le même catalogue et le même schéma que la table source à l'aide des variables DABs définies dans databricks.yml. Vous pouvez remplacer ces default en définissant des valeurs de variable différentes.
Pour notre cas d'utilisation, nous utilisons le mode de synchronisation SNAPSHOT. Consultez la section « Considérations et bonnes pratiques » de ce chapitre pour une présentation des options disponibles.
Ressource Databricks Apps
Les DABs nous permettent de définir à la fois la ressource de compute Databricks Apps en tant que ressource d'application et le code source de l'application dans un seul bundle. Cela nous permet de conserver la définition de la ressource Databricks et le code source dans un seul repository. Dans notre cas, le code source de l'application, basé sur FastAPI et Vite, est stocké dans le répertoire d'application de premier niveau du projet.
La configuration référence dynamiquement les database_name et instance_name définis dans la définition de la ressource database.yml.
La base de données est une ressource d'application prise en charge qui peut être définie dans les DAB. En définissant la base de données comme une ressource d'application, nous créons automatiquement un rôle Postgres qui sera utilisé par le Service Principal de l'application lors de l'interaction avec l'instance Lakebase.
Considérations et bonnes pratiques
Créer des bundles modulaires et réutilisables
Bien que cet exemple soit déployé dans des environnements de développement et de pré-production, les DAB permettent de définir facilement plusieurs environnements adaptés à votre cycle de vie de développement. Automatisez le déploiement dans ces environnements en configurant des pipelines CI/CD avec Azure DevOps, GitHub Actions ou d'autres plateformes DevOps.
Utilisez les substitutions et variables DABs pour définir des configurations spécifiques à l'environnement. Par exemple, vous pouvez définir différentes configurations de capacité d'instance Lakebase pour le développement et la production afin de réduire les coûts. De même, vous pouvez définir différents modes de synchronisation Lakebase pour vos tables synchronisées afin de répondre aux exigences de latence des données spécifiques à l'environnement.
Choisir les modes de synchronisation Lakebase et optimiser les performances
Choisir le bon mode de synchronisation Lakebase est essentiel pour équilibrer les coûts et la fraîcheur des données.
| INSTANTANÉ | DÉCLENCHÉ | CONTINU | |
|---|---|---|---|
| Méthode de mise à jour | Remplacement complet de la table à chaque exécution | Copie intégrale initiale et modifications progressives | Chargement initial et mises à jour en streaming temps réel |
| Performance | 10 fois plus efficace que les autres modes | Équilibre entre coût et performance | Coût plus élevé — exécution en continu |
| Latence | Latence élevée — planifiée ou manuelle | Latence moyenne — à la demande | Latence la plus faible — temps réel, ~15 s |
| Idéal pour |
|
|
|
| Limitations |
|
|
|
Configurez des notifications pour votre pipeline de synchronisation géré afin d'être alerté en cas d'échec.
Pour améliorer les performances des requêtes, dimensionnez correctement votre instance de base de données Lakebase en choisissant une capacité d'instance appropriée. Envisagez de créer des index sur la table synchronisée dans Postgres qui correspondent à vos modèles de requêtes et utilisez l'extension pg_stat_statements préinstallée pour analyser les performances des requêtes.
Préparez votre application pour la production
L'application d'exemple met en œuvre une approche par interrogation pour obtenir les dernières données de Lakebase. En fonction de vos besoins, vous pouvez également mettre en œuvre une approche de type push en utilisant des WebSockets ou des événements envoyés par le serveur pour utiliser plus efficacement les ressources du serveur et accélérer les mises à jour des données.
Pour monter en charge un plus grand nombre d'utilisateurs d'applications en réduisant la nécessité pour le back-end FastAPI de Trigger des Opérations de base de données, envisagez d'implémenter la mise en cache, telle que fastapi-cache, pour la mise en cache en mémoire des résultats de query.
Authentification et autorisation
Utilisez OAuth 2.0 pour l'autorisation et l'authentification — ne vous fiez pas aux anciens jetons d'accès personnels (PAT). Pendant le développement sur votre machine locale, utilisez l'interface de ligne de commande (CLI) de Databricks pour configurer l'authentification OAuth U2M afin d'interagir en toute fluidité avec les ressources Databricks actives telles que Lakebase.
De même, votre application déployée utilise son service principal associé pour l’authentification OAuth M2M et l’autorisation avec d’autres services Databricks. Sinon, configurez une autorisation utilisateur pour que votre application effectue des actions sur les ressources Databricks au nom de vos utilisateurs.
Voir aussi Meilleures pratiques pour les Databricks Apps dans la documentation des Databricks Apps pour d'autres bonnes pratiques générales et de sécurité.
Conclusion
Créer des applications de données de production ne devrait pas signifier jongler avec des outils distincts pour le déploiement, la synchronisation des données et la gestion de l'infrastructure. Databricks Apps vous offre le compute serverless pour exécuter vos applications Python et Node.js sans avoir à gérer l'infrastructure. Les tables synchronisées Lakebase fournissent automatiquement des données à faible latence depuis les tables Delta d'Unity Catalog vers Postgres, éliminant ainsi les pipelines ETL personnalisés. DABs rassemble tous ces éléments en vous permettant de regrouper votre code d'application, vos définitions d'infrastructure et vos configurations de synchronisation des données dans un seul lot versionné qui se déploie de manière cohérente dans tous les environnements.
La complexité du déploiement freine l'élan. Lorsque vous ne pouvez pas livrer les modifications rapidement et en toute confiance, vous ralentissez l'itération, introduisez une drift de l'environnement et perdez du temps à vous coordonner entre les équipes. En traitant l'ensemble de votre pile applicative comme du code avec les DAB, vous :
- Activer l'automatisation CI/CD
- Assurez des déploiements cohérents entre les environnements de développement, de préproduction et de production
- Permettez à votre équipe de se concentrer sur la création de fonctionnalités au lieu de se battre avec les pipelines de déploiement
Voici comment passer du prototype à la production sans les tracas habituels du déploiement.
L'exemple complet est disponible dans le repository GitHub avec des instructions de déploiement étape par étape.
Démarrer
Découvrez-en plus sur Lakebase, Databricks Apps et les DAB en consultant la documentation Databricks. Pour plus de ressources pour développeurs sur Databricks Apps, consultez la collection de ressources Databricks Apps Cookbook et Cookbook.
03 | La Fondation transactionnelle pour les applications intelligentes
Par Jasper Puts et Antonio Javier Samaniego Jurado
Introduction
Développer des outils internes ou des applications basées sur l'IA de manière traditionnelle plonge les développeurs dans un dédale de tâches répétitives et sujettes aux erreurs. Tout d'abord, ils doivent lancer une instance Postgres dédiée, configurer le réseau, les sauvegardes et le monitoring, puis passer des heures, voire des jours, à connecter cette base de données au framework front-end qu'ils utilisent. De plus, ils doivent écrire des flux d'authentification personnalisés, mapper des autorisations granulaires et maintenir ces contrôles de sécurité synchronisés entre l'interface utilisateur, la couche API et la base de données. Chaque composant d'application réside dans un environnement différent, d'un service cloud géré à une machine virtuelle auto-hébergée. Cela oblige les développeurs à jongler avec des pipelines de déploiement, des variables d'environnement et des magasins d'informations d'identification disparates. Le résultat est une stack fragmentée où un simple changement, comme une migration de schéma ou un nouveau rôle, se répercute sur plusieurs systèmes, exigeant des mises à jour manuelles, des tests approfondis et une coordination constante. Toute cette charge de travail supplémentaire détourne les développeurs de la véritable valeur ajoutée : la création des fonctionnalités principales et de l'intelligence du produit.
Avec Databricks Lakebase et Databricks Apps, l'ensemble de la pile applicative est regroupé aux côtés du lakehouse. Lakebase est une base de données Postgres entièrement managée qui offre des lectures et des écritures à faible latence, intégrée aux mêmes tables lakehouse sous-jacentes qui alimentent vos charges de travail analytiques et d'IA.
Databricks Apps fournit un environnement d'exécution serverless pour l'interface utilisateur, ainsi qu'une authentification intégrée, des autorisations précises et des contrôles de gouvernance qui sont automatiquement appliqués aux mêmes données que celles que Lakebase sert. Il est ainsi facile de créer et de déployer des applications qui combinent l'état transactionnel, l'analytique et l'IA sans avoir à assembler plusieurs plateformes, à synchroniser des bases de données, à répliquer des pipelines ou à concilier des politiques de sécurité entre les systèmes.
Pourquoi les applications Lakebase et Databricks
Lakebase et Databricks Apps fonctionnent ensemble pour simplifier le développement full-stack sur la Databricks Platform :
- Lakebase fournit une base de données Postgres entièrement gérée avec des lectures, écritures et mises à jour rapides, ainsi que des fonctionnalités modernes telles que la création de branches et la restauration à un instant T.
- Databricks Apps provides the Serverless runtime for your application front end, with built-in identity access control and integration with Unity Catalog and other lakehouse components
En combinant les deux, vous pouvez créer des outils interactifs qui stockent et mettent à jour l'état dans Lakebase, accèdent aux données gouvernées dans le lakehouse et servent le tout via une interface utilisateur sécurisée et Serverless — le tout sans gérer d'infrastructure distincte. Dans l'exemple suivant, nous montrerons comment créer une application simple d'approbation des demandes de congés à l'aide de cette configuration.
Mise en route : Créer une application transactionnelle avec Lakebase
Ce guide pas à pas montre comment créer une application Databricks simple qui aide les managers à examiner et à approuver les demandes de congés de leur équipe. L'application est créée à l'aide de Databricks Apps et utilise Lakebase comme base de données back-end pour stocker et mettre à jour les demandes.
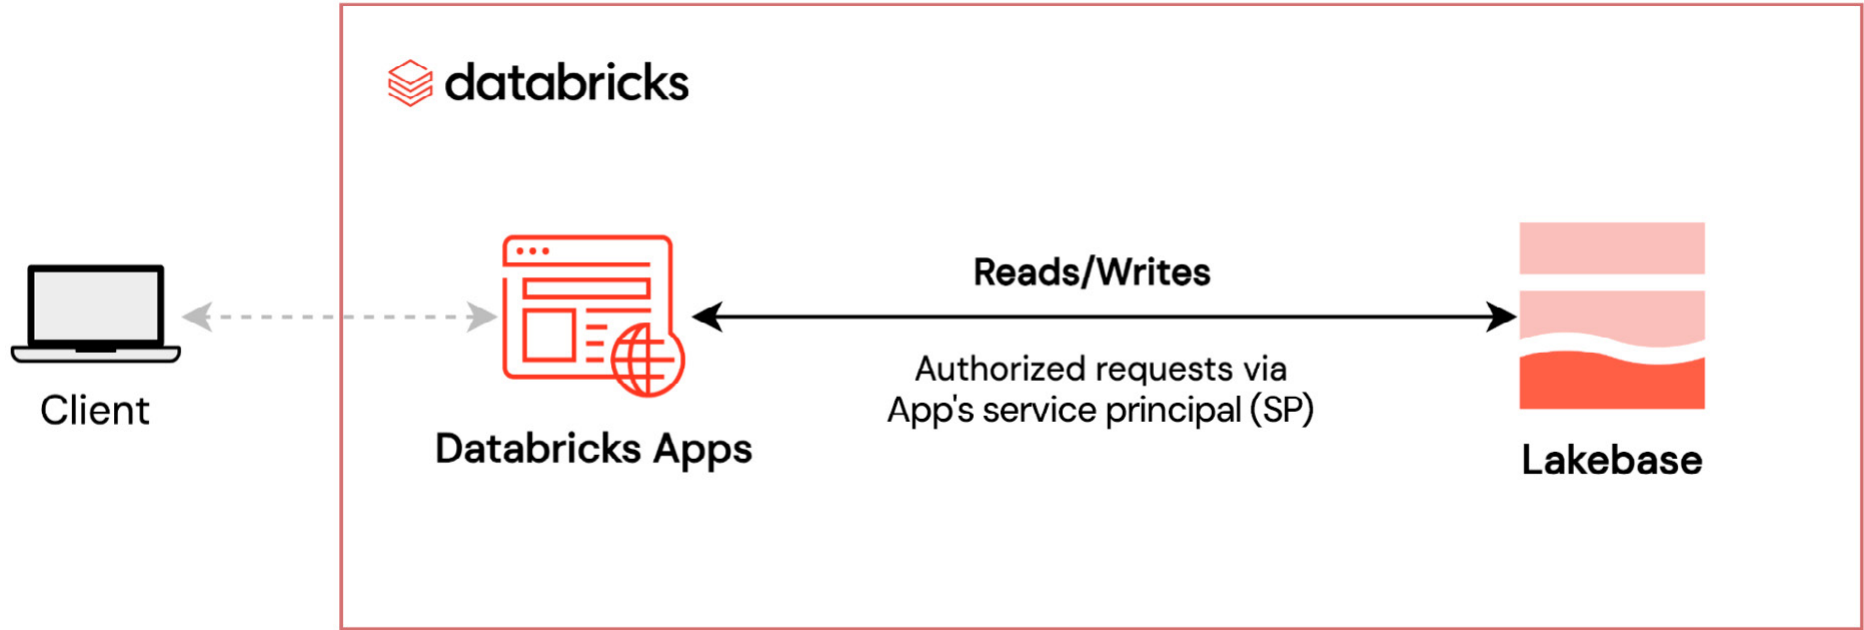
Voici ce que la solution comprend :
- Provisionner une base de données Lakebase
Configurez une base de données OLTP Postgres Serverless en quelques clics. - 2. Créer une application Databricks
Créez une application interactive à l'aide d'un framework Python, tel que Streamlit ou Dash, qui lit et écrit dans Lakebase. - Configurez le schéma, les tables et les contrôles d'accès
Créez les tables nécessaires et attribuez des autorisations granulaires à l'application à l'aide de son ID client. - Connectez-vous et interagissez en toute sécurité avec Lakebase
Utilisez le SDK Databricks et SQLAlchemy pour lire et écrire en toute sécurité dans Lakebase à partir du code de votre application.
Ce guide est conçu pour vous permettre de start rapidement avec un exemple fonctionnel minimal. Par la suite, vous pouvez l'étendre avec une configuration plus avancée.
Étape 1 : Provisionner Lakebase
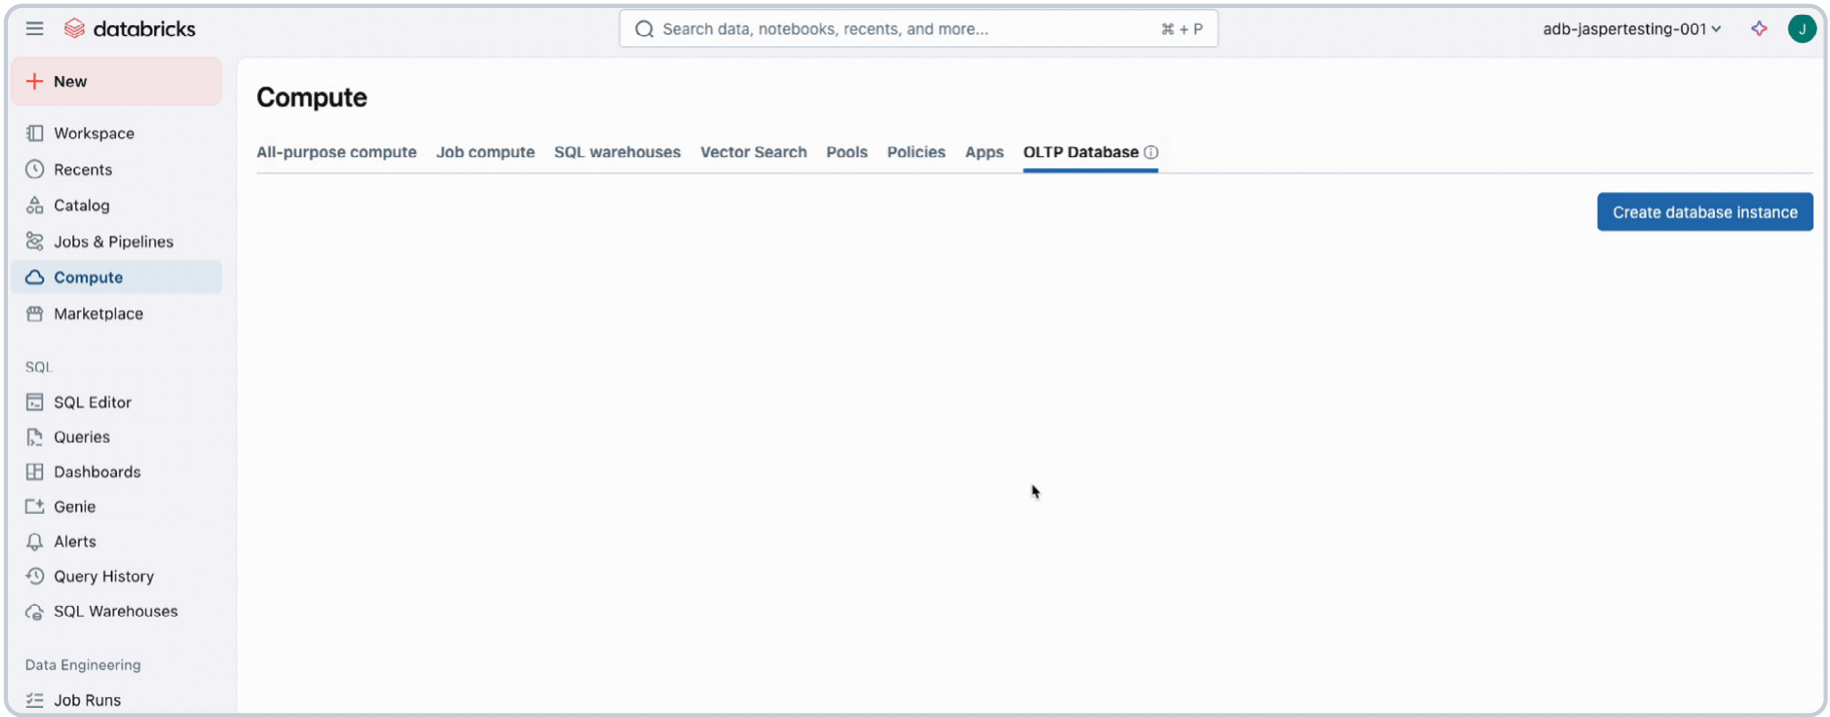
Avant de créer l'application, vous devez créer une base de données Lakebase. Pour ce faire, accédez à l'onglet Compute, sélectionnez Base de données OLTP, puis indiquez un nom et une taille. Cette action provisionne une instance Lakebase serverless. Dans cet exemple, notre instance de base de données s'appelle lakebase-demo-instance.
Étape 2 : Créer une application Databricks et ajouter un accès à la base de données
Maintenant que nous avons une base de données, créons l'application Databricks qui s'y connectera. Vous pouvez start à partir d'une application vierge ou choisir un Template — par ex., Streamlit ou Flask. Après avoir nommé votre application, ajoutez la base de données en tant que ressource. Dans cet exemple, la base de données pré-créée databricks_postgres est sélectionnée.
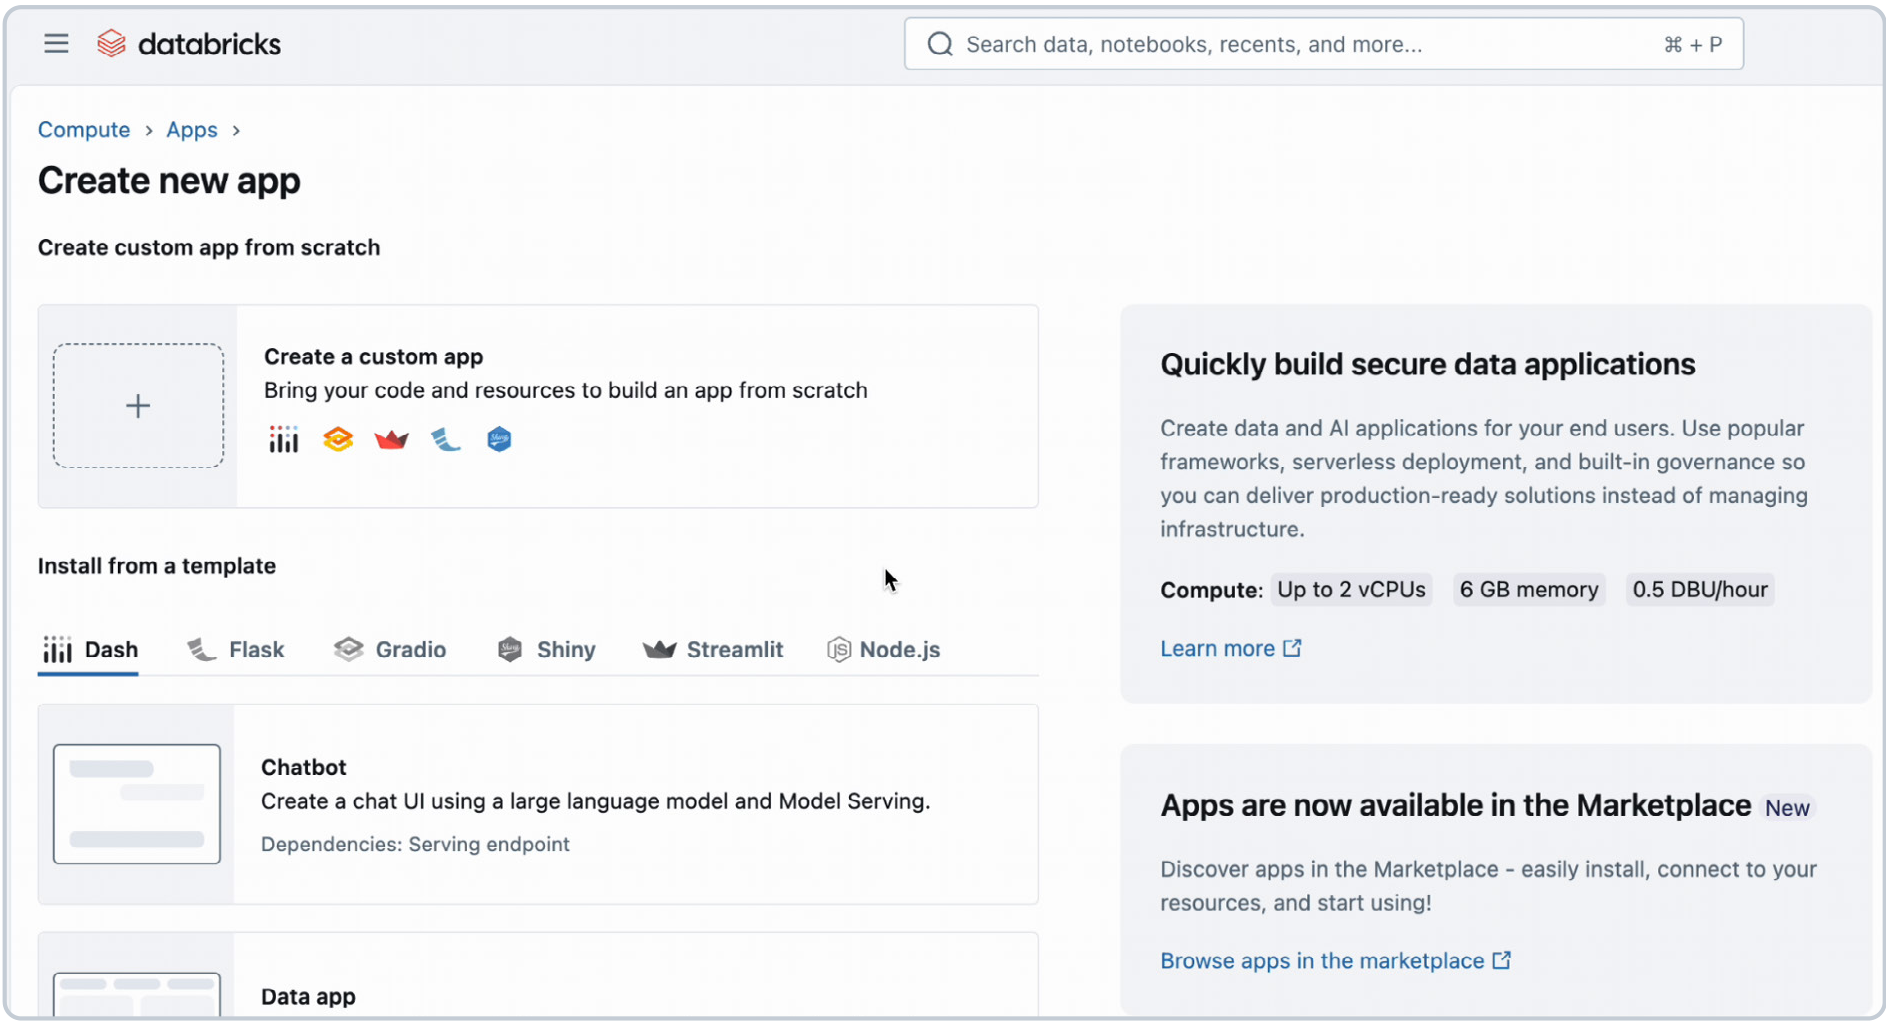
Ajout automatique de la ressource de base de données :
- Accorde à l'app les privilèges CONNECT et CREATE.
- Crée un rôle Postgres lié à l'ID client de l'application
Ce rôle sera utilisé ultérieurement pour accorder un accès au niveau de la table.
Étape 3 : Créer un schéma, définir une table et définir des autorisations
Une fois la base de données provisionnée et l'application connectée, vous pouvez créer le schéma et définir la table que l'application utilisera.

- Récupérer l'ID client de l'application
Depuis l'onglet Environnement de l'application, copiez la valeur de la variable DATABRICKS_CLIENT_ID. Vous en aurez besoin pour les instructions GRANT. - Ouvrez l'éditeur SQL Lakebase
Accédez à votre instance Lakebase et cliquez sur Nouvelle query. Cela ouvre l'éditeur SQL avec l'Endpoint de la base de données déjà sélectionné.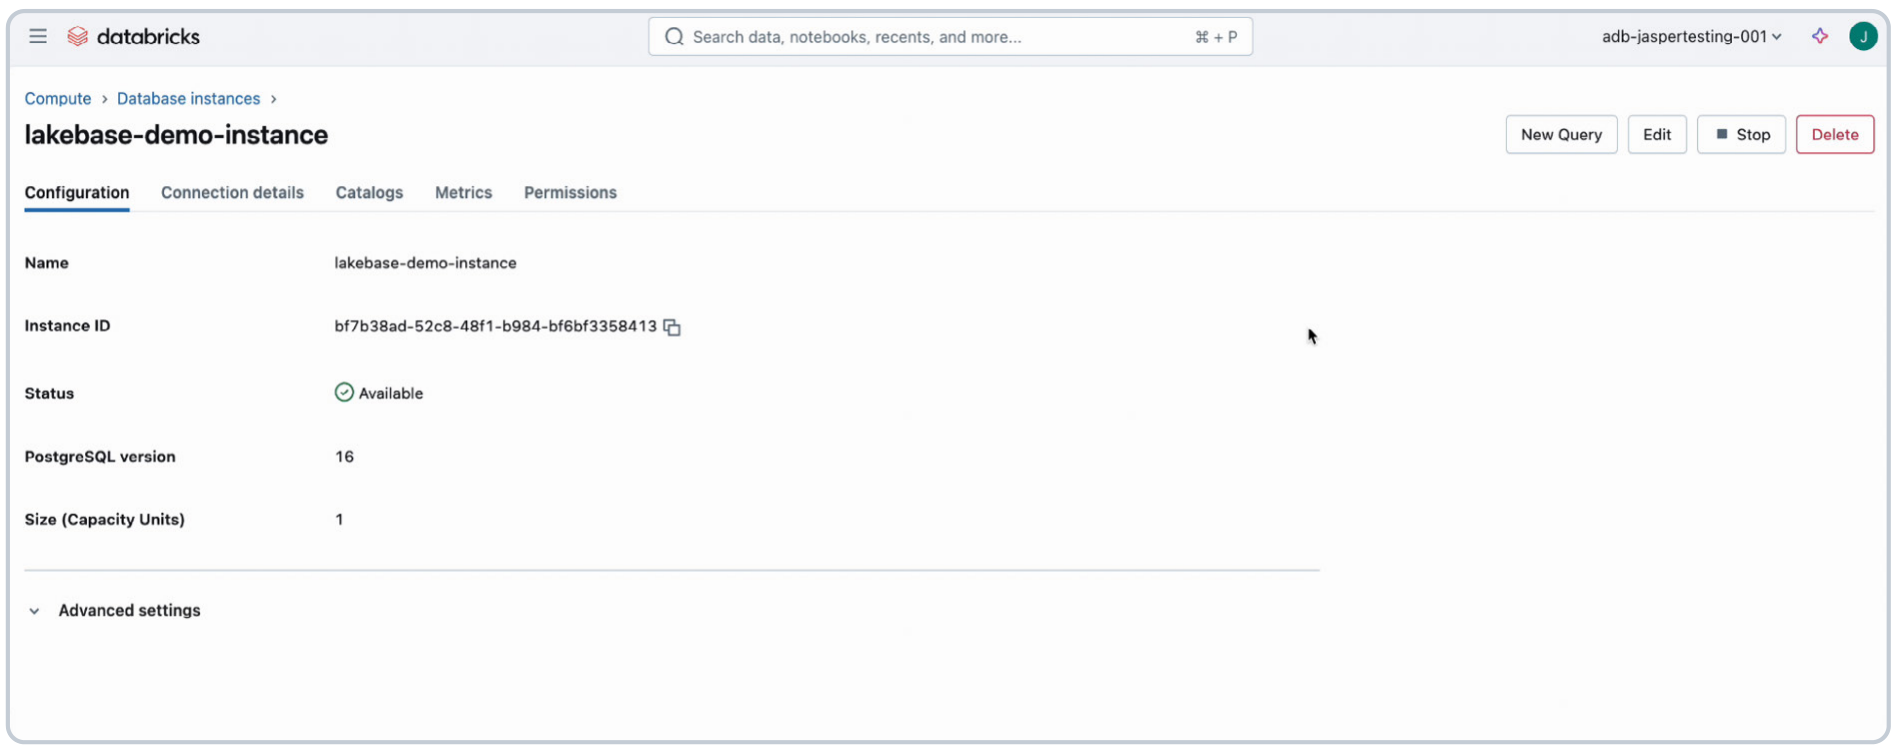
Exécutez la commande SQL suivante :
Bien que l'utilisation de l'éditeur SQL soit un moyen rapide et efficace pour effectuer ce processus, la gestion des schémas de base de données à grande échelle est mieux gérée par des outils dédiés qui prennent en charge la gestion de versions, la collaboration et l'automatisation. Des outils comme Flyway et Liquibase vous permettent de suivre les modifications de schéma, de vous intégrer aux pipelines CI/CD et de garantir que la structure de votre base de données évolue en toute sécurité parallèlement au code de votre application.
Étape 4 : Créer l'application
Une fois les autorisations configurées, vous pouvez maintenant créer votre application. Dans cet exemple, l'application récupère les demandes de congés depuis Lakebase et permet à un manager de les approuver ou de les rejeter. Les mises à jour sont écrites dans la même table.
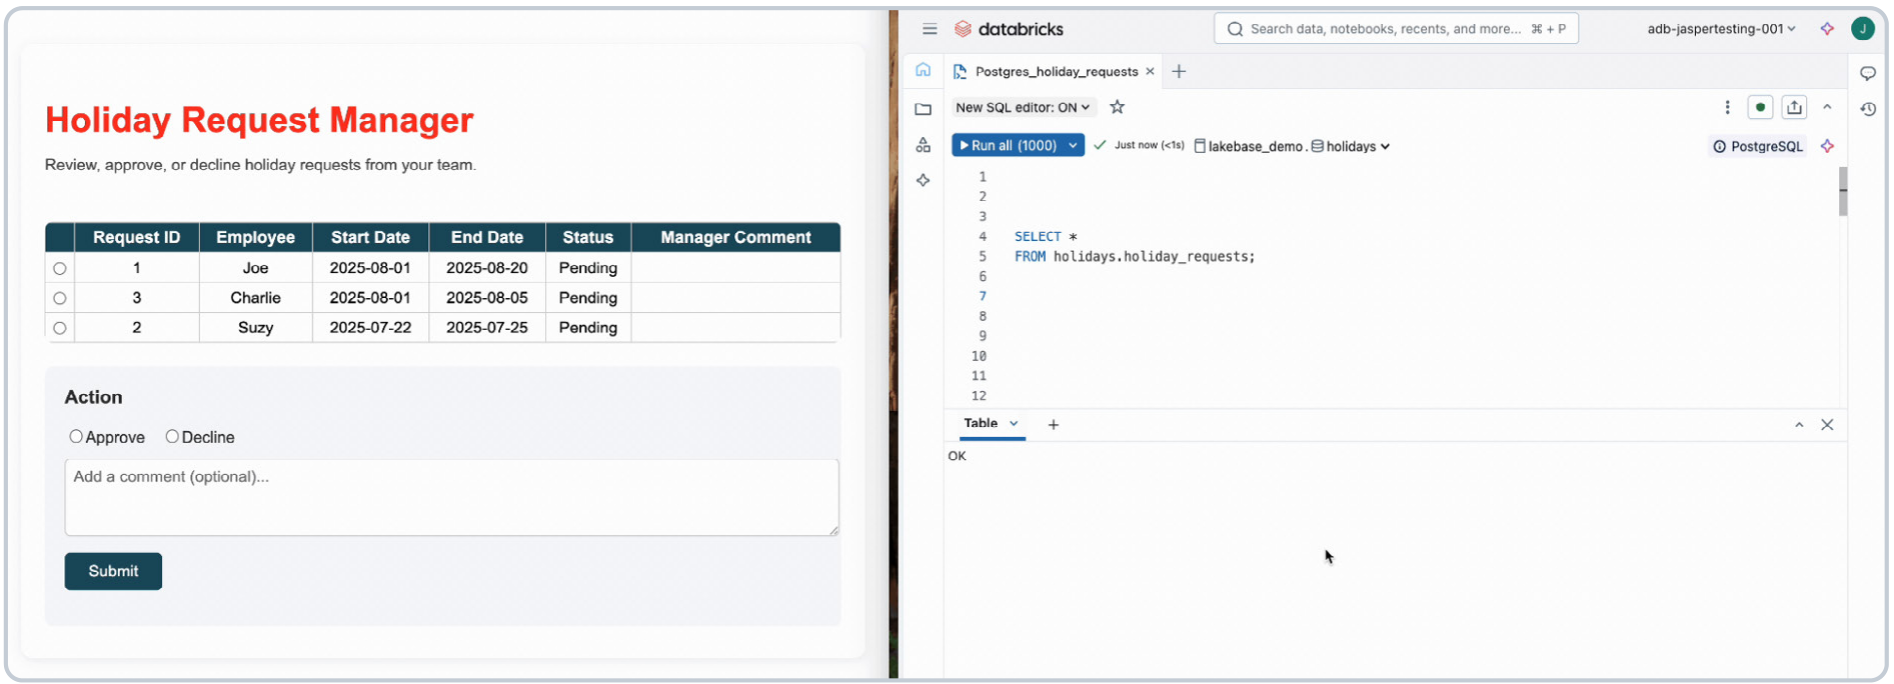
Étape 5 : Se connecter en toute sécurité à Lakebase
Utilisez SQLAlchemy et le SDK Databricks pour connecter votre application à Lakebase avec une authentification sécurisée basée sur des jetons. Lorsque vous ajoutez la ressource Lakebase, PGHOST et PGUSER sont exposés automatiquement. Le SDK gère la mise en cache des jetons.
Étape 6 : Lire et mettre à jour les données
Les fonctions suivantes lisent et mettent à jour la table des demandes de congés :
Ces extraits de code peuvent être utilisés en combinaison avec des frameworks tels que Streamlit, Dash et Flask pour extraire les données de Lakebase et les visualiser dans votre application. Pour garantir que toutes les dépendances nécessaires sont installées, ajoutez les packages requis au fichier requirements.txt de votre application. Les paquets suivants sont utilisés dans les extraits de code :
Extension du Lakehouse avec Lakebase
Lakebase ajoute des capacités transactionnelles au lakehouse en intégrant directement une base de données OLTP entièrement managé dans la plateforme. Cela réduit le besoin de bases de données externes ou de pipelines complexes lors de la création d'applications qui nécessitent des lectures et des écritures.
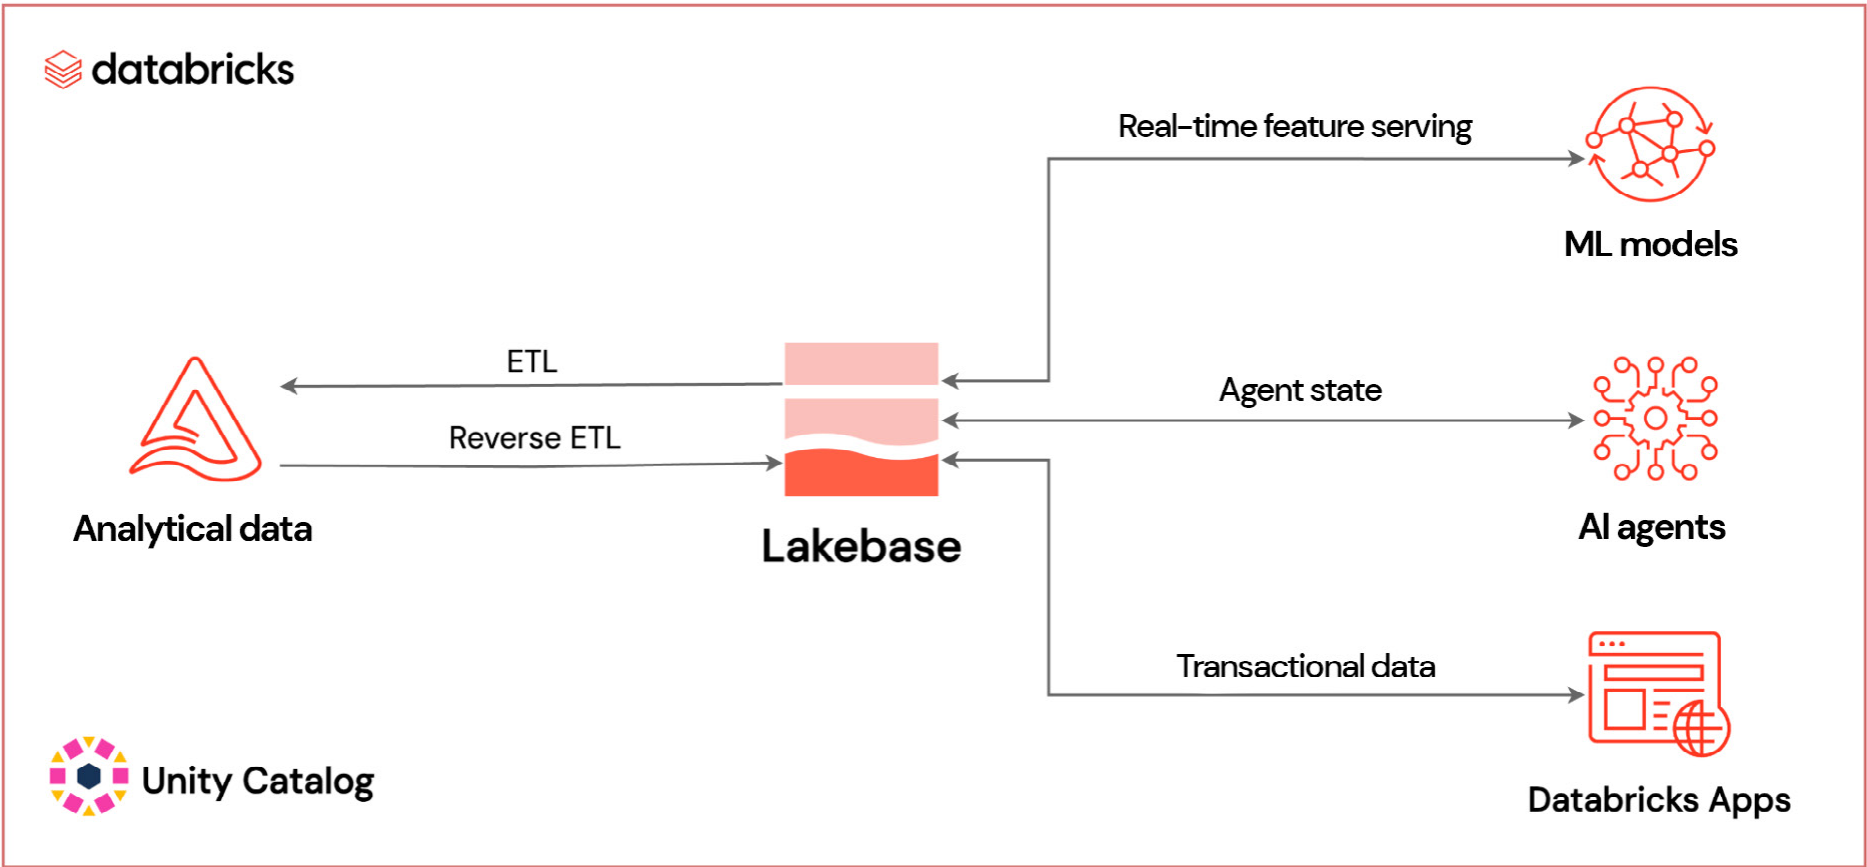
Lakebase est intégré nativement à Databricks, y compris pour la synchronisation des données, l'authentification des identités et la sécurité du réseau, tout comme les autres ressources de données du lakehouse. Par conséquent, vous n'avez pas besoin d'ETL personnalisé ou d'ETL inversé pour déplacer des données entre les systèmes. par exemple :
- Vous pouvez fournir des fonctionnalités analytiques aux applications en temps réel via le Magasin de fonctionnalités en ligne et les tables synchronisées
- Vous pouvez synchroniser les données opérationnelles avec une table Delta — par ex., pour l'analyse des données historiques
Ces fonctionnalités facilitent la prise en charge de cas d'utilisation de niveau production, comme :
- Mise à jour de l'état dans les agents d'IA
- Gestion des workflows en temps réel — p. ex., approbations, routage des tâches
- Alimenter les systèmes de recommandation ou les moteurs de tarifs avec des données en direct
Lakebase est déjà utilisé dans de nombreux secteurs d'activité pour des applications telles que les recommandations personnalisées, les applications de chatbot et les outils de gestion des flux de travail.
Résumé
Lakebase propose une base de données Postgres transactionnelle qui fonctionne parfaitement avec les applications Databricks et assure une intégration facile avec les données Lakehouse. Cela simplifie le développement d'applications de données et d'IA full-stack en éliminant le besoin de systèmes OLTP externes ou d'étapes d'intégration manuelles.
Si vous utilisez déjà Databricks pour l'analytique et l'IA, Lakebase facilite l'ajout d'interactivité en temps réel à vos applications. Grâce à la prise en charge des transactions à faible latence, à la sécurité intégrée et à l'intégration étroite avec Databricks Apps, vous pouvez passer du prototype à la production sans quitter la plateforme.
Dans cet exemple, nous vous avons montré comment :
- Mettez en place une instance Lakebase et configurez l'accès
- Créez une application Databricks qui lit et écrit dans Lakebase
- Utilisez une authentification sécurisée basée sur un jeton avec une configuration minimale
- Construis une application basique pour gérer les requêtes pendant les fêtes en utilisant Python et SQL
Pour plus de détails sur l'utilisation et la tarification, consultez la documentation de Lakebase et Databricks Apps.
04 | Transformer l'analytique en applications
Par Firas Farah et Yatish Anand
Introduction : L'analytique et les opérations convergent
Les applications d'aujourd'hui ne peuvent pas reposer uniquement sur des événements bruts. Elles ont besoin de données organisées, contextuelles et exploitables du lakehouse pour alimenter la personnalisation, l'automatisation et des expériences utilisateur intelligentes.
La livraison fiable de ces données à faible latence a toujours été un défi, nécessitant souvent des pipelines complexes et une infrastructure personnalisée.
Qu'est-ce que l'ETL inversé ?
Le Reverse ETL synchronise les données de haute qualité d'un lakehouse vers les systèmes opérationnels qui alimentent les applications. Cela garantit que des ensembles de données fiables et des insights pilotés par l’IA s’intègrent directement dans les applications qui favorisent la personnalisation, les recommandations, la détection de fraude et la prise de décision en temps réel.
Sans ETL inversé, les informations restent dans le lakehouse et n'atteignent pas les applications qui en ont besoin. Le lakehouse est l'endroit où les données sont nettoyées, enrichies et transformées en analytique, mais il n'est pas conçu pour les interactions applicatives à faible latence ou les charges de travail transactionnelles. C'est là que Lakebase intervient. Il fournit des données lakehouse fiables directement dans les outils où elles favorisent l'action.
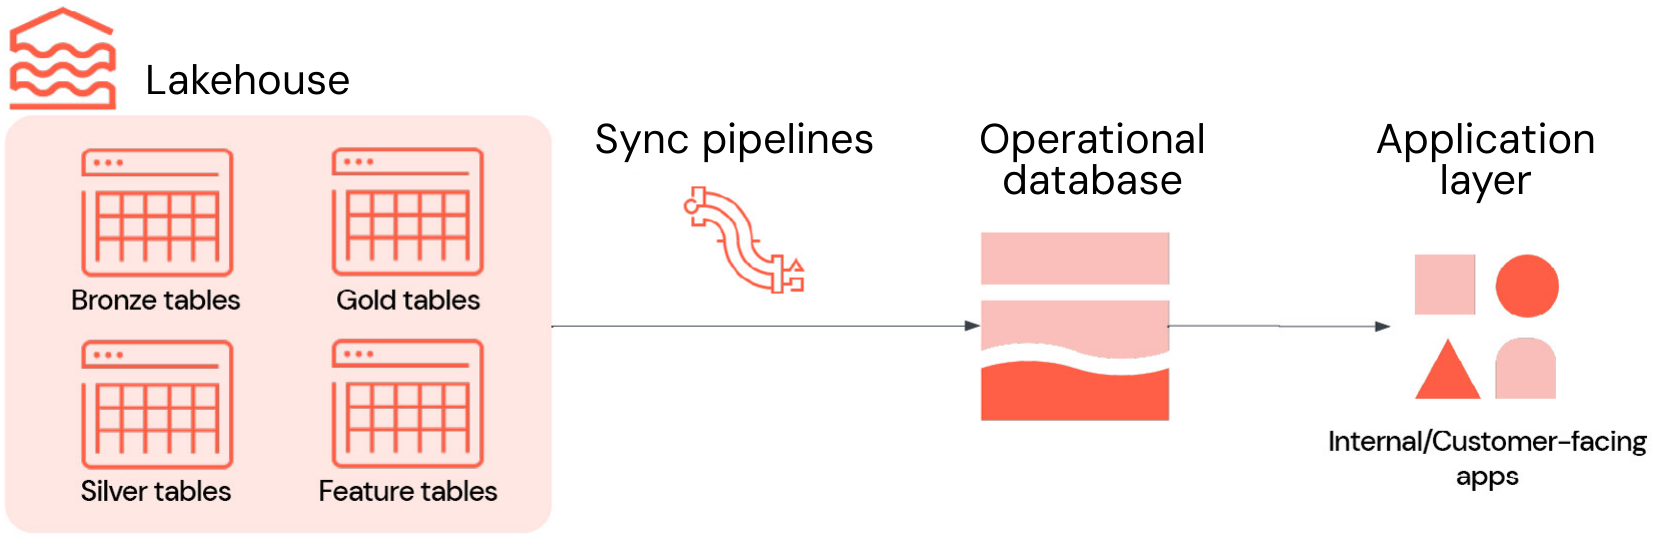
En pratique, l’ETL inversé implique généralement quatre composants clés, tous intégrés dans Lakebase :
- Lakehouse : stocke des données organisées et de haute qualité utilisées pour éclairer les décisions, telles que des tables d'agrégation au niveau de l'entreprise (également appelées tables Gold), des features d'ingénierie et des résultats d'inférence ML
- Synchronisation des pipelines : déplacez les données pertinentes vers des magasins de données opérationnels avec une planification, des garanties de fraîcheur et un monitoring.
- Base de données opérationnelle : est optimisée pour une high concurrency, une faible latence et les transactions ACID
- Applications : Servent de destination finale où les insights se transforment en actions, que ce soit dans des applications destinées aux clients, des outils internes, des APIs ou des tableaux de bord
Défis du Reverse ETL
Le Reverse ETL semble simple, mais en pratique, la plupart des équipes sont confrontées à ces défis :
- Pipelines ETL fragiles et personnalisés : ils nécessitent souvent une infrastructure de streaming, une gestion des schémas, une gestion des erreurs et une orchestration. Ils sont fragiles et leur maintenance est gourmande en ressources.
- Systèmes multiples et déconnectés : Des piles distinctes pour l'analytique et les opérations entraînent une infrastructure plus importante à gérer, des couches d'authentification supplémentaires et un risque plus élevé de non-concordance des formats
- Modèles de gouvernance incohérents : les systèmes analytiques et opérationnels se trouvent souvent dans des domaines de règles différents, ce qui rend difficile l'application de contrôles qualité et de politiques d'audit cohérents.
Ces défis créent des frictions tant pour les développeurs que pour l'entreprise, ralentissant les efforts visant à activer les données de manière fiable et à fournir des applications intelligentes en temps réel.
Lakebase : intégré par default pour un ETL inversé simplifié
Lakebase supprime ces obstacles et transforme l'ETL inversé en un workflow entièrement géré et intégré. Il combine un moteur Postgres haute performance, une intégration approfondie du lakehouse et une synchronisation des données intégrée, ce qui permet aux nouvelles informations de circuler dans les applications sans infrastructure supplémentaire.
Ces capacités de Lakebase sont particulièrement précieuses pour l’ETL inversé :
- Intégration lakehouse approfondie : synchronise les données des tables lakehouse avec Lakebase sur la base d'un instantané, de manière planifiée ou continue, sans créer ni gérer de Job ETL externes. Cela remplace la complexité des pipelines personnalisés, des nouvelles tentatives et du monitoring par une expérience native et gérée.
- Postgres entièrement géré : basé sur la version open source de Postgres, Lakebase prend en charge les transactions ACID, les index, les jointures et les extensions telles que PostGIS et pgvector. Vous pouvez vous connecter avec les drivers et les outils existants, tels que pgAdmin ou JDBC, évitant ainsi d'avoir à apprendre de nouvelles technologies de base de données ou à maintenir une infrastructure OLTP distincte.
- Architecture évolutive et résiliente : Lakebase sépare le compute et le stockage pour une mise à l'échelle indépendante, offrant une latence de query inférieure à 10 ms et des milliers de QPS. Les fonctionnalités de niveau entreprise comprennent la haute disponibilité multizone (multi-AZ), la restauration à un instant donné et le stockage chiffré, ce qui élimine les défis de mise à l'échelle et de résilience associés aux bases de données autogérées.
- Sécurité et gouvernance intégrées : enregistrez Lakebase avec Unity Catalog pour intégrer les données opérationnelles dans votre framework de gouvernance centralisé, couvrant les pistes d'audit et les autorisations au niveau du catalogue. L'accès via le protocole Postgres utilise toujours les rôles et autorisations natifs de Postgres, garantissant une sécurité transactionnelle authentique tout en s'alignant sur votre modèle de gouvernance Databricks plus large.
- Architecture cloud-agnostique : déployez Lakebase parallèlement à votre lakehouse dans votre environnement cloud préféré sans avoir à réarchitecturer vos workflows.
Grâce à ces fonctionnalités de la Databricks Data Intelligence Platform, Lakebase remplace la configuration ETL inversée fragmentée qui repose sur des pipelines personnalisés, des systèmes OLTP autonomes et une gouvernance distincte. Il fournit un service intégré, haute performance et sécurisé, garantissant que les informations analytiques s'intègrent plus rapidement dans les applications, avec moins d'effort opérationnel et en préservant la gouvernance.
Exemple de cas d'utilisation : Création d'un portail de support intelligent avec Lakebase
À titre d'exemple pratique, voyons comment créer un portail de support intelligent alimenté par Lakebase. Ce portail interactif aide les équipes de support à trier les incidents entrants à l'aide d'informations basées sur le ML provenant du lakehouse, telles que le risque d'escalade prédit et les actions recommandées. Il le fait tout en permettant aux utilisateurs d'attribuer la propriété, de suivre le statut et de laisser des commentaires sur chaque ticket.
Lakebase rend cela possible en synchronisant les prédictions dans Postgres tout en stockant les mises à jour de l'application. Cela crée un portail d'assistance qui combine l'analytique avec les opérations en direct. La même approche s'applique à de nombreux autres cas d'utilisation, y compris les moteurs de personnalisation et les tableaux de bord basés sur le ML.
Regarder la présentation de l'application.
Étape 1 : Synchroniser les prédictions du lakehouse vers Lakebase
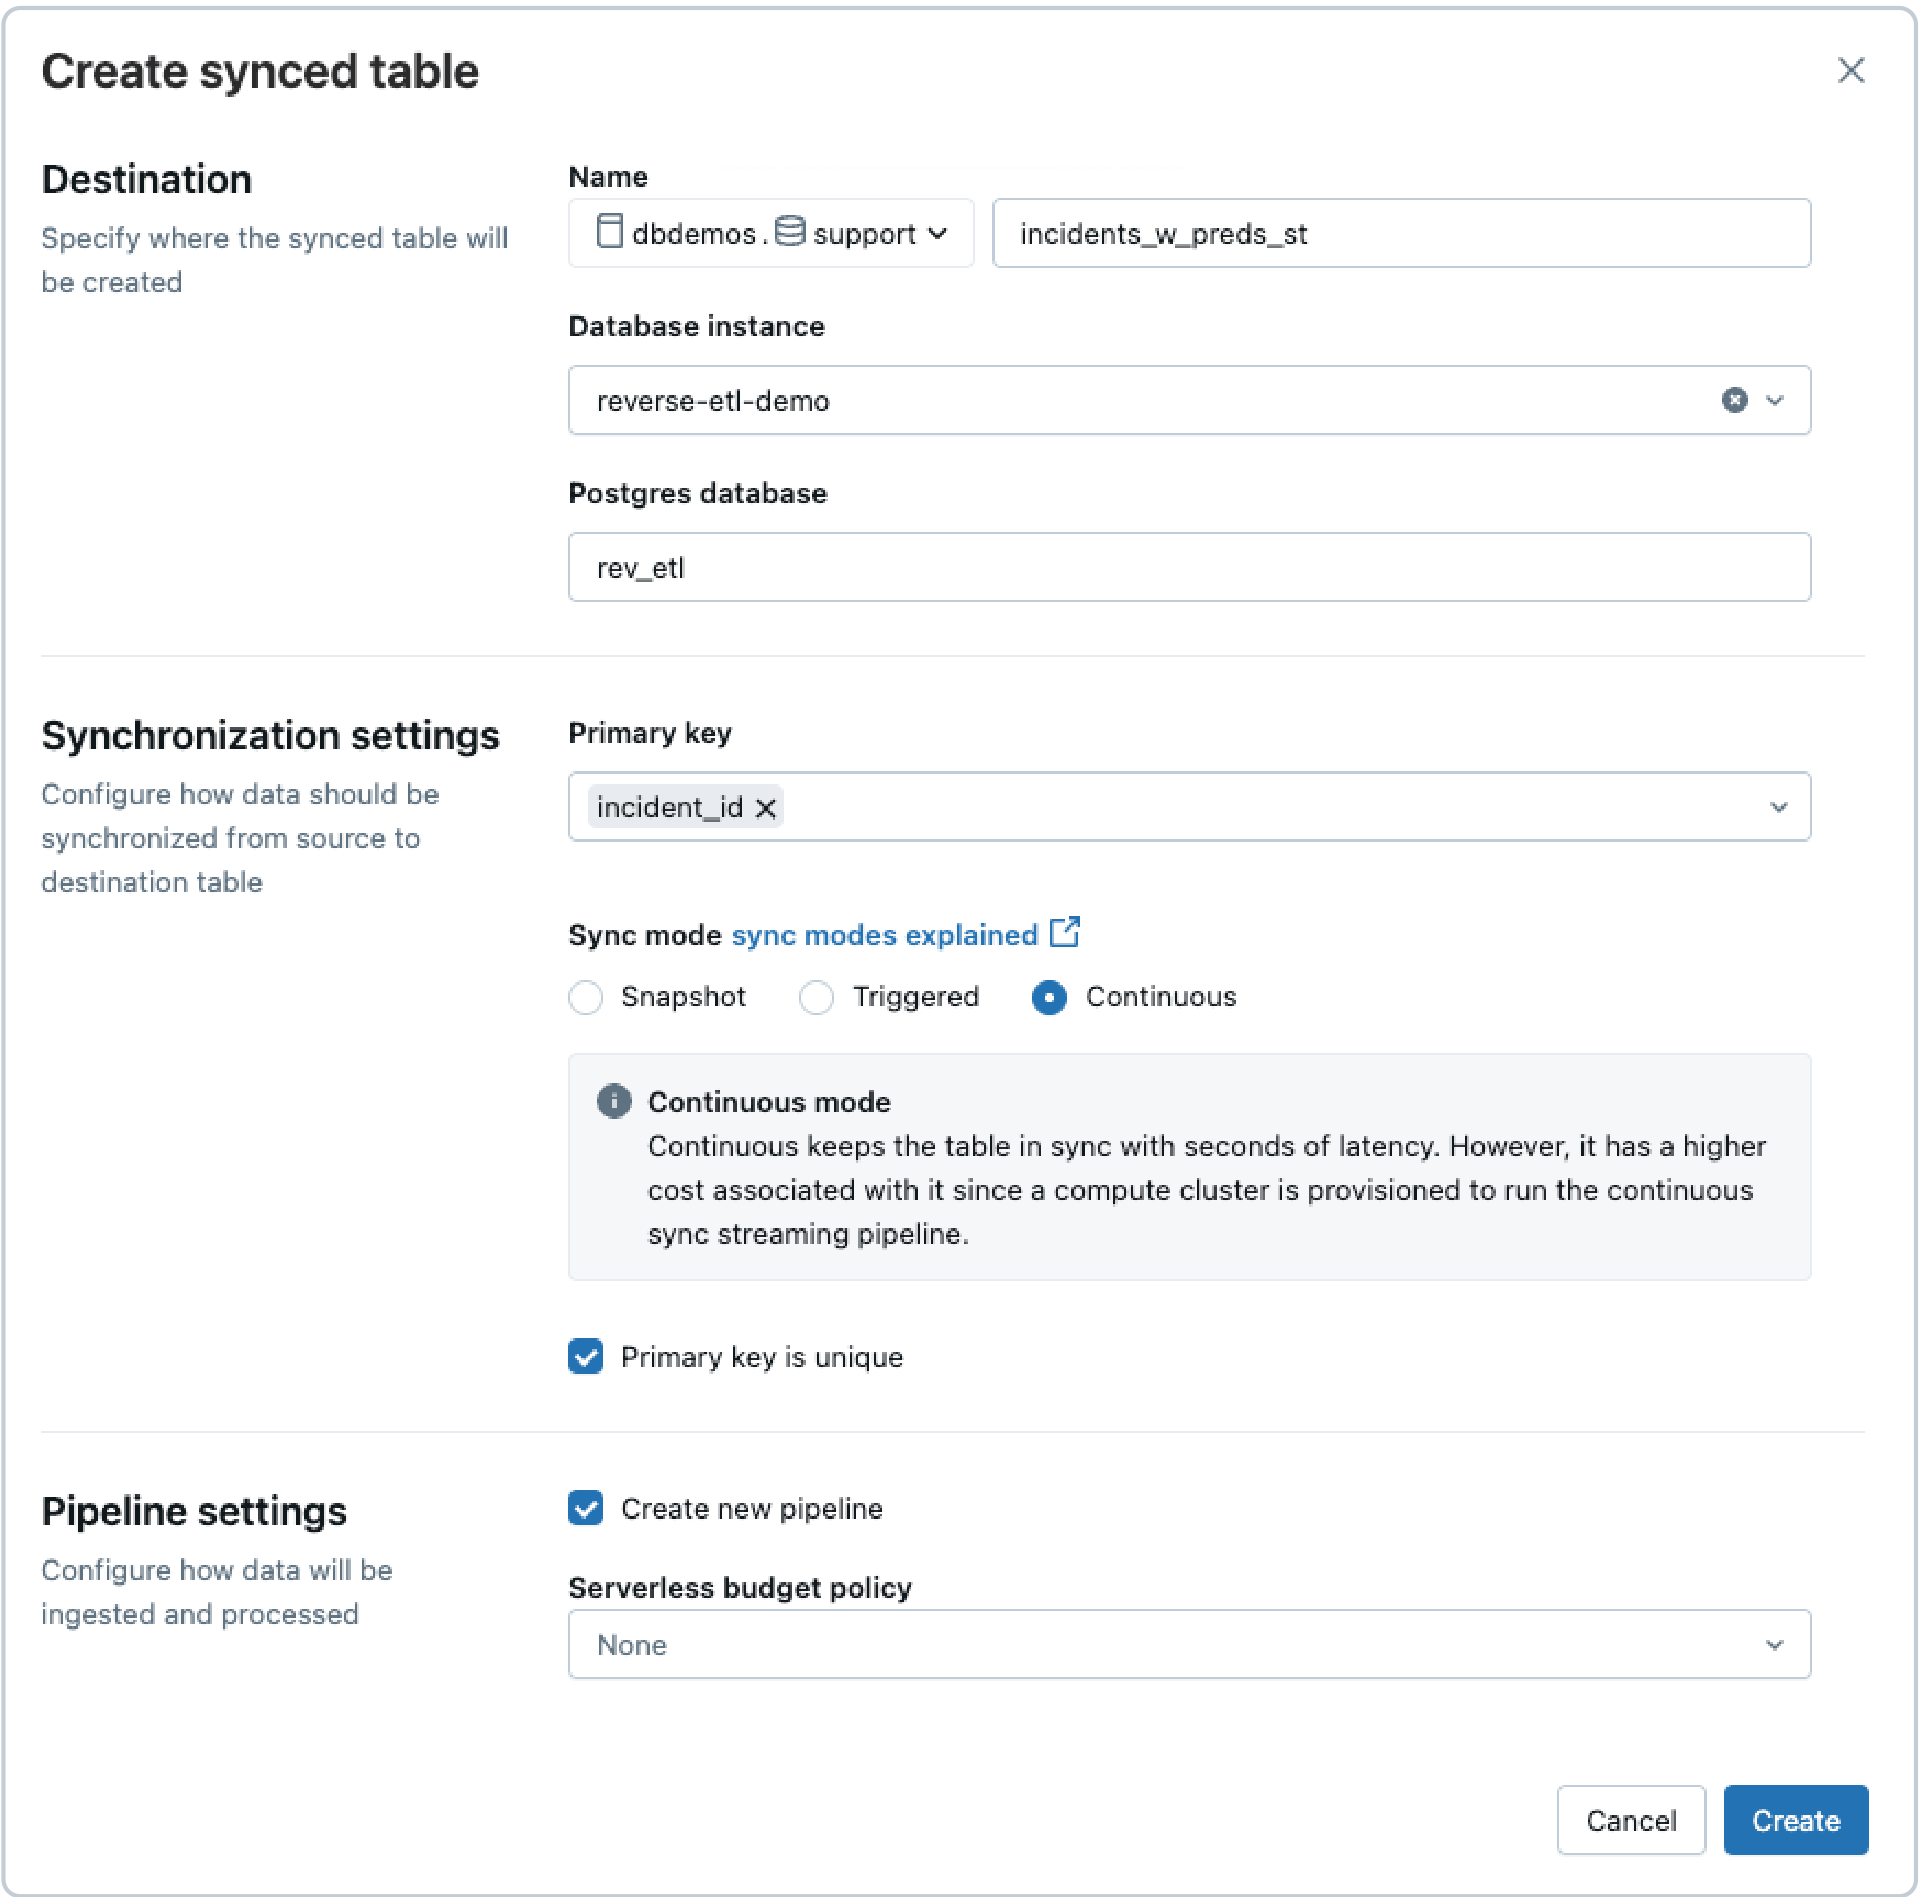
Les données d'incident, enrichies par des prédictions ML, sont stockées dans une table Delta et sont mises à jour en quasi-temps réel via un pipeline de streaming. Pour alimenter l'application de support, nous utilisons le reverse ETL de Lakebase afin de synchroniser en continu cette table Delta avec une table Postgres.
Dans l'interface utilisateur, nous sélectionnons :
- Mode de synchronisation : Continu pour des mises à jour à faible latence
- Clé primaire : incident_id
Cela garantit que l'application reflète les données les plus récentes avec un délai minimal.
Remarque : vous pouvez également créer le pipeline de synchronisation par programmation à l'aide du SDK Databricks.
Étape 2 : Créer une table d'état pour les entrées utilisateur
L'application de support nécessite également une table pour stocker les données saisies par l'utilisateur, telles que la propriété, l'état et les commentaires. Étant donné que ces données sont écrites depuis l'application, elles doivent être stockées dans une table distincte dans Lakebase, plutôt que dans la table synchronisée.
Voici le schéma :
Étape 3 : Configurer l'accès à Lakebase dans les applications Databricks
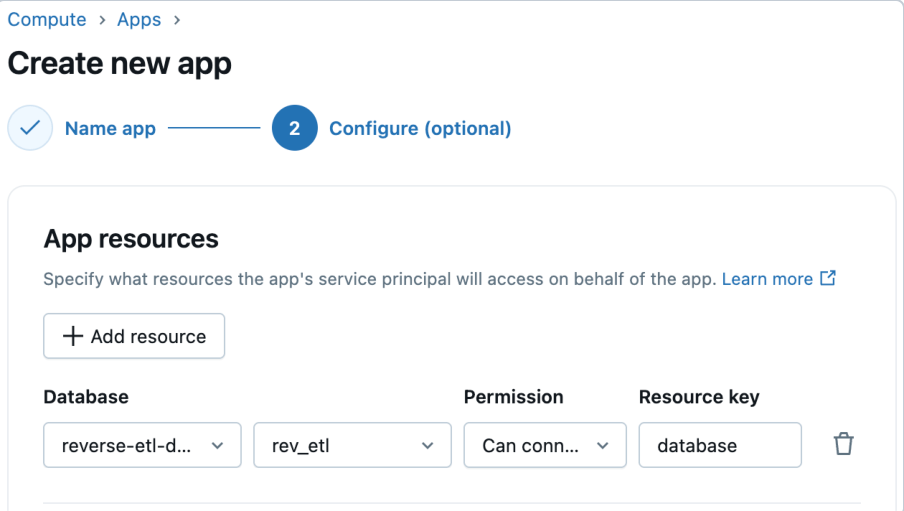
Databricks Apps prend en charge une intégration de premier ordre avec Lakebase. Lorsque vous créez votre application, il vous suffit d'ajouter Lakebase en tant que ressource d'application et de sélectionner l'instance et la base de données Lakebase. Databricks provisionne automatiquement un rôle Postgres correspondant pour le Service Principal de l'application, ce qui simplifie la connectivité entre l'application et la base de données. Vous pouvez ensuite accorder à ce rôle les autorisations requises pour la base de données, le schéma et la table.
Étape 4 : Déployer le code de votre application
Une fois vos données synchronisées et les autorisations configurées, vous pouvez maintenant déployer l'application Flask qui alimente le portail de support. L'application se connecte à Lakebase via Postgres et propose un tableau de bord riche avec des graphiques, des filtres et de l'interactivité.
Conclusion
L'intégration d'informations analytiques dans des applications opérationnelles ne nécessite plus de processus complexe et fragile. Avec Lakebase, le reverse ETL devient une fonctionnalité entièrement managée et intégrée. Il combine les performances d'un moteur Postgres, la fiabilité d'une architecture évolutive et la gouvernance de la Databricks Platform. Que vous alimentiez un portail d'assistance intelligent ou que vous créiez d'autres expériences en temps réel basées sur les données, Lakebase réduit la charge de travail d'ingénierie et accélère le passage de l'insight à l'action.
Pour en savoir plus sur la création de tables synchronisées dans Lakebase, consultez notre documentation et start dès aujourd’hui.
05 | Fournir des applications sécurisées et en temps réel sur Databricks
Par Sylvia Christin Schumacher
Introduction
Databricks Lakebase améliore considérablement la capacité de rationaliser les bases de données opérationnelles pour créer des applications intelligentes. Databricks Apps permet un déploiement rapide de ces données et applications d’IA en production, avec une gouvernance et une authentification prêtes à l’emploi.
En tant que service Postgres entièrement géré qui s'intègre de manière transparente à la Databricks Platform, Lakebase permet aux développeurs de travailler avec des données transactionnelles de manière native, sans nécessiter de pipelines ETL, de connecteurs ou de middleware personnalisés. Les Databricks Apps vont encore plus loin en éliminant entièrement la gestion de l'infrastructure, en fournissant un compute géré et Serverless qui hérite automatiquement des stratégies de sécurité de votre Workspace et des autorisations Unity Catalog.
Historiquement, le pontage des systèmes OLTP et OLAP impliquait une ingénierie des données complexe et des couches d'intégration sur mesure, tandis que le déploiement d'applications nécessitait des équipes DevOps et d'infrastructure distinctes, des pipelines CI/CD disparates et des configurations de sécurité manuelles. Avec Lakebase et Databricks Apps, ces complexités sont considérablement réduites. Les développeurs peuvent désormais accéder aux données analytiques en temps réel directement depuis la couche transactionnelle et déployer des applications interactives en quelques minutes plutôt qu'en plusieurs mois, ce qui facilite considérablement l'incorporation de données en direct dans des applications prêtes pour la production.
Dans le contexte de la GenAI, cette combinaison est particulièrement puissante. Databricks Apps combine de manière unique les données de lakehouse avec des interfaces d’IA interactives, telles que Streamlit ou Gradio, fonctionnant directement sur la Databricks Data Intelligence Platform — où vos données et modèles sont déjà présents. Les données transactionnelles de Lakebase deviennent un catalyseur essentiel, alimentant des applications contextuelles en temps réel qui mettent la GenAI en production plus rapidement avec une sécurité et une gouvernance d'entreprise intégrées.
En affichant ces données directement dans les interfaces des applications, les entreprises débloquent de nouvelles fonctionnalités :
- Les assistants IA consultent des données métier en direct tout en respectant des contrôles d'accès faciles à configurer
- Les utilisateurs prennent des décisions data-driven grâce à des recommandations à jour générées par l'IA
- Les modèles de génération augmentée par récupération (RAG) ancrent les résultats dans des faits actuels
- Les workflows restent alignés sur l'évolution des transactions grâce à des applications gérées et toujours disponibles.
Cette intégration garantit que la GenAI fonctionne avec le contexte complet de l'entreprise — exactement quand et où cela est nécessaire, avec la fiabilité de production et le déploiement simplifié dont les équipes modernes ont besoin.
Dans ce chapitre, nous allons vous expliquer comment créer une application Streamlit sécurisée et compatible CI/CD et la déployer en tant qu'application Databricks qui se connecte à Lakebase. L'application permet aux utilisateurs d'explorer les métriques de campagne synchronisées à partir d'Unity Catalog dans une interface en lecture seule. Cela peut alimenter des cas d'utilisation tels que les tableaux de bord professionnels, le suivi de campagne ou l'exploration ad hoc.
Technologies clés
- Streamlit : framework d'interface utilisateur interactif pour Python
- SQLAlchemy : boîte à outils SQL et ORM pour l'accès aux bases de données
- SDK Databricks : gestion sécurisée des jetons OAuth
- Postgres (Lakebase) : back-end OLTP géré
- DABs : déploiement déclaratif d'applications et intégration CI/CD
- GitHub : Contrôle de code source et automatisation de pipeline
Présentation de la solution
Le processus se compose de deux étapes principales :
- Configurer Lakebase
- Créez une instance Lakebase (Postgres géré par Databricks)
- Synchroniser une table Unity Catalog dans l'instance Postgres via le mode Snapshot
- Créer une application Databricks
- Utiliser Streamlit pour l'interface utilisateur
- Connectez-vous en toute sécurité à Lakebase à l'aide de SQLAlchemy et de Databricks OAuth
- Ajouter des filtres interactifs et des vues sur la table relationnelle
- Utilisez Databricks Asset Bundles (DAB) et GitHub pour le contrôle de version, le déploiement et l’automatisation
Consultez le GitHub repository pour obtenir le code source complet et les instructions de déploiement.
Guide étape par étape
Pour rationaliser le développement, nous vous recommandons de configurer Cursor avec Databricks Connect pour les tests et les itérations en local.
1. Configurez Lakebase
Si vous ne disposez pas encore d'une instance Lakebase avec des tables synchronisées, suivez ces étapes :
1. Créer une instance Lakebase
Suivez les étapes 1 à 7 de la documentation Lakebase pour créer une instance Lakebase nommée postgres-campaigns.
2. Cloner le GitHub repository
Le repository contient les fichiers suivants pour le déploiement de l'application :
- app.py — L’application principale de Streamlit
- config.yaml — Configuration centralisée pour les paramètres de la base de données et des tables
- generate_campaign_data.ipynb — Notebook pour générer des données sur les performances des campagnes
- requirements.txt — Toutes les dépendances Python, y compris Streamlit, SQLAlchemy et le SDK Databricks
- databricks.yml — Configuration de déploiement déclarative pour les DAB
- README.md — Documentation claire pour la configuration et l'utilisation
- .gitignore — Exclusion de fichiers locaux et spécifiques à l'environnement pour garder le repository propre
3. Créer une table Unity Catalog
Ouvrez le script generate_campaign_data.ipynb à partir du repository GitHub cloné. Dans les widgets du notebook, fournissez le catalogue, le schéma et le nom de la table, puis exécutez le script pour générer des données synthétiques sur les performances des campagnes.
4. Synchroniser la table Unity Catalog
Utilisez la fonctionnalité Tables synchronisées pour créer une table en lecture seule dans Postgres qui synchronise automatiquement les données d'une table Unity Catalog. Suivez les étapes ici pour créer une table synchronisée. Synchronisez la table avec votre instance Lakebase de l'étape 1.
- Base de données Postgres : campaign_db
- Nom de la table : campaign_metrics_synced
- Mode : Instantané
Vous devriez maintenant avoir :
- Une instance Lakebase : postgres-campaigns
- Une table relationnelle synchronisée : campaign_metrics_synced
2. Déployer l'application
Nous allons maintenant créer une application Streamlit qui se connecte à votre instance Lakebase et affiche les données de manière interactive.
1. Mettre à jour la configuration
Dans votre GitHub repository cloné, modifiez config.yaml avec les informations de votre base de données. Vous trouverez les informations requises sous le tab « Détails de connexion » de votre base de données.
2. Installer les dépendances
3. Définir les variables d'environnement Databricks
Allez dans Paramètres > Développeur > Jetons d'accès > Gérer > Générer un nouveau jeton pour obtenir un nouveau jeton d'accès personnel (PAT). Définissez les variables d'environnement comme suit :
4. Configurer la base de données Postgres
Pour vous connecter à votre propre base de données Postgres, mettez à jour la section DB_CONFIG dans app.py :
5. Mettre à jour le nom de l'application
Le fichier databricks.yml définit votre application comme une ressource déployable. Saisissez le nom de votre application :
6. Déployer à l'aide de DABs
Le code source de votre bundle sera désormais disponible dans le Workspace Databricks à l'emplacement suivant :
Vous pouvez accéder à votre application via Calcul > Applications > <your-app> et ouvrir le Link fourni. Comme votre application ne dispose pas encore des privilèges pour accéder à votre base de données, vous ne pourrez pas voir vos données pour le moment.
3. Configurer les privilèges de l'application pour la base de données
1. Extraire CLIENT_ID de l’application
- Naviguez vers Compute > Applications > <your-app>
- Dans votre application, ouvrez la tab Environnement et copiez la valeur de votre DATABRICKS_CLIENT_ID
2. Accordez des privilèges à l'application
- De retour dans votre instance Postgres (Compute > OLTP Database > >votre-instance>), cliquez sur New Query.
- Validez que la compute sélectionnée dans l'éditeur affiche la compute Postgres.
- Transférez la base de données de « postgres » à votre base de données Postgres — par exemple, les campagnes Postgres
- Exécutez le code suivant :
Vous pouvez revenir à votre application via Compute > Applications<your-app> >. Ouvrez le Link fourni et vous verrez votre table relationnelle.
Points forts de la connexion Postgres avec Oauth
À l'aide du SDK Databricks, l'application utilise des jetons OAuth pour s'authentifier de manière sécurisée auprès de l'instance Postgres gérée.
- Ne nécessite aucune gestion manuelle des jetons
- Actualise automatiquement les jetons toutes les 15 minutes.
- Utilise les identifiants de votre Workspace Databricks
Enseignements apprises
- Databricks OAuth — Est fluide et prêt à la production pour l’authentification des applications
- Streamlit — Offre un prototypage rapide pour les outils destinés aux entreprises
- Databricks Asset Bundles (DABs) — Simplifiez le déploiement et la restauration — essentiels pour les pipelines CI/CD
- Tables synchronisées — Rendez les données transactionnelles immédiatement accessibles dans Databricks Apps
Essayez-le vous-même
Souhaitez-vous l'essayer sur vos propres données ?
- Cloner le repository GitHub
- Personnaliser DB_CONFIG dans app.py
- Personnalisez your-app-name dans databricks.yml
- Déployer à l'aide de databricks bundle deploy
Donnez vie aux données opérationnelles dans Databricks Apps en quelques lignes de code seulement — et donnez à vos équipes les informations dont elles ont besoin, là où elles en ont besoin.
Créez une application intelligente dès aujourd’hui. Synchronisez vos données de lakehouse dans Lakebase en quelques minutes, sans construire de pipeline ni maintenir un serveur.
06 | Comment créer des agents d'IA avec une mémoire conversationnelle à l'aide de Lakebase
Par Yatish Anand, Bo Cheng, Cathy Zdravevski, Evan Pandya et Susan Pierce
Pourquoi la mémoire conversationnelle est importante
De nombreux agents d'IA fonctionnent bien dans les interactions à tour unique, mais rencontrent des difficultés lorsqu'ils sont appliqués à de vrais workflows opérationnels. En cybersécurité, les enquêtes se concluent rarement en une seule étape : les analystes passent du type de menace à l'adresse IP source, de l'adresse IP à l'utilisateur et de l'utilisateur à l'appareil. Ces investigations s'étendent souvent sur plusieurs sessions et nécessitent une continuité.
Pour être efficaces en production, les agents ont besoin d'un état. Ils doivent se souvenir de ce qui s'est déjà passé et reprendre leur travail avec le contexte complet intact.
Dans ce chapitre, vous allez créer un agent d'IA de cybersécurité sur la Databricks Platform qui conserve la mémoire conversationnelle entre les interactions. L'agent stocke l'état d'exécution dans Lakebase à l'aide du checkpointing LangGraph, ce qui permet aux enquêtes de s'interrompre et de reprendre sans interruption. Vous déploierez l'agent à l'aide du Databricks AI Agent Framework et l'exposerez aux utilisateurs finaux en tant qu'application Databricks créée avec Streamlit.
Utilisation de Lakebase comme couche d'état pour les agents
Les agents stateful ont besoin d'une base de données transactionnelle capable de lire et d'écrire l'état de l'application avec une latence minimale. Lakebase fournit cette base en tant que service OLTP entièrement managé, compatible avec Postgres et complètement intégré à la Databricks Platform. Comme il est compatible avec Postgres, vous bénéficiez de la fiabilité et de l'écosystème d'une base de données transactionnelle éprouvée sans avoir à mettre en place une infrastructure distincte.
Dans cette solution, Lakebase sert de magasin de points de contrôle pour LangGraph. Chaque étape de l'exécution de l'agent est persistée sous un identifiant de thread, et lorsque ce thread est à nouveau référencé, l'agent reprend avec son contexte complet — messages précédents, appels d'outils et état intermédiaire — intact. Les lectures à faible latence permettent à l'agent de récupérer rapidement ce contexte, ce qui maintient la réactivité des conversations.
Cette approche permet une véritable mémoire conversationnelle sans introduire de base de données distincte ni gérer de complexité opérationnelle supplémentaire. La logique de l'agent, les outils, la mémoire et le déploiement se trouvent tous sur la même plateforme où vos données et vos charges de travail d'IA s'exécutent déjà.
Modèles de mémoire pour les agents d'IA
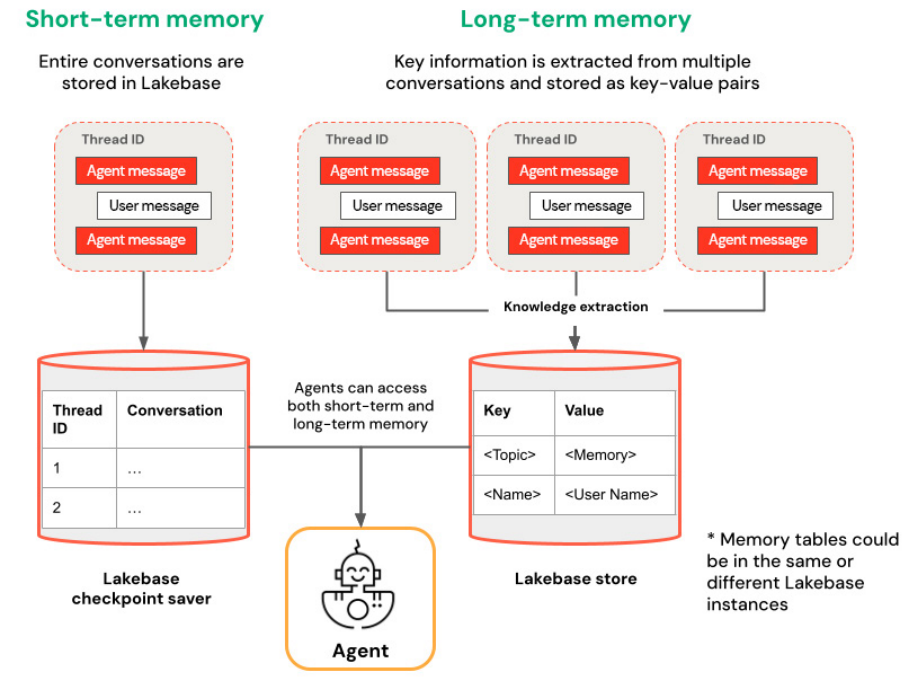
Ce chapitre se concentre sur la mémoire à court terme implémentée via un point de contrôle au niveau des threads. Chaque conversation est associée à un identifiant de thread unique, et l’état de l’agent est sauvegardé progressivement au fur et à mesure que le workflow progresse. Cela permet de reprendre les enquêtes à tout moment sans perdre de contexte.
Lakebase prend également en charge des modèles de mémoire à plus longue durée de vie qui conservent les informations entre les threads et les utilisateurs. Ces modèles permettent aux agents d'accumuler des connaissances au fil du temps, mais introduisent des considérations de conception supplémentaires concernant la portée, la conservation et la gouvernance. Pour la mémoire à long terme qui conserve les préférences de l'utilisateur ou les résultats accumulés entre les sessions, consultez la section sur la mémoire à long terme dans la documentation de Databricks.
Vue d'ensemble de l'architecture
La solution se compose des éléments suivants :
- Un modèle de chat servi sur Databricks qui effectue un raisonnement
- Fonctions Unity Catalog qui exposent des données de sécurité régies en tant qu'outils
- Orchestration LangGraph pour gérer le flux de contrôle et l'appel d'outils
- Lakebase provisionné en tant que checkpointer transactionnel pour l'état de l'agent
- Databricks AI Agent Framework pour le packaging et le déploiement
- Une application Databricks basée sur Streamlit pour l'interaction avec l'utilisateur final
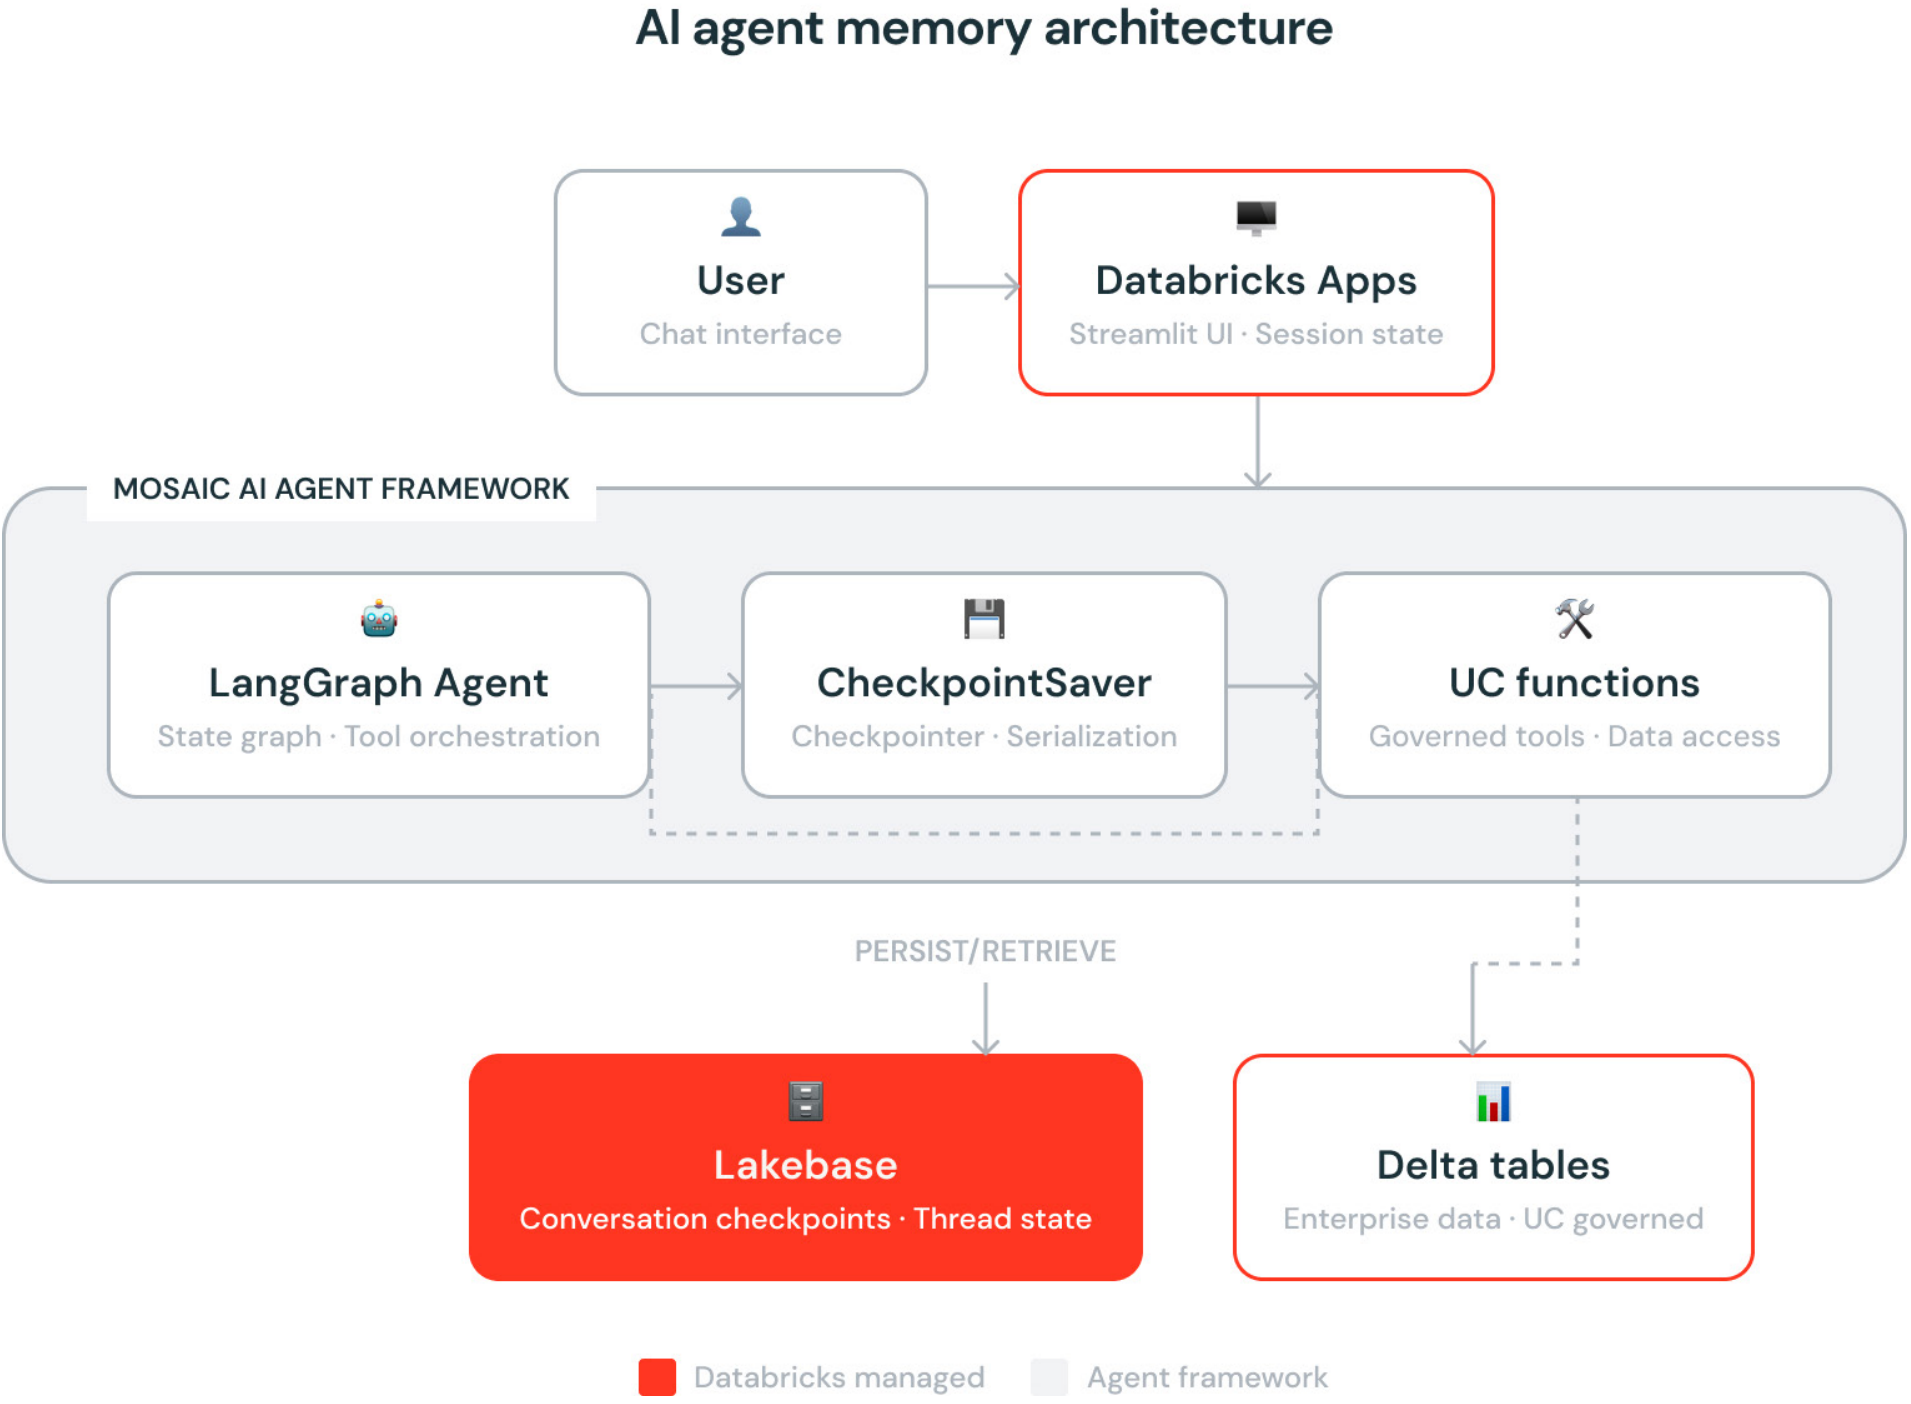
Ensemble, ces composants forment une architecture d'agent avec état, prête pour la production, qui s'exécute entièrement sur la Databricks Platform.
Guide d'implémentation
Prérequis
Ce guide suppose que vous êtes familiarisé avec la création d'applications d'IA sur la Databricks Platform et se concentre sur l'architecture de l'agent plutôt que sur l'amorçage de l'environnement.
Avant de commencer, assurez-vous de disposer des éléments suivants :
- Un Databricks Workspace avec un accès au Serverless compute
- Autorisations pour créer des fonctions Unity Catalog
- Autorisations pour créer une instance de provisionnement par Lakebase
- Accès à Databricks Model Serving et aux Databricks Apps
Vous utiliserez les bibliothèques suivantes dans cette démo. Exécutez la configuration sur le compute Serverless Databricks dans un Notebook, puis suivez les instructions pas à pas. Le repository GitHub avec la solution complète et fonctionnelle se trouve ici.
Étape 1 : Ajouter un contexte de sécurité régi avec les fonctions Unity Catalog
Les agents dépendent d'un contexte de confiance pour prendre des décisions. Dans les workflows de cybersécurité, ce contexte réside souvent dans des tables d'événements et d'identités structurées. Les fonctions Unity Catalog fournissent un mécanisme sécurisé pour exposer ces données aux agents en tant qu'outils appelables.
Dans cet exemple, vous créez deux fonctions SQL :
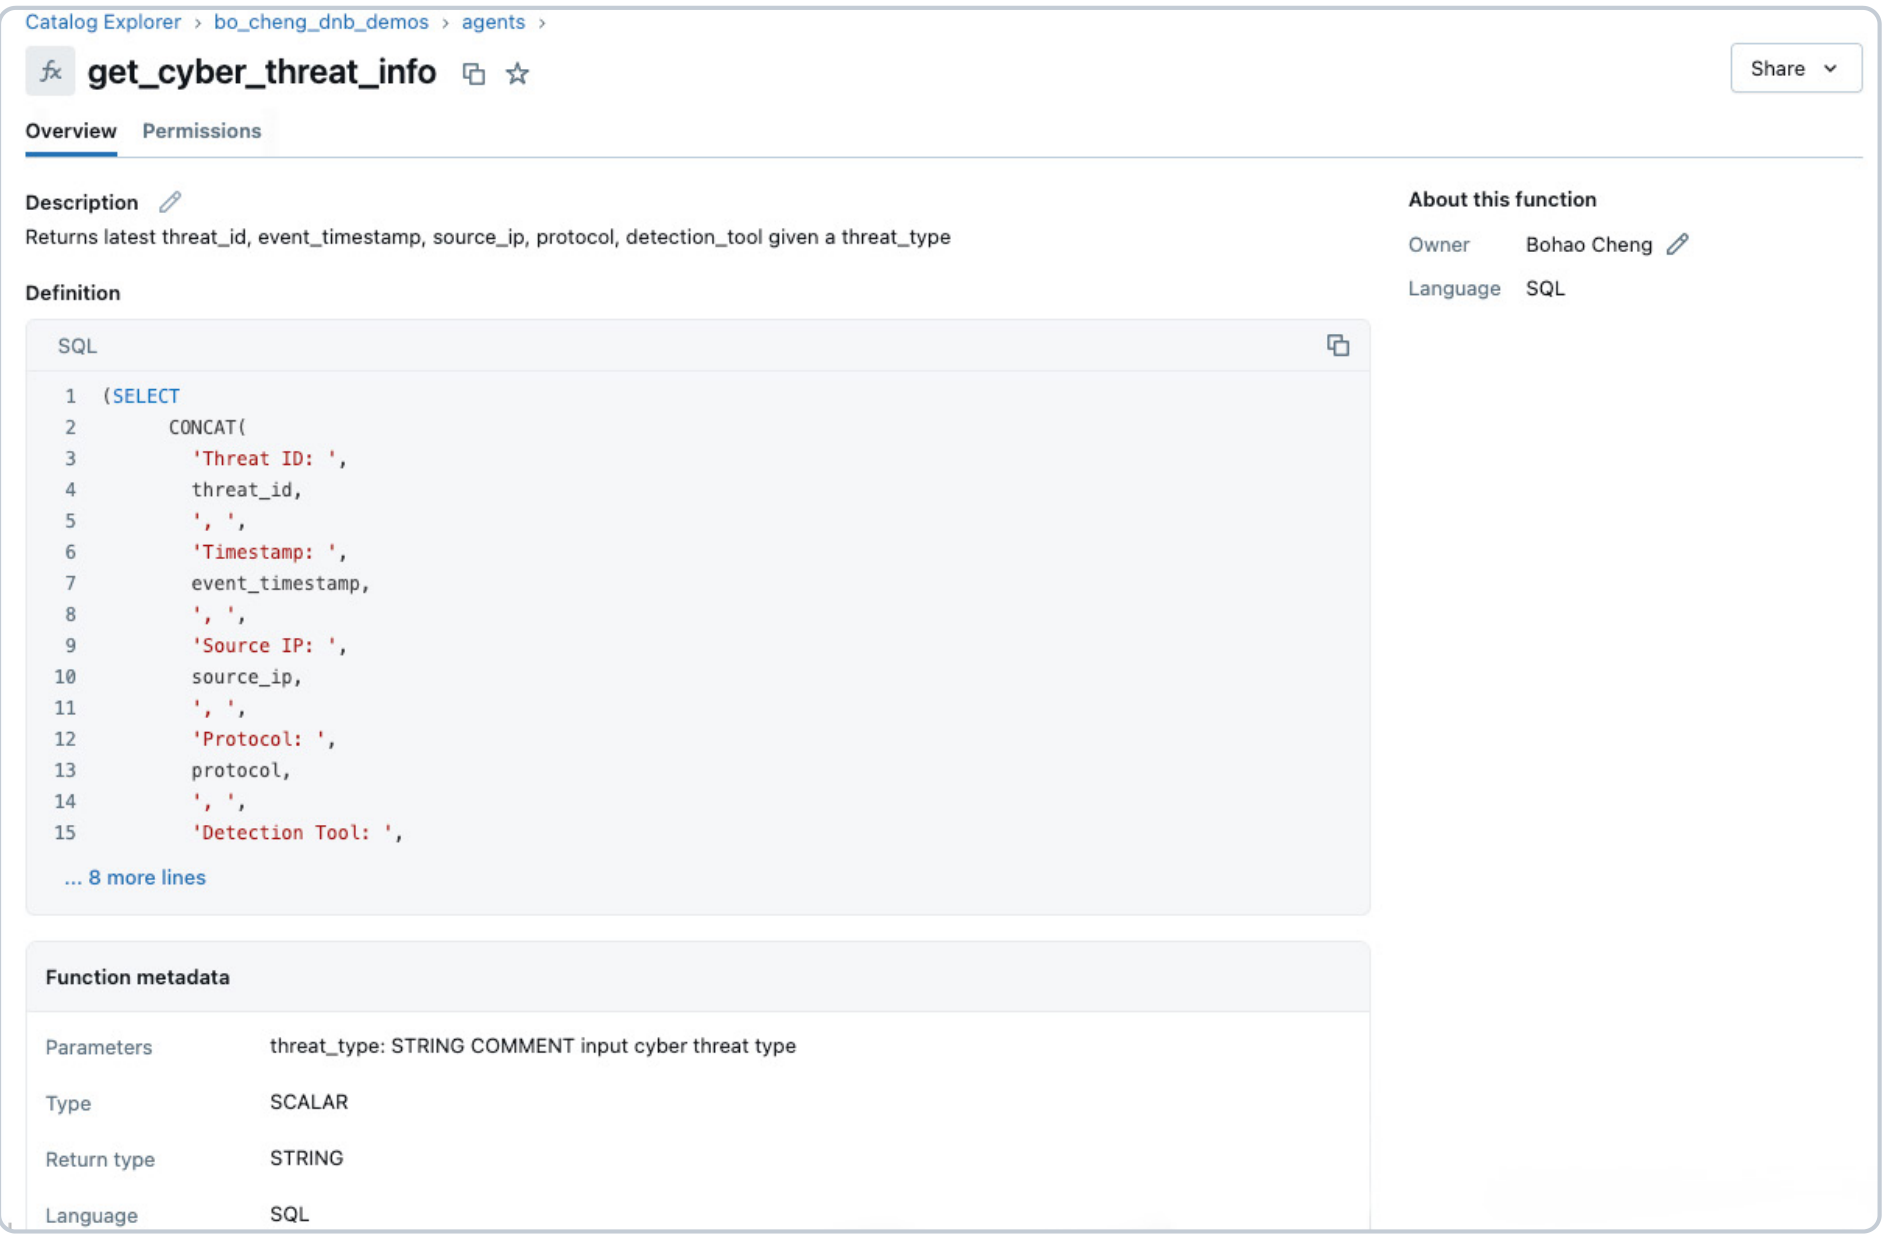
- get_cyber_threat_info récupère l'événement de menace le plus récent pour un type de menace donné
- get_user_info récupère les informations de l'utilisateur associées à une adresse IP source
Ces fonctions sont créées en Databricks SQL (DBSQL) et régies par Unity Catalog, garantissant un contrôle d'accès, un audit et une traçabilité cohérents.
Une fois que vous avez créé les fonctions, vous devriez les voir dans votre catalogue et votre schéma désignés, sous le tab.
Étape 2 : Créer une instance Lakebase pour les points de contrôle
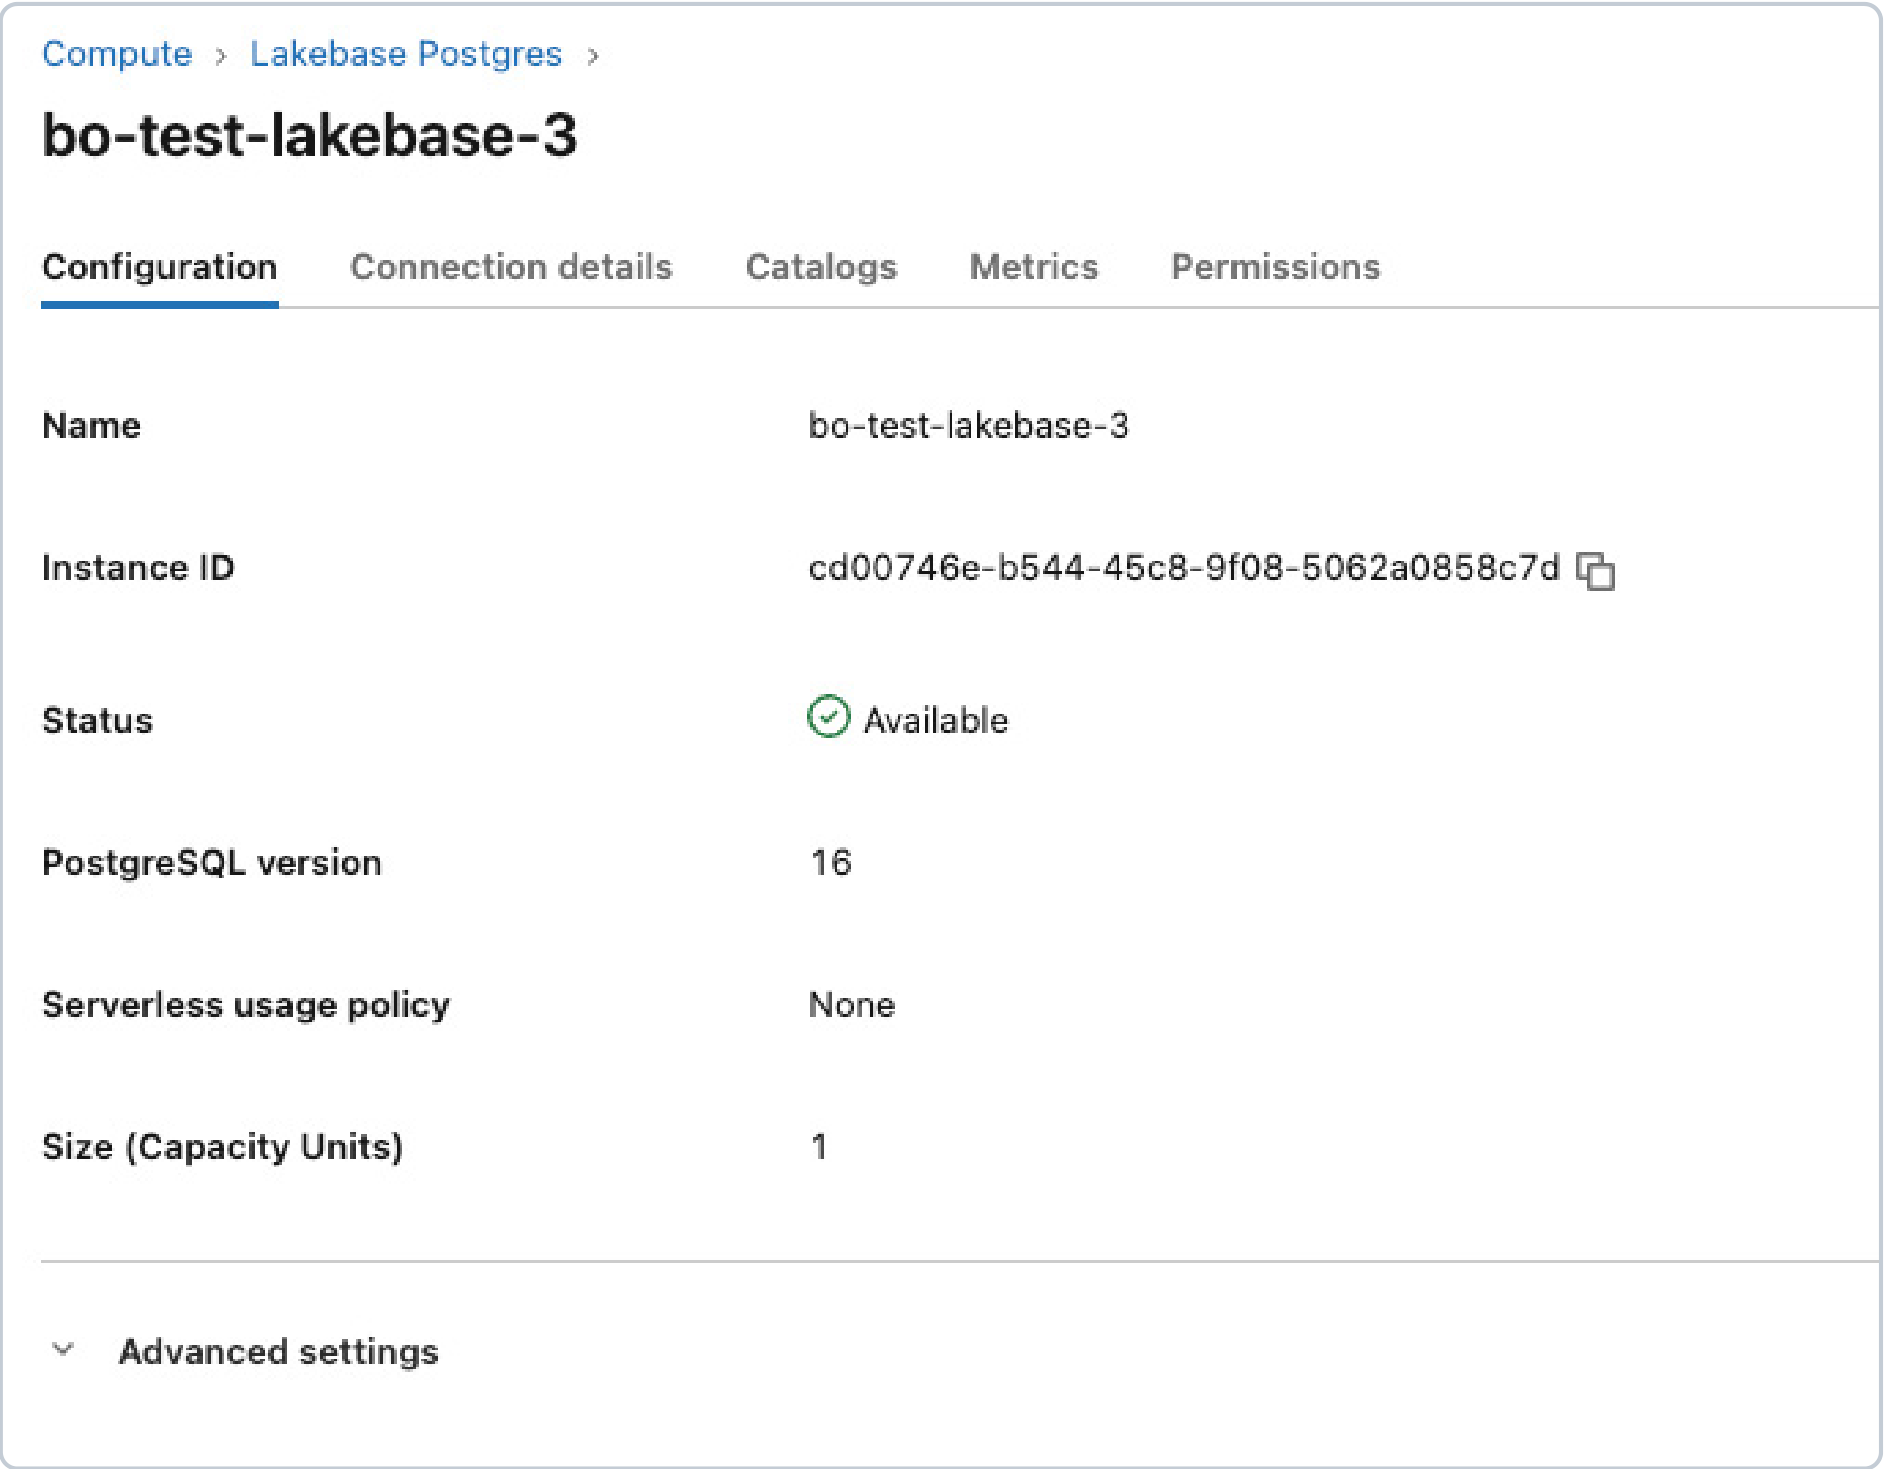
Pour persister l'état de l'agent, créez une instance Lakebase qui sert de point de contrôle LangGraph. Plutôt que de gérer une base de données Postgres externe, Lakebase fournit un service transactionnel géré qui s'intègre directement à la sécurité et à l'identité de Databricks.
Chaque étape d'exécution de l'agent est écrite dans Lakebase. Comme Lakebase est optimisé pour les charges de travail transactionnelles à faible latence, ces écritures ajoutent une surcharge minimale au temps de réponse de l'agent. En associant les points de contrôle à un identifiant de thread, l'agent peut reprendre de manière fiable les conversations d'une session à l'autre sans sacrifier la réactivité attendue par les utilisateurs.
Cette implémentation utilise l'intégration langgraph-checkpoint-postgres afin que LangGraph puisse persister l'état de l'agent directement dans Lakebase en utilisant la sémantique Postgres standard.
Vous pouvez créer l'instance Lakebase à l'aide du SDK Databricks pour Python ou la gérer de manière déclarative avec les Databricks Asset Bundles (DABs), selon la manière dont vous standardisez l'infrastructure.
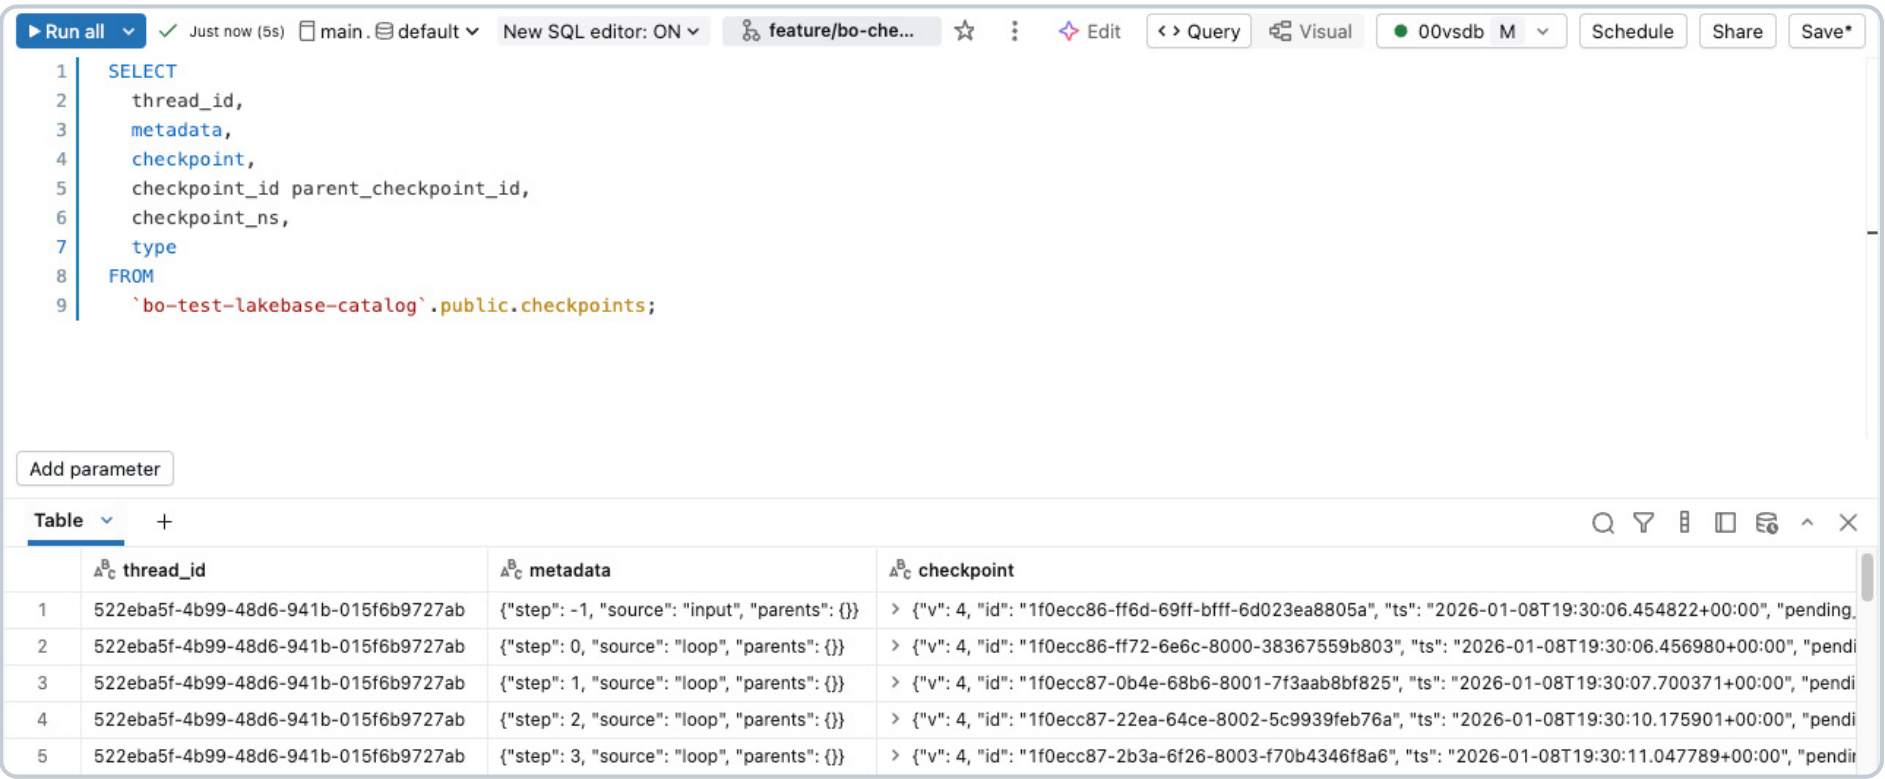
De plus, en créant le catalogue de base de données, vous pouvez désormais interroger l'historique de vos points de contrôle à l'aide de DBSQL.
Étape 3 : Orchestrer avec LangGraph et tracer avec MLflow
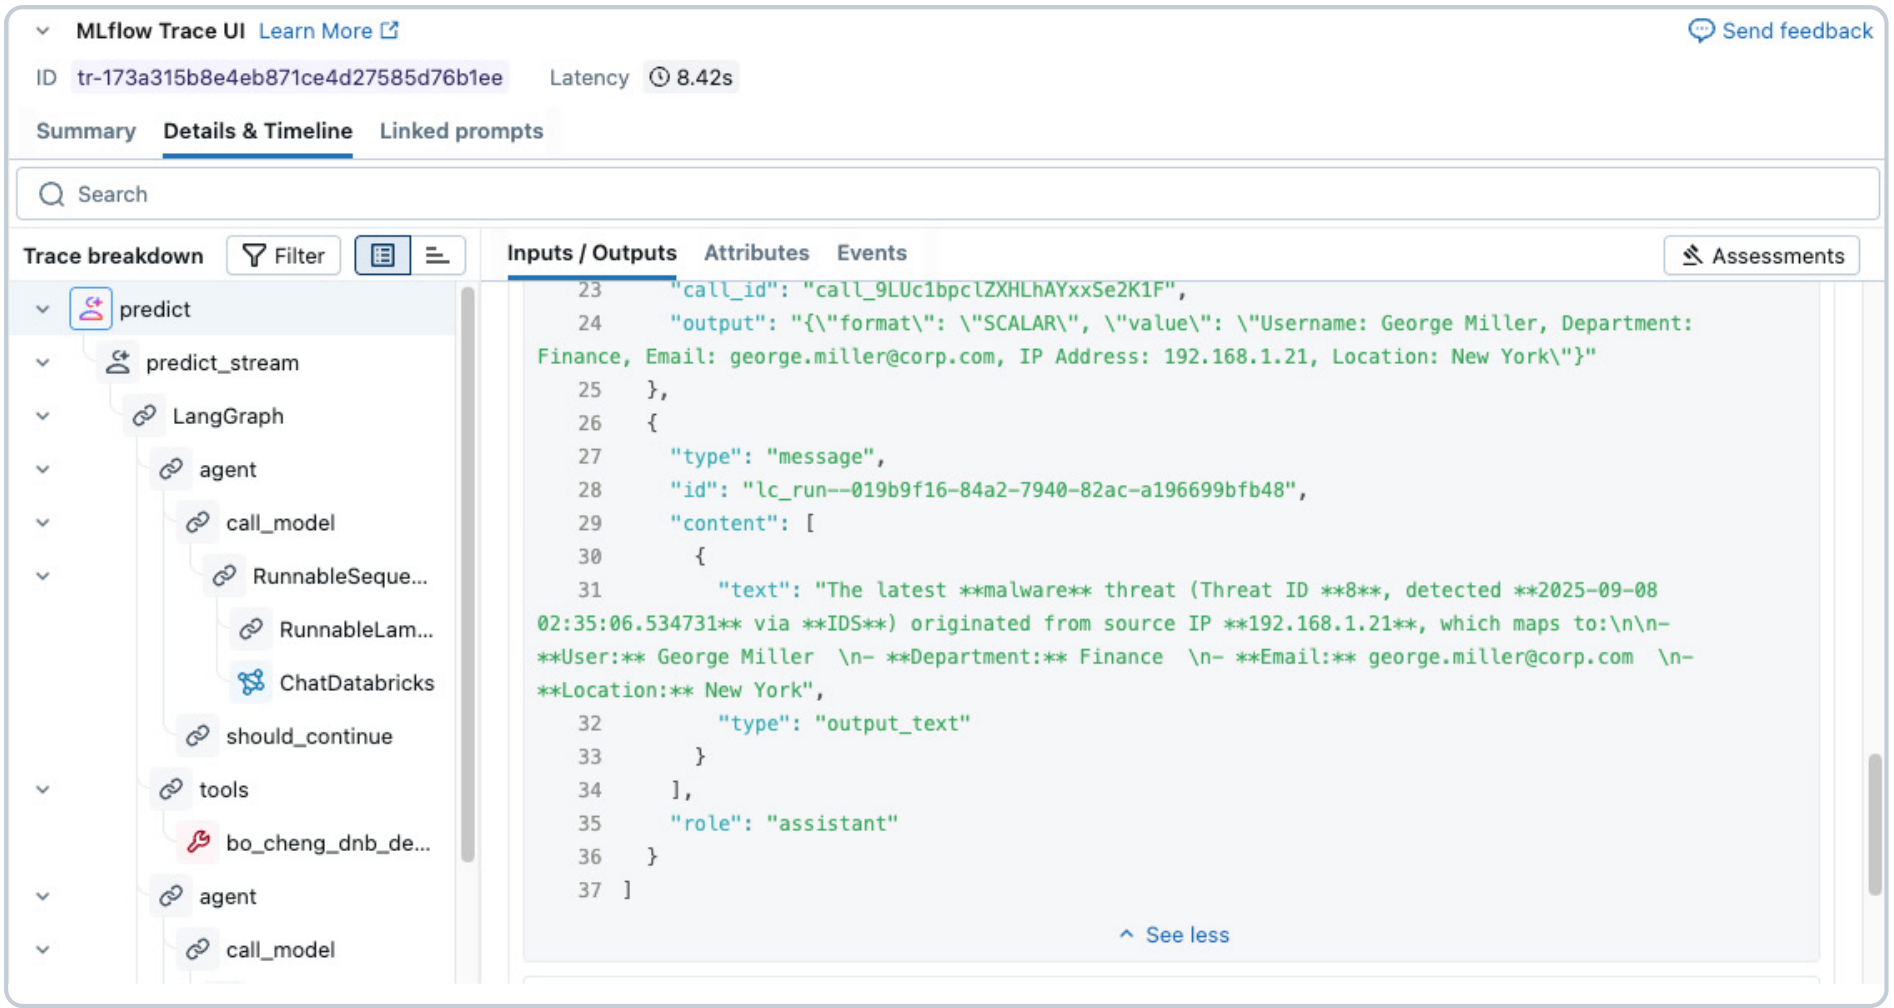
Databricks s'intègre directement au framework d'orchestration LangGraph. Si vous suivez les étapes, sélectionnez l'option LangGraph. LangGraph fournit le plan de contrôle pour le comportement de l'agent — quand appeler le modèle, quand appeler les outils et comment conserver l'état entre les tours. Dans cette implémentation, vous liez les outils Unity Catalog au modèle de chat et utilisez un checkpointer adossé à Lakebase pour sauvegarder et restaurer l'état au niveau du thread.
Avant le déploiement, validez le comportement avec MLflow Tracing. Le traçage facilite l'audit des entrées, des sorties, des appels d'outils et des étapes intermédiaires, ce qui est essentiel pour le debugging et pour comprendre le comportement de l'agent en production.
Étape 4 : Déployer l'agent avec le Databricks AI Agent Framework
Une fois validé, l'agent est empaqueté et déployé à l'aide du Databricks AI Agent Framework. Cela simplifie l'enregistrement, le versionnage et la diffusion tout en préservant le transfert d'authentification vers les ressources gouvernées.
Lors de la journalisation de l'agent avec MLflow, déclarez explicitement les ressources dépendantes, y compris les points de terminaison de service de modèle, les fonctions Unity Catalog et l'instance Lakebase. Cela garantit que le déploiement a une visibilité claire sur les ressources dont il dépend. Le code suivant ne montre que les parties pertinentes des fonctions predict et predict_stream, qui illustrent le CheckpointSaver de mémoire à court terme databricks_langchain, qui s'intègre à Lakebase. N'hésitez pas à consulter notre GitHub repository pour obtenir le code complet du modèle.
Par la suite, vous devez journaliser et inscrire votre agent en utilisant l'approche models from code dans MLflow.
Une fois le modèle journalisé, vous pouvez utiliser le catalogue pour afficher les versions, les artefacts et même obtenir une vue d'ensemble du lignage montrant les objets Unity Catalog pertinents.
![],](https://www.databricks.com/sites/default/files/doc-importer/14/figure-556.png)
Enfin, vous pouvez utiliser un simple appel à la fonction `agents.deploy()` pour créer le Endpoint de service de modèle et instancier la Review App pour l'évaluation par les experts métier. Ici, vous consignez toutes les variables d'environnement nécessaires à l'authentification de votre agent, telles que l'ID client et le secret client d'un Service Principal désignés pour l'authentification auprès de l'instance provisionnée par Lakebase.
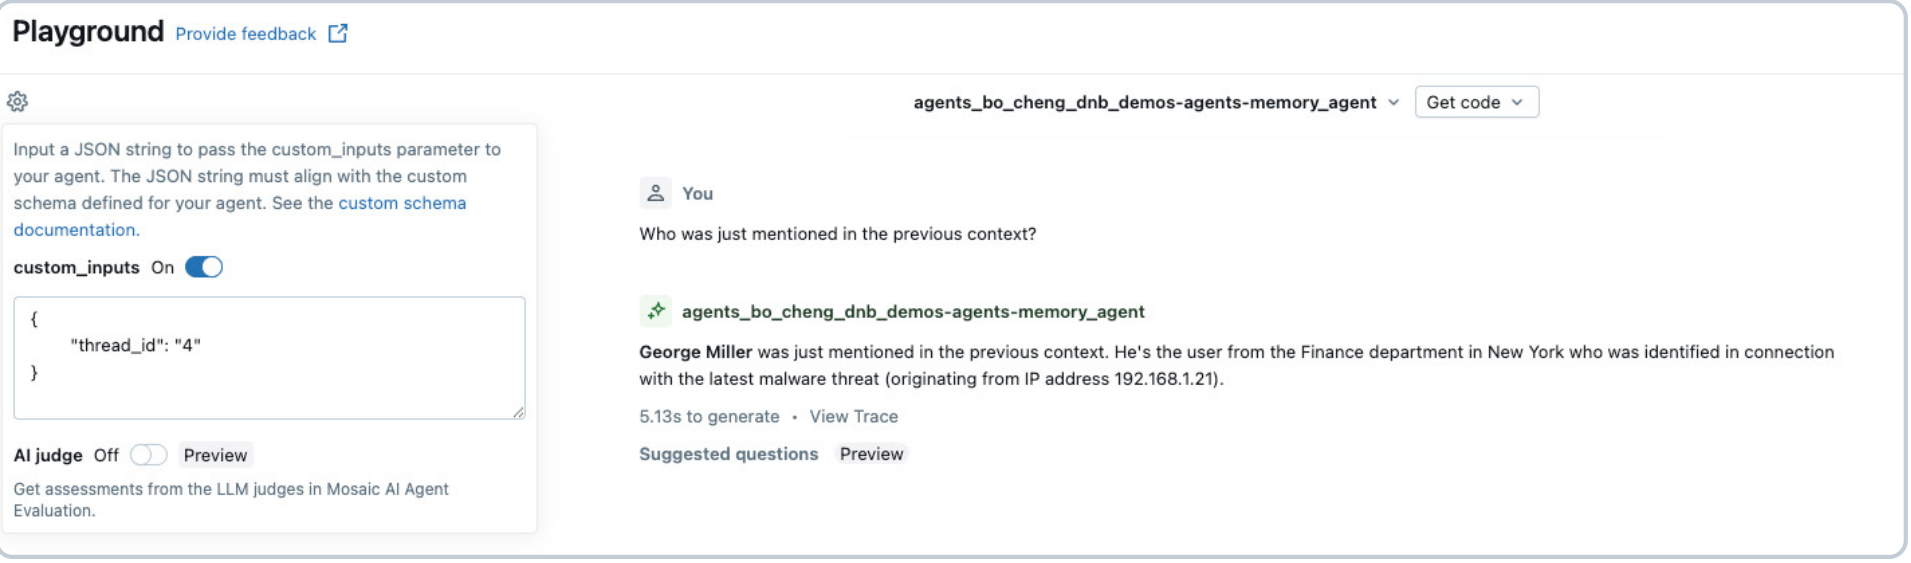
Après le déploiement, l'agent peut être testé à l'aide de l'AI Playground ou de la Review App avant d'être mis à la disposition des utilisateurs finaux. La Review App est une interface utilisateur de chat intégrée pour évaluer votre application d'IA avant de l'intégrer à votre application front-end Databricks.
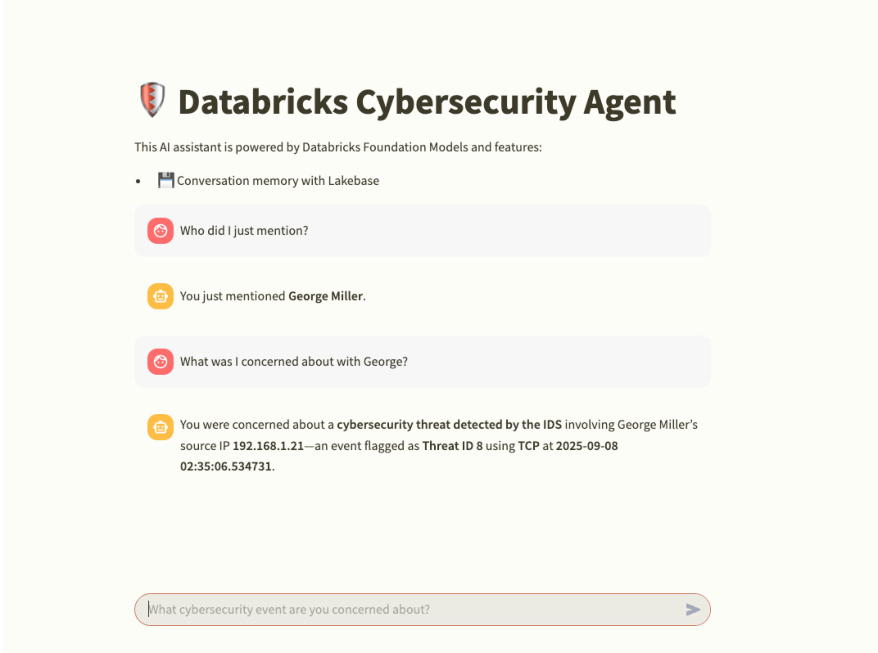
Vous pouvez désormais intégrer le model serving Endpoint avec une application Databricks — le moyen le plus sécurisé de construire des applications IA sur la Databricks Platform — avec un support prêt à l’emploi pour des frameworks Python comme Streamlit, Gradio, Plotly Dash, Shiny et Flask. Pour cet agent analyste en cybersécurité, nous utilisons Streamlit.
Databricks Apps propose deux modes d'authentification : l'autorisation d'application (à l'aide d'un Service Principal fourni) ou l'autorisation utilisateur (au nom de l'utilisateur, où l'application agit avec l'identité de l'utilisateur connecté). Dans les deux cas, vous utilisez le client de déploiement MLflow pour interagir avec l'Endpoint de service de modèle de votre agent.
La clé de la mémoire conversationnelle est le thread_id — un identifiant unique qui relie les points de contrôle d'une conversation dans Lakebase. Dans votre application Streamlit, les utilisateurs peuvent saisir un thread_id existant dans la barre latérale pour reprendre une conversation précédente exactement là où ils l'ont laissée. Dans la figure suivante, le thread_id est 4. Ainsi, si l'utilisateur ferme l'application et revient plus tard avec le même identifiant, l'agent reprend avec le contexte complet de la conversation précédente.
Si aucun thread_id n'est fourni, l'application en génère un nouveau pour la session, démarrant ainsi une nouvelle conversation. Il s'agit d'une implémentation simple pour démontrer le fonctionnement de la mémoire à court terme. En production, votre application gère généralement la persistance du thread_id automatiquement, en associant chaque utilisateur à ses fils de conversation afin qu'il n'ait pas à suivre les identifiants manuellement.
Conclusion
La mémoire avec états est essentielle pour les agents d’IA de production. Dans des domaines comme la cybersécurité, les enquêtes s’étendent sur plusieurs tours et les sessions et les agents doivent conserver le contexte pour être efficaces.
Dans ce guide, vous avez créé un agent de cybersécurité avec état sur Databricks en utilisant Lakebase comme couche de mémoire transactionnelle pour le checkpointing LangGraph. Les fonctions Unity Catalog fournissent un accès gouverné aux données, MLflow permet le traçage et la gestion du cycle de vie et le Databricks AI Agent Framework simplifie le déploiement. Ensemble, ces composants fournissent une architecture d'agent de bout en bout qui s'exécute entièrement sur la Databricks Platform.
Ce modèle s'applique de manière générale à tout workflow en plusieurs étapes qui nécessite une continuité. Avec Lakebase, vous pouvez ajouter une mémoire conversationnelle aux agents sans bases de données externes, unifiant ainsi l'état, la gouvernance et le déploiement sur une seule et même plateforme.
Ressources
Prochaines étapes ?