Intégrez Databricks dans Kiro IDE avec le Databricks Power
Deux façons de connecter Kiro IDE à la plateforme Databricks : les quatre serveurs MCP gérés par Databricks pour un démarrage en 10 minutes, ou le Databricks Power et les compétences d'agent officielles pour l'ensemble des fonctionnalités.
- Deux façons de connecter Kiro IDE à Databricks : les quatre serveurs MCP gérés par Databricks (Genie, SQL, Unity Catalog Functions, AI Search) pour une configuration en 10 minutes basée sur un PAT, ou le Databricks Power, qui installe les compétences d'agent officielles de Databricks avec la Databricks CLI.
- Un développement assisté par l'IA ancré dans les métadonnées réelles de l'espace de travail : les deux approches héritent de vos autorisations Unity Catalog, de vos filtres de lignes et de vos masques de colonnes, afin que l'assistant écrive du SQL avec vos colonnes réelles et ne voie que ce que vous êtes autorisé à voir.
- Choisissez selon le périmètre : l'approche A est la configuration la plus légère pour les analystes et les développeurs orientés SQL ; l'approche B ouvre toute la plateforme Databricks (pipelines, jobs, Agent Bricks, Lakebase, Declarative Automation Bundles) dans l'IDE.
Pourquoi c'est important
Le développement assisté par l'IA s'effondre dès que l'assistant doit deviner des noms de colonnes, la structure des tables ou les catalogues que vous pouvez lire. La solution, c'est l'ancrage : connectez l'assistant aux métadonnées en direct de l'espace de travail via le Model Context Protocol (MCP). Le SQL qu'il écrit utilise alors vos colonnes réelles, les modèles dbt joignent de vraies tables, et chaque requête hérite des autorisations Unity Catalog déjà en place. L'accès est appliqué dans Databricks, de sorte que l'IA ne voit que ce que vous êtes autorisé à voir.
Deux étapes clés rendent cela concret dans Kiro IDE, développé par AWS :
D'abord, Kiro est désormais un agent pris en charge par la Databricks CLI. Depuis la CLI v1.20.0, databricks aitools install --agents kiro installe les compétences d'agent officielles de Databricks dans ~/.kiro/skills/. Les compétences autrefois fournies avec le Databricks AI Dev Kit sont désormais ces compétences officielles, et la CLI les installe.
Ensuite, le Databricks Power du catalogue Kiro Powers installe désormais ces mêmes compétences officielles : il configure les compétences avec la Databricks CLI et ne fournit aucun serveur MCP. Installez-le depuis le panneau Powers ; sa compétence de configuration vous guide dans la vérification de la CLI, la connexion et l'installation des compétences.
Avec les quatre serveurs MCP distants gérés par Databricks déjà intégrés à la plateforme, vous disposez de deux façons de connecter Kiro à Databricks. Les deux aboutissent au même résultat : les développeurs livrent plus vite leurs analyses, leurs pipelines et leurs workflows d'agents lorsque l'assistant hérite des autorisations réelles de l'espace de travail au lieu de deviner les schémas, les colonnes et les autorisations.
Pourquoi choisir Databricks pour le développement assisté par l'IA
Les deux étapes clés ci-dessus rendent Kiro × Databricks concret. Mais ce qui compte vraiment, c'est ce qu'il y a en dessous. Quatre éléments font de Databricks la base de choix pour le développement assisté par l'IA, quelle que soit l'approche retenue.
Unity Catalog ancre l'IA au niveau des données. Chaque appel s'exécute avec vos propres autorisations, qu'il s'agisse d'un outil MCP dans l'approche A ou d'une commande Databricks CLI exécutée par une compétence dans l'approche B : les autorisations sur les tables, les filtres de lignes et les masques de colonnes s'appliquent au SQL et aux agents Genie, et les index AI Search sont partagés individuellement. L'assistant n'a pas de vue privilégiée sur vos données ; il voit ce que vous voyez. Il n'y a pas de couche de contrôle d'accès distincte à gérer pour l'assistant.
Une seule copie des données, un seul jeu de définitions. Databricks étant un lakehouse, la table que l'assistant interroge via databricks-sql est celle dans laquelle écrit votre modèle dbt, celle qu'expose votre agent Genie et celle que lit votre tableau de bord AI/BI. Pas de synchronisation entre entrepôt et lac susceptible de se rompre, pas de couche sémantique distincte à maintenir à jour. Lorsque l'assistant s'appuie sur samples.tpch.lineitem, il s'appuie sur la même définition que tous les autres outils.
La pile d'IA complète est intégrée, pas ajoutée après coup. Unity Gateway achemine les appels de modèles. Agent Bricks orchestre les workflows multi-agents. MLflow suit les expériences et les évaluations. AI Search alimente la recherche sémantique. Lakebase gère l'état transactionnel. Les compétences couvrent tout cela (databricks-unity-gateway, databricks-agent-bricks, databricks-mlflow-evaluation, databricks-vector-search et databricks-lakebase), sur le même Unity Catalog. Vous n'assemblez pas cinq produits ; vous utilisez une seule plateforme.
Les compétences sont conçues par Databricks. Les protocoles sont ouverts, mais les instructions qu'elles contiennent sont rédigées par Databricks spécifiquement pour la façon dont nos clients développent.
Les deux approches en un coup d'œil
Critère | Approche A : serveurs MCP gérés | Approche B : Databricks Power |
|---|---|---|
Périmètre | 4 serveurs : Genie, SQL, Unity Catalog Functions, AI Search | Compétences d'agent officielles de Databricks, plus les compétences MLflow |
Ce que vous obtenez | SQL en langage naturel, recherche sémantique, exécution de fonctions gouvernée | Le périmètre de l'approche A, plus les pipelines, jobs, tableaux de bord, Lakebase, Agent Bricks, Declarative Automation Bundles, MLflow, Model Serving, Apps |
Hébergement | Géré par Databricks (HTTPS distant) | Compétences installées sur votre machine par la Databricks CLI (databricks aitools) ; aucun serveur MCP |
Authentification | PAT dans l'environnement du shell | Profil Databricks CLI, OAuth U2M recommandé |
Configuration | Modifier ~/.kiro/settings/mcp.json, exporter les variables d'environnement | Installer le Power, puis suivre sa configuration guidée de la CLI |
Idéal pour | Les analystes et développeurs orientés SQL qui veulent interroger leur entrepôt en 10 minutes | Les data engineers et développeurs de plateforme qui ont besoin de tout le périmètre Databricks dans un seul IDE |
L'architecture d'intégration en un coup d'œil
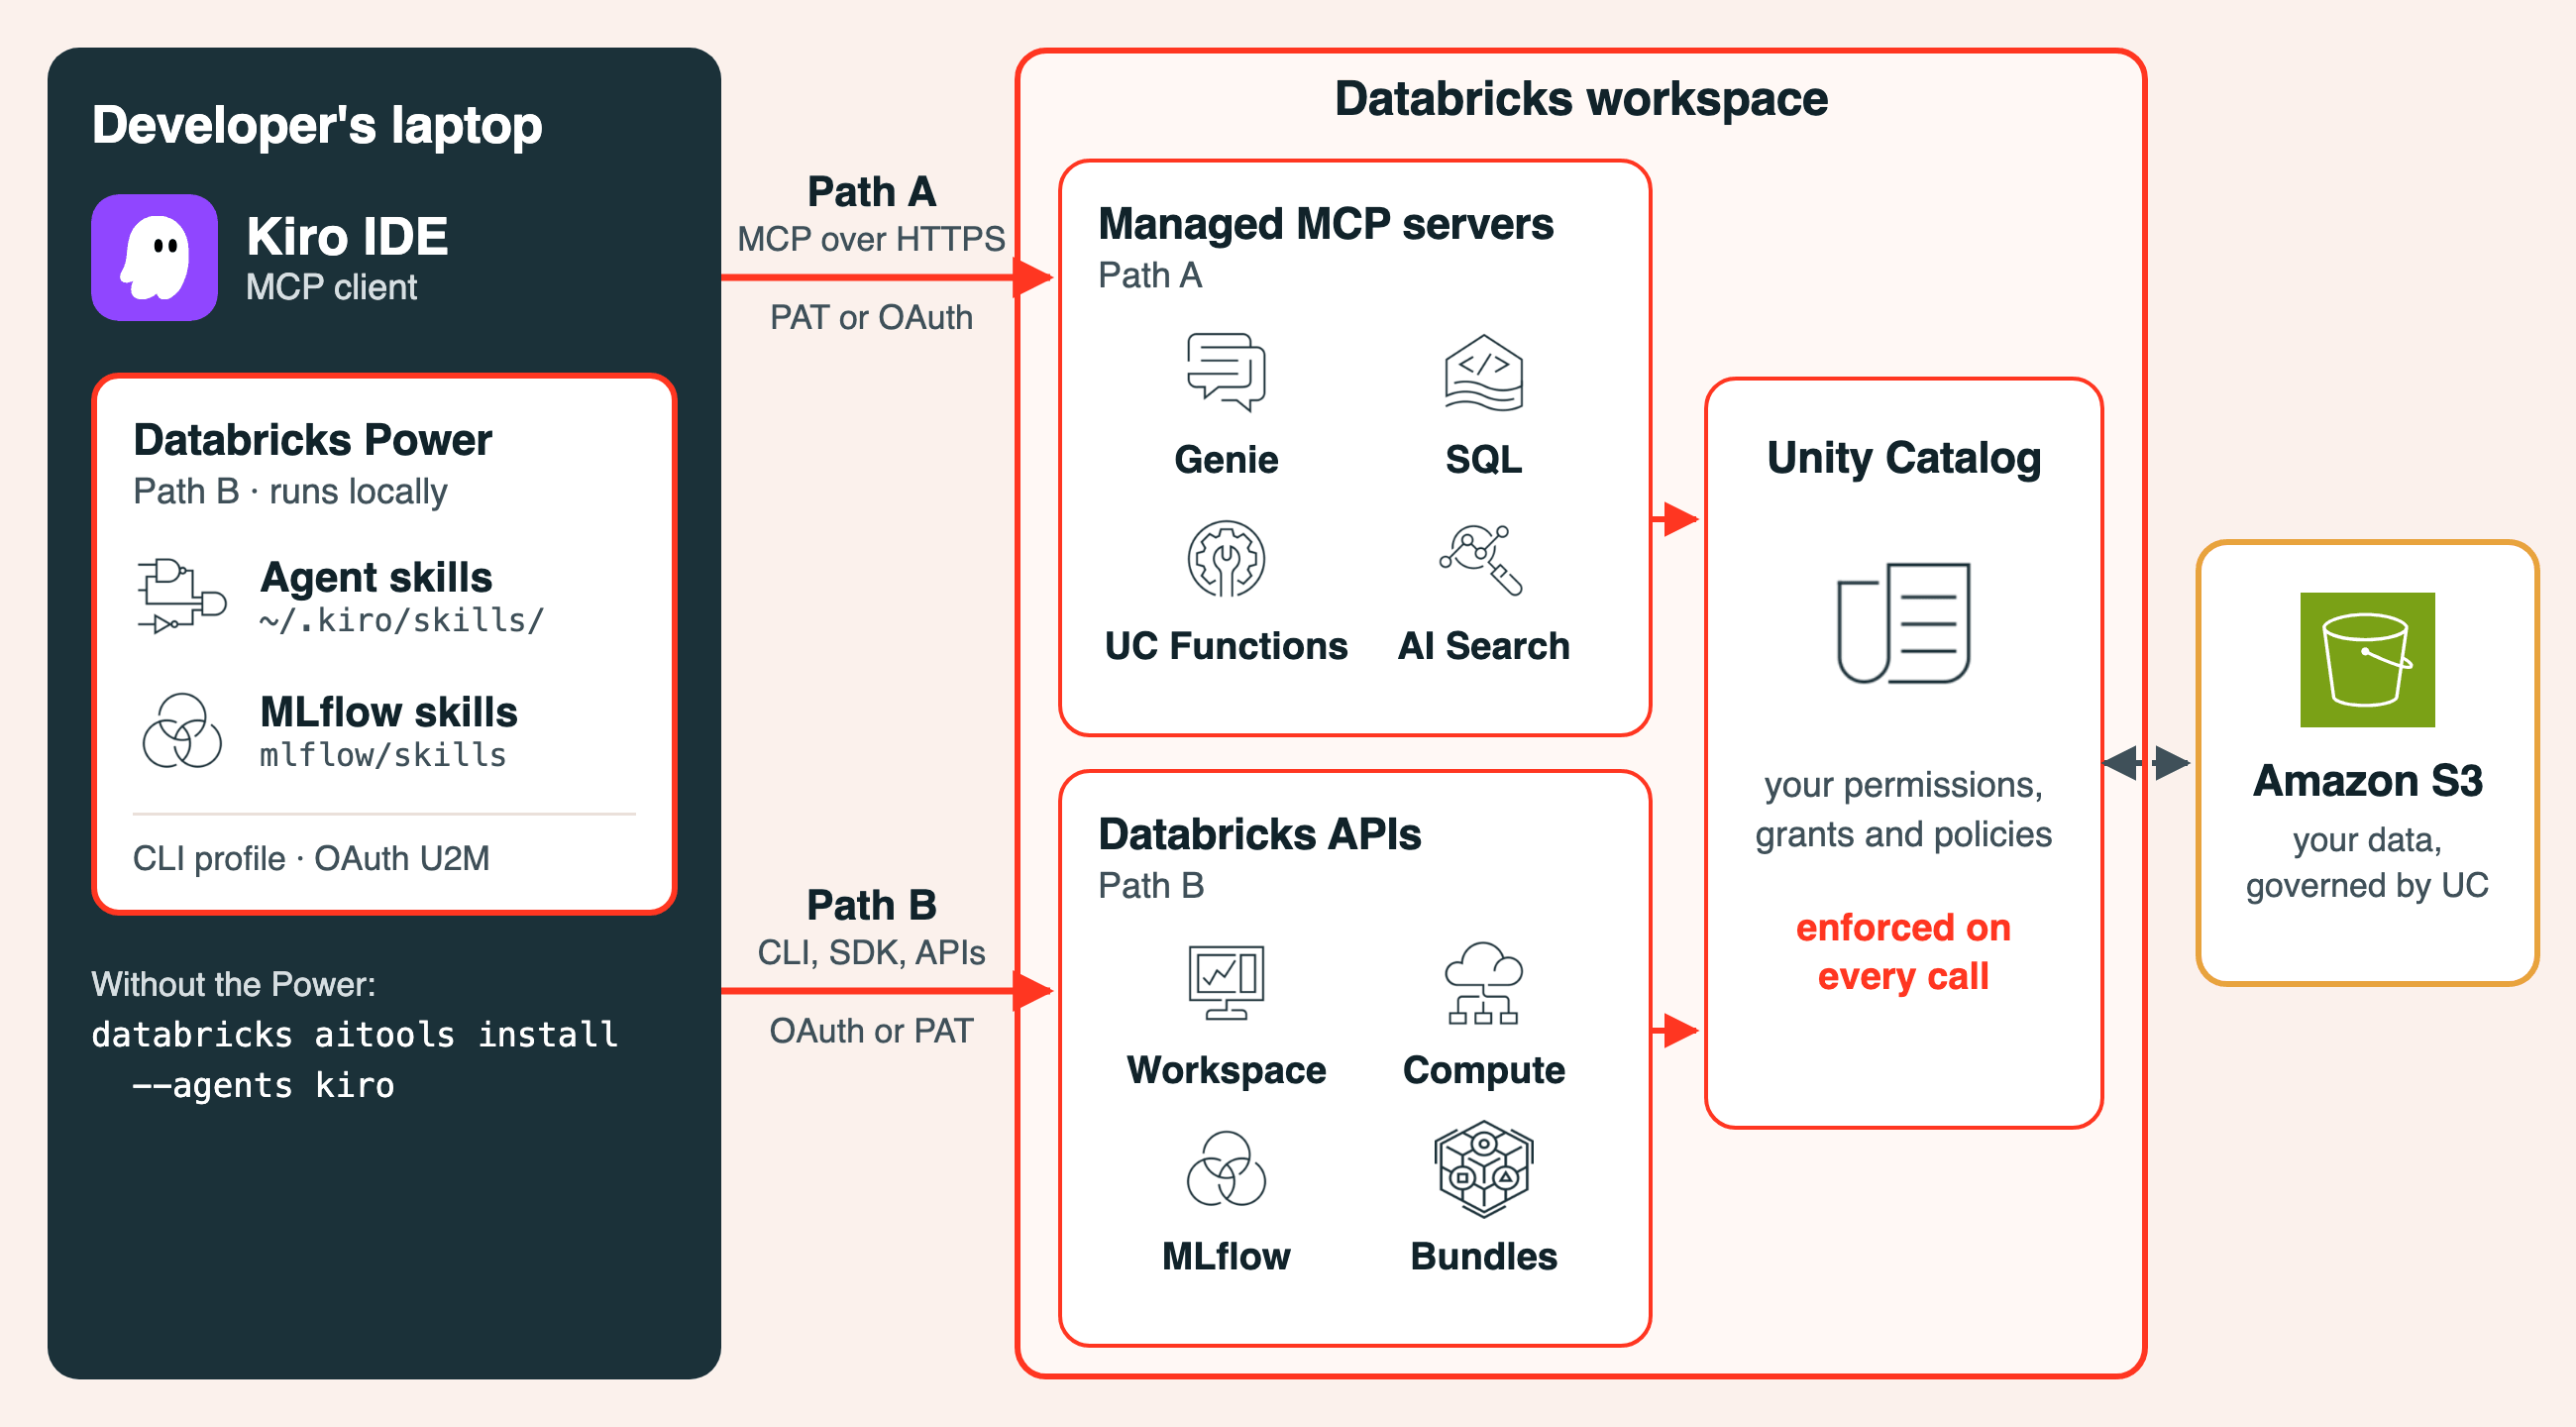
Les deux approches partagent le même back-end : l'application des règles par Unity Catalog et l'identité de l'espace de travail Databricks. Elles diffèrent par leur périmètre et leur modèle d'authentification.
Approche A : se connecter aux quatre serveurs MCP gérés
C'est la configuration la plus légère : un fichier mcp.json, un Personal Access Token Databricks et une modification du profil du shell. En moins de 10 minutes, Kiro communique avec Genie, SQL, Unity Catalog Functions et AI Search.
Pour les nouvelles intégrations, Databricks recommande désormais les MCP system.ai via Unity Gateway. Les quatre endpoints /api/2.0/mcp de cette approche sont en Public Preview et ne sont pas gouvernés par Unity Gateway. L'accès continue de suivre vos autorisations sur les ressources sous-jacentes (agents Genie, tables, fonctions, index et entrepôts SQL) ; vous renoncez seulement au traçage d'Unity Gateway et à ses autorisations, stratégies et garde-fous au niveau MCP. Le MCP Genie One (system.ai.genie_one_mcp) est disponible pour tous, et la compétence de configuration du Databricks Power montre comment l'ajouter à mcp.json. Consultez Databricks-provided MCPs pour les deux options.
Prérequis
- Un espace de travail Databricks sur AWS avec Unity Catalog activé.
- Un administrateur de l'espace de travail a activé Managed MCP Servers sur la page Previews de l'espace de travail. Sans cela, les URL ci-dessous ne fonctionnent pas.
- Un Personal Access Token (PAT) Databricks ou un jeton OAuth limité aux serveurs MCP que vous prévoyez d'utiliser (
sql,unity-catalog,genie,ai-search). Les PAT inutilisés sont révoqués automatiquement au bout de 90 jours. - Kiro installé et lancé au moins une fois, de sorte que
~/.kiro/existe. - Le nom d'hôte de votre espace de travail au format
<workspace>.cloud.databricks.com.
Générer un PAT Databricks
Dans l'espace de travail Databricks, accédez à Settings, Developer, Access tokens, Manage, Generate new token. Définissez une date d'expiration conforme à la politique de rotation de votre équipe. Ne sélectionnez que les périmètres d'API dont vous avez besoin ; le moindre privilège l'emporte sur la commodité du « tout ». Copiez le jeton immédiatement. Databricks ne l'affiche plus ensuite.
Où Kiro stocke la configuration MCP
Kiro lit la configuration MCP au format JSON dans deux portées ; la portée de l'espace de travail prévaut sur celle de l'utilisateur.
- Portée utilisateur :
~/.kiro/settings/mcp.jsons'applique à tous les espaces de travail. - Portée de l'espace de travail :
$PWD/.kiro/settings/mcp.jsons'applique uniquement à l'espace de travail actuel et remplace l'entrée de même clé de la portée utilisateur.
Installation en un clic depuis le répertoire de serveurs Kiro
Ouvrez kiro.dev/docs/mcp/servers/, repérez la ligne Databricks et cliquez sur Add to Kiro. Le navigateur lance Kiro et ouvre une boîte de dialogue de confirmation avec une configuration préremplie. Confirmez pour écrire l'entrée databricks-sql dans ~/.kiro/settings/mcp.json. Elle est créée désactivée, avec une URL d'exemple et une référence à la variable DATABRICKS_ACCESS_TOKEN. Ensuite, définissez l'URL sur ${DATABRICKS_SQL_MCP_URL}, passez "disabled" à false et créez les deux variables.
Vérifier (ou ajouter) l'entrée databricks-sql
Définir les variables d'environnement
Dans le profil du shell qui lance Kiro (généralement ~/.zshrc sur macOS) :
Rechargez le profil (source ~/.zshrc) avant de lancer Kiro. Quittez complètement Kiro (Cmd+Q sur macOS) puis rouvrez-le. Reload Window ne relit pas les variables d'environnement ; seul un redémarrage du processus le fait.
Kiro ne développe les références ${...} dans mcp.json que pour les variables d'environnement que vous avez approuvées. Lorsque Kiro affiche son invite de sécurité listant les variables DATABRICKS_*, approuvez-les, ou ajoutez-les vous-même sous Settings, Mcp Approved Env Vars.
Ajouter Genie, Unity Catalog Functions et AI Search
Les quatre serveurs gérés par Databricks se connectent en tant que MCP HTTP distants. La négociation initialize réussit même avec une URL d'exemple ; le serveur ne valide la ressource qu'au moment où un outil est appelé. Un état connecté mais défaillant, où tools/call renvoie RESOURCE_DOES_NOT_EXIST ou PERMISSION_DENIED, est le cas d'échec le plus courant. Effectuez d'abord ces vérifications préalables :
- Genie : vérifiez qu'un agent Genie existe et que vous pouvez l'ouvrir. Copiez son ID d'espace depuis l'onglet Settings de l'agent (l'interface l'appelle Agent ID) ; c'est le
<genie_space_id>du tableau des URL ci-dessous. - Unity Catalog Functions : vérifiez que la fonction existe et que vous disposez de
EXECUTE. Listez les fonctions avecSELECT * FROM system.information_schema.routines WHERE routine_type = 'FUNCTION'. - AI Search : vérifiez qu'il existe un endpoint avec au moins un index accessible.
- Portée du PAT : un PAT limité à l'espace de travail peut quand même provoquer
PERMISSION_DENIEDsi l'utilisateur n'a pas accès à la ressource concernée : Can View sur l'agent Genie, ouSELECTsur l'index AI Search (plusUSE CATALOGetUSE SCHEMA). Les agents Genie sont partagés individuellement.
Ajoutez les variables d'environnement supplémentaires (DATABRICKS_GENIE_MCP_URL, DATABRICKS_UC_FUNCTIONS_MCP_URL, DATABRICKS_AI_SEARCH_MCP_URL) et mettez à jour mcp.json avec la configuration complète :
Formats d'URL par serveur :
Serveur | Modèle d'URL |
|---|---|
databricks-genie | https://<workspace-hostname>/api/2.0/mcp/genie/<genie_space_id> |
databricks-sql | https://<workspace-hostname>/api/2.0/mcp/sql |
databricks-uc-functions | https://<workspace-hostname>/api/2.0/mcp/functions/<catalog>/<schema>/<function_name> |
databricks-ai-search | https://<workspace-hostname>/api/2.0/mcp/ai-search/<catalog>/<schema>/<index_name> |
Quittez puis relancez Kiro. Ouvrez la section MCP SERVERS du panneau Kiro ; les quatre entrées databricks-* apparaissent avec un voyant d'état vert. Cliquez sur reconnect pour tout ce qui est rouge et refaites les vérifications préalables. Essayez une première requête sans risque dans le panneau de chat : « List the catalogs I have access to. »
Approche B : installer le Databricks Power
Les quatre serveurs gérés couvrent le SQL, la recherche sémantique et l'analyse en langage naturel, ce qui suffit à de nombreux développeurs. Si votre workflow inclut des pipelines, des jobs, Model Serving, Lakebase, Declarative Automation Bundles, Agent Bricks, des tableaux de bord AI/BI, MLflow ou Databricks Apps, la configuration à quatre serveurs vous oblige à faire des copier-coller vers l'interface de l'espace de travail toute la journée.
Le Databricks Power règle ce problème. Une seule installation met en place les compétences d'agent officielles de Databricks, qui se chargent à la demande selon la tâche en cours.
Ce que vous obtenez
Domaine | Couverture |
|---|---|
SQL & Compute | Exécuter du SQL sur les entrepôts ; exécuter du Python ou du Scala sur les clusters ; gérer le cycle de vie du calcul |
Pipelines & Jobs | Spark Declarative Pipelines (tables de streaming, CDC, SCD Type 2, Auto Loader) ; DAG de jobs multitâches |
Unity Catalog | Tables, volumes, autorisations, tags, identifiants de stockage, tables système, metric views, External Iceberg Reads |
Tableaux de bord AI/BI | Visualisations, KPI, tableaux de bord analytiques |
Agents Genie | Exploration des données en langage naturel sur des jeux de données gouvernés |
Agent Bricks | Knowledge Assistants (RAG) et Multi-Agent Supervisors |
AI Search | Recherche sémantique et RAG avec des index gérés |
Model Serving | Modèles de ML, agents d'IA et Foundation Model APIs (FMAPI) facturées au jeton, routables via Unity Gateway |
MLflow | Expériences, évaluations, instrumentation des traces, requêtes de métriques |
Lakebase | PostgreSQL géré, provisionné ou à mise à l'échelle automatique, pour les charges de travail OLTP |
Databricks Apps | Applications web full-stack sur le Lakehouse |
Declarative Automation Bundles (anciennement Databricks Asset Bundles) | Infrastructure as code pour les ressources Databricks |
Installer le Power
Dans Kiro (IDE 1.0.288 ou ultérieur), ouvrez le panneau Powers, recherchez databricks et installez le Databricks Power. Sa compétence de configuration vous guide ensuite en quatre étapes :
- Vérifier que la Databricks CLI est en v1.20.0 ou ultérieure, la première version prenant en charge Kiro dans
databricks aitools, et l'installer ou la mettre à jour si nécessaire. - Connecter la CLI avec
databricks auth login, ou réutiliser un profil existant. - Installer les compétences avec
databricks aitools install --agents kiro --scope global, qui les place dans~/.kiro/skills/. Utilisez--scope projectpour les installer dans un seul espace de travail. - Ajouter huit compétences MLflow depuis mlflow/skills (traçage, évaluation, analyse des traces, métriques), que la CLI ne fournit pas.
En dehors de sa compétence de configuration, le Power n'embarque aucun contenu et ne fournit aucun serveur MCP. La CLI récupère les compétences depuis databricks/databricks-agent-skills, et vous les mettez à jour vous-même avec databricks aitools update.
Authentification
Les compétences exécutent des commandes Databricks CLI ; elles utilisent donc un profil Databricks CLI. Pour un usage interactif, connectez-vous avec OAuth user-to-machine : databricks auth login --host https://<your-workspace-url> --profile <profile-name> ouvre un navigateur, et le jeton se renouvelle automatiquement. L'OAuth par principal de service convient à l'automatisation, et les Personal Access Tokens restent une option ; consultez Databricks CLI authentication. La compétence de configuration liste vos profils existants sans afficher de secrets, et n'en réutilise jamais un sans vous le demander.
Vérifier l'installation
Kiro charge les compétences au début d'une session de chat ; ouvrez donc une nouvelle session et demandez : « Using the databricks-core skill, which workspace am I connected to? » Une réponse correcte confirme la CLI, votre profil et les compétences. databricks aitools list affiche la version installée de chaque compétence.
Mettre à niveau depuis le Power AI Dev Kit
Si vous avez installé l'ancien Databricks AI Dev Kit Power, mettez à jour le Power dans Kiro, puis suivez les étapes des compétences et de MLflow ci-dessus. Quelques éléments se trouvent en dehors du Power et doivent être nettoyés manuellement : une entrée databricks de premier niveau dans mcp.json qui exécute databricks-mcp-server/run_server.py, et tous les exports d'identifiants DATABRICKS_* que l'ancienne configuration a ajoutés à votre profil de shell. Vous pouvez aussi supprimer le clone ai-dev-kit (~/.ai-dev-kit, ou le répertoire indiqué dans AIDEVKIT_HOME), mais seulement si vous n'utilisez pas ai-dev-kit pour d'autres agents ou projets. Supprimez le répertoire plutôt que d'exécuter install.sh --uninstall d'ai-dev-kit, qui supprime des dossiers de compétences par nom dans ~/.kiro/skills/, y compris ceux installés par la Databricks CLI. La section « Migrating from the AI Dev Kit Power » de la compétence databricks-kiro-setup du Power couvre ces trois points.
Comment choisir entre les deux approches
Un arbre de décision simple :
- Vous exécutez seulement du SQL, posez des questions en langage naturel sur des jeux de données gouvernés via Genie et effectuez des recherches dans des index AI Search ? Utilisez l'approche A. Les quatre serveurs gérés font exactement cela, et la configuration prend 10 minutes.
- Vous créez des pipelines, gérez des jobs, déployez des Declarative Automation Bundles, travaillez avec Lakebase, développez des Databricks Apps ou appelez Agent Bricks ? Utilisez l'approche B. La boîte à outils complète est trop vaste pour être ajoutée sous forme de serveurs MCP distants isolés.
- Un mélange des deux ? Utilisez les deux. Les approches A et B ne sont pas en conflit : l'approche B ajoute des compétences, pas des serveurs MCP, si bien que les quatre serveurs de l'approche A (
databricks-genie,databricks-sql,databricks-uc-functions,databricks-ai-search) coexistent avec elle dans le panneau MCP de Kiro. La compétence de configuration du Power peut aussi vous guider pour ajouter à votremcp.jsonun MCP fourni par Databricks, comme Genie One, via Unity Gateway.
Pour les développeurs qui comptent travailler au quotidien dans Kiro sur des charges de travail Databricks, l'approche B est la meilleure solution à long terme. L'approche A est la bonne réponse si vous disposez de 10 minutes et d'un entrepôt SQL avec lequel vous voulez discuter.
Du point de vue des développeurs
Les deux approches n'ont pas le même impact selon la personne qui utilise l'IDE. Quatre profils, quatre difficultés, quatre réponses.
L'analytics engineer. Vous passez la moitié de votre journée à interroger des tables que vous n'avez jamais vues, et l'autre moitié à faire des copier-coller entre votre éditeur et l'interface de l'espace de travail. L'approche A règle cela en 10 minutes. Les serveurs Genie et SQL ancrent chaque requête dans de vraies métadonnées de schéma ; l'assistant écrit avec vos colonnes réelles, sans deviner ; et chaque résultat hérite de vos autorisations Unity Catalog. Vous arrêtez de jongler entre les onglets.
Le data engineer. Votre quotidien, ce sont les pipelines, les jobs, les Declarative Automation Bundles et les promotions entre environnements qui les accompagnent. Rédiger databricks.yml à la main et lancer databricks bundle deploy depuis un terminal latéral, c'est la méthode lente. L'approche B, c'est la méthode rapide. Les compétences du Power pour les pipelines, les jobs et les Declarative Automation Bundles produisent, valident et déploient l'IaC en une seule conversation. Spark Declarative Pipelines, CDC, SCD Type 2, Auto Loader : tout est généré à partir de vos tables Unity Catalog réelles et prêt à être commité.
Le développeur d'IA et d'agents. Vous reliez appels de modèles, évaluation, gouvernance et orchestration d'agents à travers trois ou quatre outils qui ne s'accordent pas tout à fait sur le schéma. L'approche B couvre toute l'offre d'IA de Databricks : Unity Gateway pour le routage et les solutions de repli, Agent Bricks pour les superviseurs multi-agents et les assistants de connaissances, MLflow pour l'évaluation et AI Search pour la recherche, le tout gouverné de bout en bout par Unity Catalog. Votre agent hérite des mêmes autorisations que son appelant, et vos traces d'évaluation arrivent dans le même espace de travail que vos exécutions d'entraînement.
Le développeur de plateforme. Vous gérez les ressources Databricks sous forme de code, faites des promotions entre dev/stage/prod et répondez chaque semaine à la question « avons-nous dérivé ? ». La compétence Declarative Automation Bundles de l'approche B (databricks-dabs), associée aux compétences de gestion d'Unity Catalog, génère le bundle complet, le valide et affiche le plan de déploiement (databricks bundle plan) avant tout changement. Vous ne maintenez plus un jeu de YAML à la main et un autre dans un document.
Un workflow à essayer dès aujourd'hui
Quelle que soit l'approche choisie, cet exercice ancre l'assistant dans de vraies métadonnées de l'espace de travail grâce au jeu de données samples.tpch du catalogue samples intégré.
Vous demandez : « What columns and types does samples.tpch.lineitem have, and what is the data distribution by l_shipdate year? »
Kiro renvoie le schéma réel et un histogramme à partir d'une seule requête. De vrais noms de colonnes et une vraie distribution, ancrés dans votre espace de travail.
Vous demandez : « Draft a dbt model that joins lineitem to orders and aggregates revenue by nation per quarter. »
Kiro produit du SQL avec les vrais noms de colonnes (l_extendedprice, l_discount, o_orderdate) au lieu de suppositions. Comme il a d'abord interrogé le schéma, il connaît les types exacts et le niveau de granularité.
Vous demandez : « Run my new aggregation against samples.tpch and compare the row count to last week's snapshot in poc.gold.revenue_by_nation_qtr. »
Kiro exécute les deux requêtes et met en évidence les différences. Si un chiffre semble anormal, « Show me the lineage for gold.revenue_by_nation_qtr » récupère les tables en amont depuis system.access.table_lineage. Une fois les données vérifiées, Kiro génère le JSON du job Databricks pour le modèle et liste les catalogues et schémas concernés.
Avec l'approche B, le même workflow s'étend à « Generate a Declarative Automation Bundle for this job and deploy it to staging », « Create an AI/BI dashboard backed by this aggregation » ou « Wire this into a Unity Gateway endpoint with a fallback model », le tout sans quitter l'IDE.
Bonnes pratiques, quelle que soit l'approche
- Authentification au moindre privilège. Générez un PAT distinct par poste de travail et par ensemble de périmètres. Dans l'approche B, préférez OAuth U2M aux PAT pour un usage interactif.
- Ne commitez jamais d'identifiants. Stockez
DATABRICKS_ACCESS_TOKENdans votre profil de shell ou dans un gestionnaire de secrets. Ne le placez jamais dans un fichiermcp.jsonversionné. - Une portée par projet. Conservez les ID des agents Genie et les chemins des index AI Search dans
$PWD/.kiro/settings/mcp.json, afin que chaque projet emporte ses propres liaisons de ressources. - Faites confiance aux autorisations Unity Catalog. Dans les deux approches, l'IA travaille avec vos autorisations effectives : autorisations sur les tables, filtres de lignes et masques de colonnes pour le SQL et les agents Genie, et partage par ressource pour les index AI Search. Il n'y a pas de couche de contrôle d'accès distincte à gérer.
- Redémarrez, ne rechargez pas. Kiro lit les variables d'environnement une seule fois, au démarrage du processus. Après avoir modifié votre profil de shell ou ajouté une authentification, quittez complètement Kiro (Cmd+Q sur macOS) puis rouvrez-le.
Dépannage
« Server not found » ou statut rouge sur une entrée MCP.
Approche A : vérifiez echo $DATABRICKS_SQL_MCP_URL dans le shell qui a lancé Kiro. Une valeur vide signifie que Kiro ne peut pas résoudre l'URL. Assurez-vous que le fichier mcp.json de la portée de l'espace de travail ne masque pas votre configuration de portée utilisateur. Vérifiez que le PAT est toujours valide dans Settings, Developer, Access tokens.
Connecté au MCP, mais les appels d'outils renvoient RESOURCE_DOES_NOT_EXIST ou PERMISSION_DENIED.
C'est l'échec le plus courant de l'approche A. La négociation initialize réussit avec une URL d'exemple, car le serveur reporte la validation de la ressource jusqu'à l'appel. Refaites les vérifications préalables pour le serveur concerné (l'agent Genie existe et est partagé avec vous, la fonction existe et vous disposez de EXECUTE, l'index AI Search existe et vous disposez de SELECT dessus).
Kiro n'utilise pas les compétences Databricks (approche B).
Ouvrez une nouvelle session de chat, car les compétences se chargent au début d'une session, et vérifiez que databricks-core/SKILL.md existe dans ~/.kiro/skills/. Error: unknown agent "kiro" signifie que la Databricks CLI est antérieure à la v1.20.0 ; mettez-la à jour et relancez l'installation. Si la commande CLI d'une compétence ne parvient pas à s'authentifier, exécutez databricks auth profiles et reconnectez-vous avec databricks auth login.
Essayez dès aujourd'hui. Le Databricks Power est le moyen le plus rapide d'accéder à toute la plateforme (pipelines, jobs, Lakebase, Agent Bricks et tout ce qui est décrit ci-dessus) dans Kiro. Installez-le depuis le catalogue Kiro Powers sur kirodotdev/powers, ou installez les mêmes compétences sans le Power en exécutant databricks aitools install --agents kiro avec la Databricks CLI v1.20.0 ou ultérieure. Pour les autres agents de codage, databricks aitools install détecte ceux présents sur votre machine (Claude Code, Cursor, Codex, GitHub Copilot, Gemini CLI et d'autres) ; exécutez databricks aitools --help pour obtenir la liste à jour, ou consultez databricks/databricks-agent-skills. Pour les quatre serveurs MCP gérés par Databricks, l'installation en un clic se trouve sur kiro.dev/docs/mcp/servers/.
Vous avez des commentaires ou rencontrez un problème ? Ouvrez une issue : pour la configuration ou le packaging du Power, kirodotdev/powers ; pour les compétences d'agent, databricks/databricks-agent-skills ; pour la Databricks CLI et databricks aitools, databricks/cli. Nous les lisons toutes.
Partenaires, Lakebase, Genie, Unity Gateway, Agent Bricks, Unity Catalog, MCP, Developer Tools, AI Search, MLOps & LLMOps et Business Intelligence
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.