Données de fabrication et IA : connecter la chaîne de valeur du produit
Donnez à chaque étape de la chaîne de valeur de fabrication un accès à des données fiables et à l'AI
- Les données de fabrication couvrent une chaîne de valeur de produits connectés, mais les systèmes qui les capturent restent séparés par fonction et par usine
- Databricks rassemble les données de systèmes disparates – ou les interroge sur place – afin que les équipes puissent répondre à des questions transversales tout au long de la chaîne de valeur
- Une sémantique gouvernée, des analyses en langage naturel et des applications agentiques aident plus de personnes à passer de la recherche de données à l'action sans devenir des ingénieurs de données
Un défaut de fabrication est rarement lié à un seul système. Un pic de rebuts peut être lié au réglage d'une machine, au lot d'un fournisseur, à un événement logistique ou à un problème récurrent enregistré dans un système qualité. Pourtant, les données nécessaires pour l'analyser sont généralement réparties entre les usines, les fonctions et les différents systèmes.
Il y a plus de 50 ans, la vision de la fabrication intégrée par ordinateur (CIM) du Dr Joseph Harrington reconnaissait déjà que la fabrication dépend d'un flux d'informations connecté entre les fonctions. Aujourd'hui, cette vision devient réalité à mesure que les données et l'IA connectent les étapes de la chaîne de valeur du produit.
Les questions de fabrication les plus complexes sont des questions transversales :
- Quel lot de fournisseur a atteint les produits concernés ?
- Ce défaut est-il déjà apparu ? L'action corrective a-t-elle fonctionné ?
- Quels clients ou dossiers d'assistance pourraient être concernés ?
Pour répondre à l'une de ces questions, il faut croiser des données provenant de systèmes qui n'ont jamais été conçus pour communiquer entre eux. Les fabricants n'ont pas besoin de rapports isolés supplémentaires. Ils ont besoin d'un flux d'informations connecté tout au long de la chaîne de valeur du produit, avec la gouvernance et le contexte métier nécessaires pour rendre ces informations exploitables. C'est le rôle que peut jouer une plateforme moderne de données et d'IA.
Qu'est-ce que la chaîne de valeur du produit dans l'industrie ?
La chaîne de valeur du produit est la séquence de fonctions de bout en bout qui transforme les matières premières et les idées en produits livrés aux clients et pris en charge sur le terrain. Elle relie la recherche et développement (R&D) et l'ingénierie, les achats, la production et la qualité, les ventes et le marketing, ainsi que le service après-vente et l'assistance sur le terrain. Chaque étape a ses propres objectifs, équipes et systèmes opérationnels :
- La recherche et développement (R&D) et l'ingénierie travaillent avec la gestion du cycle de vie des produits (PLM), la conception assistée par ordinateur (CAD), l'ingénierie assistée par ordinateur (CAE) et la simulation, les données de test, les exigences et les nomenclatures d'ingénierie (BOM).
- Les achats travaillent avec les modules d'achat des progiciels de gestion intégrés (ERP), le source-to-pay, les contrats, les risques fournisseurs et les portails fournisseurs.
- La production et la qualité travaillent avec les systèmes d'exécution de la fabrication (MES), les données de contrôle de supervision et d'acquisition de données (SCADA)/automates programmables industriels (PLC), les historiens de processus, les systèmes de gestion de la qualité (QMS)/systèmes de gestion des informations de laboratoire (LIMS) et les systèmes de maintenance.
- La logistique et la chaîne d'approvisionnement travaillent avec les progiciels de gestion intégrés (ERP), les systèmes de gestion d'entrepôt (WMS), les systèmes de gestion des transports (TMS), les systèmes de planification, l'échange de données informatisé (EDI) et la télématique.
- Les ventes et le marketing travaillent avec la gestion de la relation client (CRM), le Configure-Price-Quote (CPQ), la tarification, la gestion des concessionnaires, l'automatisation du marketing et l'e-commerce.
- Le service après-vente et l'assistance sur le terrain travaillent avec la gestion des services, la garantie, la planification des pièces de rechange, les données des produits connectés, les diagnostics et les tickets.
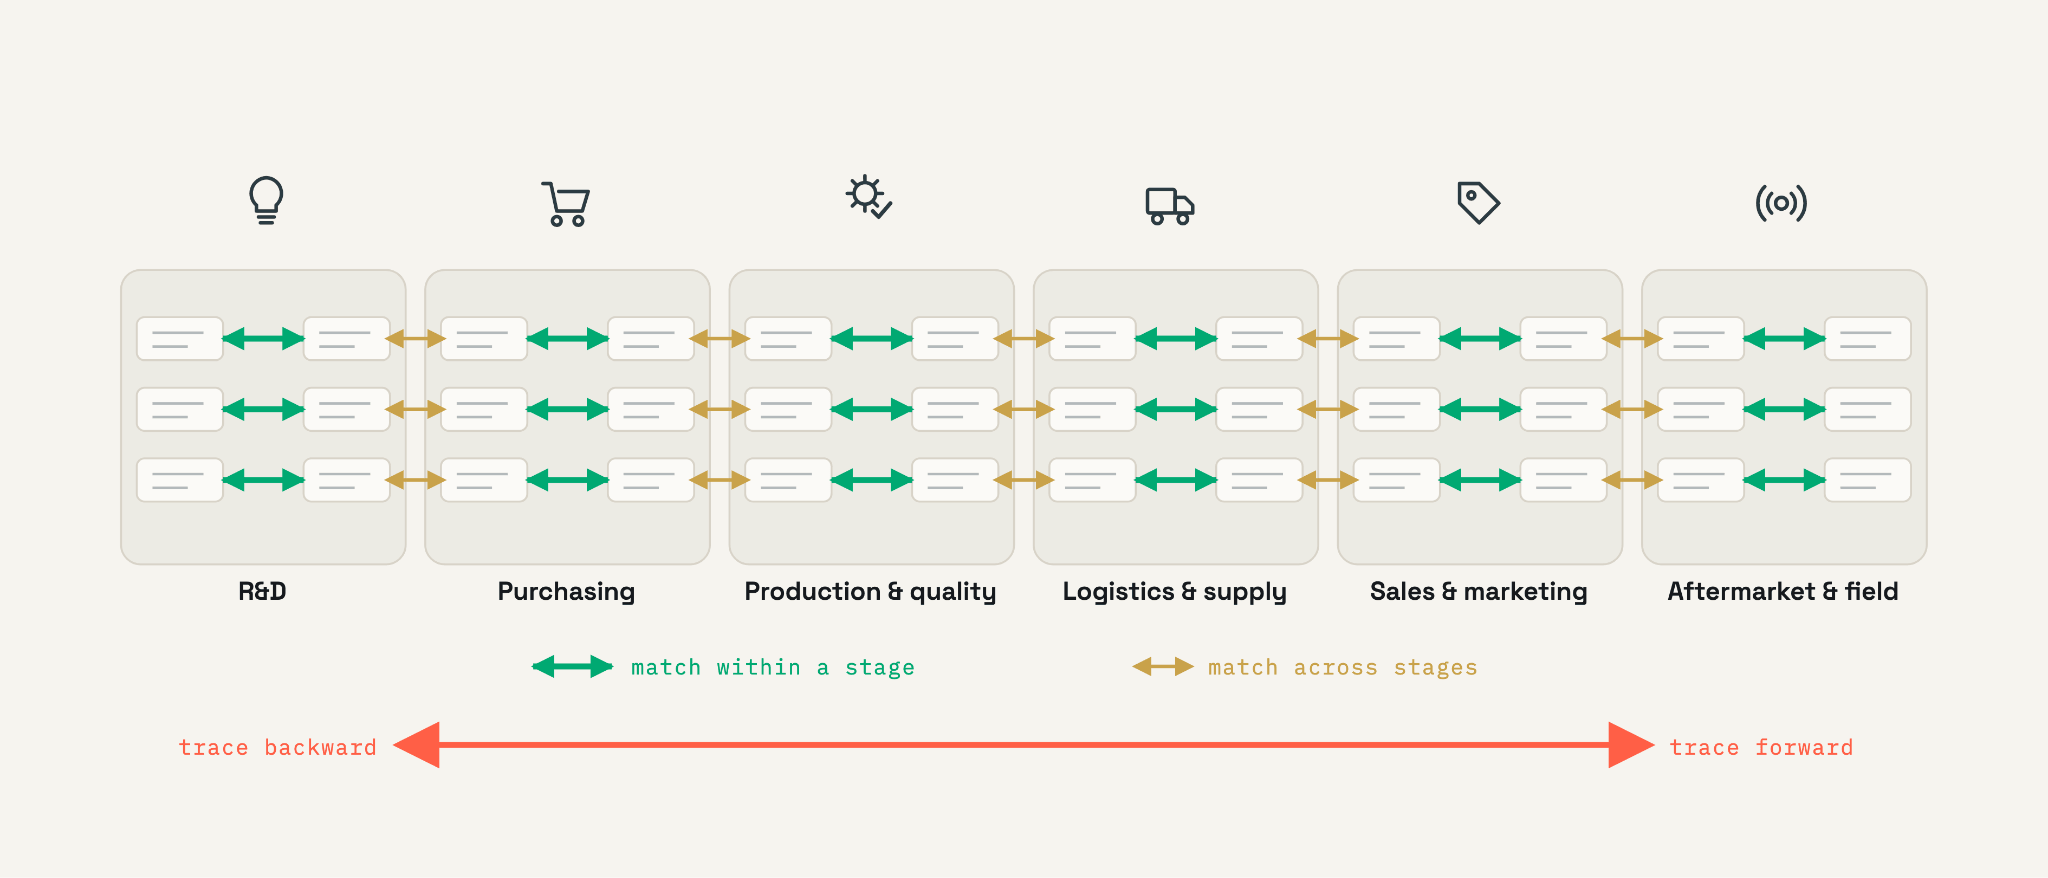
Chaque étape produit des données opérationnelles précieuses. La véritable opportunité réside dans la connexion d'une découverte dans une partie de la chaîne à une action dans une autre : un problème de qualité détecté en production analysé à l'aide des dossiers logistiques et fournisseurs, ou une alerte fournisseur tracée jusqu'à chaque produit ayant reçu le matériau concerné.
Pourquoi les frontières entre les systèmes sont le véritable problème
Lorsque chaque étape de la chaîne de valeur est isolée, une question transversale se transforme en un projet manuel de tickets, d'exports et de réconciliation. Lorsque les données sont accessibles au sein d'un système unique et gouverné, la même question devient une simple requête.
Exemple 1 : Un ingénieur qualité d'usine doit répondre à trois questions :
- Un pic de rebuts est-il causé par le lot, la machine ou le réglage, et est-ce toujours le cas actuellement ?
- Avons-nous déjà rencontré ce défaut, et la solution a-t-elle tenu ?
- Pourquoi une usine met-elle au rebut beaucoup plus de pièces identiques qu'une autre ?
Chaque question englobe plusieurs systèmes : les enregistrements du système d'exécution de la fabrication (MES), les données de l'historien de processus, les données du fournisseur et de la gestion de la qualité des fournisseurs (SQM), l'historique du système de gestion de la qualité (QMS), les rapports des huit disciplines (8D) et, souvent, plusieurs instances d'usine. Aujourd'hui, y répondre implique de créer des tickets, d'effectuer des exports manuels et de dépendre de quelques spécialistes.
Exemple 2 : Un analyste des achats doit répondre à trois questions :
- Quelles pièces critiques dépendent d'un fournisseur unique qui est désormais signalé comme présentant un risque de livraison ?
- Les performances de livraison et de qualité d'un fournisseur ont-elles diminué lors des dernières commandes ?
- Si un fournisseur fait défaut, quels produits, usines et commandes en cours sont exposés ?
Chaque question englobe plusieurs systèmes : les enregistrements d'achat ERP et source-to-pay, les contrats, les flux de risques fournisseurs et les portails fournisseurs. Aujourd'hui, y répondre peut se transformer en un mini-projet impliquant des tickets, des connaissances spécialisées et des exports manuels.
Le regroupement de ces sources de données opérationnelles élimine ces frictions. Rassemblez la chaîne de valeur une fois, gouvernez-la une fois, utilisez un identifiant partagé (un numéro de série, de lot ou de pièce) comme clé de jointure, et la traçabilité devient une simple requête. Six questions, un besoin sous-jacent : joindre des données entre des systèmes qui n'ont jamais été conçus pour être connectés, et faire confiance au résultat. Quatre fonctionnalités de la plateforme rendent cela possible.
Comment Databricks connecte les données de fabrication
Aucune migration perturbatrice requise
Une chaîne de valeur connectée ne nécessite pas de migration perturbatrice de chaque système source. Les données peuvent être copiées lorsque c'est le bon choix, ou elles peuvent rester en place tout en étant interrogées.
Grâce à Open Sharing sans copie et à la Lakehouse Federation, les entreprises peuvent accéder aux données dans leurs systèmes sources sans avoir à créer un autre pipeline d'extraction, de transformation et de chargement (ETL) ou une copie pour chaque cas d'usage. Lorsque la réplication est appropriée, les connecteurs et le stockage d'objets cloud offrent une voie évolutive pour importer les données dans le lakehouse.
La plateforme de données et d'IA Databricks associe cette flexibilité aux fonctionnalités dont les équipes de fabrication ont besoin : analyse historique des données de production, de qualité et d'approvisionnement ; traitement à faible latence pour la télémétrie des machines et des véhicules ; et applications capables de lire et d'écrire rapidement des enregistrements individuels.
Les quatre fonctionnalités sur lesquelles reposent ces exemples
Regrouper ou fédérer les données sources, sans migration perturbatrice : la question de l'ingénieur qualité englobe les enregistrements MES, d'historien de processus, de fournisseur et SQM, QMS et 8D à travers les instances d'usine ; celle de l'analyste des achats englobe les achats ERP, les contrats et les flux de risques fournisseurs. Grâce à Open Sharing sans copie et à la Lakehouse Federation, ces données peuvent être interrogées sur place, et répliquées via des connecteurs lorsque la copie est le meilleur choix. Dans tous les cas, aucune nouvelle copie ETL n'est requise par question.
Orchestration et raffinement : les deux exemples effectuent des jointures sur des tables Gold gouvernées, et non sur des extraits bruts. Lakeflow aide les équipes à créer, planifier et surveiller les pipelines qui transforment les entrées brutes en données fiables et prêtes pour l'analyse, généralement via des couches Bronze, Silver et Gold.
Gouvernance des données et de l'IA : Unity Catalog est le plan de contrôle unique pour les données répliquées et fédérées : un modèle d'autorisation unique, une traçabilité complète (lineage) et une découverte englobant les données, les modèles et les agents d'IA, de sorte que la même surface gouvernée répond aux deux exemples. Unity Gateway vous permet de contrôler l'accès à l'IA, les dépenses et l'observabilité à travers les agents, les outils, les modèles et les MCP.
Capacités agentiques : conçu sur cette base gouvernée, Genie One est un collègue IA qui se connecte à vos données, Agent Bricks aide à créer des agents d'IA basés sur les données de l'entreprise, et Genie App Builder permet à quiconque de créer des agents et des applications en langage naturel. L'ingénieur et l'analyste peuvent poser leurs questions en langage naturel et obtenir des réponses basées sur des définitions reconnues par l'entreprise, ce qui fait l'objet des deux sections suivantes.
Le principe de conception pratique est simple : regrouper les données là où elles apportent de la valeur, les fédérer là où la copie n'a pas de sens, et gouverner les deux via le même plan de contrôle. Le résultat est une méthode de travail à travers les types de données et les étapes de fabrication sans créer de nouveau silo pour chaque cas d'usage analytique ou d'IA.
Améliorer la culture des données : rendre les données utiles au-delà des spécialistes
Une plateforme n'a de valeur que si les personnes savent l'utiliser. Dans de nombreuses entreprises industrielles, un petit groupe d'experts comprend les systèmes spécifiques à l'usine, tandis que les utilisateurs métier attendent des rapports ou des exports.
La culture des données (data literacy) se développe lorsque les collaborateurs peuvent suivre une progression pratique : trouver des données pertinentes, comprendre des définitions fiables, les analyser, poser des questions en langage naturel, créer des agents ou des applications gouvernés, et partager ces ressources avec d'autres. Tout le monde n'a pas besoin de devenir data engineer pour participer. Cette progression suit six étapes, présentées ci-dessous.

La technologie n'est qu'une partie du changement. Les formations, les communautés de pratique et un réseau de champions aident chaque fonction à gagner en confiance et à partager des modèles réutilisables. Une surface de données commune et gouvernée offre à ces communautés une base concrète sur laquelle travailler : des définitions partagées, un vocabulaire commun et des réponses réutilisables d'une équipe à l'autre.
Comment fonctionne « Parler aux données » dans l'industrie (et pourquoi cela nécessite une sémantique gouvernée)
Le moyen le plus rapide de renforcer la culture des données est de permettre aux utilisateurs de parler à leurs données : aucun langage de requête à apprendre, aucun ticket à créer et aucun rapport à attendre. L'analyse en langage naturel peut réduire la barrière à l'accès aux données, mais une interface conversationnelle ne suffit pas. La réponse doit s'appuyer sur des définitions reconnues par l'entreprise.
Exemple : Les achats
Une question telle que « Quelles pièces critiques dépendent d'un fournisseur unique actuellement signalé pour un risque de livraison ? » peut nécessiter la connaissance des en-têtes de table spécifiques à SAP, des jointures et des règles métier. Un analyste achats ne devrait pas avoir à devenir un spécialiste des données pour mener cette enquête.
La démo Purchasing Genie Demo concrétise ce modèle. Ce projet exécutable suit trois étapes : préparer des données gouvernées, créer des agents experts, puis les assembler sous la direction d'un superviseur et les partager sous la forme d'une application gouvernée unique.

Ce modèle sépare le travail qui nécessite une expertise technique (la préparation et la gouvernance des données) de celui que les utilisateurs métier doivent pouvoir faire eux-mêmes : poser des questions, examiner les réponses et prendre des mesures.
Exemple : Rapports de KPI
Le même modèle s'applique aux rapports quotidiens. Lorsque les définitions des KPI résident dans une couche sémantique gouvernée, les outils de BI et l'IA fonctionnent à partir de la même logique métier. Les agents Genie répondent aux questions au sein d'une fonction en utilisant ces définitions fiables, et Agent Bricks les assemble en agents basés sur des personas qui fonctionnent de manière transversale. Résultat : une même question obtient toujours la même réponse, basée sur des définitions reconnues par l'entreprise plutôt que déduite de schémas complexes ou de rapports déconnectés.
Mercedes-Benz Korea applique ce modèle en pratique, découvrez-en plus ici.
Une voie pratique à suivre
Il y a plus de 50 ans, la vision de la production intégrée par ordinateur (CIM) du Dr Joseph Harrington décrivait l'industrie comme un système unique et cohérent, unifié par le flux d'informations. Cette vision est désormais réalisable à grande échelle.
La recette de mise en œuvre comporte trois étapes :
- Regrouper les données une seule fois et les gouverner une seule fois avec Unity Catalog comme plan de contrôle unique, couvrant à la fois les sources de données répliquées et fédérées.
- Faire d'un identifiant partagé la clé de jointure (un numéro de série, de lot ou de pièce), afin que les résultats d'une partie de la chaîne de valeur puissent déclencher des actions dans une autre, permettant ainsi une traçabilité de bout en bout sous forme de requête. L'identifiant approprié dépend du domaine : unités sérialisées et VIN dans certains cas, numéros de lot ou de batch dans l'industrie de transformation.
- Permettre aux utilisateurs de parler à leurs données en basant l'accès en langage naturel sur une sémantique métier gouvernée.
Lorsque les utilisateurs métier peuvent poser des questions en langage clair et obtenir des réponses fiables, la culture des données cesse d'être le privilège de quelques spécialistes pour devenir une compétence organisationnelle. Le résultat n'est pas un énième tableau de bord. Ce sont des milliers de personnes tout au long de la chaîne de valeur qui peuvent trouver, comprendre et exploiter des données fiables.
Foire aux questions (FAQ)
Quel est le principal avantage de la connexion des données industrielles tout au long de la chaîne de valeur ?
Le principal avantage de la connexion des données industrielles tout au long de la chaîne de valeur est la possibilité de répondre à des questions qui débutent à une étape et nécessitent une action à une autre. Un défaut de production peut être tracé à travers la logistique jusqu'au lot du fournisseur qui en est à l'origine, ou un lot de fournisseur suspect peut être tracé en amont vers chaque produit qu'il a intégré. Sans données connectées, chacune de ces investigations nécessite des jours de travail manuel. Avec un lakehouse connecté, la même question devient une simple requête.
Les fabricants doivent-ils migrer toutes leurs données sources vers Databricks ?
Les fabricants n'ont pas besoin de migrer toutes leurs données sources vers Databricks. Les données peuvent être copiées lorsque cela est utile, mais le partage ouvert sans copie (Open Sharing) et Lakehouse Federation permettent aux données de rester dans les systèmes sources et d'être interrogées sur place. Unity Catalog peut gouverner à la fois les données fédérées et répliquées.
Qu'est-ce que la traçabilité ?
La traçabilité relie les étapes du processus de fabrication, les produits, les matériaux et les enregistrements opérationnels afin que les équipes puissent remonter le fil à partir d'un produit affecté ou suivre le parcours d'un matériau suspect. Elle permet de résoudre les problèmes plus rapidement et de réaliser des analyses de rappel plus précises. Un exemple consiste à tracer les numéros de série ou de lot des produits fabriqués.
Qu'est-ce que le LTAP et pourquoi les fabricants en ont-ils besoin ?
LTAP signifie Lake Transactional/Analytical Processing. Il désigne l'exécution de charges de travail analytiques et transactionnelles sur une seule plateforme gouvernée. L'industrie a besoin à la fois d'analyses à grande échelle de données historiques et d'applications réactives qui lisent et écrivent des enregistrements opérationnels. Historiquement, ces éléments résidaient dans deux environnements distincts avec des données copiées de l'un à l'autre ; le LTAP exécute les deux sur une seule copie de données gouvernées.
Qu'est-ce qui favorise le développement de la culture des données au-delà des fonctionnalités de la plateforme ?
Les fonctionnalités seules ne suffisent pas. Les formations, les communautés de pratique et les champions au sein de chaque fonction aident les collaborateurs à gagner en confiance, à partager des modèles et à utiliser une surface de données commune et gouvernée. La plateforme fournit les fondations ; une communauté active la transforme en une compétence globale.
Comment rendre l'approche « Parler aux données » fiable ?
L'accès en langage naturel doit s'appuyer sur une sémantique métier gouvernée : mesures, dimensions, jointures et définitions documentées. Genie peut alors répondre aux questions en utilisant le même contexte de confiance plutôt que de déduire le sens à partir de schémas complexes ou de rapports déconnectés.
Qu'est-ce que Lakehouse Federation ?
Lakehouse Federation est une fonctionnalité de Databricks qui permet aux données de rester dans leur système source tout en étant interrogées via Databricks. Elle évite de créer des pipelines ETL supplémentaires ou des copies de données. Les données sources sont gouvernées via Unity Catalog aux côtés de toutes les données répliquées, offrant ainsi une couche de gouvernance unifiée, quel que soit l'endroit où résident physiquement les données.
Qu'est-ce que Unity Catalog dans le contexte des données industrielles ?
Unity Catalog est la couche de gouvernance unifiée de Databricks pour les données, les modèles et les agents d'IA. Il fournit un modèle d'autorisation unique, une traçabilité complète des données (lineage) et une découverte sur l'ensemble du paysage des données. Pour l'industrie, cela signifie un plan de contrôle unique qui gouverne les données de production, les enregistrements de qualité, les données des fournisseurs et les agents d'IA, que ces données résident dans le lakehouse ou soient fédérées à partir de systèmes sources.
La plateforme gère-t-elle la télémétrie à haut volume des machines et des véhicules ?
Oui. La plateforme combine le traitement par lots (batch) et en continu (streaming). La télémétrie à haut volume des machines et des véhicules peut être ingérée sous forme de flux continu à très faible latence et traitée de manière fiable, afin qu'aucun événement ne soit perdu en cours de route.
Comment les données sont-elles intégrées dans Databricks ?
L'ingestion est conçue pour être simple. Zerobus Ingest prend en charge le streaming basé sur le push directement dans des tables gouvernées, Lakeflow Connect fournit des connecteurs gérés et la capture des changements de données (CDC) pour les systèmes métier, tandis qu'Auto Loader et Structured Streaming gèrent les fichiers et les événements.
La plateforme est-elle ouverte et multi-cloud ?
Oui. Les tables Delta sont stockées sur un stockage objet cloud, le stockage et le calcul évoluant indépendamment. Databricks fonctionne sur AWS, Azure et Google Cloud, et les données sont stockées dans des formats ouverts tels que Delta Lake et Iceberg.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.