Traitement simultané de données provenant de plusieurs plateformes de streaming à l'aide de Spark Declarative Pipelines
Gérez et consommez facilement des données provenant de diverses plateformes de streaming sur plusieurs clouds via un seul pipeline ETL.
L'un des principaux impératifs des organisations aujourd'hui est de permettre la prise de décision à la vitesse des affaires. Les équipes commerciales et les systèmes de décision autonomes ont souvent besoin de toutes les informations nécessaires pour prendre des décisions et réagir rapidement dès que leurs événements sources se produisent, en temps réel ou quasi réel. Ces informations, appelées événements dans le jargon du traitement de flux, sont relayées de manière asynchrone d'une source à une destination et sont généralement traitées par l'intermédiaire d'un courtier de messages ou d'un bus de messages.
À mesure que les organisations se développent et que les équipes se diversifient, les schémas d'utilisation, le nombre et la variété des courtiers de messages augmentent. Dans les scénarios de fusion et d'acquisition, les entreprises héritent souvent de nouveaux courtiers de messages, qui doivent ensuite être intégrés à leurs processus d'ingénierie des données existants. La gestion cohérente d'une multitude de courtiers de messages, de leurs producteurs, de leurs consommateurs et de leurs pipelines d'ingénierie des données peut s'avérer complexe en raison du nombre de technologies, de plateformes cloud et de langages de programmation qu'ils nécessitent.
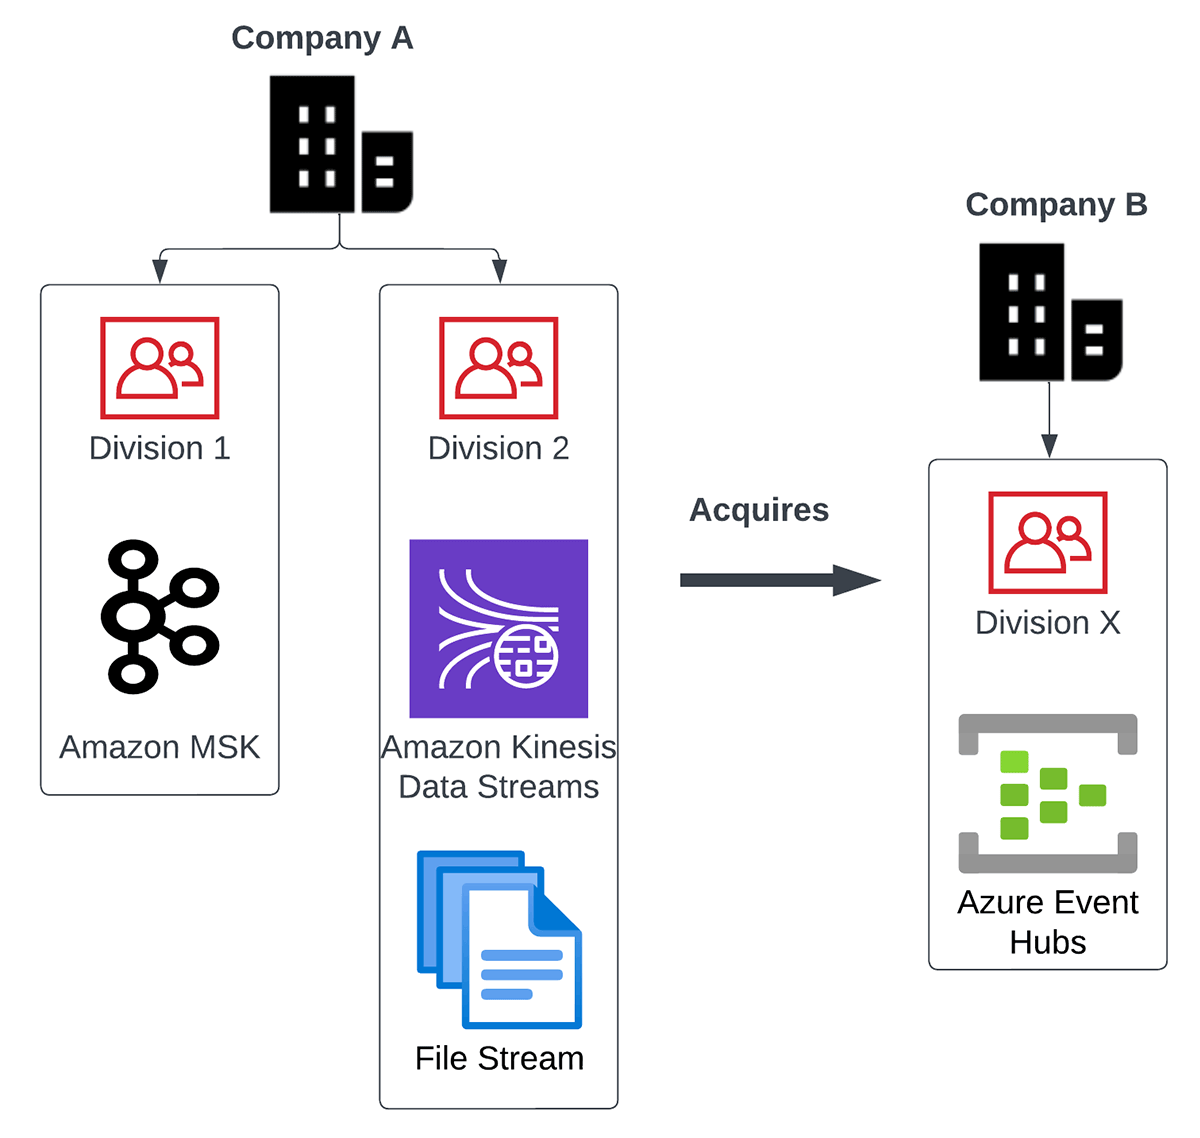
Par exemple, examinons un cas d'utilisation multi-flux. Imaginons la situation suivante dans un conglomérat mondial, où
- Ils possèdent deux divisions principales qui utilisent deux courtiers de messages distincts : Amazon Kinesis Data Streams et Amazon Managed Service for Kafka (MSK).
- Ils ont acquis une autre entreprise de produits plus petite qui utilise Azure Event Hubs en interne.
- Ils disposent également d'une source majeure de données provenant d'un flux continu de fichiers CSV ou JSON.
Le diagramme ci-dessous illustre le cas d'utilisation multi-flux décrit ci-dessus :
Voici quelques-uns des principaux défis liés au traitement de toutes ces données dans un tel scénario :
- Comment intègrent-ils toutes ces sources de données variées et leurs technologies ?
- Comment construisent-ils des systèmes d'ingénierie des données de manière à ce qu'ils soient faciles à mettre à l'échelle et à maintenir ? Font-ils appel à des talents spécialisés pour chaque technologie ?
- Comment s'assurent-ils qu'en résolvant cette énigme technologique, ils ne perdent pas de vue l'objectif final : donner du sens aux données et accélérer la prise de décision ?
- Comment s'assurent-ils que les besoins en matière de traitement par lots et en continu peuvent être satisfaits par le même système de traitement des données ?
Dans ce blog, nous allons montrer comment résoudre ces problèmes de manière simple et propre grâce à Spark Declarative Pipelines (SDP). Spark Declarative Pipelines sur la Databricks Lakehouse Platform simplifie la création et la gestion de pipelines de données de haute qualité, qu'il s'agisse de traitement par lots ou en continu.
Cas d'utilisation multi-flux
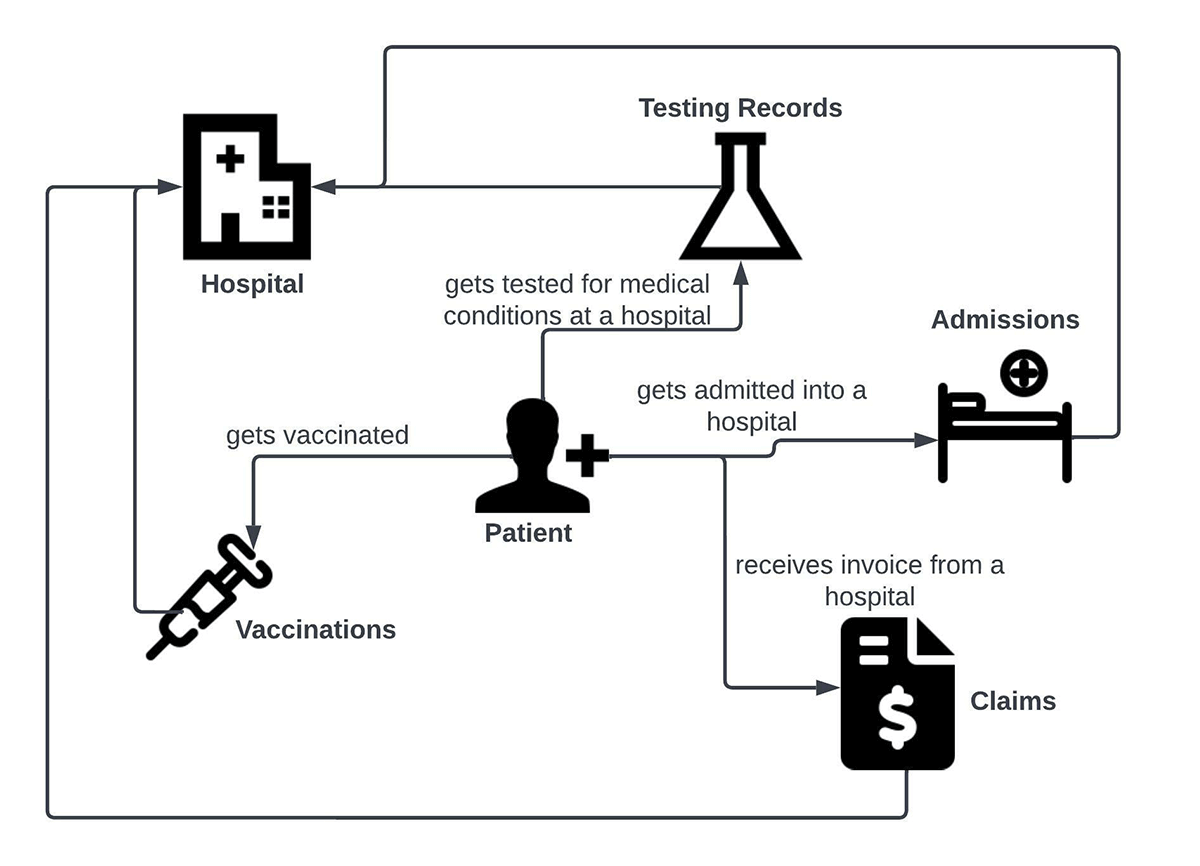
Pour illustrer un scénario de traitement multi-flux via SDP, imaginons un cas d'utilisation dans le domaine de la santé. Au centre de ce cas d'utilisation se trouve un patient. Le patient effectue les interactions suivantes avec une autre entité, l'hôpital :
- Se fait vacciner contre des problèmes de santé dans un hôpital
- Se fait tester pour des problèmes de santé dans un hôpital
- Est admis dans un hôpital pour certains problèmes de santé
- Reçoit une facture pour son traitement, dans le cadre d'un processus de remboursement
Ces interactions peuvent être représentées dans le diagramme de cas d'utilisation commerciale ci-dessous.
Les entités impliquées dans ces interactions peuvent être représentées sous la forme du diagramme entité-relation (ER) ci-dessous. Par la suite, nous utiliserons abondamment les termes Faits et Dimensions issus du lexique de la modélisation dimensionnelle des entrepôts de données. Dans le diagramme ER, vous pouvez voir que Patient et Hôpital sont des tables de dimension, tandis que les données relatives aux admissions, aux vaccinations, aux tests et aux réclamations sont représentées sous la forme de tables de faits.
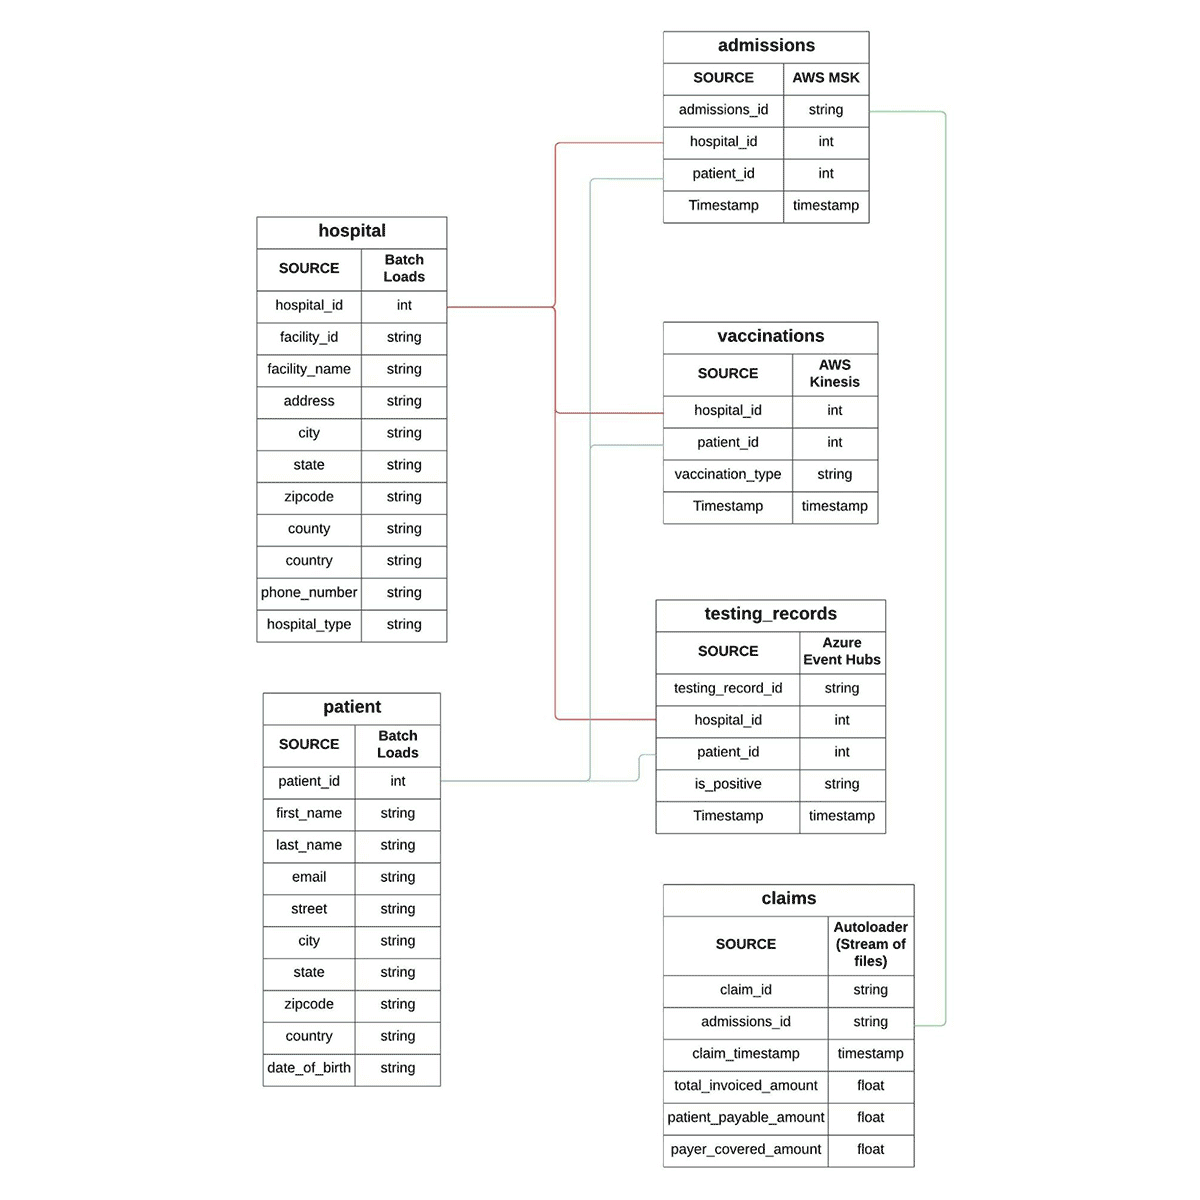
Supposons que les données de faits pour les admissions, les vaccinations, les tests et les réclamations proviennent de différents courtiers de messages. Pour ce blog, nous avons sélectionné les plus populaires du secteur, à savoir Apache Kafka (Amazon MSK), AWS Kinesis Data Streams et Azure Event Hubs. Notre quatrième méthode pour présenter un scénario de traitement de flux consiste à ingérer une séquence de fichiers de manière incrémentielle dans des tables (Delta Lake dans ce cas). Nous avons choisi Databricks Autoloader à cette fin. Grâce à ces informations, le diagramme des interactions du patient peut maintenant être mis à jour avec les sources de données pertinentes :
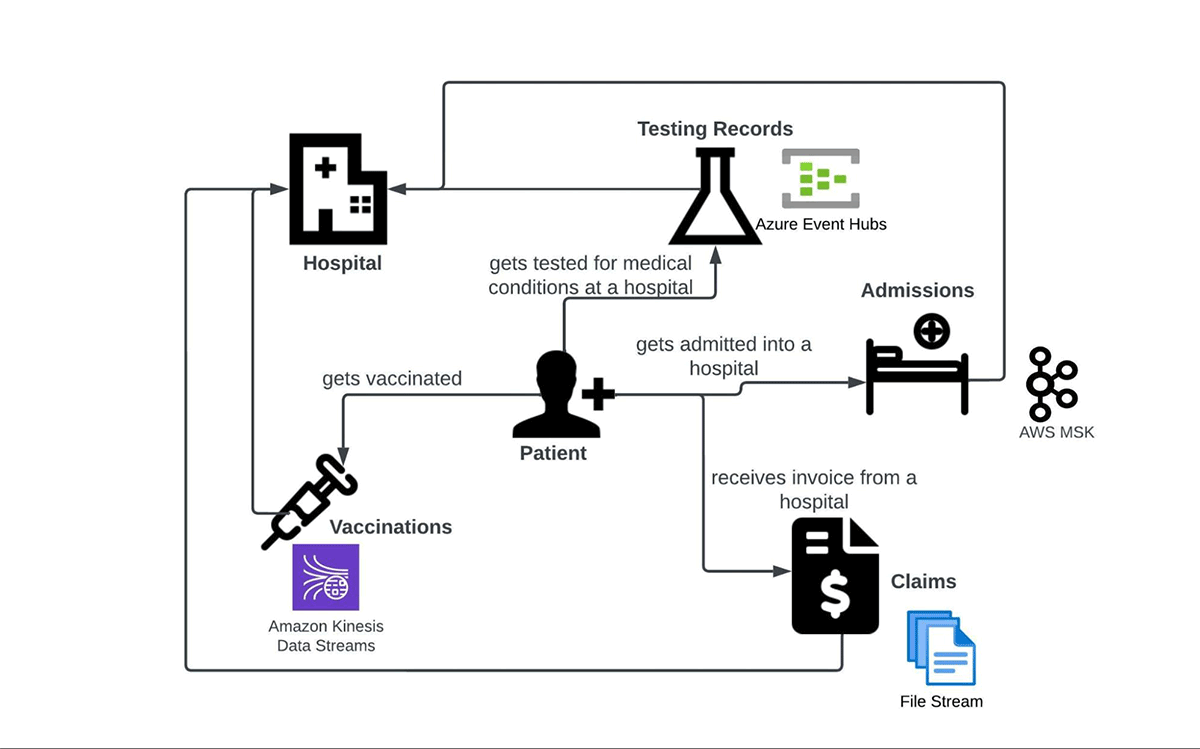
Vous trouverez ci-dessous un résumé des sources de données sous forme de tableau :
| Fait | Source de données |
| Admissions | Amazon MSK (Apache Kafka) |
| Dossiers de tests | Azure Event Hubs |
| Vaccinations | AWS Kinesis Data Streams |
| Réclamations | Flux incrémentiel de fichiers |
Dans la section suivante, nous allons montrer comment un seul pipeline SDP peut ingérer des données provenant des sources de streaming ci-dessus simultanément et effectuer des opérations ETL sur celles-ci. Nous avons utilisé l'infrastructure AWS pour configurer les ressources et le pipeline pour ce blog, mais les scénarios devraient être configurables de manière similaire sur d'autres clouds publics comme Azure et GCP.
Traitement multi-flux via SDP
Le diagramme ci-dessous illustre à quoi ressemble un pipeline SDP classique. Bien que l'ingestion et la transformation des données en continu provenant de sources diverses constituent l'essentiel de ce blog, d'autres fonctionnalités de SDP méritent également notre attention. Par exemple, la gestion de la qualité des données est une fonctionnalité clé qui peut aider les équipes à ne traiter que les données qui satisfont à certaines « attentes ». Les équipes peuvent ensuite prendre des mesures correctives et préventives sur les données erronées. Les autres avantages de SDP sont la gestion des points de contrôle et l'mise à l'échelle automatique améliorée. Vous pouvez en savoir plus sur ces fonctionnalités et bien d'autres dans cet article : Spark Declarative Pipelines concepts.
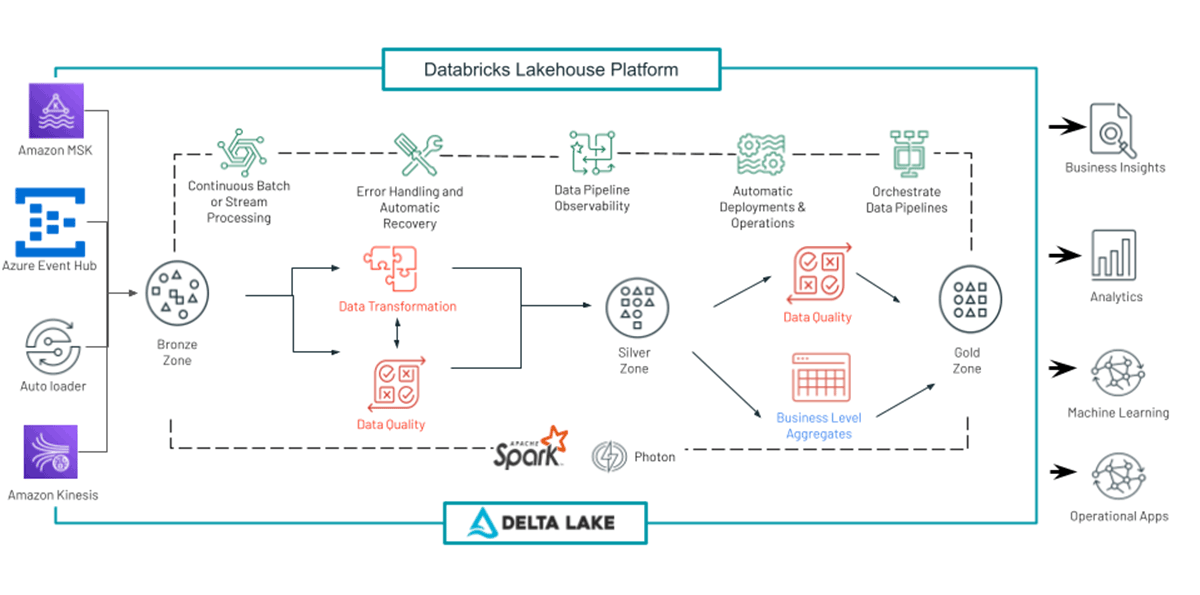
Notre pipeline SDP de traitement multi-flux (appelons-le sdp_multistream_consumer par souci de simplicité) comprend les opérations suivantes :
- Chargement des données de streaming des courtiers de messages dans une couche brute de tables Delta Lake.
- Analyse et application d'un schéma sur les données brutes pour générer des faits significatifs (tables de faits) à partir des charges utiles des messages.
- Génération d'ensembles de données agrégés pour une utilisation par les équipes de Business Intelligence et d'analyse. Pour ce faire, on joint diverses tables de faits et de dimensions, et on découpe les enregistrements générés.
Un pipeline SDP peut être configuré pour fonctionner dans les modes suivants :
- Continu : un cluster actif traite les données dès leur arrivée, de manière continue. C'est ce qui est recommandé pour les scénarios de streaming où la latence est primordiale.
- Déclenché : un cluster est lancé selon un calendrier souhaité et traite les données disponibles à ce moment-là. Une fois qu'il n'y a plus de données en attente de traitement (pendant un certain seuil de durée), le cluster est arrêté. Ce mode est recommandé lorsque les économies de coûts et le débit priment sur la latence.
Pour cet article de blog, nous utilisons le mode continuous pour deux raisons. La première est de démontrer un scénario de traitement de flux « réel » où les données sont capturées et traitées en temps réel. Deuxièmement, le connecteur Amazon Kinesis Data Streams pour Apache Spark, au moment de la publication de cet article, ne prend pas en charge le mode d'ingestion par lots (c'est-à-dire déclenchement unique ou disponible maintenant), ce qui est le cas avec le mode déclenché. Cela ne devrait toutefois plus tarder.
Un autre point à souligner est que, de manière générale, dans une configuration de production, une fois les données brutes ingérées, elles traversent de nombreuses étapes de traitement et d'enrichissement. Ces étapes nettoient, transforment et agrègent les données pour les cas d'utilisation métier impliquant l'analyse de données, ainsi que l'analyse historique et prédictive des données. Nous désignons cette amélioration progressive de la structure et de la qualité des données au fil de leur passage dans chaque couche de l'architecture sous le nom d'architecture Medallion Lakehouse. Bien que l'architecture Medallion soit une bonne pratique pour les cas d'utilisation courants, nous allons simplifier cet article en ignorant la partie transformation des données pour nous concentrer sur l'analyse des données afin de répondre aux cas d'utilisation métier.
Voyons maintenant comment effectuer l'ingestion de données en streaming (en une seule fois à partir d'une multitude de systèmes de streaming) à l'aide de SDP dans Delta Lake, puis analyser ces données pour générer des informations exploitables.
Ingestion de données à partir de flux
Dans cette section, nous vous montrons comment ingérer des données provenant de plusieurs plateformes de streaming.
Ingestion de données à partir d'Amazon MSK
Amazon Managed Streaming pour Apache Kafka (Amazon MSK) est un service entièrement géré qui vous permet de créer et d'exécuter des applications qui utilisent Apache Kafka pour traiter des données en streaming. Amazon MSK fournit les opérations de plan de contrôle, telles que celles permettant de créer, mettre à jour et supprimer des clusters.
Nous avons utilisé un cluster MSK avec les configurations suivantes pour les besoins de cet article de blog :
- Type de cluster - Provisionné
- Nombre total de brokers - 2
- Version d'Apache Kafka - 2.5.1
- Type de broker - kafka.m5.large
- Nombre de zones de disponibilité - 2
- Volume de stockage EBS par broker - 300 Gio
- Chiffrement entre les clients et les brokers :
- Chiffrement TLS - Activé
- Texte en clair - Activé
Pour l'authentification dans l'environnement AWS, nous avons associé un profil d'instance au cluster SDP. Il fait référence à un rôle IAM disposant des autorisations de lecture/écriture appropriées telles que configurées dans la définition du rôle.
Le pipeline sdp_multistream_consumer ingère le jeu de données d'admission à l'hôpital à partir de la rubrique MSK admission dans la table delta lake nommée msk_admissions_tbl_raw. La charge utile Kafka (binaire représentée sous forme de chaîne de caractères) pour un fait d'admission se présente comme suit :
Nous avons utilisé le code suivant dans un bloc-notes Python pour l'ingestion, et nous l'avons associé à notre pipeline SDP sdp_multistream_consumer.
Lorsqu'il est lancé, le pipeline sdp_multistream_consumer crée la table msk_admissions_tbl_raw dans la base de données/le schéma souhaité et remplit la table avec les données lues à partir de la rubrique admission. Il continue ensuite à ingérer des données supplémentaires au fur et à mesure qu'elles sont écrites dans cette rubrique.
Outre les quatre champs ingérés à partir de la rubrique Kafka, nous avons ajouté une colonne msk_event_timestamp (dérivée de l'événement timestamp généré par Kafka) à la table msk_admissions_tbl_raw. Les messages sont reçus dans le champ value de la charge utile Kafka au format binaire. Ils doivent être convertis en chaîne de caractères pour que les processus en aval puissent les analyser.
Ingestion à partir d'Amazon Kinesis
Amazon Kinesis Data Streams facilite la collecte, le traitement et l'analyse de données en streaming en temps réel. Il peut s'agir de données vidéo, audio, de journaux d'applications, de flux de clics de sites Web et de données de télémétrie IoT pour le machine learning, l'analytique et d'autres applications. Pour notre article, nous avons utilisé un flux de données Kinesis doté des configurations suivantes :
- Nom du flux de données : test_vaccination_data
- Mode de capacité : À la demande
- Capacité d'écriture : 200 Mio/seconde ou 200 000 enregistrements/seconde (Maximum par défaut)
- Capacité de lecture : 400 Mio/seconde (Par défaut)
Pour un meilleur débit, la fonction Amazon Kinesis enhanced fan-out (EFO) du connecteur Databricks Runtime Kinesis peut être utilisée dans les scénarios de production.
Dans notre cas d'utilisation, le flux test_vaccination_data transporte les faits (événements) de vaccination d'un patient. Vous trouverez ci-dessous un exemple de charge utile :
Le code SDP permettant de consommer les données du flux de données Kinesis vers la zone de destination (Landing zone) dans Lakehouse est le suivant :
Le pipeline sdp_multistream_consumer remplit la table cible kinesis_vaccination_tbl_raw avec les données disponibles dans le flux de données Kinesis et effectue un point de contrôle (checkpoint) pour éviter de relire les données. Les messages sont reçus dans le champ data de la charge utile Kinesis au format binaire. Ils doivent être convertis en chaîne de caractères pour que les processus en aval puissent les analyser.
Ingestion à partir d'Azure Event Hubs
Azure Event Hubs est une plateforme de streaming populaire proposée par Microsoft. Event Hubs prend en charge plusieurs protocoles de lecture et d'écriture, tels que AMQP, HTTPS et Apache Kafka. Pour cet article, notre pipeline SDP sdp_multistream_consumer utilise l'interface Kafka d'Event Hubs pour consommer les messages, car le connecteur Kafka pour Spark est fourni en standard dans Databricks Runtime, sans nécessiter de bibliothèques supplémentaires. Nous utilisons le niveau tarifaire standard pour notre espace de noms Event Hubs avec 2 unités de débit (Throughput Units).
La documentation Azure décrit les espaces de noms comme des conteneurs de gestion pour les hubs d'événements (ou rubriques, dans le jargon Kafka). Le hub d'événements (ou rubrique) qui nous intéresse est testing_records_stream, qui transporte les événements relatifs aux résultats de laboratoire d'un patient. Chaque message se présente comme suit :
Le code SDP pour consommer les messages du Event Hub testing_records_stream ressemble beaucoup au modèle d'ingestion avec Amazon MSK (après tout, ils utilisent tous les deux le protocole Kafka).
Le pipeline SDP lit de manière incrémentielle les messages d'enregistrement de test provenant de Event Hubs et les ajoute sous forme de nouvelles lignes dans la table Delta Lake eventhubs_testing_records_tbl_raw. Les messages sont reçus dans le champ valeur de la charge utile de l'interface Kafka au format binaire. Ils doivent être convertis en chaîne de caractères pour que les processus en aval puissent les analyser.
Ingestion de fichiers via Auto Loader
Auto Loader est l'un des outils d'ingestion de fichiers de données les plus puissants et robustes du secteur. Il traite de manière incrémentielle et efficace les nouveaux fichiers de données dès leur arrivée dans le stockage cloud, sans nécessiter de configuration supplémentaire. À ce jour, il peut ingérer les formats de fichiers JSON, CSV, PARQUET, AVRO, ORC, TEXT et BINARYFILE.
Auto Loader permet aux consommateurs de configurer une source Structured Streaming appelée cloudFiles. Les options de configuration incluent les chemins de fichiers du stockage cloud, les motifs de filtrage des fichiers, ainsi que les options d'événements d'arrivée de fichiers pour les files d'attente telles que Azure Queue Storage, AWS SQS, AWS SNS, etc. Le pipeline SDP utilise ces options pour ingérer automatiquement les nouveaux fichiers dès leur arrivée, avec la possibilité de traiter également tous les fichiers préexistants dans ce répertoire. Auto Loader prend en charge à la fois Python et SQL dans les pipelines SDP. Des clients ont utilisé Auto Loader pour traiter des milliards de fichiers afin de migrer des données ou de remplir une table. Il s'extensibilité pour prendre en charge l'ingestion en quasi temps réel de millions de fichiers par heure.
Dans ce blog, nous avons ingéré des données de réclamations de patients à l'aide d'Auto Loader avec l'exemple suivant :
Dans le pipeline sdp_multistream_consumer, les fichiers JSON des réclamations de patients sont ingérés via Auto Loader dès leur arrivée à l'emplacement source, comme illustré dans le code ci-dessous :
Analyse des données ingérées pour générer des insights métiers
Comme mentionné précédemment, pour ce blog, nous avons déjà ingéré les jeux de données de patients provenant de quatre sources différentes : Amazon MSK, Amazon Kinesis Data Streams, Azure Event Hubs et Databricks Auto Loader. Par souci de concision, nous avons limité la partie transformation des données au contrôle de schéma uniquement et nous passons à l'analyse de ces jeux de données pour répondre à des cas d'usage métiers.
Nous avons créé deux cas d'usage d'analyse métier pour ce blog. L'idée est de montrer comment les utilisateurs peuvent utiliser les tables Delta Lake créées par SDP pour effectuer de l'analyse de données afin de répondre à des questions métiers.
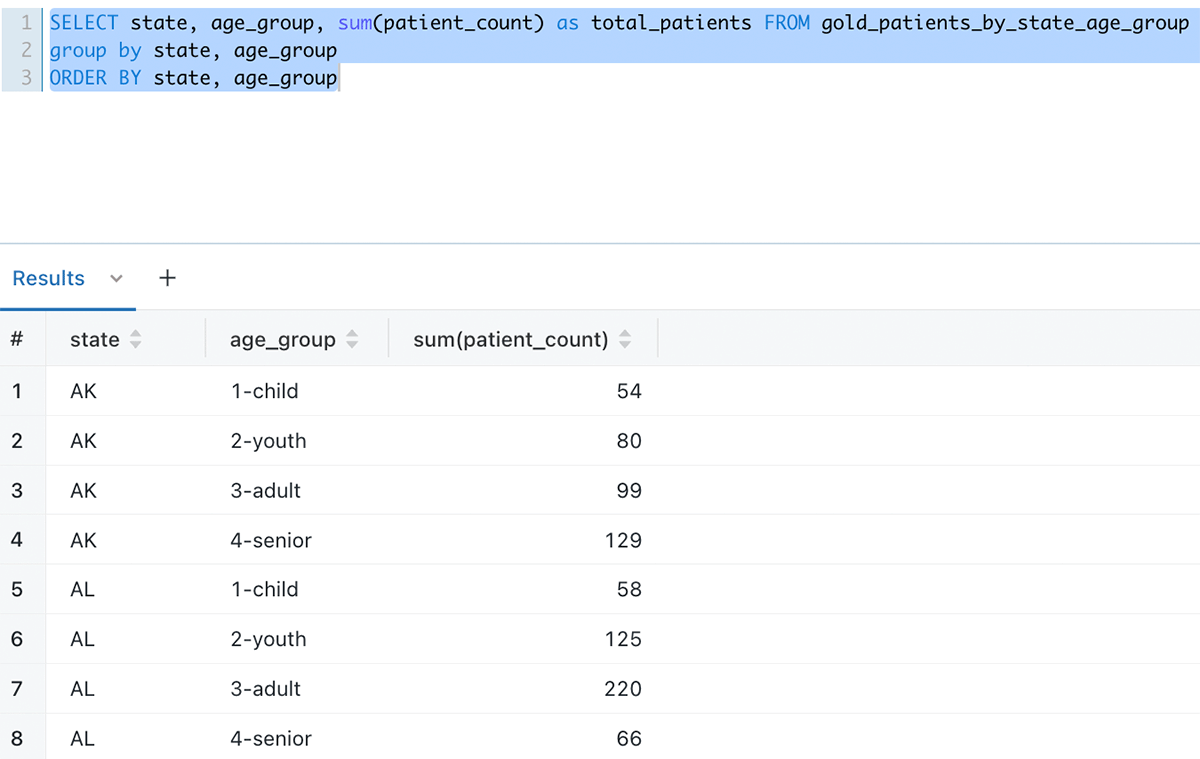
Nombre de patients par État et par tranche d'âge ayant contracté la COVID-19 après avoir été vaccinés
La table gold_patients_by_state_age_group est créée dans SDP en joignant les tables qui ont été alimentées via l'ingestion de données par SDP. Au fur et à mesure que de nouvelles données arrivent dans la couche d'ingestion, le pipeline SDP continu les intègre et met à jour cette table gold_patients_by_state_age_group pour l'analyse des données. --
Voici à quoi ressemblent les données lorsqu'elles sont interrogées via l'éditeur de requêtes Databricks SQL :
Nombre d'admissions par mois, par ville et par État
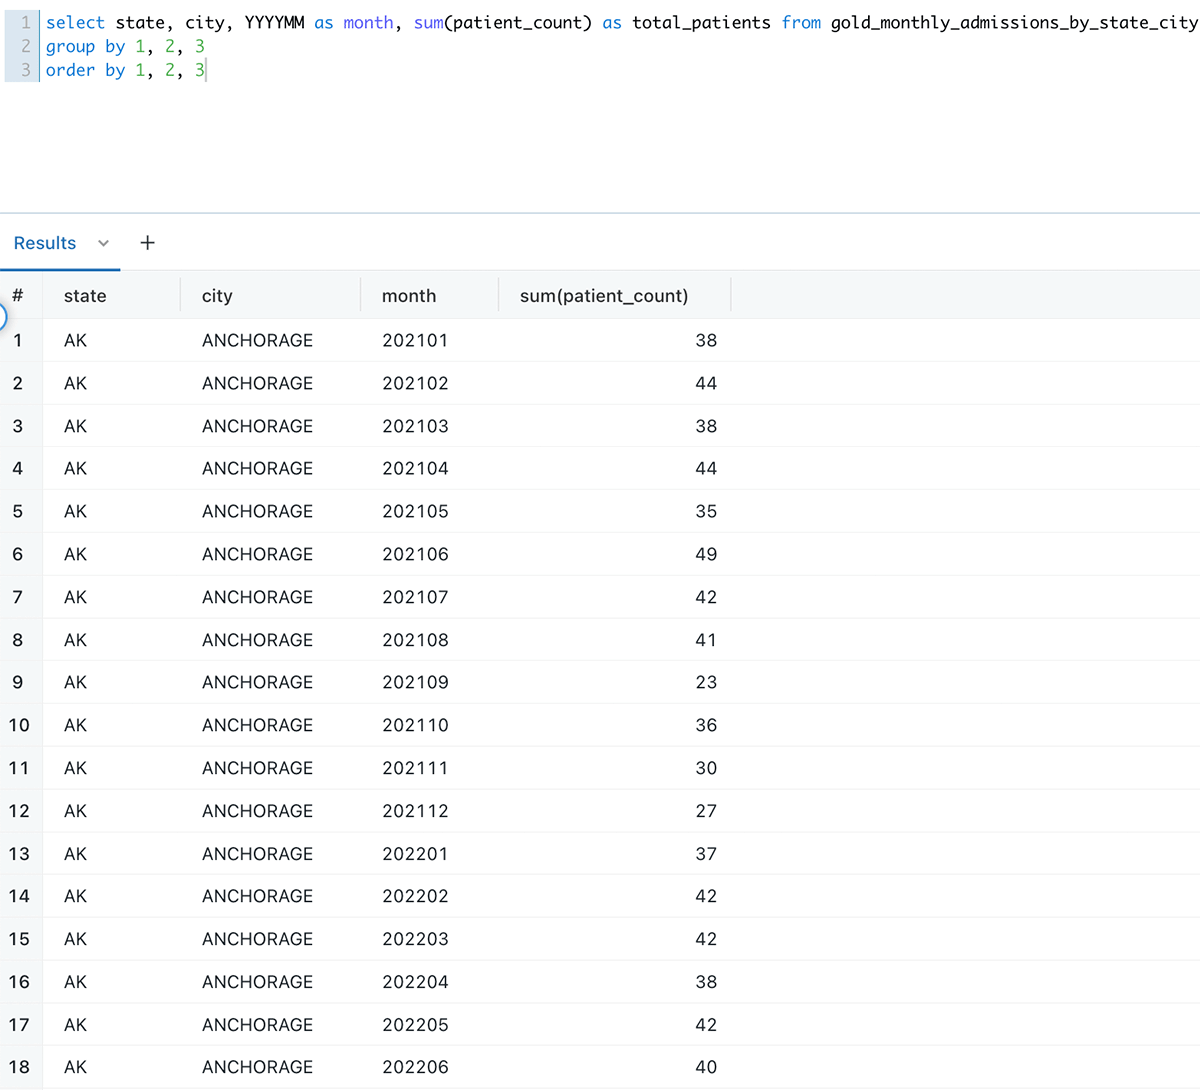
Le nombre d'admissions par ville, par État et par mois est un autre cas d'usage pris en charge en interrogeant la table gold_monthly_admissions_by_state_city.
Voici à quoi ressemblent les données une fois interrogées via l'éditeur de requêtes Databricks SQL :
Vue de bout en bout du pipeline SDP
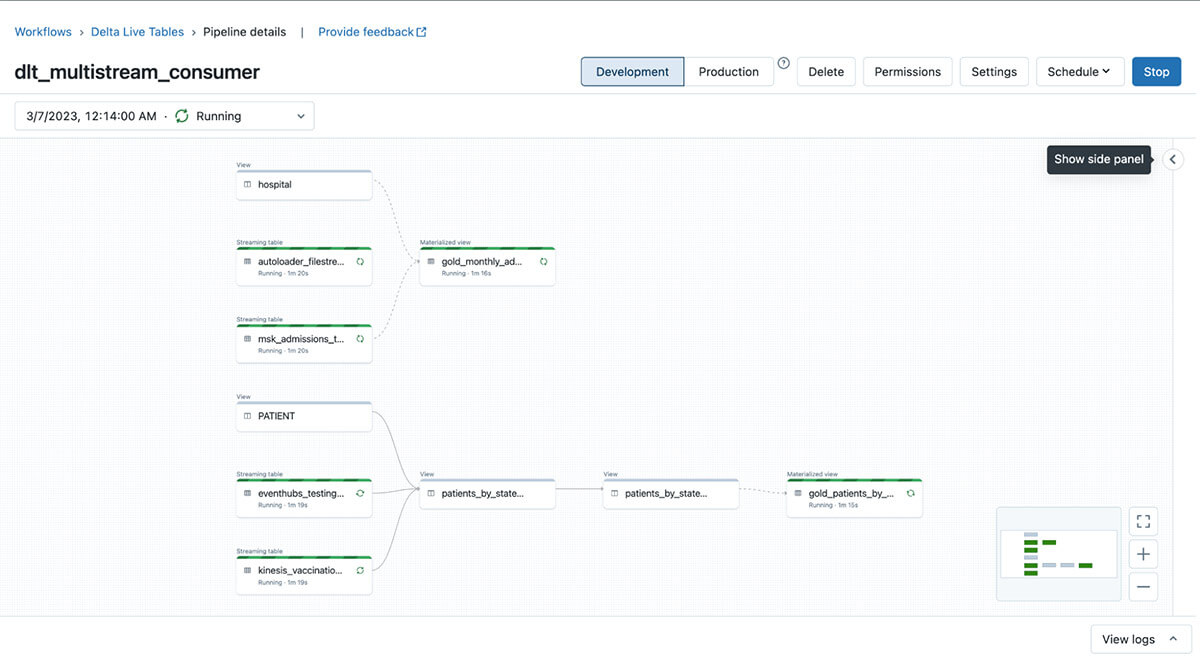
L'une des principales fonctionnalités de SDP est sa capacité à parcourir toutes les dépendances au niveau des tables parmi les artefacts de code inclus dans le pipeline, puis à les afficher sous la forme d'un graphique de lignage. Ce graphique est « dynamique ». Au fur et à mesure que les opérations ETL progressent, il affiche les opérations réussies en vert et celles en échec en rouge. Une capture d'écran de notre pipeline de données SDP en cours d'exécution est présentée ci-dessous :
Conclusion
Dans ce blog, nous avons montré comment ingérer et consommer des données provenant de diverses plateformes de streaming sur plusieurs clouds à l'aide de Databricks Spark Declarative Pipelines via un unique pipeline de données. Le processus ETL s'exécute en continu, dès l'arrivée des données. Les données générées par les transformations sont disponibles en continu pour effectuer des analyses de données et répondre à vos questions métier. Une telle solution simplifie grandement l'architecture technique globale et facilite sa maintenance et son évolutivité. Avec l'introduction régulière de nouvelles fonctionnalités dans SDP par Databricks, cette solution est largement adoptée par les clients pour les charges de travail ETL. Essayez Spark Declarative Pipelines dès aujourd'hui.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.