Intelligence du commerce de détail en temps réel : créer des recommandations e-commerce avec Lakebase et la recherche IA sur Databricks
Comment une plateforme leader de l'e-commerce de mode propose des recommandations de produits personnalisées à faible latence à des millions d'utilisateurs — entièrement propulsée par la Databricks Data Intelligence Platform.
par Sunny Singh
- Une architecture de référence complète pour concevoir un moteur de recommandation et de classement multi-étape sur Databricks — de l'ingestion du clickstream au service personnalisé en temps réel — remplaçant une infrastructure ML fragmentée par une plateforme unique et unifiée.
- Le système fournit des recommandations de produits personnalisées à faible latence en combinant des recommandations par lots (batch) précalculées avec un chemin de scoring en temps réel, utilisant Databricks AI Search pour la recherche de candidats, Lakebase pour le feature serving en ligne et Model Serving pour l'inférence à faible latence.
- En unifiant l'ingénierie des données, la gestion des features, l'entraînement des modèles et le service en temps réel sur une plateforme gouvernée unique, les équipes d'e-commerce éliminent le code de liaison, accélèrent les cycles d'itération et bénéficient d'un lignage de bout en bout, du clickstream brut aux prédictions en production.
L'opportunité : la personnalisation comme moteur de revenus
Chaque seconde qu'un acheteur passe sur une application d'e-commerce de mode génère un flux de signaux d'intention — recherches, consultations de produits, ajouts à la liste d'envies, interactions avec le panier. Les plateformes qui convertissent ces signaux en recommandations de produits pertinentes en temps réel sont celles qui l'emportent. Les indicateurs de référence du secteur montrent qu'une personnalisation efficace peut augmenter les taux de conversion de 10 à 30 % et accroître considérablement la valeur moyenne des commandes.
Pourtant, la création d'un système de recommandation prêt pour la production reste l'un des défis d'ingénierie ML les plus complexes. Elle nécessite une ingestion de données en temps réel, une ingénierie des caractéristiques complexe, plusieurs modèles ML fonctionnant de concert et une infrastructure de service qui répond en quelques millisecondes — tout en maintenant synchronisés les stocks, la localisation et les règles métier.
Ce blog présente une architecture de référence complète pour concevoir un tel système sur Databricks, basée sur une implémentation réelle pour une plateforme d'e-commerce de mode de premier plan en Asie, desservant plus d'un million d'utilisateurs actifs mensuels sur un catalogue de plus de 100 000 SKUs.
Présentation du système : l'architecture en un coup d'œil
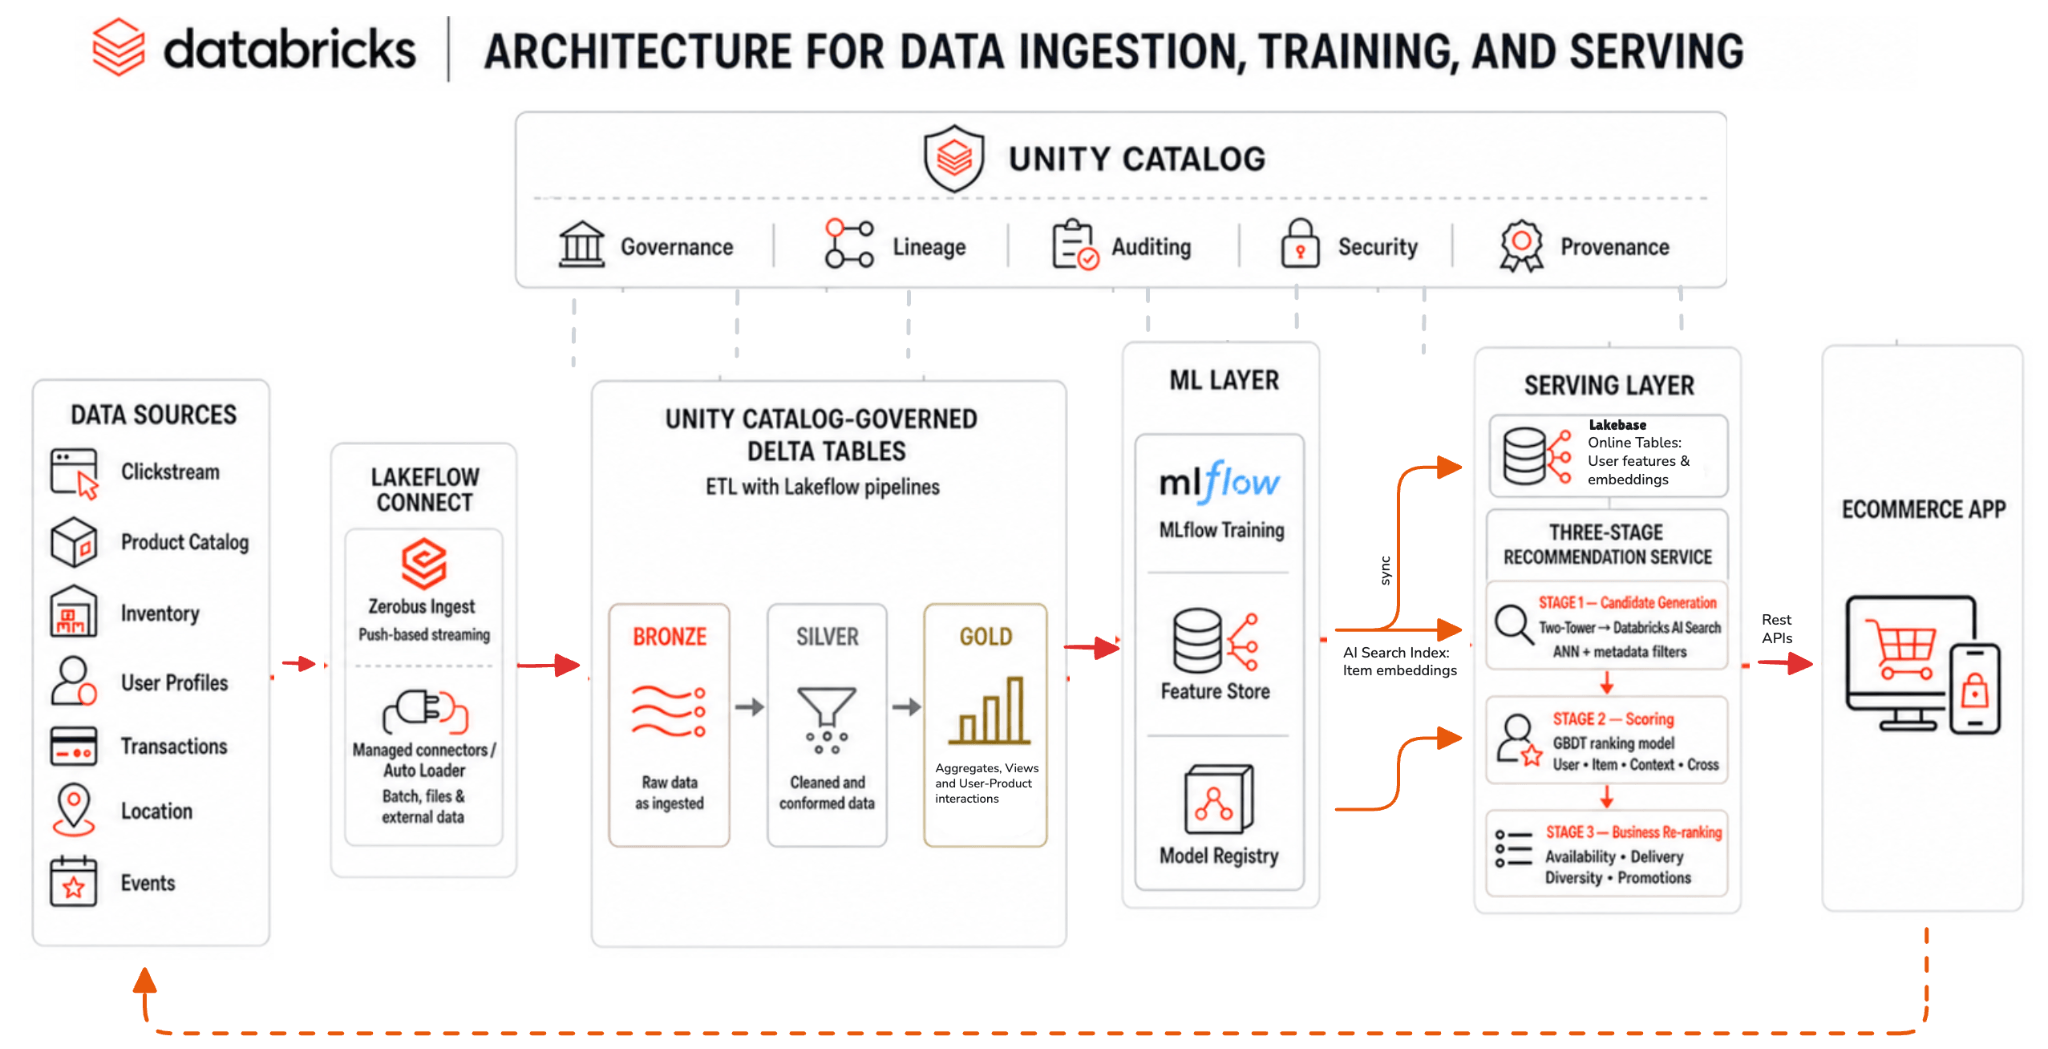
L'architecture suit une approche de plateforme unifiée où chaque composant — de l'ingestion au service — s'exécute sur Databricks, sous la gouvernance d'Unity Catalog.
Architecture globale du système :
Ingestion de données : du clickstream au lakehouse en quelques secondes
La plateforme ingère environ 1 000 événements par seconde — consultations de produits, recherches, ajouts au panier, achats et métadonnées de session. La solution Zerobus Ingest de Lakeflow Connect constitue le cœur de l'ingestion, acheminant les événements directement dans les tables Delta d'Unity Catalog sans nécessiter de courtier de messages autogéré.
Une distinction architecturale importante : les données de clickstream transitent par Zerobus vers le lakehouse pour le calcul hors ligne des caractéristiques et l'entraînement des modèles, mais lors de l'inférence en temps réel (chemin B), les signaux utilisateur en cours de session — ce que l'acheteur consulte en ce moment même — sont envoyés directement dans la charge utile de la requête API vers le point de terminaison Model Serving. Cela permet de contourner entièrement le stockage du lakehouse pendant la phase d'inférence, garantissant ainsi la disponibilité du contexte en temps réel sans subir de latence d'ingestion.
Zerobus accepte les données de n'importe quel client producteur Kafka standard (Java, Python, Go) via un simple changement de configuration — il suffit de faire pointer le serveur de bootstrap vers le point de terminaison Zerobus, et les enregistrements arrivent dans la table Delta cible. Pour les équipes qui exploitent déjà une infrastructure Kafka, Structured Streaming avec Declarative Pipelines offre une alternative avec la même architecture en aval.
Les données alimentent une architecture médaillon :
Couche Bronze — Flux d'événements bruts en ajout uniquement, plus données de référence :
- Signaux utilisateur :
- Comportementaux : séquences de navigation, requêtes de recherche, modèles de temps de rétention, historique des clics
- Transactionnels : fréquence d'achat, valeur moyenne des commandes, taux de retour, répartition des dépenses par catégorie
- Préférences : articles ajoutés à la liste d'envies, recherches enregistrées, affinités avec les marques, préférences de taille
- Démographiques : tranche d'âge, groupe de localisation, type d'appareil, niveau d'engagement sur l'application
- Signaux des articles :
- Catalogue : hiérarchie des catégories, marque, tranche de prix, matériau, couleur, saisonnalité
- Performance : taux de conversion, ratio consultations/panier, taux de retour, note moyenne
- Visuels : plongements d'images (embeddings) (capturant la similarité de style au-delà des attributs textuels)
- Nouveauté : jours depuis la mise en ligne, vitesse de tendance, trajectoire des stocks
- Signaux contextuels :
- Temporels : heure de la journée, jour de la semaine, proximité du jour de paie, périodes de fêtes/soldes
- Géographiques : ville de l'utilisateur, centre de distribution le plus proche, préférences de style régionales
- Environnementaux : météo (oriente les préférences de catégories), événements locaux
- Session : intention de navigation actuelle (déduite du comportement au cours de la session)
Silver layer — Nettoyée, découpée en sessions et enrichie :
- Comportement de l'utilisateur structuré en sessions (séquences de navigation, temps de rétention, modèles d'interaction)
- Caractéristiques des produits nettoyées (attributs normalisés, hiérarchies de catégories)
- Signaux d'engagement agrégés (nombre de vues sur 7 jours, scores de tendance, indices de popularité)
- Matrices d'interaction utilisateur-produit (signaux de rétroaction implicites)
Gold layer — Tables de caractéristiques prêtes pour les modèles et jeux de données d'entraînement :
- Vecteurs de caractéristiques utilisateur (embeddings comportementaux, profils de préférences, clusters démographiques)
- Vecteurs de caractéristiques d'articles (embeddings de produits, encodages d'attributs)
- Jeux de données d'entraînement (paires d'interactions étiquetées pour l'entraînement des modèles)
- Listes de recommandations précalculées (générées par lots, stockées pour une recherche rapide)
Les caractéristiques sont actualisées à des rythmes différents : les agrégats comportementaux sont mis à jour quotidiennement via des Databricks Workflows planifiés, tandis que l'ensemble du catalogue de produits est synchronisé de manière hebdomadaire. Les embeddings pour les utilisateurs et les articles sont recalculés chaque jour afin de capturer l'évolution des préférences et les nouveaux stocks. Le Databricks Feature Store gère à la fois les caractéristiques hors ligne (pour l'entraînement) et en ligne (pour le service), garantissant la cohérence entre l'entraînement et le service — les mêmes définitions de caractéristiques utilisées lors de l'entraînement du modèle sont automatiquement disponibles au moment de l'inférence via les tables en ligne Lakebase.
Unity Catalog gouverne chaque couche — assurant la traçabilité depuis l'événement clickstream brut jusqu'à la prédiction finale fournie à l'application, avec un contrôle d'accès précis garantissant la protection des PII tandis que les caractéristiques agrégées alimentent librement l'entraînement des modèles.
Service en temps réel : deux voies vers des réponses à faible latence
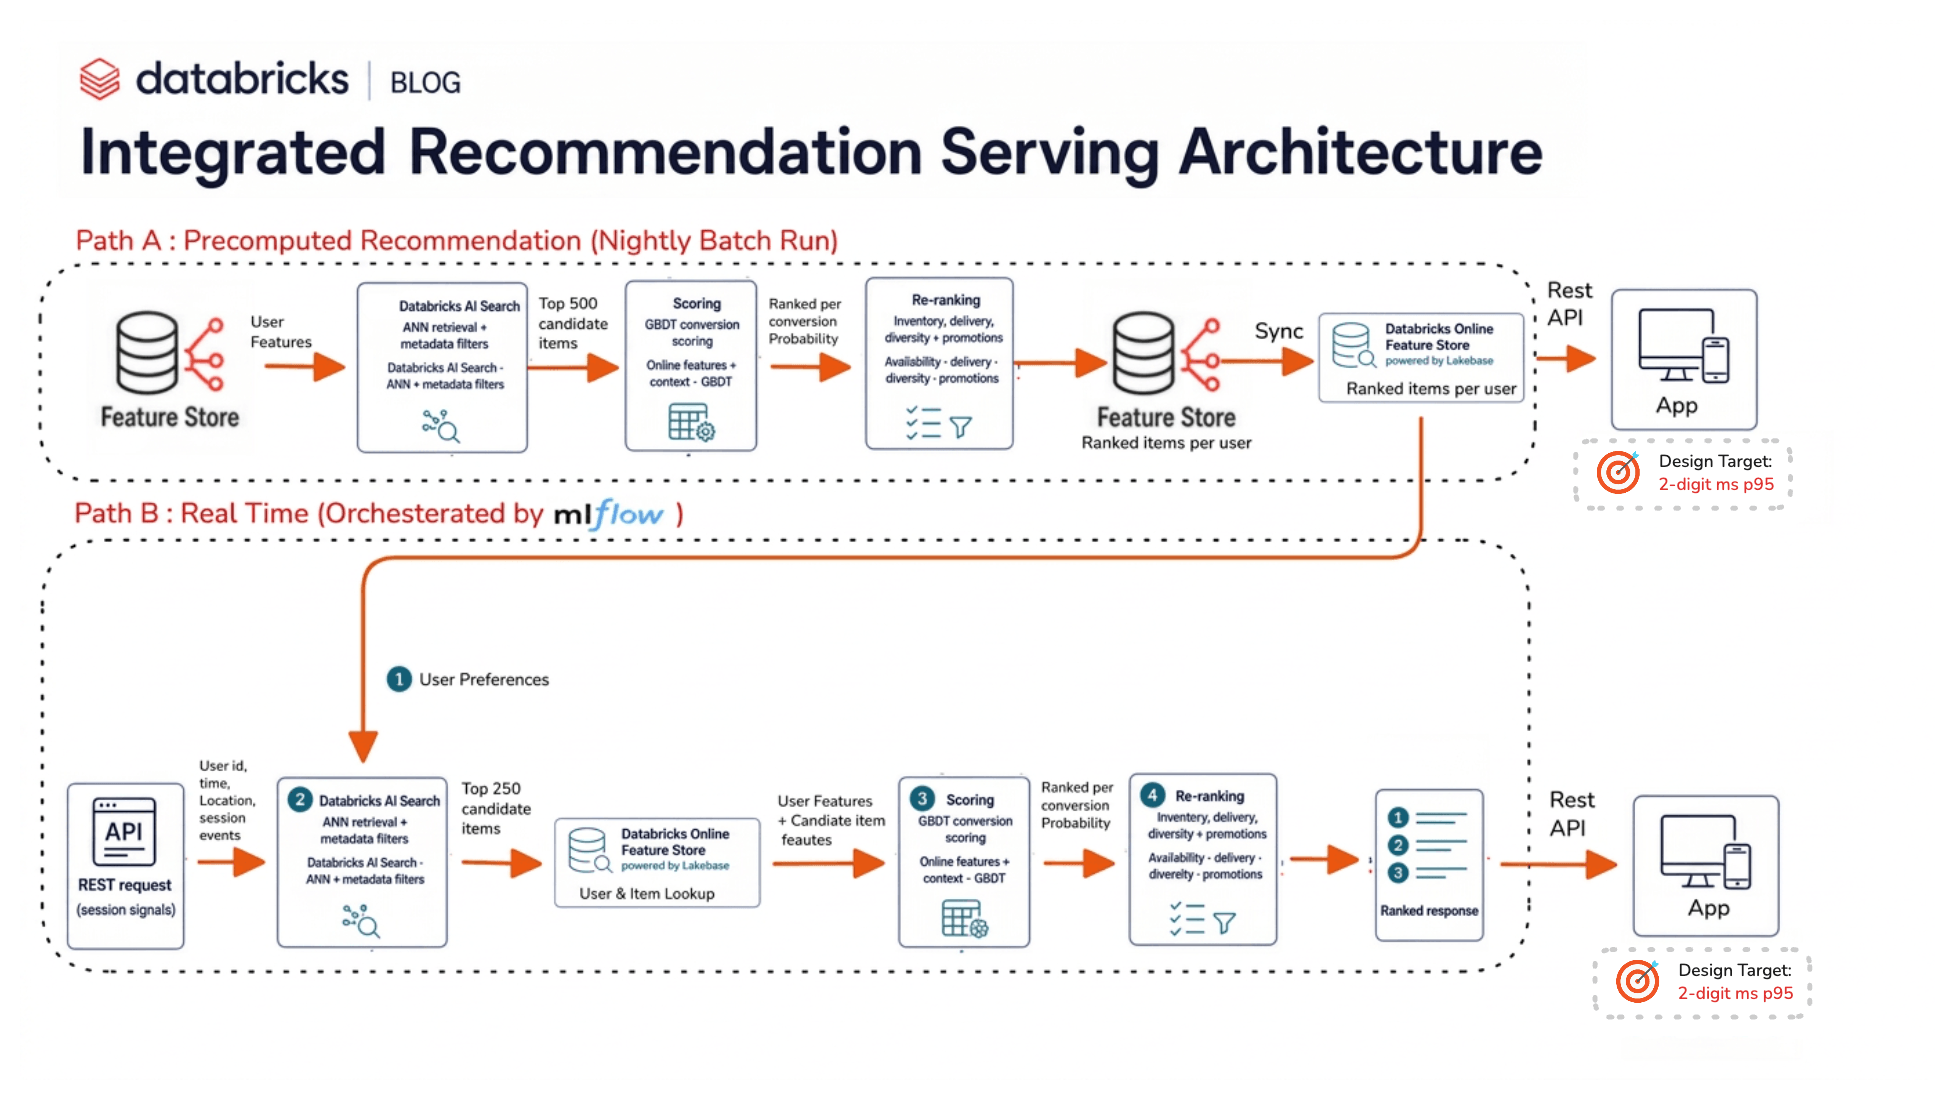
L'architecture de service propose deux voies complémentaires, chacune optimisée pour différents modèles d'interaction. La voie A gère les surfaces prévisibles à fort volume où le précalcul est à la fois réalisable et optimal. La voie B gère les surfaces dynamiques et sensibles à la session où l'intention immédiate de l'utilisateur doit façonner la réponse en temps réel.
Voie A — Recommandations par lots précalculées (< 100 ms)
La voie A alimente la majorité des surfaces de recommandation — carrousels de la page d'accueil, classements des pages de catégories, campagnes d'e-mailing et notifications push. Ces surfaces partagent un trait commun : l'identité de l'utilisateur et le type de surface sont connus à l'avance, de sorte que les résultats peuvent être calculés au préalable.
Un traitement par lots nocturne, orchestré par Databricks Workflows, exécute l'intégralité de l'entonnoir à 3 étapes hors ligne pour chaque utilisateur actif. Il récupère les derniers embeddings utilisateur, exécute des requêtes ANN par lots sur l'index d'articles AI Search pour générer des candidats, les évalue avec le modèle LightGBM à l'aide des caractéristiques de la couche Gold, et applique les règles métier (évaluation des stocks, proximité de livraison, diversité, mise en avant promotionnelle). Le résultat — une liste de produits classés Top-N par utilisateur (généralement 50 à 100 articles par surface) — est écrit dans les tables en ligne Lakebase, indexé par ID utilisateur et type de surface.
Au moment du service, l'application effectue une simple recherche clé-valeur : user_id + surface → liste de produits classés. Pas d'inférence de modèle, pas de recherche vectorielle, pas d'assemblage de caractéristiques — juste une lecture directe depuis Lakebase.
Comme le traitement par lots s'exécute chaque nuit, la voie A reflète les signaux et l'état des stocks de la veille. Pour la plupart des interfaces, cette fraîcheur est largement suffisante — les préférences à long terme et les affinités avec les marques évoluent sur plusieurs jours, pas en quelques minutes — et les nouveaux produits ayant reçu leurs premiers embeddings apparaîtront dans les recommandations sous 24 heures.
Voie B — Scoring en temps réel basé sur la session (< ms à 2 chiffres)
La voie B s'active lorsque le contexte de recommandation n'existe qu'au moment de la requête — « Articles similaires » sur une page de détails de produit, suggestions « Compléter le look » ou résultats de recherche reclassés dynamiquement qui s'adaptent à la navigation de l'utilisateur.
L'application d'e-commerce envoie les signaux de la session en cours — articles consultés au cours des dernières minutes, requêtes de recherche actives, contenu du panier et profils de temps de rétention — directement sous forme de charge utile de requête (payload) au point de terminaison de Model Serving via une REST API. Le point de terminaison exécute l'intégralité de l'entonnoir en 3 étapes de manière synchrone au cours d'un seul cycle de requête-réponse :
- Étape 1 — Récupération des candidats en temps réel Le point de terminaison transforme les signaux de session en un embedding de requête — soit l'embedding d'article du produit consulté, soit un embedding utilisateur mixte qui fusionne le profil de préférence à long terme (provenant de Lakebase) avec le comportement au cours de la session, en accordant plus de poids aux signaux récents. Cet embedding est envoyé à Databricks AI Search, qui effectue une récupération hybride : une recherche de similarité ANN combinée à des filtres de métadonnées stricts (éligibilité de la catégorie, inventaire régional, seuils de stock minimaux). Les articles en rupture de stock ou inéligibles n'entrent jamais dans l'ensemble des candidats. AI Search renvoie 200 à 500 candidats en un seul aller-retour réseau. Pour les interfaces basées sur la session, le point de terminaison calcule un embedding de requête mixte — combinant l'embedding de préférence à long terme précalculé de l'utilisateur (récupéré depuis Lakebase) avec un embedding de session dérivé des articles récemment consultés, pondéré en faveur des signaux récents pour capturer l'intention immédiate. Ce mélange est un calcul léger effectué au sein du point de terminaison, et non un appel de modèle distinct.
- Étape 2 — Assemblage des caractéristiques et scoring Les identifiants des articles candidats déclenchent des recherches ponctuelles dans les tables en ligne Lakebase, récupérant les caractéristiques utilisateur précalculées (agrégats comportementaux, segment démographique, sensibilité au prix) et les caractéristiques d'articles (taux de conversion, score de tendance, jours depuis la mise en ligne). Les caractéristiques de contexte en temps réel (heure de la journée, appareil, localisation, promotions actives) sont dérivées directement de la charge utile de la requête. Le point de terminaison construit des vecteurs de caractéristiques pour chaque paire utilisateur-candidat — y compris des caractéristiques croisées telles que l'affinité utilisateur-catégorie et le chevauchement des préférences de marque — et les transmet au modèle de scoring LightGBM, qui prédit la probabilité de conversion lors d'un seul appel d'inférence par lots sans ressources GPU.
- Étape 3 — Règles métier et reclassement La liste scorée passe par une couche de reclassement déterministe : le scoring basé sur l'état des stocks dépriorise les stocks en baisse, le scoring de proximité de livraison favorise les entrepôts les plus proches pour une exécution plus rapide, l'injection de diversité empêche la domination d'une marque ou d'une catégorie dans la liste finale, et le boosting promotionnel met en avant les articles alignés avec les campagnes actives. La liste reclassée est tronquée à la taille demandée (généralement 10 à 20 articles) et renvoyée en tant que réponse de l'API.
Les règles métier sont basées sur la configuration — les poids promotionnels, les seuils de diversité et les limites de stock sont lus à partir d'une table de configuration managée au moment du serving, ce qui permet aux équipes commerciales d'ajuster les règles sans redéployer le modèle.
Le point de terminaison est implémenté sous la forme d'un MLflow PyFunc model personnalisé qui orchestre le pipeline multi-étapes en interne — en interrogeant AI Search, en effectuant des recherches Lakebase, en exécutant l'inférence LightGBM et en appliquant les règles métier au sein d'un seul appel predict().
Une stratégie de repli assure la résilience : si la voie en temps réel dépasse son budget de latence, le système se dégrade de manière fluide pour proposer des articles populaires mis en cache ou les recommandations précalculées de l'utilisateur issues de la voie A.
Gérer le problème du démarrage à froid
Chaque système de recommandation doit faire face à deux scénarios de démarrage à froid :
Nouveaux utilisateurs (aucun historique de navigation) : lorsqu'un utilisateur arrive pour la première fois, le système construit un embedding utilisateur par défaut à partir des signaux démographiques disponibles — localisation, type d'appareil, contexte d'inscription et toutes préférences déclarées. Cet embedding est utilisé pour une recherche ANN dans l'index des articles, plaçant ainsi le nouvel utilisateur dans un cluster comportemental de données démographiques similaires. À mesure que l'utilisateur interagit, son embedding converge rapidement vers ses préférences réelles.
Nouveaux produits (aucune donnée d'interaction) : lorsqu'un nouveau SKU entre dans le catalogue, le système génère un embedding d'article à partir de ses attributs — titre, catégorie, marque, niveau de prix et caractéristiques visuelles extraites des images du produit. Cet embedding est utilisé pour trouver des articles existants similaires dans l'espace vectoriel, et le nouveau produit hérite des scores de recommandation initiaux de ses plus proches voisins. Les nouveaux produits apparaissent dans les recommandations lors du prochain cycle de traitement par lots quotidien.
Cycle de vie du modèle et amélioration continue
Les modèles sont réentraînés chaque semaine à l'aide de Databricks Workflows, le suivi des expériences et la gestion des versions étant gérés via MLflow. La plateforme prend en charge le déploiement champion/challenger — les nouvelles versions de modèles sont déployées aux côtés du modèle de production, le trafic étant progressivement transféré en fonction des indicateurs de performance en ligne.
Les principaux indicateurs ML surveillés comprennent :
- AUC-ROC — mesure la capacité du modèle de scoring à distinguer les articles avec lesquels un utilisateur va interagir ou non
- NDCG@K (Normalized Discounted Cumulative Gain) — évalue si les articles les plus pertinents apparaissent en haut de la liste classée
- Recall@K — mesure la fraction d'articles pertinents que l'étape de génération de candidats parvient à récupérer
- Log Loss — suit le calibrage des prédictions, garantissant que les scores de probabilité de conversion restent bien calibrés au fil du temps
Ces indicateurs de modèle sont complétés par des KPIs métier — taux de clic, taux de conversion et chiffre d'affaires par session — qui servent de validation ultime que les améliorations du modèle se traduisent par un impact concret.
La détection automatique de la dérive signale lorsque les distributions de caractéristiques ou de scores de prédiction s'écartent des valeurs de référence, déclenchant une investigation ou un réentraînement accéléré. Les journaux de serving sont corrélés aux pipelines d'entraînement via des identifiants au niveau de la requête, garantissant que la boucle de rétroaction produit des données d'entraînement propres et sans fuite pour la prochaine itération du modèle. Les techniques d'entraînement sensibles à la position garantissent que le modèle apprend les véritables préférences de l'utilisateur plutôt que des artefacts liés à la position d'affichage.
Résultats attendus
Cette architecture permet :
- des réponses personnalisées de l'ordre de quelques dizaines de millisecondes à grande échelle, répondant aux attentes de performance des acheteurs modernes adeptes du mobile
- Des recommandations actualisées quotidiennement qui reflètent l'état le plus récent des stocks, les produits tendance et l'évolution des préférences des utilisateurs
- Une gouvernance unifiée depuis le flux de clics brut jusqu'aux prédictions en production, avec une traçabilité complète et un contrôle d'accès via Unity Catalog
- Une expérimentation rapide — de nouvelles variantes de modèles peuvent être entraînées, évaluées et déployées en quelques jours plutôt qu'en plusieurs mois
- Une simplicité opérationnelle — une plateforme unique remplace le puzzle de systèmes distincts pour l'ingestion, l'ingénierie des caractéristiques, l'entraînement et le serving
- Une mise à l'échelle fluide — de milliers à des millions d'utilisateurs sans réarchitecture, en tirant parti du calcul serverless et de l'infrastructure managée
Conclusion
La création d'un moteur de recommandation et de classement de qualité production ne nécessite plus d'assembler une douzaine de systèmes spécialisés. En unifiant l'ingestion en temps réel (Zerobus), la gestion des caractéristiques (Feature Store + Lakebase), l'entraînement des modèles (MLflow + Workflows), la récupération vectorielle (AI Search) et le serving à faible latence (Model Serving) sur une seule plateforme gouvernée, les équipes d'e-commerce peuvent se concentrer sur l'essentiel : comprendre leurs clients et proposer le bon produit au bon moment.
Le résultat n'est pas seulement un moteur de recommandation — c'est une plateforme de personnalisation complète, prête pour la production, qui peut servir de colonne vertébrale intelligente à toute expérience d'e-commerce.
Prêt à créer le vôtre ? Explorez les accélérateurs de solutions de moteur de recommandation Databricks, plongez dans la documentation d'AI Search ou contactez votre équipe de compte Databricks pour un atelier d'architecture.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.