Utilisation de Structured Streaming avec Delta Sharing dans Unity Catalog
par Will Girten, Josh Seidel, Lin Zhou et Sachin Thakur
Nous avons le plaisir d'annoncer que la prise en charge de Structured Streaming avec Delta Sharing est désormais disponible pour tous (GA) sur Azure, AWS et GCP ! Cette nouvelle fonctionnalité permettra aux destinataires de données sur la plateforme Databricks Lakehouse de diffuser en continu les modifications apportées à une table Delta partagée via Unity Catalog.
Les fournisseurs de données peuvent exploiter cette capacité pour faire évoluer facilement leur offre de data-as-a-service, réduire les coûts opérationnels liés au partage de grands ensembles de données, améliorer la qualité des données grâce à une validation et des contrôles de qualité immédiats au fur et à mesure de l'arrivée de nouvelles données, et optimiser le service client grâce à la livraison de données en temps réel. De même, les destinataires de données peuvent diffuser en continu les dernières modifications d'un ensemble de données partagé, réduisant ainsi les coûts d'infrastructure liés au traitement de gros volumes de données en lot (batch) et posant les bases d'applications de données en temps réel de pointe. Les destinataires de données de nombreux secteurs d'activité peuvent bénéficier de cette nouvelle fonctionnalité, par exemple :
- Vente au détail : les analystes de données peuvent diffuser en continu les derniers chiffres de ventes d'une ligne de mode saisonnière et présenter des informations décisionnelles sous la forme d'un rapport BI.
- Sciences de la vie et de la santé : les professionnels de santé peuvent diffuser en continu les relevés d'un électrocardiogramme dans un modèle ML afin d'identifier des anomalies.
- Secteur industriel : les équipes de gestion de bâtiments peuvent diffuser en continu les relevés de thermostats intelligents et déterminer les moments de la journée ou de la nuit où les unités de chauffage et de climatisation doivent s'activer ou s'éteindre efficacement.
Souvent, les équipes de données s'appuient sur des pipelines de données exécutés en mode batch pour traiter leurs données, car l'exécution en lot est à la fois robuste et facile à mettre en œuvre. Cependant, aujourd'hui, les entreprises ont besoin des dernières données arrivées pour prendre des décisions stratégiques en temps réel. Structured Streaming ne simplifie pas seulement le traitement en temps réel, il simplifie également le traitement par lots en réduisant le nombre de jobs batch à seulement quelques jobs de streaming. La conversion des pipelines de données batch vers le streaming est très simple, car Structured Streaming prend en charge la même API DataFrame.
Dans cet article de blog, nous verrons comment les entreprises peuvent exploiter Structured Streaming avec Delta Sharing pour maximiser la valeur commerciale de leurs données en quasi-temps réel à l'aide d'un exemple dans le secteur financier. Nous examinerons également comment d'autres fonctionnalités complémentaires, telles que Databricks Workflows, peuvent être utilisées conjointement avec Delta Sharing et Unity Catalog pour créer une application de données en temps réel.
Prise en charge de Structured Streaming
La fonctionnalité Delta Sharing la plus attendue ces derniers mois était sans doute la prise en charge de l'utilisation d'une table Delta partagée comme source dans Structured Streaming. Cette nouvelle fonctionnalité permettra aux destinataires de données de créer des applications en temps réel à l'aide de tables Delta partagées via Unity Catalog sur la plateforme Databricks Lakehouse.
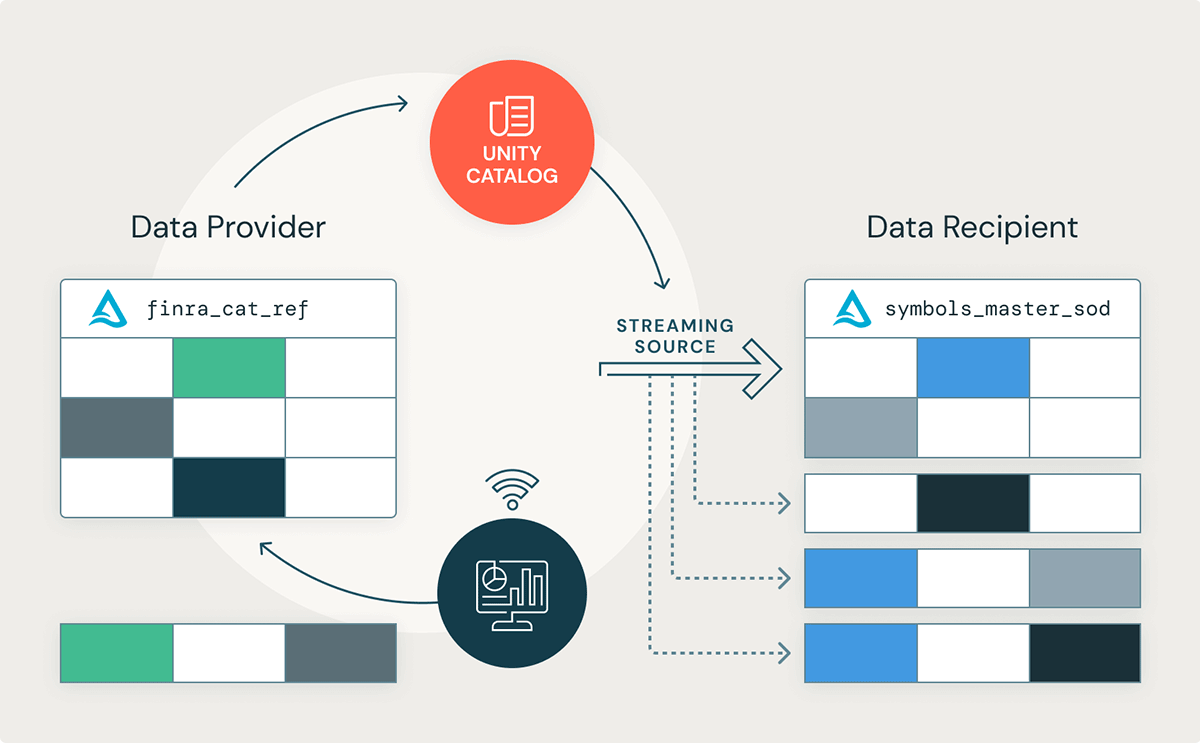

Comment utiliser Delta Sharing avec Structured Streaming
Examinons de plus près comment un destinataire de données peut diffuser en continu des informations sur les symboles d'actions cotées en bourse pour obtenir des analyses de trading en temps réel. Cet article utilisera le jeu de données FINRA CAT Reportable Equity Securities Symbol Master, qui répertorie toutes les actions et tous les titres de participation négociés sur le National Market System (NMS) américain. Structured Streaming peut être utilisé pour créer des applications en temps réel, mais peut également s'avérer utile dans des scénarios où les données arrivent moins fréquemment. Pour une simple démonstration dans un notebook, nous utiliserons un jeu de données mis à jour trois fois par jour : une fois au début de la date de transaction (SOD), une deuxième fois au cours de la journée pour refléter les modifications en cours de journée, et une troisième fois à la fin de la date de transaction (EOD). Aucune mise à jour n'est publiée le week-end ou les jours fériés aux États-Unis.
| Fichier publié | Horaire |
|---|---|
| CAT Reportable Equity Securities Symbol Master – SOD | 6 h 00 EST |
| CAT Reportable Options Securities Symbol Master – SOD | 6 h 00 EST |
| Member ID (IMID) List | 6 h 00 EST |
| Member ID (IMID) Conflicts List | 6 h 00 EST |
| CAT Reportable Equity Securities Symbol Master – Intraday | 10 h 30 EST, puis environ toutes les 2 heures jusqu'à la publication du fichier EOD |
| CAT Reportable Options Securities Symbol Master – Intraday | 10 h 30 EST, puis environ toutes les 2 heures jusqu'à la publication du fichier EOD |
| CAT Reportable Equity Securities Symbol Master – EOD | 20 h 00 EST |
| CAT Reportable Options Securities Symbol Master – EOD | 20 h 00 EST |
Tableau 1.1 - Les données de référence sur les symboles et les membres FINRA CAT sont publiées tout au long de la journée ouvrable. Aucune mise à jour n'est publiée le week-end ou les jours fériés aux États-Unis.
Du point de vue du fournisseur de données : ingérer les données CAT à l'aide de Databricks Workflows
L'un des avantages majeurs de la plateforme Databricks Lakehouse est qu'elle facilite grandement la diffusion en continu des modifications dans une table Delta. Nous commencerons par définir une tâche Python simple qui télécharge le fichier de symboles d'actions FINRA CAT au début de la date de transaction (SOD). Ensuite, nous enregistrerons le fichier publié dans un répertoire temporaire du système de fichiers Databricks.
Code 1.1. - Une tâche Python simple permet de télécharger le fichier de symboles d'actions FINRA CAT au début de la journée de négociation.
À titre de démonstration, nous définirons également une fonction qui ingérera le fichier brut et mettra à jour en continu une table bronze dans notre Delta Lake chaque fois qu'un fichier mis à jour est publié.
Code 1.2. - Les données des symboles d'actions FINRA CAT sont ingérées dans une table Delta au début de chaque journée de négociation.
Une fois démarré, le Databricks Workflow commencera à alimenter le jeu de données des symboles d'actions CAT chaque fois que le fichier sera publié au début de la journée de négociation.
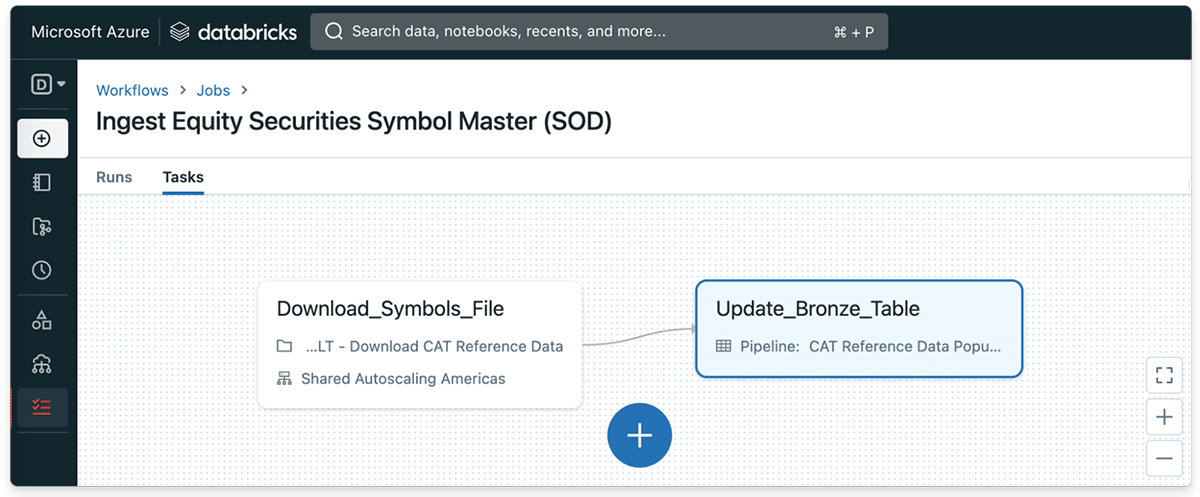

Du point de vue du fournisseur de données : partager une table Delta en tant que source de streaming
Maintenant que nous avons créé un pipeline de streaming pour ingérer les mises à jour du fichier de symboles chaque jour de cotation, nous pouvons utiliser Delta Sharing pour partager la table Delta avec des destinataires de données. Créer un partage Delta (Delta Share) sur la plateforme Databricks Lakehouse peut se faire en quelques clics seulement ou avec une seule instruction SQL si vous préférez la syntaxe SQL.
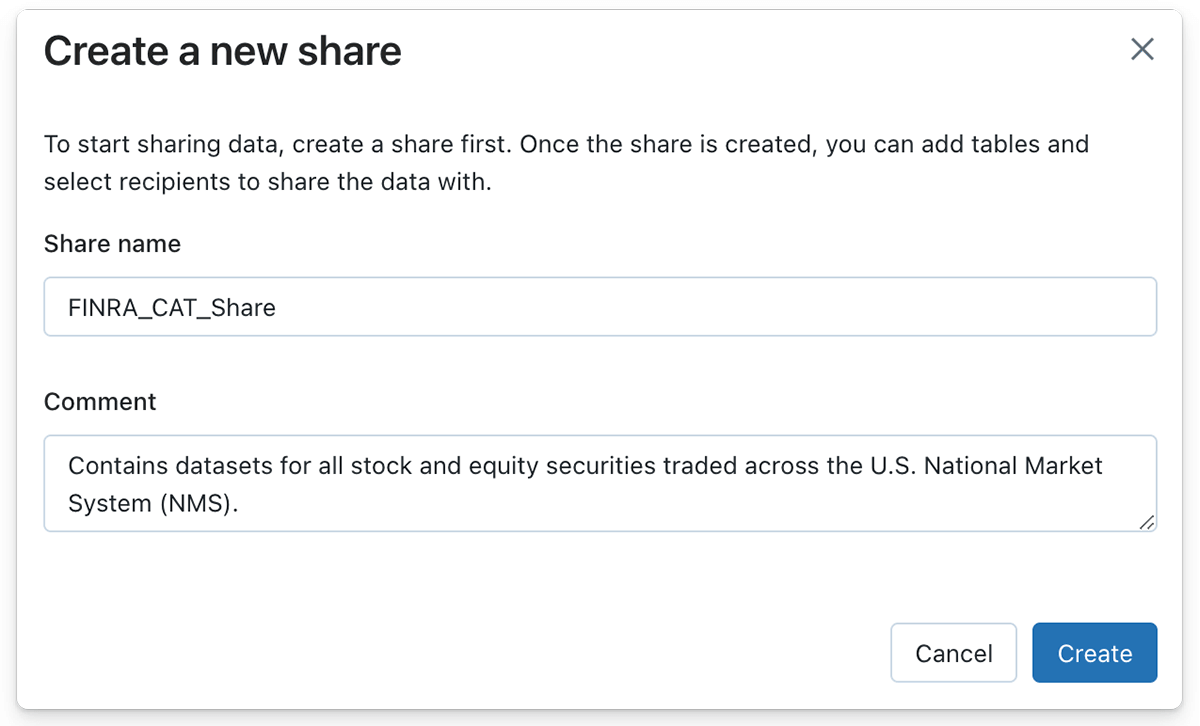

De même, un fournisseur de données peut alimenter un partage Delta avec une ou plusieurs tables en cliquant sur le bouton « Manage assets », puis sur le bouton « Edit tables ». Dans ce cas, la table Delta bronze contenant les données de symboles boursiers est ajoutée à l'objet Share.
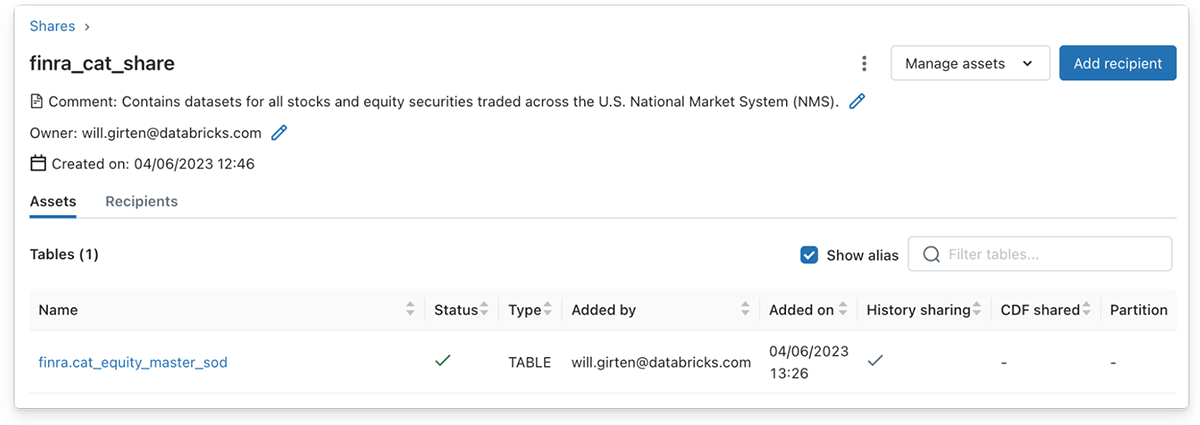

Notez que l'historique complet d'une table Delta doit être partagé pour prendre en charge les lectures avec Structured Streaming. Le partage de l'historique est activé par défaut lorsque vous utilisez l'interface utilisateur de Databricks pour ajouter une table Delta à un Share. En revanche, le partage de l'historique doit être spécifié explicitement lors de l'utilisation de la syntaxe SQL.
Code 1.4 - L'historique d'une table Delta doit être explicitement partagé pour prendre en charge les lectures Structured Streaming lors de l'utilisation de la syntaxe SQL.
Du point de vue du destinataire des données : lire une table Delta partagée en streaming
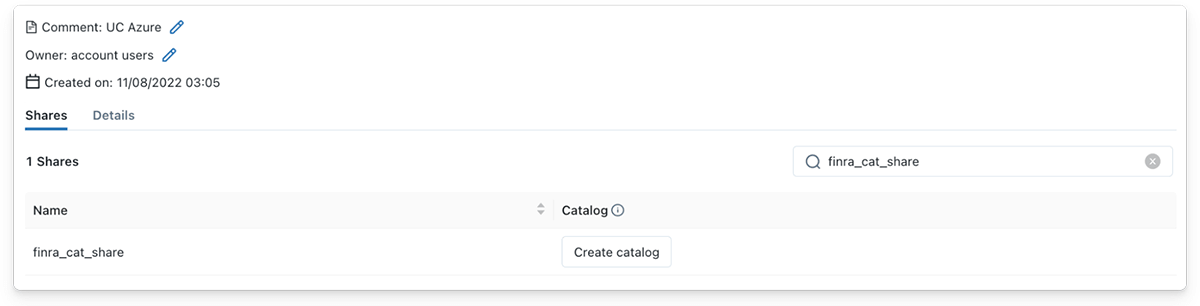

En tant que destinataire des données, lire en streaming à partir d'une table Delta partagée est tout aussi simple ! Une fois que le partage Delta a été partagé avec un destinataire, ce dernier verra immédiatement le Share apparaître sous les détails du fournisseur dans Unity Catalog. Par la suite, le destinataire des données peut créer un nouveau catalogue dans Unity Catalog en cliquant sur le bouton « Create catalog », en fournissant un nom explicite et en ajoutant un commentaire facultatif pour décrire le contenu du Share.
Les destinataires des données peuvent lire en streaming depuis une table Delta partagée via Unity Catalog en utilisant Databricks Runtime 12.1 ou supérieur. Dans cet exemple, nous avons utilisé un cluster Databricks sur lequel est installé Databricks 12.2 LTS Runtime. Un destinataire de données peut lire la table Delta partagée sous forme de flux Spark Structured Streaming en utilisant la source de données deltaSharing et en fournissant le nom de la table partagée.
Code 1.4 - Un destinataire de données peut lire en streaming à partir d'une table Delta partagée en utilisant la source de données deltaSharing.
Comme autre exemple, combinons le jeu de données maître des symboles boursiers CAT partagé avec un jeu de données d'historique des cours boursiers, local au Unity Catalog du destinataire des données. Nous commencerons par définir une fonction utilitaire pour obtenir l'historique hebdomadaire du cours d'un symbole boursier donné.
Ensuite, nous associerons le flux de données maître de symboles boursiers aux historiques locaux du cours des actions de 3 grandes entreprises technologiques : Apple Inc. (AAPL), Microsoft Corporation (MSFT) et Nvidia Corporation (NVDA).
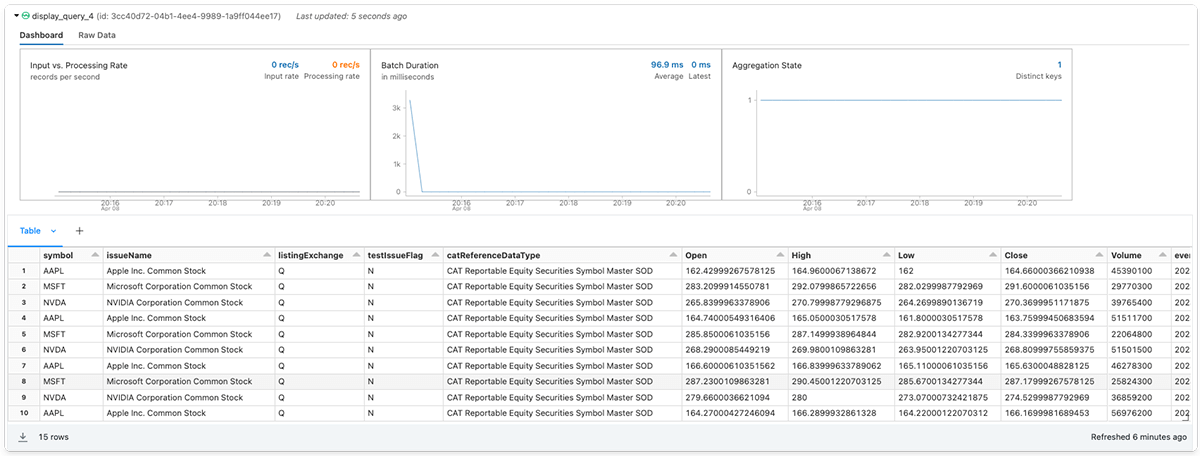
Enfin, le destinataire des données peut ajouter un collecteur de destination (sink) facultatif et démarrer la requête de streaming.

Débuter avec Delta Sharing sur Databricks
J'espère que vous avez apprécié cet exemple montrant comment les entreprises peuvent exploiter Delta Sharing pour maximiser la valeur métier de leurs données en temps quasi réel.
Vous souhaitez débuter avec Delta Sharing mais ne savez pas par où commencer ? Si vous êtes déjà client Databricks, suivez le guide pour commencer à utiliser Delta Sharing (AWS | Azure | GCP). Consultez la documentation pour en savoir plus sur les options de configuration incluses avec cette fonctionnalité. Si vous n'êtes pas encore client Databricks, inscrivez-vous pour un essai gratuit avec un espace de travail Premium ou Enterprise.
Crédits
Nous aimerions adresser des remerciements particuliers pour toutes les contributions à cette version, notamment à Abhijit Chakankar, Lin Zhou et Shixiong Zhu.
Ressources
- Notebooks d'accompagnement :
- [eBook] Découvrez le partage de données et la collaboration avec Databricks Lakehouse
- [eBook] Grand livre de la gouvernance de l'IA
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.