Vos données, votre stockage, vos règles : le guide 2026 du stockage des tables gérées Unity Catalog
Les données de vos tables gérées sont stockées dans un stockage cloud qui vous appartient, à un emplacement que vous contrôlez
par Elizabeth Bowman et Isabel Dong
- Les tables gérées Unity Catalog stockent vos données dans un stockage cloud qui vous appartient, à un chemin défini par l'emplacement de stockage géré sur votre métastore, catalogue ou schéma.
- À mesure que les organisations évoluent, les équipes peuvent se retrouver bloquées avec des données dans un emplacement hérité qu'elles n'ont jamais choisi. SET MANAGED LOCATION modifie l'emplacement de destination des nouvelles tables, et la conversion de tables externes déplace leurs données vers l'emplacement que vous avez défini.
- Vous gardez le contrôle sur l'emplacement de stockage des données de vos tables gérées, qu'il s'agisse d'un emplacement unique ou d'un stockage distinct pour des raisons de conformité et d'attribution des coûts.
Les tables gérées Unity Catalog vous permettent de contrôler l'emplacement de vos données lorsque votre organisation a besoin d'un stockage distinct. Contrairement à d'autres plateformes de données, les données des tables Databricks restent dans un compte de stockage cloud qui vous appartient, comme votre compartiment S3, votre conteneur ADLS ou votre compartiment GCS.
Unity Catalog automatise la gestion des tables gérées. Que vous stockiez vos tables gérées Unity Catalog au format Iceberg ou Delta, Databricks gère pour vous l'agencement, l'ajustement et le nettoyage des données à l'endroit de votre choix, en appliquant des optimisations automatiquement au fur et à mesure que vos tables changent.
Ce blog explique le fonctionnement du modèle de stockage des tables gérées et comment choisir ou modifier un emplacement de stockage géré Databricks.
Vos tables restent dans le stockage qui vous appartient
Lorsque vous apportez votre propre stockage cloud, les données des tables gérées sont stockées dans un compte cloud qui vous appartient. Vous conservez la propriété de ce stockage et la visibilité sur l'organisation de vos données. Vous pouvez inspecter, auditer et appliquer vos propres politiques de compartiment, ainsi que contrôler l'emplacement de vos données.
Contrairement à d'autres plateformes proposant des tables gérées ou natives qui conservent les tables dans un stockage contrôlé par le fournisseur ou dans des formats de données propriétaires, avec Databricks, vos données restent dans votre propre compte.
Ouvert par conception
Conserver les données dans votre propre compte cloud n'est qu'un aspect de l'ouverture des tables gérées chez Databricks. Unity Catalog est le seul catalogue majeur du secteur qui vous permet d'être propriétaire de vos données avec un accès complet en lecture et en écriture gouverné sur Iceberg et Delta, ainsi que la possibilité de fédérer des tables appartenant à des tiers dans des formats ouverts, en utilisant des standards ouverts.
Des outils externes tels que Apache Spark™, Flink, Trino, Kafka Connect et Snowflake peuvent lire et écrire dans des tables gérées via l'Iceberg REST Catalog et les API ouvertes d'Unity Catalog. Un accès sécurisé est possible grâce aux API ouvertes et à la distribution d'identifiants (credential vending), permettant aux outils externes d'interagir avec les données gouvernées sans les dupliquer. Cela simplifie l'architecture et permet d'avoir une source unique de vérité pour les charges de travail d'analytique et d'AI.
Lorsque vous apportez votre propre stockage, les fichiers restent accessibles dans votre compte cloud tandis qu'Unity Catalog en régit l'accès.
Vous contrôlez l'emplacement de vos données
Avec les tables gérées dans Databricks, vous pouvez décider de l'emplacement de stockage des données des tables gérées. Définissez un emplacement de stockage géré une seule fois au niveau du metastore, du catalogue ou du schéma, et chaque table sous-jacente en héritera. Le niveau le plus spécifique l'emporte : l'emplacement d'un schéma est prioritaire sur celui de son catalogue, et celui d'un catalogue sur celui du metastore. Vous pouvez définir une valeur par défaut générale et la remplacer partout où une équipe ou un domaine a besoin de son propre stockage.
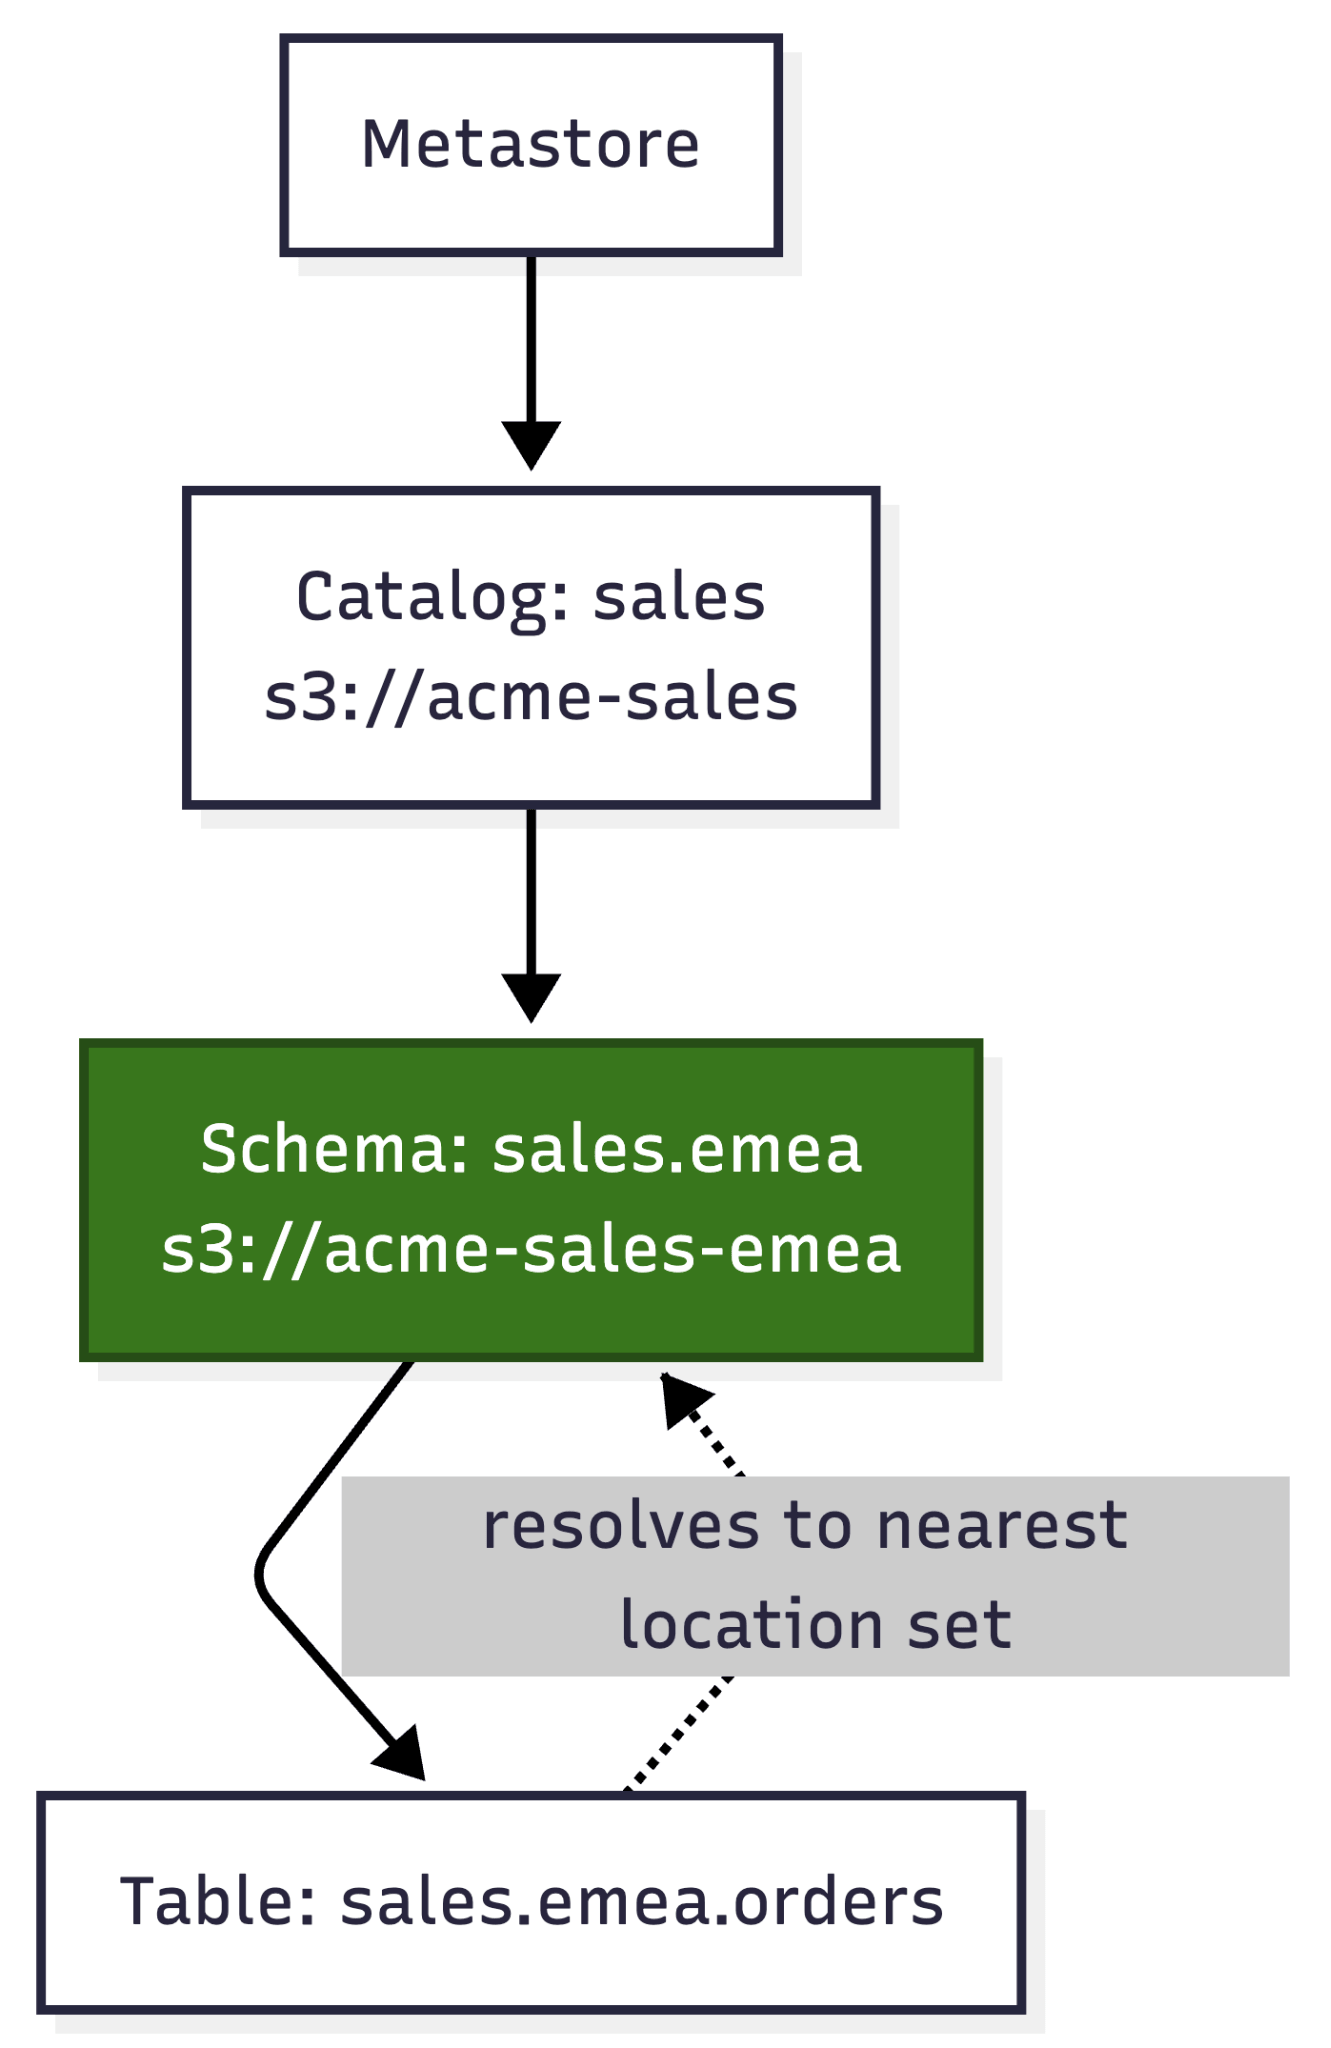
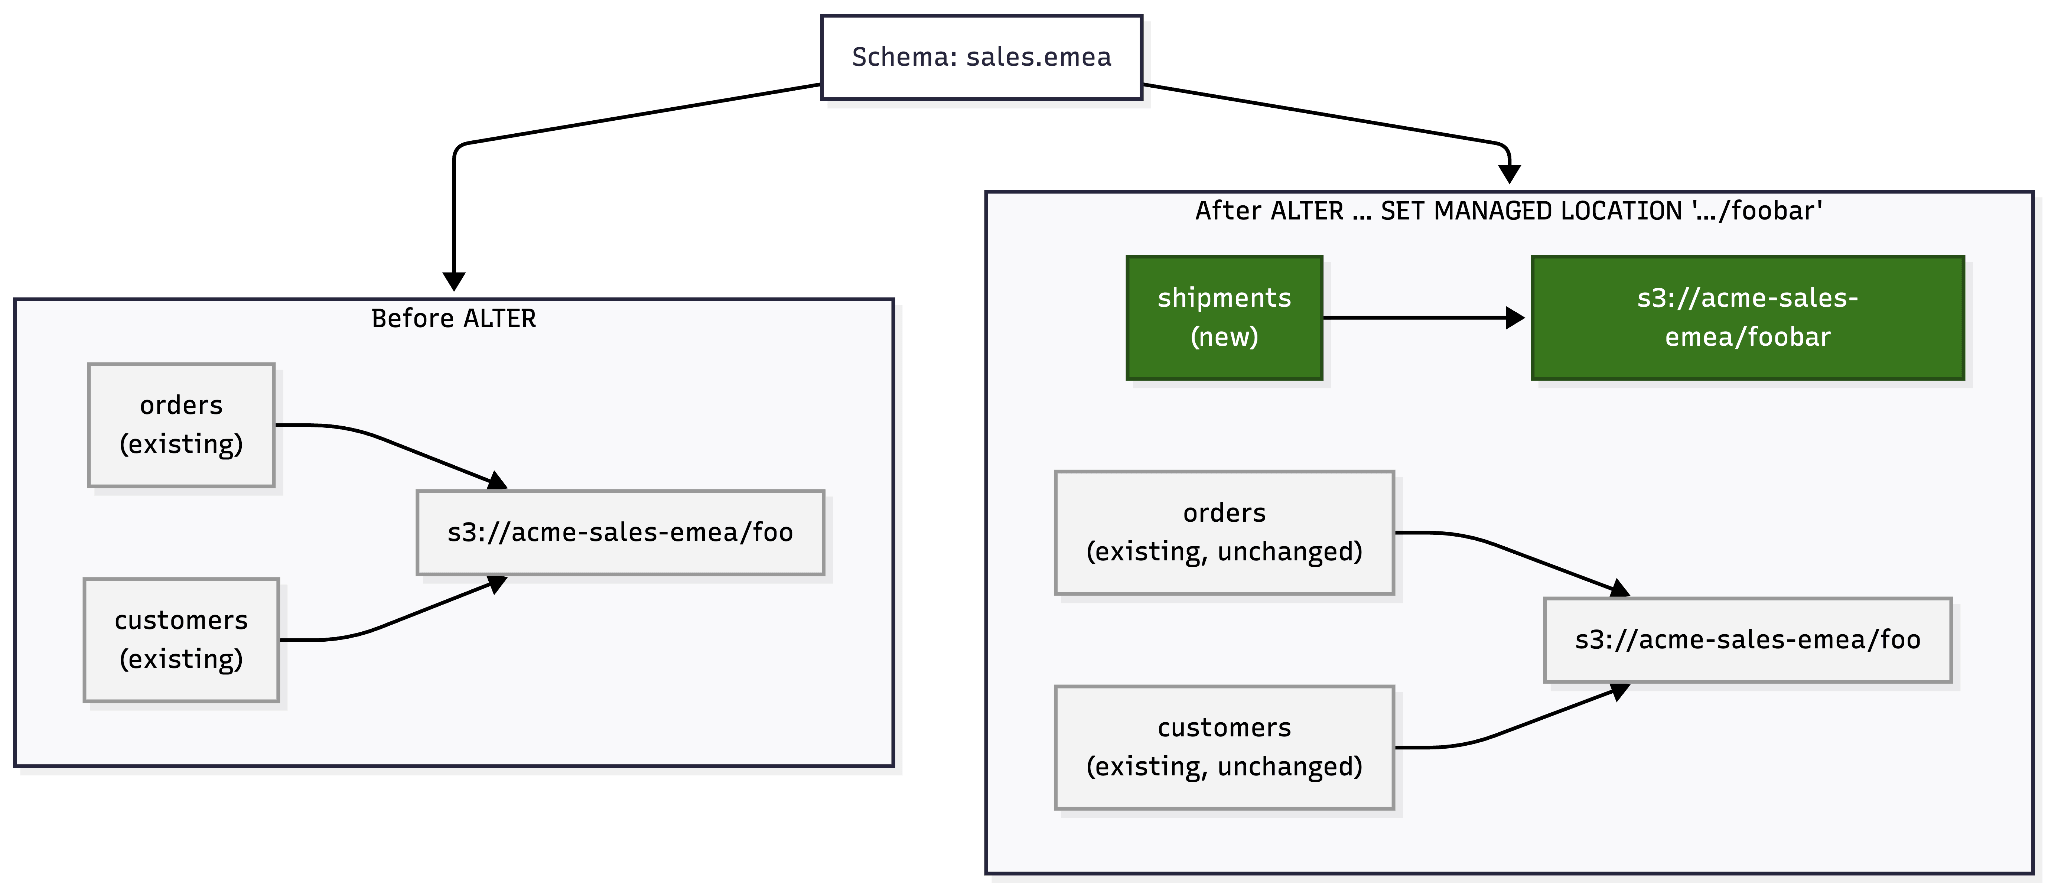
Ce contrôle n'est pas figé lors de la configuration. Au fur et à mesure que votre organisation évolue, ALTER CATALOG ou ALTER SCHEMA ... SET MANAGED LOCATION pointe les nouvelles tables et volumes vers un nouvel emplacement, tandis que tout ce qui a déjà été écrit reste là où il se trouve.
Plus de contrôle lorsque vous avez besoin d'un stockage distinct
La plupart des équipes organisent leurs données de manière logique, via des catalogues et des schémas, sans jamais avoir à se soucier de l'emplacement physique des fichiers sous-jacents : l'emplacement de stockage géré dont héritent leurs catalogues et schémas est tout ce dont elles ont besoin. Associée aux contrôles d'accès basés sur les rôles et les attributs dans Unity Catalog, cette approche répond aux exigences standard de ségrégation des données du GDPR.
Certaines organisations ont toutefois besoin de limites qui s'étendent au stockage physique lui-même. Une branche d'activité peut avoir besoin d'un stockage distinct pour l'administration ou la répartition des coûts cloud. Ou des règles régionales et réglementaires peuvent imposer l'endroit où certaines données résident physiquement. Dans ce cas, vous pouvez attribuer à un catalogue ou à un schéma spécifique son propre emplacement de stockage géré, de sorte que l'emplacement physique des données corresponde à la limite requise.
Choisissez l'emplacement des données lors de la conversion en table gérée
Lorsque vous convertissez une table externe en table gérée, les données sont stockées dans l'emplacement de stockage géré vers lequel son catalogue ou son schéma pointe actuellement. Si cette table externe se trouve déjà dans un emplacement ad hoc ou non standard, vous souhaiterez peut-être que la table gérée soit placée ailleurs, dans le stockage que vous utilisez actuellement pour ce domaine.
Lors de la conversion, Databricks copie les données et le journal des transactions de la table dans l'emplacement de stockage géré que vous avez défini, de sorte que la table gérée se retrouve à l'endroit que vous avez choisi.
Résumé
Les tables gérées automatisent la maintenance des tables tandis que vos données peuvent rester dans un stockage qui vous appartient. Cela diffère des autres plateformes gérées qui conservent les données des tables dans un stockage contrôlé par le fournisseur. Vous pouvez contrôler l'emplacement au niveau du metastore, du catalogue ou du schéma, modifier l'emplacement des nouvelles tables et choisir un emplacement lors de la conversion d'une table externe en table gérée. Vos données restent dans des formats ouverts, accessibles via l'Iceberg REST Catalog et les API ouvertes d'Unity Catalog.
Lorsque vous êtes prêt à définir ou à modifier un emplacement de stockage géré, la documentation sur le stockage géré détaille la procédure.
Fonctionnalité | Databricks Unity Catalog | Autres plateformes |
Données stockées dans un stockage appartenant au client | ✅ Oui | Souvent propriétaire |
Formats de table ouverts (Iceberg et Delta) | ✅ Oui | Varie selon le format |
Accès en lecture/écriture pour les outils externes avec gouvernance au niveau des lignes et des colonnes | ✅ Via Iceberg REST Catalog ou les API ouvertes d'Unity Catalog | Limité |
Possibilité de contrôler l'emplacement de stockage au niveau du catalogue/schéma | ✅ SET MANAGED LOCATION | Rare |
Définitions
Beaucoup de ces termes réutilisent les mêmes mots, ce qui les rend faciles à confondre. Voici ce que chacun signifie dans cet article.
- Table gérée : Une table dont les données et le cycle de vie sont gérés pour vous par Unity Catalog. Vous la créez sans clause
LOCATION. - Emplacement de stockage géré : Le chemin de stockage cloud où sont écrits les volumes et les tables gérées d'un metastore, d'un catalogue ou d'un schéma. Vous le définissez avec la clause
SET MANAGED LOCATION. - Emplacement externe : Un objet Unity Catalog qui associe un chemin cloud à un identifiant de stockage pour régir l'accès à ce chemin. Les emplacements externes régissent à la fois les tables externes et le stockage géré : un emplacement de stockage géré au niveau du catalogue ou du schéma se trouve à l'intérieur de l'un d'eux.
- Stockage appartenant au client : Une option de stockage où le stockage cloud sous-jacent se trouve dans le propre compte cloud du client. Cela représente la grande majorité des tables dans Databricks.
- Stockage par défaut : Une option de stockage alternative où Databricks provisionne le stockage cloud sous-jacent pour vous, au lieu que vous n'apportiez votre propre bucket.
- ALTER CATALOG / ALTER SCHEMA … SET MANAGED LOCATION : La commande qui modifie l'emplacement où les nouvelles tables gérées et les nouveaux volumes d'un catalogue ou d'un schéma sont écrits. Les tables existantes ne sont pas affectées.
- Conversion d'externe à géré (ALTER TABLE … SET MANAGED) : La commande qui convertit une table externe en table gérée. Lors de la conversion, les données et le journal des transactions sont copiés dans l'emplacement de stockage géré actuel.
FAQ
1. Où Unity Catalog stocke-t-il les données des tables gérées : dans un stockage appartenant à Databricks ou dans mon propre compte cloud ?
Dans votre propre compte. Les données des tables gérées sont écrites dans le stockage cloud de votre propre compte, qu'il s'agisse de S3, ADLS ou GCS, à un emplacement de stockage géré que vous définissez sur votre métastore, catalogue ou schéma. Databricks gère la disposition et le cycle de vie de la table, mais les fichiers sous-jacents résident dans un bucket ou un conteneur qui vous appartient et que vous enregistrez auprès d'Unity Catalog, et non dans un compte contrôlé par Databricks.
2. Les tables gérées d'Unity Catalog m'enferment-elles dans Databricks ?
Non. Les tables gérées utilisent des formats de table ouverts, notamment Iceberg et Delta, qui restent dans le stockage cloud qui vous appartient. Les moteurs externes peuvent y écrire et y lire via l'Iceberg REST Catalog et les API ouvertes d'Unity Catalog, de sorte que vos données ne sont pas piégées derrière une interface propriétaire. Vous conservez la propriété du stockage, les données restent dans des formats ouverts et l'accès se fait via des standards ouverts. Les tables gérées ne créent pas de dépendance exclusive : il est tout aussi possible de migrer vers ou depuis Databricks avec des tables gérées qu'avec des tables externes. Dans les deux cas, vous pouvez conserver vos données physiquement au même endroit.
3. Puis-je conserver certaines données dans un stockage distinct pour des raisons de conformité ou de résidence des données ?
Oui. Vous pouvez attribuer à un catalogue ou à un schéma spécifique son propre emplacement de stockage géré, séparé de tout le reste si nécessaire, afin de conserver les données de différents pays ou régimes réglementaires dans des stockages distincts, ou d'attribuer les coûts de stockage à une équipe ou une unité commerciale particulière.
4. Des moteurs et outils autres que Databricks peuvent-ils écrire et lire dans mes tables gérées ?
Oui. Les tables gérées sont accessibles en lecture ou en écriture via l'Iceberg REST Catalog et les API ouvertes d'Unity Catalog, de sorte que des moteurs externes tels qu'Apache Spark, Trino et Flink peuvent y accéder. Unity Catalog gère la gouvernance de l'accès au stockage, évitant ainsi la corruption des données que pourrait provoquer leur contournement. Un accès direct basé sur le chemin est également disponible via la redirection basée sur le chemin et le mode de compatibilité.
5. Puis-je modifier l'emplacement de stockage des données de ma table gérée après qu'il a été défini ?
Oui. Utilisez ALTER CATALOG … SET MANAGED LOCATION ou ALTER SCHEMA … SET MANAGED LOCATION pour diriger les nouvelles tables vers un emplacement différent chaque fois que les besoins de séparation physique de votre organisation changent : une réorganisation, un nouveau bucket, une nouvelle région. Les tables existantes restent exactement là où elles se trouvent, et les nouvelles tables sont créées dans le nouvel emplacement. Chaque fois que vous convertissez une table externe en table gérée, ses données sont copiées dans l'emplacement que vous avez défini, ce qui vous permet de déplacer les données vers le bon emplacement au cours de la même étape.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.