Le cadre de pipeline ouvert pour les agents et les équipes de données
Créez en toute sécurité des pipelines à l'échelle agentique avec une qualité, une validation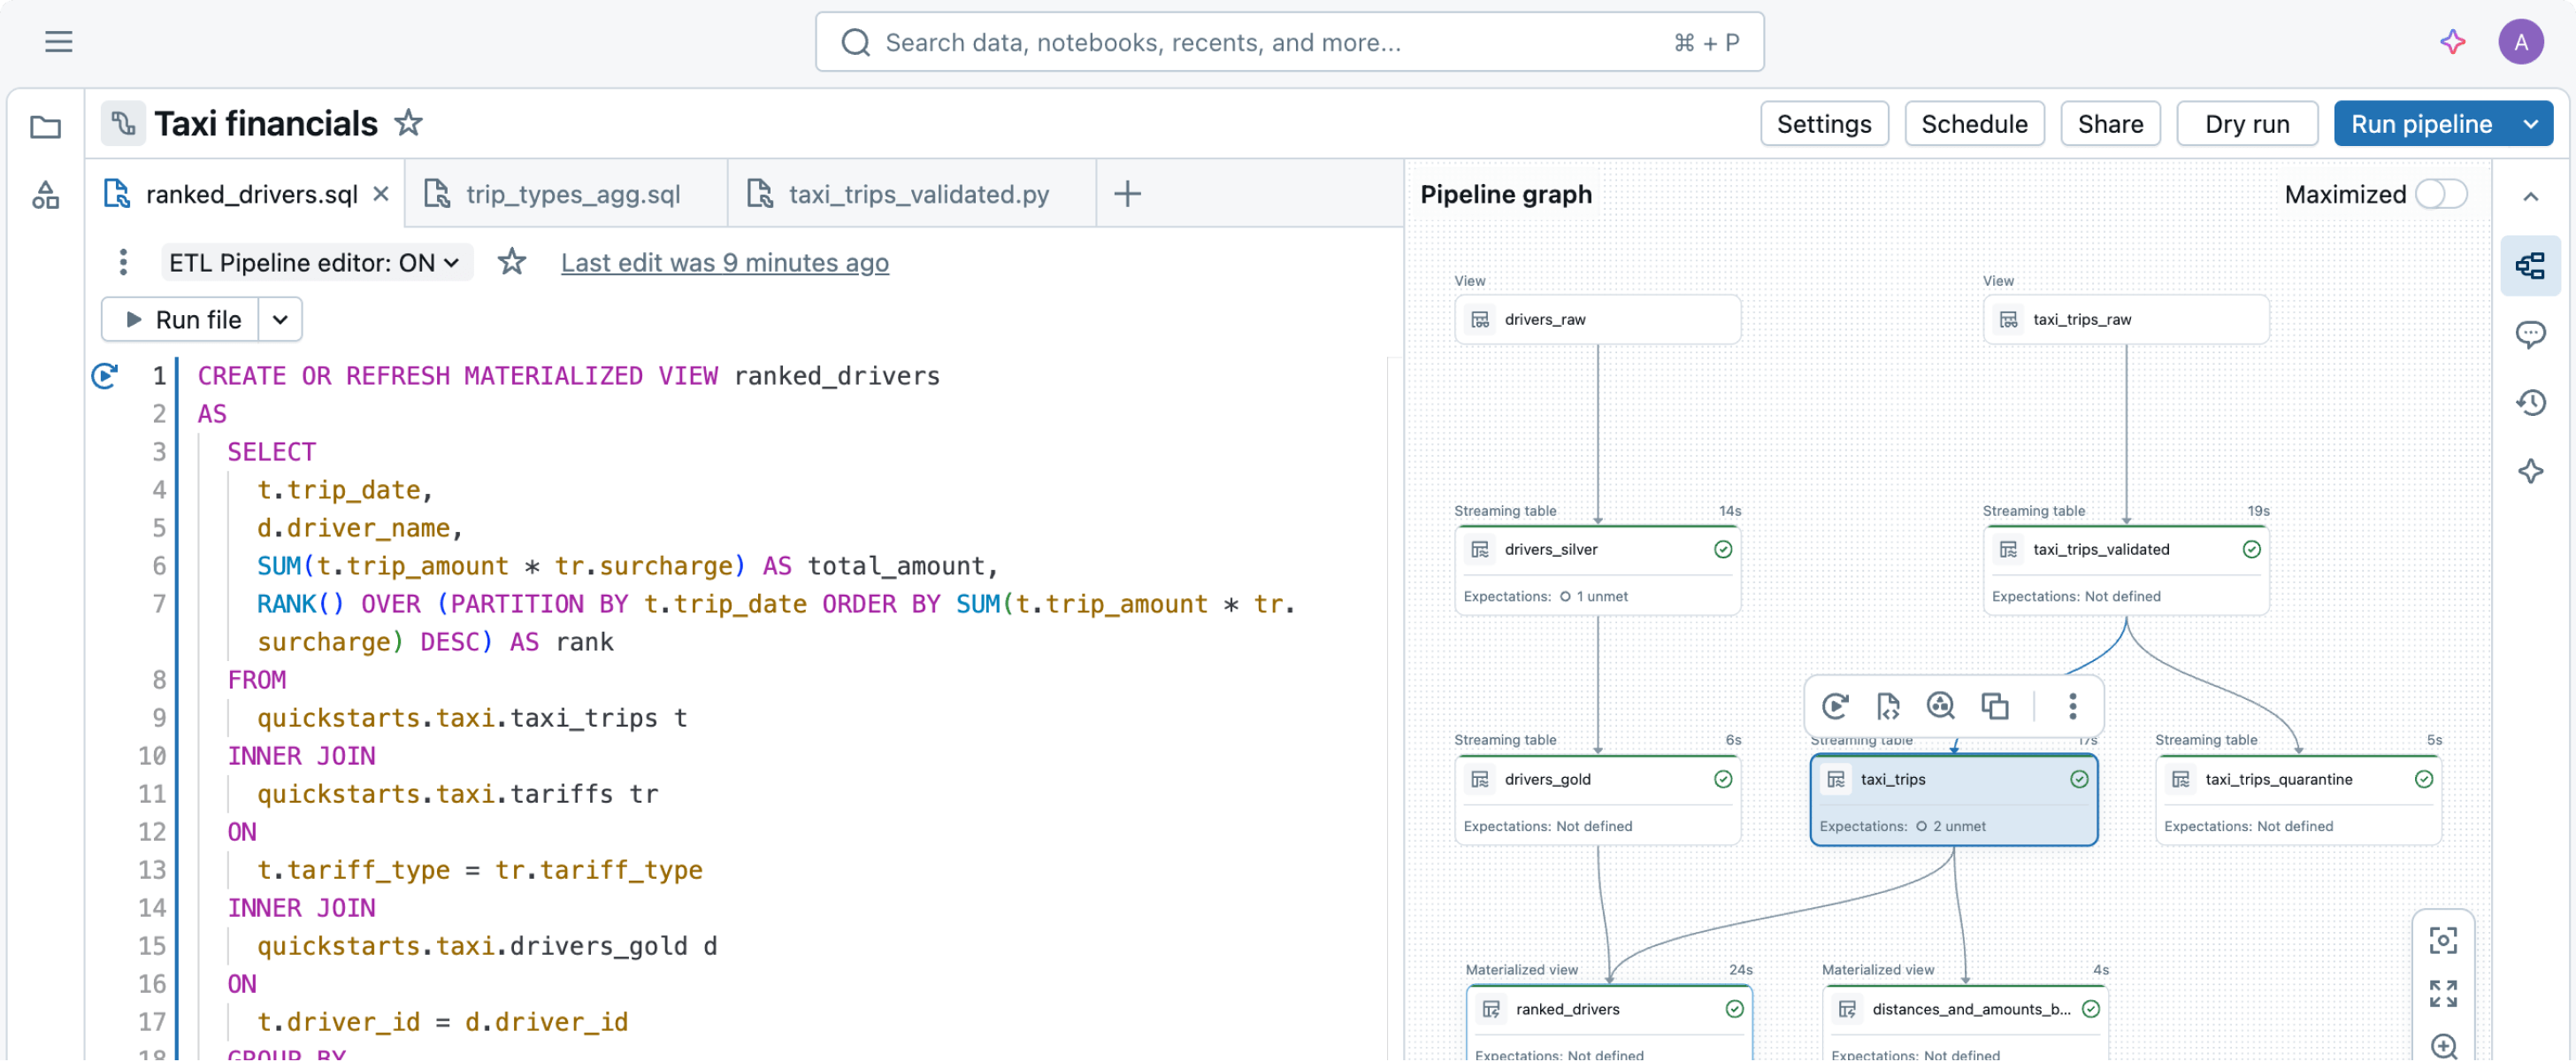
TOP TEAMS SUCCEED WITH INTELLIGENT DATA PIPELINES
Créez et exécutez des pipelines à l'échelle agentique en toute confiance
Donnez aux équipes de données et aux agents d'IA les moyens d'agir grâce à des normes ouvertes, des contrôles de qualité automatisés et une gouvernance de niveau entreprise.
Des normes ouvertes
Le standard ouvert et universel pour les pipelines de données. Unifiez le traitement par lots et le streaming, ainsi que le SQL et Python, sur Apache Spark™ — offrant aux équipes de données et aux agents d'IA une base portable pour générer du code de production robuste.

Conçu pour les agents
Le cadre natif pour les agents de codage. Les agents déclarent les résultats de données cibles. Apache Spark™ Declarative Pipelines (SDP) résout automatiquement les graphes de dépendance, effectue des simulations de compilation et applique les règles de qualité avant l'exécution des pipelines.

Une exécution gérée
Une exécution du pipeline sans danger et autonome. Unity Catalog impose des limites de catalogue et une sécurité strictes, tandis que le SDP gère la gestion d'état, la récupération d'erreurs et le traitement incrémentiel en arrière-plan.
Conçu pour normaliser le développement de pipelines pour les agents et les humains
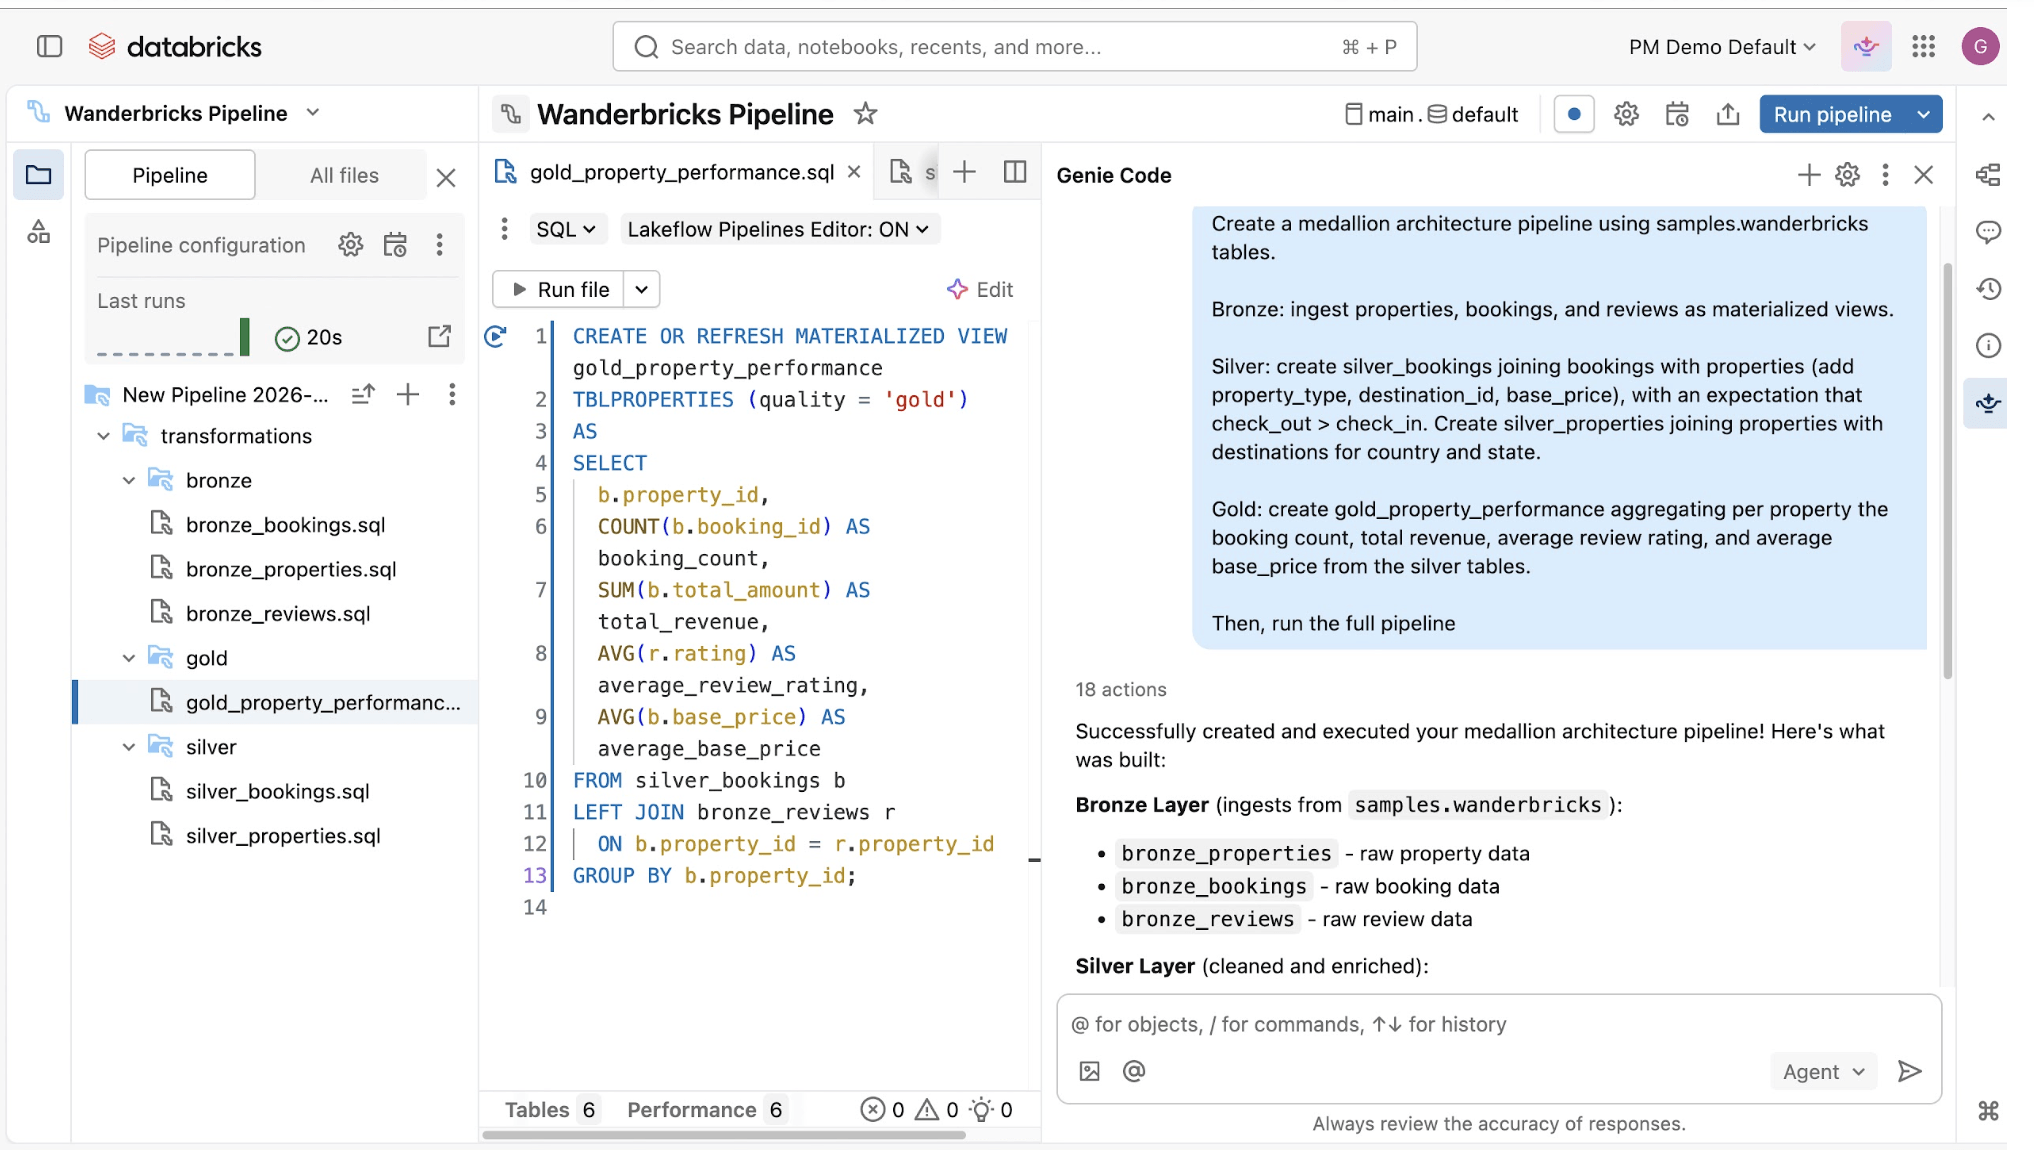
Normalisez le développement de pipelines avec une création prête pour les agents, une gestion automatisée des modèles et un seul cadre pour toutes les équipes.Créez, validez et itérez de manière déclarative en utilisant le langage naturel via Genie Code, ou via l'agent de codage de votre choix.
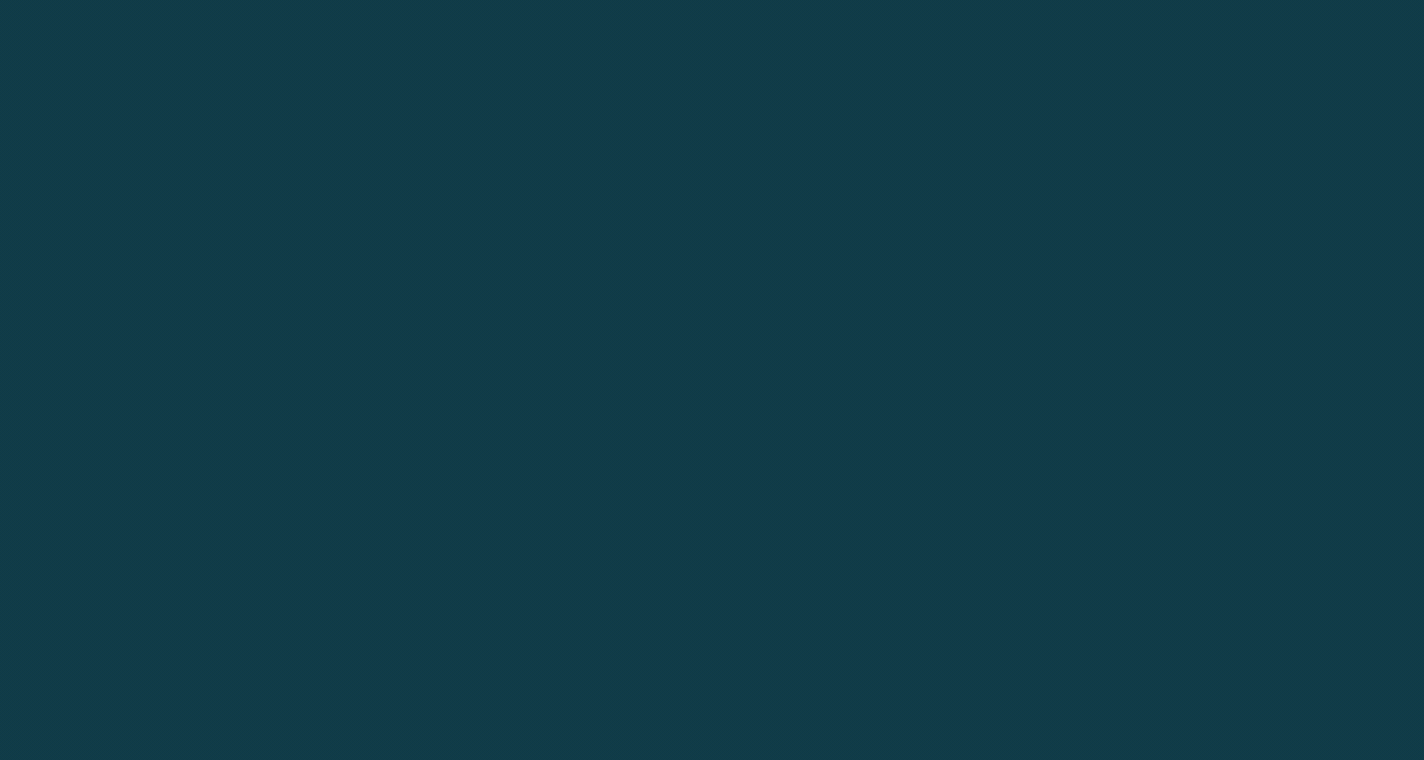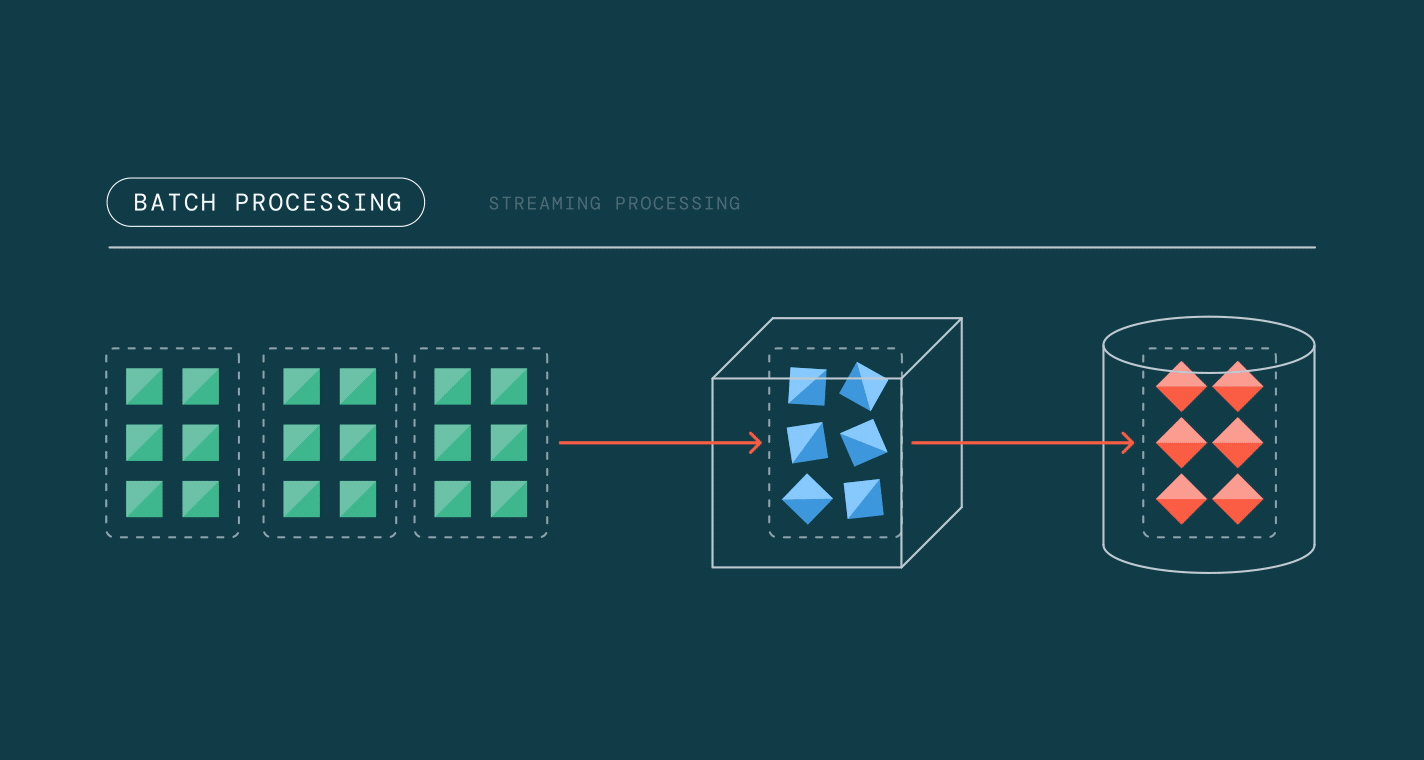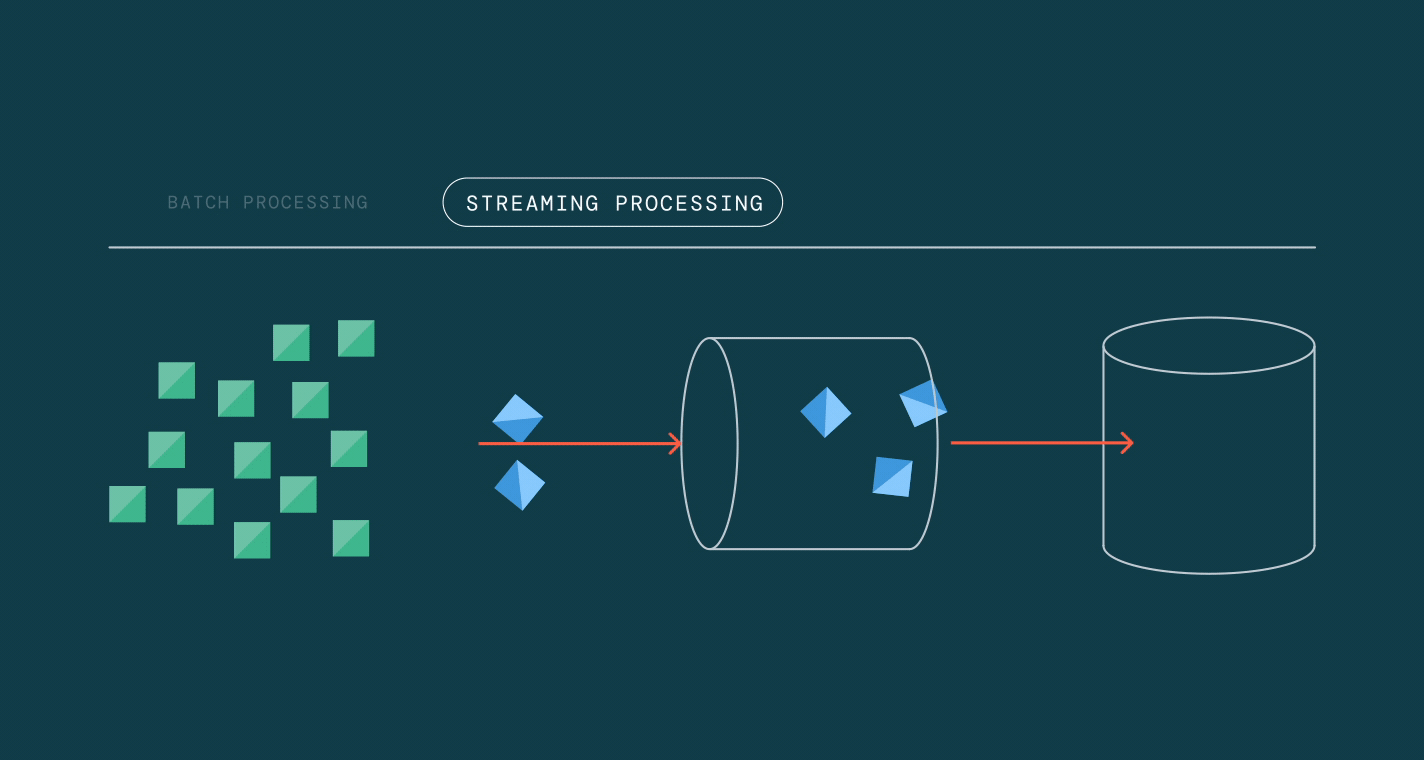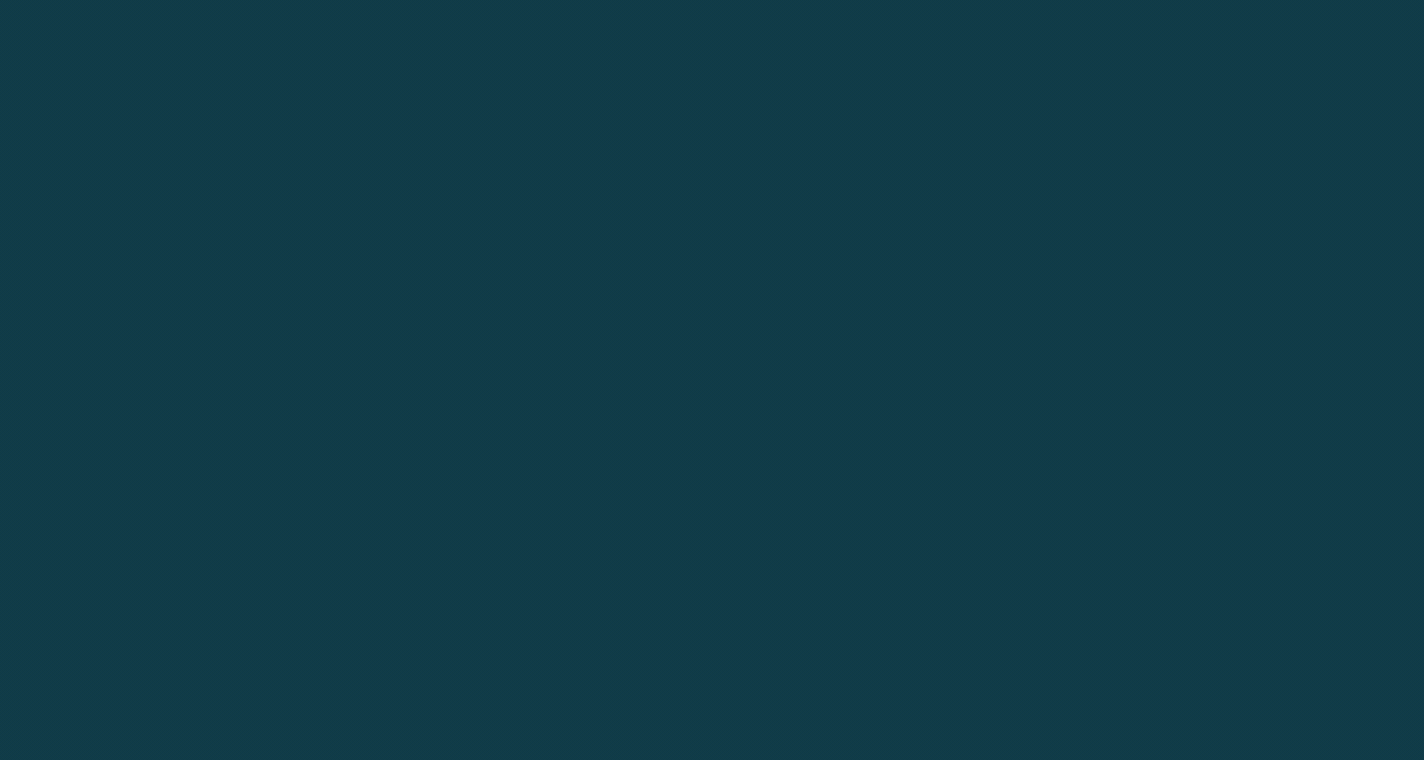
Grâce à l'API unifiée de Spark pour le traitement par batch et en streaming, les pipelines SDP vous permettent d'alterner facilement entre les modes de traitement.
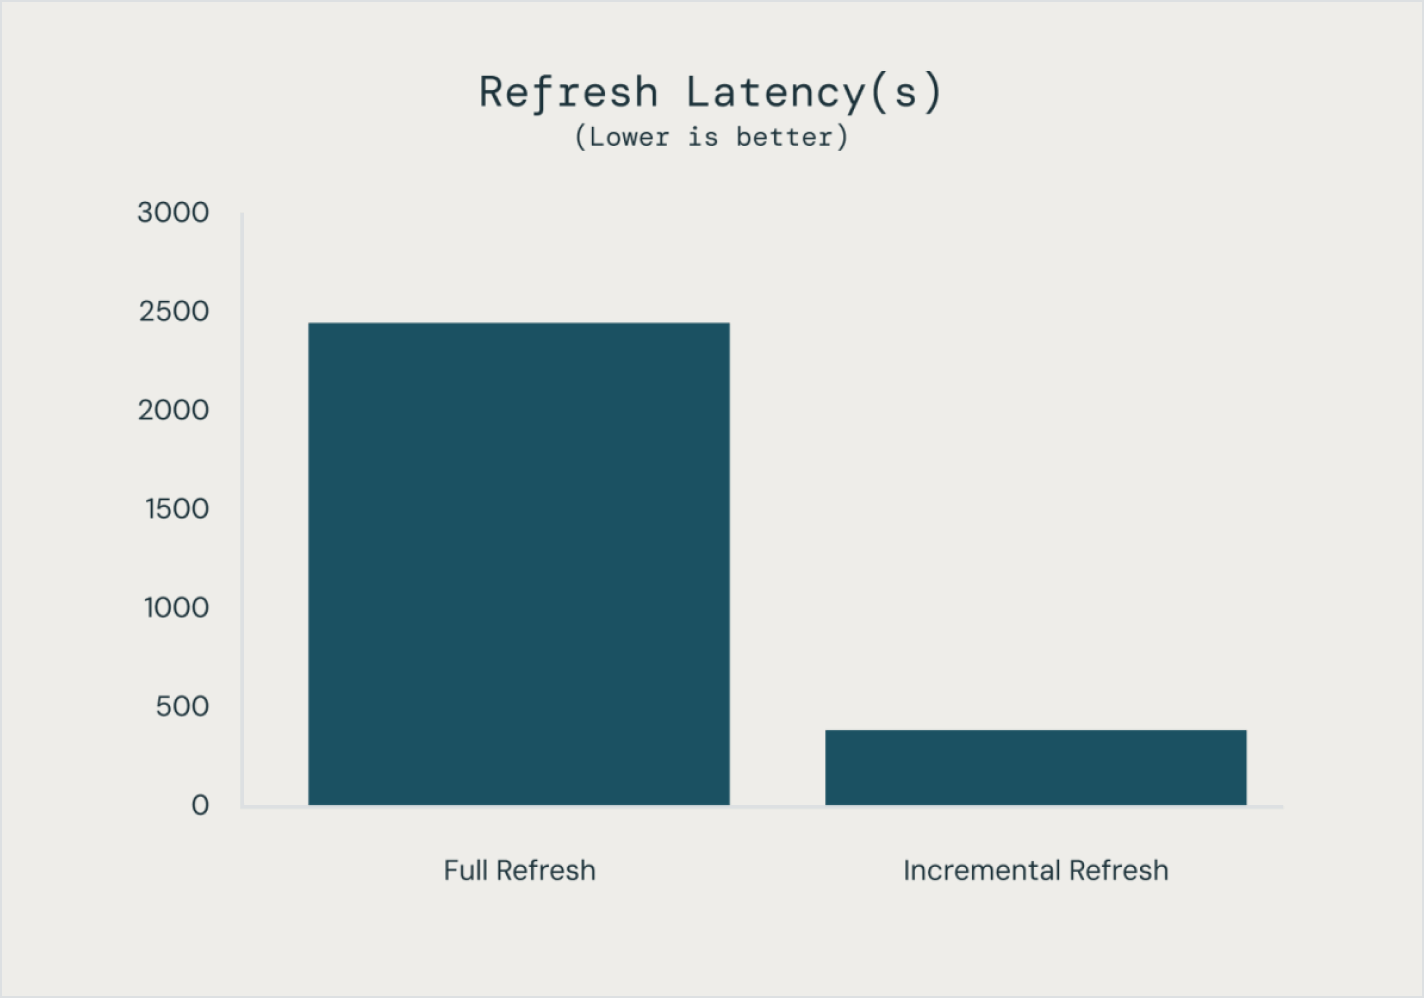
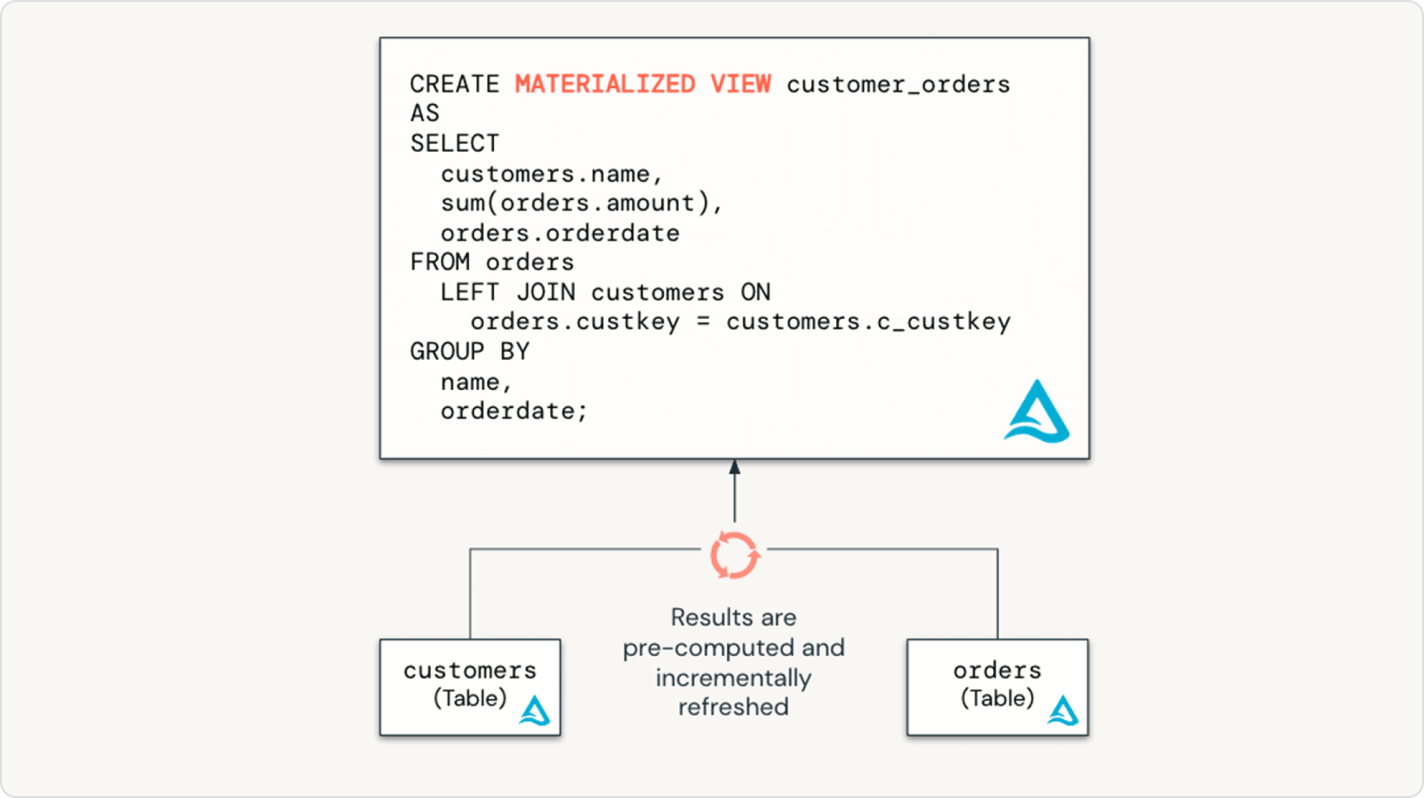
Le SDP permet d'optimiser facilement les performances du pipeline en déclarant un pipeline de données incrémentiel complet, accompagné de tables de streaming et de vues matérialisées.
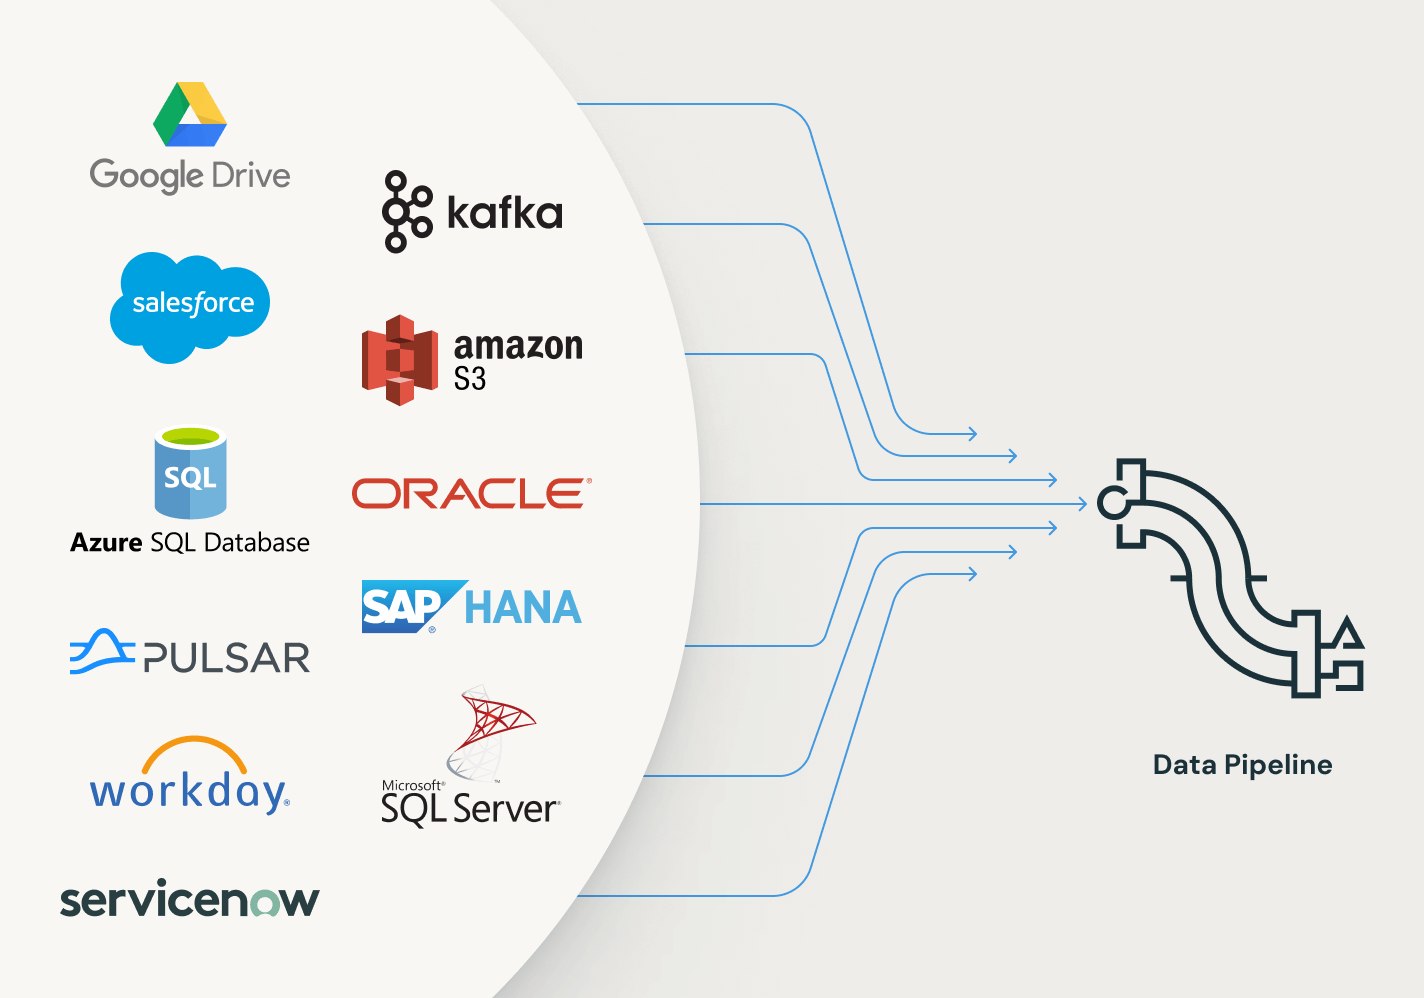
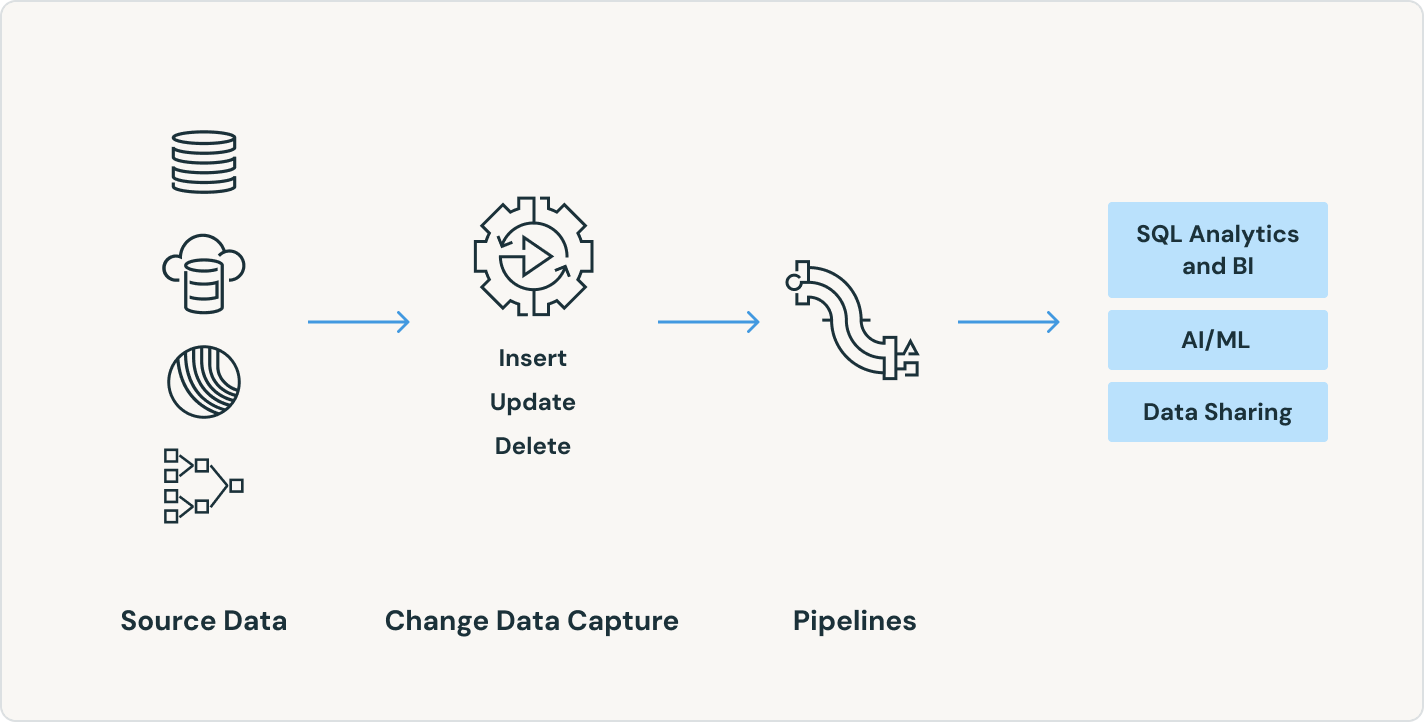
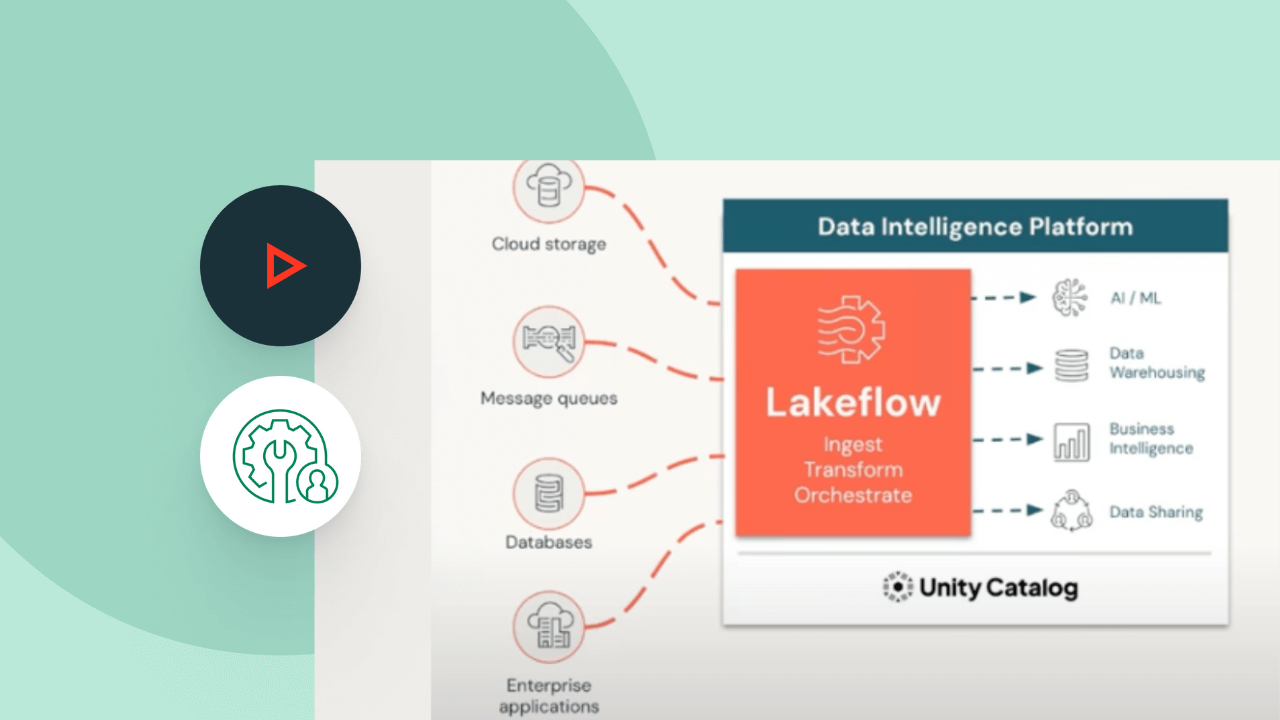
Le SDP prend en charge un large écosystème de sources et de puits. Chargez les données depuis n'importe quelle source, y compris le stockage cloud, les bus de messages, les flux de données modifiées, les bases de données et les applications d'entreprise.
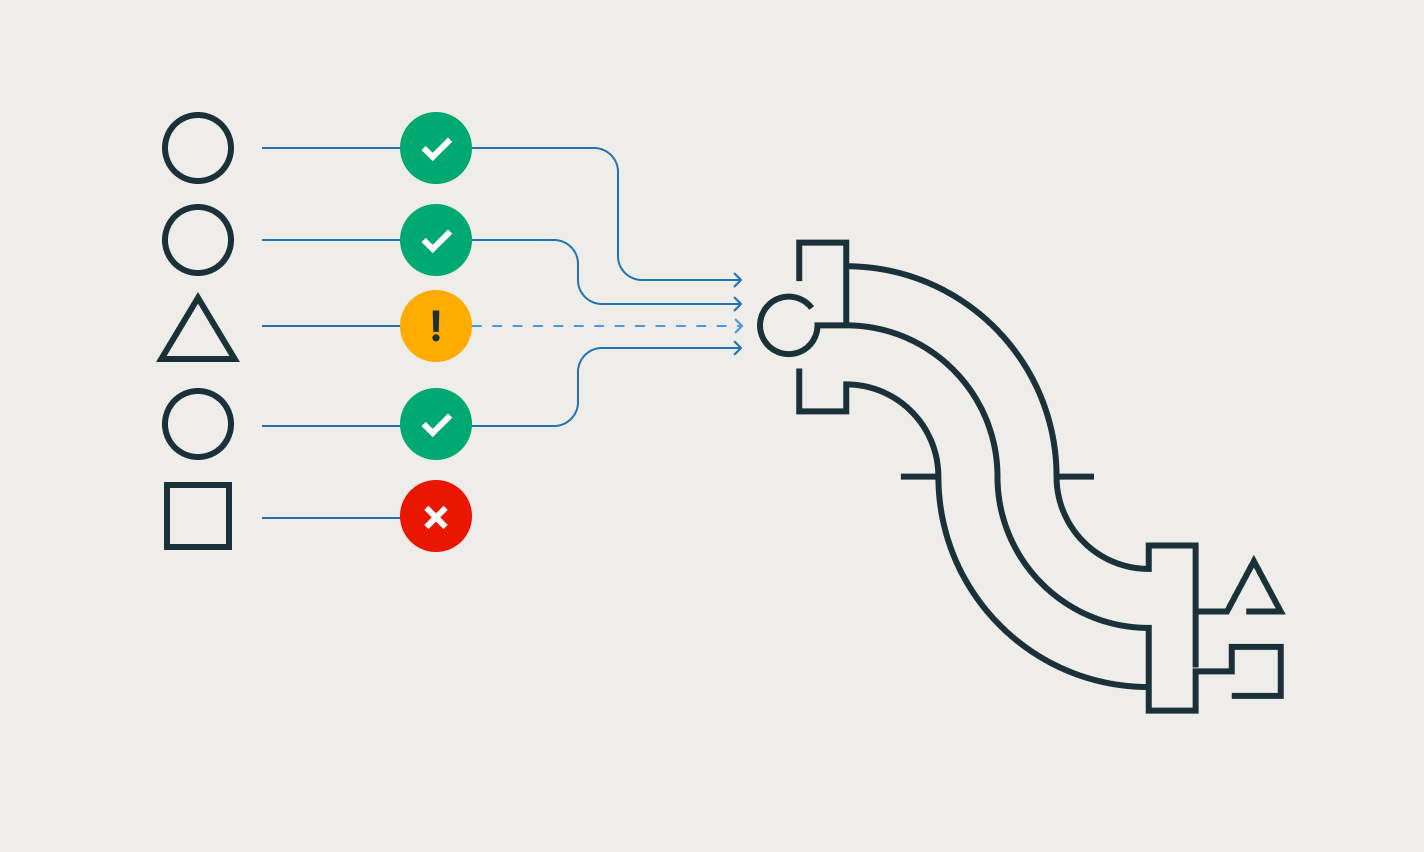
Définissez des attentes pour garantir que les données arrivant dans les tables répondent à vos exigences de qualité, et obtenez des informations sur la qualité des données à chaque mise à jour des pipelines.
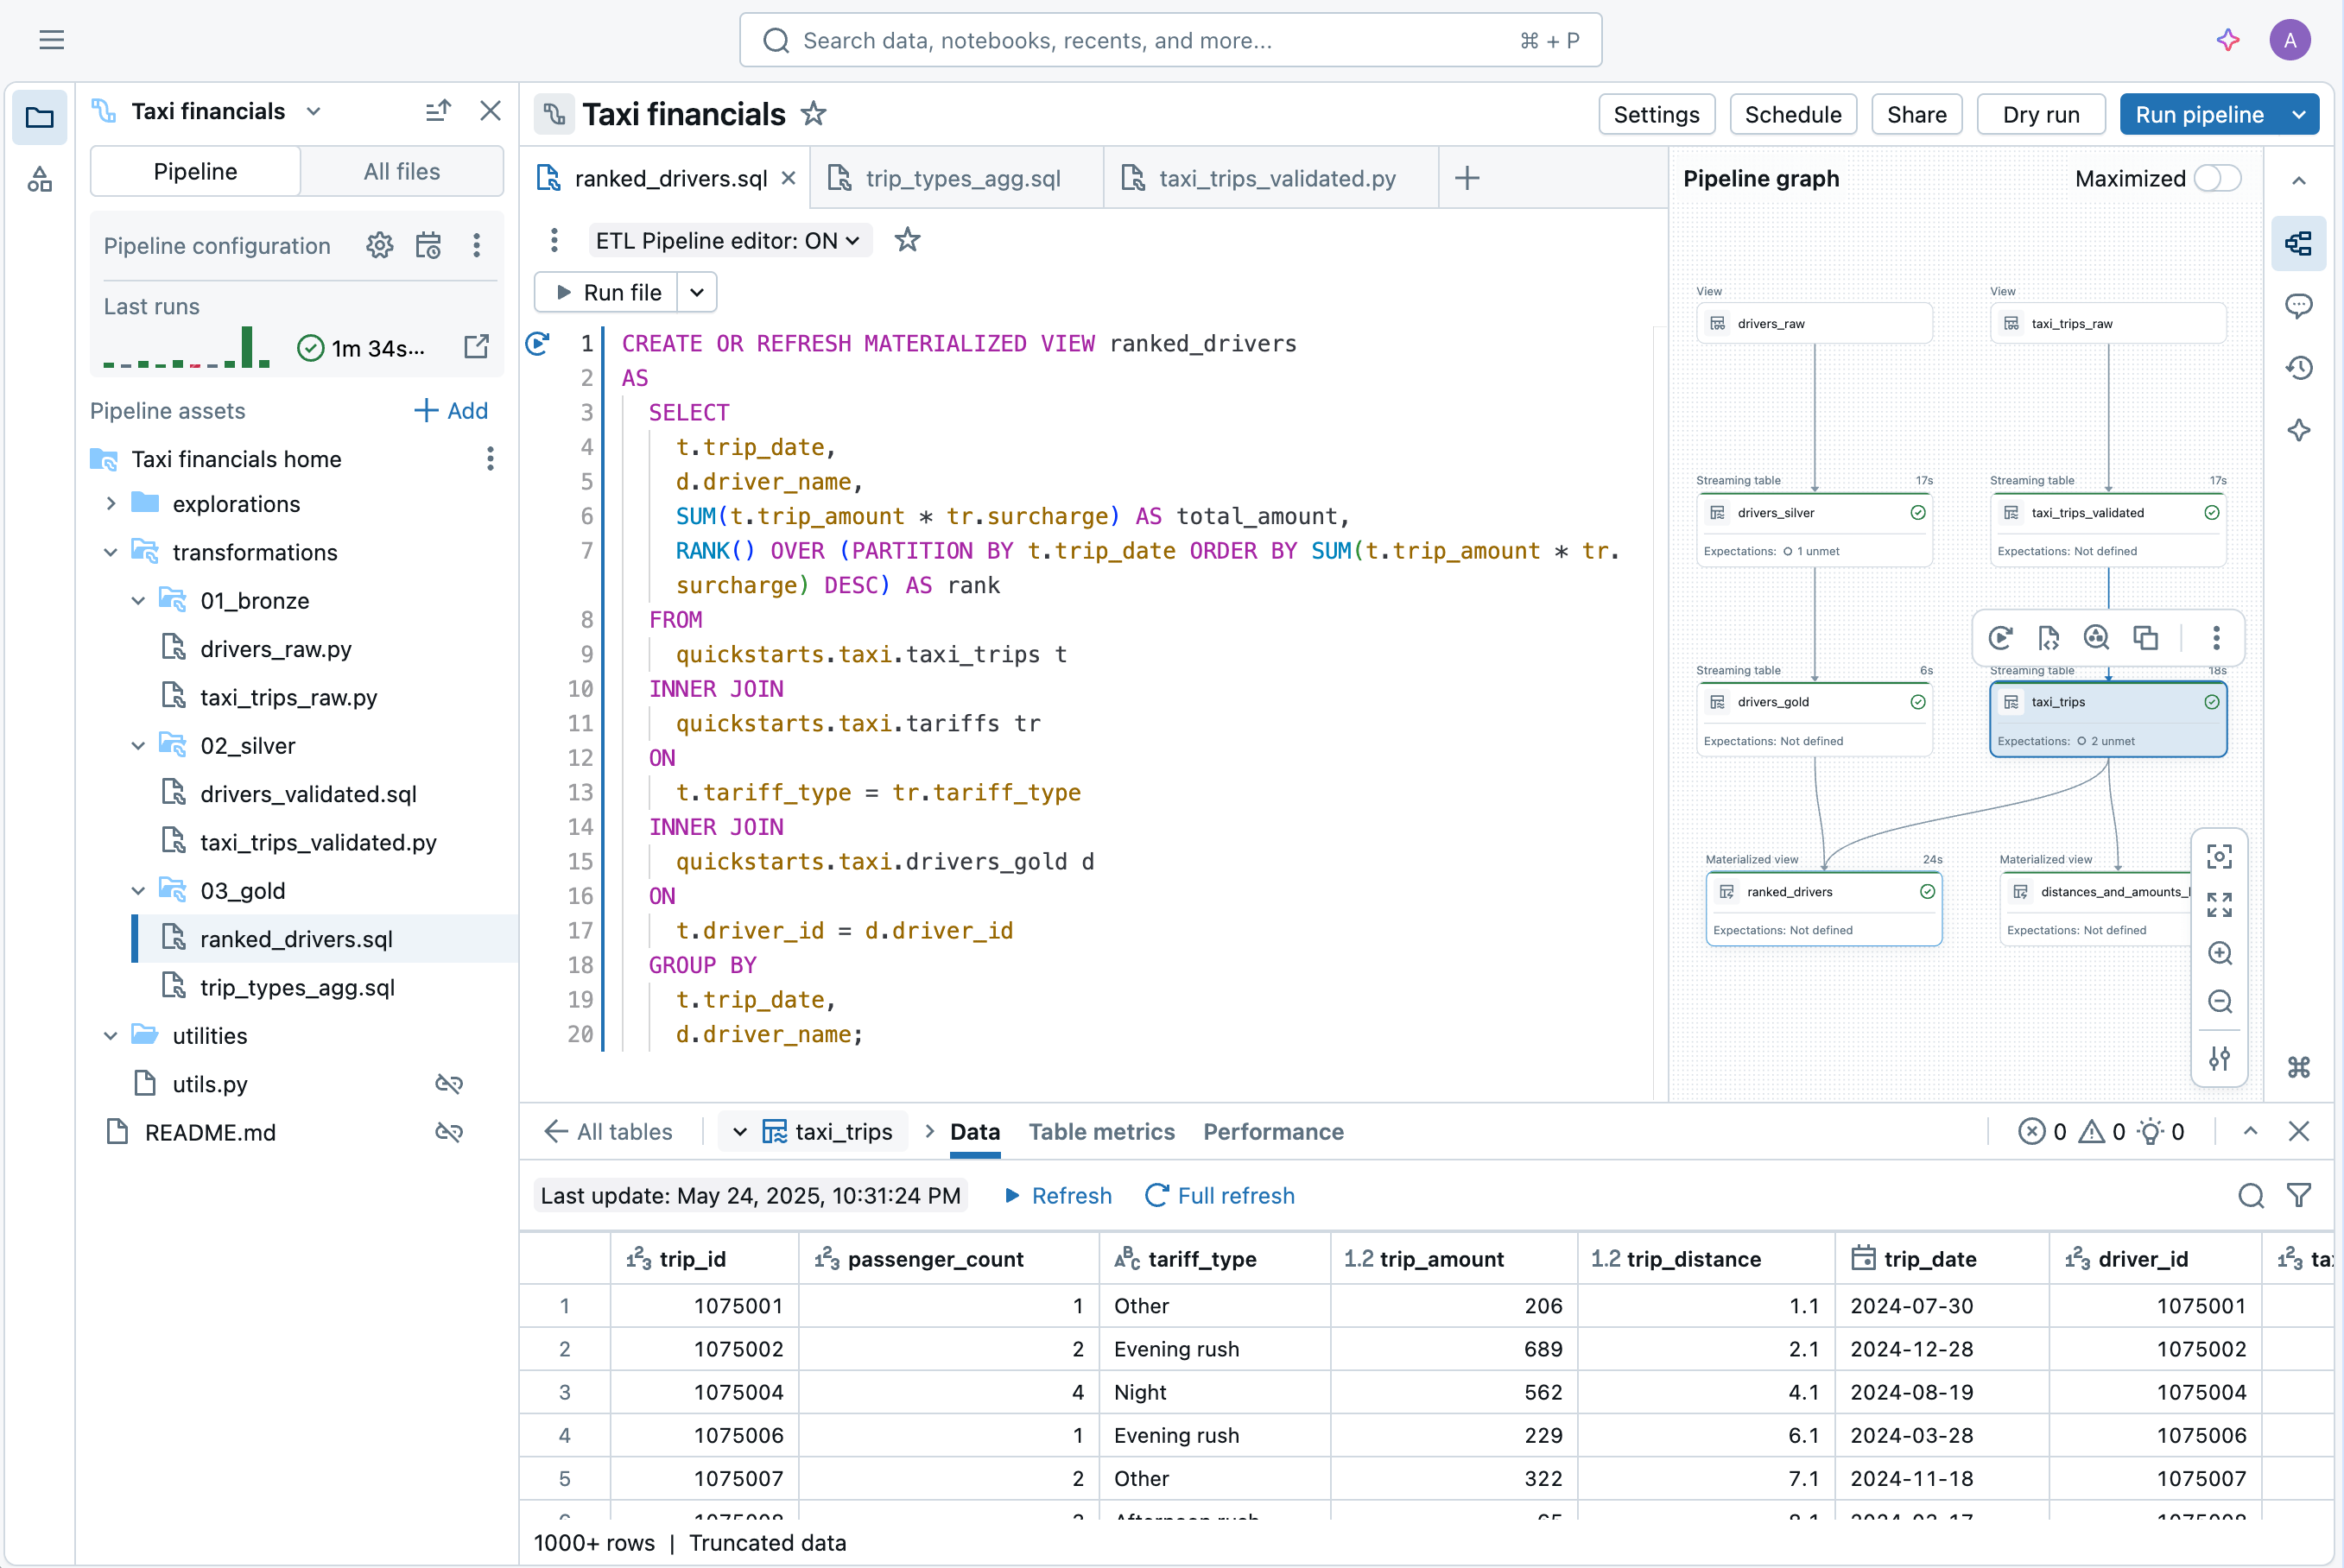
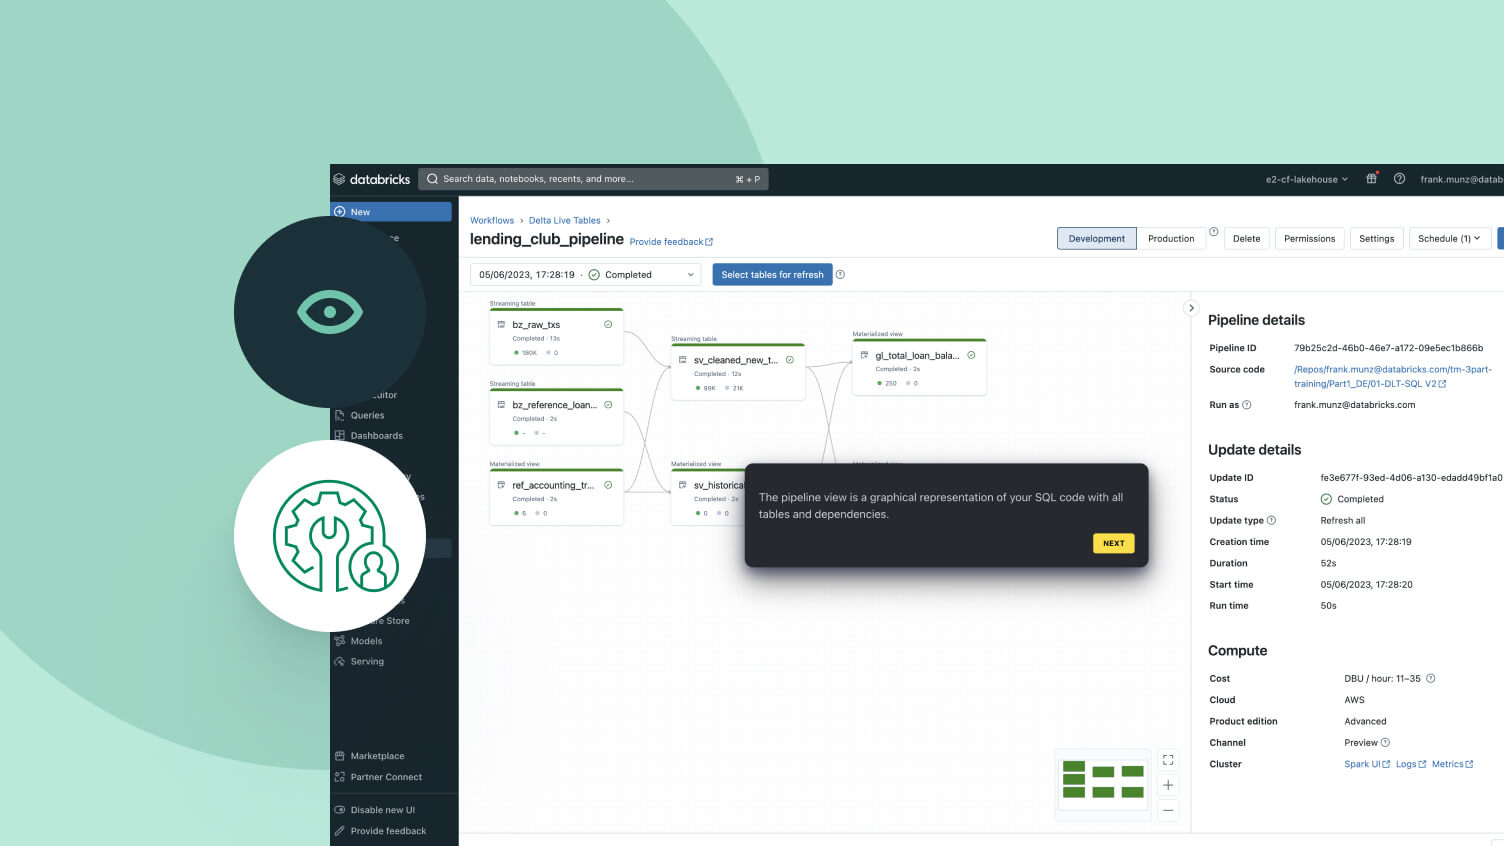
Développez des pipelines dans l'éditeur de pipelines Lakeflow, un IDE natif pour l'ingénierie des données, sans aucun changement de contexte. Visualisez le DAG, l'aperçu des données et les informations d'exécution dans une seule interface utilisateur. Développez facilement du code avec l'autocomplétion, l'affichage intégré des erreurs et les diagnostics.
Autres fonctionnalités
Rationalisez vos pipelines de données

Simplifiez la gestion des sources, des transformations et des destinations simples
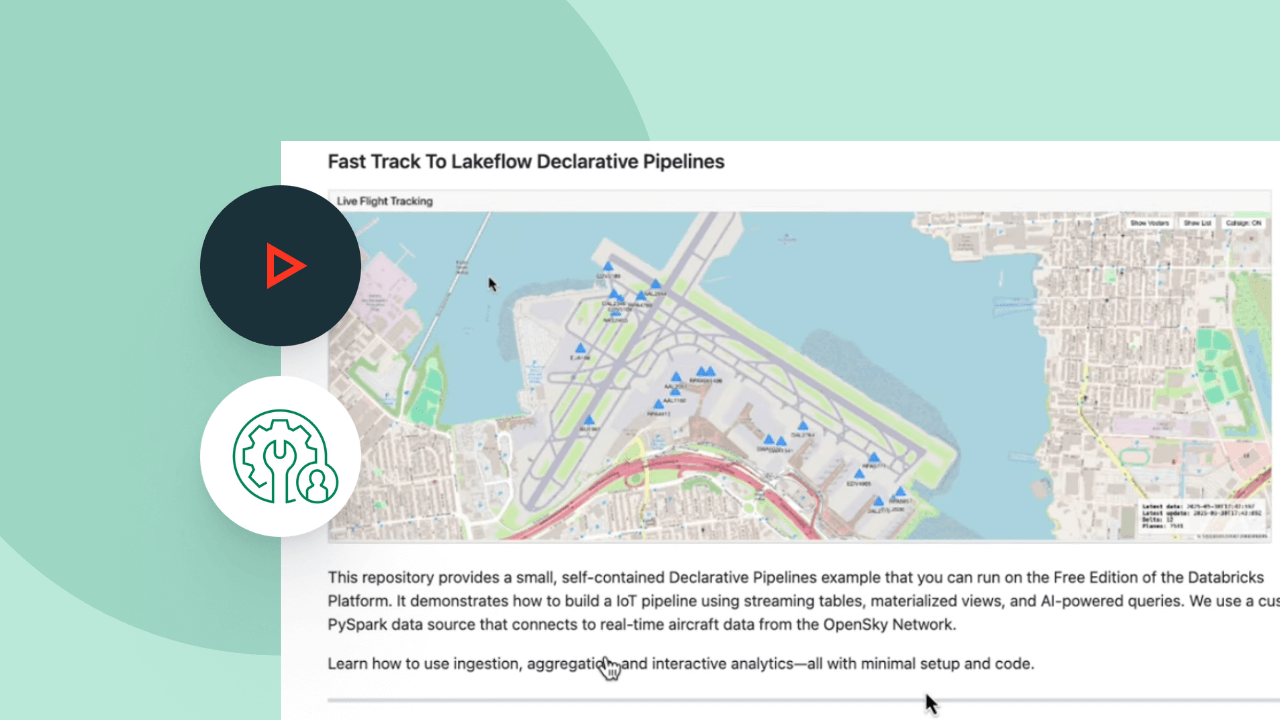
Grâce à la programmation déclarative, vous pouvez exploiter la puissance de l'ETL sur la plateforme Databricks avec seulement quelques lignes d'intention.
Les tarifs basés sur l'utilisation permettent de maîtriser les dépenses
Ne payez que les produits que vous utilisez, à la seconde près.En savoir plus
Explorez d'autres offres intelligentes et intégrées sur la plateforme Datatabricks Data + AI.
Genie Code
Votre partenaire IA autonome pour travailler avec les données.

Lakeflow Connect
Avec des connecteurs d'ingestion de données efficaces pour tous les types de source et une intégration native à la plateforme Databricks Data + AI, les équipes accèdent en toute simplicité à l'analytique et à l'IA avec une gouvernance unifiée.

Tâches Lakeflow
Définissez, gérez et supervisez en toute simplicité des workflows multitâche pour vos pipelines ETL, d'analytique et de machine learning. Il prend en charge un large éventail de types de tâches, permet une observabilité approfondie et affiche une grande fiabilité. Avec ce service, vos équipes sont en mesure de mieux automatiser et orchestrer tout type de pipeline pour gagner en productivité.

Stockage en lakehouse
Unifiez les données du lakehouse, quels que soient leur format et leur type, pour les mettre à disposition de toutes vos charges d'analytique et d'IA.

Unity Catalog
Encadrez sans problème tous vos actifs de données avec la seule solution de gouvernance unifiée et ouverte de l'industrie pour les données et l'IA, intégrée à la plateforme Databricks Data + AI.

Document Intelligence
Analysez, extrayez et classifiez des documents d'entreprise à grande échelle grâce à une gouvernance intégrée pour l'IA agentique.

La plateforme Databricks Data + AI
Découvrez comment la plateforme Databricks Data + AI permet de gérer vos charges de travail de données et d'IA.
Passez à l'étape suivante
Explorez la documentation de Spark Declarative Pipelines
Tout ce dont vous avez besoin pour commencer à utiliser les Spark Declarative Pipelines sur les environnements AWS, Microsoft Azure ou Google Cloud Platform.
Essayez Databricks gratuitement
Commencez un essai gratuit, ou inscrivez-vous simplement pour obtenir la Free Edition.
FAQ sur les Spark Declarative Pipelines
Les Spark Declarative Pipelines (SDP) sont un cadre ouvert qui simplifie l'ingénierie des données par lots et en continu sur Apache Spark. En permettant aux équipes de données et aux agents de codage de déclarer les états de données souhaités au lieu de devoir écrire du code procédural, le SDP résout automatiquement les dépendances, applique les attentes en matière de qualité des données et traite la gestion des états progressifs.
Prêts à devenir une entreprise axée sur les données et l'IA ?
Faites le premier pas de votre transformation