Databricks 시스템 테이블로 데이터 엔지니어의 고급 관찰 기능(Observability)을 지원하는 방법
시스템 테이블은 데이터 엔지니어가 비용 효율적이고 안정적인 워크로드를 위해 대규모 데이터 파이프라인의 상태를 간단하게 추적하는 데 필요한 폭넓고 심층적인 데이터를 제공합니다.
작성자: 테레사 해머
- 시스템 테이블이 Lakeflow 작업 및 파이프라인에 대한 메타데이터와 실행 인사이트를 포함하여 플랫폼 원격 측정 데이터를 쿼리 가능한 테이블로 노출하는 방법을 알아보세요.
- 예제 쿼리를 사용하여 이 원격 측정 데이터를 대규모 Lakeflow 작업의 안정성, 비용 및 효율성 기회에 대한 인사이트로 전환하세요.
- Lakeflow 대시보드 template을 사용하여 데이터 엔지니어링 팀을 위한 공유 일일 운영 뷰로 이러한 인사이트를 중앙 집중화하세요.
새벽 3시 문제
새벽 3시인데 뭔가 고장 났습니다. 대시보드가 최신이 아니고 SLA가 지켜지지 않았으며, 모두가 플랫폼의 어느 부분이 잘못되었는지 추측하고 있습니다. 타임아웃 없이 작업이 몇 시간 동안 실행되었을 수 있습니다. 파이프라인이 몇 달 동안 아무도 읽지 않은 테이블을 업데이트했을 수 있습니다. 클러스터가 여전히 이전 런타임을 사용하고 있을 수 있습니다. 작업 소유자를 아는 유일한 사람이 휴가 중일 수도 있습니다.
사용하지 않는 파이프라인으로 인한 compute 낭비, 상태 규칙 누락으로 인한 안정성 격차, 노후화된 런타임으로 인한 위생 문제, 불분명한 소유권으로 인한 지연 등은 데이터 팀을 지치게 하는 패턴입니다. 이러한 문제는 조용히 나타나 서서히 커지다가 갑자기 온콜 엔지니어를 잠 못 들게 하는 원인이 됩니다.
Databricks 시스템 테이블 은 작업 메타데이터, 작업 타임라인, 실행 동작, 구성 기록, 리니지, 비용 신호, 소유권을 한곳에 노출하여 이러한 문제를 조기에 발견할 수 있는 일관된 레이어를 제공합니다.
새로 출시된 Lakeflow Jobs용 시스템 테이블을 통해 더 풍부한 실행 세부 정보와 메타데이터 신호를 제공하고 더 향상된 관측 가능성을 지원하는 확장된 스키마에 액세스할 수 있습니다.
시스템 테이블을 사용하여 모든 데이터에 대한 더 심층적이고 중앙화된 가시성을 쉽게 확보할 수 있습니다.
시스템 테이블이란?
Databricks 시스템 테이블은 계정에 대한 운영 및 관찰 가능성 데이터를 제공하는 system 카탈로그에 있는 Databricks 관리 읽기 전용 테이블 집합입니다. 기본적으로 제공되며 작업, 파이프라인, 클러스터, 청구, 리니지 등을 포함한 광범위한 데이터를 다룹니다.
범주 | 추적하는 항목 |
Lakeflow Jobs | 작업 구성, 태스크 정의, 실행 타임라인 |
Lakeflow Spark Declarative Pipelines | 파이프라인 메타데이터, 업데이트 기록 |
청구 | 워크로드별 사용량, 비용 귀속 |
계보 | 테이블 수준 읽기/쓰기 종속성 |
클러스터 | 컴퓨팅 구성, 사용률 |
관측성에 시스템 테이블이 중요한 이유
시스템 테이블은 한 리전 내에서 워크스페이스 간 분석을 지원하므로 데이터 엔지니어링 팀이 단일 쿼리 가능 인터페이스에서 대규모로 모든 워크로드 동작 및 운영 패턴을 쉽게 분석할 수 있습니다. 이러한 테이블을 사용하여 데이터 전문가는 모든 파이프라인의 상태를 중앙에서 모니터링하고, 비용 절감 기회를 발견하며, 안정성 향상을 위해 장애를 신속하게 식별할 수 있습니다.
일부 시스템 테이블은 SCD Type 2 시맨틱을 사용하여 각 업데이트에 대해 새 행을 삽입함으로써 전체 변경 기록을 보존합니다. 이를 통해 구성 감사 및 시간에 따른 플랫폼 상태의 기록 분석이 가능합니다.
Lakeflow 시스템 테이블
Lakeflow 시스템 테이블 은(는) 지난 365일간의 데이터를 보관하며 다음과 같은 테이블로 구성됩니다.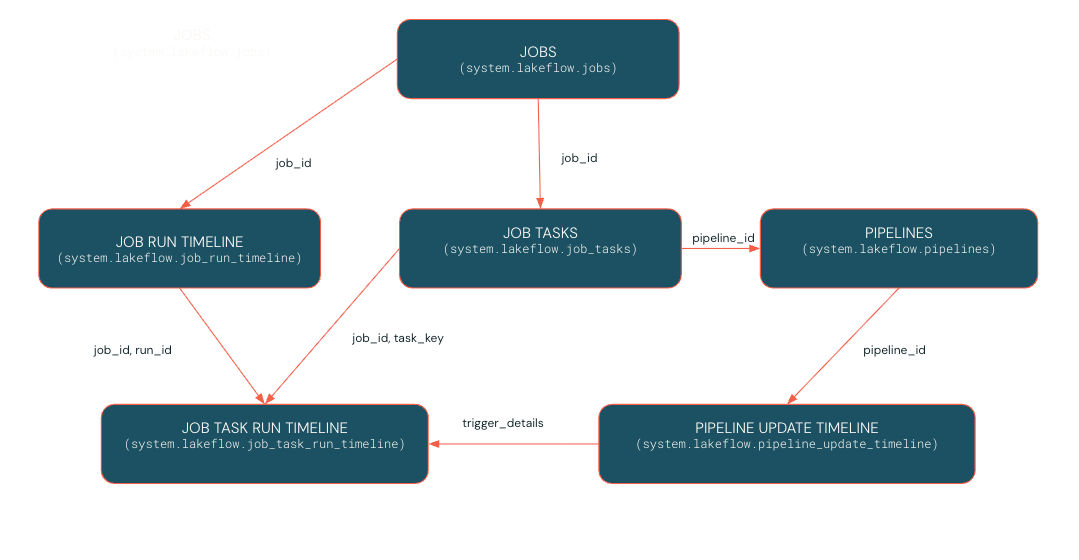
시스템 테이블의 전체 목록과 그 관계에 대해서는 설명서를 참조하세요.
작업 관찰 가능성 테이블(일반 공급)
system.lakeflow.jobs– 구성 및 태그를 포함하여 작업에 대한 SCD2 메타데이터입니다. 인벤토리, 거버넌스, 구성 드리프트 분석에 유용합니다.system.lakeflow.job_tasks– 모든 작업 태스크, 해당 정의 및 종속성을 설명하는 SCD2 테이블입니다. 대규모 태스크 구조를 이해하는 데 유용합니다.system.lakeflow.job_run_timeline– 상태, 컴퓨팅, 타이밍이 포함된 작업 실행의 불변 타임라인입니다. SLA 및 성능 추세 분석에 이상적입니다.system.lakeflow.job_task_run_timeline– 각 작업 내 개별 태스크 실행 타임라인입니다. 병목 현상과 태스크 수준의 문제를 정확히 파악하는 데 도움이 됩니다.
파이프라인 관찰 가능성 테이블(공개 미리보기)
system.lakeflow.pipelines– 작업 공간 간 파이프라인 가시성 및 변경 추적을 지원하는 SDP 파이프라인용 SCD2 메타데이터 테이블입니다.system.lakeflow.pipeline_update_timeline– 파이프라인 업데이트를 위한 변경 불가능한 실행 로그이며, 기록 디버깅 및 최적화를 지원합니다.
Lakeflow 시스템 테이블은 매일 수천만 개의 쿼리가 실행되면서 인기가 급성장했으며, 이는 전년 대비 17배 증가한 수치입니다. 이러한 급증은 많은 Databricks Lakeflow 고객에게 일상적인 관찰 가능성의 중요한 구성 요소가 된 Lakeflow 시스템 테이블에서 데이터 엔지니어가 얻는 가치를 강조합니다.
최근에 확장되어 이제 정식으로 사용 가능한 작업 시스템 테이블(Jobs System Tables)을 통해 가능해진 사용 사례를 살펴보겠습니다.
시스템 테이블 실제 활용: Lakeflow 작업의 운영 상태
중앙 플랫폼 팀의 데이터 엔지니어는 여러 팀의 수많은 작업을 관리해야 합니다. 목표는 데이터 플랫폼의 비용 효율성, 안정성, 성능을 유지하면서 팀이 거버넌스 및 운영 모범 사례를 따르도록 하는 것입니다.
이를 위해 네 가지 핵심 목표에 걸쳐 Lakeflow 작업 및 파이프라인을 감사하기 시작합니다.
- 비용 최적화: 다운스트림에서 전혀 사용되지 않는 데이터세트를 업데이트하는 예약된 작업을 식별합니다.
- 안정성 보장: 시간 초과 및 런타임 임계값을 적용하여 과도한 작업 및 SLA 위반을 방지합니다.
- 체계적인 관리: 일관된 런타임 버전 및 구성 표준을 확인합니다.
- 책임 할당: 작업 소유자를 식별하여 후속 조치 및 해결을 간소화합니다.
패턴 1: 사용되지 않는 데이터를 생성하는 작업 찾기
문제점: 예약된 작업은 충실하게 실행되어 테이블을 업데이트하지만 다운스트림 소비자는 아무도 읽지 않습니다. 이러한 부분을 찾아낼 수만 있다면 가장 쉽게 비용을 절감할 수 있는 경우가 많습니다.
접근 방식: Lakeflow Jobs 테이블을 계보 및 청구 테이블과 조인하여 소비자가 없는 생산자를 비용 순으로 식별합니다.
다음 단계: 상위 문제 항목을 소유자와 함께 검토합니다. 일부는 즉시 일시 중지해도 안전할 수 있습니다. Databricks 외부의 외부 시스템에서 사용하는 경우 다른 항목에 대해서는 지원 중단 계획이 필요할 수 있습니다.
패턴 2: 시간 초과 또는 기간 임계값이 없는 작업 찾기
문제점: 시간 제한이 없는 작업은 무기한 실행될 수 있습니다. 중단된 작업은 아무도 알아차리지 못하는 사이에 몇 시간 또는 며칠 동안 compute를 소모합니다. 이는 비용 증가 외에도 SLA 위반을 유발할 수 있으므로, 마감일이나 다운스트림 프로세스에 영향을 미치기 전에 초과 실행을 조기에 발견하고 조치를 취해야 합니다.
접근 방식: 누락된 시간 초과 및 기간 임계값 설정을 위해 현재 작업 구성을 쿼리합니다.
다음 단계: job_run_timeline의 과거 런타임과 상호 참조하여 현실적인 임계값을 설정합니다. 일반적으로 20분 실행되는 작업에는 1시간의 시간 초과와 30분의 기간 임계값이 필요할 수 있습니다. 편차가 큰 작업은 먼저 조사가 필요할 수 있습니다.
패턴 3: 레거시 런타임 버전 감지
문제점: 더 이상 사용되지 않는 런타임은 보안 패치, 성능 개선이 누락되고 곧 지원이 종료될 예정입니다. 하지만 수백 개의 작업이 있는 상황에서 누가 아직도 이전 버전을 사용하고 있는지 추적하기는 번거롭습니다.
접근 방식: 작업 태스크 구성에서 런타임 버전을 쿼리하고 임계값 미만인 항목에 플래그를 지정합니다.
다음 단계: EOL 타임라인에 따라 업그레이드 우선순위를 정합니다. 이 목록을 작업 소유자와 공유하고 후속 쿼리에서 진행 상황을 추적합니다.
패턴 4: 문제 해결을 위한 작업 소유자 식별
문제점: 작업이 실패하거나 올바르게 구성되지 않은 경우 문제를 해결하기 위해 누구에게 연락해야 하는지 알아야 합니다.
접근 방식: 시스템 테이블을 쿼리하여 취해야 할 각 조치에 대한 작업 소유자를 쉽게 식별합니다.
다음 단계: 조치가 필요한 문제에 대한 소유권을 할당하도록 작업 소유자에게 연락하세요.
이러한 패턴들을 함께 사용하면 비용을 최적화하고, 데이터를 최신 상태로 유지하며, 안정성 가드레일을 적용하고, 문제 해결을 위한 명확한 소유권을 할당하는 데 도움이 됩니다. 이것들은 운영 관측성의 기반을 형성합니다.
종합: 대시보드를 사용하여 인사이트 운영하기
이러한 쿼리를 애드혹으로 실행하는 것은 유용합니다. 하지만 일상적인 운영을 위해서는 전체 팀이 참조할 수 있는 공유 뷰가 필요합니다.
Lakeflow 대시보드는 단순히 비용 수준뿐만 아니라 파이프라인 상태 및 운영에 대해서도 모든 작업 공간의 작업을 전체적으로 파악할 수 있는 뷰를 제공합니다. 지출을 추적하고, 오래된 파이프라인을 식별하며, 장애를 모니터링하고, 최적화 기회를 발견할 수 있죠. - Zoe Van Noppen, Data Solution Architect, Cubigo
시작하려면 대시보드를 작업 공간으로 가져오세요. 단계별 지침은 공식 설명서를 참조하세요.
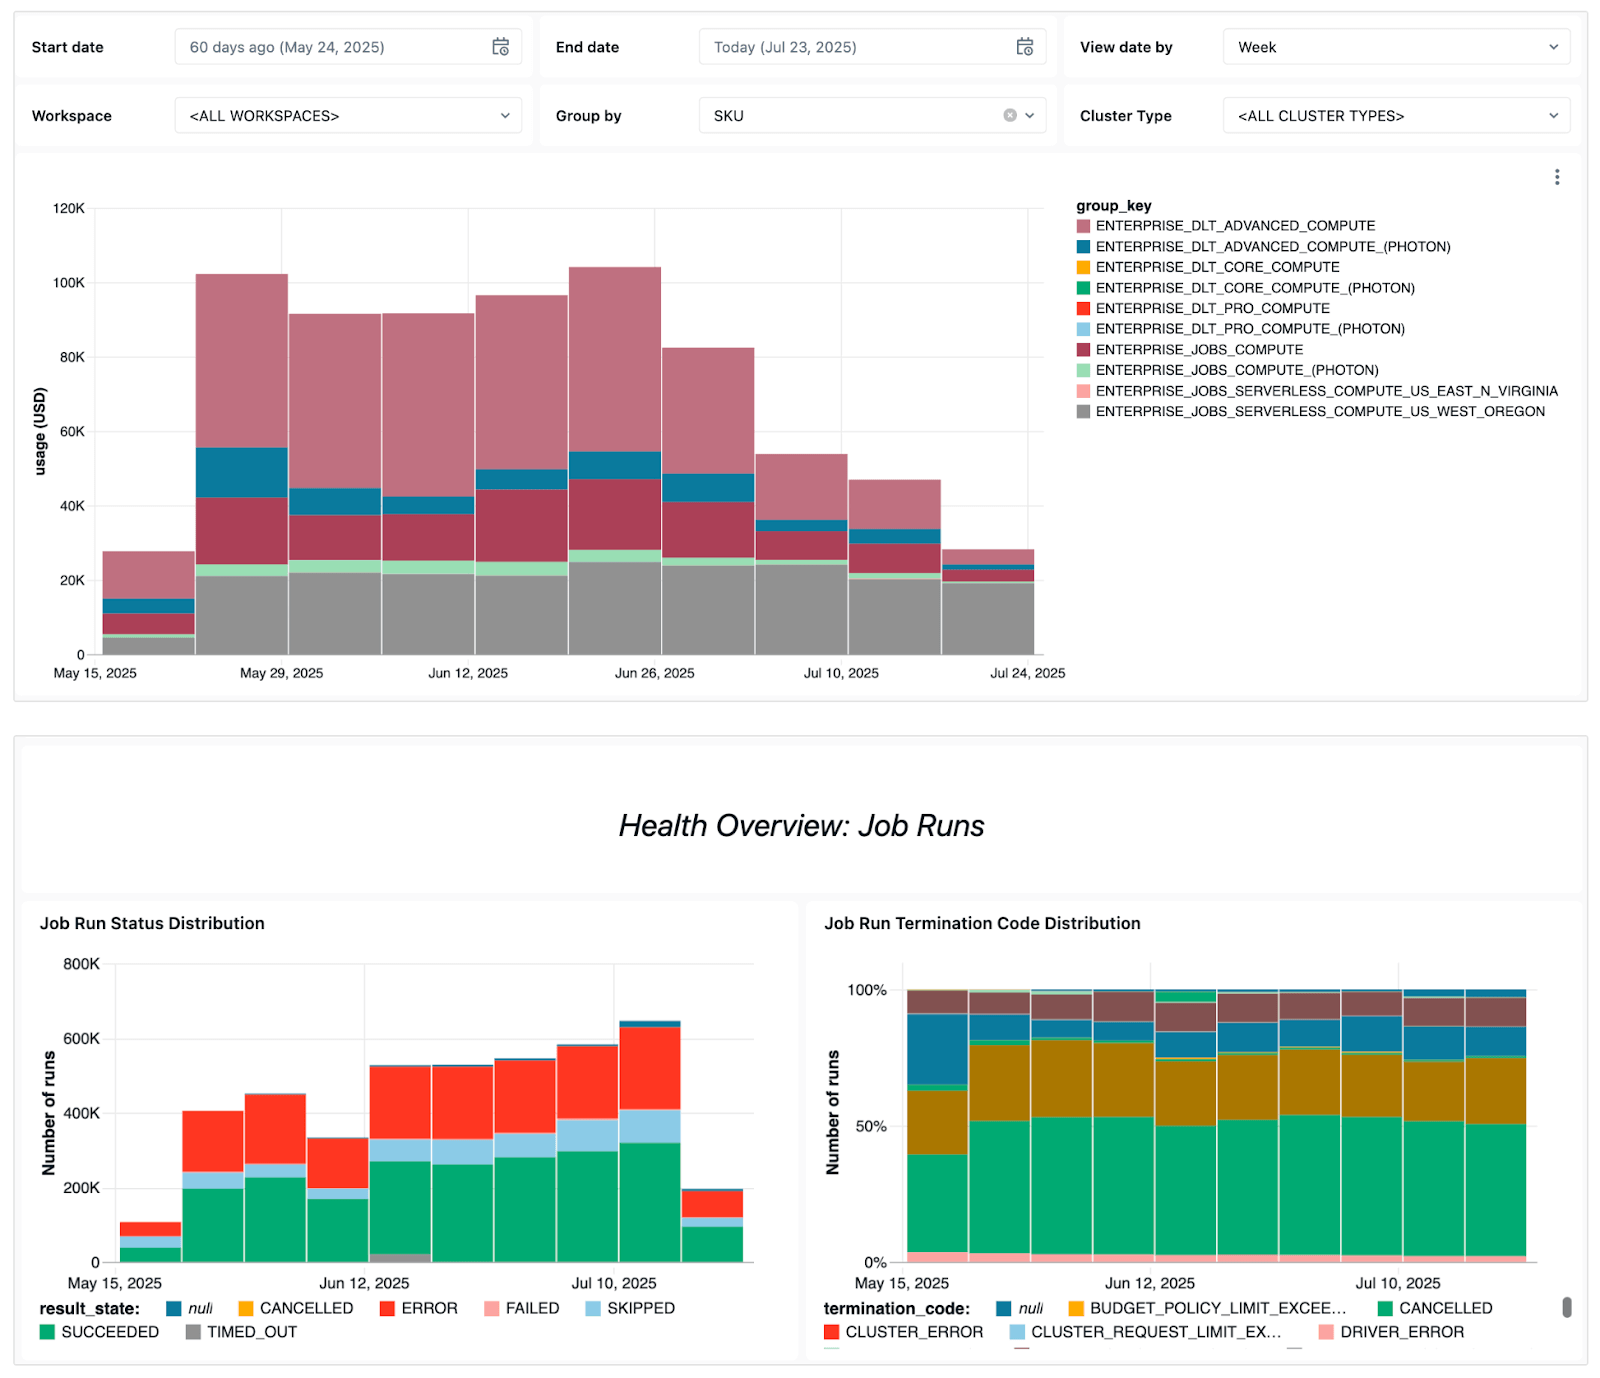
대시보드는 다음을 포함한 몇 가지 주요 운영 신호를 표시합니다.
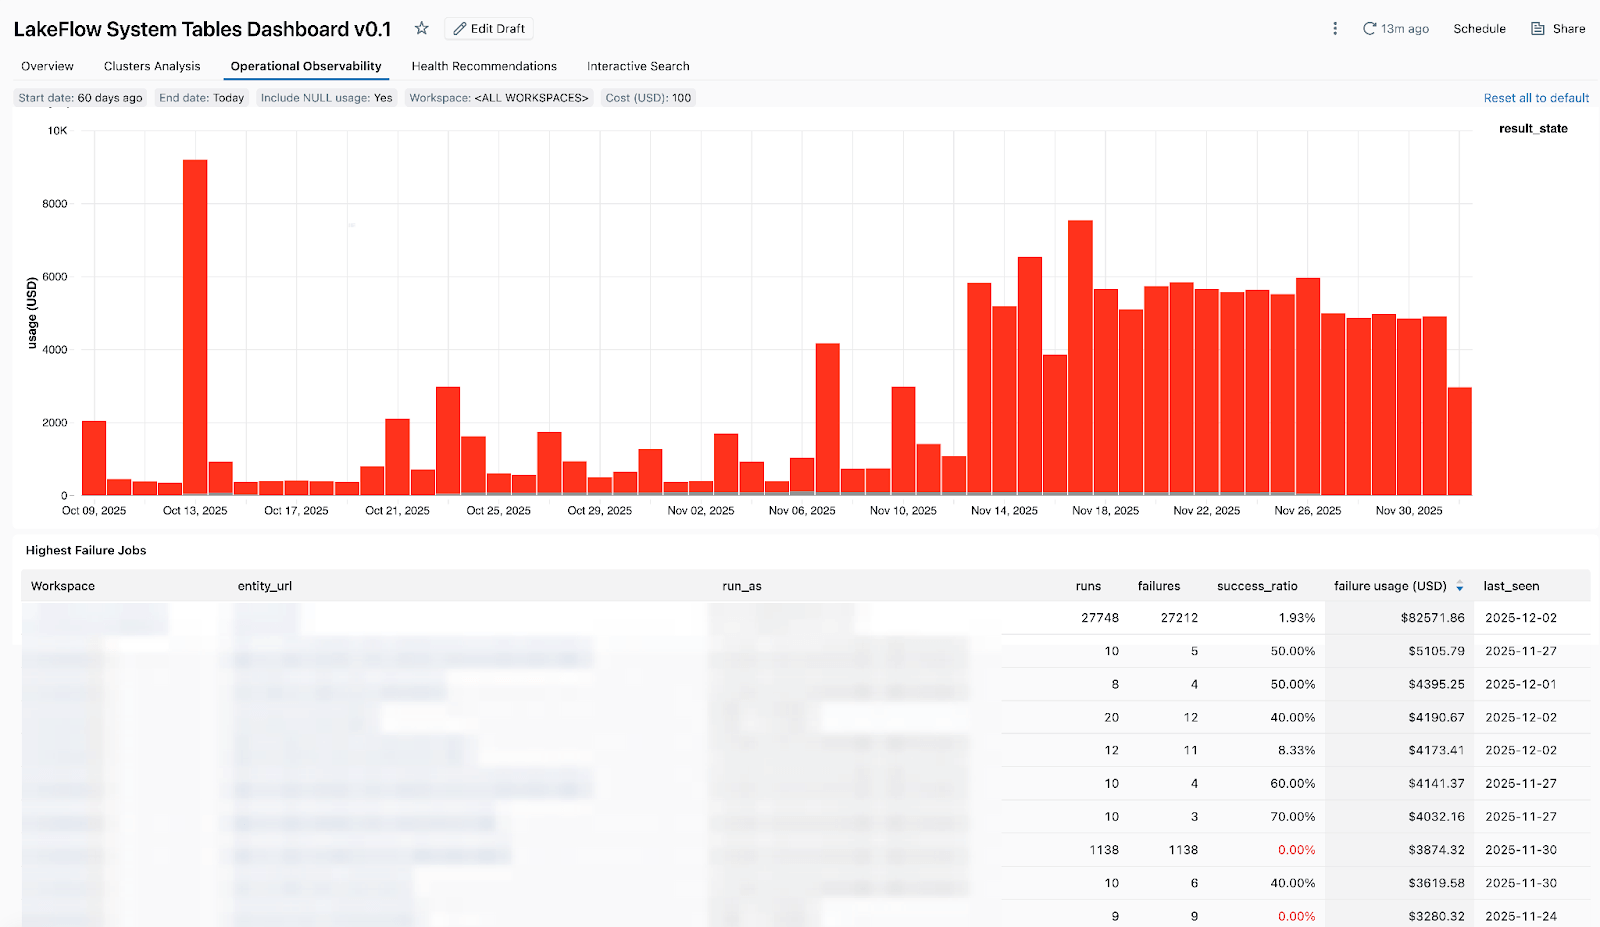
- 실패 추세 - 가장 자주 실패하는 작업, 전체적인 오류 추세 및 일반적인 오류 메시지를 확인할 수 있습니다.
- 고비용 작업 - 지난 30일 동안 또는 시간 경과에 따라 가장 비용이 많이 드는 작업과 개별 작업 실행을 식별할 수 있습니다. 아래 표는 선택한 기간 동안 비용이 가장 높은 작업 순으로 정렬되어 있으며 시간 경과에 따른 비용 추세를 보여줍니다.
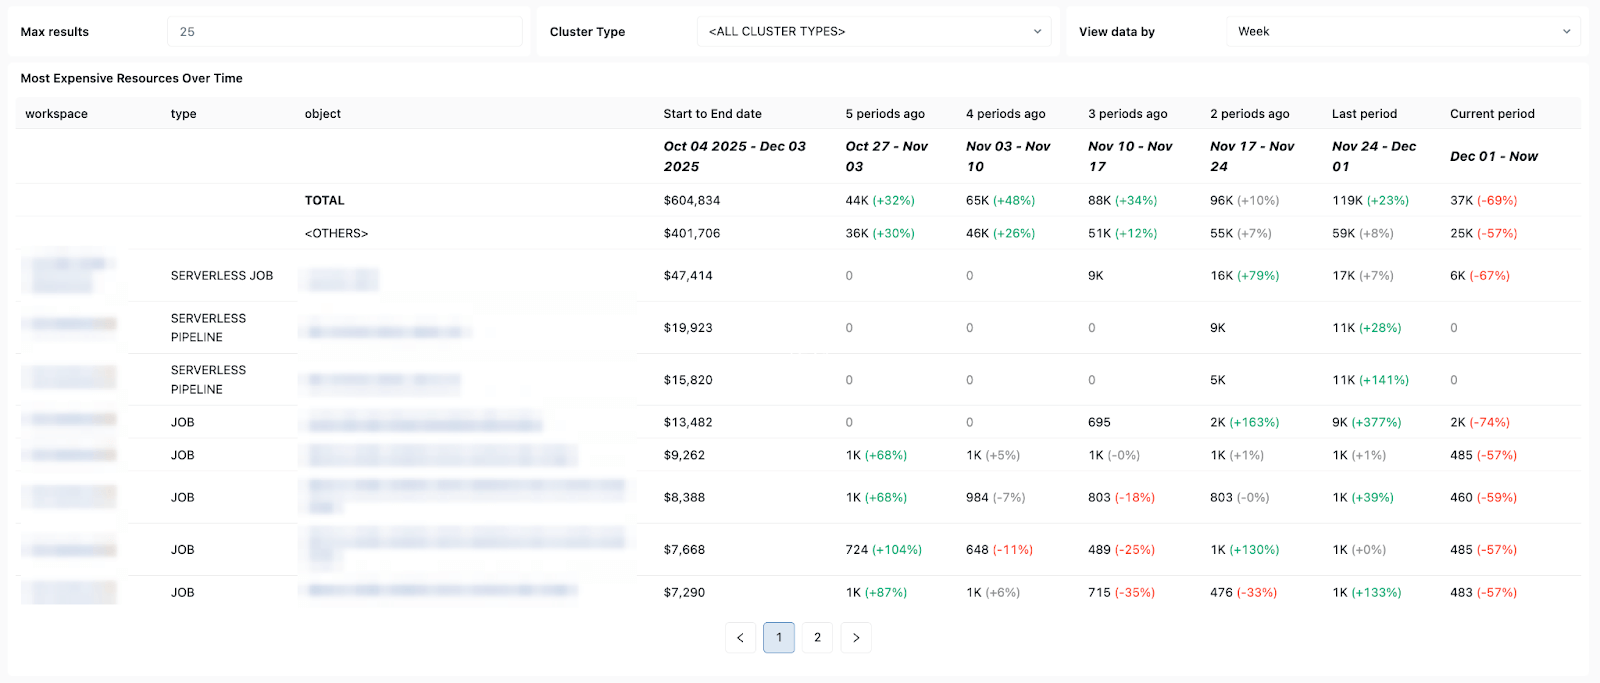
비용 및 재시도 패턴 - 비용 추세를 추적하고 재시도 또는 복구 실행이 총 지출에 미치는 영향을 파악하도록 도와줍니다.
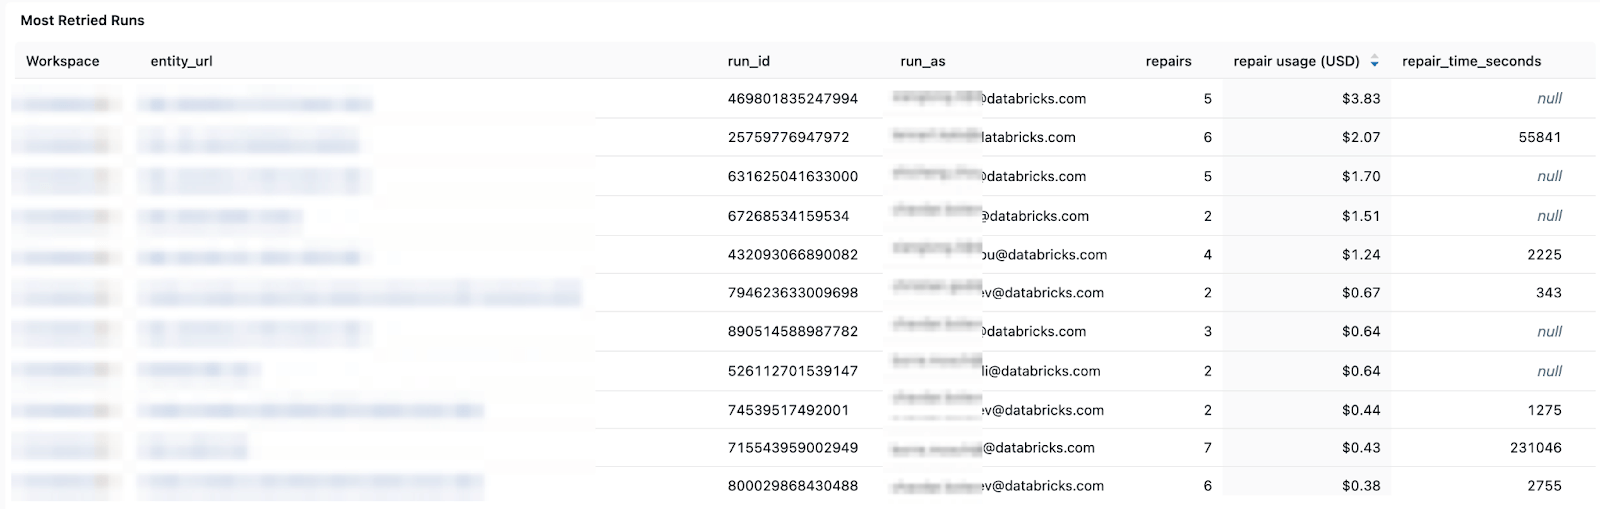
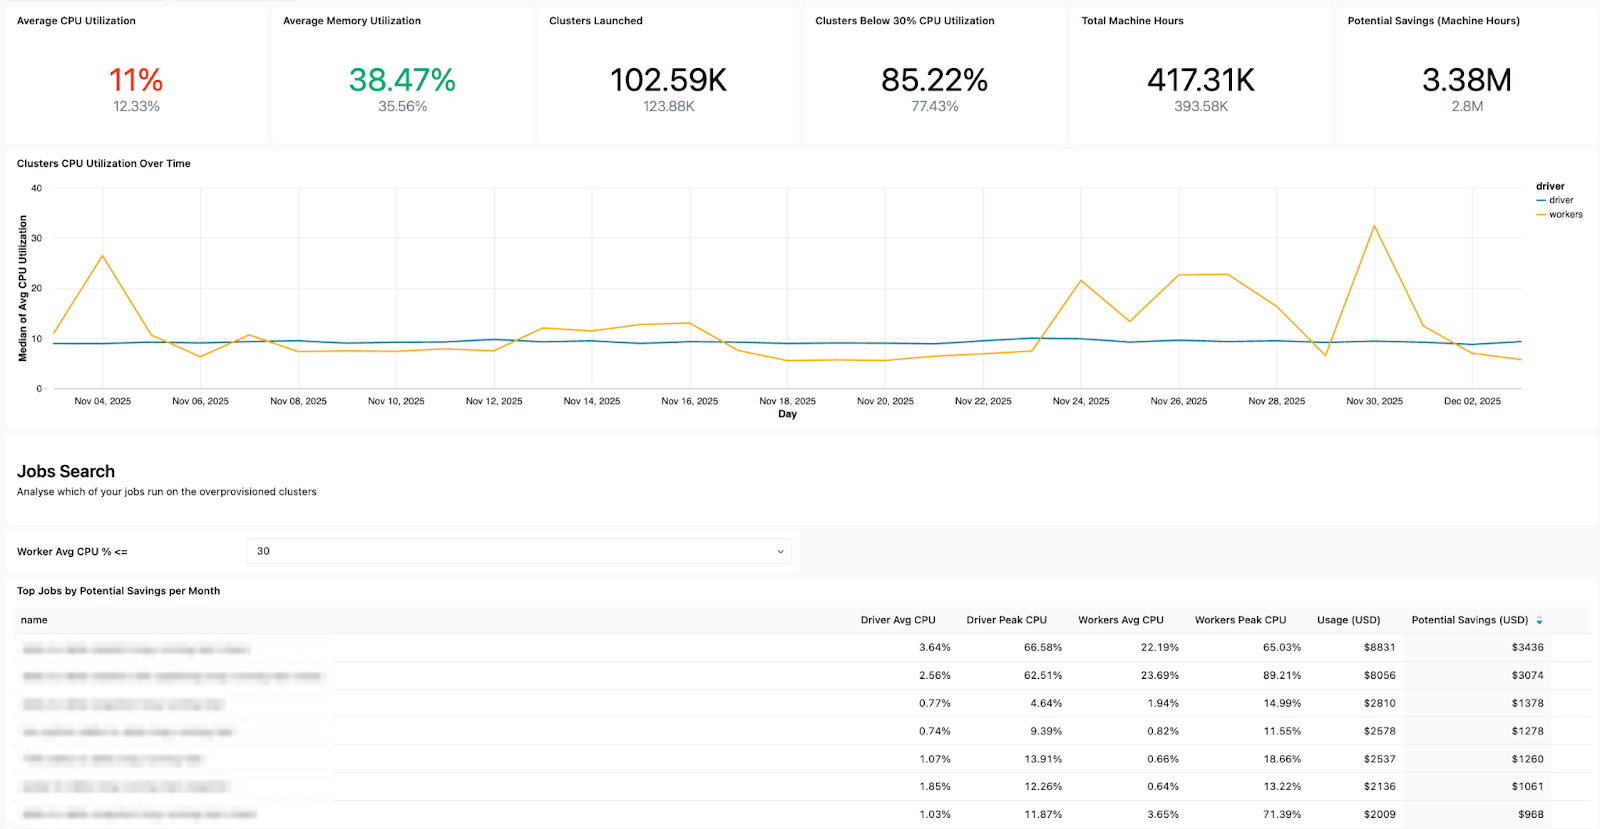
- 구성 인사이트 - 운영 상태를 위해 클러스터 효율성, 상태 규칙, 시간 초과 및 런타임 버전을 확인할 수 있습니다.
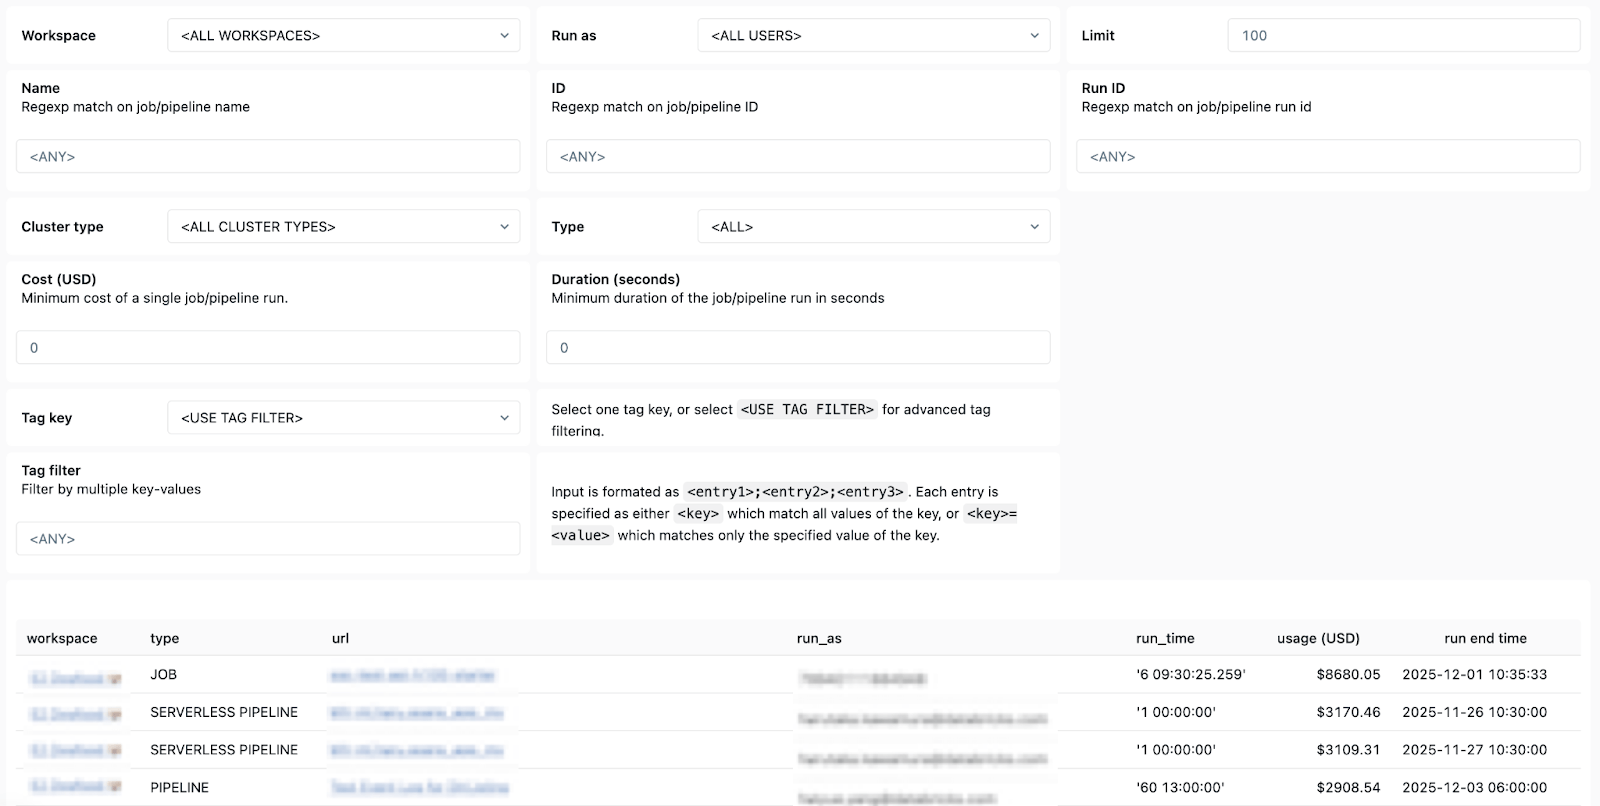
- 소유권 세부 정보 - "run-as" 사용자와 작업 생성자를 쉽게 찾아 누구에게 연락해야 하는지 알 수 있습니다.
요약하자면, Databricks 시스템 테이블을 사용하면 여러 워크스페이스에서 대규모로 Lakeflow 작업을 효율적으로 모니터링, 감사, 문제 해결할 수 있습니다. 대시보드 template에서 제공되는 명확하고 간단하며 액세스하기 쉬운 작업 및 파이프라인 시각화를 통해 Lakeflow를 사용하는 모든 데이터 엔지니어는 고급 관찰 가능성을 달성하고 프로덕션에 즉시 사용할 수 있으며 비용 효율적이고 안정적인 파이프라인을 일관되게 보장할 수 있습니다.
시스템 테이블은 플랫폼 원격 분석 데이터를 쿼리 가능한 자산으로 전환합니다. 5개의 서로 다른 도구에서 신호를 짜깁기하는 대신 통합된 스키마에 대해 SQL을 작성하고 몇 초 만에 답을 얻을 수 있습니다.
새벽 3시의 당신이 고마워할 거예요.
시스템 테이블에 대해 자세히 알아보려면 다음 리소스를 확인하세요.
Databricks를 처음 사용하시나요? 지금 Databricks를 무료로 사용해 보세요!
(이 글은 AI의 도움을 받아 번역되었습니다. 원문이 궁금하시다면 여기를 클릭해 주세요)
최신 게시물을 이메일로 받아보세요
블로그를 구독하고 최신 게시물을 이메일로 받아보세요.