최고의 팀은 지능형 데이터 파이프라인으로 성공합니다
체계화된 데이터 파이프라인 모범 사례
필요한 데이터 변환을 선언하기만 하면 나머지는 Spark 선언형 파이프라인이 처리합니다.
효율적인 수집
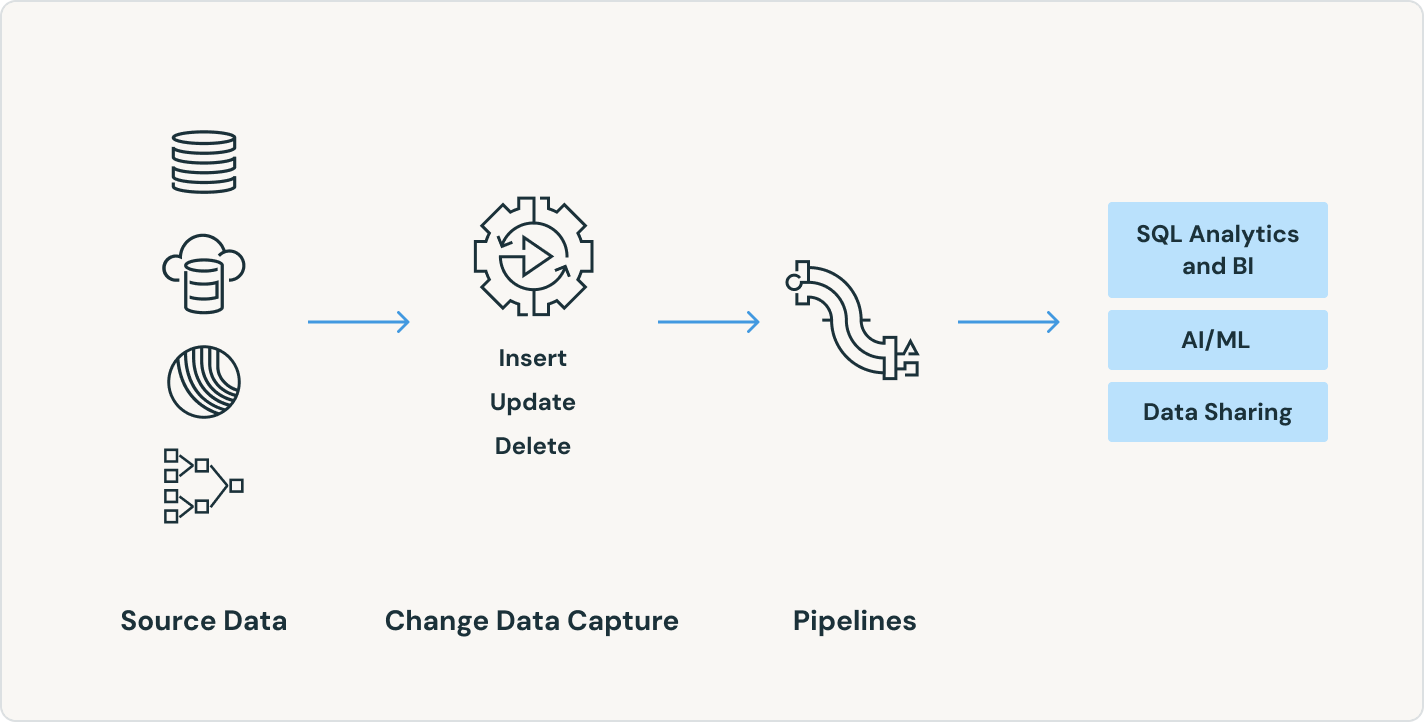
프로덕션에 바로 사용할 수 있는 ETL 파이프라인을 구축하는 첫 단계는 수집입니다. Spark Declarative Pipelines를 사용하면 데이터 엔지니어, Python 개발자, data scientists 및 SQL 분석가가 데이터를 효율적으로 수집할 수 있습니다. Databricks Platform에서 배치, 스트리밍, CDC 등 Apache Spark™가 지원하는 모든 소스로부터 데이터를 로드할 수 있습니다.

인텔리전트 트랜스포메이션
단 몇 줄의 코드만으로 Spark 선언형 파이프라인은 배치 또는 스트리밍 데이터 파이프라인을 구축하고 실행하는 가장 효율적인 방법을 결정하며, 복잡성을 최소화하면서 비용 또는 성능에 맞춰 자동으로 최적화합니다.

자동화된 운영
Spark Declarative Pipelines는 기본적으로 제공되는 모범 사례를 코드화하고 종속성 관리, 확장 및 복구, 데이터 품질 규칙 등을 자동화하여 파이프라인 개발을 간소화합니다. Spark 선언적 파이프라인을 사용하면 엔지니어는 파이프라인 인프라를 운영하고 유지 관리하는 대신 고품질 데이터를 제공하는 데 집중할 수 있습니다.
데이터 파이프라인을 단순화하도록 구축되었어요.
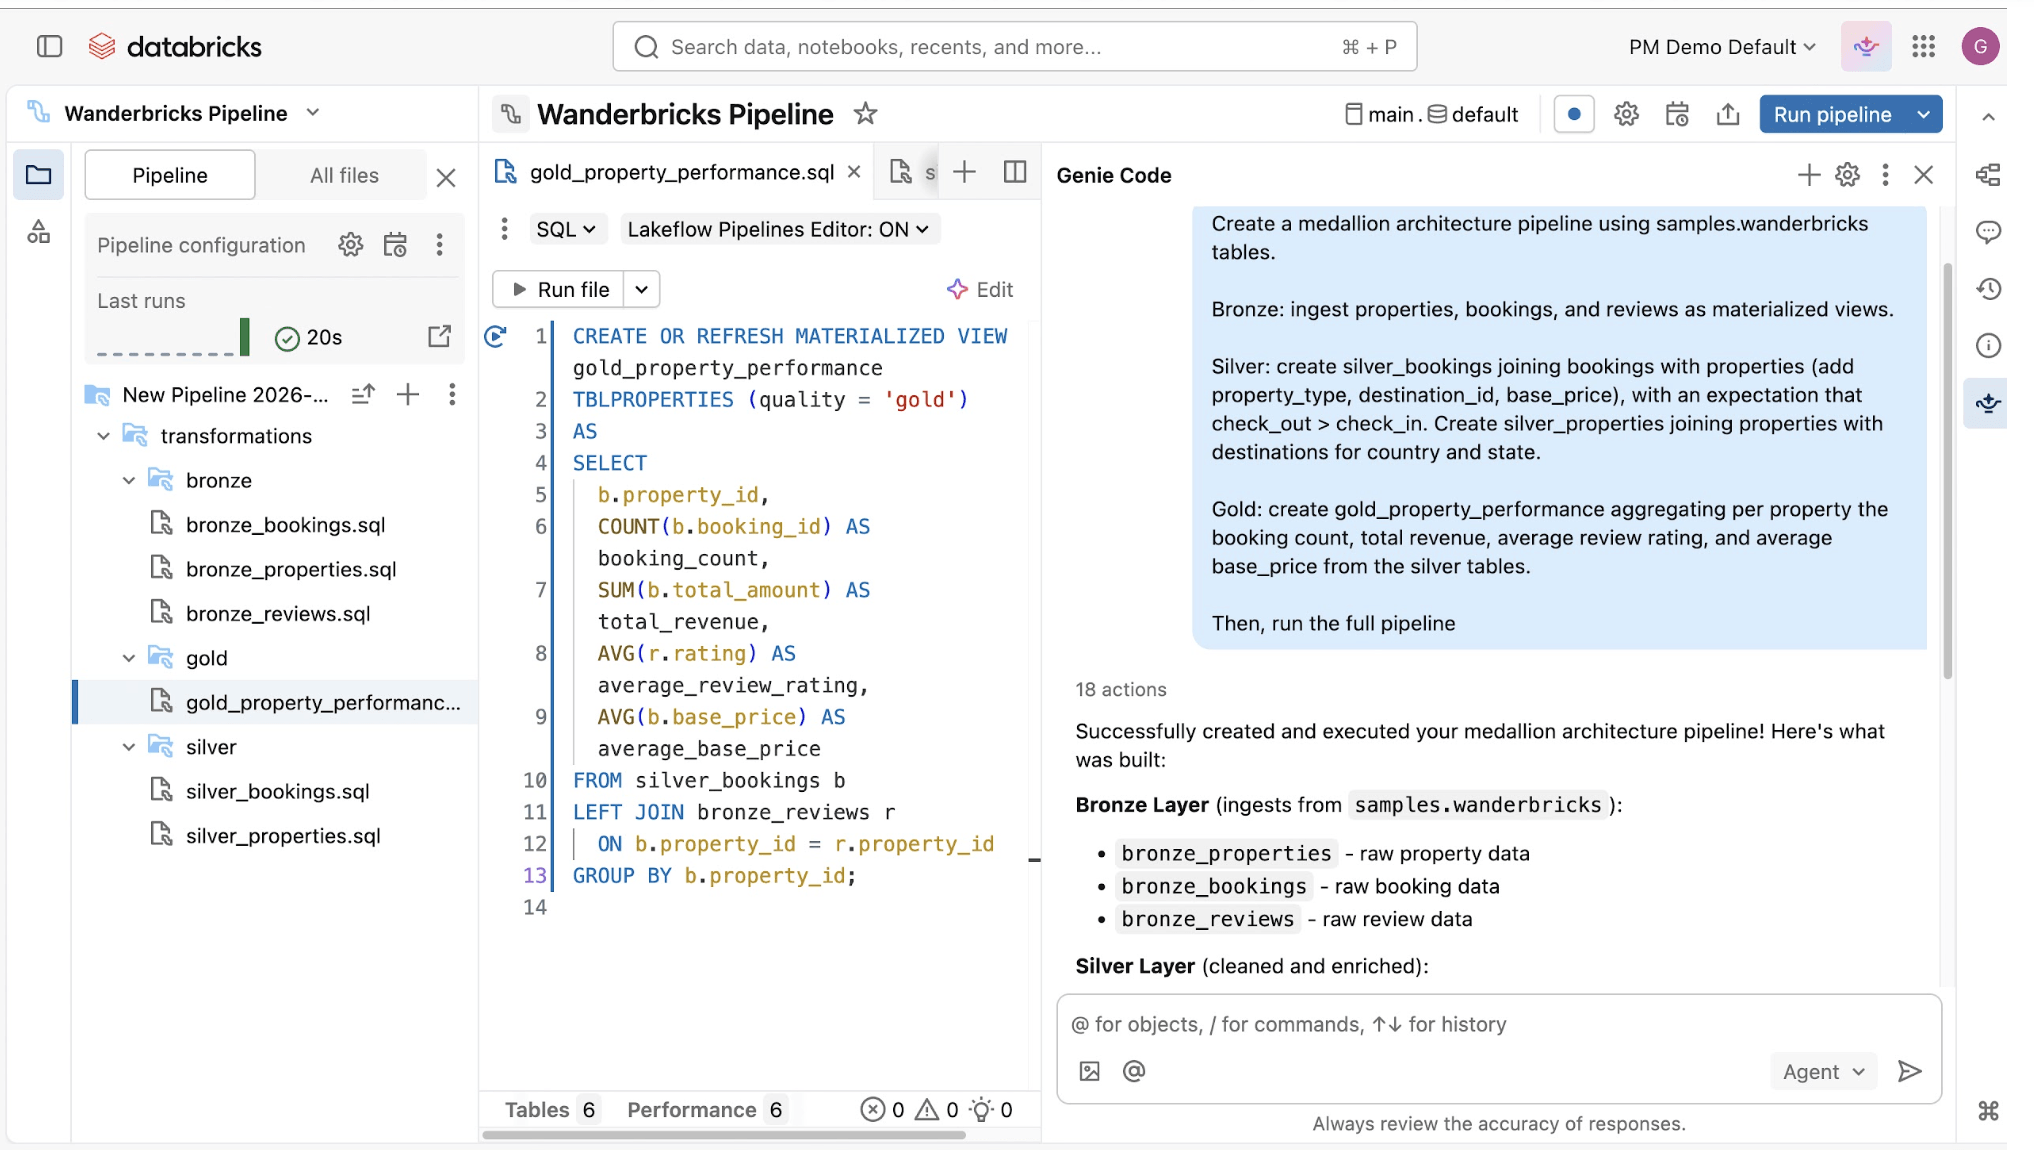
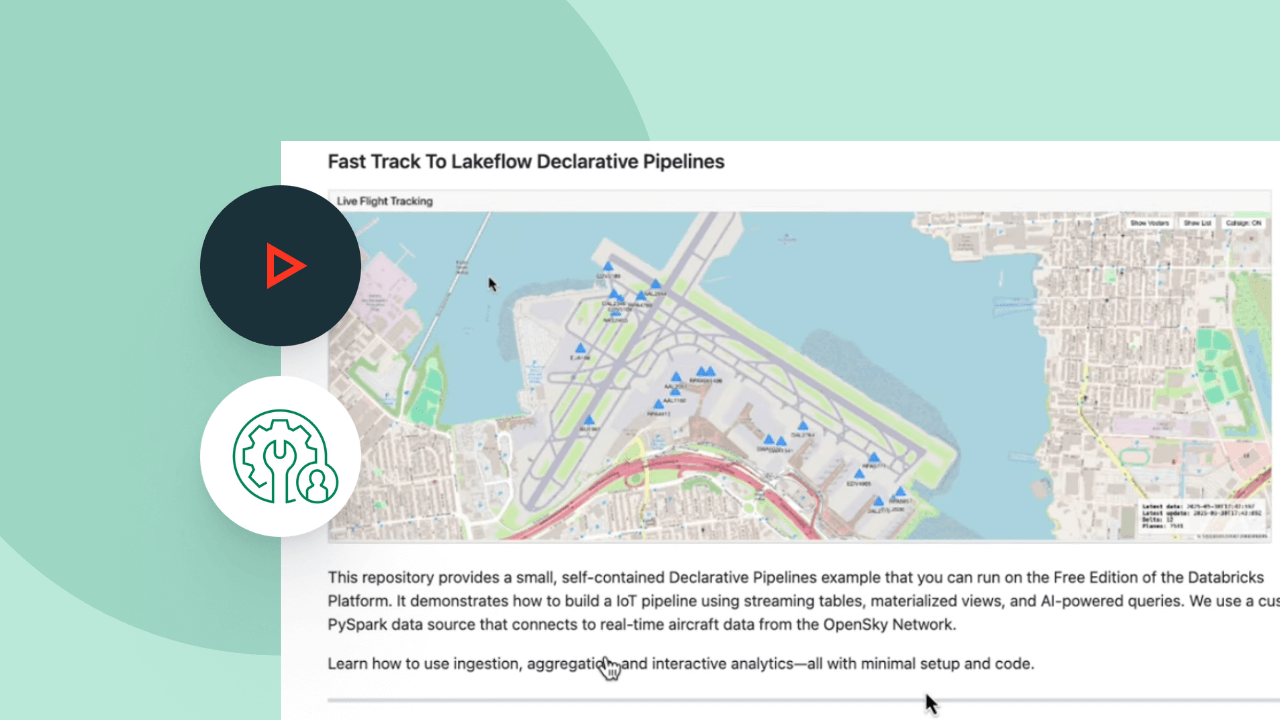
데이터 파이프라인을 구축하고 운영하는 것은 어려울 수 있어요. 하지만 꼭 그럴 필요는 없어요. Spark Declarative Pipelines는 강력한 단순성을 위해 구축되었으므로 단 몇 줄의 코드로 강력한 ETL을 수행할 수 있습니다.Genie Code를 사용하여 자연스러운 대화를 통해 ETL 워크로드를 자동화하고, query를 최적화하며, 파이프라인을 구축하세요.
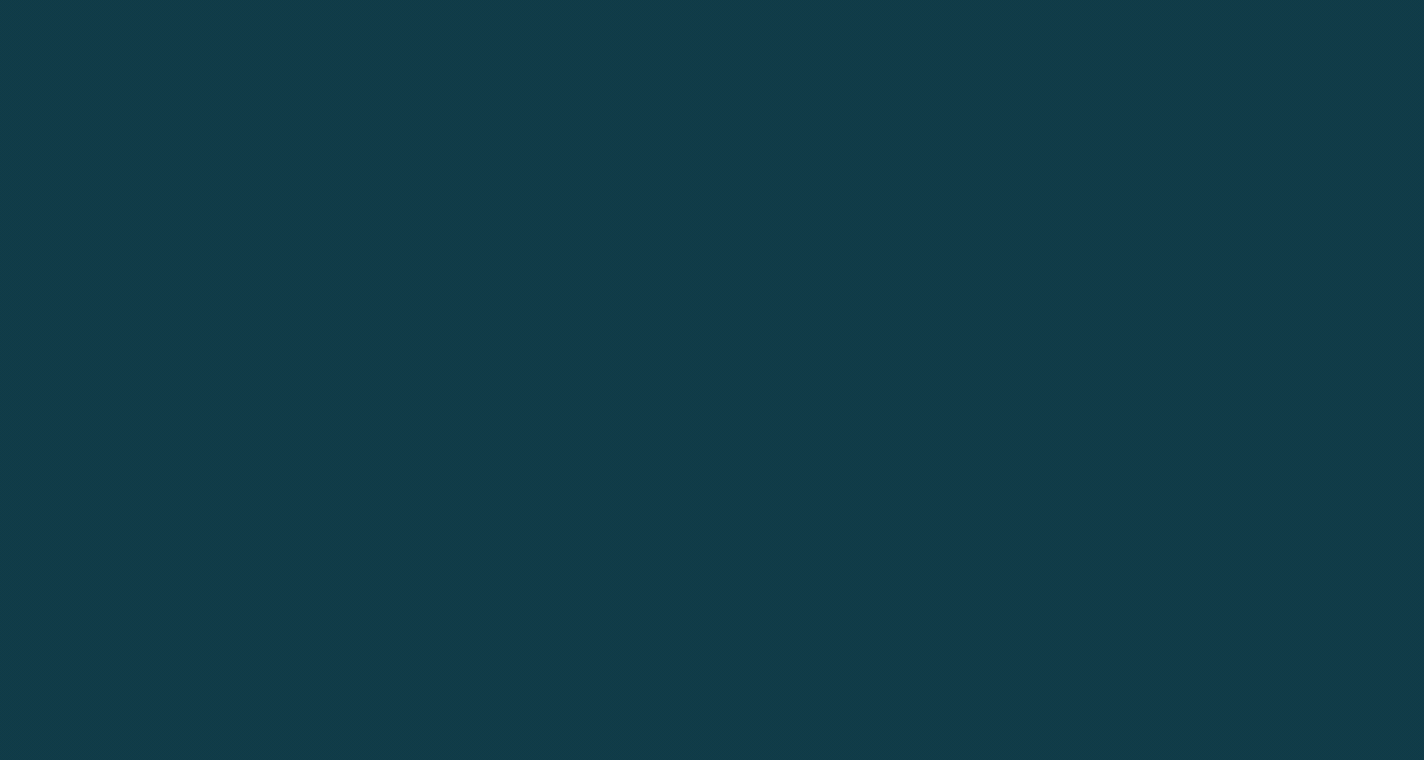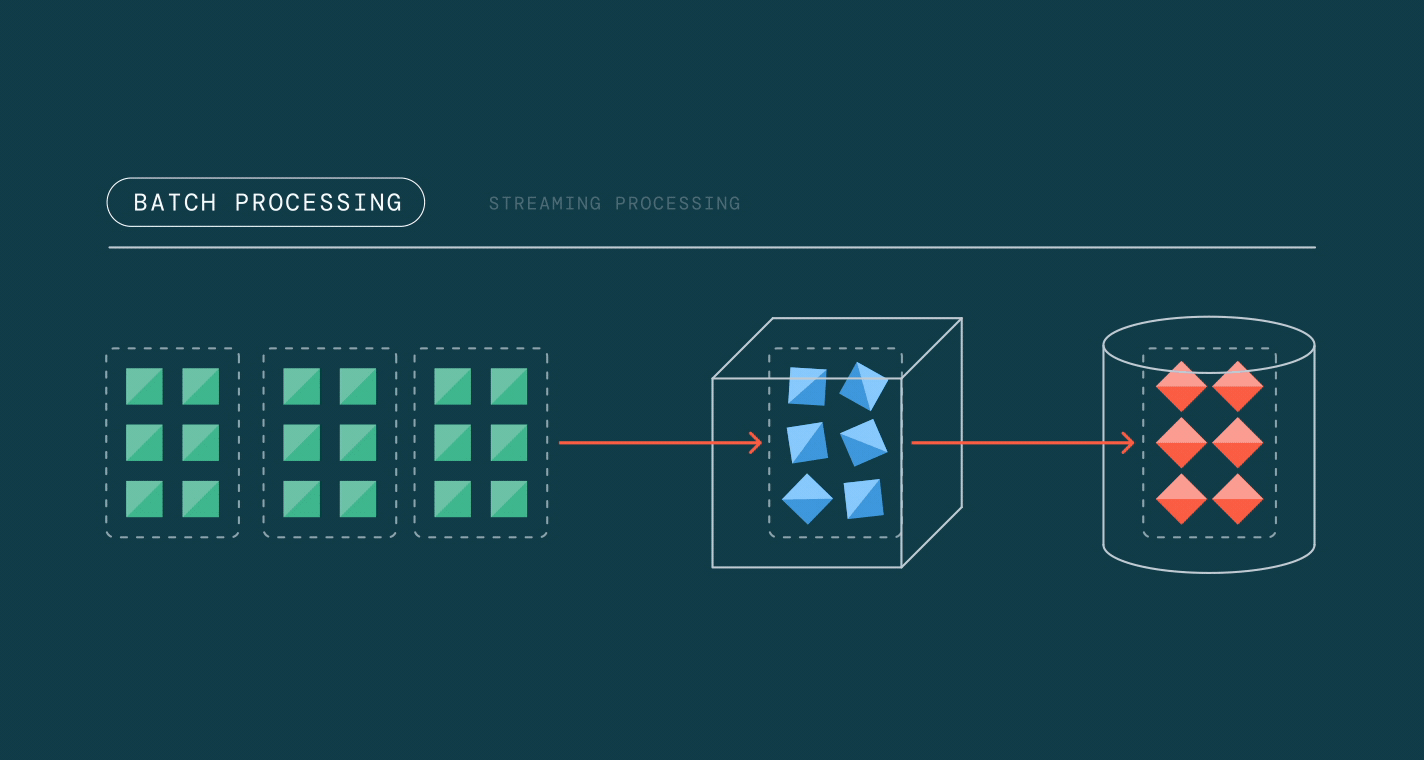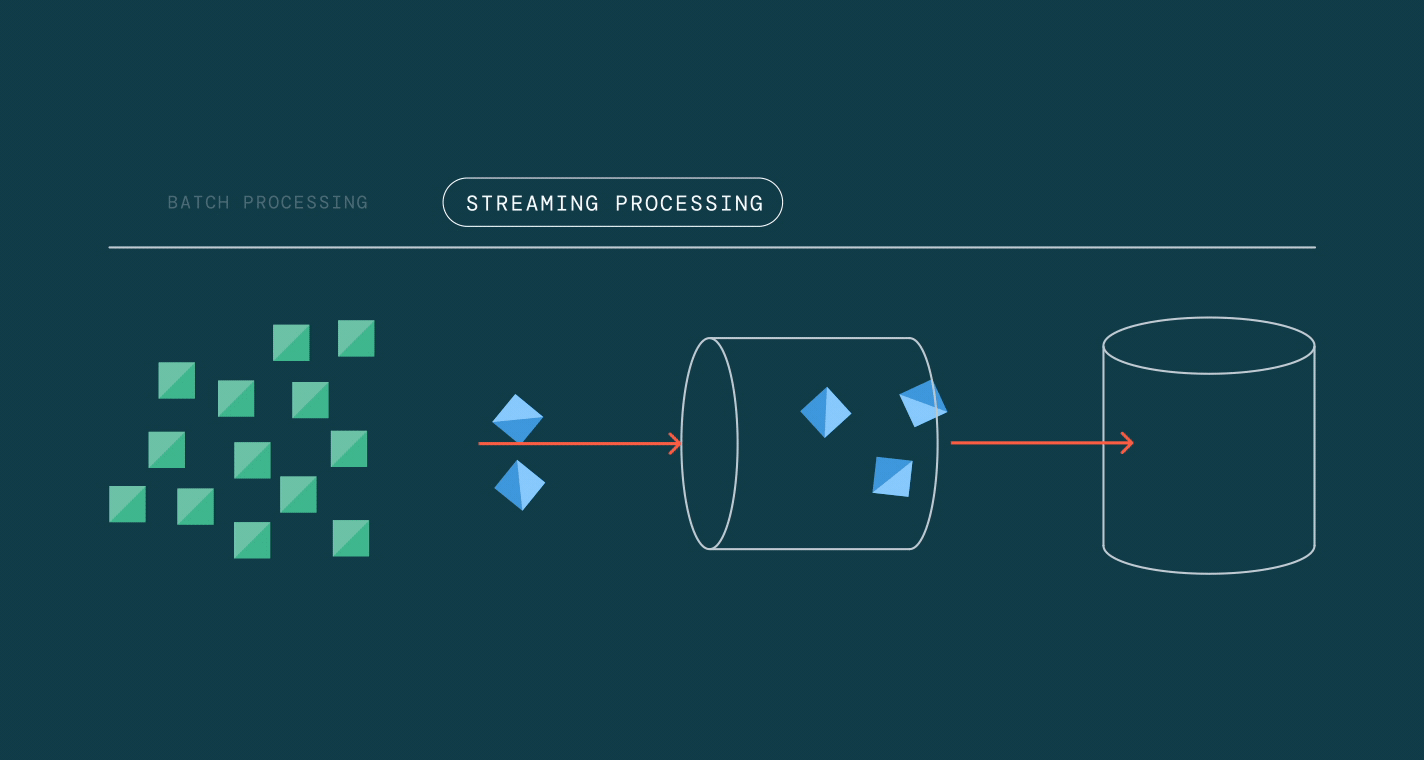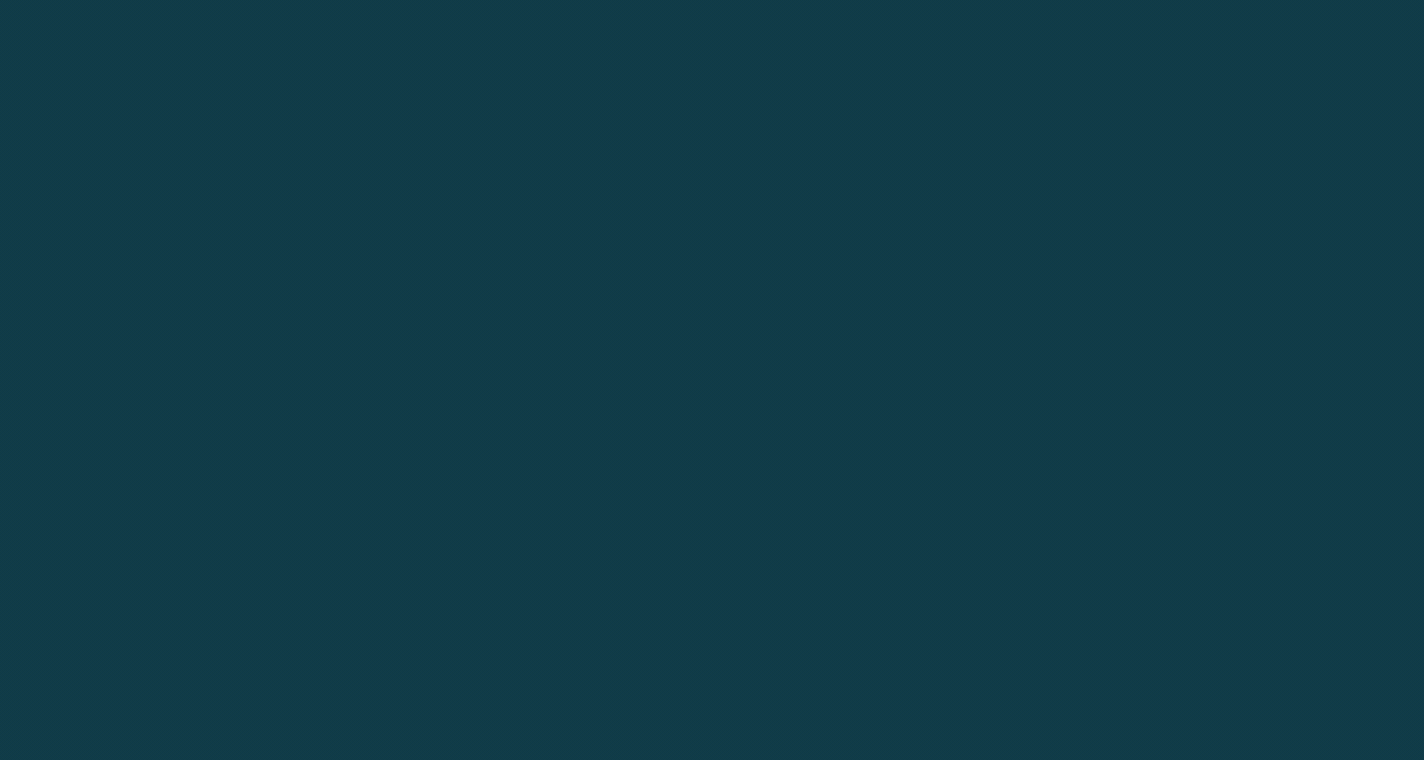
Spark Declarative Pipelines는 배치 및 Stream 처리를 위한 Spark의 통합 API를 활용하여 처리 모드 간에 쉽게 전환할 수 있습니다.
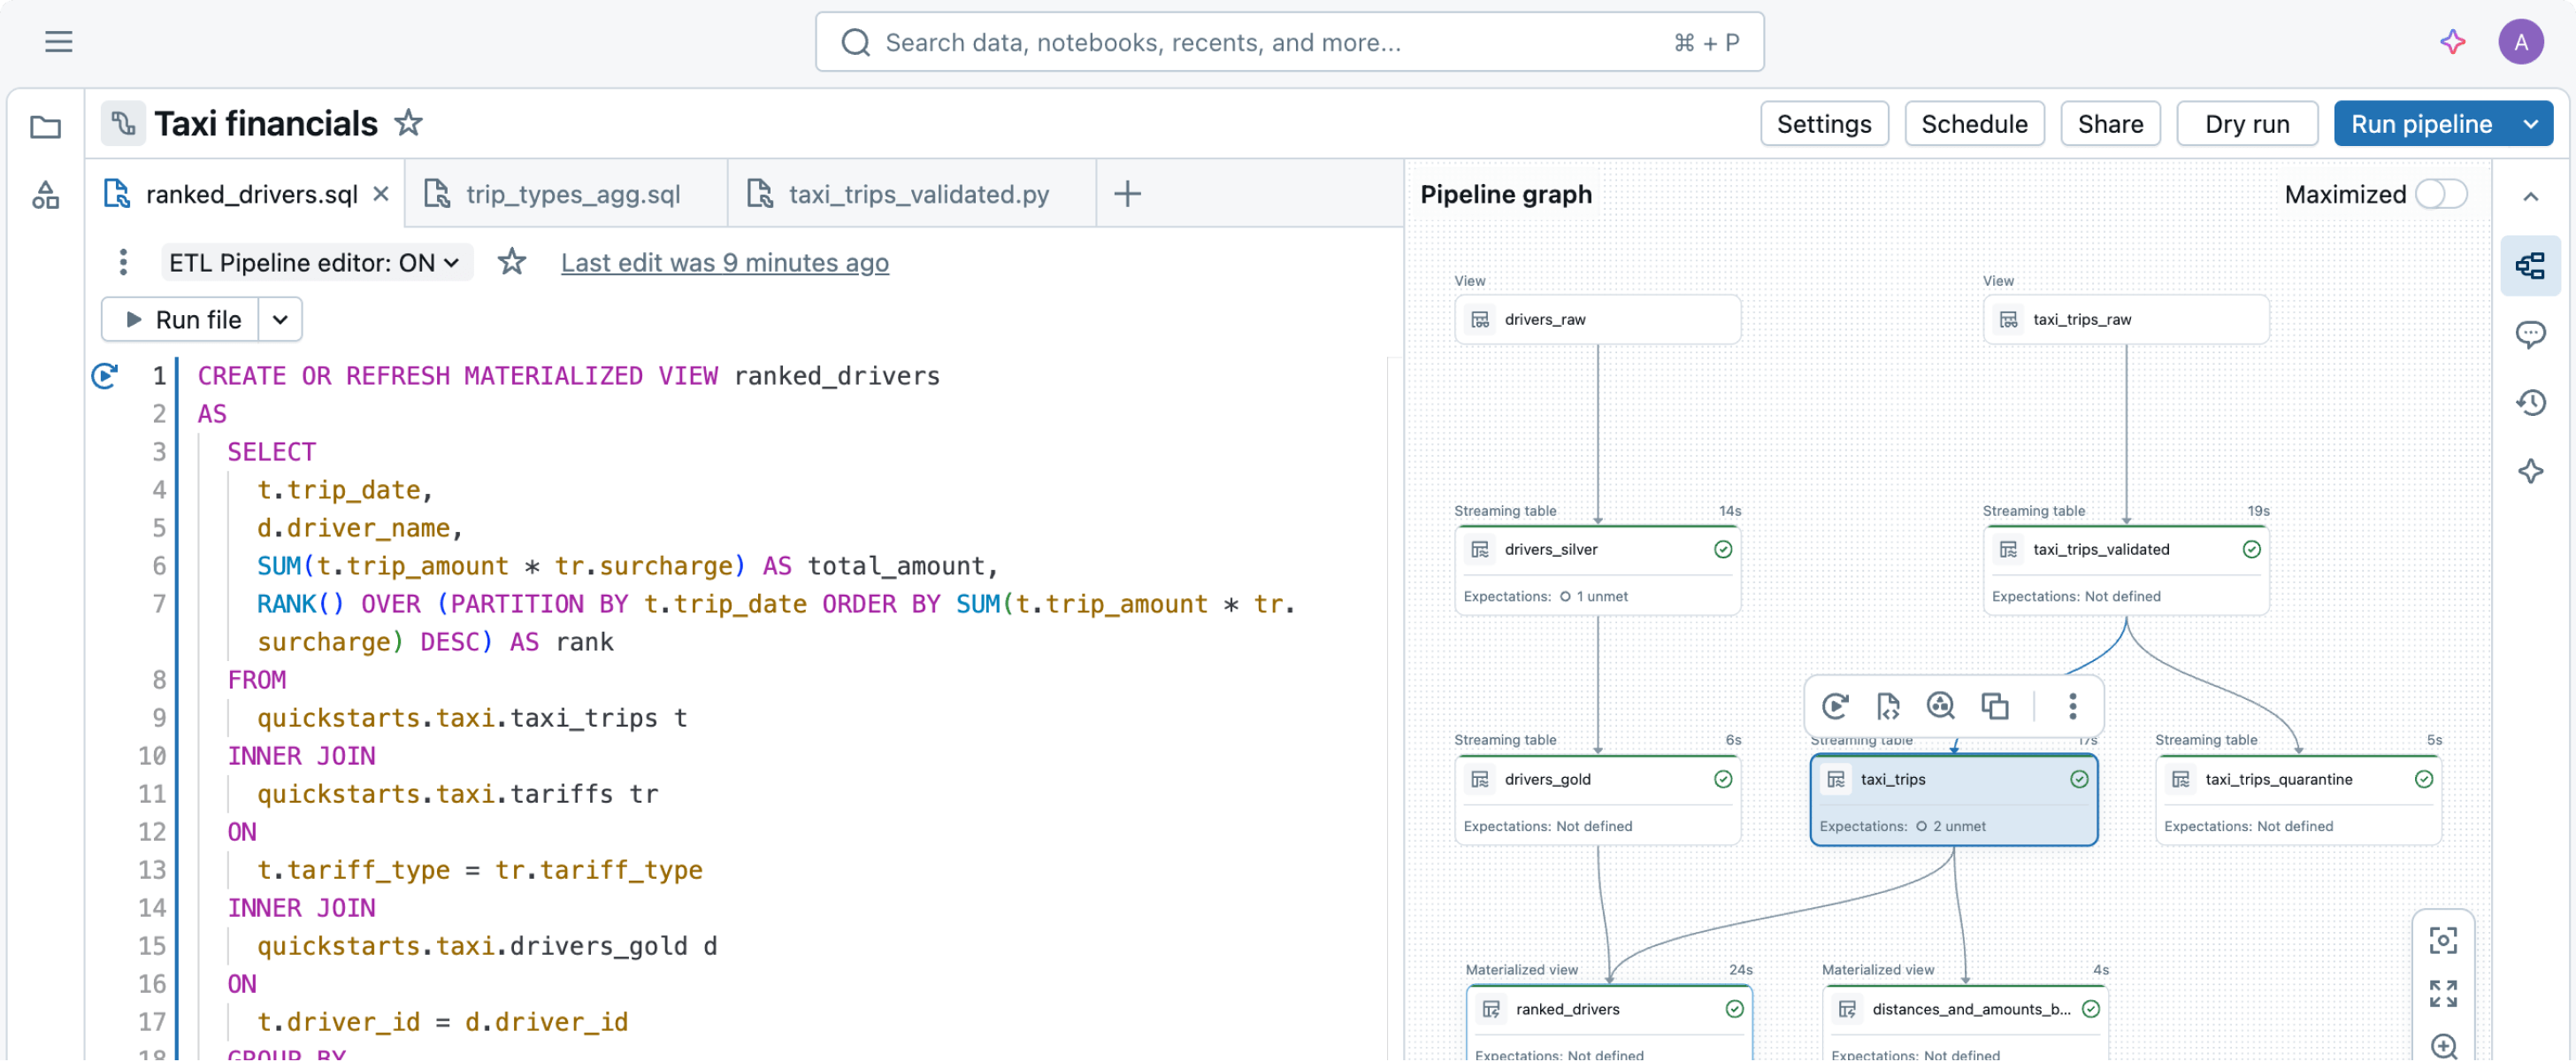
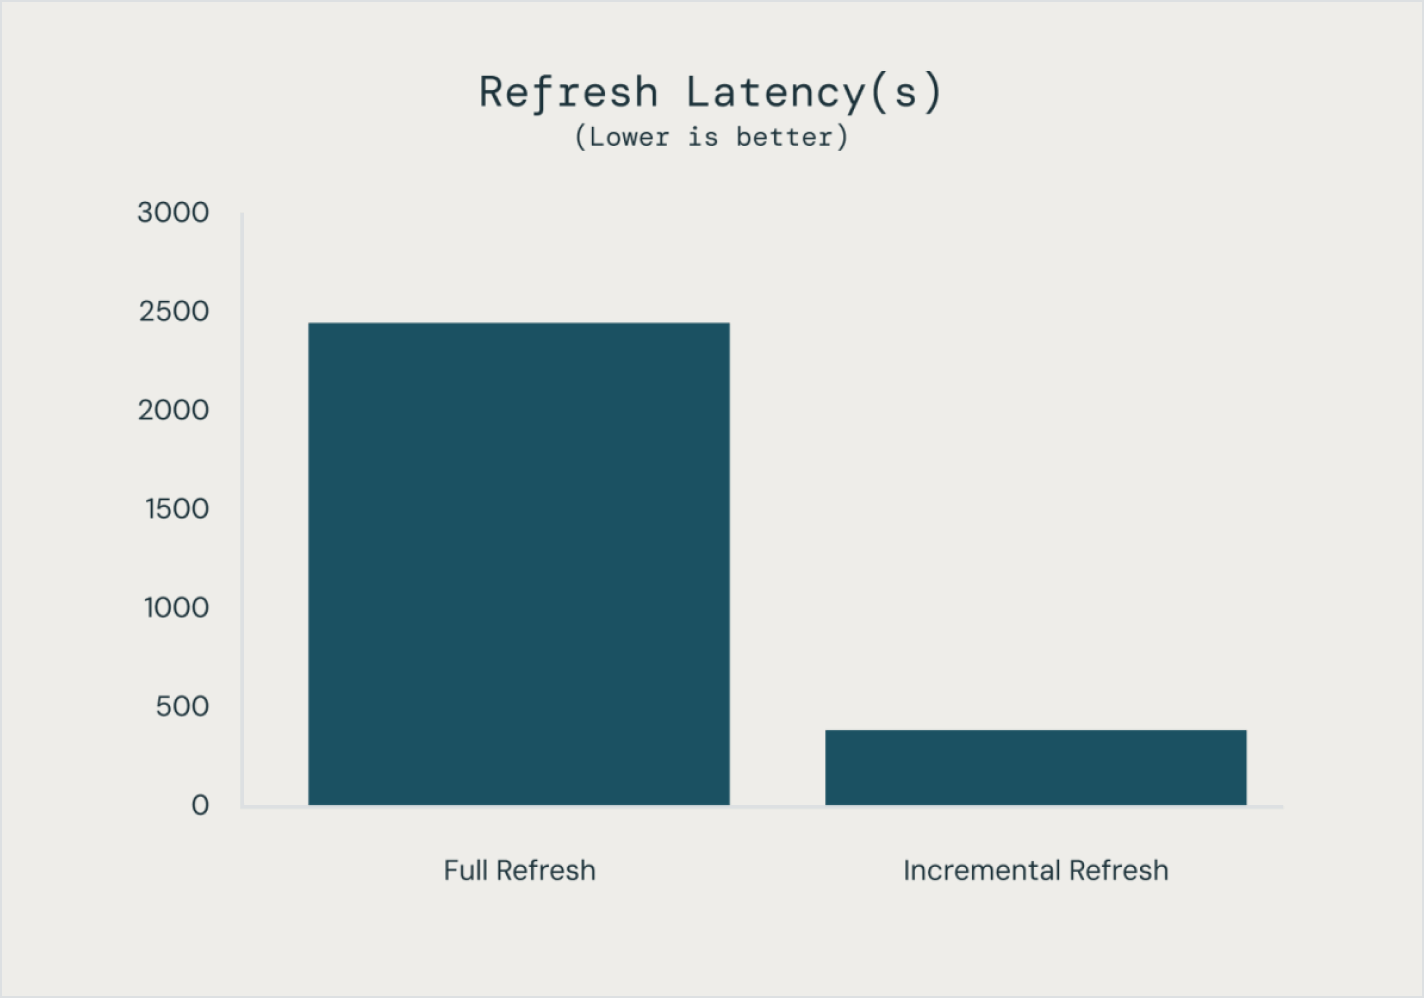
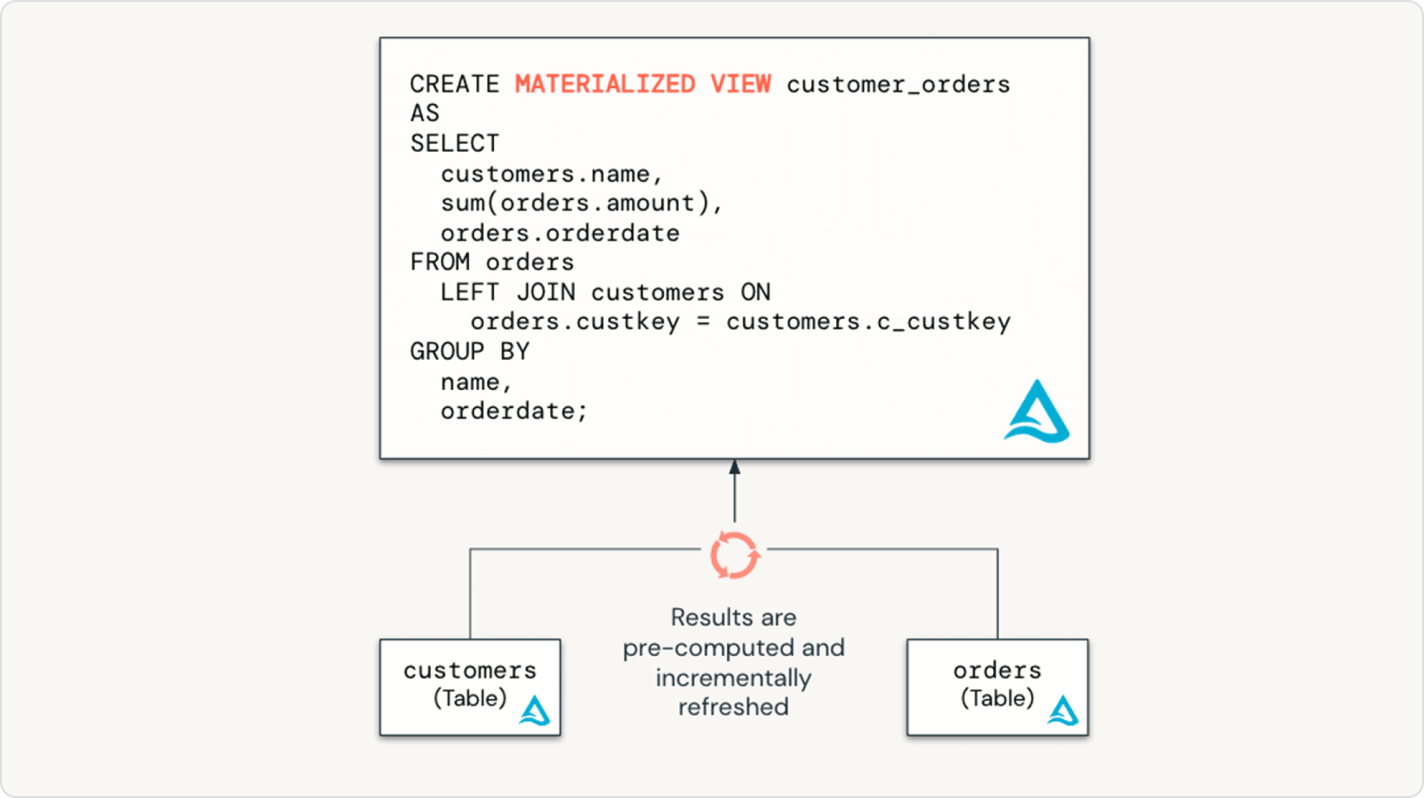
Spark Declarative Pipelines는 스트리밍 테이블과 구체화된 뷰로 전체 증분 데이터 파이프라인을 선언하여 파이프라인 성능을 쉽게 최적화할 수 있도록 합니다.
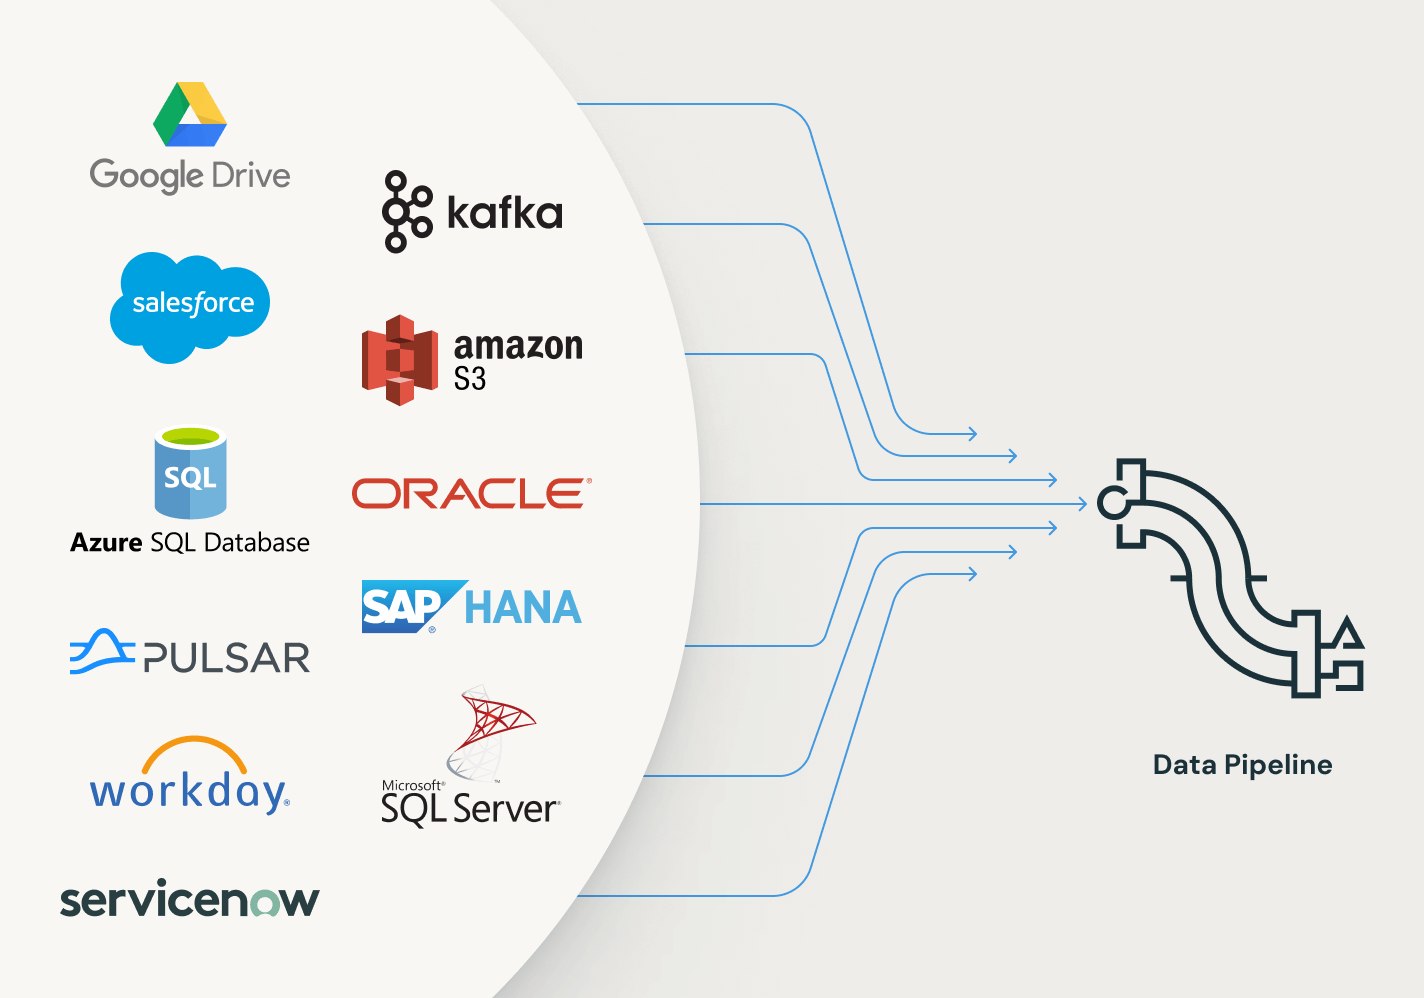
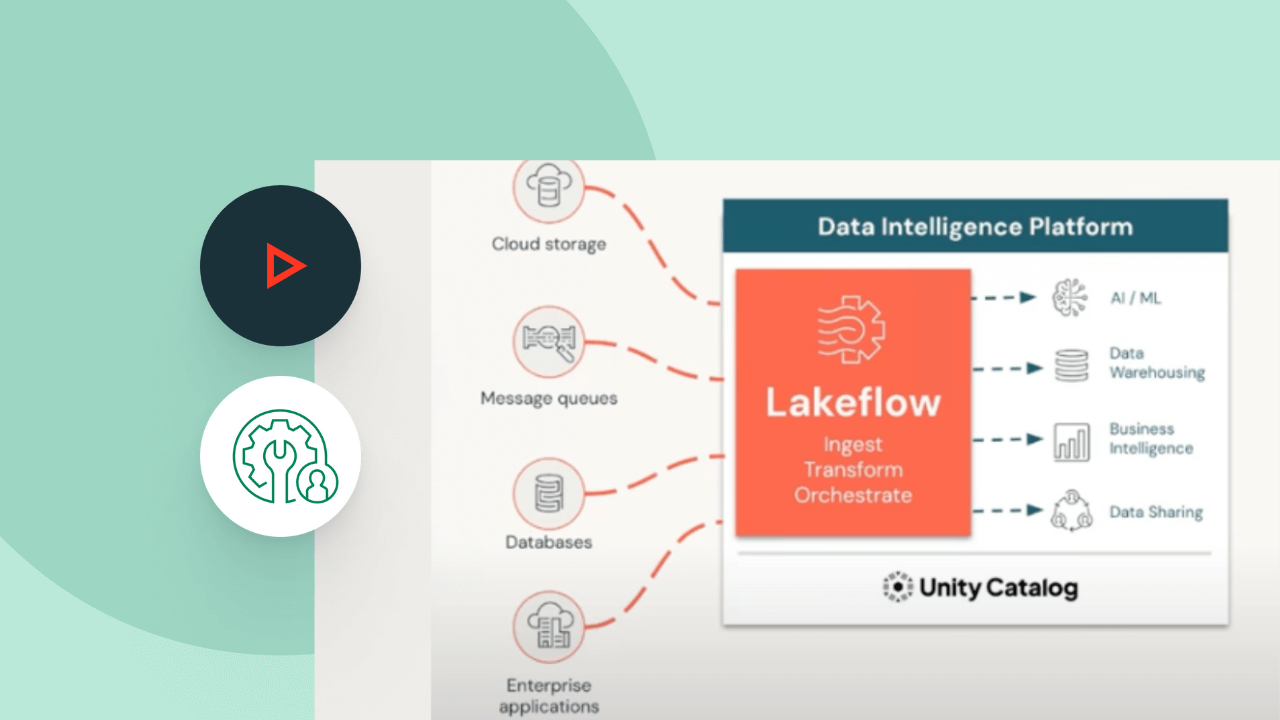
Spark Declarative Pipelines는 광범위한 소스 및 싱크 에코시스템을 지원합니다. 클라우드 스토리지, 메시지 버스, 변경 데이터 피드, 데이터베이스, 엔터프라이즈 앱 등 모든 소스에서 데이터를 로드하세요.
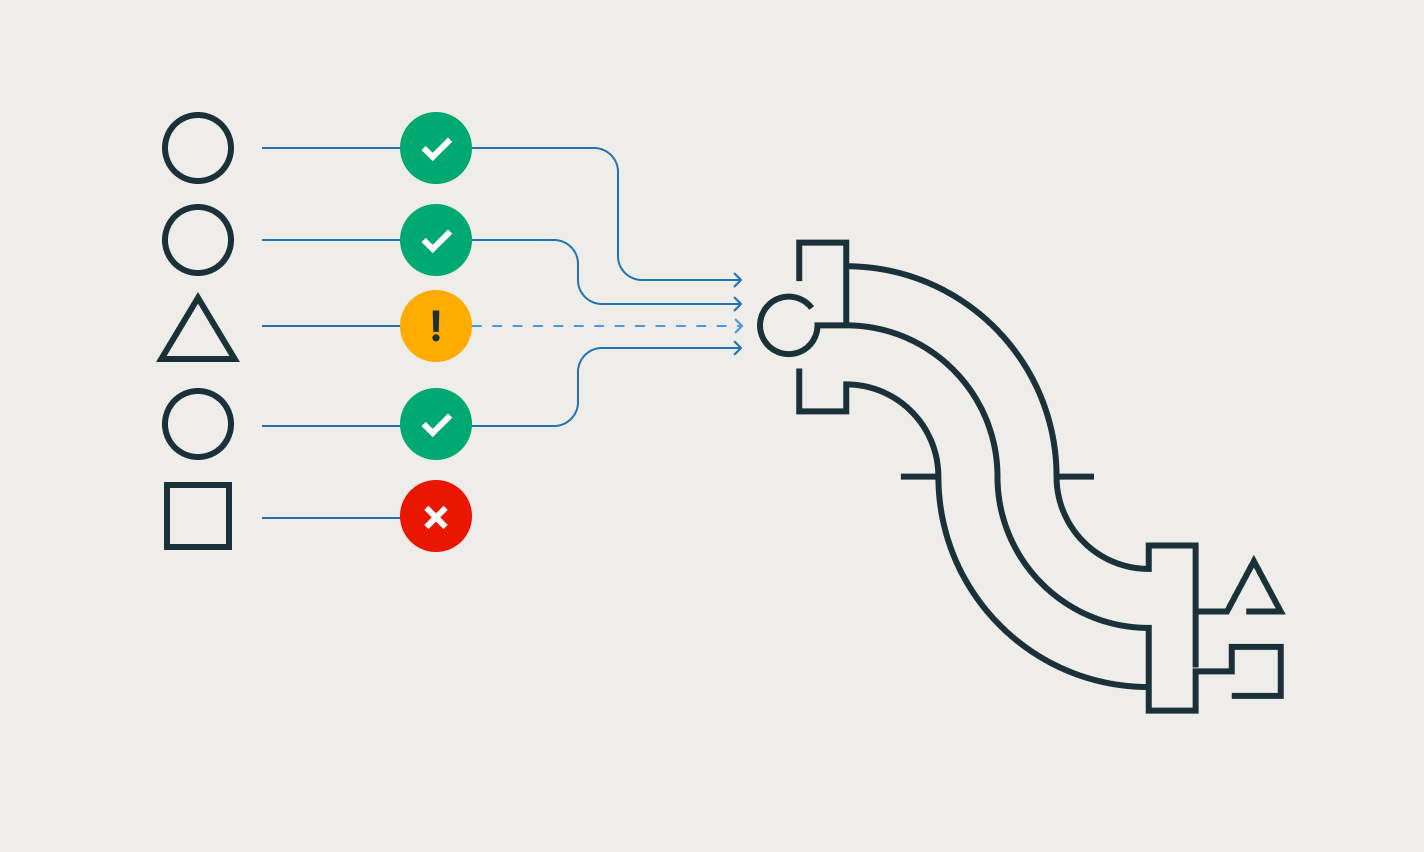
기대를 통해 테이블에 도착하는 데이터가 데이터 품질 요구 사항을 충족하고 파이프라인이 업데이트될 때마다 데이터 품질에 대한 통찰력을 제공할 수 있어요.
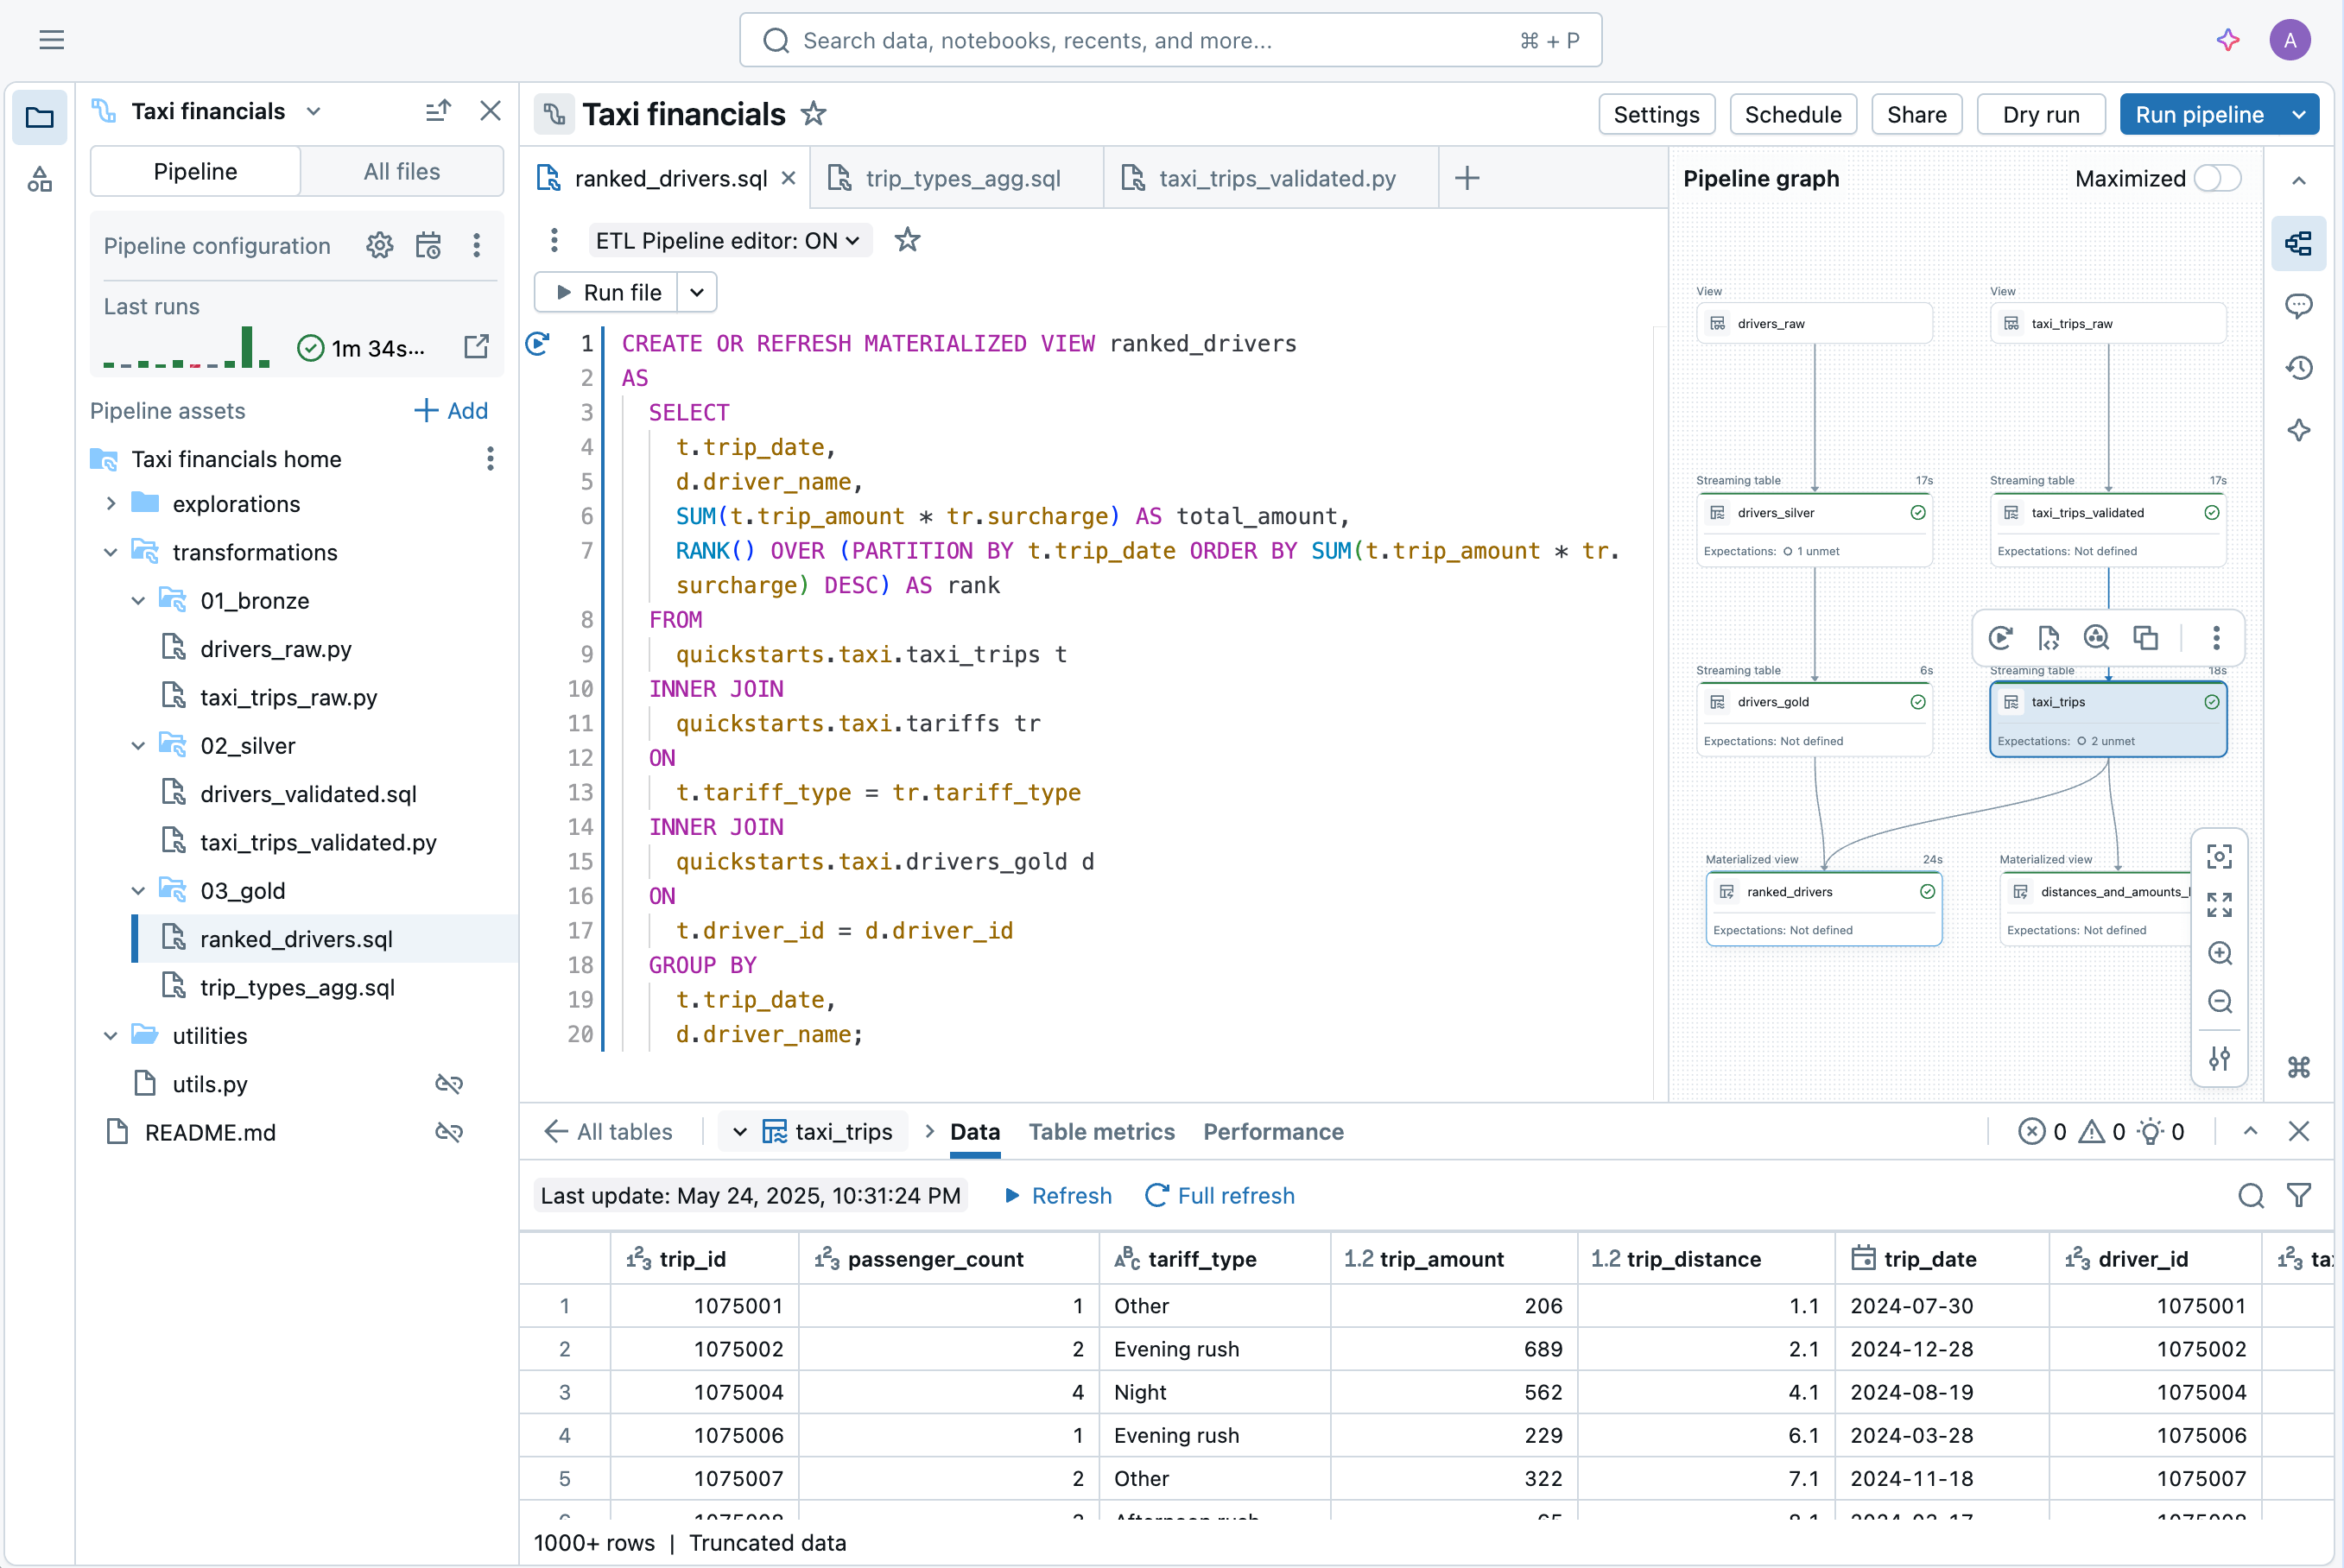
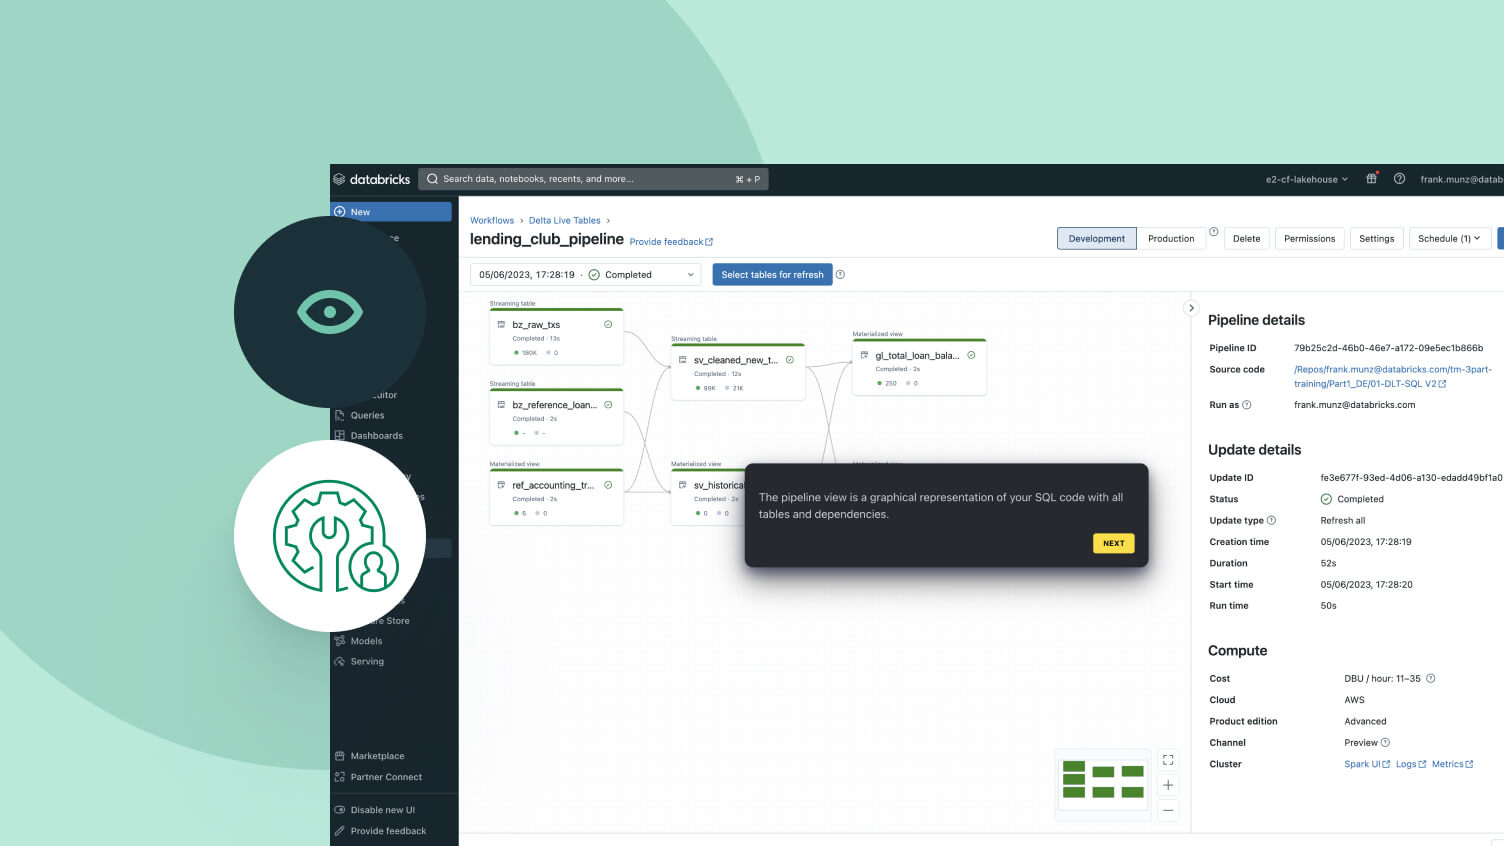
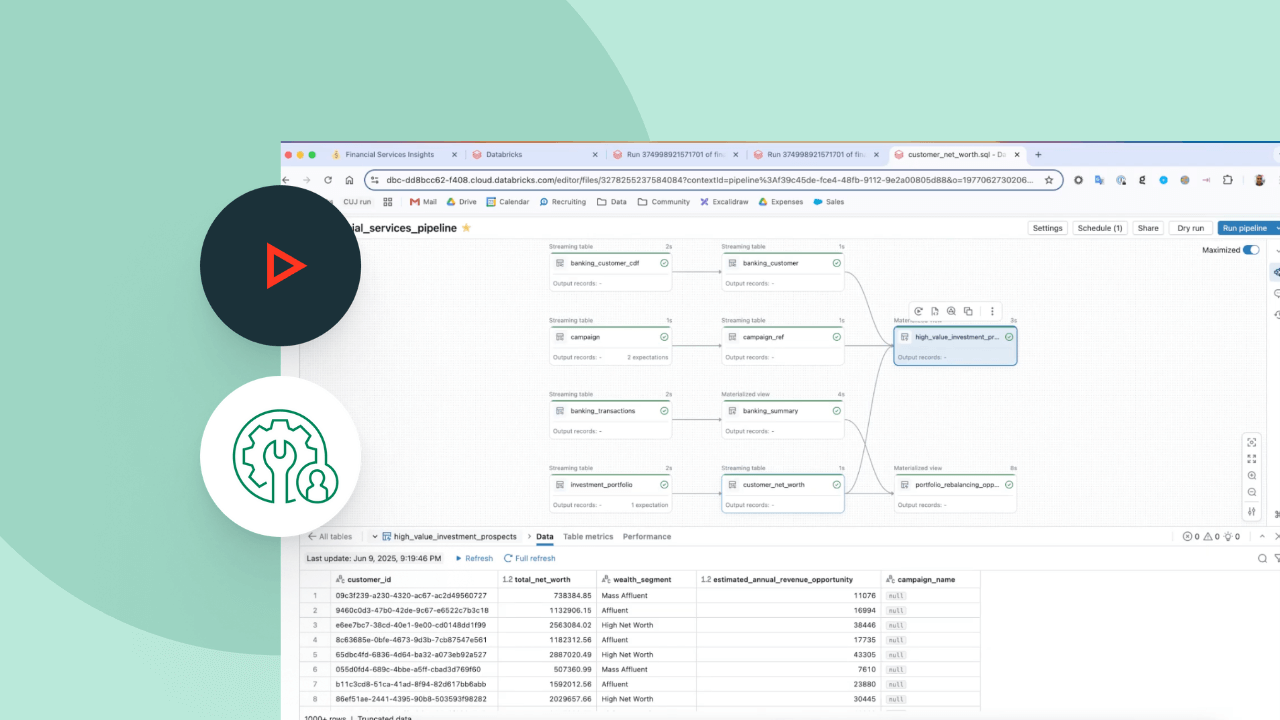
컨텍스트 전환 없이 IDE에서 데이터 엔지니어링용 파이프라인을 개발하세요. DAG, 데이터 미리보기, 실행 인사이트를 하나의 UI에서 볼 수 있어요. 자동 완성, 인라인 오류 및 진단 기능으로 코드를 쉽게 개발하세요.
기타 기능
데이터 파이프라인 간소화

사용량 기반 가격 책정으로
지출 통제
사용한 제품에 대해서만 초 단위로 비용을 지불하세요.더 자세히 알아보기
Databricks 플랫폼에서 다른 통합된 지능형 제품을 살펴보세요.
LakeFlow Connect
모든 소스로부터의 효율적인 데이터 수집 커넥터와 Databricks Platform과의 네이티브 통합은 통합 거버넌스를 통해 분석 및 AI에 대한 간편한 액세스를 지원합니다.

Lakeflow Jobs
ETL, 분석, Machine Learning 파이프라인을 위한 다중 작업 워크플로를 손쉽게 정의, 관리, 모니터링하세요. 데이터 팀은 다양한 지원 작업 유형, 심층적인 관측 기능 및 높은 안정성을 기반으로 모든 파이프라인을 보다 효과적으로 자동화 및 오케스트레이션하고 생산성을 높일 수 있습니다.

Genie Code
데이터 작업을 위한 자율적인 AI 파트너입니다.

레이크하우스 스토리지
모든 분석과 AI 워크로드에 대해 레이크하우스에 있는 모든 형식과 유형의 데이터를 통합하세요.

Unity Catalog
Databricks 플랫폼에 내장된 업계 유일의 통합된 개방형 데이터 및 AI 거버넌스 솔루션으로 모든 데이터 자산을 원활하게 관리하세요.

Databricks Platform
Databricks Platform이 데이터 및 AI 워크로드를 지원하는 방법을 알아보세요.
다음 단계 수행
Spark Declarative Pipelines
대부분의 ETL 도구는 수동 오케스트레이션, 클러스터 튜닝, 모니터링 및 데이터 품질을 위한 별도의 시스템을 필요로 합니다. Spark Declarative Pipelines는 이러한 작업을 엔드투엔드로 자동화하고, 내장된 관찰 가능성, 데이터 품질 적용, Serverless 인프라에서의 자동 확장을 통해 배치 및 스트리밍 파이프라인을 지원합니다. 또한 Unity Catalog를 통해 기본 계보, 로깅, 거버넌스를 제공하여 전체 수명 주기에 걸쳐 파이프라인을 더 쉽게 관리할 수 있습니다.