Annonce de la disponibilité générale du calcul sans serveur pour les notebooks, Workflows et Spark Declarative Pipelines
Un calcul rapide et sans effort pour exécuter des notebooks, des tâches et des pipelines est désormais généralement disponible sur Azure et AWS
par Bilal Aslam et Lucian Popa
Nous avons le plaisir d'annoncer la disponibilité générale (GA) du calcul sans serveur pour les notebooks, les travaux et Spark Declarative Pipelines (SDP) sur AWS et Azure. Les clients de Databricks profitent déjà d'un calcul sans serveur rapide, simple et fiable pour Databricks SQL et Databricks Model Serving. Cette même fonctionnalité est désormais disponible pour toutes les charges de travail ETL sur la plateforme Data + AI Platform, incluant Apache Spark et Spark Declarative Pipelines. Vous écrivez le code et Databricks assure un démarrage rapide des charges de travail, une mise à l'échelle automatique de l'infrastructure et des mises à niveau fluides des versions de Databricks Runtime. Surtout, avec le calcul sans serveur, vous ne payez que pour le travail effectué au lieu du temps passé à acquérir et initialiser des instances auprès des fournisseurs cloud.

Notre offre actuelle de calcul sans serveur est optimisée pour un démarrage, une mise à l'échelle et des performances rapides. Les utilisateurs pourront bientôt exprimer d'autres objectifs, comme la réduction des coûts. Nous proposons actuellement une remise promotionnelle de lancement sur le calcul sans serveur, disponible dès maintenant et jusqu'au 31 janvier 2025. Vous bénéficiez d'une réduction de 50 % sur le calcul sans serveur pour Workflows et SDP, ainsi que d'une réduction de 30 % pour les Notebooks.
"Le démarrage des clusters est une priorité pour nous, et les notebooks et Workflows sans serveur ont fait une énorme différence. Le calcul sans serveur pour les notebooks simplifie tout en un seul clic ; nous obtenons un calcul sans serveur qui s'intègre de manière transparente dans les workflows. De plus, c'est sécurisé. Cette fonctionnalité tant attendue change la donne. Merci, Databricks !" - Chiranjeevi Katta, Data Engineer chez Airbus
Explorons les défis que le calcul sans serveur aide à résoudre et les avantages uniques qu'il offre aux équipes de données.
L'infrastructure de calcul est complexe et coûteuse à gérer
La configuration et la gestion du calcul, comme les clusters Spark, ont longtemps été un défi pour les ingénieurs et les scientifiques des données. Le temps passé à configurer et à gérer le calcul est du temps perdu pour apporter de la valeur à l'entreprise.
Choisir le bon type et la bonne taille d'instance prend du temps et nécessite des expérimentations pour déterminer le choix optimal pour une charge de travail donnée. Définir les politiques de cluster, la mise à l'échelle automatique et les configurations Spark complexifie encore cette tâche et requiert de l'expertise. Une fois vos clusters configurés et opérationnels, vous devez encore consacrer du temps à la maintenance, à l'optimisation de leurs performances et à la mise à jour des versions de Databricks Runtime pour profiter des nouvelles fonctionnalités.
Le temps d'inactivité — le temps non consacré au traitement de vos charges de travail, mais que vous continuez à payer — est un autre résultat coûteux de la gestion de votre propre infrastructure de calcul. Pendant l'initialisation et la mise à l'échelle du calcul, les instances doivent démarrer, les logiciels, y compris Databricks Runtime, doivent être installés, etc. Vous payez votre fournisseur cloud pour ce temps. De plus, si vous surdimensionnez le calcul en utilisant trop d'instances ou des types d'instances dotés d'une mémoire ou d'un processeur excessifs, le calcul sera sous-utilisé tout en vous coûtant l'intégralité de la capacité provisionnée.
L'observation de ces coûts et complexités à travers des millions de charges de travail clients nous a poussés à innover avec le calcul sans serveur.
Le calcul sans serveur est rapide, simple et fiable
Dans le mode de calcul classique, vous donnez à Databricks des autorisations déléguées via des rôles et des politiques cloud complexes pour gérer le cycle de vie des instances nécessaires à vos charges de travail. Le calcul sans serveur élimine cette complexité puisque Databricks gère un parc de calcul vaste et sécurisé pour vous. Vous pouvez simplement commencer à utiliser Databricks sans aucune configuration.
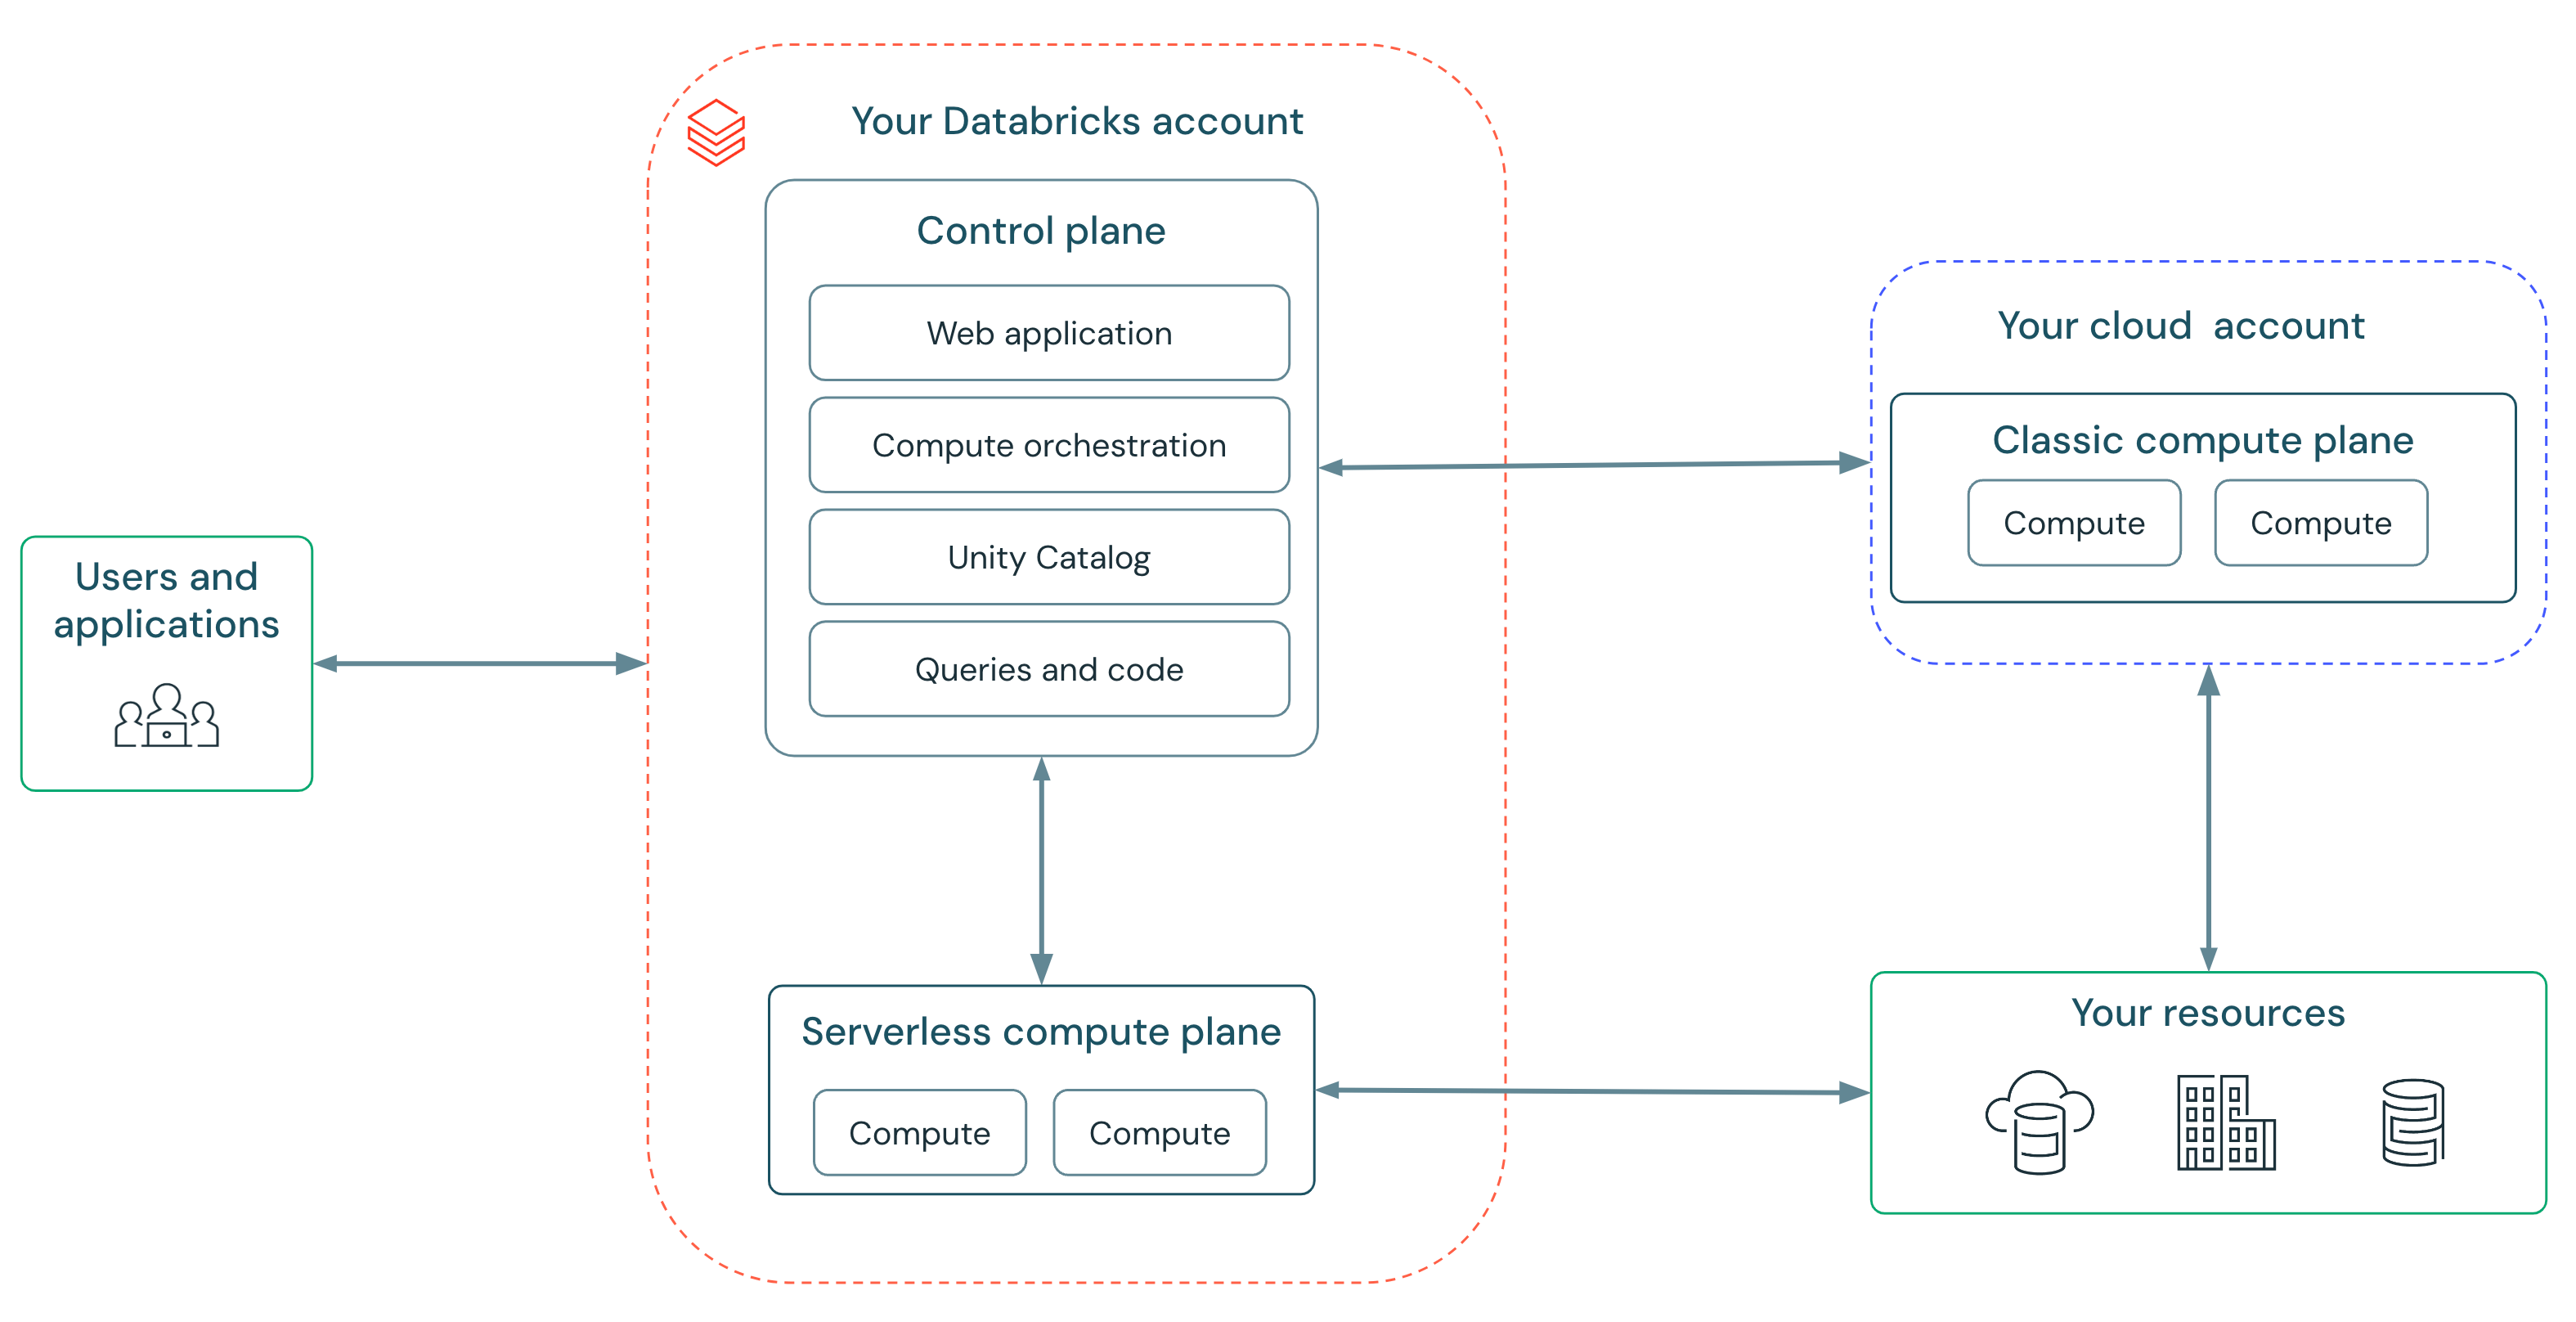
Le calcul sans serveur nous permet de fournir un service qui est rapide, simple et fiable :
- Rapide : Plus besoin d'attendre les clusters — le calcul démarre en quelques secondes, et non en minutes. Databricks exécute des « pools chauds » d'instances pour que le calcul soit prêt quand vous l'êtes.
- Simple : Fini le choix des types d'instances, des paramètres de mise à l'échelle des clusters ou des configurations Spark. Le mode sans serveur inclut un nouvel autoscaler qui est plus intelligent et plus réactif aux besoins de votre charge de travail que celui du calcul classique. Cela signifie que chaque utilisateur est désormais capable d'exécuter des charges de travail sans l'aide d'experts en infrastructure. Databricks met automatiquement à jour les charges de travail et effectue une transition sécurisée vers les dernières versions de Spark, vous garantissant ainsi de toujours bénéficier des dernières performances et mesures de sécurité.
- Fiable : Le calcul sans serveur de Databricks protège les clients contre les pannes du cloud grâce au basculement automatique des types d'instances et à un « pool chaud » d'instances faisant tampon contre les pénuries de disponibilité.
"Il est très facile de migrer des workflows du dev vers la prod sans avoir à choisir les types de workers. L'amélioration significative du temps de démarrage, combinée à la réduction de la configuration et de la maintenance DataOps, améliore grandement la productivité et l'efficacité." - Gal Doron, Head of Data chez AnyClip
Le calcul sans serveur facture le travail effectué
Nous sommes ravis de présenter un modèle de facturation élastique pour le calcul sans serveur. Vous êtes facturé uniquement lorsque le calcul est assigné à vos charges de travail et non pour le temps nécessaire à l'acquisition et à la configuration des instances de calcul.
L'autoscaler sans serveur intelligent garantit que votre espace de travail disposera toujours de la bonne capacité provisionnée pour répondre à la demande, par exemple lorsqu'un utilisateur exécute une commande dans un notebook. Il augmentera ou réduira automatiquement la capacité de l'espace de travail par étapes progressives pour répondre à vos besoins. Pour garantir une gestion judicieuse des ressources, nous réduirons la capacité provisionnée après quelques minutes lorsque l'autoscaler intelligent estimera qu'elle n'est plus nécessaire.
"Le calcul sans serveur pour SDP a été incroyablement facile à configurer et à lancer, et nous constatons déjà d'importantes améliorations de performance sur nos vues matérialisées. Auparavant, passer des données brutes à la couche silver nous prenait environ 16 minutes, mais après le passage au sans serveur, cela ne prend plus que 7 minutes environ. Les gains de temps et d'argent vont être immenses" - Aaron Jepsen, Director IT Operations chez Jet Linx Aviation
Le calcul sans serveur est facile à gérer
Le calcul sans serveur intègre des outils permettant aux administrateurs de gérer les coûts et les budgets. Après tout, la simplicité ne doit pas rimer avec dépassements de budget et factures surprises !
Les données relatives à l'utilisation et aux coûts du calcul sans serveur sont disponibles dans les tables système. Nous fournissons des tableaux de bord préconfigurés qui vous permettent d'obtenir une vue d'ensemble des coûts et d'analyser en détail des charges de travail spécifiques.
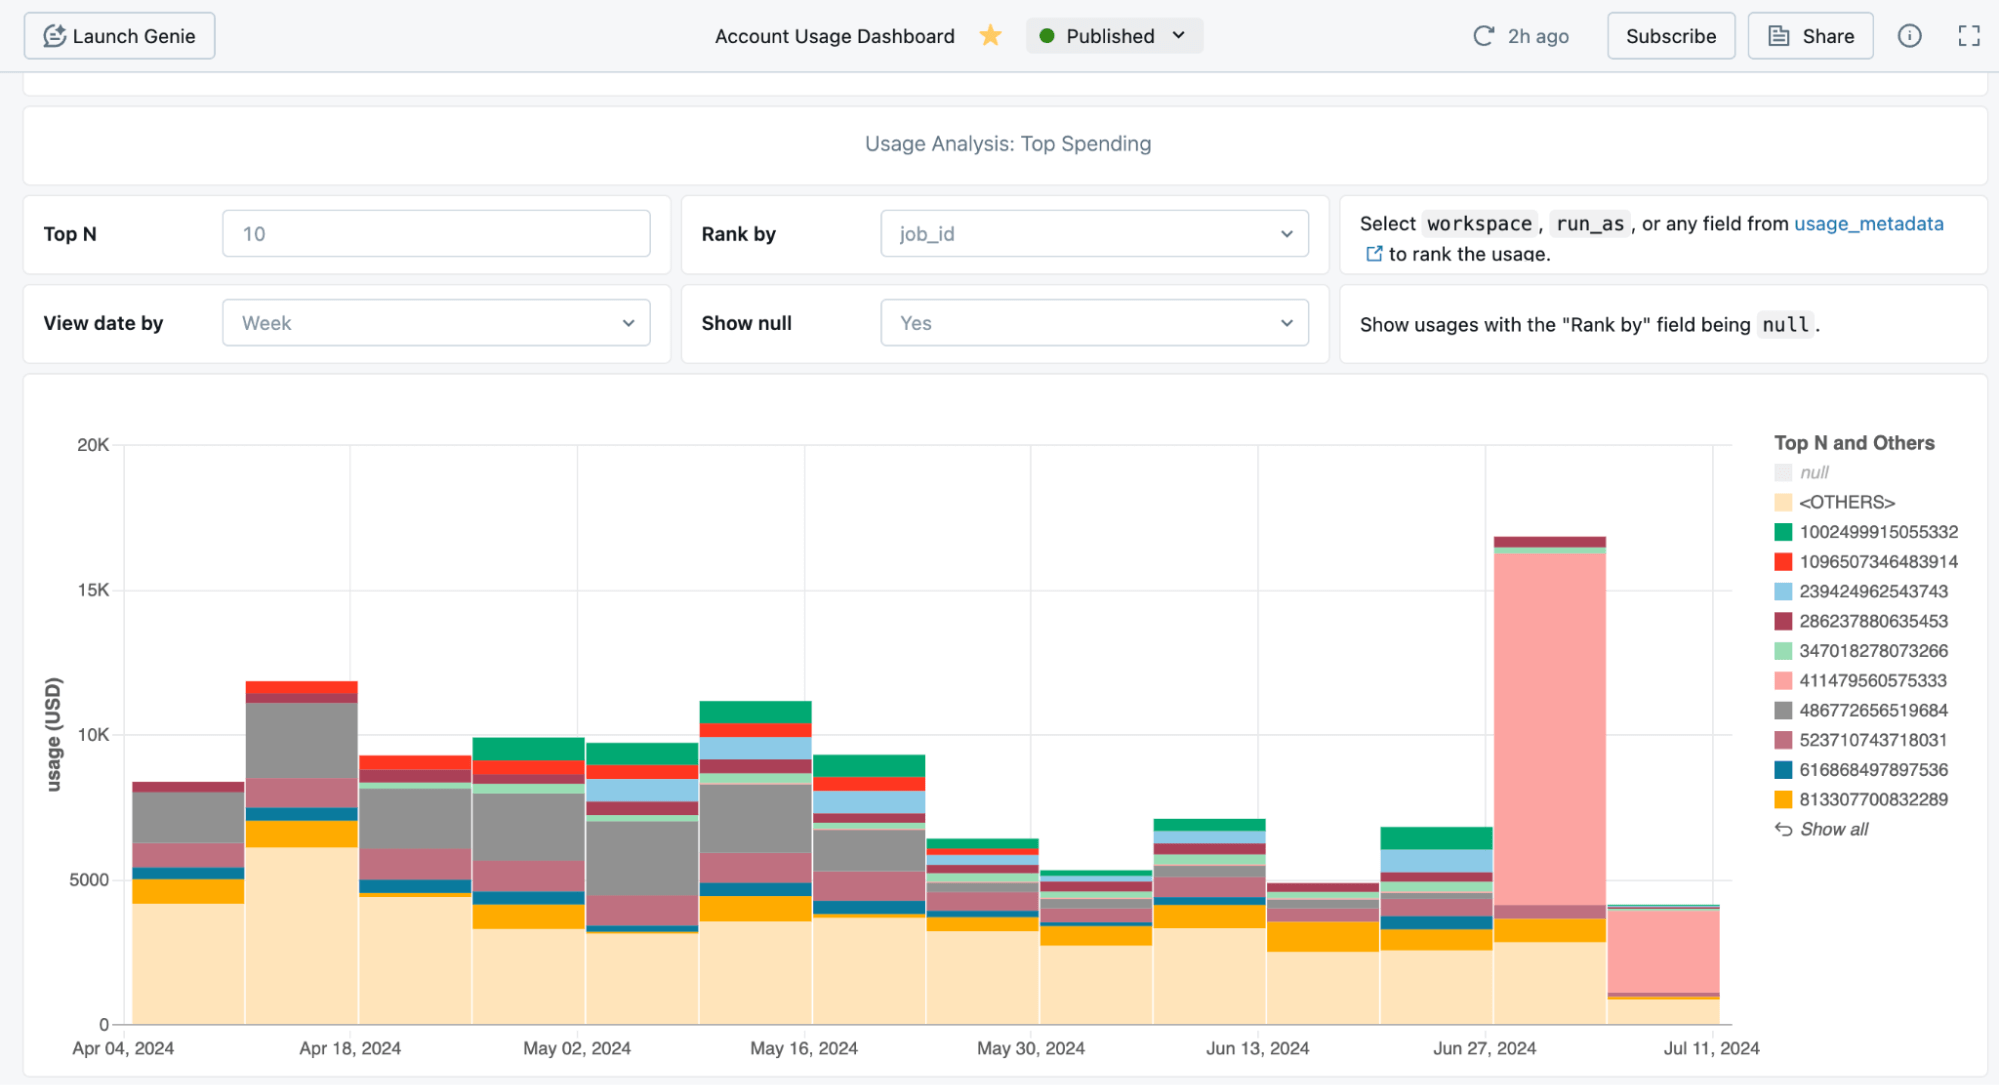
Les administrateurs peuvent utiliser les alertes de budget (en avant-première) pour regrouper les coûts et configurer des alertes. Une interface utilisateur intuitive facilite la gestion des budgets.

Le calcul sans serveur est conçu pour les charges de travail Spark modernes
Sous le capot, le calcul sans serveur utilise Lakeguard pour isoler le code utilisateur à l'aide de techniques de sandboxing, une nécessité absolue dans un environnement sans serveur. Par conséquent, certaines charges de travail nécessitent des modifications de code pour continuer à fonctionner en mode sans serveur. Le calcul sans serveur requiert Unity Catalog pour un accès sécurisé aux actifs de données, de sorte que les charges de travail accédant aux données sans utiliser Unity Catalog peuvent nécessiter des modifications.
Le moyen le plus simple de tester si votre charge de travail est prête pour le calcul sans serveur est de l'exécuter d'abord sur un cluster classique en utilisant le mode d'accès partagé sur DBR 14.3+.

Le calcul sans serveur est prêt à l'emploi
Nous travaillons d'arrache-pied pour rendre le calcul sans serveur encore meilleur dans les mois à venir :
- Prise en charge de GCP : Nous débutons une avant-première privée du calcul sans serveur sur GCP ; restez à l'écoute pour nos annonces concernant l'avant-première publique et la disponibilité générale.
- Mise en réseau privée et contrôles d'accès sortants : Connectez-vous aux ressources de votre réseau privé et contrôlez ce que vos ressources de calcul sans serveur peuvent atteindre sur Internet public.
- Attribution vérifiable : Assurez-vous que tous les notebooks, flux de travail et pipelines SDP sont correctement étiquetés afin de pouvoir imputer les coûts à des centres de coûts spécifiques, par exemple pour la refacturation.
- Environnements : Les administrateurs pourront définir un environnement de base pour l'espace de travail avec un accès aux dépôts privés, à des versions spécifiques de Python et de bibliothèques, ainsi qu'à des variables d'environnement.
- Coût et performances : Le calcul sans serveur est actuellement optimisé pour un démarrage, une mise à l'échelle et des performances rapides. Les utilisateurs pourront bientôt exprimer d'autres objectifs, comme la réduction des coûts.
- Prise en charge de Scala : Les utilisateurs pourront exécuter des charges de travail Scala sur le calcul sans serveur. Pour vous préparer à passer en toute transparence au sans serveur dès qu'il sera disponible, déplacez vos charges de travail Scala vers le calcul classique avec le mode d'accès partagé.
Pour commencer à utiliser le calcul sans serveur dès aujourd'hui :
- Activez le calcul sans serveur dans votre compte sur AWS ou Azure
- Assurez-vous que votre espace de travail est configuré pour utiliser Unity Catalog et se trouve dans une région prise en charge sur AWS ou Azure.
- Pour les charges de travail PySpark existantes, assurez-vous qu'elles sont compatibles avec le mode d'accès partagé et DBR 14.3+
- Suivez les instructions spécifiques pour les Notebooks, les Workflows et les Spark Declarative Pipelines
- Utilisez le calcul sans serveur à partir de n'importe quel système tiers avec Databricks Connect, par exemple lors du développement local à partir de votre IDE, ou lors de l'intégration native de vos applications avec Databricks en Python.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.