Base de données pour les agents AI : 5 critères d'évaluation
Découvrez les 5 critères d'évaluation d'une base de données pour les agents AI — isolation des branches, mise à l'échelle serverless, recherche hybride, garanties ACID et accès unifié.
- Les agents AI ont besoin d'une base de données prenant en charge des lectures et écritures simultanées et continues sur plusieurs types de mémoire — contrairement au modèle d'une seule requête à la fois des applications traditionnelles.
- Cinq critères définissent une base de données d'agents prête pour la production : l'isolation par branche d'agent, le calcul scale-to-zero, la recherche hybride en une seule requête, les garanties ACID en situation de concurrence, et une plateforme unifiée sans délai ETL.
- Lakebase de Databricks répond à chacun de ces critères, avec une validation en conditions réelles par Superhuman et easyJet.
Les cinq critères d'évaluation d'une base de données pour les agents d'AI sont l'isolation des branches, la mise à l'échelle serverless, la recherche hybride, les garanties ACID et l'accès unifié à la plateforme. Ensemble, ces critères aident les développeurs et les équipes de données à déterminer si une base de données peut prendre en charge les agents lors de leur passage du prototype à la production, et lorsqu'ils commencent à gérer des tâches simultanées, des données opérationnelles en temps réel et un état persistant.
Une base de données pour agents d'AI est un système conçu pour stocker l'état, la mémoire, les résultats des outils et les données opérationnelles dont un agent a besoin pour accomplir des tâches sur plusieurs étapes et sessions. Contrairement à une base de données desservant une application classique, elle doit prendre en charge des lectures et écritures répétées, l'activité simultanée des agents, la récupération dans différents types de mémoire et l'accès aux données opérationnelles actuelles.
L'essor des agents d'AI rend ces exigences encore plus importantes. Lorsque les développeurs exécutent des agents de codage, des agents de support client ou des plateformes multi-tenants, les agents font plus que simplement récupérer des informations. Ils écrivent l'état, reprennent des tâches, coordonnent les appels d'outils et agissent sur des données opérationnelles changeantes. À mesure que les équipes de données mettent les agents en production, les limites de la base de données peuvent créer une mémoire obsolète, des conflits d'écriture, de la latence et des coûts de calcul inutiles.
Pourquoi une base de données pour agents d'AI pose un problème différent
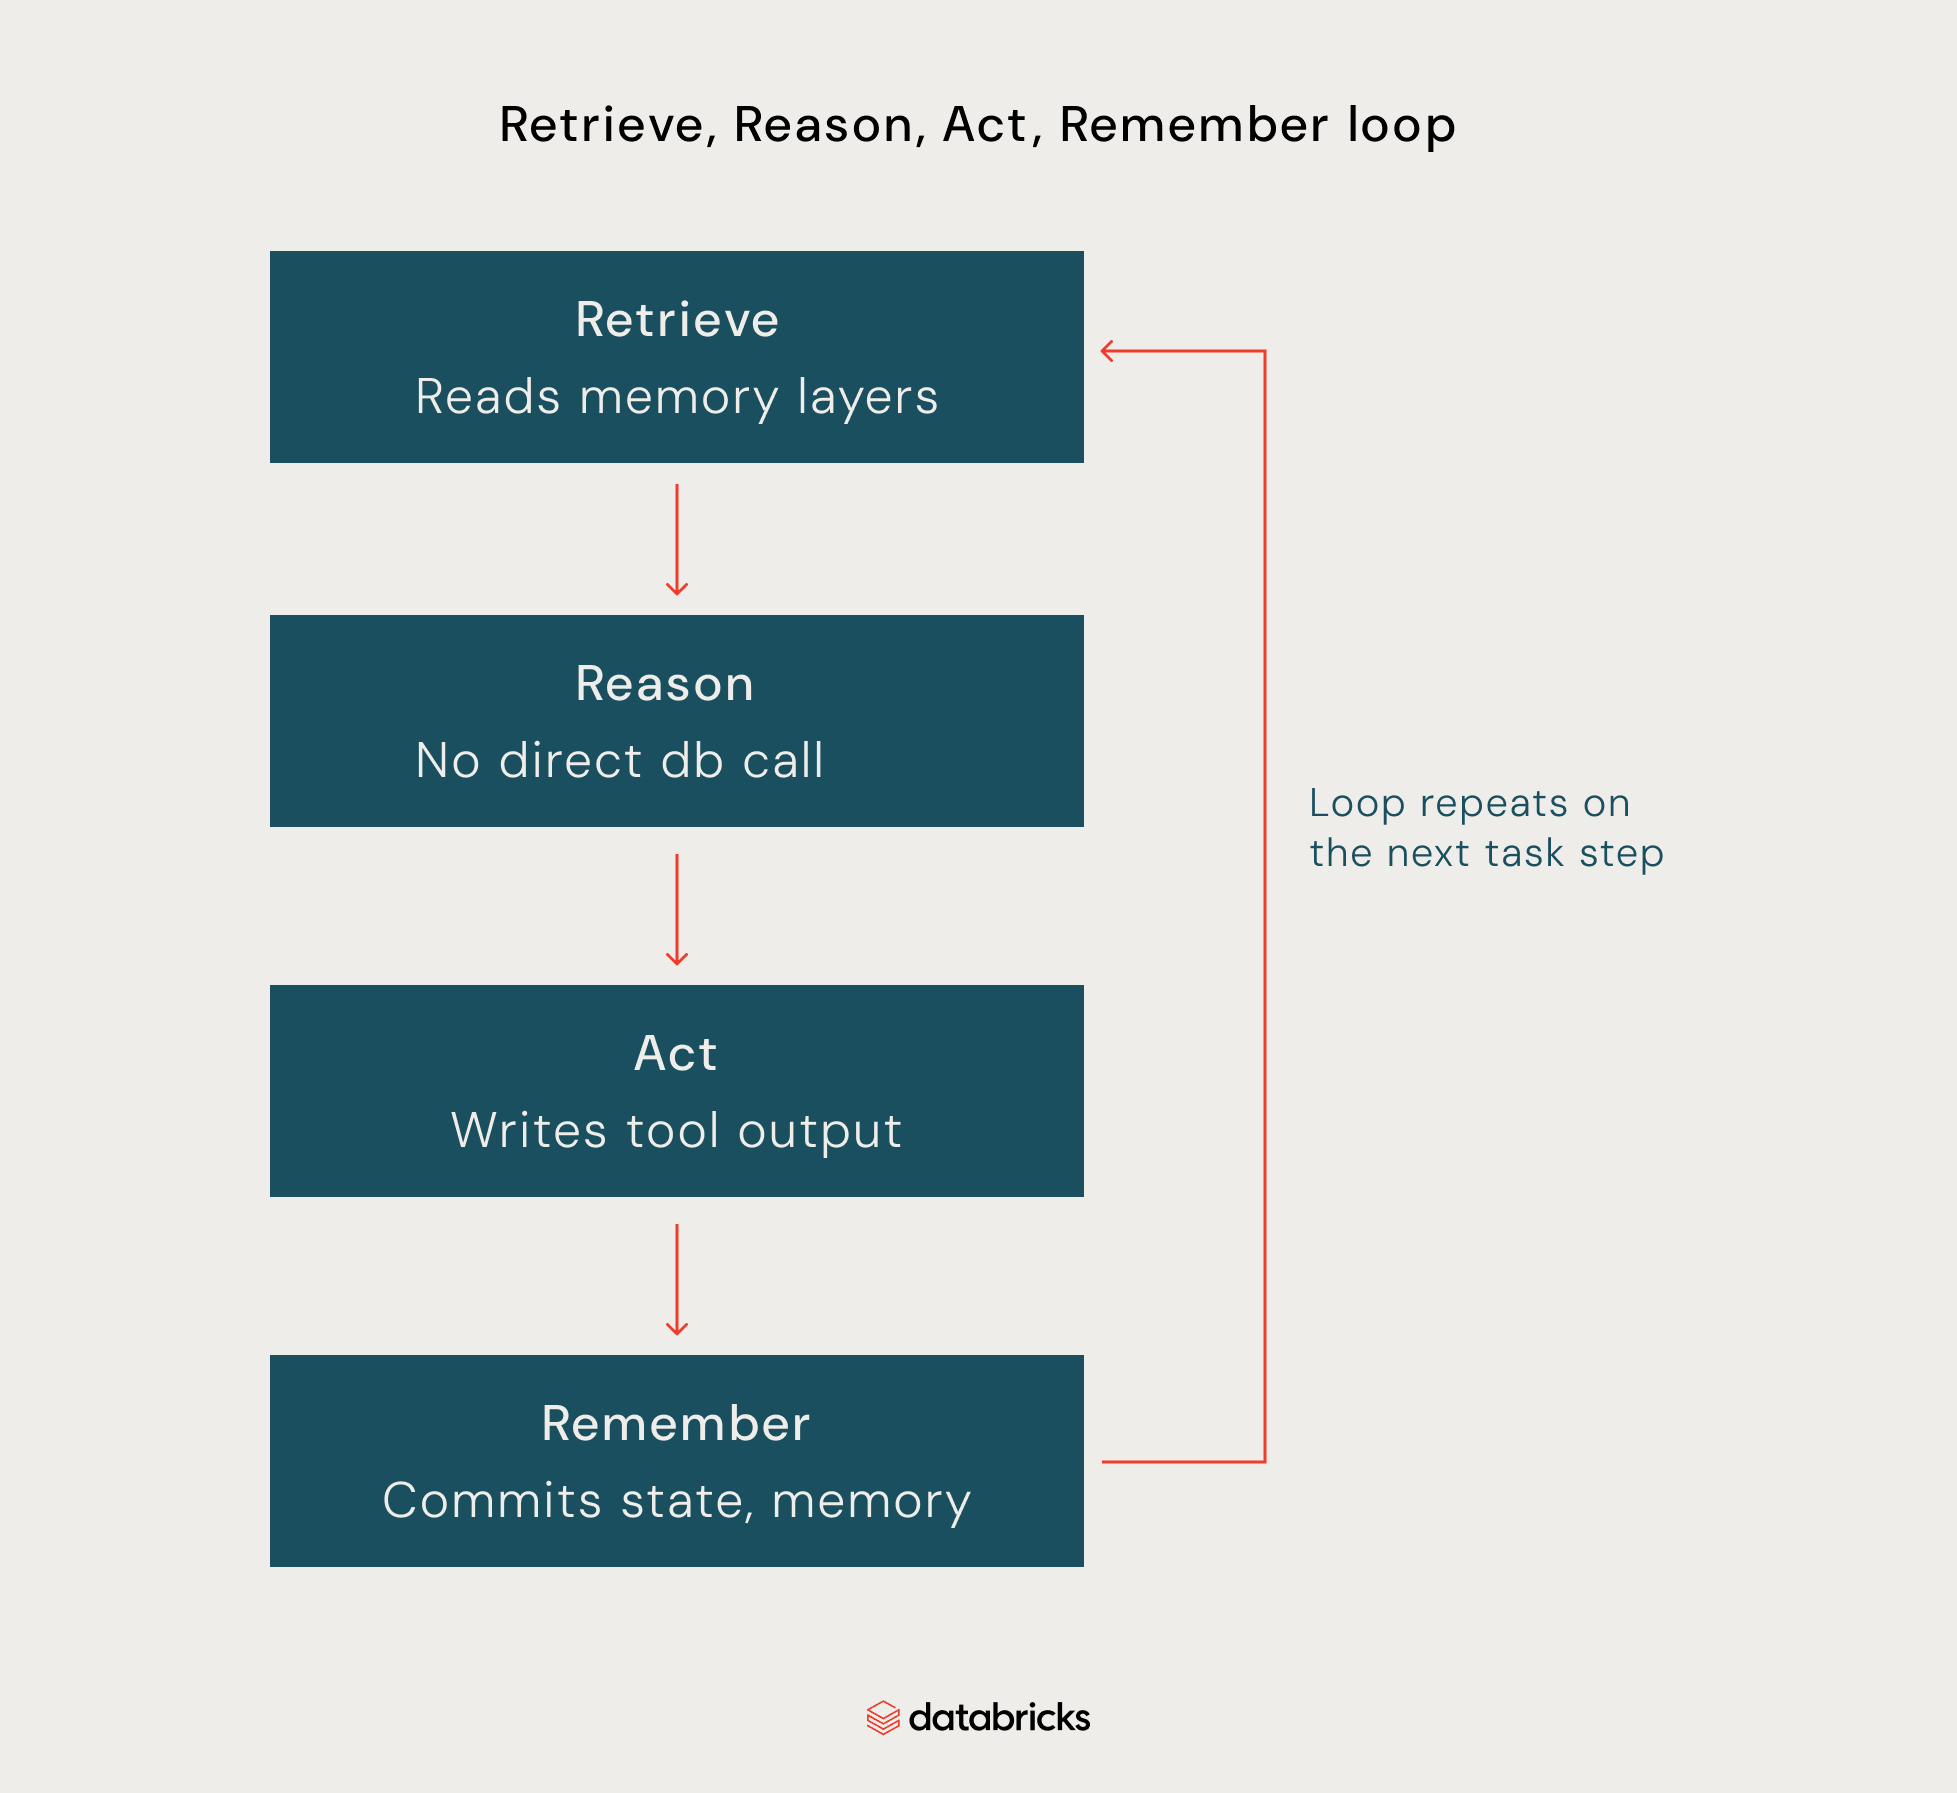
Un agent prêt pour la production doit se souvenir de ce qu'il a déjà fait, reprendre une tâche là où il s'est arrêté et intégrer le bon contexte avant d'agir. Associez-le à la mauvaise base de données, et cette mémoire peut devenir obsolète, incomplète ou incohérente.
Pour y parvenir, les agents en production s'appuient sur quatre couches de mémoire :
- Mémoire à court terme : la mémoire de travail en contexte disponible lors de l'interaction en cours, y compris les messages récents, les informations récupérées et les résultats des outils.
- Mémoire épisodique : les interactions passées qui permettent à un agent de se rappeler les conversations précédentes, les préférences de l'utilisateur et les tâches accomplies.
- Mémoire procédurale : les workflows, les définitions d'outils et les instructions qui guident la réalisation des tâches, qu'ils soient stockés en externe ou intégrés au modèle.
- État opérationnel : le statut en temps réel de la tâche, y compris les étapes terminées et en attente, les sorties d'outils et les points de contrôle pour reprendre le travail plus tard.
Il s'agit d'une charge de travail plus complexe que celle d'une application classique, qui envoie une requête à la base de données puis passe à autre chose. La plupart des bases de données de production sont des bases de données opérationnelles, également appelées systèmes de traitement des transactions en ligne (OLTP), construites autour de ce même modèle d'une requête à la fois. Un agent ne fonctionne pas ainsi. Il enchaîne les lectures et les écritures au sein d'une même tâche, sans pause humaine, pendant que des centaines d'autres agents font de même.
Les 5 critères d'évaluation d'une base de données pour les charges de travail des agents d'AI
Lors de la sélection d'une base de données pour les agents d'AI, plusieurs critères entrent en ligne de compte, mais ces cinq-là méritent d'être évalués quel que soit le fournisseur envisagé, qu'il soit géré ou auto-hébergé.
Une branche par agent : tester en toute sécurité avec des données réelles
Tester un agent uniquement par rapport à des données synthétiques revient à tester un système de support avec une poignée de comptes clients parfaitement formatés. Il peut se comporter exactement comme prévu, mais les comptes réels sont toujours plus complexes. Les équipes de données finissent par se heurter à des champs manquants, des enregistrements incohérents, des données obsolètes et des cas limites qui n'ont jamais été intégrés dans leurs jeux de tests.
C'est pourquoi nous recommandons de considérer les tests isolés sur des données réelles comme un critère d'évaluation de la base de données. L'objectif est que l'agent travaille avec un état similaire à la production sans lui donner la possibilité de modifier cette dernière. L'un des moyens d'obtenir cette isolation est le branching sans copie, qui permet aux développeurs de créer un environnement distinct sans avoir à maintenir une seconde copie complète de la base de données.
Lakebase Projects est conçu pour gérer ce type de développement et de test isolés en permettant aux développeurs de créer des branches à partir de données de production sans copier les données sous-jacentes. La création d'une branche pour une base de données de production à l'échelle du téraoctet prend environ une seconde, sans coût de stockage supplémentaire tant que la branche ne diverge pas de son parent.
Mise à l'échelle à zéro : comment la tarification serverless modifie l'économie des agents
Chaque année, 27 % des dépenses cloud sont gaspillées, et les ressources de calcul inactives et sous-utilisées en sont systématiquement la cause principale. Les bases de données d'agents en sont un parfait exemple. La plupart des agents ne fonctionnent pas en continu. Ils s'activent, effectuent une tâche, écrivent les résultats, puis se mettent en veille jusqu'à la prochaine requête. Payer pour des ressources de calcul dédiées 24 heures sur 24 revient à payer pour ce même problème de calcul inactif sur chaque base de données d'agent exécutée par une équipe.
Un modèle serverless de mise à l'échelle à zéro résout ce problème en suspendant les ressources de calcul après une période sans connexion active et en les reprenant lorsque le travail recommence. Ainsi, les coûts s'alignent sur l'utilisation réelle plutôt que sur le temps d'inactivité. Cependant, la vitesse de démarrage compte tout autant que les économies. Un agent qui attend 20 ou 30 secondes que sa base de données s'active n'est pas viable, en particulier lorsqu'il répond à un utilisateur ou attend le prochain appel d'outil.
Lakebase utilise ce modèle pour Postgres, avec une reprise du calcul en quelques centaines de millisecondes lors d'une nouvelle requête. Cela permet de maintenir un délai de démarrage suffisamment court pour que la mise à l'échelle à zéro fonctionne avec des charges de travail d'agents interactives.
Recherche hybride : récupérer des informations sur les quatre couches de mémoire en une seule requête
La recherche vectorielle seule ressemble à un bibliothécaire qui ne pourrait chercher que par « ce qui semble similaire », et jamais par une cote exacte. Demandez-lui de trouver documents sur l'architecture des bases de données, et il s'en sortira très bien. Demandez-lui l'enregistrement avec l'ID de compte 48291, et il n'aura aucun moyen fiable de le trouver. La similarité sémantique n'est pas conçue pour les correspondances exactes.
C'est la lacune à laquelle se heurtent de nombreux pipelines de génération augmentée par récupération (RAG) lorsqu'ils s'appuient uniquement sur la recherche vectorielle. La recherche hybride comble ce vide en combinant la similarité vectorielle, la correspondance de mots-clés et le filtrage des métadonnées dans une seule requête, au lieu d'assembler des résultats provenant de systèmes distincts. Si vous divisez cela entre un index vectoriel et un stockage relationnel, l'agent effectue deux appels au lieu d'un. Les systèmes peuvent se désynchroniser, et chaque étape supplémentaire ajoute une latence que la boucle d'un agent ne peut pas toujours absorber. La récupération doit s'effectuer bien en dessous de 100 millisecondes pour rester exploitable au sein d'un cycle de raisonnement rapide.
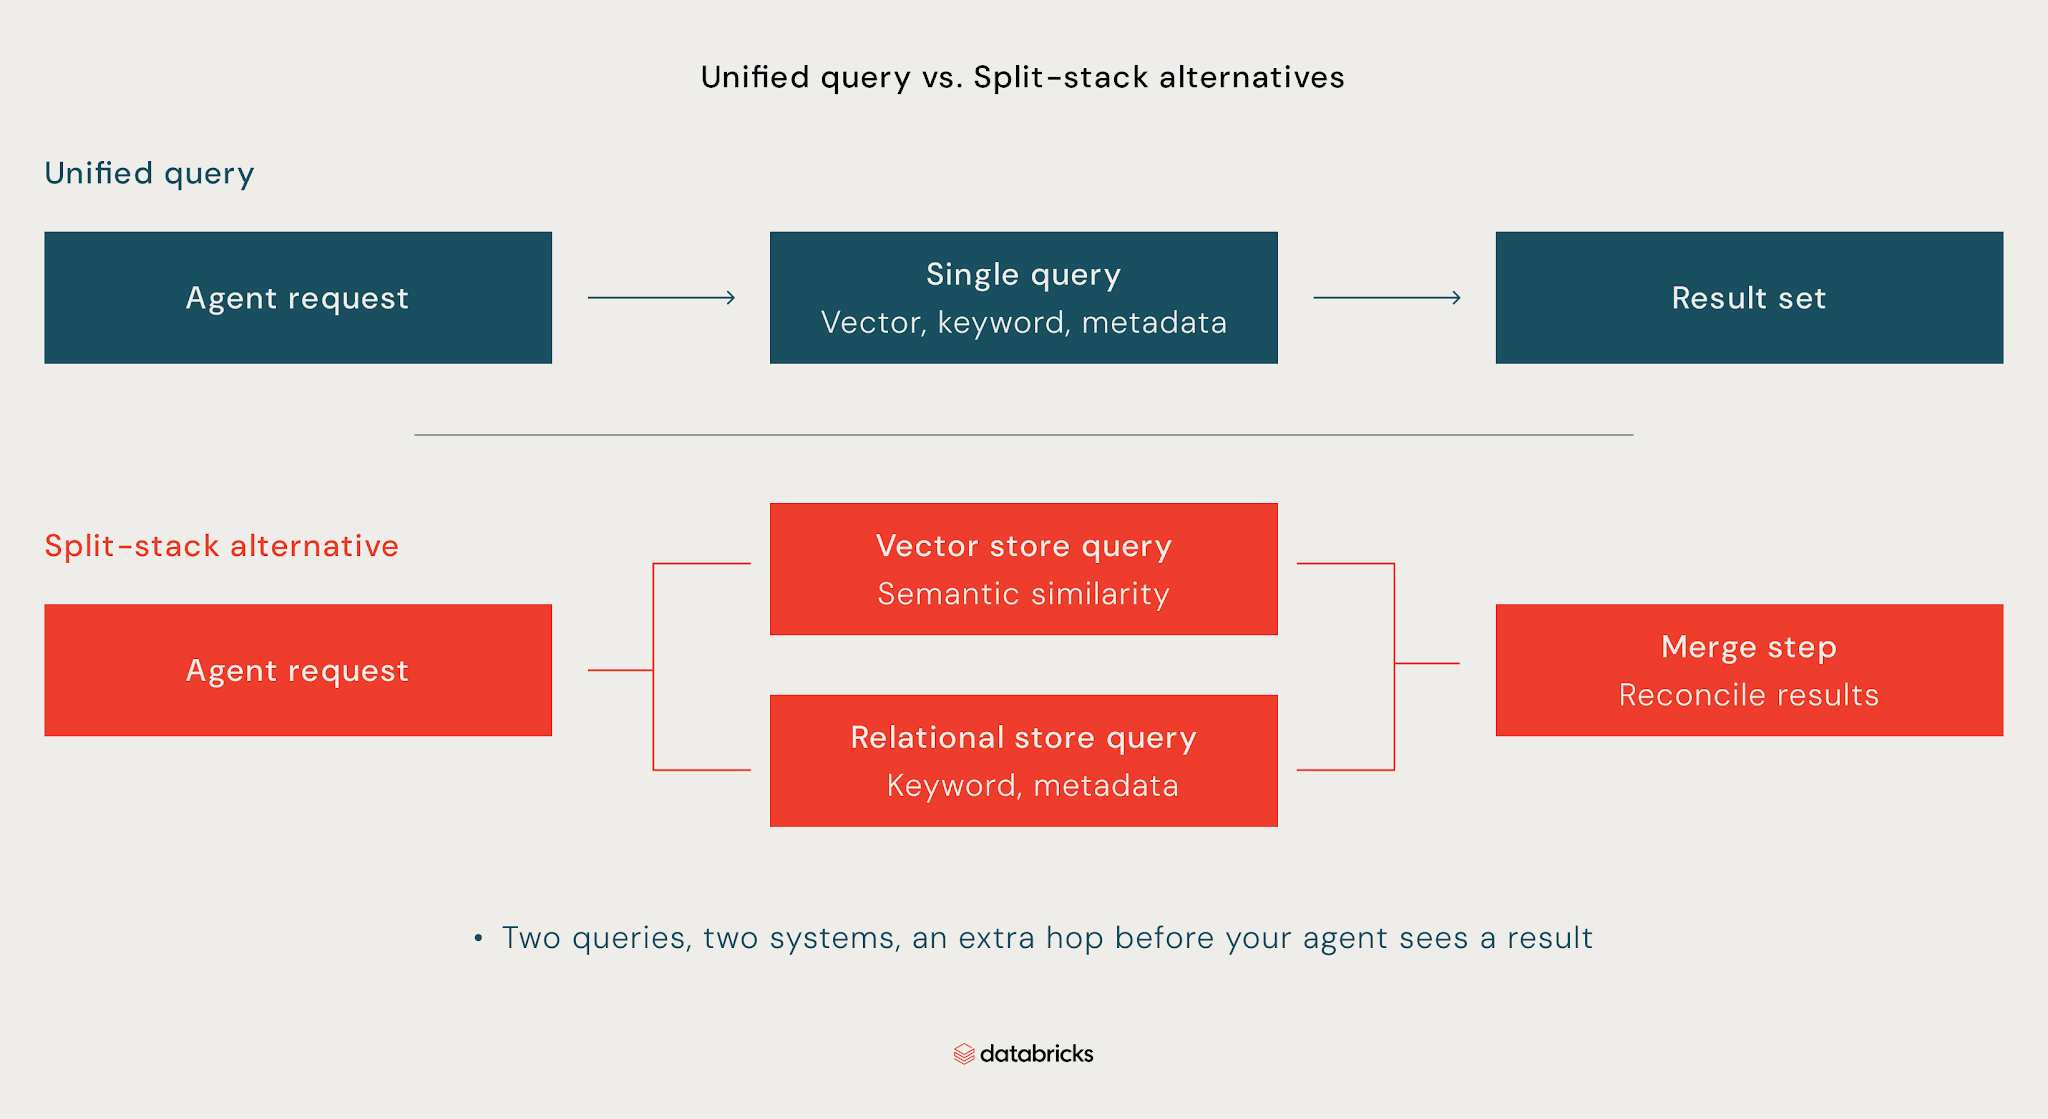
Lakebase Search exécute des requêtes vectorielles, de mots-clés et de métadonnées sur les mêmes tables Postgres où résident déjà les données opérationnelles, de sorte qu'il n'y a pas de second système susceptible de se désynchroniser. C'est son architecture LTAP qui maintient ces données à jour, avec des performances d'écriture jusqu'à 5 fois plus rapides que le Postgres standard. Cela signifie que ce qu'un agent vient d'écrire peut être disponible pour la récupération presque immédiatement.
Garanties ACID pour les systèmes multi-agents
Imaginez deux agents de support mettant à jour le même dossier client en même temps. L'un résout un problème de facturation et ajuste le niveau d'abonnement, tandis que l'autre enregistre un remboursement. Sans une isolation appropriée, une mise à jour peut écraser l'autre, laissant le dossier dans un état qu'un des deux agents n'avait prévu.
C'est pourquoi les garanties transactionnelles doivent être un critère absolu lors de l'évaluation d'une base de données pour les charges de travail multi-agents. ACID offre aux développeurs quatre propriétés à vérifier :
- Atomicité : une transaction s'exécute entièrement ou pas du tout.
- Cohérence : la base de données reste valide avant et après chaque transaction.
- Isolation : les transactions simultanées n'interfèrent pas avec le travail des autres de manière inattendue.
- Durabilité : une écriture validée survit à une panne ou à un redémarrage.
Pour les systèmes multi-agents, les questions pratiques importent plus que l'acronyme. La validation de la sortie d'un outil peut-elle se faire de manière atomique, de sorte qu'une action à moitié terminée ne soit jamais considérée comme complète ? Que se passe-t-il lorsque deux agents mettent à jour le même enregistrement ? Quels niveaux d'isolation la base de données prend-elle en charge ? Un agent peut-il reprendre après un redémarrage sans perdre l'état validé ?
Lors de la comparaison des bases de données, nous vous recommandons de vérifier les niveaux d'isolation et la sémantique de validation qu'elles prennent réellement en charge, et pas seulement si elles prétendent « prendre en charge les transactions ». Dès lors que plusieurs agents partagent des données opérationnelles, ces détails déterminent si le travail simultané reste prévisible.
Plateforme unifiée : les données opérationnelles dans la stack d'AI sans ETL
Un agent qui attend qu'un pipeline se mette à jour prend des décisions basées sur des données obsolètes. Le temps que ce pipeline s'exécute, l'enregistrement sur lequel il agit a peut-être déjà changé à nouveau. Lors de l'évaluation d'une base de données, examinez à quel point elle connecte étroitement les données opérationnelles avec les systèmes d'analyse et d'AI qui en dépendent.
Une plateforme unifiée conserve les écritures opérationnelles et les lectures analytiques sur les mêmes données, sans qu'un pipeline d'extraction, de transformation et de chargement (ETL) distinct ne s'interpose entre elles. Vos agents peuvent travailler avec des données à jour, tandis que vos modèles peuvent utiliser des résultats en direct au lieu d'attendre un traitement par lots. Les équipes de données conservent également la gouvernance et les pistes d'audit sur la même plateforme, plutôt que d'envoyer les charges de travail des agents vers un système distinct plus difficile à suivre. Unity Catalog est ce qui applique cette couche de gouvernance sur les données opérationnelles et analytiques dans Databricks. L'expérience de Superhuman montre ce que cela donne en pratique : le remplacement des pipelines de synchronisation personnalisés vers une couche de mise en cache et un magasin NoSQL géré par une plateforme unifiée a permis de réduire le délai d'intégration des données de près de trois mois à environ deux semaines.
easyJet a adopté une approche similaire pour sa pile de gestion des revenus. Depuis son passage à Lakebase, la compagnie aérienne capture les activités de réservation et de tarification en direct ainsi que les analyses sur les mêmes données du lakehouse, a consolidé plus de 100 dépôts Git en deux, et a réduit les cycles de développement d'applications de six à neuf mois à environ quatre.
Lakebase conserve les données opérationnelles dans le lakehouse Databricks, de sorte que les mêmes données peuvent prendre en charge les charges de travail transactionnelles et les analyses en aval sans pipeline ETL distinct.
Le guide pratique de l'IA agentique pour l'entreprise

Grille d'évaluation des bases de données pour agents IA
Soumettez n'importe quel candidat à ces cinq vérifications, et vous saurez en quelques minutes où il tient la route et où il échoue, quel que soit le fournisseur que vous comparez.
| Critère | Ce qu'il faut tester | Seuil minimal | Signaux d'alarme | Comportement de Lakebase |
|---|---|---|---|---|
| Branche par agent | Pouvez-vous créer une branche isolée à partir de données de production réelles sans faire de copie complète ? | La création de la branche se termine en quelques secondes, pas en minutes | Nécessite une copie complète de la base de données, ou prend plus de temps que votre cycle de test | Crée des branches d'une base de données à l'échelle du téraoctet en une seconde environ, sans coût de stockage jusqu'à ce qu'elle diverge |
| Mise à l'échelle à zéro | Le calcul s'interrompt-il après une période d'inactivité et reprend-il assez rapidement pour rester utilisable ? | Le calcul reprend en moins d'une seconde, sans étape de réveil manuel | Le démarrage à froid prend plus de 10 secondes, ou les bases de données inactives sont toujours facturées au tarif plein | Se réactive en quelques centaines de millisecondes et ne facture rien lorsqu'elle est suspendue |
| Recherche hybride | Une seule requête peut-elle combiner la similarité vectorielle, la correspondance de mots-clés et un filtre structuré ? | Requête unique, moins de 100 ms | Nécessite des appels distincts à un magasin de vecteurs et à un magasin relationnel, puis une fusion manuelle | Exécute des requêtes de vecteurs, de mots-clés et de métadonnées sur les mêmes tables Postgres |
| Garanties ACID | Deux agents peuvent-ils écrire sur le même enregistrement en même temps sans perdre l'une ou l'autre écriture ? | Aucune perte d'écriture ; l'isolation tient face à une charge concurrente | Écritures écrasées silencieusement, ou isolation qui se dégrade en cas de concurrence | Garanties transactionnelles Postgres standard, non affectées par la charge concurrente des agents |
| Plateforme unifiée | Combien de temps faut-il pour qu'une nouvelle écriture devienne disponible pour l'analyse ? | Pas d'étape ETL, ou un délai mesuré en secondes, pas en heures | Nécessite un pipeline planifié avant que les données ne puissent être interrogées ailleurs | Chaque écriture devient interrogeable dans le lakehouse Databricks sans pipeline distinct |
Une base de données qui échoue à plus d'un de ces seuils minimaux représente un risque pour la production dès lors que vous exécutez des agents à grande échelle, et non un simple compromis mineur que vous pourrez contourner plus tard.
Conclusion
Le choix d'une base de données pour les agents IA dépend de l'adéquation avec la charge de travail, et non des listes de fonctionnalités. Les cinq critères de ce guide offrent aux développeurs et aux équipes de données un cadre pratique pour évaluer n'importe quelle base de données avant de l'engager en production. Si un candidat ne peut pas répondre à ces exigences aujourd'hui, les agents en production finiront par révéler ces lacunes à mesure qu'ils prendront en charge plus d'utilisateurs, plus de tâches et plus de travail concurrent.
Si vous évaluez une base de données pour des agents IA, découvrez Lakebase pour voir comment Databricks prend en charge les charges de travail transactionnelles, la création de branches, la mise à l'échelle serverless, la recherche hybride et l'accès unifié aux données opérationnelles.
Foire aux questions
Les agents IA ont-ils besoin d'une base de données ?
Oui. La plupart des implémentations d'agents ne conservent pas le contexte à court terme, l'historique épisodique, les connaissances procédurales ou l'état des tâches en direct d'un appel à l'autre, à moins que vous ne les persistiez et ne les rechargiez explicitement. Sans base de données sous-jacente, votre agent perd généralement ce contexte dès la fin d'une session et ne peut pas reprendre une tâche là où il l'avait laissée.
Une base de données vectorielle est-elle suffisante pour les agents IA ?
Pas à elle seule. Une base de données vectorielle gère bien la recherche sémantique, mais votre agent doit également écrire et mettre à jour l'état opérationnel, appliquer l'intégrité transactionnelle sur les écritures concurrentes et filtrer sur des champs structurés qu'une recherche par similarité ne peut pas capturer de manière fiable. La recherche sémantique couvre une partie des besoins d'un agent, pas l'ensemble de la charge de travail.
Quelle est la meilleure base de données pour le RAG dans les agents IA ?
Il n'y a pas de réponse unique. Pour le RAG dans les agents IA, la meilleure base de données est celle qui peut exécuter une recherche hybride en une seule requête, maintenir la récupération suffisamment rapide pour la boucle de l'agent et rester assez à jour pour éviter une mémoire obsolète.
Comment les systèmes multi-agents modifient-ils les exigences en matière de base de données ?
Dès que plusieurs agents écrivent simultanément dans des données partagées, l'intégrité transactionnelle cesse d'être facultative. Votre base de données doit isoler les écritures concurrentes afin que la mise à jour d'un agent n'écrase pas silencieusement celle d'un autre, et elle doit valider les sorties des outils de manière atomique afin qu'une action à moitié terminée ne soit jamais considérée comme achevée.
Quelle est la différence entre l'OLTP et l'OLAP pour les agents IA ?
Les actions en direct de votre agent, l'écriture des sorties d'outils, la mise à jour de l'état et la création de points de contrôle de progression sont des charges de travail OLTP. Les rapports et l'entraînement des modèles par-dessus ces données sont des charges de travail OLAP. Les agents ont généralement besoin des deux pour travailler à partir des mêmes données sans pipeline entre elles. C'est pourquoi les critères de ce guide se concentrent sur les bases de données capables de gérer à la fois le travail des agents à forte intensité de transactions et les analyses en aval à partir des mêmes données.
Postgres est-il adapté aux agents IA ?
Postgres standard offre des garanties ACID solides et un écosystème mature, couvrant une partie des besoins de votre agent. Il ne fournit pas de lui-même la création de branches sans copie, la mise à l'échelle du calcul à zéro ou un accès opérationnel et analytique unifié ; ceux-ci dépendent de la plateforme construite autour.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.