Postgres géré : ce que Lakebase prend réellement en charge à votre place
Découvrez ce que Lakebase automatise réellement dans Postgres géré — application de correctifs, mise à l'échelle, basculement et sauvegardes — et ce qui relève toujours de votre responsabilité.
- Postgres géré devrait décharger l'équipe de base de données des opérations de routine telles que l'application de correctifs, la mise à l'échelle, le basculement et les sauvegardes.
- Lakebase exécute PostgreSQL sur une infrastructure serverless avec mise à l'échelle automatique, mise à l'échelle à zéro, restauration à un instant dans le passé, branching, pgvector et PostGIS.
- Lakebase gère la plupart des opérations de Postgres géré au sein d'une région, tandis que la reprise après sinistre interrégionale nécessite toujours des procédures de restauration gérées par le client.
Chaque fournisseur de Postgres se qualifie de "géré". Peu d'entre eux s'accordent sur ce que ce mot recouvre. Pour certains, cela signifie qu'ils corrigent le système d'exploitation (OS) et laissent le reste à l'équipe de base de données. Pour d'autres, cela signifie que la base de données s'adapte, gère les pannes et se sauvegarde d'elle-même sans que quiconque dans l'équipe n'ait à toucher à un fichier de configuration.
Postgres géré est un service de base de données dans lequel le fournisseur exploite l'infrastructure sous-jacente et gère les opérations de base de données essentielles telles que l'application de correctifs, la mise à l'échelle, le basculement et les sauvegardes, de sorte que l'équipe de base de données passe moins de temps sur la maintenance et plus de temps à concevoir l'application qui repose dessus. Plus le fournisseur prend en charge ces opérations, moins l'administration de la base de données incombe au client.
Cette distinction gagne en importance à mesure que Postgres s'intègre dans les applications d'AI. La base de données peut désormais contenir l'état de l'application, l'historique des conversations, les embeddings et les données d'agent aux côtés des charges de travail transactionnelles traditionnelles, de sorte que la surface opérationnelle s'étend bien au-delà du simple maintien en fonctionnement de la base de données.
Lakebase Postgres apporte cette approche gérée au Postgres serverless, en combinant la mise à l'échelle automatique, la compatibilité PostgreSQL, la récupération et les intégrations Databricks. La question est de savoir quelle quantité de travail opérationnel elle élimine réellement.
TL;DR
- Postgres géré doit décharger l'équipe de base de données des opérations de routine telles que l'application de correctifs, la mise à l'échelle, le basculement et les sauvegardes.
- Lakebase s'exécute sur une infrastructure serverless PostgreSQL avec mise à l'échelle automatique, mise à l'échelle à zéro (scale-to-zero), instantanés automatiques, restauration à un instant précis (PITR), création de branches (branching) et prise en charge d'extensions populaires comme pgvector et PostGIS.
- Lakebase gère la plupart des opérations Postgres gérées au sein d'une région.
Ce que signifie réellement un Postgres géré
Pensez au Postgres géré comme si vous remettiez les clés d'une base de données. La part de responsabilité déléguée par une équipe dépend du fournisseur. D'un côté, l'équipe de base de données gère toujours le serveur, les sauvegardes, le basculement et la mise à l'échelle. De l'autre, un service entièrement géré s'occupe du travail opérationnel pour l'équipe, et pas seulement de l'infrastructure sous-jacente. La plupart des fournisseurs se situent entre les deux, gérant la VM et le réseau tout en laissant certaines opérations de base de données, décisions de mise à l'échelle, configurations de basculement et politiques de sauvegarde à la charge de l'équipe.
Un fournisseur peut corriger l'OS et qualifier la base de données de gérée alors que l'équipe reste responsable du travail qui la maintient disponible et récupérable.
L'application de correctifs, la mise à l'échelle, le basculement et les sauvegardes sont de bons critères pour tracer cette limite. Un service géré détermine également la part de sécurité, de récupération, de migration, de charges de travail d'AI et d'outils de développement autour de Postgres que votre équipe doit encore prendre en charge.
Postgres géré est un service dans lequel le fournisseur exploite l'infrastructure de la base de données et gère les tâches opérationnelles de base telles que l'application de correctifs, la mise à l'échelle, le basculement et les sauvegardes. Un service entièrement géré assume la responsabilité de ces opérations, afin que votre équipe puisse se concentrer sur le développement avec Postgres plutôt que sur sa gestion.
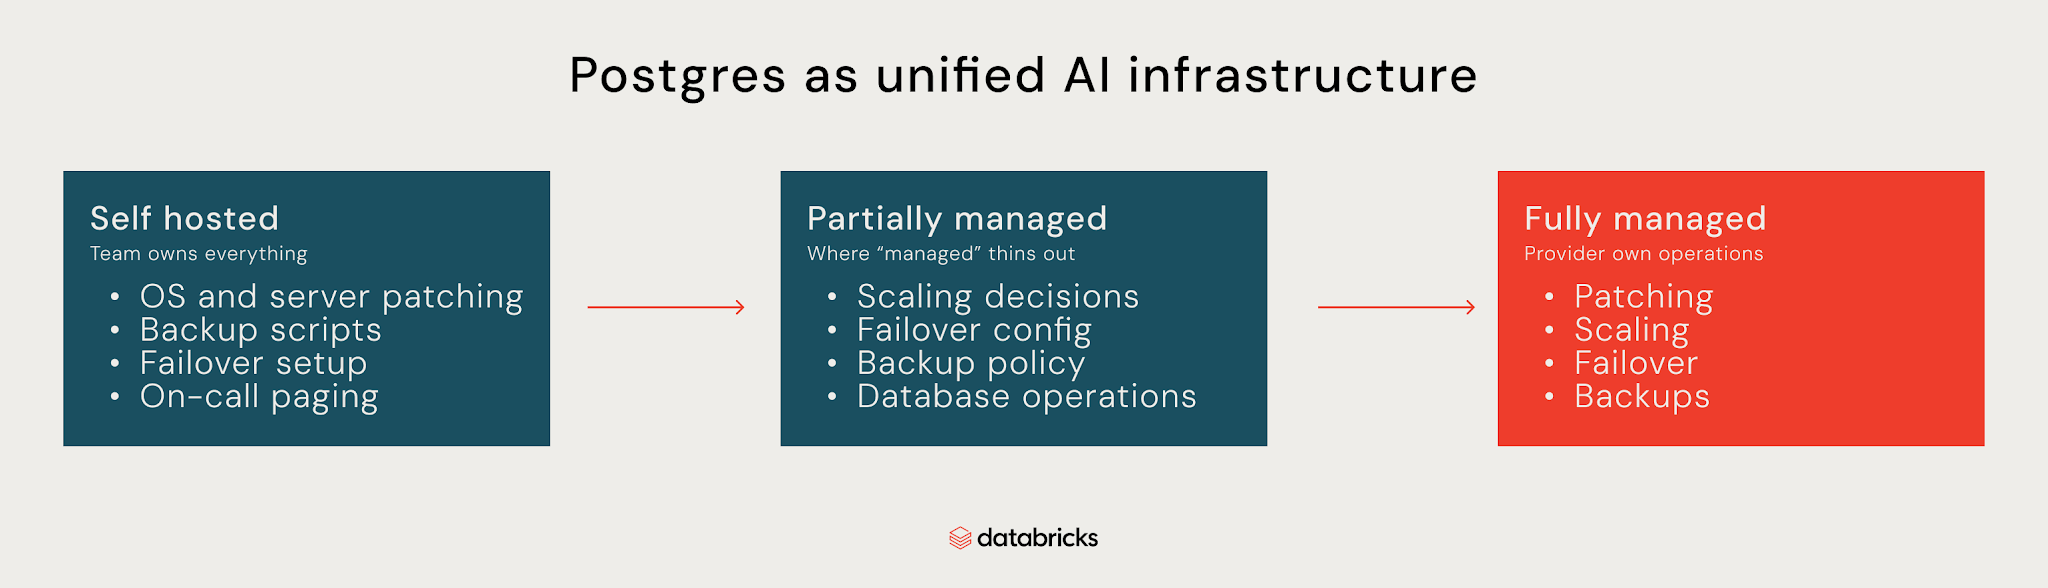
Ce qu'un Postgres géré devrait prendre en charge
Le test le plus clair pour situer un service sur ce spectre est de savoir s'il décharge l'équipe de ces quatre tâches opérationnelles :
Maintenance et application de correctifs
Un fournisseur géré doit appliquer les correctifs de l'OS, les versions mineures de PostgreSQL et la maintenance de routine comme l'optimisation du vacuum (vacuum tuning) sans que l'équipe de base de données n'ait à planifier ou à exécuter quoi que ce soit manuellement — à l'inverse d'un Postgres auto-hébergé, où tout repose sur elle. Les mises à niveau de versions majeures nécessitent toujours une planification, car les extensions et le comportement des applications peuvent changer, mais un bon fournisseur réduit cette implication au minimum et rend le parcours de mise à niveau clair.
Mise à l'échelle
La capacité doit s'adapter à la charge de travail sans que les ingénieurs de plateforme n'aient à redimensionner l'infrastructure manuellement : mise à l'échelle verticale pour plus de calcul ou de mémoire, réplicas de lecture pour le trafic de lecture, et idéalement une mise à l'échelle serverless qui élimine complètement cette décision. L'autoscaling de Lakebase en est un exemple en production, permettant des écritures Postgres 5 fois plus rapides que le Postgres standard. Le véritable test est un pic de trafic : si l'équipe de base de données surveille l'utilisation et attend un redimensionnement, la mise à l'échelle reste son travail.
Haute disponibilité et basculement
La base de données doit rester opérationnelle en cas de défaillance de l'infrastructure, sans qu'un ingénieur d'astreinte n'ait à promouvoir manuellement un réplica à 2 heures du matin. Certains fournisseurs gèrent cela avec des instances de secours (standby) qui prennent le relais automatiquement ; d'autres, comme Lakebase, remplacent purement et simplement le calcul défaillant puisqu'il ne conserve aucun état local durable. Pourtant, tous les fournisseurs ne basculent pas à la même vitesse ni avec la même perte de données. Certains perdent quelques secondes d'écritures au cours du processus ; d'autres n'en perdent aucune. C'est le détail qui mérite d'être vérifié avant de faire confiance à l'étiquette, notamment si le basculement existe et ce qu'il advient des écritures en cours lorsqu'il se déclenche.
Sauvegardes et récupération
Les sauvegardes automatiques et un processus de restauration que les équipes peuvent exécuter sans ticket de support constituent la base. La restauration à un instant précis (PITR) permet de restaurer à un moment spécifique plutôt qu'au dernier instantané, ce qui est crucial lorsqu'une mauvaise migration corrompt les données en milieu d'après-midi. L'arrêt complet d'une région entière est un problème plus important, mesuré par le Recovery Time Objective (RTO), c'est-à-dire la durée de l'interruption, et le Recovery Point Objective (RPO), la quantité de données que vous pouvez vous permettre de perdre. Un fournisseur qui ne définit pas de chiffres pour ces deux indicateurs n'a pas de plan de reprise d'activité, juste une supposition.
Comment Postgres géré protège vos données
Une base de données gérée doit chiffrer les données au repos et en transit, contrôler qui peut y accéder et donner aux équipes de données une visibilité sur l'activité de la base de données. Cela signifie :
- Chiffrement : Les données ont besoin d'être protégées au repos et en transit, sur le disque et lors de leur transfert entre votre application et la base de données. Le détail à vérifier est de savoir qui contrôle les clés, car certains fournisseurs gèrent entièrement le chiffrement de leur côté, ce qui devient un problème dès qu'une exigence de conformité ou une politique interne stipule que l'organisation doit les détenir. Les clés gérées par le client vous offrent ce contrôle tout en laissant les opérations de base de données sous-jacentes au fournisseur.
- Contrôle d'accès : Le contrôle d'accès basé sur les rôles gère les aspects fondamentaux, différents utilisateurs et services bénéficiant de privilèges différents, mais les systèmes de production ont souvent besoin de plus, et les secteurs gérant des données de paiement doivent en plus respecter des normes telles que la Payment Card Industry Data Security Standard (PCI DSS). Le contrôle d'accès basé sur les attributs via Unity Catalog étend encore ces politiques en prenant en compte les propriétés de l'utilisateur, de la ressource ou de la requête plutôt que de s'appuyer uniquement sur les rôles.
- Journaux d'audit : Sans visibilité sur qui a fait quoi et quand, enquêter sur un incident devient plus difficile, tout comme prouver la conformité. Les journaux d'audit doivent offrir par défaut aux équipes de données une visibilité sur l'activité de la base de données et de l'administration, et non être une fonctionnalité qu'elles doivent configurer, exploiter et maintenir en tant que pipeline distinct en plus de la base de données.
Éléments à prendre en compte lors de la migration d'une base de données PostgreSQL existante
Une migration peut sembler simple jusqu'à ce que la nouvelle base de données ne prenne pas en charge une extension, une configuration ou une fonctionnalité PostgreSQL dont dépend une application. Vérifiez les dépendances de l'application avant de déplacer quoi que ce soit. Voici les éléments clés à prendre en compte lors de la migration d'une base de données PostgreSQL existante :
- Compatibilité : Vérifiez si la configuration actuelle se comporte de la même manière sur la nouvelle plateforme : prise en charge de la version PostgreSQL, configuration personnalisée et hypothèses au niveau de l'application qui pourraient ne plus être valables une fois l'infrastructure modifiée. La compatibilité avec le protocole filaire Postgres standard signifie que les chaînes de connexion existantes, les mappeurs objet-relationnel (ORM), les pilotes et les outils ont de réelles chances de fonctionner sans modification de code.
- Extensions : C'est lors de la migration que les équipes découvrent si toutes les extensions dont dépend la base de données ont bien été transférées. Vérifiez donc la liste des extensions prises en charge par le fournisseur par rapport à celles réellement utilisées avant de vous engager. Il convient de vérifier pgvector pour les charges de travail d'AI ou d'embeddings, PostGIS est important pour les données géospatiales, et chaque autre extension dont dépend une application doit être vérifiée individuellement plutôt que de supposer qu'une extension populaire sera présente.
- Méthodes de migration : La migration basée sur un dump (exportation et restauration sur la nouvelle plateforme) est simple et convient aux bases de données de petite taille ou aux fenêtres de maintenance planifiées. La réplication logique maintient la source active tout en diffusant les modifications vers la destination, ce qui permet aux équipes d'effectuer la transition avec une interruption beaucoup plus courte une fois les deux synchronisées. Le bon choix dépend de la taille de la base de données, du volume d'écriture et du temps d'arrêt que l'entreprise peut absorber.
Le guide pratique de l'IA agentique pour l'entreprise

Postgres est-il adapté aux applications d'IA ?
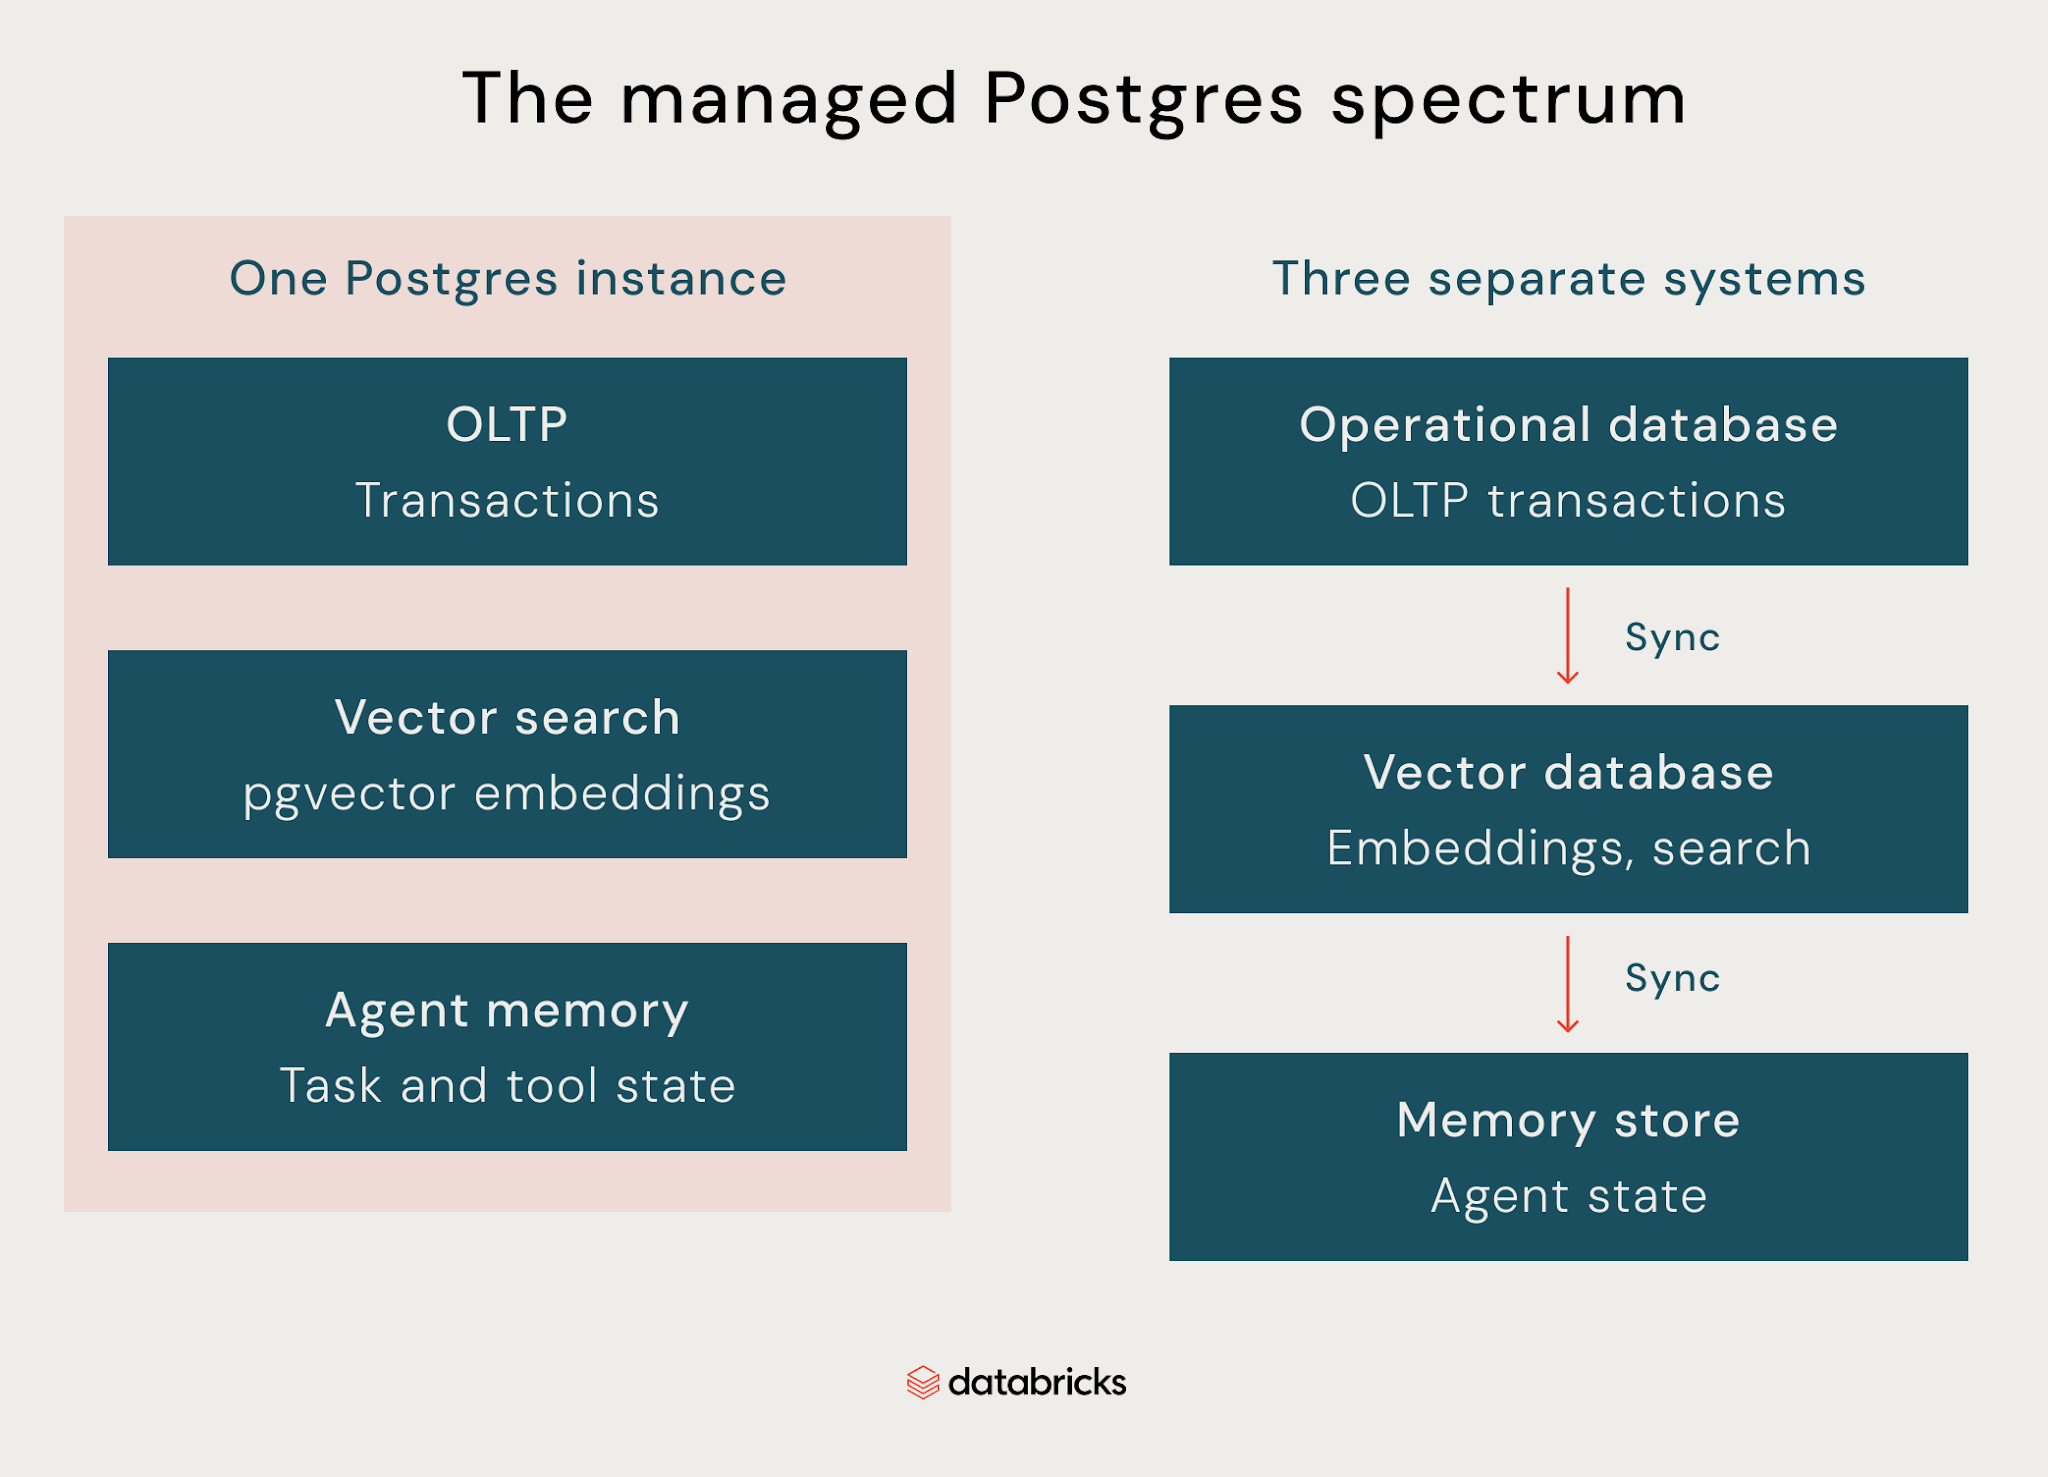
Postgres peut être un excellent choix pour les applications d'IA lorsqu'une application a besoin à la fois d'un état transactionnel et de la recherche vectorielle dans le même système. Cela repose sur quatre éléments : l'extension pgvector qui rend cela possible, la recherche vectorielle pour la récupération, la mémoire des grands modèles de langage (LLM) pour conserver l'état entre les requêtes, et les charges de travail des agents qui nécessitent les deux simultanément.
pgvector
pgvector ajoute un type de données vectorielles et un index de recherche de similarité directement dans Postgres, de sorte que les embeddings résident à côté du reste des données de votre application plutôt que dans un système distinct. Le compromis est qu'une base de données vectorielle séparée nécessite de synchroniser les embeddings et les données opérationnelles, ce qui devient un défi d'ingénierie en soi. pgvector élimine ce problème pour les charges de travail qui n'ont pas besoin d'un stockage vectoriel dédié.
Recherche vectorielle et recherche sémantique
pgvector vous permet de stocker des embeddings et d'utiliser des index de recherche des plus proches voisins approximatifs (ANN) pour trouver efficacement des vecteurs similaires à mesure que le jeu de données grandit, ce qui rend possible la recherche sémantique, la génération augmentée par récupération (RAG) et la correspondance basée sur le sens au sein de Postgres. La bonne stratégie d'indexation dépend toujours de la taille du jeu de données et des modèles de requêtes, pgvector ne dispense donc pas d'évaluer les performances pour votre charge de travail spécifique.
Mémoire des LLM
Les applications de LLM ont besoin d'un endroit pour conserver l'état entre les requêtes, notamment l'historique des conversations, les préférences des utilisateurs, les documents récupérés et les résultats des outils. Postgres peut stocker cet état sous forme de données relationnelles ordinaires tandis que pgvector gère les embeddings dans la même base de données. Pour les charges de travail nécessitant une récupération vectorielle spécialisée à très grande échelle, une base de données vectorielle dédiée peut toujours s'avérer judicieuse, mais de nombreuses applications d'IA peuvent regrouper l'état opérationnel et la récupération.
Charges de travail des agents
Les agents lisent et mettent à jour continuellement leur état au cours de leur exécution. Ils suivent les conversations, stockent les résultats intermédiaires et enregistrent les appels d'outils, ce qui fait de la base de données une partie intégrante de la couche d'exécution de l'agent, plutôt qu'un simple endroit où récupérer du contexte. Une base de données conçue pour les charges de travail des agents d'IA doit prendre en charge, au sein d'un seul système, à la fois cet état transactionnel en constante évolution et la récupération que l'agent utilise pour trouver le contexte pertinent.
Postgres pour le développement d'applications
Au-delà de l'exécution des charges de travail en production, Postgres doit s'adapter à la manière dont votre équipe conçoit réellement ses applications. Cela signifie que les connexions ne doivent pas devenir un goulot d'étranglement lors de la mise à l'échelle, et que tester les modifications de schéma ne doit pas mettre en péril les données de production.
Gestion des connexions
Postgres a une limite définie sur le nombre de connexions simultanées qu'il peut gérer, et les instances d'application qui évoluent horizontalement peuvent atteindre cette limite avant que le calcul ou le stockage ne devienne le goulot d'étranglement. Le regroupement de connexions (connection pooling) réutilise les connexions établies à la base de données pour plusieurs requêtes au lieu d'en ouvrir une nouvelle à chaque fois. Dans un service managé, ce qui importe est de savoir si ce regroupement est intégré ou si votre équipe doit le gérer séparément.
Branching de base de données
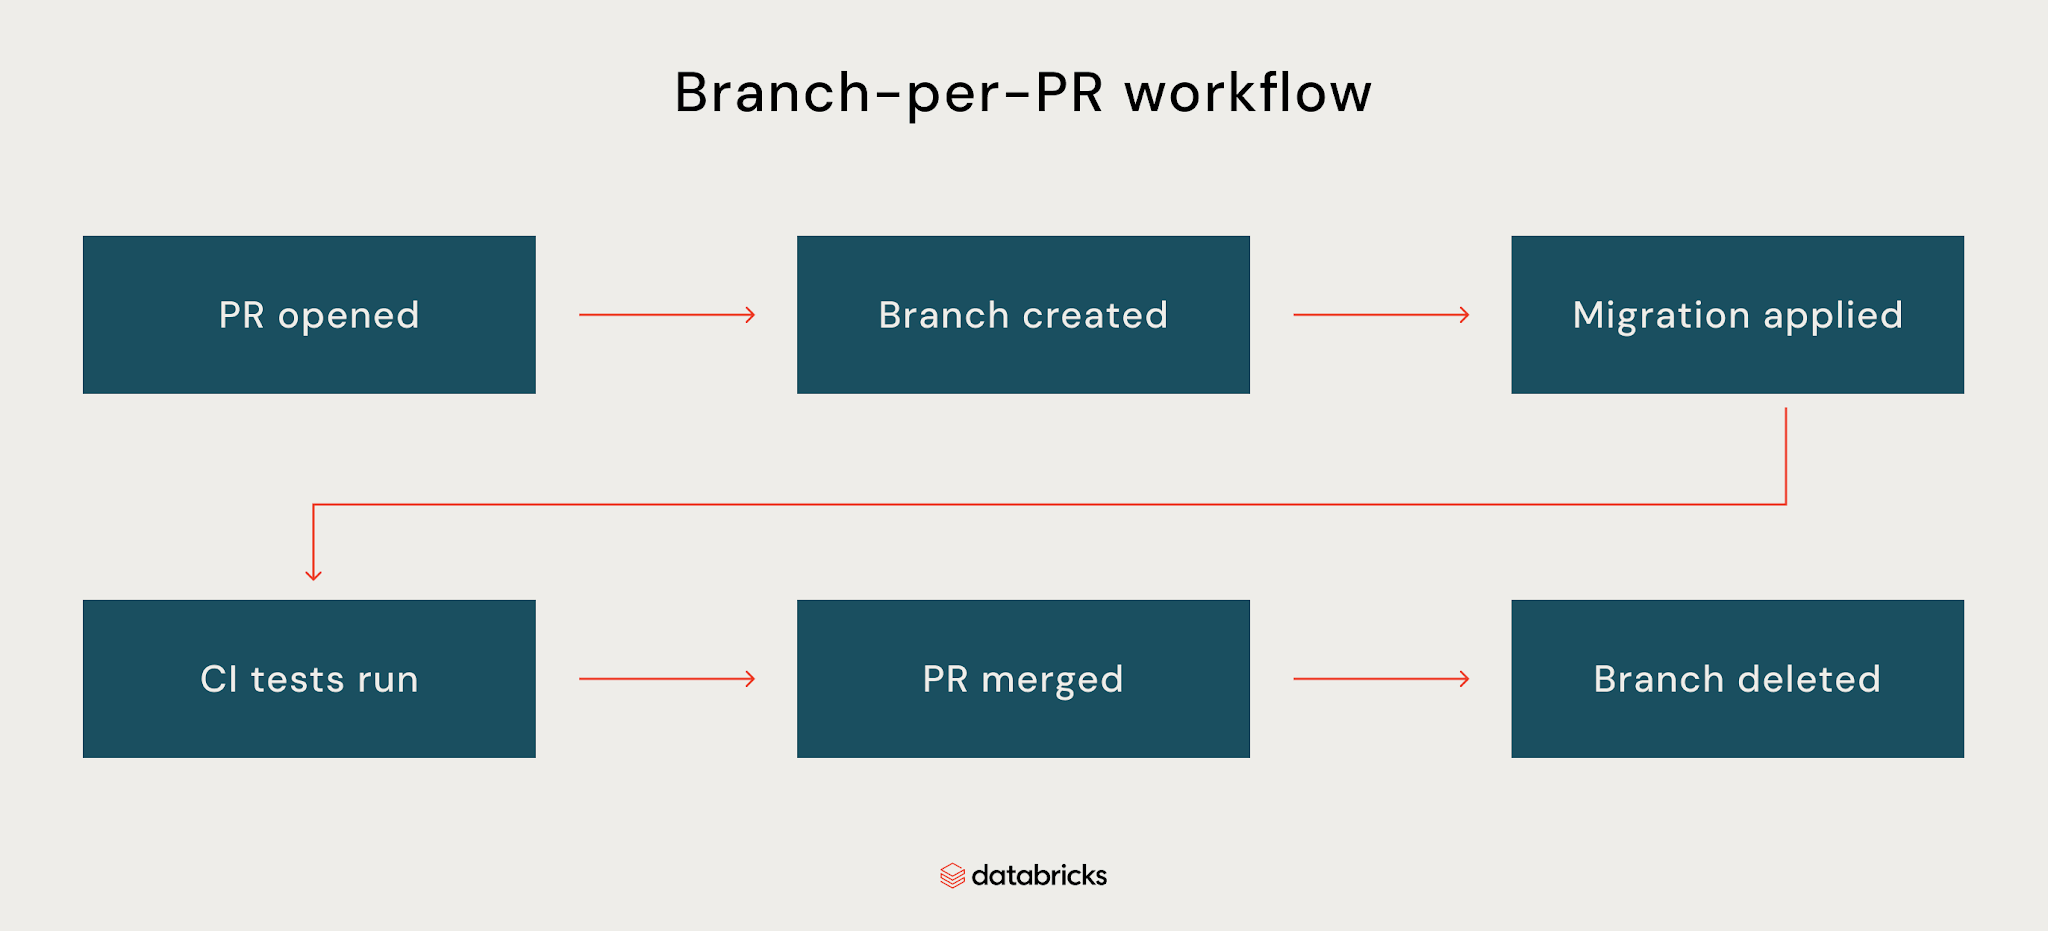
Tester des modifications de schéma par rapport aux données de production signifie risquer la production ou maintenir une base de données de préproduction (staging) qui se désynchronise au fil du temps. Le branching de base de données crée un environnement isolé à partir d'un état de base de données existant ou d'un instantané (snapshot) à un instant T, afin que les développeurs puissent tester les migrations par rapport à des données réalistes, travailler selon une approche de développement évolutif de base de données, et supprimer la branche lorsqu'elle n'est plus nécessaire.
Pourquoi choisir Lakebase sur Postgres managé
L'approche de Lakebase devient plus claire lorsque vous la comparez aux tâches fondamentales qu'un Postgres managé doit gérer :
- Serverless : Lakebase exécute PostgreSQL sur un calcul serverless qui s'adapte automatiquement à la demande, y compris jusqu'à zéro en cas d'inactivité, de sorte qu'il n'est pas nécessaire de dimensionner une instance à l'avance ou de payer pour de la capacité inutilisée. Databricks signale un débit d'écriture Postgres jusqu'à 5 fois plus rapide avec Lakebase lors de ses tests, bien que le résultat dépende de la charge de travail et de la configuration.
- Compatibilité PostgreSQL : Lakebase utilise une connectivité PostgreSQL standard, de sorte que les pilotes existants, les ORM et les outils tels que psql, pgAdmin et DBeaver se connectent de la même manière qu'à n'importe quelle autre instance Postgres, sans aucun protocole propriétaire entre l'application et la base de données.
- Fiabilité : Lakebase exécute des ressources de calcul secondaires dans des zones de disponibilité distinctes et les promeut automatiquement en cas de défaillance du système principal, ce qui permet de conserver le même point de terminaison (endpoint) de connexion. L'équipe chargée de la base de données n'a pas à promouvoir manuellement un réplica ni à reconfigurer l'application pendant l'incident.
- Tarification : Les ressources de calcul s'adaptent à la charge de travail au lieu d'utiliser une instance provisionnée en permanence, et la facturation s'arrête dès que la base de données est suspendue. Le stockage est facturé séparément.
- Intégration au Lakehouse : Lakebase se connecte au reste de la plateforme Databricks plutôt que de fonctionner comme un service Postgres isolé. Les tables synchronisées rendent les données de Unity Catalog disponibles pour les applications Postgres sans pipeline de synchronisation personnalisé, et Change Data Feed, actuellement en Public Preview, expose les modifications de la base de données pour un traitement en aval dans le lakehouse.
Ce qui n'est plus à la charge de l'équipe
Le tableau ci-dessous présente les opérations de base de données gérées par Lakebase et celles qui restent sous la responsabilité de l'équipe chargée de la base de données :
| Dimension | Ce que Lakebase gère |
|---|---|
| Application des correctifs | Mises à jour automatiques de PostgreSQL, de la sécurité, de l'OS et du calcul |
| Mise à l'échelle | Mise à l'échelle automatique, y compris la réduction à zéro en cas d'inactivité |
| Basculement | Basculement automatique vers des ressources de calcul secondaires au sein d'une même région |
| Sauvegardes et restauration | Restauration à un instant T avec un historique configurable de 2 à 30 jours, plus des instantanés (snapshots) planifiés pour une protection de sauvegarde supplémentaire |
| Reprise après sinistre | Private Preview, AWS uniquement. Réplication périodique avec basculement manuel et procédures de récupération gérées par le client. |
| Chiffrement | Au repos et en transit, clés gérées par le client disponibles |
| Contrôle d'accès | Rôles et autorisations PostgreSQL, avec des intégrations Unity Catalog pour une gouvernance plus large. |
| Extensions | pgvector, PostGIS et autres extensions PostgreSQL prises en charge |
| Regroupement de connexions | PgBouncer intégré |
| Branching | Copie sur écriture (copy-on-write), pas de stockage dupliqué |
| Intégration au Lakehouse | Tables synchronisées et Change Data Feed |
| Tarification | Serverless, s'adapte à la charge de travail, se suspend en cas d'inactivité. Stockage facturé séparément. |
L'application des correctifs, la mise à l'échelle, le basculement et les sauvegardes s'exécutent tous automatiquement conformément au tableau ci-dessus. La reprise après sinistre fait exception : elle est toujours en Private Preview, sur AWS uniquement, avec un basculement manuel et des procédures de récupération gérées par le client. C'est le détail qu'il convient de vérifier avant de compter sur Lakebase pour tout ce qui s'étend sur plusieurs régions. En savoir plus sur Databricks Lakebase.
Conclusion
Le terme « managé » revêt une signification différente selon le fournisseur, allant de la simple application de correctifs sur l'OS à la prise en charge complète de l'exécution d'une base de données de production : mise à l'échelle, basculement, sauvegardes, sécurité, migration, charges de travail d'IA et expérience de développement globale.
Lakebase franchit cette barre haut la main sur la plupart de ces aspects. L'application des correctifs, la mise à l'échelle et le basculement s'exécutent sans intervention de votre équipe ; la restauration à un instant T est intégrée, et la sécurité, les extensions, le regroupement de connexions ainsi que le branching sont inclus dans le service. La reprise après sinistre multi-région est la seule exception, toujours en Private Preview avec basculement manuel, n'offrant pas la même protection automatique que celle fournie par Lakebase au sein d'une même région.
Pour les équipes qui évaluent Postgres managé, la question cruciale est de savoir quelle part du travail opérationnel n'est réellement plus à leur charge. Lakebase gère la majeure partie de ce travail au sein d'une région, tandis que la reprise après sinistre multi-région reste un domaine où les équipes conservent des responsabilités.
Foire aux questions
Quelle est la différence entre un Postgres managé et un Postgres auto-hébergé ?
Postgres auto-hébergé confie chaque tâche opérationnelle à l'équipe de base de données : application de correctifs, mise à l'échelle, basculement, politique de sauvegarde, reprise après sinistre. Le service Postgres géré transfère une partie ou la totalité de ces tâches au fournisseur, mais la part transférée varie considérablement. Les services partiellement gérés s'occupent de l'infrastructure et laissent le reste au client. Certains services entièrement gérés incluent également des outils de sécurité, une assistance à la migration et des flux de travail de développement tels que la création de branches de base de données.
Qu'est-ce que Postgres serverless ?
Postgres serverless est un modèle de base de données gérée où les ressources de calcul s'adaptent automatiquement à la demande, éliminant ainsi le besoin de provisionner une taille d'instance fixe. Certains fournisseurs réduisent les ressources de calcul à zéro lorsque la base de données est inactive, tandis que d'autres maintiennent une capacité de base. La tarification dépend généralement des ressources de calcul utilisées plutôt que d'une instance provisionnée en permanence.
Comment fonctionne la création de branches de base de données dans Postgres ?
La création de branches de base de données crée une branche isolée de type « copy-on-write » d'une base de données sans dupliquer le stockage sous-jacent. Chaque branche peut disposer de ses propres ressources de calcul et modifications de données sans affecter la production. Les équipes l'utilisent pour tester des migrations de schéma sur des données réelles, créer une branche par pull request, ou restaurer une branche à un instant précis, puis la supprimer une fois le travail terminé.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.