MemCurrent : Conception d'une mémoire persistante pour les agents en production
Les outils d'IA ont rendu le « vibe coding » d'agents très facile. Cependant, la construction et la maintenance d'un agent d'entreprise en production restent nettement plus complexes. En particulier, les développeurs sont souvent contraints de faire un compromis entre la qualité (obtenir de bonnes réponses, notamment sur les tâches rares de la longue traîne) et l'efficacité (maîtriser les coûts et la latence à grande échelle). Bien souvent, les techniques apportent des gains sur une dimension aux dépens d'une autre.
La mémoire est une voie prometteuse pour améliorer ces deux aspects simultanément. Elle peut aider les agents à conserver un contexte utile d'une tâche à l'autre, comme les préférences des utilisateurs, les corrections antérieures, les définitions de métriques et les workflows réussis. En principe, cela permet d'améliorer la précision, de réduire les erreurs répétées et d'éviter les redécouvertes inutiles. Mais un historique plus étendu ne garantit pas une meilleure mémoire. Fournir chaque interaction passée est coûteux et peut introduire un contexte obsolète, contradictoire ou non pertinent. Le défi principal consiste à décider quoi conserver, comment le maintenir et comment mesurer son utilité.
Dans cet article, nous présentons MemCurrent, une architecture de mémoire persistante pour les agents en production, qui alimente désormais le nouveau Agent Bricks Memory et Genie. Les agents lisent et écrivent dans la mémoire pendant qu'ils travaillent, et un pipeline hors ligne de « rêverie » (dreaming) consolide la mémoire pour la maintenir cohérente et à jour. Sur notre benchmark interne, élaboré à partir de tâches d'entreprise réalistes, MemCurrent triple le taux de réussite de l'agent par rapport à une absence de mémoire, tout en utilisant 31 % de tokens en moins et en s'exécutant 26 % plus rapidement. La suite de cet article explique comment nous l'avons conçue et évaluée, ainsi que les enseignements que nous en avons tirés.
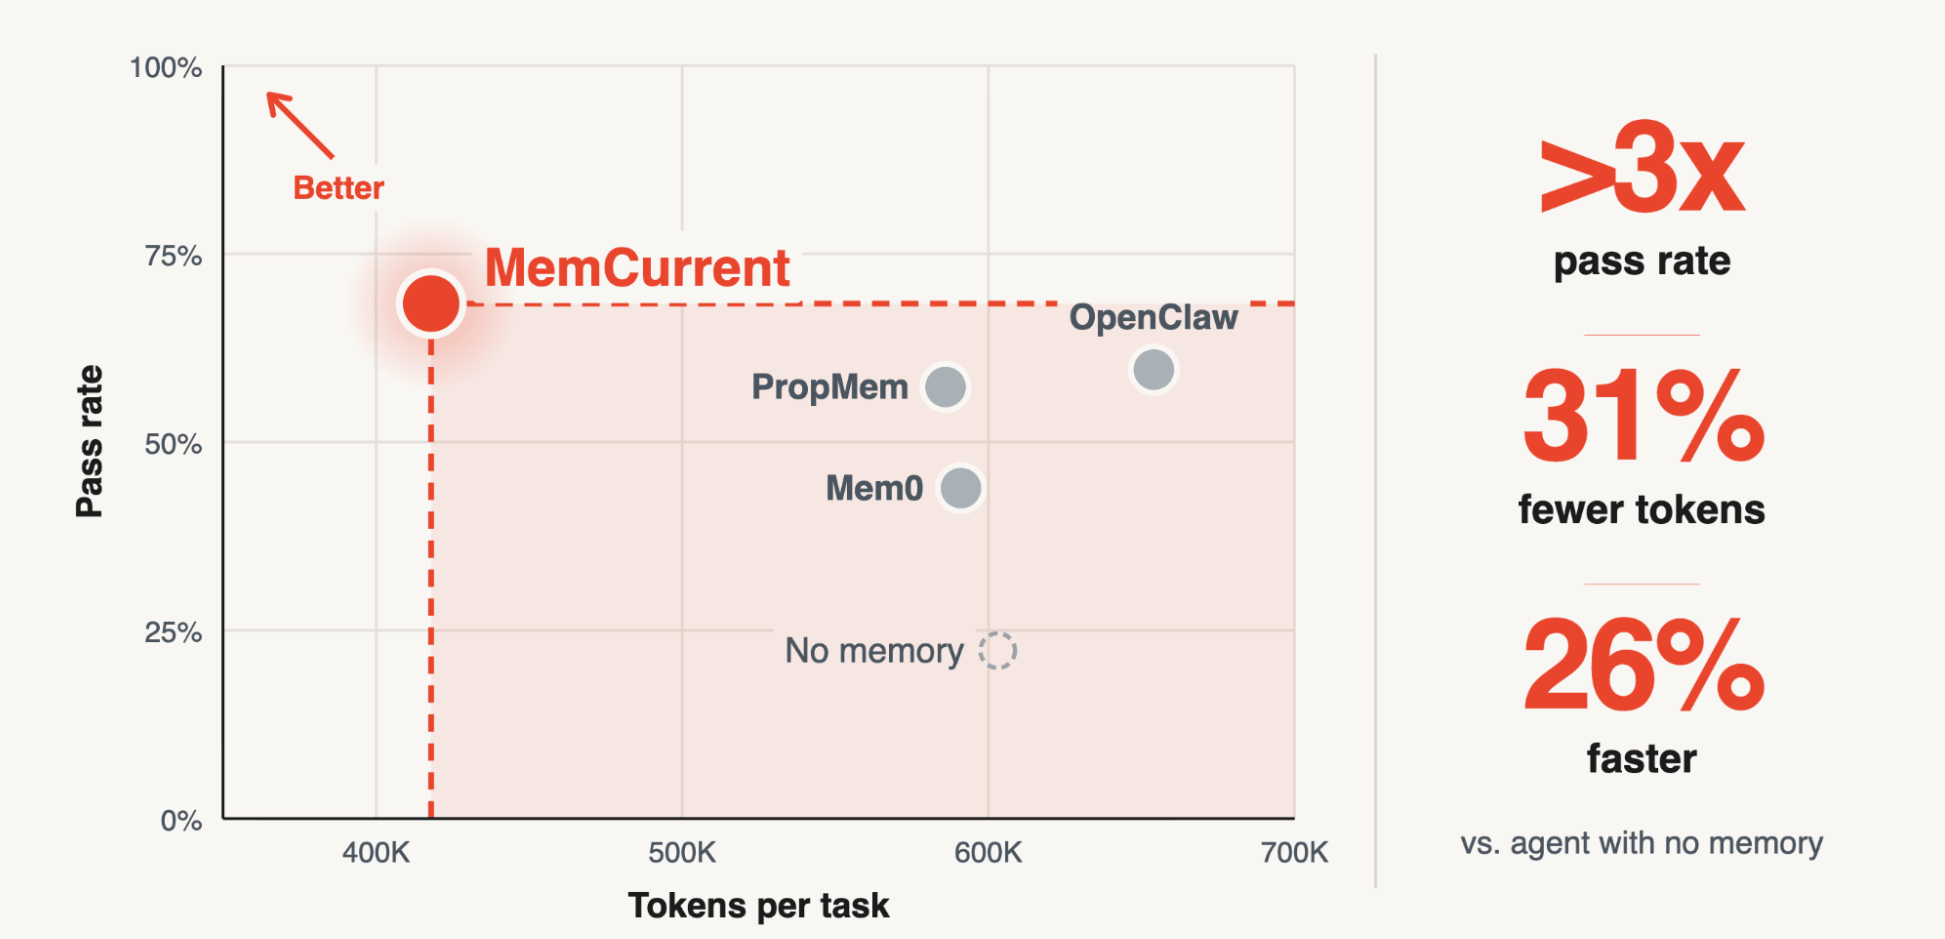
Figure 1. Taux de réussite par rapport aux tokens par tâche sur notre benchmark de mémoire interne. MemCurrent se situe sur la frontière de Pareto, surpassant la mémoire de Mem0, PropMem et OpenClaw sur les deux dimensions.
Comment nous avons conçu la mémoire
Il existe trois façons d'intégrer de la mémoire dans un agent. En tant que plugin (comme dans nos travaux précédents sur MemAlign et Memory Scaling), la mémoire est lue et écrite automatiquement à des moments précis d'une session. En tant qu'outils, l'agent décide quoi et quand lire et écrire. En tant que pipeline hors ligne, la mémoire est mise à jour en arrière-plan selon un planificateur ou un déclencheur, puis utilisée dans les sessions ultérieures. Chacune comporte des compromis :
Mémoire en tant que… | Déclenché par | Moment du calcul | Avantages | Inconvénients |
Plugin | Automatique | En ligne |
|
|
Outil | Agent | En ligne |
|
|
| Pipeline | Planification ou déclencheur | Hors ligne |
|
|
Tableau 1. Trois modes d'accès à la mémoire : plugin, outil ou pipeline hors ligne.
MemCurrent utilise ces trois approches, chacune là où elle est la plus adaptée.
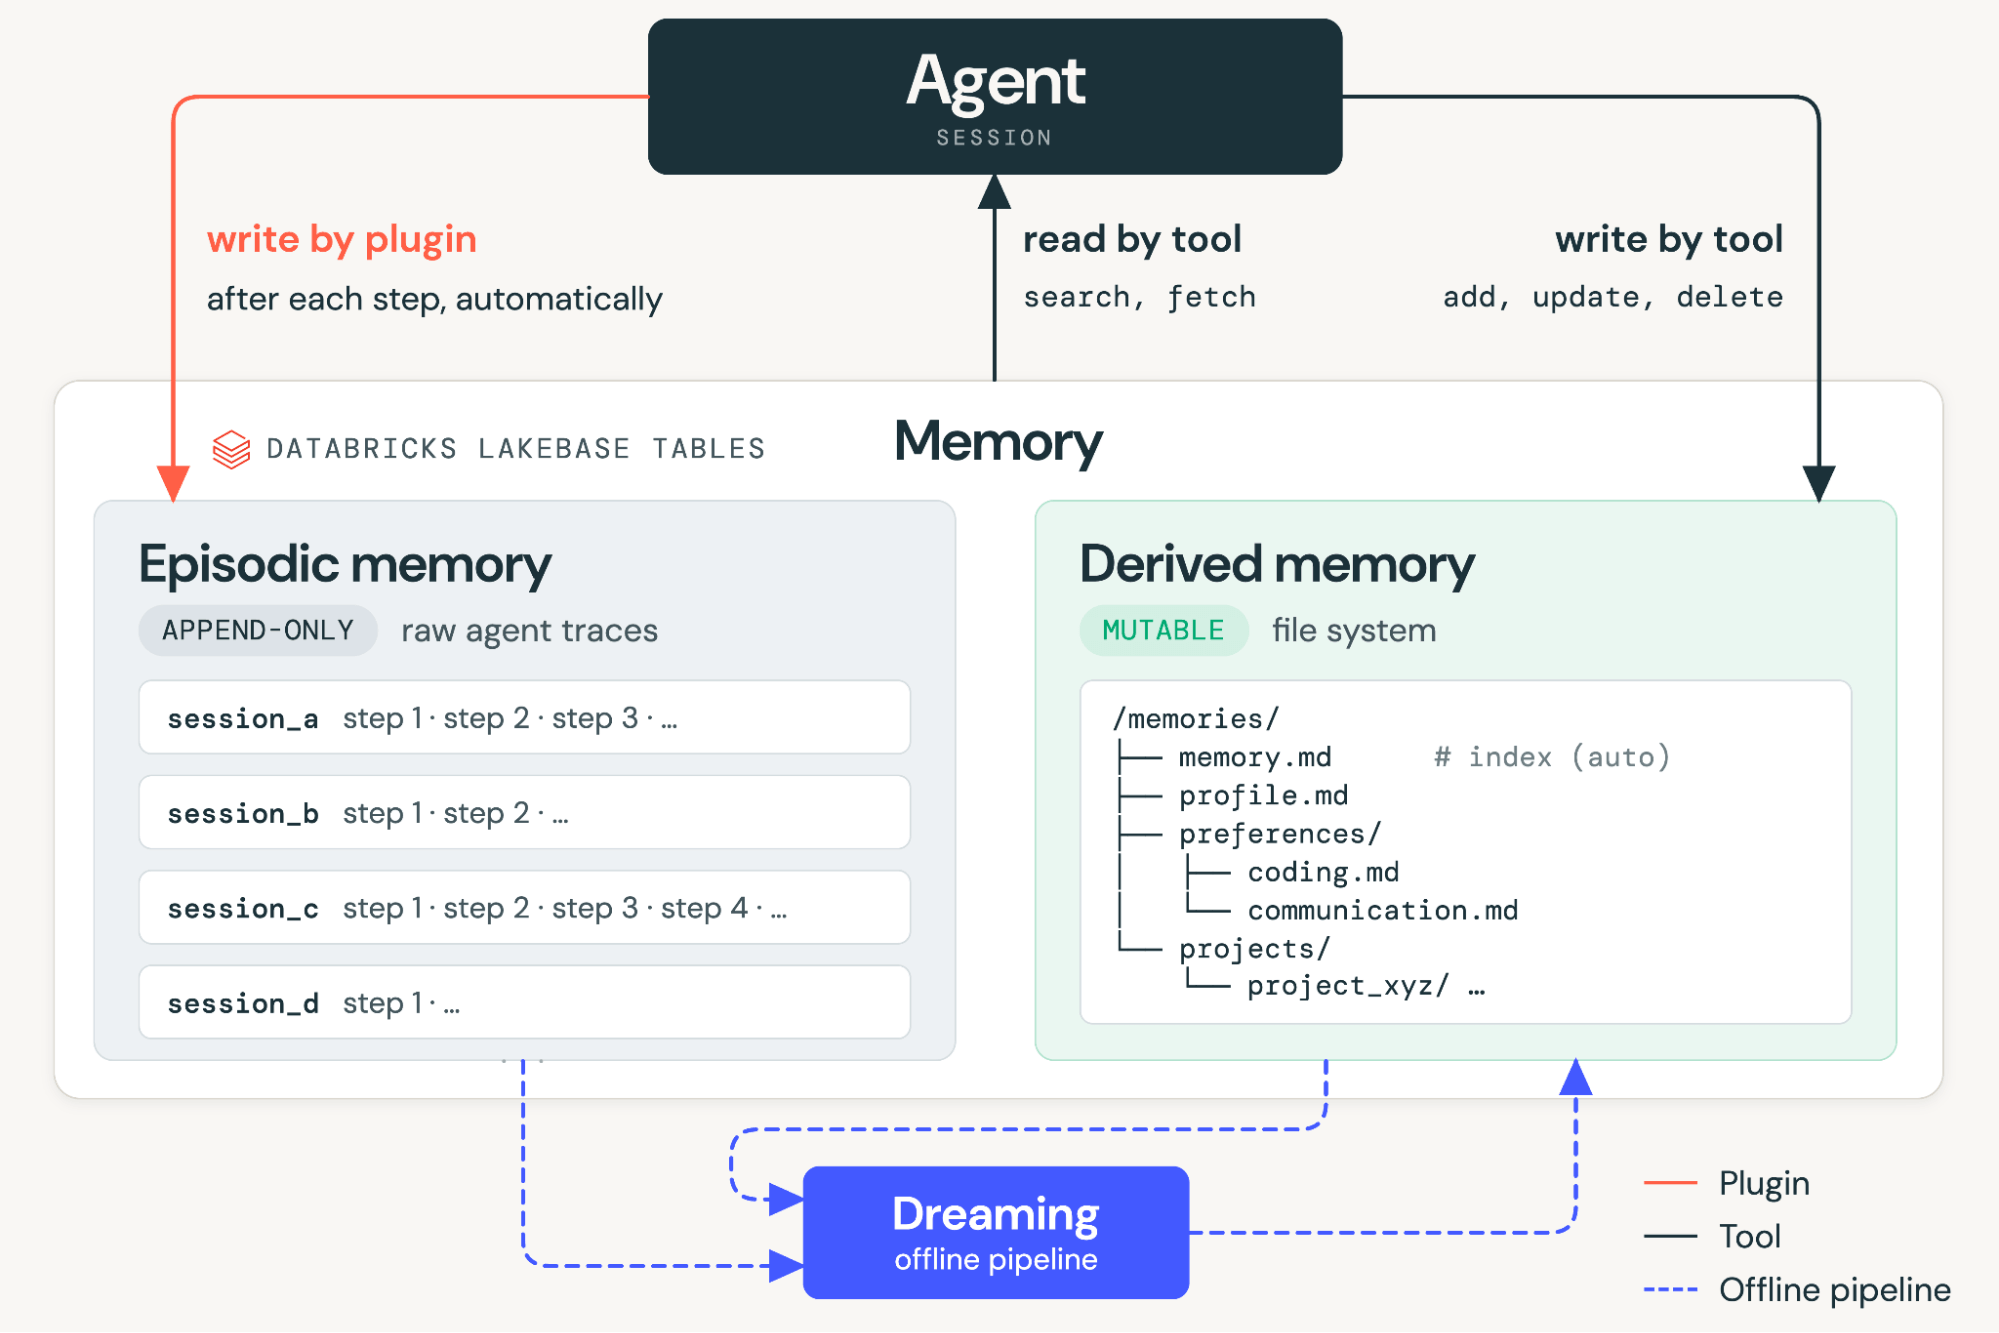
Figure 2. Vue d'ensemble de MemCurrent.
MemCurrent possède deux types de mémoire : la mémoire épisodique, qui stocke les traces brutes des sessions, et la mémoire dérivée, qui contient les enseignements synthétisés à partir de ces traces, stockés sous forme de fichiers dans une base de connaissances structurée. Un index généré automatiquement ( memory.md) se trouve au niveau supérieur et décrit la structure des fichiers ainsi que le contenu de chacun.
La mémoire épisodique et la mémoire dérivée résident toutes deux dans une base de données de niveau production capable de passer à l'échelle pour de nombreux utilisateurs tout en fournissant des réponses à faible latence. La mémoire épisodique fonctionne uniquement en ajout (append-only), où un plugin enregistre chaque étape au fil de la session. La mémoire dérivée est une table mutable simulant un système de fichiers hiérarchique, dans laquelle l'écriture s'effectue de deux manières. Les outils de l'agent (add_memory, update_memory, delete_memory) traitent les demandes explicites comme « Ne jamais écrire de scripts dans le répertoire /tmp ». Un pipeline de rêverie hors ligne capture le reste, en synthétisant les apprentissages implicites de chaque nouvelle session dans les fichiers appropriés. Il nettoie également l'ensemble du stockage, en divisant les fichiers trop volumineux, en fusionnant les doublons et en résolvant les conflits.
La lecture fonctionne par couches. Au début de la session, un plugin injecte l'index de mémoire afin que l'agent sache ce qu'il sait avant de commencer. Pendant la session, l'agent dispose de deux outils qui fonctionnent sur les deux types de mémoire : search_memory renvoie les meilleurs résultats pour une requête (une étape d'une trace passée ou une ligne d'un fichier de mémoire), et fetch_memory renvoie l'entrée complète par identifiant (ID de session ou chemin de fichier).
Comment nous avons évalué la mémoire
Benchmarks
Nous commençons par trois benchmarks open source populaires : LoCoMo, LongMemEval et ConvoMem. Tous trois permettent de tester si un agent est capable de se souvenir de faits énoncés plus tôt dans des conversations synthétiques ouvertes.
De plus, nous avons élaboré un benchmark de mémoire interne à partir de véritables conversations Genie, dans lesquelles les utilisateurs posent toutes sortes de questions sur leurs données. Comme le montre la figure 3, nous sommes partis de plus de 12 000 sessions, avons extrait 3 000 candidats contenant des signaux pertinents pour la mémoire et avons rédigé une question de suivi accompagnée de grilles d'évaluation. Les autres sessions du même utilisateur servent d'éléments de remplissage (fillers) pour le cas de test. Un juge contradictoire a ensuite vérifié chaque cas de test par rapport à 7 critères, notamment si les connaissances sont réellement présentes, spécifiques à l'utilisateur, nécessaires pour répondre, naturelles et vérifiables. Après une révision manuelle finale, le benchmark compte un total de 114 cas de test, répartis sur 29 utilisateurs et 2 233 sessions d'historique.
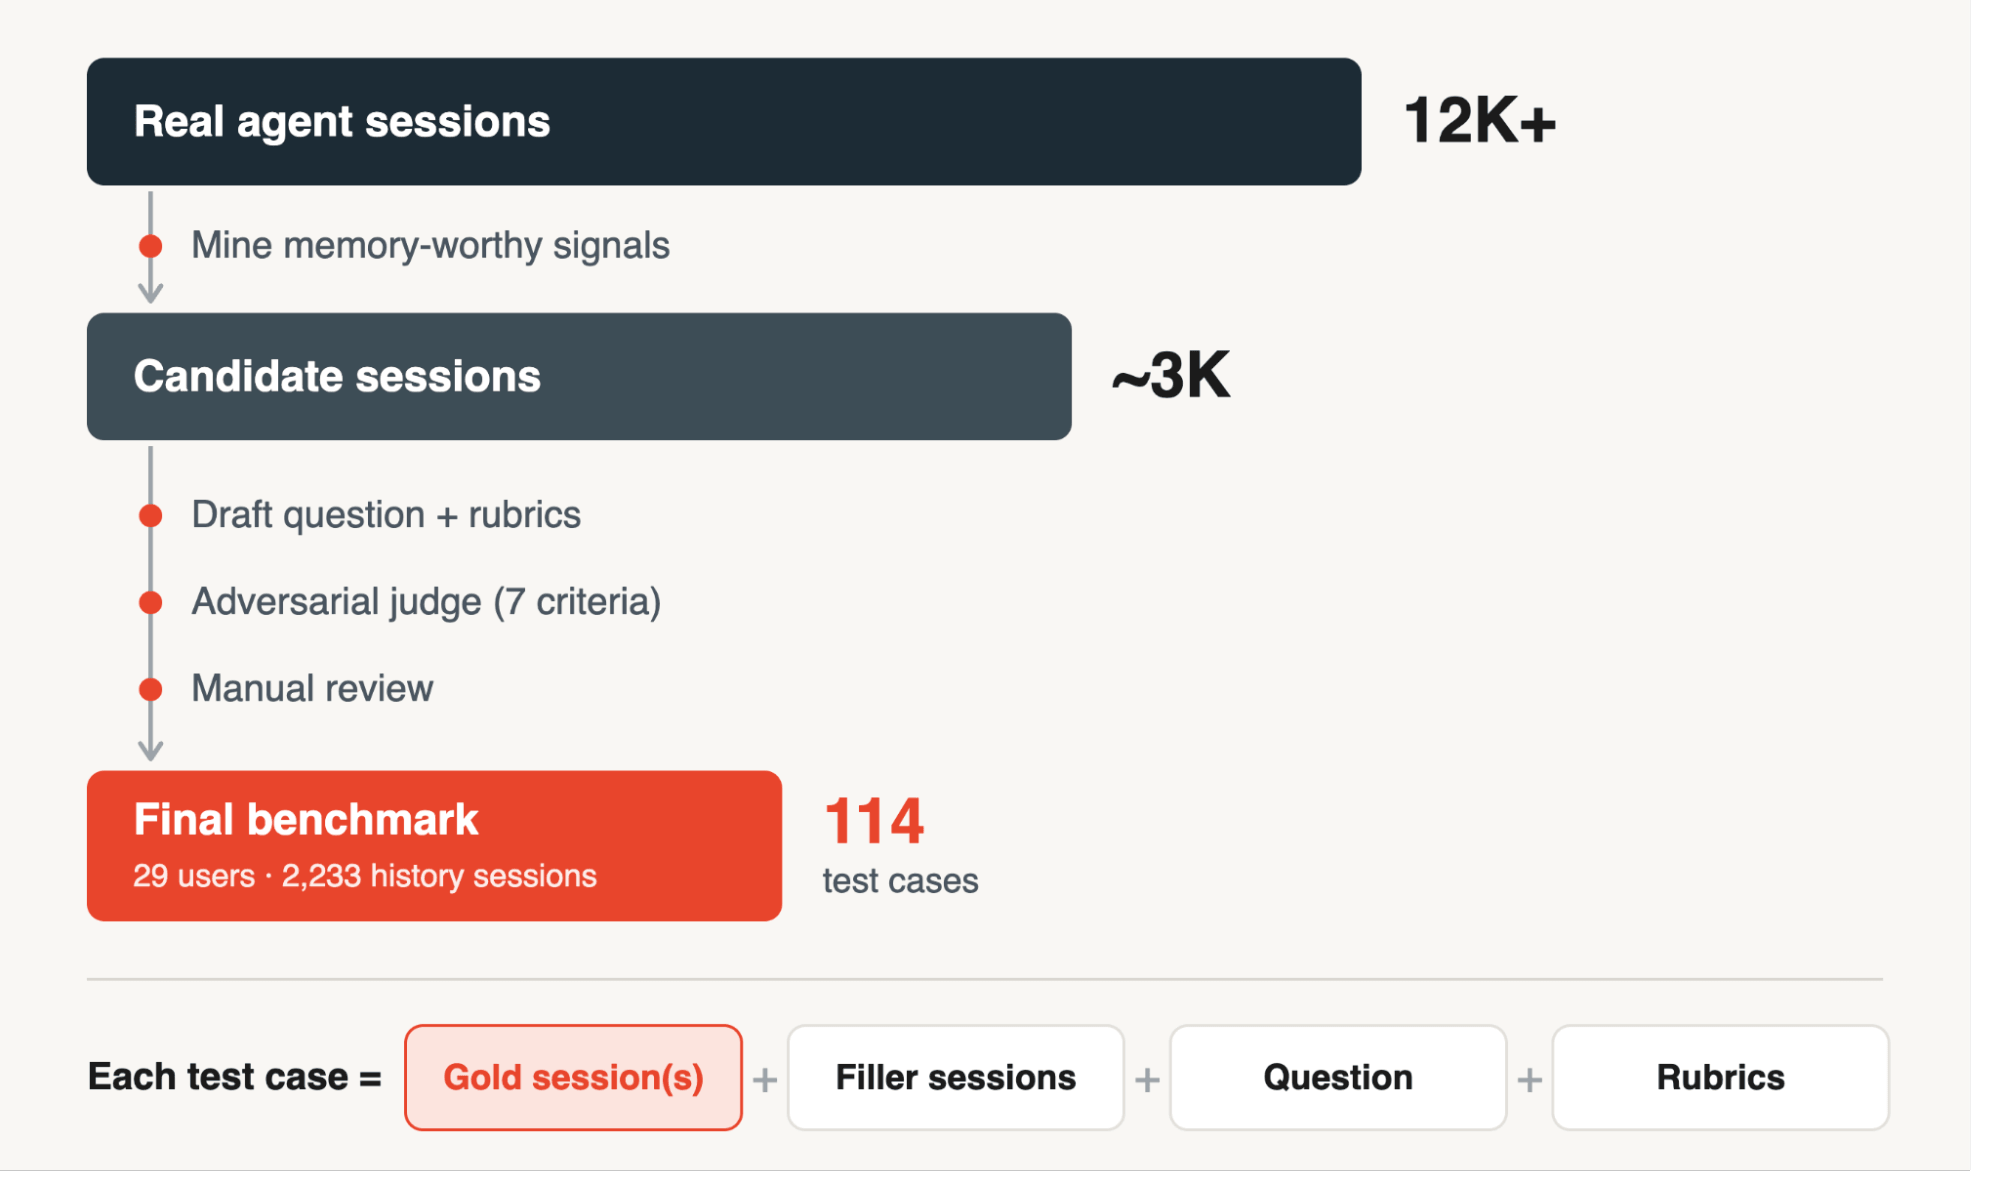
Figure 3. Comment nous avons conçu notre benchmark de mémoire interne.
Voici un exemple :
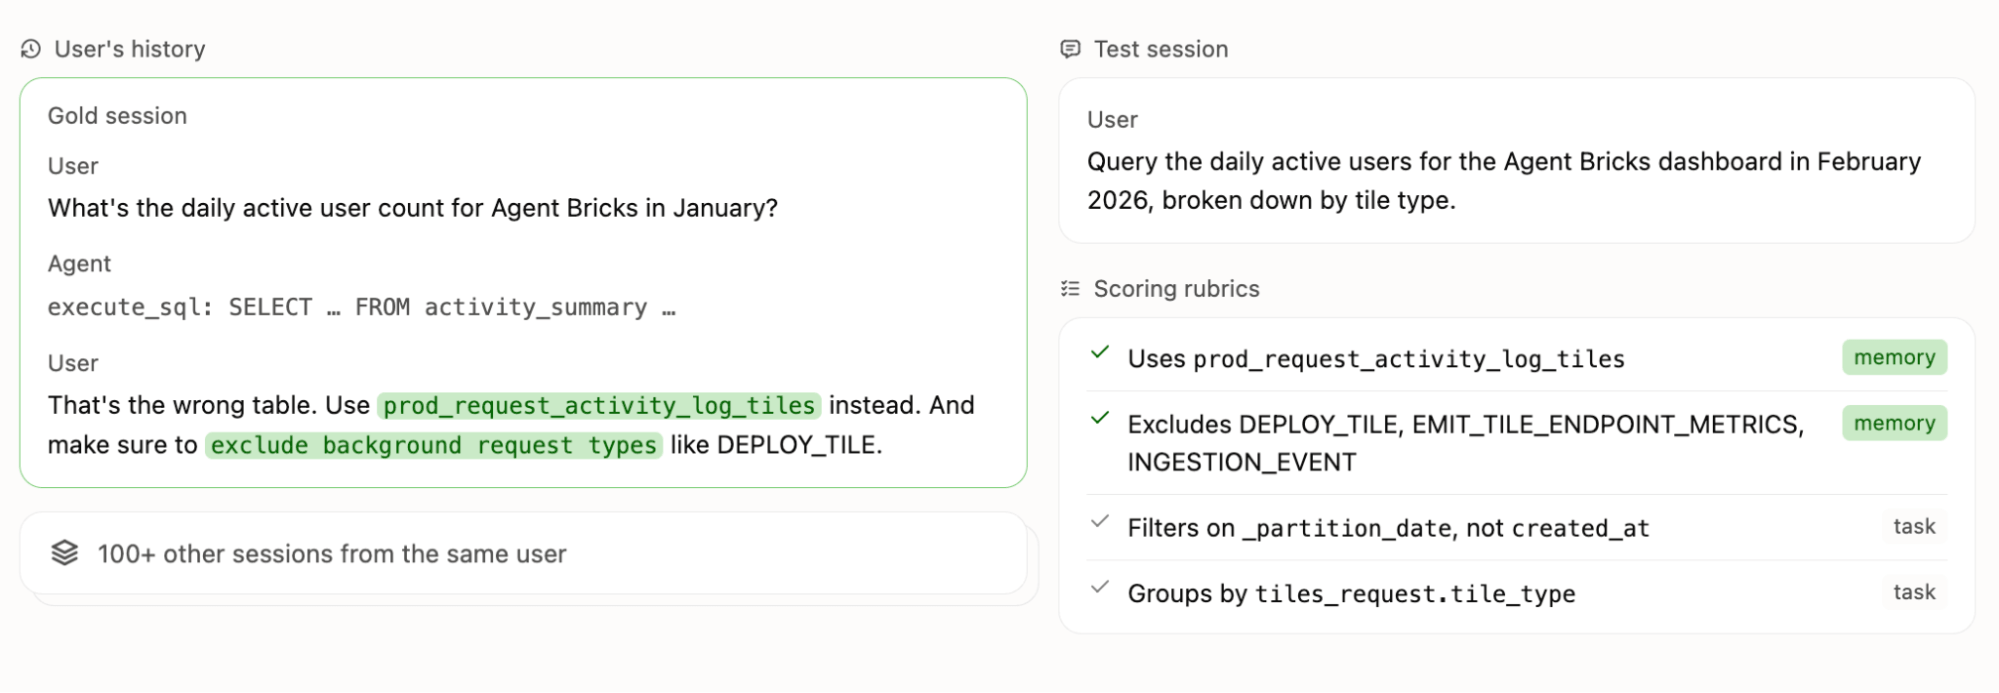
Figure 4. Exemple de cas de test issu de notre benchmark de mémoire interne. Lors d'une session antérieure, l'utilisateur corrige le choix de table de l'agent et lui demande d'exclure les requêtes en arrière-plan. Plus tard, l'agent est confronté à une question différente mais liée, et doit retrouver cette session parmi plus de 100 autres pour appliquer ce qu'il a appris. Le résultat est évalué par un juge LLM selon une grille d'évaluation (certains critères dépendant de la mémoire, d'autres étant intrinsèques à la tâche).
Notre benchmark se distingue des benchmarks existants de trois manières :
Domaine d'entreprise. Les benchmarks existants sont des discussions ouvertes sur la vie de personas simulés. Le nôtre provient de travaux réels dans un espace de travail de données, impliquant de riches connaissances d'entreprise telles que la sémantique des tables, les définitions de métriques et les flux de travail.
La mémoire alimente les actions, pas les réponses. Trouver la bonne chaîne de caractères dans les conversations passées ne suffit pas ; les agents doivent appliquer les connaissances extraites pour accomplir des tâches en plusieurs étapes.
Diversité. Les cas de test couvrent 5 types de mémoire (profil, préférences, connaissances du domaine, projets, flux de travail) croisés avec 11 scénarios (instruction directe, faits modifiés ou obsolètes, agrégation inter-sessions, questions indépendantes de la mémoire, et plus encore).
Résultats
Nous comparons MemCurrent avec trois backends de mémoire open-source, Mem0, PropMem, OpenClaw memory, en utilisant le même LLM sous-jacent.
Benchmarks open-source. Nous associons chaque backend de mémoire à un agent de question-réponse simple, conçu avec deux frameworks d'agents (LangGraph et OpenAI Agents SDK). Nous exécutons également deux références (baselines) : un plancher sans mémoire, et un plafond avec contexte complet, où chaque session passée est incluse dans le contexte de l'agent. Sur l'ensemble des trois benchmarks, MemCurrent obtient le meilleur score parmi tous les backends de mémoire et reste sur la frontière de Pareto coût-précision. En moyenne, MemCurrent (88,1 %) affiche des performances équivalentes au contexte complet (87,8 %) avec environ 12 fois moins de jetons d'entrée par question (8,4 k contre 103 k). Sur les deux benchmarks avec les historiques les plus longs, il surpasse même le contexte complet, où le fait d'injecter l'ensemble des données dans le prompt finit par rendre l'agent confus.
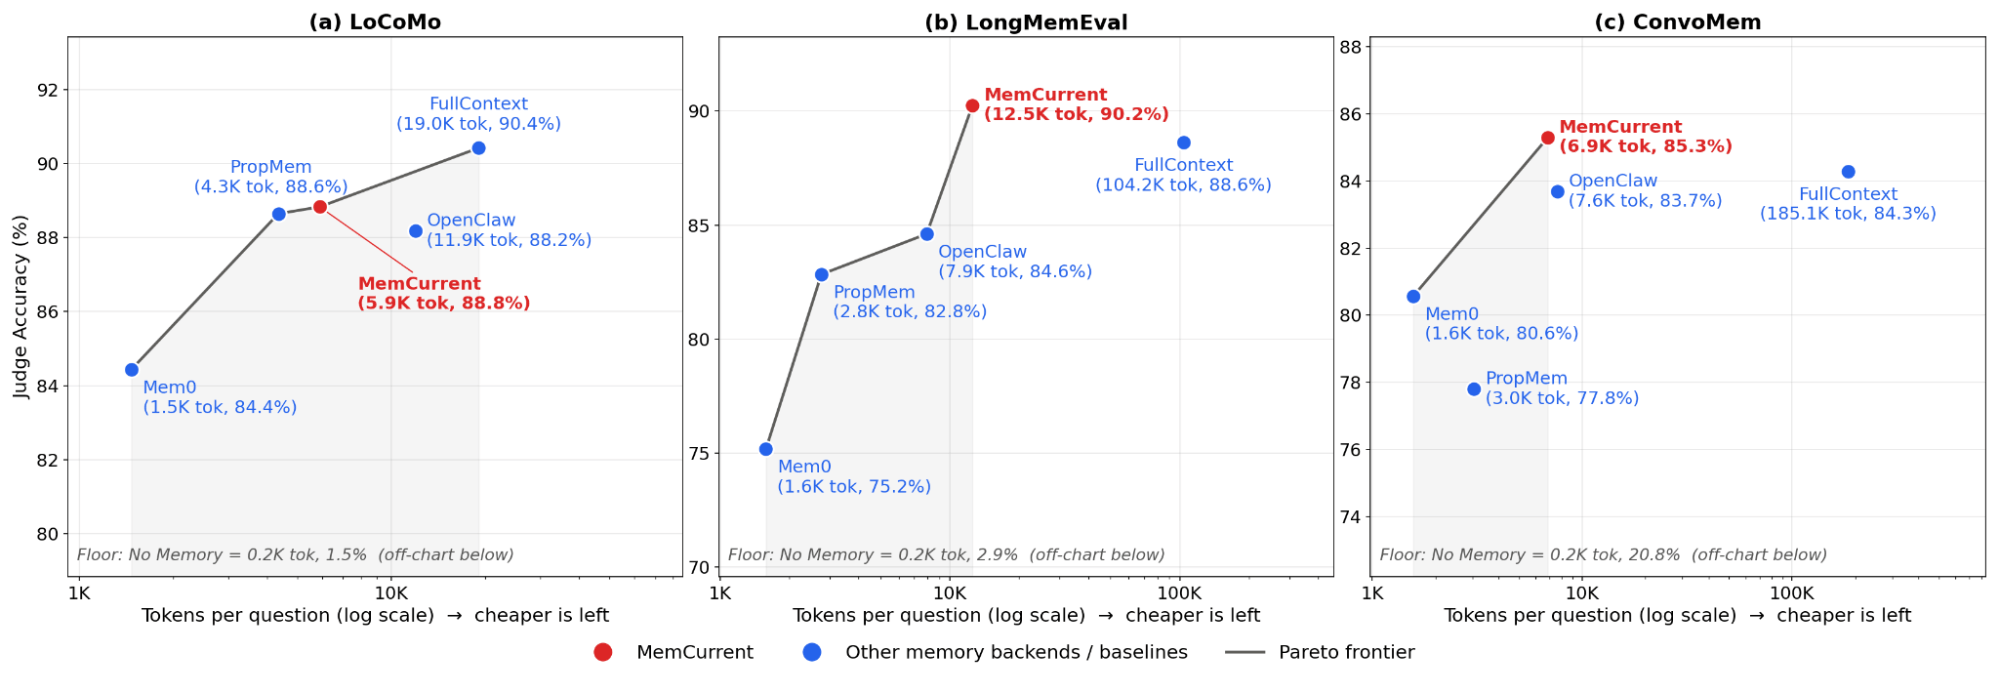
Figure 5. Compromis coût-précision1 des backends de mémoire sur (a) LoCoMo (19 à 32 sessions/échantillon), (b) LongMemEval (s split) (38 à 62 sessions/échantillon) et (c) ConvoMem (sous-ensemble stratifié de 500 échantillons, 100 sessions/échantillon). Nous utilisons GPT 5.6 luna comme modèle d'agent et de mémoire. Tous les backends de mémoire sont exécutés sous forme de plugin, qui recherche automatiquement les mémoires liées à la question et les injecte dans le contexte de l'agent au début de la session.2 La précision est la moyenne sur les frameworks LangGraph et OpenAI Agents SDK et 3 répétitions. Le coût correspond à la moyenne des jetons d'entrée par question (échelle logarithmique).
Benchmark de mémoire interne. Sur notre benchmark, l'écart se creuse. Ici, chaque backend de mémoire s'exécute au sein de notre outil interne Genie, le même agent dont proviennent les sessions du benchmark. Les historiques sont trop longs pour tenir dans le contexte, notre plafond est donc l'injection « gold » : l'injection exclusive des mémoires de référence (« gold ») dans le contexte de l'agent. Parmi tous les backends de mémoire, MemCurrent affiche le taux de réussite le plus élevé (68,4 %), la latence la plus faible (252 s) et l'utilisation de jetons la plus basse (418 k), comblant plus de 80 % de l'écart entre l'absence de mémoire (22,3 %) et l'injection gold (78,6 %). Notamment, alors que Mem0 figurait aussi sur la frontière sur les benchmarks précédents, il accuse ici un retard de 43,9 % avec une latence et un coût plus élevés. Par rapport à l'absence de mémoire, MemCurrent triple le taux de réussite de l'agent (22,3 % → 68,4 %) tout en le rendant 1,35 fois plus rapide et 1,44 fois moins cher.
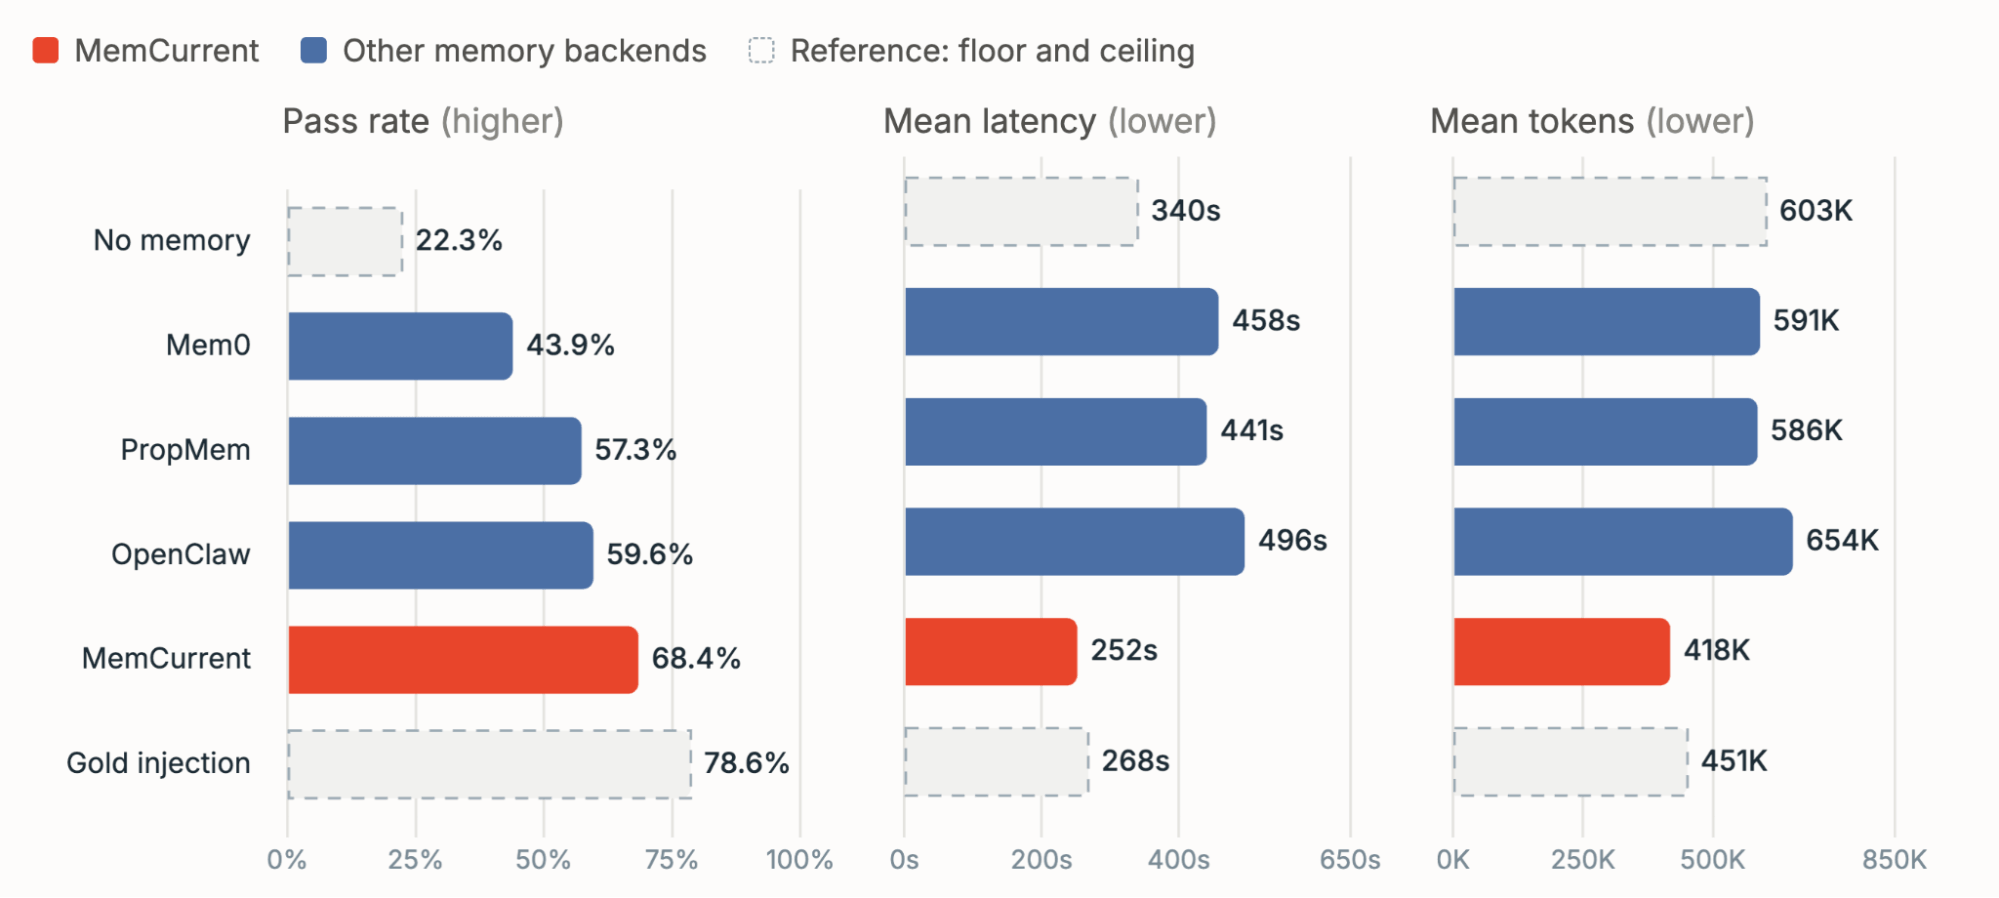
Figure 6. Taux de réussite, latence moyenne et utilisation moyenne de jetons par tâche sur notre benchmark de mémoire interne sur 3 répétitions. Nous utilisons Claude Opus 4.6 comme modèle d'agent et GPT 5.6 sol comme modèle de mémoire. Tous les backends de mémoire sont fournis sous forme d'outils d'agent et de plugin de début de session.
MemCurrent en action
En plus des chiffres de benchmark, examinons deux exemples concrets de la façon dont MemCurrent apporte son aide dans la pratique, issus de sessions internes de Genie.
Exemple 1 : La mémoire empêche une hallucination occasionnelle. Dans la Figure 7, un utilisateur a demandé à l'agent les 20 principaux utilisateurs du Produit X au cours des deux derniers mois. L'agent a rédigé une requête SQL correcte, mais n'a jamais lu les résultats d'exécution réels enregistrés dans un fichier. Il a tout de même généré avec assurance un tableau contenant du contenu hallucinatoire. Suite aux retours de l'utilisateur, l'agent a enregistré cette leçon en mémoire. La fois suivante, une fois la requête exécutée, l'agent a d'abord lu les résultats et renvoyé le bon tableau. Une seule correction de mémoire a empêché qu'une erreur ponctuelle ne devienne une habitude.
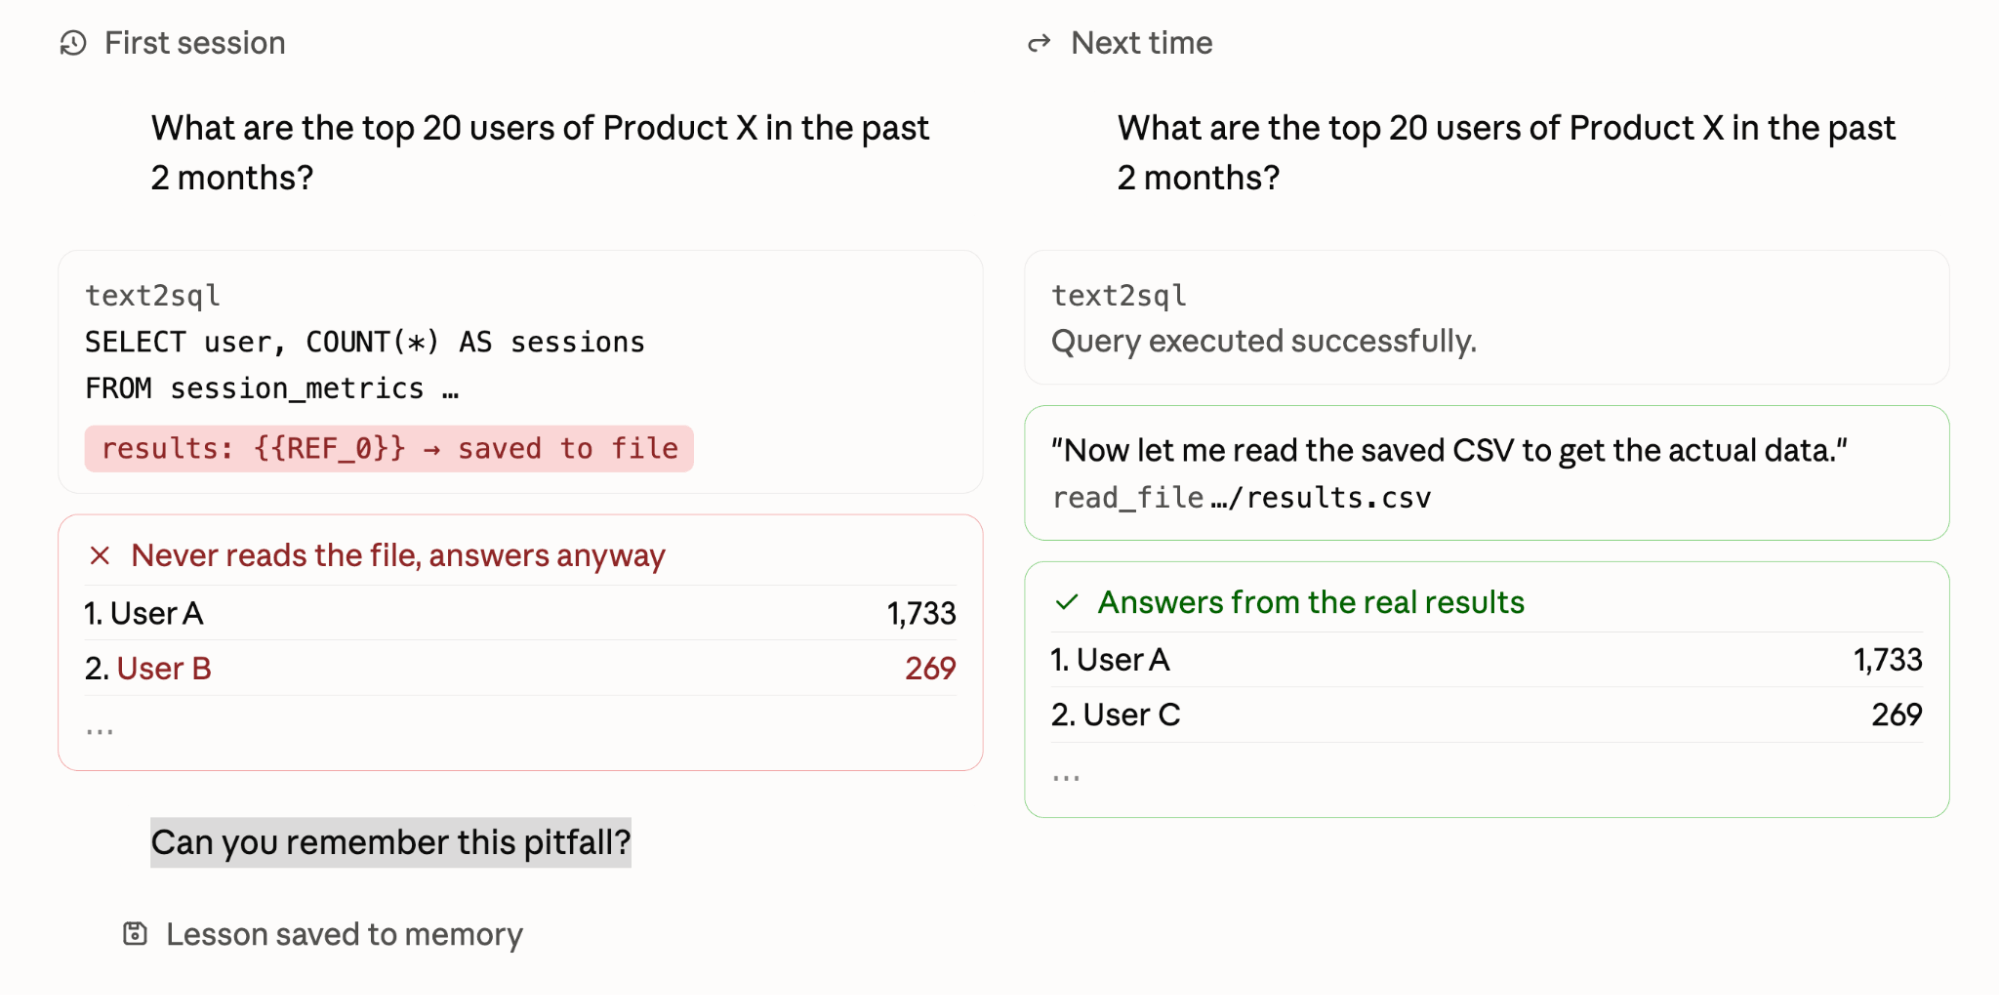
Figure 7. Exemple anonymisé illustrant comment la mémoire aide l'agent à éviter une hallucination répétée.
Exemple 2 : La mémoire économise du calcul sur des tâches similaires. Dans la Figure 8, un utilisateur a demandé « les 5 principaux clients SDP ». L'agent a dû tout déterminer à partir de zéro : la signification de « SDP », les tables contenant les données d'utilisation, ainsi que la manière de les joindre et de les filtrer. Cela a nécessité 11 appels d'outils, 8 sous-agents et près de six minutes. L'agent a enregistré ces étapes sous forme de fichier de workflow dans la mémoire, réutilisable pour des tâches similaires. Plus tard, l'utilisateur a posé une question différente : combien de clients SDP avaient enregistré plus de 5 k exécutions de pipeline le mois dernier. Grâce au workflow, l'agent a répondu avec 2 appels d'outils et 1 sous-agent en 41 secondes. La question était nouvelle, mais la démarche pour y répondre ne l'était pas, et la mémoire a permis à l'agent d'éviter toute exploration inutile.
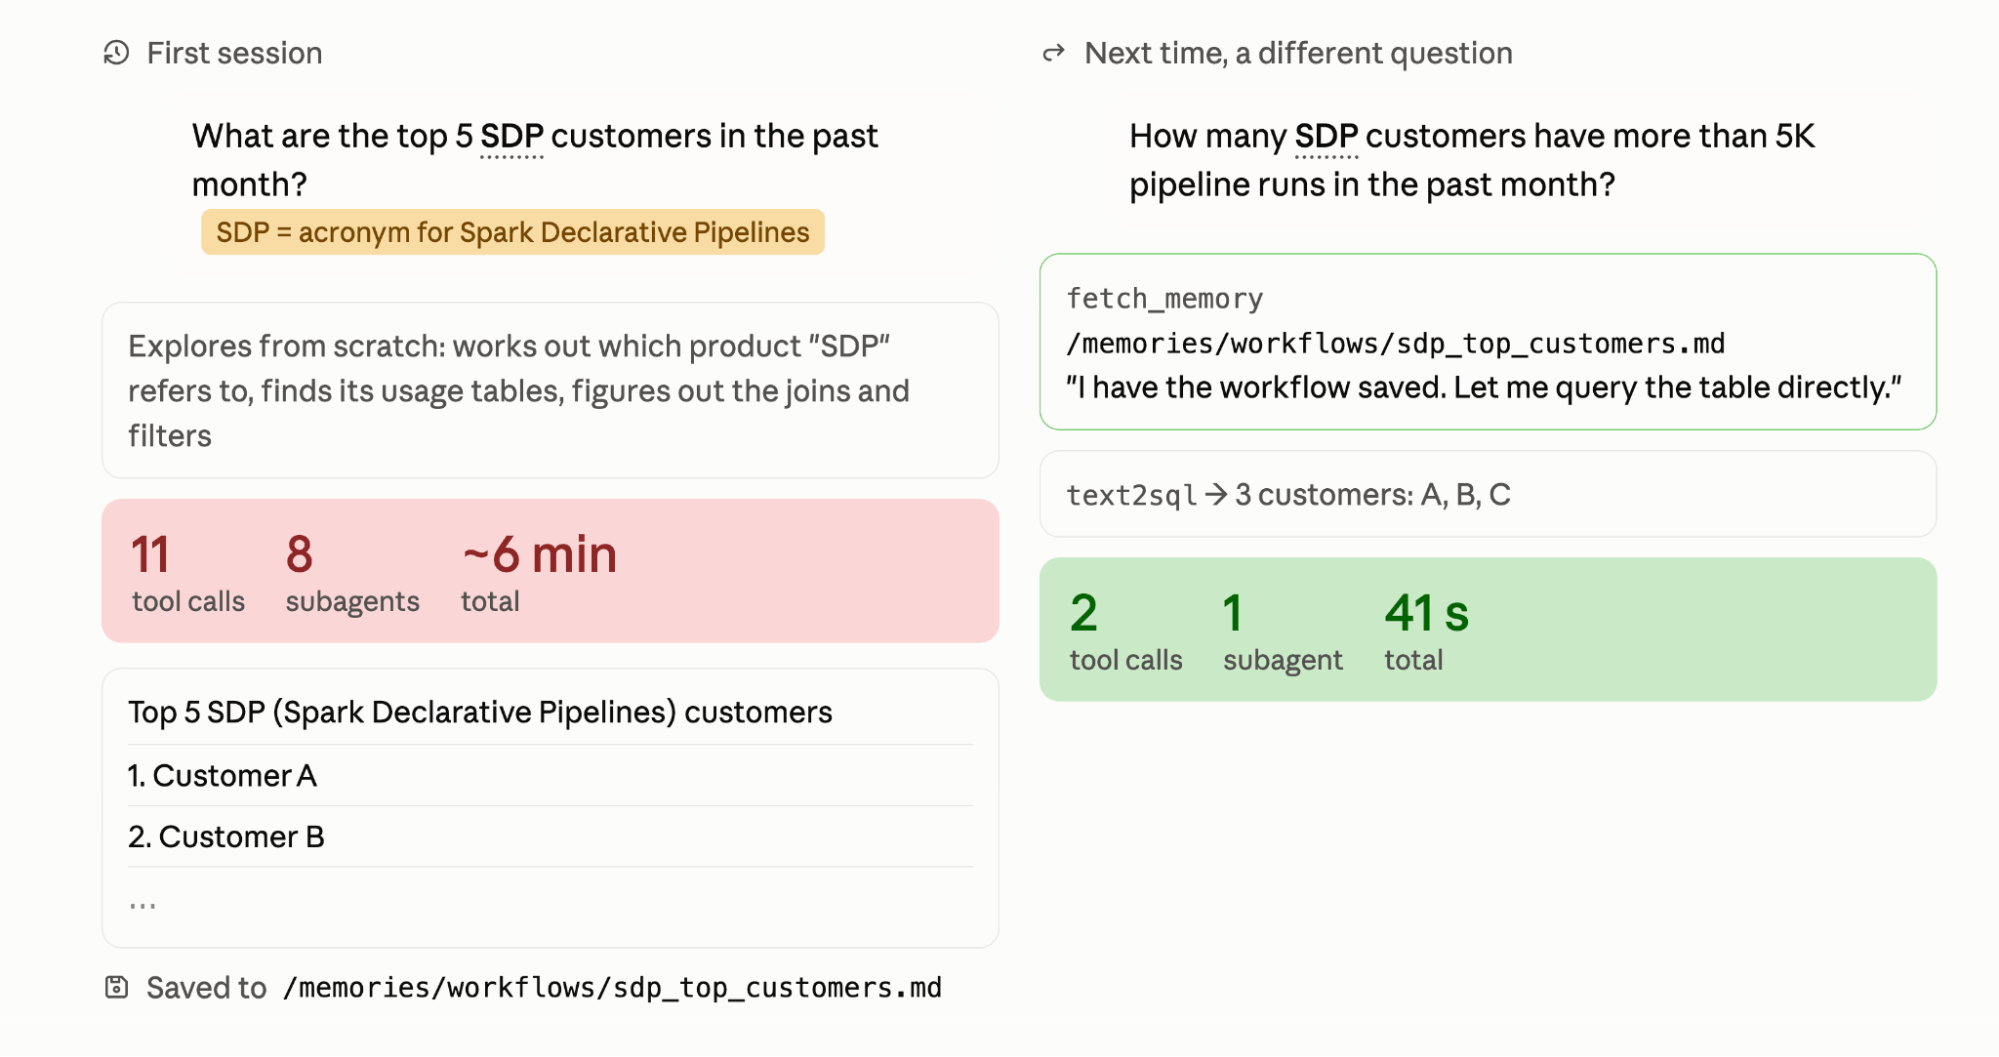
Figure 8. Exemple anonymisé illustrant comment la mémoire réduit une tâche de 6 minutes à 41 secondes.
Ce qui fait le succès de MemCurrent
Pour comprendre ce qui explique la performance supérieure de MemCurrent, nous avons réalisé des études d'ablation sur notre benchmark de mémoire interne pour deux choix de conception : les types de mémoire et la stratégie d'extraction.
Avons-nous besoin des deux types de mémoire ? La mémoire épisodique seule apporte une amélioration modérée : 35,8 %, contre 22,3 % sans mémoire. L'historique brut est utile, mais l'agent ne le consulte que dans environ un tiers des cas de test, bien qu'il réussisse 60 % de ces cas lorsqu'il le fait. La mémoire dérivée évite ce problème, car l'index de mémoire injecté au début de la session fournit à l'agent des informations sur ce qui est disponible en mémoire et sur le moment opportun pour chercher, faisant grimper le taux de réussite à 66,1 %. L'ajout de la mémoire épisodique par-dessus offre le meilleur résultat, à 68,4 %. Le gain est minime, mais il suggère que les traces brutes permettent de récupérer des détails éliminés par la distillation.
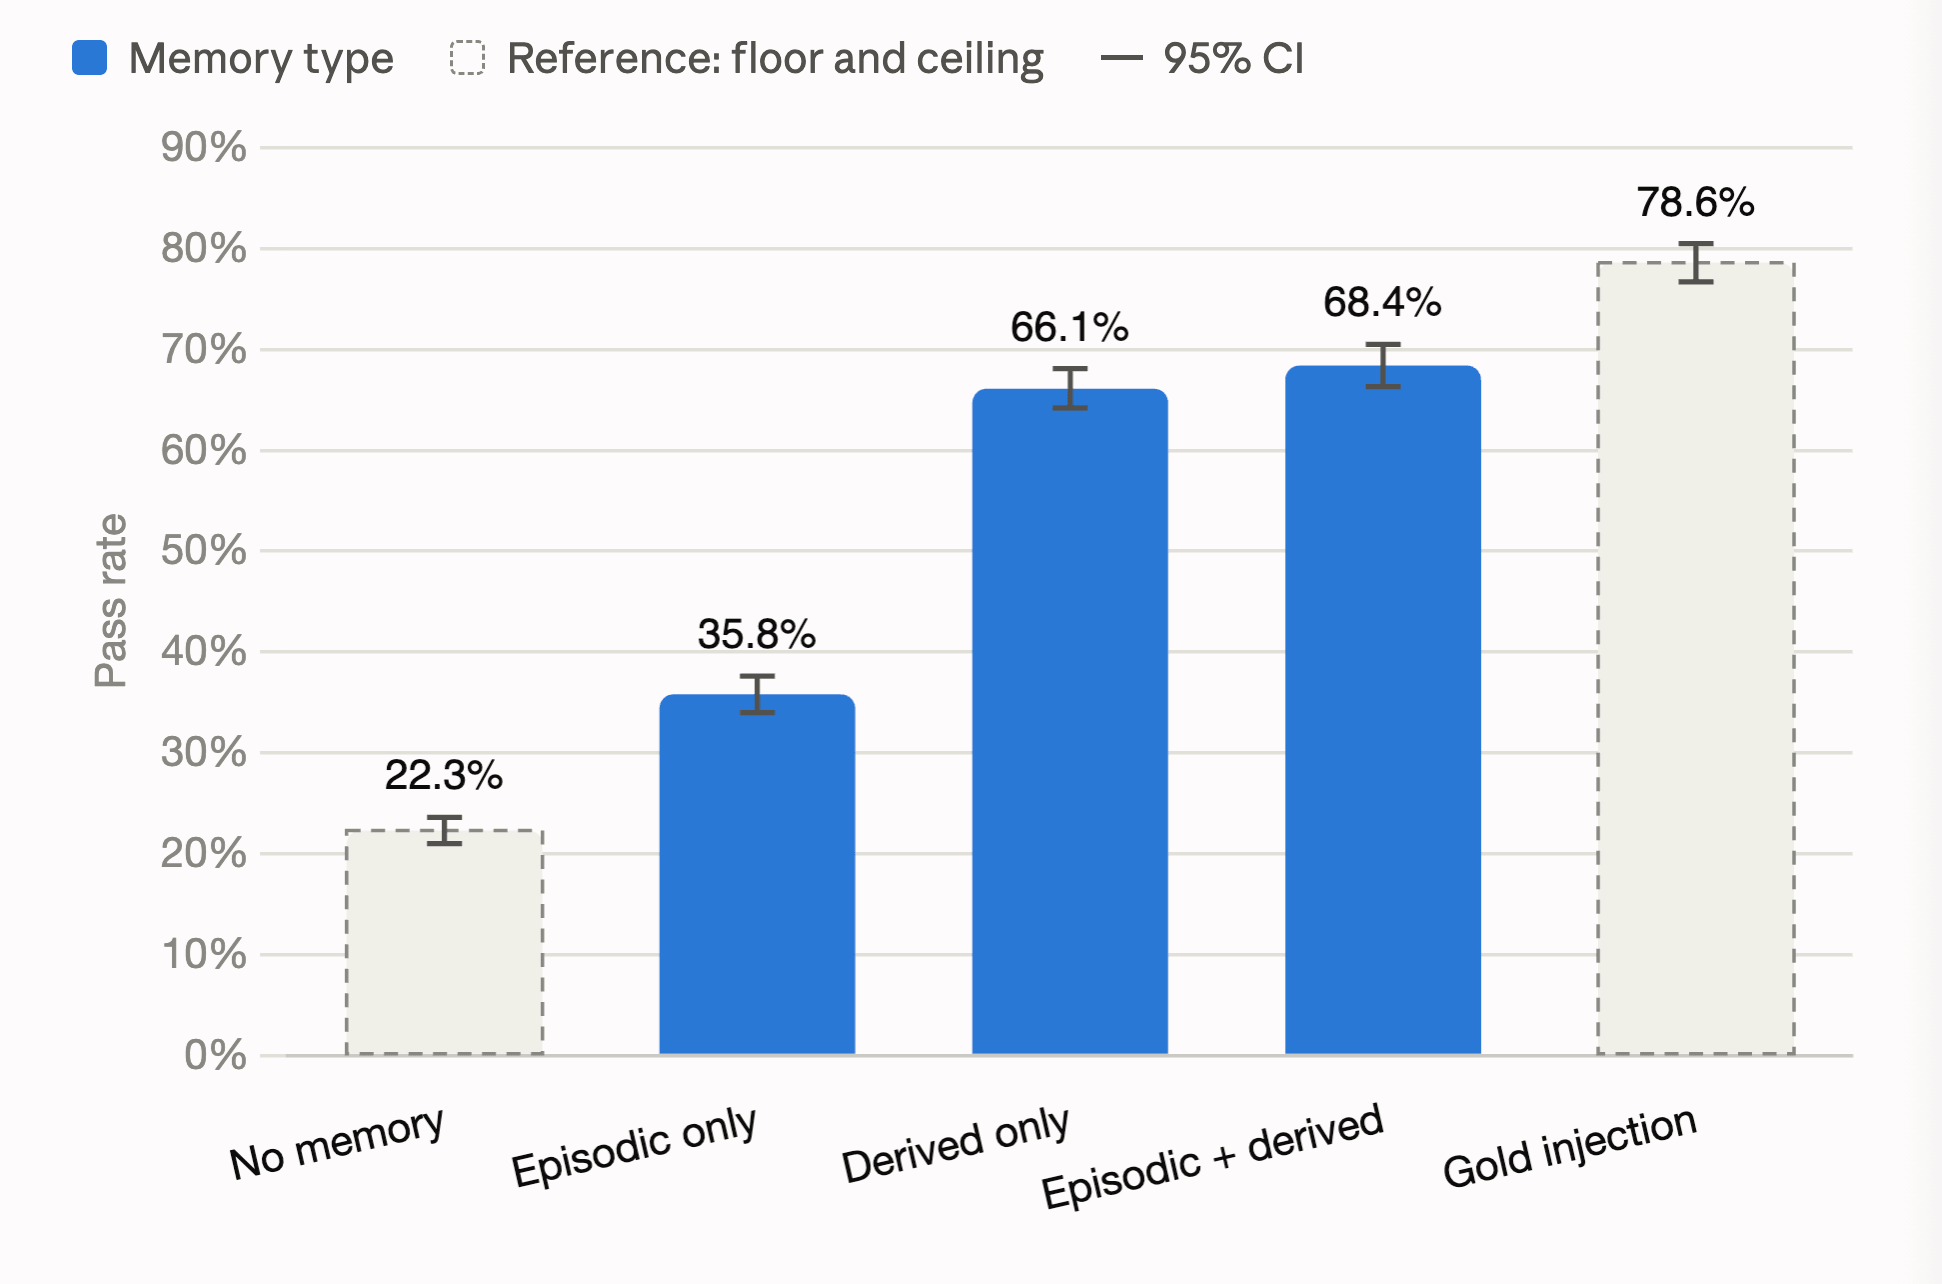
Figure 9. Taux de réussite par type de mémoire.
Quelle est une bonne stratégie d'extraction de mémoire ? Comme le montre la Figure 2, deux canaux extraient la mémoire dérivée : les outils en ligne et le « dreaming » (rêve) hors ligne. Lorsqu'il est isolé, le dreaming hors ligne (63,5 %) surpasse les outils en ligne (53,9 %) de près de 10 points. Leur combinaison produit le taux de réussite le plus élevé à 66,1 %. Cela confirme la répartition des tâches : le dreaming gère l'extraction et la consolidation en arrière-plan, tandis que les outils en ligne permettent aux requêtes explicites d'avoir un effet immédiat.
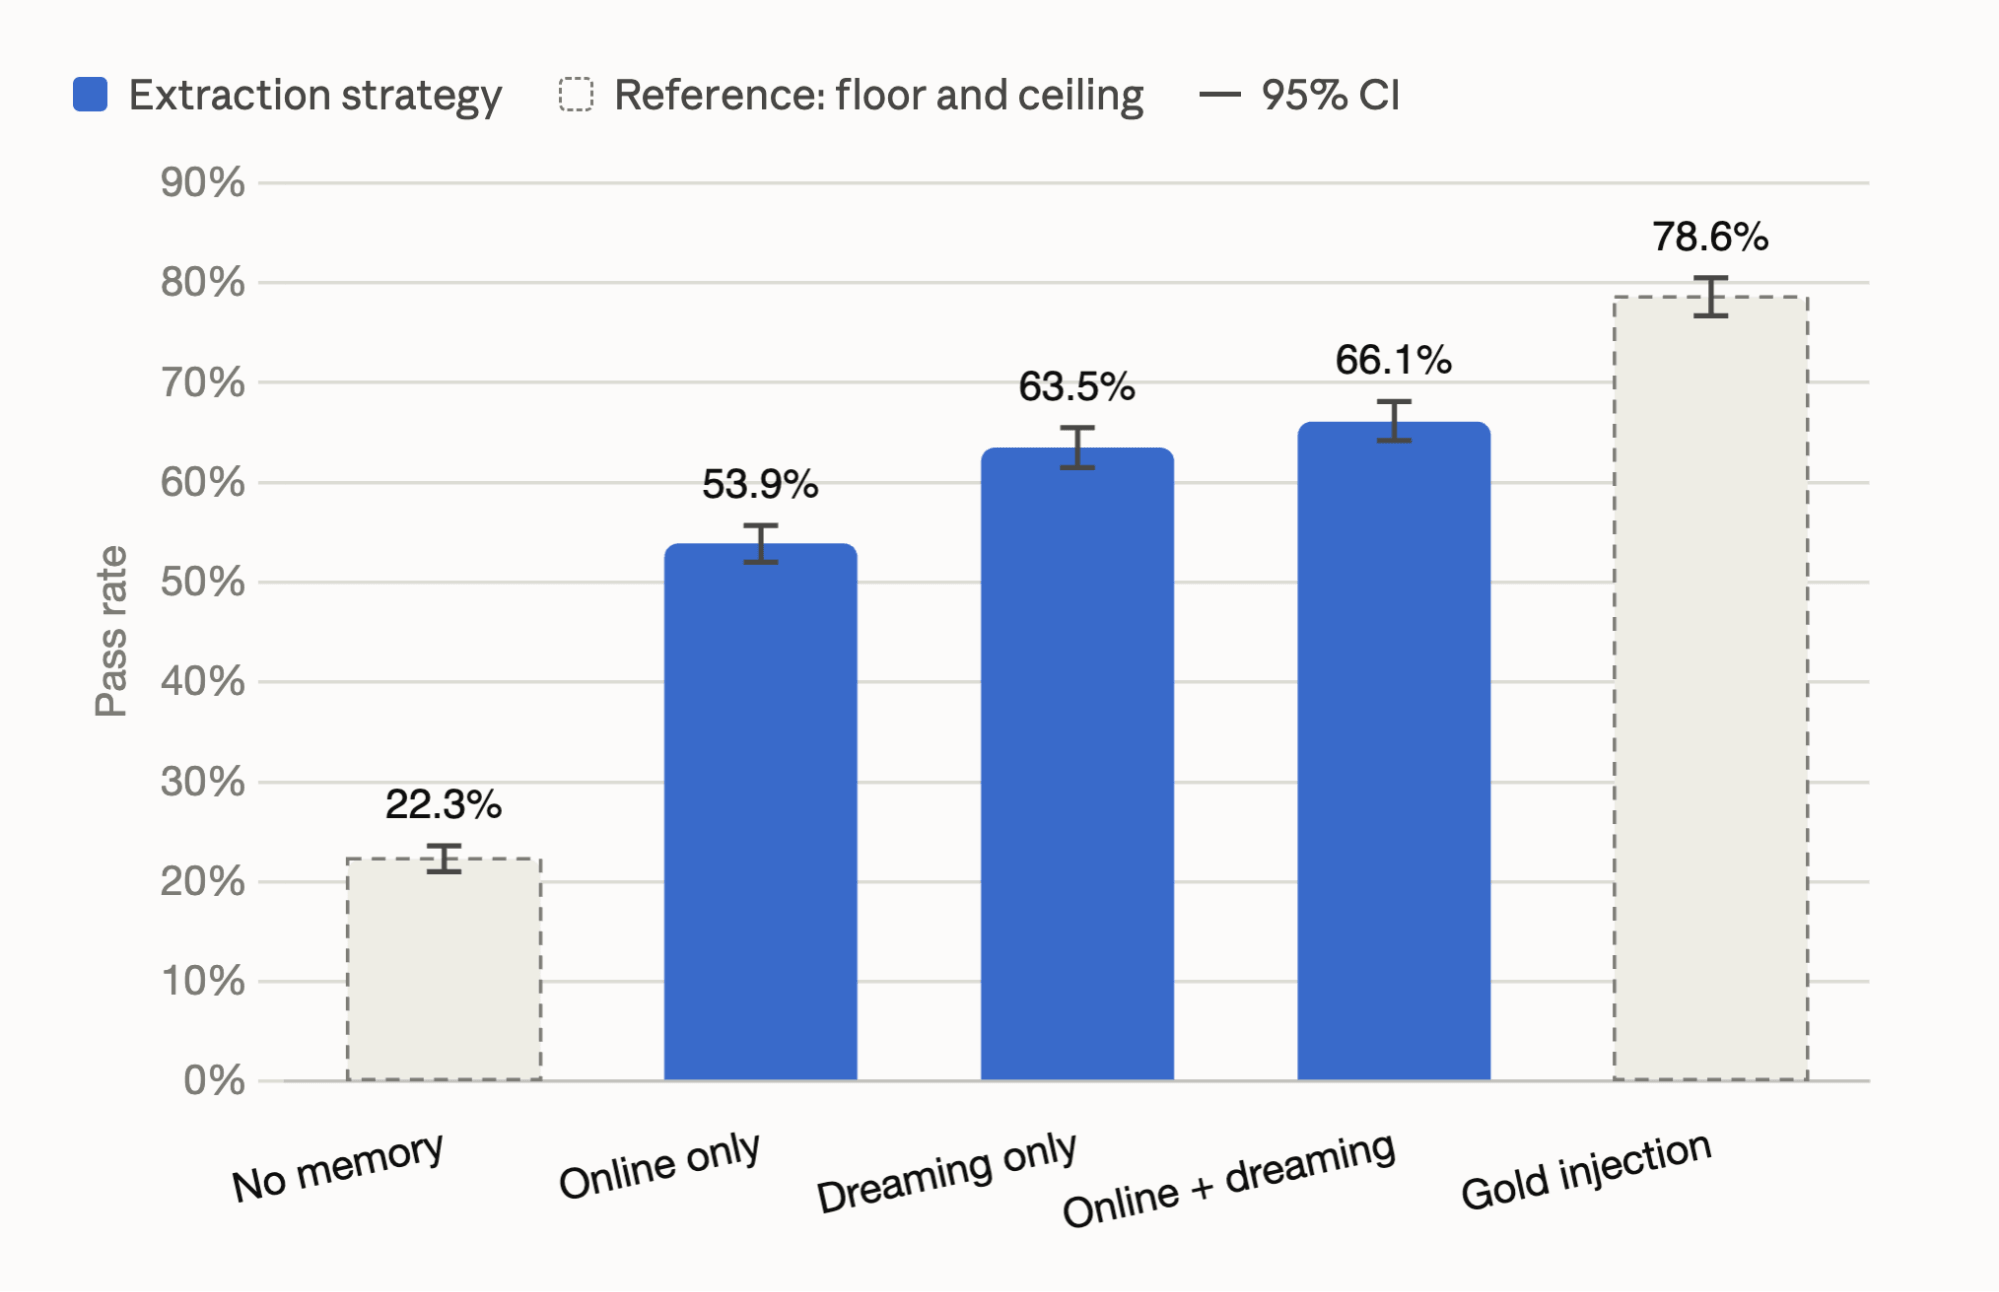
Figure 10. Taux de réussite par stratégie d'extraction.
Conclusion
La mémoire permet à un agent de ne plus repartir de zéro. Dans cet article, nous avons présenté MemCurrent, une architecture de mémoire pour agents en production qui combine mémoire épisodique et mémoire dérivée, avec trois modes d'accès : des plugins pour enregistrer et charger le contexte automatiquement, des outils que l'agent appelle à la demande, et un pipeline de dreaming hors ligne qui consolide la mémoire en arrière-plan.
Sur l'ensemble des benchmarks effectués, MemCurrent améliore simultanément la qualité et l'efficacité, le compromis que nous cherchions à surmonter. Sur les benchmarks open-source, il rivalise avec les performances du contexte complet avec environ 12 fois moins de jetons d'entrée. Sur notre benchmark de mémoire interne, élaboré à partir de travaux de données réels, il triple le taux de réussite de l'agent par rapport à l'absence de mémoire tout en le rendant plus rapide et plus économique.
Les études d'ablation montrent d'où provient cette valeur ajoutée. La mémoire dérivée accomplit la majeure partie du travail, et la mémoire épisodique apporte une amélioration complémentaire en récupérant des détails que la distillation laisse de côté. La combinaison des outils en ligne et du dreaming hors ligne constitue la meilleure stratégie d'extraction : les requêtes explicites prennent effet immédiatement, tandis que le dreaming distille les apprentissages implicites et consolide le magasin de données en arrière-plan.
Au-delà des chiffres, la mémoire fournit une base de connaissances qui n'est pas liée à un seul agent ou LLM. Elle peut accompagner les utilisateurs vers de nouveaux agents ou LLM et servir de socle à des connaissances partagées dans toute leur organisation, une piste que nous explorerons prochainement.
Prise en main
Nous exploitons ces résultats pour améliorer l'ensemble des produits Databricks :
Pour les développeurs d'agents. Agent Bricks est la plateforme de développement de Databricks conçue pour créer des agents personnalisés. MemCurrent est intégré à l'offre Memory d'Agent Bricks, propulsée par Lakebase. L'offre comprend :
- Stockage de session pour la mémoire épisodique
- Stockage de mémoire pour la mémoire dérivée
- Un pipeline de rêve automatique
- Traçabilité et évaluation de la qualité des agents, y compris l'impact de la mémoire
- Une CLI pour vous aider à démarrer rapidement avec un exemple d'agent de bout en bout comprenant tous ces éléments en <10 minutes
Démarrez la création de votre agent personnalisé dès aujourd'hui.
Pour les utilisateurs de Databricks Genie. Genie est une interface permettant aux utilisateurs de Databricks de converser avec leurs données en langage naturel. MemCurrent est déjà à l'œuvre en coulisses, aidant à améliorer la qualité des réponses tout en réduisant la latence et les coûts.
Démarrez avec Genie.
Auteurs : Veronica Lyu, Wenhao Zhan, Sam Havens, Ziyi Yang, Jenny Sun, Qinxin Wang, Nihit Desai, Sirui Sun, Ankit Mathur, Jane Zhang, Yi Liu, Jialu Liu, Michael Bendersky, Matei Zaharia, Xing Chen
Nous remercions Jonathan Li, Rishabh Singh, Andy Zhang, Kenneth Choi, Will Tipton, Cassie Cao, Siddharth Murching, Sue Ann Hong, Pranav Sukumar, Neo Ni, Shanshan Zheng, Chung Wu, ainsi que les participants à notre étude interne d'utilisateurs pour leurs retours et leur soutien tout au long de ce projet.
1 La latence est similaire (4-7s/question) sur l'ensemble des back-ends de mémoire, car la plupart des questions trouvent une réponse en un seul saut.
2 Nous constatons que la mémoire basée sur des plugins est suffisante pour les benchmarks existants. Les résultats découlant de l'ajout d'outils sont strictement dominés et donc omis.
(Cet article de blog a été traduit à l'aide d'outils basés sur l'intelligence artificielle) Article original
Recevez les derniers articles dans votre boîte mail
Abonnez-vous à notre blog et recevez les derniers articles directement dans votre boîte mail.