Il vero collo di bottiglia dell'imaging biomedico sono i dati, non il modello
Dai silos PACS alla multi-omica: perché l'IA per l'imaging si blocca sui dati e come costruire le fondamenta che la sbloccano.
- Cos'è: Una prospettiva sul campo sul perché l'AI per l'imaging medico non riesce a fornire i risultati attesi in ospedali, università, aziende medtech e farmaceutiche; e come dovrebbe essere una base dati più solida per la ricerca e sviluppo.
- La sfida: L'imaging è il dato più ricco della medicina ma il meno utilizzabile: silosato tra PACS, CRO e laboratori centrali, difficile da de-identificare e raramente collegato ad altre modalità di dati che alimentano biomarcatori e stratificazione dei pazienti. La parte difficile sono i dati, non il modello.
- Il punto chiave: La frontiera non è un modello migliore, ma la base dati che lo supporta. Governa l'imaging in un unico luogo, rendilo interrogabile, de-identificalo su larga scala e collegalo a dati EHR, omici e di sperimentazione (tramite pattern lakehouse governati). Gestisci correttamente i dati, e il modello diventerà la parte facile.
Parte I — Il problema
Quattro settori, un unico collo di bottiglia
Ospedali e sistemi sanitari generano la materia prima. La radiologia è l'ambito più strettamente regolamentato dell'AI medica: dei circa 950 dispositivi abilitati all'AI/ML autorizzati dalla FDA entro la metà del 2024, circa 723 (circa il 76%) erano strumenti di radiologia. Quasi tutti sono specifici e supervisionati da esseri umani, eseguendo triage, misurazione, ricostruzione o prioritizzazione delle liste di lavoro. La vera difficoltà in un ospedale raramente risiede nel modello. È che i dati sono bloccati all'interno di PACS e archivi vendor-neutrali costruiti per servire le immagini a un visualizzatore, non per rispondere a domande di ricerca. Estrarre una coorte significa estrarre immagini dai sistemi clinici, de-identificarle (il PHI si nasconde nelle intestazioni DICOM e viene "bruciato" nei pixel) e trovare la capacità di calcolo per utilizzarle. Il modello è il facile 10%.
I centri medici accademici sono il luogo in cui si svolge la maggior parte della scienza aperta. Il campo deve gran parte dei suoi progressi a dataset condivisi come MIMIC-CXR (377.110 radiografie del torace), The Cancer Imaging Archive, fastMRI e il braccio di imaging della UK Biobank, insieme a strumenti open source come MONAI, nnU-Net e 3D Slicer. L'accademia espone anche il problema di credibilità del settore. Una nota revisione del BMJ (Nagendran et al., 2020) sugli studi di imaging che confrontavano il deep learning con i clinici ha rilevato che, su 81 studi, solo una manciata erano prospettici o testati in un contesto clinico reale, e codice e dati non erano disponibili nel 93% e nel 95% di essi. Questo debito di riproducibilità risale direttamente alla difficoltà di condividere e ri-eseguire i dati di imaging.
Le aziende di tecnologia medica e dispositivi (GE HealthCare, Siemens Healthineers, Philips, Canon) integrano l'AI direttamente nello scanner: ricostruzione basata su deep learning che accorcia le scansioni, riduzione della dose, triage sul dispositivo. Il loro problema più difficile è la generalizzazione. Un algoritmo addestrato su uno scanner, una forza di campo e un protocollo di un fornitore può degradare silenziosamente su quelli di un altro. Curare dati di training multi-sito che rappresentino il mondo reale, e poi dimostrarlo ai regolatori attraverso i percorsi 510(k) e PMA, è sia il vantaggio competitivo che il costo.
Le aziende farmaceutiche e biotecnologiche trattano l'imaging come uno strumento di misurazione. Gli studi oncologici dipendono da criteri di risposta standardizzati come RECIST, iRECIST e RANO, letti centralmente e in cieco per eliminare il bias del sito, e i biomarcatori di imaging quantitativi possono rilevare la risposta ai farmaci prima delle misurazioni basate sulle dimensioni. Nulla di tutto ciò funziona a meno che una misurazione non significhi la stessa cosa tra siti, scanner e tempo, motivo per cui il QIBA dell'RSNA redige profili che definiscono l'acquisizione e l'analisi con una precisione dichiarata. La variabilità è il nemico di un endpoint di studio.
Quattro lavori diversi, un unico collo di bottiglia condiviso. I pixel sono ovunque, e interrogabili da nessuna parte.

Perché la collaborazione è l'elemento chiave, e perché è così difficile
Nessuna singola istituzione detiene dati sufficientemente diversi per costruire un modello che generalizzi. Lo studio collaborativo più forte fino ad oggi lo dimostra. Nello studio EXAM (Nature Medicine, 2021), 20 istituzioni hanno addestrato un modello condiviso per prevedere il fabbisogno di ossigeno per COVID-19 da radiografie del torace più dati EMR senza spostare alcun dato del paziente tra di loro. Solo i pesi del modello sono stati trasferiti, e il modello federato ha guadagnato, in media, il 16% in AUC e il 38% in generalizzabilità rispetto ai modelli a sito singolo. I meccanismi sono meno esotici di quanto sembri: ogni sito si addestra localmente, un coordinatore calcola la media dei pesi del modello anziché dei dati (la classica ricetta di federated-averaging), e l'aggregazione sicura e la privacy differenziale impediscono che i record di un singolo sito vengano ricostruiti da quei pesi.
Questa è la promessa. La realtà è che la collaborazione è genuinamente difficile, per ragioni strutturali piuttosto che tecniche:
- Eterogeneità dei dati. Scanner, protocolli e convenzioni di etichettatura diversi significano che "lo stesso" esame spesso non lo è. I modelli federati si degradano su questi dati non-IID, distorti dall'acquisizione, a meno che non vengano deliberatamente progettati con tecniche come la media della normalizzazione batch o l'armonizzazione consapevole del sito.
- Privacy e governance. Ogni studio inter-istituzionale comporta approvazioni IRB per sito, accordi sull'uso dei dati e de-identificazione che deve essere difendibile.
- Nessun substrato comune. Consorzi come MIDRC (co-diretti da ACR, RSNA e AAPM) esistono proprio perché l'acquisizione, la curatela, la de-identificazione, l'etichettatura e la condivisione sono così difficili da richiedere uno sforzo nazionale dedicato.
La collaborazione nell'imaging non è un optional. È l'unica strada per modelli che funzionano al di fuori dell'edificio in cui sono stati addestrati, ed è ostacolata quasi interamente dalla gestione dei dati e dalla governance.
La complessità che la maggior parte delle persone al di fuori del settore non vede mai
Quando le persone dicono "immagini mediche", di solito immaginano una radiografia del torace. La realtà è uno zoo di formati e scale che fa cedere gli strumenti di dati generici.
| Tipo di imaging | Formati | Dimensioni e scala | Perché gli strumenti generici cedono |
|---|---|---|---|
| Radiologia — Raggi X, TC, RMN | DICOM, codificabile in circa una dozzina di sintassi di trasferimento (non compresso → JPEG 2000 → HTJ2K) | Raggi X 2D → Volumi TC/RMN 3D → Cardiaco dinamico 4D | Costruito per spostare studi tra macchine, non per analizzare in massa; i decoder (pydicom, GDCM, pylibjpeg) funzionano a thread singolo — pochi studi sono banali, alcuni milioni sono un problema di sistemi distribuiti |
| Patologia digitale — immagini di intere sezioni | Formati proprietari: Aperio .svs, Hamamatsu .ndpi, Philips iSyntax (tramite OpenSlide); quasi nessun DICOM | Gigapixel — diversi GB, decine di migliaia di tessere, letto come una piramide a diverse magnificazioni | Troppo grande per essere aperto in memoria; il colore della colorazione e dello scanner varia da laboratorio a laboratorio, diventando una propria fonte di errore del modello |
| Oftalmologia, dermatologia e altro | Volumi OCT, fotografia clinica, ciascuno con le proprie convenzioni | 2D e 3D, specifici per modalità | Un'altra serie di formati che uno strumento per "cartelle di JPEG" non è mai stato costruito per gestire |
"Le immagini mediche" non sono una cosa sola — sono uno zoo di formati e scale. Gli archivi di ricerca raggiungono i petabyte, una quantità tale che la loro de-identificazione su larga scala è una linea di ricerca pubblicata a sé stante.
Esiste un secondo tipo di complessità che silenziosamente compromette gli studi: i numeri stessi non sono comparabili tra i siti. Un valore di uptake standardizzato o un volume tumorale misurato su due scanner con due protocolli non sono la stessa misurazione. Questo è il motivo per cui l'imaging quantitativo si basa su standard come i profili QIBA e le definizioni IBSI per le caratteristiche radiomiche, e perché la riproducibilità, non l'accuratezza grezza, è solitamente ciò che fallisce.
Uno strumento che gestisce una cartella di JPEG non può gestire nulla di tutto questo, il che è una parte importante del motivo per cui l'imaging è rimasto indietro rispetto alla genomica e ai dati EHR nel diventare pronto per l'analisi.
L'imaging è la punta più acuta di un problema più grande
Ciò che è facile perdere di vista quando ci si concentra solo sulle immagini: tutto ciò che è qui descritto è vero anche per il resto della R&S. L'imaging è solo il luogo in cui il problema si manifesta per primo, perché i dati sono i più grandi e i più strani.
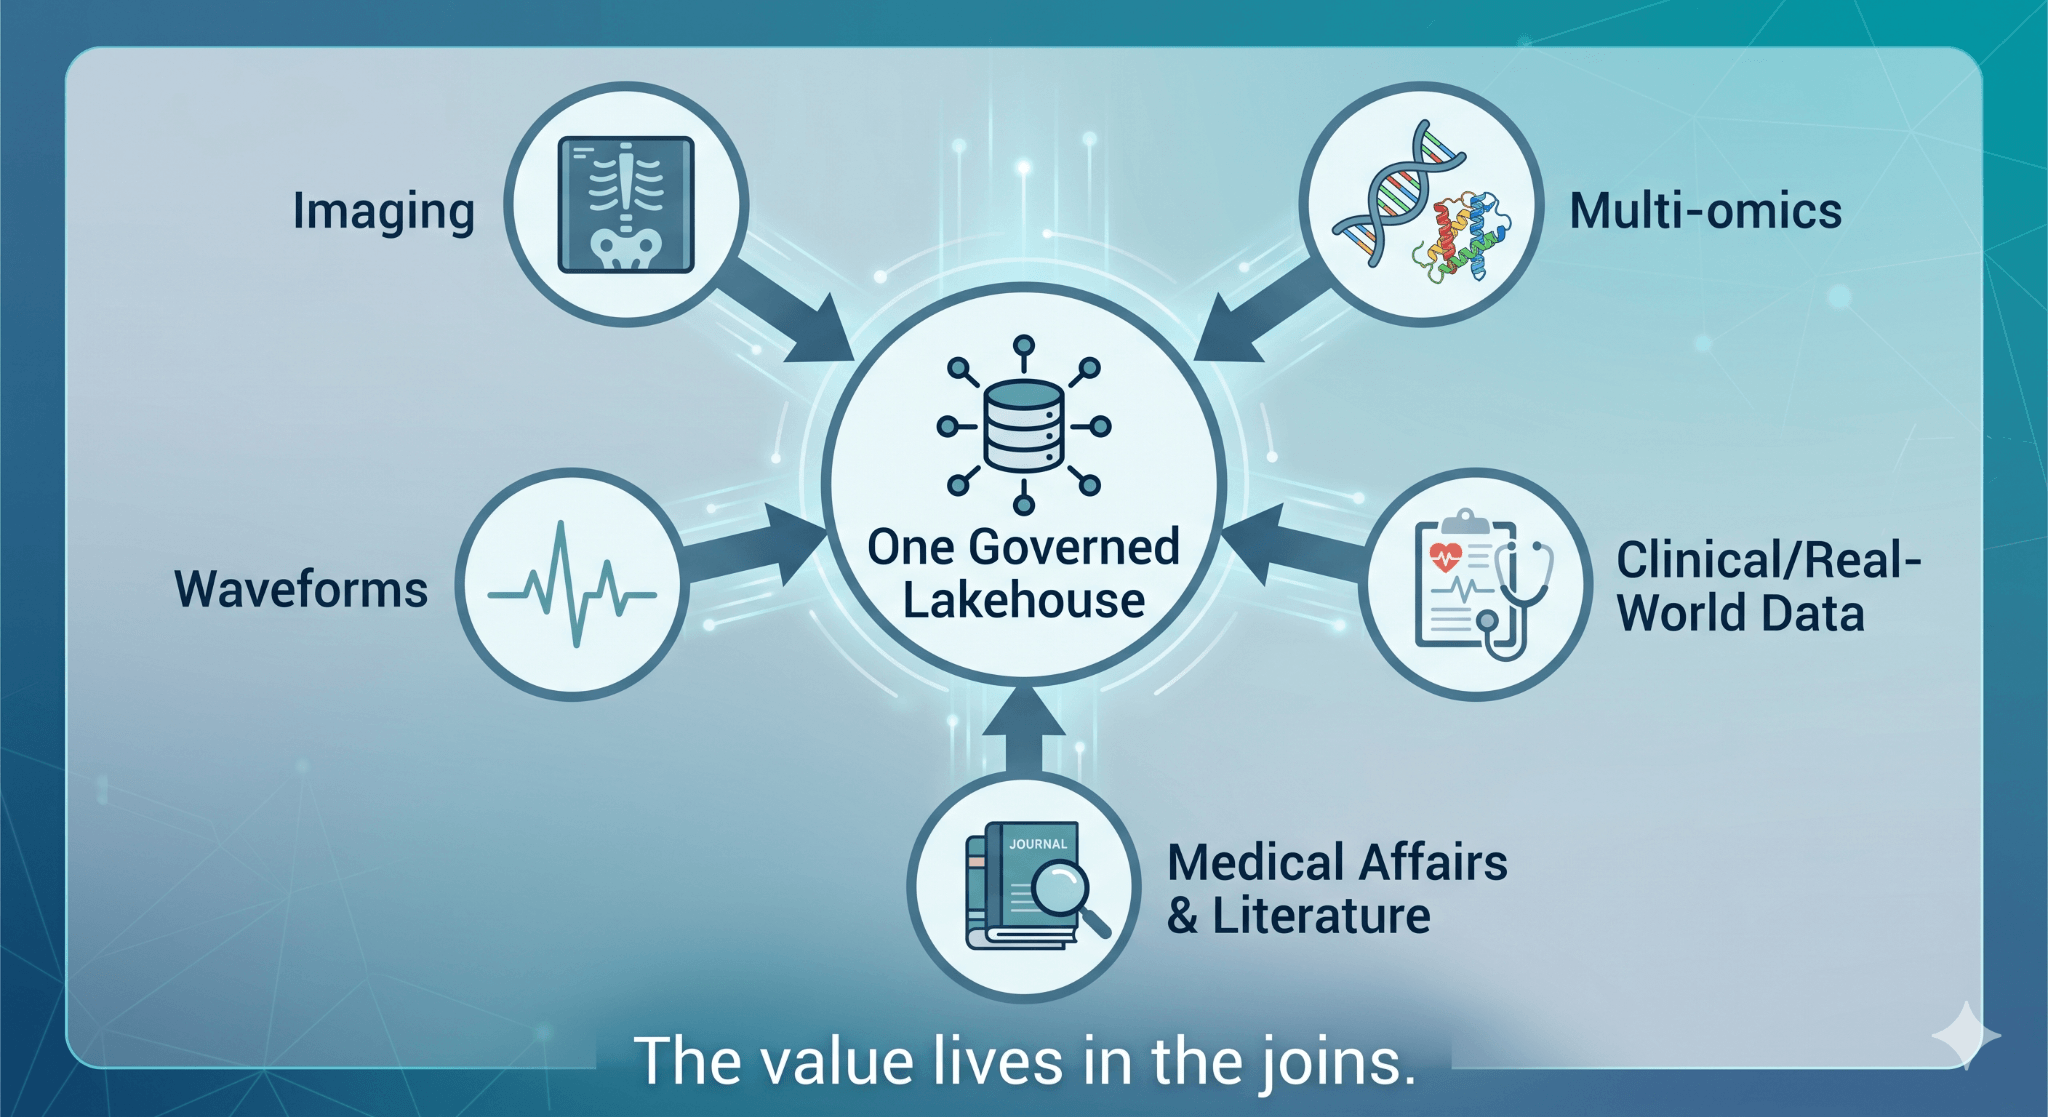
Entrando oggi in un'organizzazione di R&S nel campo delle scienze della vita, la vera frontiera non è un singolo tipo di dato. È la multi-omica, la genomica, la trascrittomica, la proteomica e la metabolomica, ognuna delle quali arriva con i propri formati e silos. Sono dati del mondo reale e di studi clinici, EHR e registri e forme d'onda. Sono gli affari medici e la letteratura. Le domande che fanno effettivamente progredire un programma, quali pazienti rispondono e perché, cosa dicono insieme l'immagine, la firma molecolare e l'esito, vivono nelle intersezioni tra questi domini, non all'interno di uno solo di essi.
Ognuno di questi tipi di dati porta con sé la stessa afflizione dell'imaging. È ricco, ad alta dimensionalità, per lo più non strutturato, intrappolato in sistemi specifici di dominio, difficile da governare e più difficile da collegare. Un'immagine di intera sezione, una chiamata di variante genomica e un endpoint di studio sono già abbastanza difficili da soli. Il valore deriva dal metterli nella stessa frase. Questo è un problema di fondazione dei dati prima ancora di essere un problema di AI, ed è quello che i team sottovalutano di più.
Questa non è solo una storia di assistenza sanitaria. Una recente analisi di Bain sul perché i budget dell'AI continuano a salire mentre i rendimenti no, ha rilevato che l'accesso e l'integrazione dei dati sono la più grande barriera all'AI, citata dal 41% delle aziende e nominata ancora più spesso dai leader rispetto ai ritardatari. La loro versione schietta: la maggior parte delle organizzazioni non riesce ancora ad accedere in modo affidabile ai propri dati. La medicina rende solo più difficile ignorarlo.
Parte II — La fondazione
Qui le cose si fanno più concrete e tecniche. Per i lettori che non stanno costruendo la piattaforma, la versione breve è semplice: governare tutto in un unico luogo, rendere i pixel interrogabili, de-identificare su larga scala e collegare l'imaging al resto dei dati del paziente. Il resto di questa sezione spiega come.
Cosa deve fare effettivamente la fondazione dei dati
Eliminando le specificità del settore, i requisiti risultano gli stessi. La piattaforma deve:
- Governare i file di imaging non strutturati e i loro metadati estratti in un unico luogo, con controllo degli accessi, lignaggio e auditabilità che resistano alle domande di un regolatore.
- Elabora dati multidimensionali su scala petabyte e gigapixel (raggi X 2D, volumi CT/MRI 3D, studi dinamici 4D, vetrini patologici gigapixel) senza interruzioni.
- De-identifica su larga scala, sia nelle intestazioni che nei pixel.
- Collega l'imaging a EHR, genomica, forme d'onda e testo, in modo che una singola domanda di ricerca possa toccarli tutti.
- Rendi la condivisione tra istituzioni un passaggio di configurazione, non una negoziazione di sei mesi.
Questa è la forma di un lakehouse. Ecco come si traduce in pratica, utilizzando modelli che funzionano su Databricks.
Un'architettura a medaglione per Pixels
Il modello mentale che rende l'imaging trattabile è lo stesso modello a medaglione che i team già utilizzano per i dati tabulari, adattato per i file binari.
- Bronze: gli studi grezzi atterrano prima in uno storage di oggetti cloud ad accesso limitato o in un Volume, dove un lavoro di de-identificazione viene eseguito su intestazioni e pixel prima di qualsiasi altra cosa; i file de-identificati formano quindi il livello bronze governato in Unity Catalog Volumes, una riga di catalogo per file, con Auto Loader che gestisce l'arrivo incrementale in modo che i nuovi studi fluiscano continuamente piuttosto che in fragili batch notturni.
- Silver: i tag DICOM con valori di testo vengono estratti in tabelle Delta (i blob binari come i dati dei pixel rimangono nel file), in modo che i metadati che erano intrappolati all'interno dei file diventino interrogabili con SQL semplice. Questo è il passaggio che trasforma "un visualizzatore può aprirlo" in "un analista può interrogarlo". L'acceleratore open-source Pixels fa esattamente questo, catalogando i file in parallelo ed estraendo i tag su larga scala.
- Gold: coorti curate e pronte per l'analisi, unite a tabelle cliniche e omiche e pronte per il training, la BI o uno studio rivolto a un regolatore.
La ragione per cui questo non è banale è il throughput. Le librerie di parsing DICOM sono single-core; il trucco è distribuirle. In pratica ciò significa UDF pandas e mapInPandas per distribuire il parsing su un cluster, o una sorgente dati Spark personalizzata. Nel lavoro pubblicato dal team Pixels, una sorgente dati zipdcm legge i metadati DICOM direttamente dagli archivi zip in memoria, lasciando i file originali compressi sul posto: ha catalogato più di 107.000 DICOM in circa 3,5 minuti su due worker a 8 core, circa 7 volte più velocemente rispetto agli approcci precedenti. Il collo di bottiglia si sposta dall'I/O del disco e della rete al parsing puro della CPU, che è esattamente il tipo di cosa per cui un cluster è bravo.

Governance che supera un audit
L'imaging è il problema di governance dei dati non strutturati per eccellenza, ed è il requisito che la maggior parte delle piattaforme non riesce a soddisfare silenziosamente. Unity Catalog Volumes governa i file grezzi in S3, ADLS o GCS sotto un namespace a tre livelli, mentre i metadati estratti atterrano in Delta. Entrambi rientrano in un unico modello di controllo degli accessi e di lineage che si estende fino ai modelli addestrati sui dati, il che rende possibile rispondere "chi ha toccato questa coorte e cosa è stato costruito da essa" mesi dopo. La sicurezza a livello di riga e colonna e le regole basate sugli attributi consentono a un'organizzazione di esporre ampiamente i metadati de-identificati mantenendo i pixel sottostanti bloccati.
La de-identificazione è dove la cosa si fa seria. L'PHI dell'intestazione viene gestito con crittografia che preserva il formato in modo che lo stesso identificatore del paziente si mappi sempre allo stesso pseudonimo. Questo dettaglio è più importante di quanto sembri: significa che la TC di un paziente può ancora essere collegata alla sua patologia e ai suoi esami di laboratorio tra i dataset senza mai esporre l'identificatore reale. I profili di riservatezza dello standard DICOM definiscono cosa rimuovere e cosa mantenere. Il problema più difficile è l'PHI "bruciato" nei pixel, il nome del paziente incorporato in un'ecografia o in un modulo scansionato. Strumenti classici come Presidio gestiscono bene il testo libero ma non le immagini. La rimozione di quell'PHI incorporato è un problema di ricerca attivo: lavori recenti mostrano che i modelli vision-language superano ora le pipeline solo OCR nel rilevarlo e oscurarlo (Lee et al., Radiology 2025), e i metodi di de-identificazione in produzione che accoppiano la sanificazione dei metadati DICOM con OCR mirato sul testo incorporato sono stati validati su centinaia di migliaia di immagini che coprono dieci modalità (Macdonald et al., 2024). Per i pixel, il team Pixels ha pubblicato una pipeline di modelli vision-language che combina OCR con un VLM e viene eseguita in modo distribuito con UDF pandas. Su un campione bilanciato dal benchmark MIDI-B, GPT-4o e Claude 3.7 Sonnet hanno raggiunto circa il 100% di recall e precisione, l'open Llama 4 Maverick ha raggiunto il 100% di recall a una frazione del costo, e Spark ha ridotto la de-identificazione di 1.000 frame da 105 minuti a 6. Il team sta anche esplorando un approccio più snello, solo VLM, per spingersi oltre.
Training e serving, sullo stesso dato governato
Una volta che i pixel sono interrogabili e governati, il livello ML smette di essere la parte difficile. I modelli di segmentazione e classificazione si registrano nello stesso catalogo dei modelli MLflow, con la loro lineage che risale alla coorte esatta su cui sono stati addestrati. Per l'imaging in particolare, NVIDIA MONAI e VISTA-3D (un modello di segmentazione fondamentale che copre 127 classi anatomiche) si integrano per l'auto-segmentazione e il fine-tuning, con un visualizzatore OHIF incorporato in una Databricks App in modo che un radiologo o un patologo possa rivedere, correggere e rietichettare sotto il modello di sicurezza della piattaforma.
Il loop di active-learning di MONAI Label significa che ogni correzione migliora il batch successivo, ed è così che i team escono dalla trappola di aver bisogno di un dataset completamente annotato prima di poter iniziare. L'inferenza viene eseguita come serving di modelli GPU in tempo reale (scale-to-zero in modo che un modello usato raramente non stia "bruciando" una GPU) o come inferenza batch distribuita su milioni di studi. E poiché i lavori più recenti di Pixels distribuiscono un servizio DICOMweb (QIDO-RS, WADO-RS, STOW-RS), il lakehouse può trovarsi direttamente in un flusso di lavoro clinico o PACS/VNA piuttosto che a lato.
Dimostrare che è sicuro: validazione, drift e percorso normativo
Addestrare un modello è l'inizio, non la fine. Un modello che sembra ottimo sullo scanner di un singolo sito può degradare silenziosamente su quello di un altro, quindi il vero lavoro è la validazione esterna tra siti, fornitori e protocolli, quindi il monitoraggio del drift man mano che gli scanner vengono aggiornati e i protocolli cambiano in produzione. MLflow gestisce la valutazione e il tracciamento; la disciplina più difficile è trattare ogni modello come un asset versionato con la sua coorte, le metriche e le approvazioni allegate. Per qualsiasi cosa si diriga verso la clinica, i regolatori hanno iniziato a venire incontro all'AI adattiva. Il Predetermined Change Control Plan (PCCP) della FDA consente ai team di pre-specificare come un modello può essere riaddestrato e aggiornato senza una nuova presentazione ogni volta, e le Good Machine Learning Practice (GMLP) stabiliscono le aspettative per i dati, la validazione e il monitoraggio. Costruire queste "guardrail" nelle fondamenta dei dati, invece di aggiungerle in seguito, è ciò che separa una demo da qualcosa che un ospedale implementerà.
Collaborazione senza spostare i dati
Ci sono due modi complementari per ottenere la diversità inter-istituzionale che EXAM ha dimostrato essere necessaria, e risolvono problemi diversi.
Il federated learning mantiene i dati fisicamente in loco e sposta solo i pesi del modello, con l'averaging federato per combinarli e l'aggregazione sicura più la privacy differenziale per impedire che i dati di qualsiasi sito fuoriescano. È lo strumento giusto quando i dati non possono muoversi affatto legalmente.
Il lakehouse aggiunge una seconda opzione che è spesso più semplice in pratica: Delta Sharing e Clean Rooms consentono alle istituzioni di condividere tabelle e file governati (o eseguire analisi congiunte su coorti de-identificate) senza copiare nulla, utilizzando la distribuzione di credenziali piuttosto che l'esportazione di dati. Per molte ricerche multi-sito, "condividere una vista governata della coorte" è un compito molto più leggero rispetto all'implementazione di un anello di training federato, e i due possono essere combinati.
Rendere l'imaging multimodale
Questo è il requisito che trasforma l'imaging da una modalità autonoma in parte del paziente. Poiché i metadati sono solo Delta, l'imaging può essere unito a feed FHIR e HL7 da EHR, a tabelle di varianti genomiche, a forme d'onda e a testo clinico, con l'identità del paziente risolta tramite lo strato di pseudonimizzazione. Modelli di dati comuni come OMOP danno ai dati osservazionali uno schema condiviso in cui atterrare. Inoltre, Vector Search indicizza gli embeddings per il recupero semantico (Pixels distribuisce anche una funzione che mappa un termine in linguaggio naturale al tag DICOM corretto), e strumenti di linguaggio naturale come Genie consentono a uno scienziato di costruire una coorte chiedendola invece di scrivere SQL.
Le forme d'onda fisiologiche sono un tipo di dati a sé stante. Un ECG, una traccia della pressione arteriosa o un pullback IVUS o OCT è una serie temporale ad alta frequenza campionata centinaia o migliaia di volte al secondo, solitamente archiviata in formati come WFDB anziché DICOM. Il problema tecnico è l'allineamento: un frame di pullback o un battito ECG ha significato solo quando è sincronizzato temporalmente con l'immagine e l'evento clinico a cui appartiene. Fare questo correttamente, ricampionare, riconciliare i timestamp e archiviare la serie accanto allo studio, è esattamente il tipo di unione che ripaga quando la domanda è perché un paziente ha risposto, non solo se.
Gli embedding sbloccano anche qualcosa di più potente della semplice ricerca. I modelli immagine-testo addestrati su scansioni e referti accoppiati (la linea di lavoro BiomedCLIP e CheXzero) collocano immagini e linguaggio in uno spazio vettoriale condiviso, in modo che i sistemi possano recuperare casi simili, segnalare reperti senza un'etichetta esplicita o basare un modello generativo sulle immagini reali e sui referti precedenti di un paziente anziché solo sui suoi dati di addestramento. Quest'ultimo modello, la generazione aumentata dal recupero su immagini più referti, è ciò che rende la stesura dei referti e la sintesi dei casi abbastanza affidabile da essere mostrata a un clinico: il modello può indicare ciò che ha visto. Funziona solo quando le immagini, i referti e i loro embedding si trovano insieme sotto un unico tetto governato, il che è questo intero pezzo in miniatura.
Questo è anche ciò di cui ha bisogno la nuova ondata di modelli di fondazione. Prov-GigaPath (Nature, 2024), pre-addestrato con auto-supervisione su 1,3 miliardi di tessere da 171.189 immagini di intere sezioni, funziona solo con dati ampi, diversi, governati e multimodali. I silos non possono alimentarlo. Una lakehouse sì.
Il risultato: un co-scienziato per il ricercatore, un compagno per il clinico
La versione tangibile di tutto questo non è un sistema autonomo che sostituisce nessuno. È un compagno, un co-scienziato AI per il ricercatore e un co-pilota per il clinico, basato sui dati governati dell'istituzione stessa anziché sull'internet aperto.
Per un ricercatore, un agente co-scienziato trasforma una domanda in lavoro. Chiedetegli di "trovare pazienti NSCLC naive al trattamento con una TC basale, patologia corrispondente e stato EGFR, quindi riassumere come le lesioni sono cambiate al follow-up", e pianifica i passaggi, interroga le tabelle di imaging e cliniche tramite uno spazio Genie, recupera casi simili con Vector Search, chiama un endpoint di segmentazione per misurare le lesioni e basa il suo riassunto nella letteratura pertinente, con ogni affermazione tracciabile ai dati che ha utilizzato.
La classe emergente di sistemi "AI co-scienziato" mira esattamente a questo: aiutare a generare e selezionare ipotesi, non solo a rispondere a ricerche. Ciò che separa un giocattolo da un collaboratore fidato è se si basa su dati governati e multimodali.
Per un clinico, la stessa macchina diventa un compagno che svolge il lavoro di base che un radiologo o un oncologo farebbe altrimenti a mano: recuperare gli antecedenti del paziente, misurare e confrontare le lesioni, evidenziare i criteri guida applicabili e redigere il referto per la revisione. Non firma mai; lo fa l'essere umano. Questa non è una limitazione, è il design. Quasi tutta l'AI di imaging approvata oggi è supervisionata dall'uomo, e un compagno che mostra il suo lavoro e cita le sue fonti è ciò che rende tale supervisione reale anziché un timbro di gomma.
Ciò che rende entrambi sicuri è la fondazione sottostante. Ogni strumento chiamato dall'agente è un oggetto governato, una funzione di Unity Catalog, un endpoint di model serving, un indice di Vector Search, uno spazio Genie, quindi gli stessi controlli di accesso, la stessa lineage e l'identità 'on-behalf-of' che proteggono i pixel limitano anche ciò che l'agente può vedere e fare. Componi specialisti, un agente di radiologia, un agente di genomica, un agente di affari medici, sotto un supervisore, e il team di agenti riflette le unioni multimodali che la fondazione dati rende già possibili. Il compagno è la parte facile, una volta che la fondazione è corretta.
Oltre l'imaging: la stessa fondazione supporta il resto della R&S
Il motivo per cui questo è importante oltre la radiologia è che la stessa identica architettura assorbe il resto del patrimonio di dati di R&S. La multi-omica (genomica, trascrittomica, proteomica, metabolomica) arriva nello stesso Unity Catalog insieme ai dati di imaging e clinici. Porta i suoi formati e standard pesanti, VCF per le varianti, BAM e CRAM per le letture di sequenziamento allineate, le specifiche GA4GH che li mantengono interoperabili e motori come Glow e Hail per l'analisi su scala di popolazione, ma il pattern della lakehouse è identico: governare i file, estrarre lo strato interrogabile, unirlo a tutto il resto.
Qui si inserisce anche lo stack NVIDIA come BioNeMo e NIMs per i modelli di sequenza e struttura. Dati del mondo reale e di studi clinici, registri e forme d'onda si uniscono a coorti di imaging senza un'esportazione. Gli affari medici e la letteratura diventano testo interrogabile sotto la stessa governance e la stessa superficie AI/BI e Genie. I programmi che vanno avanti, quelli che rispondono a quali pazienti rispondono e perché, vivono nelle unioni tra questi domini, e una lakehouse è la rara architettura che contiene una slide gigapixel, una chiamata di variante e un endpoint di trial sotto un unico modello di governance e permette di interrogarli insieme.
Il punto cruciale

I team che costruiscono AI e GenAI su questo tipo di dati continuano a imbattersi nella stessa lezione. Un modello può essere dimostrato bene in una settimana. Ciò che richiede mesi dopo è rendere i dati puliti, collegati, de-identificati e sufficientemente governati per potersi fidare di essi di fronte a uno scienziato o a un regolatore. Il problema dei dati non è la parte meno affascinante del progetto. È il progetto.
Considerando i dati di imaging, omici, clinici e di affari medici all'interno delle stesse organizzazioni, la conclusione è semplice. La frontiera nell'imaging medico non è un'architettura migliore. È una fondazione migliore. Gli algoritmi esistono. I dati esistono, da qualche parte. Ciò che è mancato è un modo per rendere l'imaging governato, interrogabile, collegabile e condivisibile, e unito a tutto il resto che una domanda di ricerca tocca, senza rinunciare alla privacy e al rigore che la medicina richiede.
I team che vinceranno in R&S non saranno quelli che inseguiranno prima il modello. Saranno quelli che sistemeranno prima i dati e lasceranno che l'AI segua. Risolvete questo, e il modello diventerà la parte facile, come è sempre stato.
Da dove iniziare
Il modo più veloce per testarlo è sui vostri dati.
- Iniziate con l'acceleratore open-source Pixels (databricks-industry-solutions/pixels) per trasformare una cartella di DICOM in tabelle Delta governate e interrogabili e vedere il pattern a medaglione in azione.
- Eseguitelo su Databricks. Avviate un workspace, puntate i volumi di Unity Catalog a un dataset pubblico come TCIA o MIMIC-CXR e configurate l'ingestione, la de-identificazione e un visualizzatore OHIF end-to-end prima di importare dati protetti.
- Approfondite l'ingegneria dietro i numeri qui: l'ingestione 7x, la de-identificazione VLM e gli articoli MONAI/VISTA-3D collegati sopra.
- Scalate da una coorte all'intero patrimonio. Una volta che un singolo tipo di studio è ingerito, de-identificato e unito a una tabella clinica, lo stesso pattern si estende alla multi-omica, ai dati del mondo reale e allo strato agentico superiore.
Se il vostro team sta sviluppando soluzioni per l'imaging medico o la R&S multimodale su Databricks, gli autori vorrebbero sapere come lo state affrontando. Contattateci o lasciate un commento, e quando sarete pronti a passare da un progetto pilota alla produzione, il team Databricks Healthcare and Life Sciences potrà aiutarvi a raggiungere l'obiettivo.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.