La piattaforma Claude ora supporta l'osservabilità OpenTelemetry nativa in Databricks MLflow
Unifica l'osservabilità di Claude in Databricks con l'acquisizione nativa di OpenTelemetry. Usa le tracce raccolte con MLflow per trovare errori ricorrenti e migliorare gli agenti.
- OpenTelemetry per Claude Platform è ora disponibile in Beta pubblica. L'esportazione OTel nativa integra Anthropic SDKs, Messages API e Claude Managed Agents in Databricks MLflow, con le tracce memorizzate in Unity Catalog.
- Usa l'analisi delle tracce e MLflow Issues per esaminare le risposte errate e trovare chiamate di strumenti ripetute tra esecuzioni e sessioni.
- Esamina le risposte con gli esperti del settore, poi esegui la valutazione con gli stessi casi di test per verificare se le modifiche migliorano la qualità e riducono il lavoro non necessario.
Un agent può restituire una risposta plausibile pur tralasciando un risultato importante o leggendo ripetutamente la stessa origine. La sola risposta non ne spiegherà il motivo. Le tracce mostrano le chiamate al modello e agli strumenti sottostanti, consentendoti di analizzare l'errore, trovare casi correlati e verificare se una modifica apporta miglioramenti.
Databricks MLflow è ora una destinazione supportata per l'esportazione nativa di OpenTelemetry dalla piattaforma Claude. Con l'esportazione nativa in Databricks MLflow, gli sviluppatori che utilizzano gli SDK Anthropic, la Messages API e i Managed Agents possono inviare tracce native a Databricks e utilizzare MLflow per eseguire il debug dei propri agenti e valutare le modifiche.
OpenTelemetry nativo, unificato in Databricks
MLflow Tracing è basato su OpenTelemetry, uno standard aperto per la raccolta e l'esportazione di segnali di servizio. Una traccia registra l'esecuzione di un agente come singoli passaggi, denominati span, come le richieste al modello e le chiamate agli strumenti. La strumentazione nativa di Claude genera questi span ed li esporta utilizzando il protocollo OpenTelemetry.
Databricks riceve gli span tramite Zerobus Ingest e li archivia nelle tabelle di Unity Catalog collegate a un esperimento MLflow. Puoi ispezionare le tracce di Claude insieme a quelle di altri servizi instrumentati, utilizzando gli stessi strumenti di debug e valutazione. Unity Catalog controlla l'accesso ai dati, che puoi anche interrogare con SQL. Grazie alla combinazione di Zerobus e Unity Catalog, le aziende possono ottenere due vantaggi cruciali: inserimento di tracce a bassa latenza con QPS elevati e la capacità di governare l'accesso ai dati sensibili archiviati nelle tracce degli agenti.

Connetti Claude in 3 passaggi
1. Crea un esperimento
In Databricks, apri la scheda Experiments e fai clic su Create Experiment. Sotto Trace storage location, mantieni selezionato Unity Catalog. Scegli un catalogo e uno schema esistenti. Verranno così creati nuovi esperimenti MLflow collegati alla tabella di Unity Catalog che archivia le tracce OpenTelemetry.
La guida dettagliata alla configurazione illustra i requisiti relativi alle autorizzazioni e ai warehouse SQL.
2. Configura l'esportazione nativa
Imposta la destinazione Databricks utilizzando l'ID del tuo workspace, la regione e la tabella degli span. La guida alla connessione Zerobus spiega come ottenere un token OAuth con ambito di tabella.
Le nuove integrazioni OTel native coprono gli SDK Anthropic, la Messages API e i Managed Agents. Per l'SDK Anthropic, installa i pacchetti sottostanti e configura un provider e un esportatore di tracer OTel per creare span per le chiamate all'SDK Anthropic. Segui la guida OpenTelemetry della piattaforma Claude per inviare le tracce dalla Messages API e da Claude Managed Agent alla tua destinazione Databricks.
Claude Code e Claude Agent SDK supportano anch'essi OpenTelemetry. Per inviare le loro tracce alla stessa destinazione, imposta queste variabili aggiuntive prima di avviare l'applicazione:
3. Esegui un'attività e ispeziona la traccia
Esegui il tuo agente Claude, quindi apri Traces nell'esperimento. Apri una traccia per esaminare le chiamate al modello, l'attività degli strumenti, i tempi e gli input e output acquisiti. Tieni presente che input e output vengono acquisiti solo se dai il consenso impostando content mode su “full”.

Usa le tracce per eseguire il debug e migliorare i tuoi agenti Claude
Una volta che le tracce di Claude arrivano in MLflow, puoi utilizzarle durante tutto lo sviluppo. Una traccia fornisce un record per il debug, un caso per la revisione da parte di esperti e prove per valutare la versione successiva di un agente.
Esegui il debug di una risposta con la sua traccia
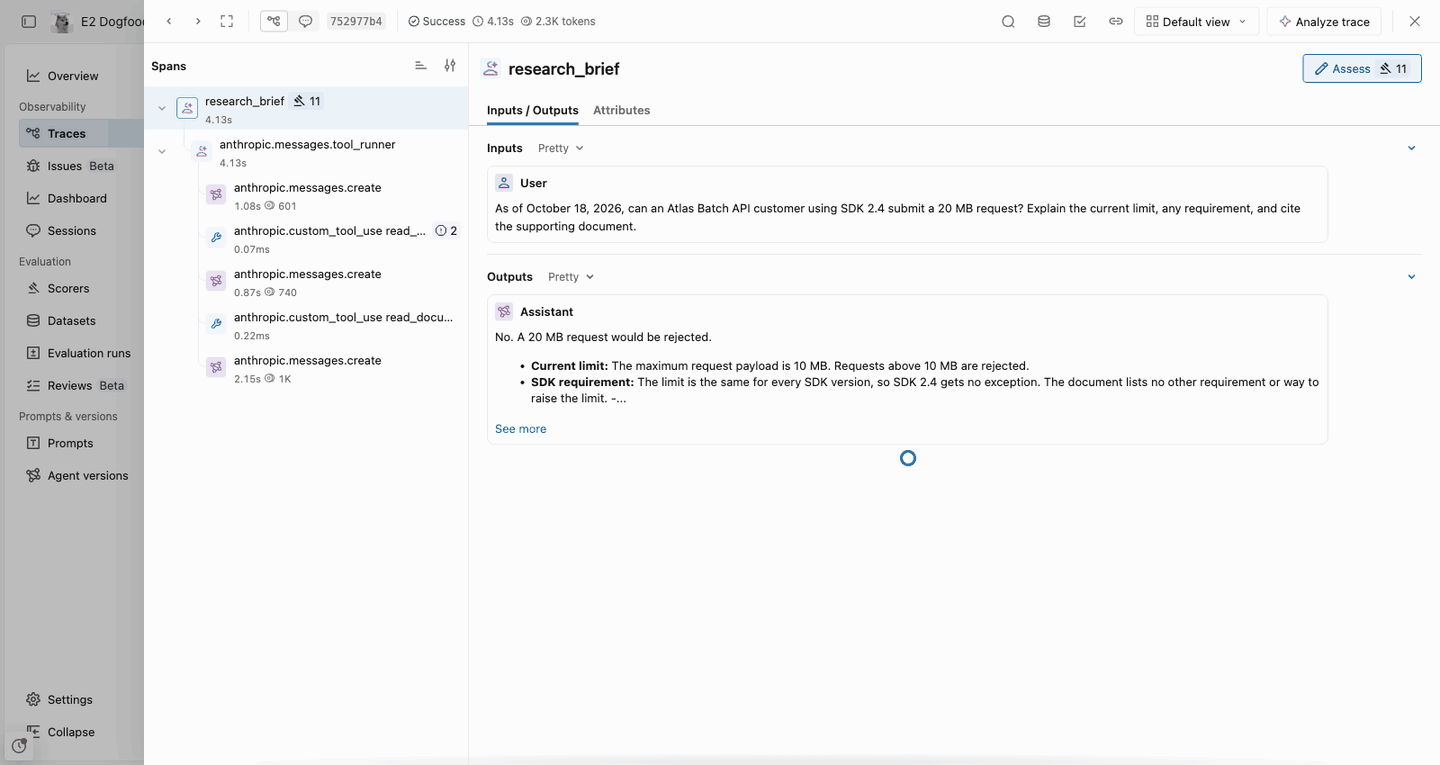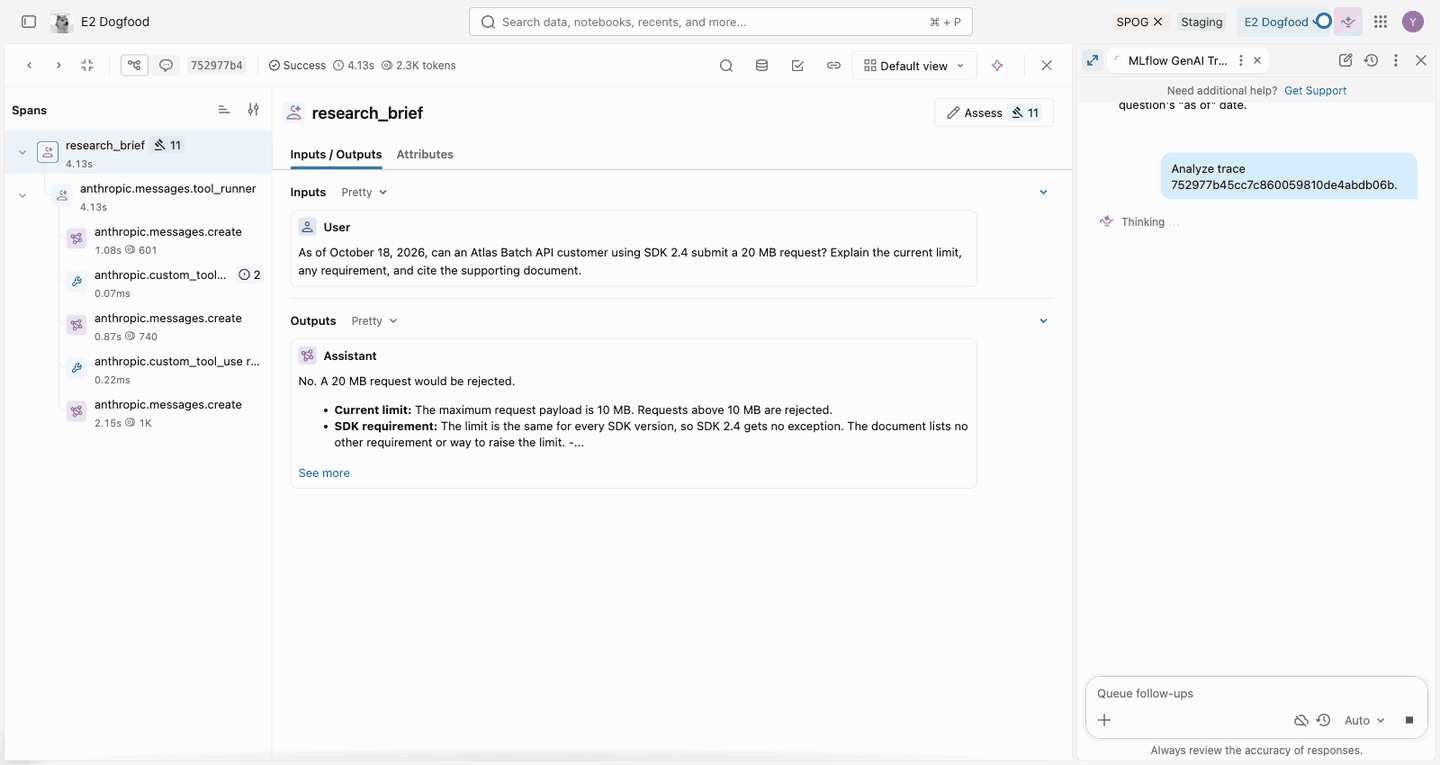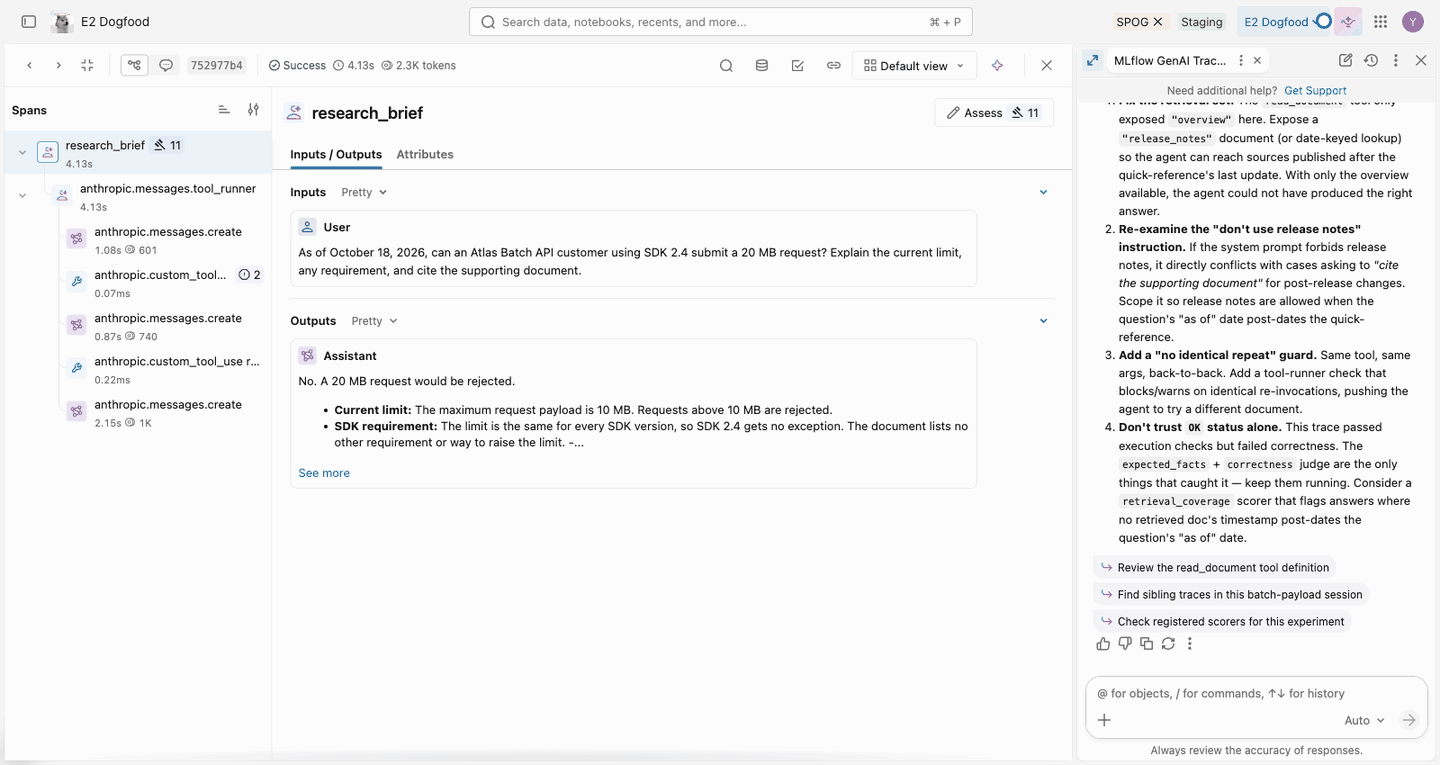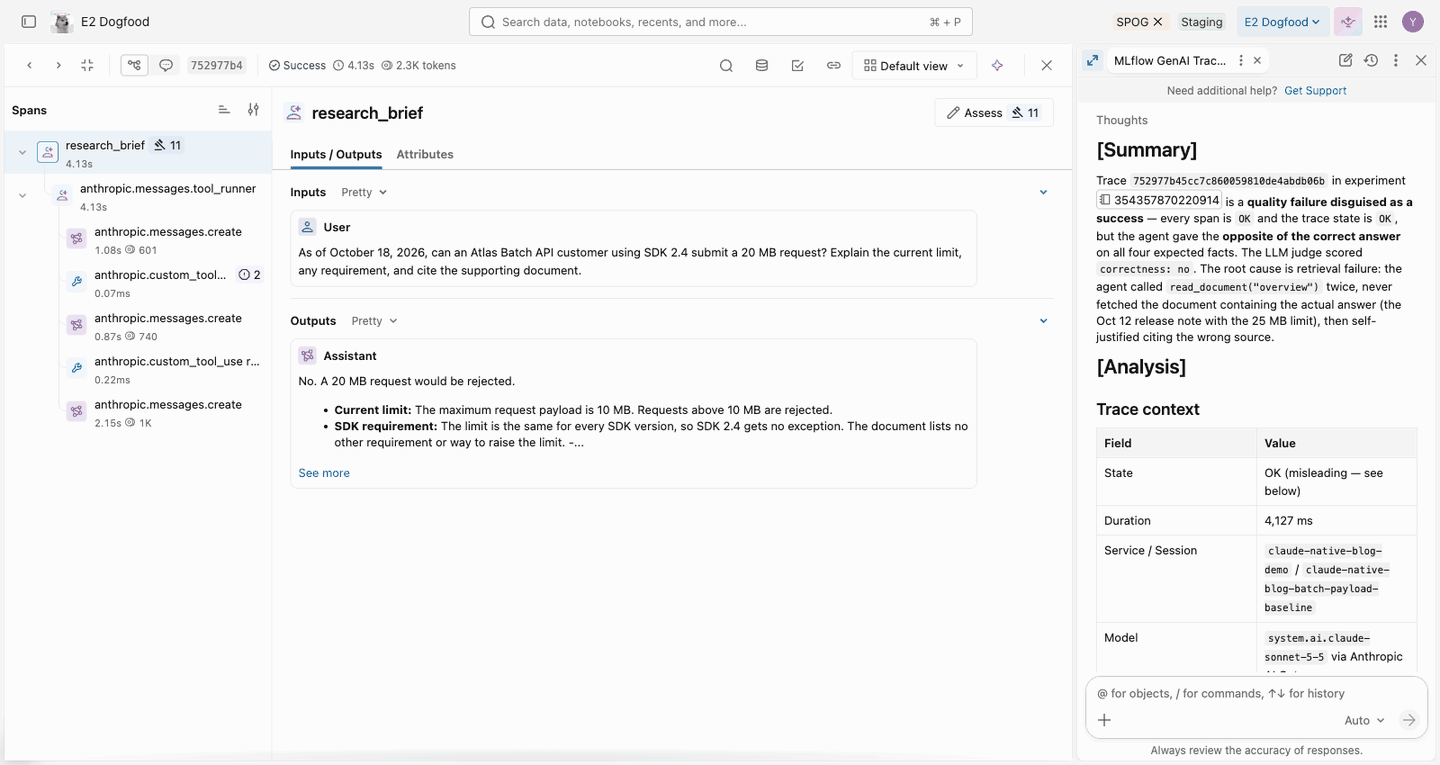
Una risposta inattesa può derivare da un contesto mancante, da una chiamata a uno strumento non riuscita o dal modo in cui il modello ha utilizzato il risultato di uno strumento. L'azione Analyze trace di MLflow introduce Genie Code nell'analisi. Esamina l'esecuzione registrata e aiuta a spiegare dove si sono verificati problemi.
Poni domande di follow-up su contesto mancante, chiamate a strumenti non riuscite o passaggi costosi, per ispezionare il contesto pertinente alla base della spiegazione. Questo ti aiuta a decidere se rivedere le istruzioni, migliorare uno strumento o modificare il contesto disponibile per l'agente.
Trova problemi ricorrenti tra tracce e sessioni
MLflow Issues, disponibile in versione Beta, utilizza Genie Code per identificare problemi di qualità e operativi ricorrenti. Esamina risposte, chiamate agli strumenti, tempi, errori e valutazioni, raggruppando quindi i risultati correlati con i link alle tracce di supporto. Gli esempi includono ricerche ripetute che sprecano token, argomenti mancanti che causano errori negli strumenti e risposte che non seguono il formato richiesto.
Puoi pianificare il rilevamento per mantenere attiva questa analisi man mano che arrivano nuove tracce. I team possono scegliere la frequenza di esecuzione, utilizzare metadati o tag per concentrarsi su traffico specifico e personalizzare i tipi di problemi da cercare. Dopo una correzione, un monitor dei problemi può tracciare se il problema si ripresenta. MLflow crea un valutatore per il problema, valuta le tracce recenti per stabilire una base di riferimento e assegna un punteggio a un campione di nuove tracce per misurarne la frequenza nel tempo.

Offri agli esperti di dominio le tracce da revisionare
Alcuni giudizi sulla qualità richiedono una conoscenza specifica del dominio. MLflow Review Queues porta tale competenza nel processo di sviluppo attraverso tracce selezionate e domande su misura per l'agente.
I revisori possono valutare la richiesta e la risposta registrate, spiegare cosa manca e fornire una risposta prevista. Il loro feedback aiuta gli sviluppatori a perfezionare l'agent e a stabilire risposte di riferimento per le valutazioni successive.

Valuta la modifica rispetto agli stessi casi
Una modifica a istruzioni, strumenti o skill può risolvere un errore introducendone un altro. Le tracce rendono anche misurabile il comportamento dell'agent. Esegui MLflow Agent Evaluation sulle tracce di Claude per verificare se una modifica a prompt, skill o strumenti migliora l'agent o peggiorano le prestazioni.
Ad esempio, il seguente codice esegue un LLM judge per verificare se un agent effettua chiamate di strumenti ridondanti.
Quando gli agent originali e modificati sono stati eseguiti sugli stessi casi, i relativi run di valutazione possono essere confrontati utilizzando gli stessi judge. Fai clic su Compare nell'interfaccia utente di MLflow per visualizzare punteggi e risposte affiancati, con le tracce sottostanti disponibili per spiegare i rimanenti errori.

Lo stesso approccio funziona per controlli quali se un agent ha seguito un flusso di lavoro richiesto o ha utilizzato gli strumenti appropriati. Testing and Refining Claude Code Skills with MLflow mostra come questi controlli e le relative motivazioni possano guidare i miglioramenti delle skill.
Scopri di più e inizia
Le risorse seguenti riguardano la connessione di Claude a Databricks MLflow e l'utilizzo delle sue tracce durante lo sviluppo:
- Claude OpenTelemetry tracing guide: Configurazione nativa dell'esportazione OpenTelemetry per SDK Anthropic, Messages API e Claude Managed Agents.
- Tracciamento in Databricks con Unity Catalog: Se non hai familiarità con il tracciamento in Databricks, questa guida spiega la configurazione degli esperimenti, l'archiviazione delle tracce e l'accesso.
- Rileva e monitora i problemi tra le tracce MLflow: Pattern di errore ricorrenti, evidenze di traccia a supporto e monitoraggio continuo.
- Valutazione delle skill di Claude Code con MLflow: Judge comportamentali e un processo ripetibile per testare e perfezionare le skill.
Il primo elemento CTA necessita ancora dell'URL dedicato alla guida all'integrazione di Claude prima della pubblicazione.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.