Presentazione della memoria degli agenti su Databricks
di Sirui Sun e Nihit Desai
Oggi presentiamo la memoria per gli agenti su Agent Bricks, la piattaforma di sviluppo per agenti di Databricks. La memoria per gli agenti migliora la qualità degli agenti riducendo al contempo costi e latenza, memorizzando fatti critici, preferenze e workflow che un agente dovrebbe ricordare. È disponibile in Beta da oggi, viene eseguita su Lakebase per garantire un'elevata affidabilità e una bassa latenza, ed è basata sulla più recente ricerca sulla memoria di Databricks.
Senza memoria, gli agenti rischiano di dover riscoprire fatti chiave, dimenticare le preferenze dell'utente e ripetere errori che erano già stati corretti. Di conseguenza, molti sviluppatori stanno creando soluzioni di memoria personalizzate, incontrando però diversi interrogativi di progettazione: ad esempio, dove dovrebbero essere conservati i ricordi? Come dovrebbero essere sintetizzati? E una volta generati, come dovrebbero essere recuperati?
Per risolvere questo problema, Databricks Agent Memory si basa sull'architettura MemCurrent, sviluppata da Databricks Research. MemCurrent combina tre pattern di accesso: plugin per registrare e caricare automaticamente il contesto, strumenti che l'agente richiama su richiesta e una pipeline di dreaming offline che consolida la memoria in background. Tutto questo viene erogato con una latenza estremamente bassa grazie a Lakebase. Nei nostri benchmark interni, l'implementazione di questa architettura di memoria ha triplicato il tasso di successo degli agenti su attività aziendali reali, utilizzando al contempo il 31% in meno di token.
Agent Memory si unisce al resto di Agent Bricks, inclusi l'hosting degli agenti, Databricks Sandbox, Unity Gateway, server MCP predefiniti e le funzionalità di tracciamento e valutazione, offrendo agli sviluppatori tutte le capacità infrastrutturali necessarie per creare agenti pronti per la produzione.
Il problema: gli agenti stateless pagano due volte per lo stesso contesto
Non appena un agente passa dalla fase di demo all'uso quotidiano, emergono due problemi.
- I costi aumentano a ogni riscoperta. Un agente stateless deve dedurre nuovamente ciò che aveva già scoperto il giorno prima: quale tabella contiene i dati di utilizzo, cosa significa un acronimo interno, quale join funziona davvero. In una sessione reale della nostra ricerca, un agente ha impiegato 11 chiamate a strumenti, 8 subagenti e quasi sei minuti per rispondere a una domanda sui principali clienti di un prodotto. Il giorno dopo, avrebbe dovuto rifare tutto da capo.
- Gli agenti non imparano mai a personalizzare l'esperienza. Un utente indica una preferenza, corregge un errore o spiega come il proprio team definisce una metrica, e l'agente dimentica tutto al termine della sessione. Così l'utente deve ripetersi, oppure l'agente ripete l'errore.
Gli sviluppatori di agenti e i team di piattaforma che li gestiscono utilizzano solitamente due soluzioni temporanee, ciascuna delle quali sostituisce un problema con un altro:
- Reinserire l'intera cronologia nel contesto funziona finché la cronologia non diventa troppo lunga. Nei benchmark di memoria open source, l'uso dell'intero contesto ha impiegato circa 12 volte più token di input per domanda rispetto a una memoria ben progettata a parità di accuratezza; nelle cronologie più lunghe ha persino ottenuto risultati worse, perché i passaggi irrilevanti hanno confuso l'agente.
- Creare la memoria in autonomia su un object storage o un database vettoriale significa doversi occupare di estrazione, deduplicazione, recupero e controllo degli accessi. Le informazioni diventano obsolete, i fatti contraddittori si accumulano e nessuno riesce a capire quale ricordo abbia causato una risposta errata.
Ciò di cui i team hanno bisogno è una memoria che renda gli agenti al contempo più economici e più personalizzati, senza dover configurare un ulteriore sistema.
Come funziona Agent Memory su Databricks
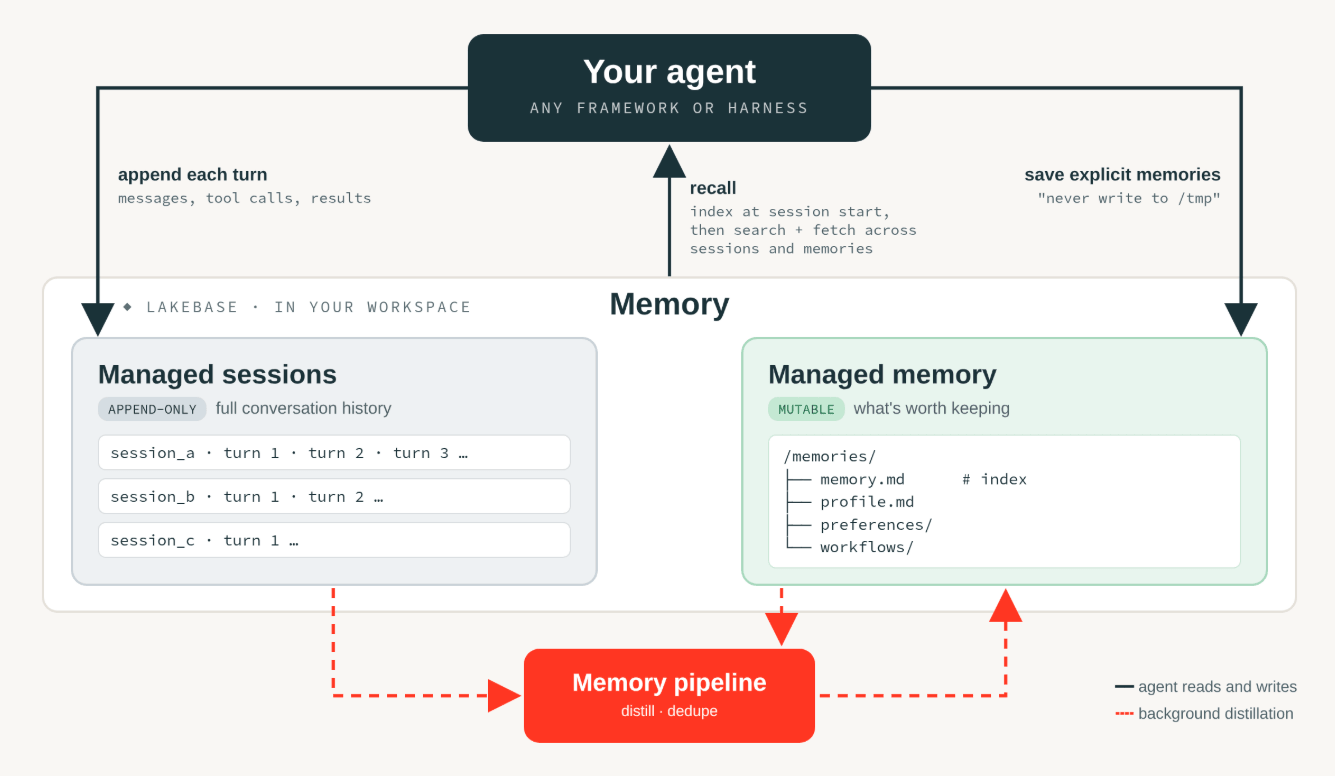
Figura 1. Agent Memory su Agent Bricks. L'agente aggiunge ogni passaggio alle sessioni gestite, richiama e salva direttamente le informazioni nella memoria, mentre una pipeline della memoria sintetizza le sessioni nella memoria a lungo termine in background.
Agent Memory si compone di tre parti:
- Sessioni gestite registrano ogni conversazione come una cronologia ordinata di messaggi, chiamate a strumenti e risultati, nel formato nativo del framework in uso.
- Memoria gestita conserva ciò che vale la pena ricordare: profilo, preferenze, conoscenze del dominio e workflow. All'inizio di una sessione, l'agente carica un indice delle informazioni presenti in memoria. Durante la sessione, trova i dettagli mediante ricerca semantica e per parole chiave ibrida.
- Pipeline della memoria sintetizzano le sessioni nella memoria su richiesta o su base regolare in background. Estraggono fatti duraturi e preferenze, rimuovono i duplicati e sostituiscono i fatti che vengono contraddetti dalle conversazioni più recenti.
Tutto viene eseguito su Lakebase, il Postgres serverless di Databricks, fornito nel tuo workspace e gestito da Databricks. Questo garantisce che il salvataggio e il recupero dei ricordi siano velocissimi e che i tuoi store possano scalare insieme al traffico dei tuoi agenti.
Basato sulla nostra ricerca sulla memoria
Agent Memory è un'implementazione di produzione di MemCurrent, il sistema di memoria descritto in MemCurrent: Designing Memory for Enterprise Agents. La conclusione principale dei nostri ricercatori è che la memoria funziona al meglio su due livelli: una registrazione grezza di ciò che è accaduto e una registrazione sintetizzata di ciò che vale la pena ricordare, mantenuta aggiornata da un processo in background anziché scritta ad hoc dall'agente durante l'esecuzione di un'attività.
Strutturata in questo modo, la memoria ha migliorato contemporaneamente qualità ed efficienza. Gli agenti hanno completato con successo circa il triplo delle attività rispetto agli agenti privi di memoria, terminando più velocemente e utilizzando meno token. La stessa infrastruttura alimenta già la memoria in Genie, l'esperienza in linguaggio naturale di Databricks per gli utenti aziendali.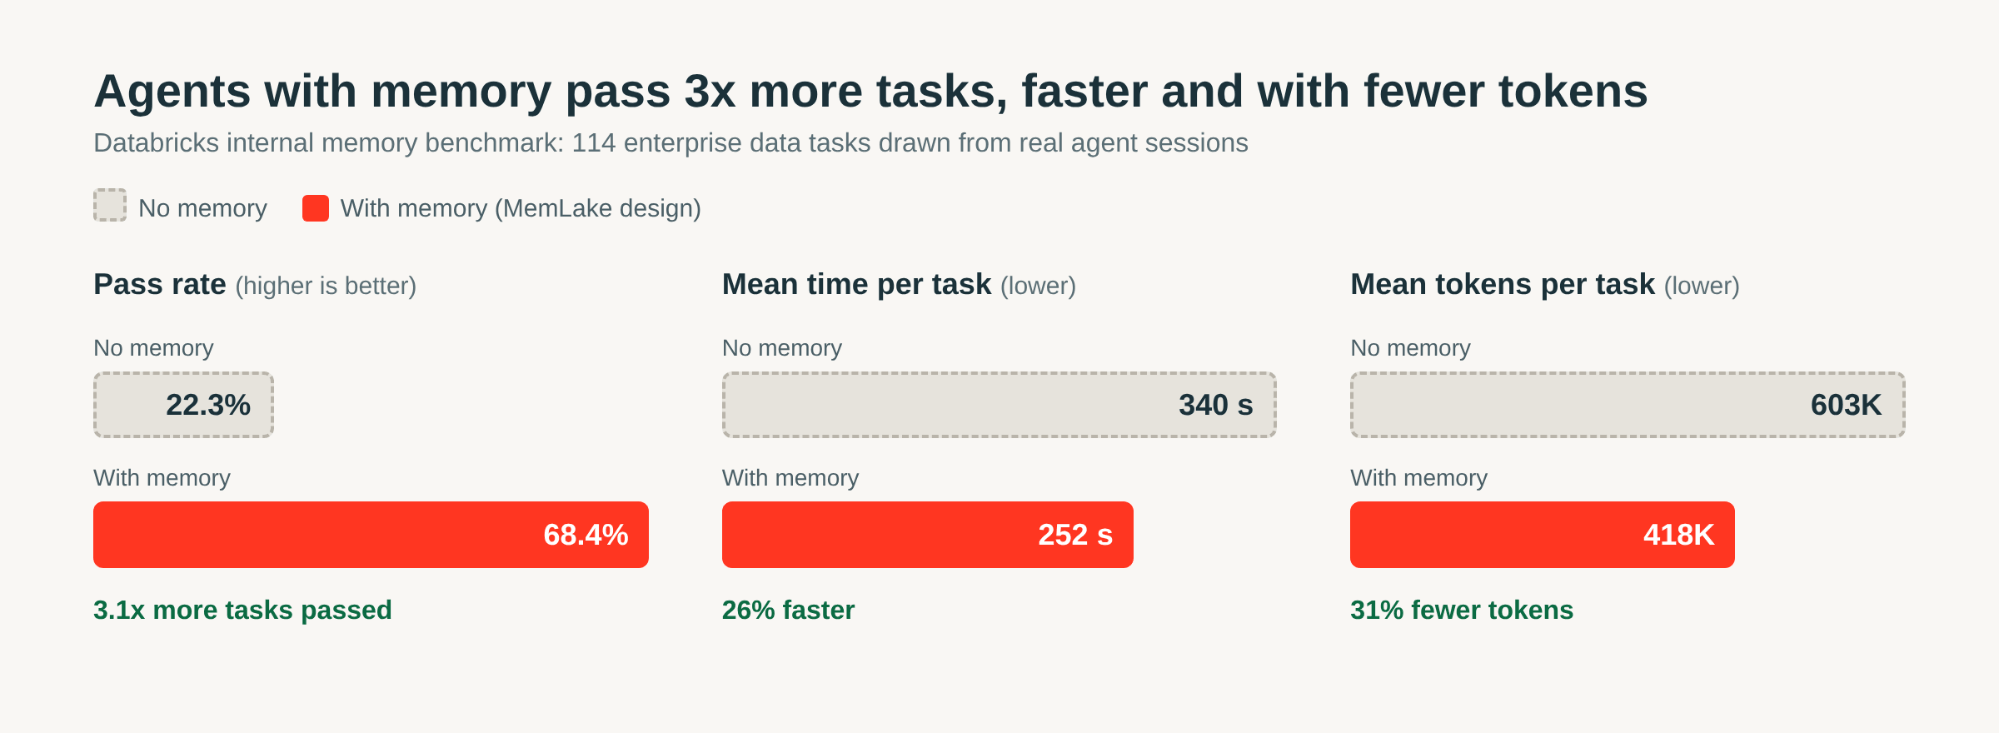
Figura 2. Agenti con e senza memoria nel benchmark di memoria interno di Databricks sulle attività di dati aziendali. Fonte: ricerca MemCurrent.
Cosa cambia per i tuoi agenti
- Costo inferiore per attività. Gli agenti evitano di ripetere il lavoro già svolto. Nell'esempio sopra, una volta salvato il workflow in memoria, l'agente ha risposto a una domanda di approfondimento correlata in 2 chiamate a strumenti e 41 secondi, rispetto alle 11 chiamate a strumenti e quasi sei minuti iniziali.
- Personalizzazione persistente. Preferenze, correzioni e definizioni specifiche per il team vengono mantenute tra le sessioni, collegate a ciascun utente, evitando così che le persone debbano ripetersi.
- Errori che non si ripetono. Gli agenti ricordano i propri errori e possono evitare di commettere lo stesso errore due volte, risparmiando tempo e token preziosi.
- Memoria di tua proprietà e sotto il tuo controllo. Le sessioni e i ricordi risiedono nel tuo progetto Lakebase, indipendentemente da qualsiasi singolo framework di agenti. Gli sviluppatori possono leggere, esportare ed eliminare le voci conservate da un agente su ciascun utente e fornire istruzioni alla pipeline della memoria per indicare cosa conservare, come ad esempio "mantieni le preferenze durature dei clienti; ignora le note di debugging occasionali".
- Un'unica piattaforma per l'intero ciclo. Lo stesso agente utilizza i modelli tramite Unity Gateway, viene distribuito con la CLI di Agent Bricks ed è tracciato e valutato con il tracciamento di Agent Bricks, memoria inclusa.
Per iniziare
Niente di tutto questo richiede nuova infrastruttura da parte tua. La CLI di Agent Bricks può aiutarti a distribuire un agente con memoria e sessioni in pochi minuti.
Da quel momento in poi, la conversazione successiva del tuo agente con ciascun utente inizierà con ciò che ha appreso da quelle precedenti. Per maggiori informazioni, consulta la guida rapida per creare un nuovo agente con memoria, oppure il nostro tutorial per aggiungere la memoria a un agente esistente.
Agent Memory è un componente di Agent Bricks, la piattaforma di sviluppo di agenti di Databricks per creare, eseguire e migliorare agenti personalizzati su scala, con qualsiasi modello, framework o harness. Esplora Agent Bricks per scoprire il resto della piattaforma.
Altre risorse
- Crea un agente stateful in meno di 10 minuti con la documentazione della CLI di Agent Bricks.
- Aggiungi memoria e sessioni a un agente esistente con la documentazione su memoria e sessioni dell'agente.
- Leggi la ricerca alla base in MemCurrent: Designing Memory for Enterprise Agents.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.