Ripristini basati su branch di Lakebase Postgres per un recupero rapido su scala
Come Lakebase Postgres sostituisce i lenti ripristini dei database con ripristini basati su branch quasi istantanei per recuperare 100 TB in pochi secondi.
- Il ripristino tradizionale dei database è incredibilmente lento e non si adatta bene alle dimensioni, causando spesso ore di inattività durante il provisioning di nuove risorse di calcolo, il download di snapshot di grandi dimensioni e la riproduzione dei file di log.
- Lakebase Postgres introduce i ripristini basati su branch, un'operazione sui metadati che ripristina istantaneamente un database puntando alla cronologia immutabile in uno storage disaccoppiato anziché copiare i dati.
- Il ripristino di un database da 100 TB richiede pochi secondi, rendendo il recupero praticamente istantaneo e consentendo agli agenti AI di gestire in modo fluido i flussi di lavoro di branching e annullamento.
Nell'OLTP gestito, i ripristini sono sempre stati dolorosamente lenti e rallentano ulteriormente su larga scala. Ciò significa spesso che i database di produzione di grandi dimensioni, dove i tempi di inattività costano di più, sono quelli che attendono più a lungo per essere ripristinati.
Le solite soluzioni alternative sono difficili, costose e rischiose. Comportano repliche aggiuntive, ambienti extra e persino la presenza di un DBA durante il ripristino, il che non garantisce del tutto la protezione. Il failover su una replica integra aiuta quando una macchina si guasta, ma non serve quando la scrittura errata è già presente sul sistema di standby. Ciò comporta comunque un ripristino, e un ripristino può significare ore di inattività.
Questa difficoltà è causata dall'architettura dei sistemi OLTP gestiti tradizionali. Compute e storage vengono forniti come un'unica macchina, un ripristino inizia con il provisioning di una nuova istanza (e l'attesa è già iniziata); gli snapshot risiedono nell'object storage mentre Postgres viene eseguito su quel volume, quindi lo snapshot deve comunque essere trasferito su disco (altra attesa); il replay del WAL deve poi colmare il divario tra il momento dello snapshot e l'esatto timestamp di ripristino (ulteriore attesa). Man mano che il database cresce, questo processo diventa più lento e costoso.
L'architettura di Lakebase Postgres rompe il monolite e cambia i meccanismi di ripristino. In Lakebase, compute e storage sono disaccoppiati e la cronologia del database è già conservata nell'object storage in modo da essere immediatamente consultabile. In questa architettura, un ripristino non copia i dati su un nuovo disco. Al contrario, crea semplicemente un branch a un determinato timestamp, il che rappresenta una semplice operazione sui metadati, non un lavoro di copia e replay di diverse ore.
In termini pratici, il tempo di ripristino scende a pochi secondi, anche se il database è di 100 TB. Ed è così semplice che può farlo un agent.
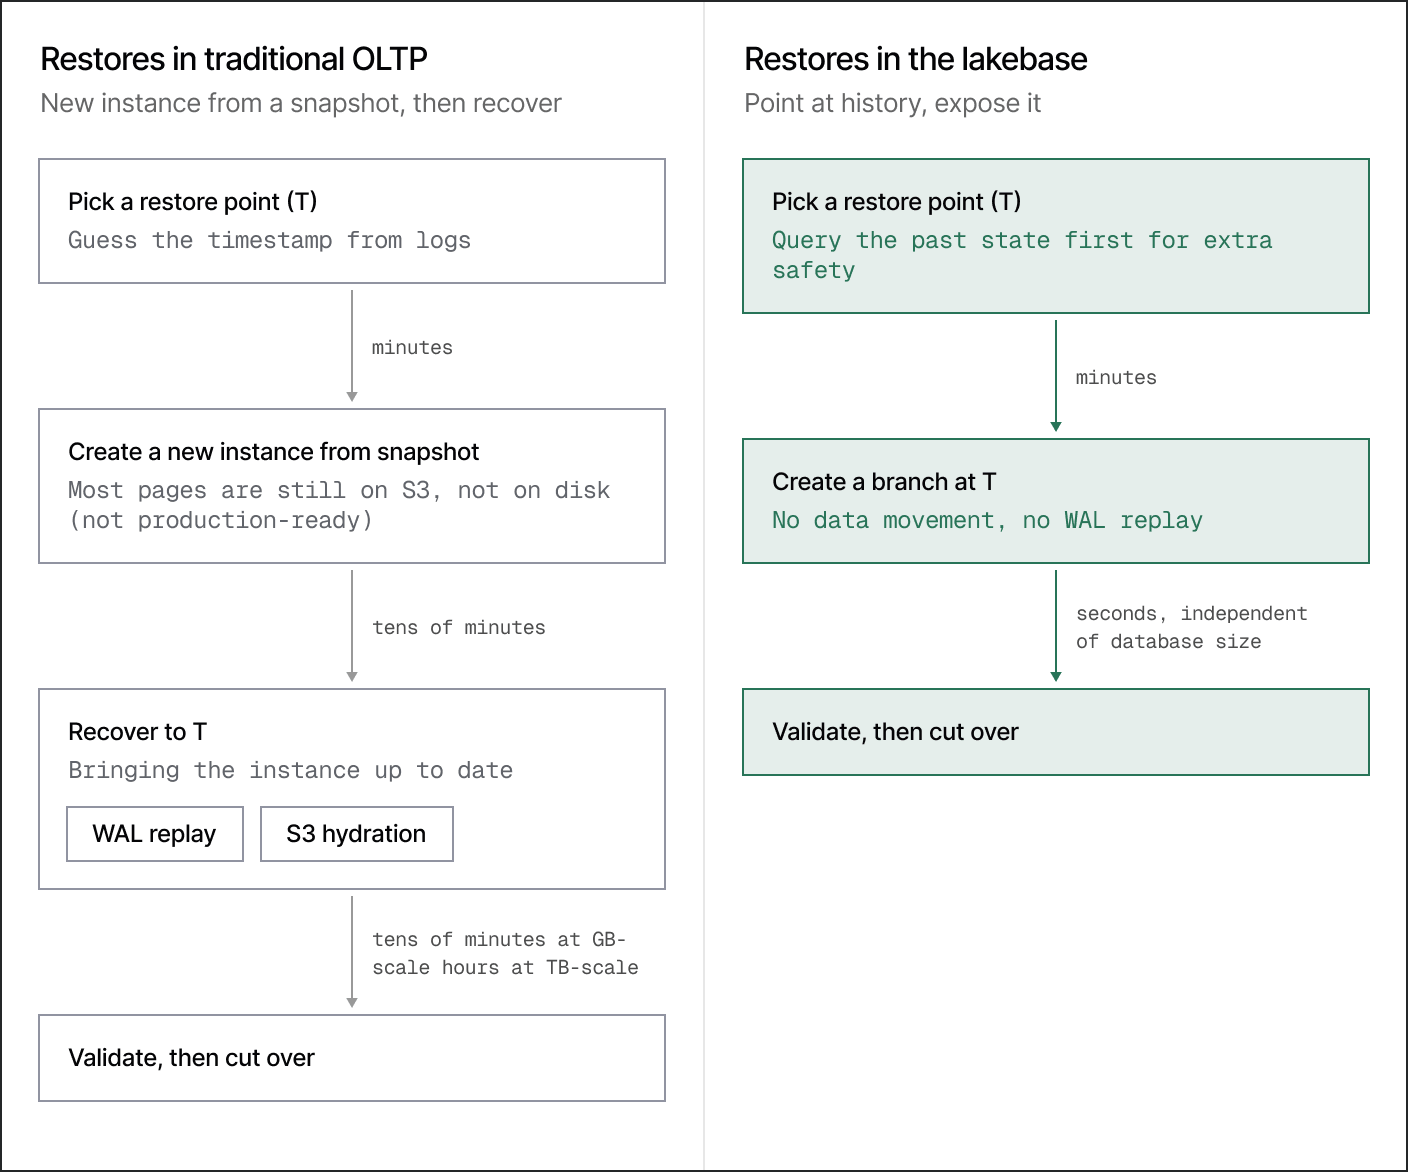
Il percorso di ripristino OLTP tradizionale (e dove si interrompe)
Il point-in-time recovery (PITR) tradizionale di Postgres si basa su due elementi: un backup di base dei file e il WAL archiviato per tutto ciò che segue quel backup. In un ambiente Postgres gestito, come Amazon RDS, tale backup è solitamente uno snapshot memorizzato nell'object storage.
Il "ripristino da backup" a un particolare momento nel tempo T è in realtà un processo che prevede tre fasi:
- Distribuire una nuova istanza
- Ripristinare l'ultimo snapshot utilizzabile prima di T
- Eseguire il replay del WAL da quello snapshot fino a T
1. Distribuire una nuova istanza
Ciò comporta la fornitura di volumi di compute e storage (accoppiati) di dimensioni almeno pari a quelli del database primario. Un'istanza di piccole dimensioni può essere avviata in pochi minuti, ma un'istanza di grandi dimensioni con volumi EBS capienti richiede solitamente più tempo, costringendoti ad attendere prima ancora di avviare il processo di ripristino.
2. Ripristinare dallo snapshot
Gli snapshot RDS risiedono in S3, quindi "ripristinare" significa estrarre lo snapshot dall'object storage e trasferirlo sul disco di Postgres.
Questo processo è lento per dimensioni elevate, quindi RDS non attende il suo completamento prima di rendere disponibile l'istanza ripristinata available. Per i volumi di grandi dimensioni, ciò avviene mentre la maggior parte delle pagine di tabelle e indici si trova ancora in S3. Ma "disponibile" non significa che il working set sia sul volume di Postgres. Se una query interessa un blocco non ancora locale, il volume lo recupera da S3 all'istante, mentre il resto continua a caricarsi in background.
Questo tipo di query comporta una latenza accettabile per un controllo interno, ma non per la produzione. Il ripristino è completato solo quando i dati effettivamente necessari risiedono sul volume, e questo non è un processo rapido per un database di grandi dimensioni. Più grande è il database, maggiore sarà il tempo (in ore) richiesto.
3. Eseguire il replay del WAL fino a T
Lo snapshot è coerente solo con riferimento al momento in cui è stato creato. Per raggiungere T, Postgres deve comunque eseguire il replay dei log delle transazioni archiviati dopo lo snapshot. Il tempo richiesto per il replay dipende da quante operazioni sono state eseguite tra lo snapshot e T. Uno snapshot di un'ora prima sarà molto più veloce di uno snapshot della sera precedente. Inoltre, se si è trattato di una giornata con un carico di scrittura elevato, ci saranno molti WAL di cui eseguire il replay. Ancora una volta, ciò comporta una lunga attesa (oltre al fatto che l'istanza si sta ancora caricando da S3).
Finestre di inattività significative
A meno che il database non sia di piccole dimensioni, il PITR è quasi sempre un'operazione che richiede diverse ore. È necessario eseguire il provisioning del monolite, estrarre uno snapshot da S3, eseguire il replay del WAL e attendere che una parte sufficiente del volume sia locale per poter gestire il traffico.
Per l'intera durata di questa finestra, potresti subire tempi di inattività. Una replica integra ad alta disponibilità (HA) può salvarti se il database primario si guasta e la replica contiene ancora dati corretti. Tuttavia, potrebbe non salvarti dal PITR, quindi le tabelle eliminate e le scritture errate potrebbero essere già presenti sul sistema di standby.
I ripristini lenti dei database sono un problema serio
In un sondaggio, a 50 sviluppatori che gestiscono database Postgres di produzione da oltre 1 TB è stata chiesta la loro esperienza con i ripristini:
- Il 59% ha riscontrato un guasto critico in produzione negli ultimi 12 mesi
- Il 30% ha subito tempi di inattività superiori a 3 ore, in alcuni casi oltre mezza giornata
- Solo il 21% ha completato il ripristino in meno di 60 minuti
Ciò ha generato un potenziale impatto negativo sul business:
- Il 40% ha segnalato una significativa interruzione dell'attività
- Il 52% ha ricevuto feedback negativi dai clienti a causa dell'incidente
- Il 72% si sentiva solo "abbastanza sicuro" di poter effettuare un ripristino rapido in caso di un nuovo guasto
I ripristini basati su branch introducono un nuovo percorso
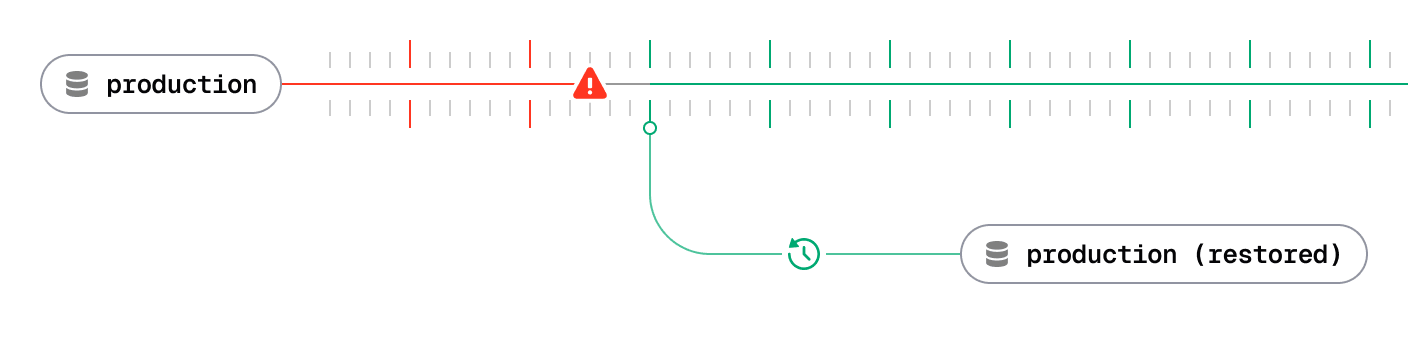
In Lakebase Postgres, un'architettura moderna consente un percorso diverso per i ripristini.
Compute e storage sono separati
Compute e lo storage persistente sono separati e collegati dal WAL. Compute esegue Postgres, il che significa che esegue SQL, pianifica le query, applica l'MVCC, gestisce i blocchi e genera il WAL (tutte le normali attività di Postgres). Ciò che non fa è possedere la copia persistente dei tuoi dati.
Lo storage è ciò che garantisce la persistenza e la cronologia, e questo compito è suddiviso in tre parti eseguite da tre componenti distinti:
- I safekeeper ricevono il WAL da compute. Una transazione è persistente una volta che un quorum di safekeeper ha confermato il relativo record WAL
- Il pageserver trasforma il WAL nelle pagine lette da Postgres. Può ricostruire qualsiasi pagina per una determinata chiave a un determinato LSN.
- L'object storage conserva la cronologia immutabile a lungo termine. Compute non lo legge mai direttamente; il pageserver si trova nel mezzo.
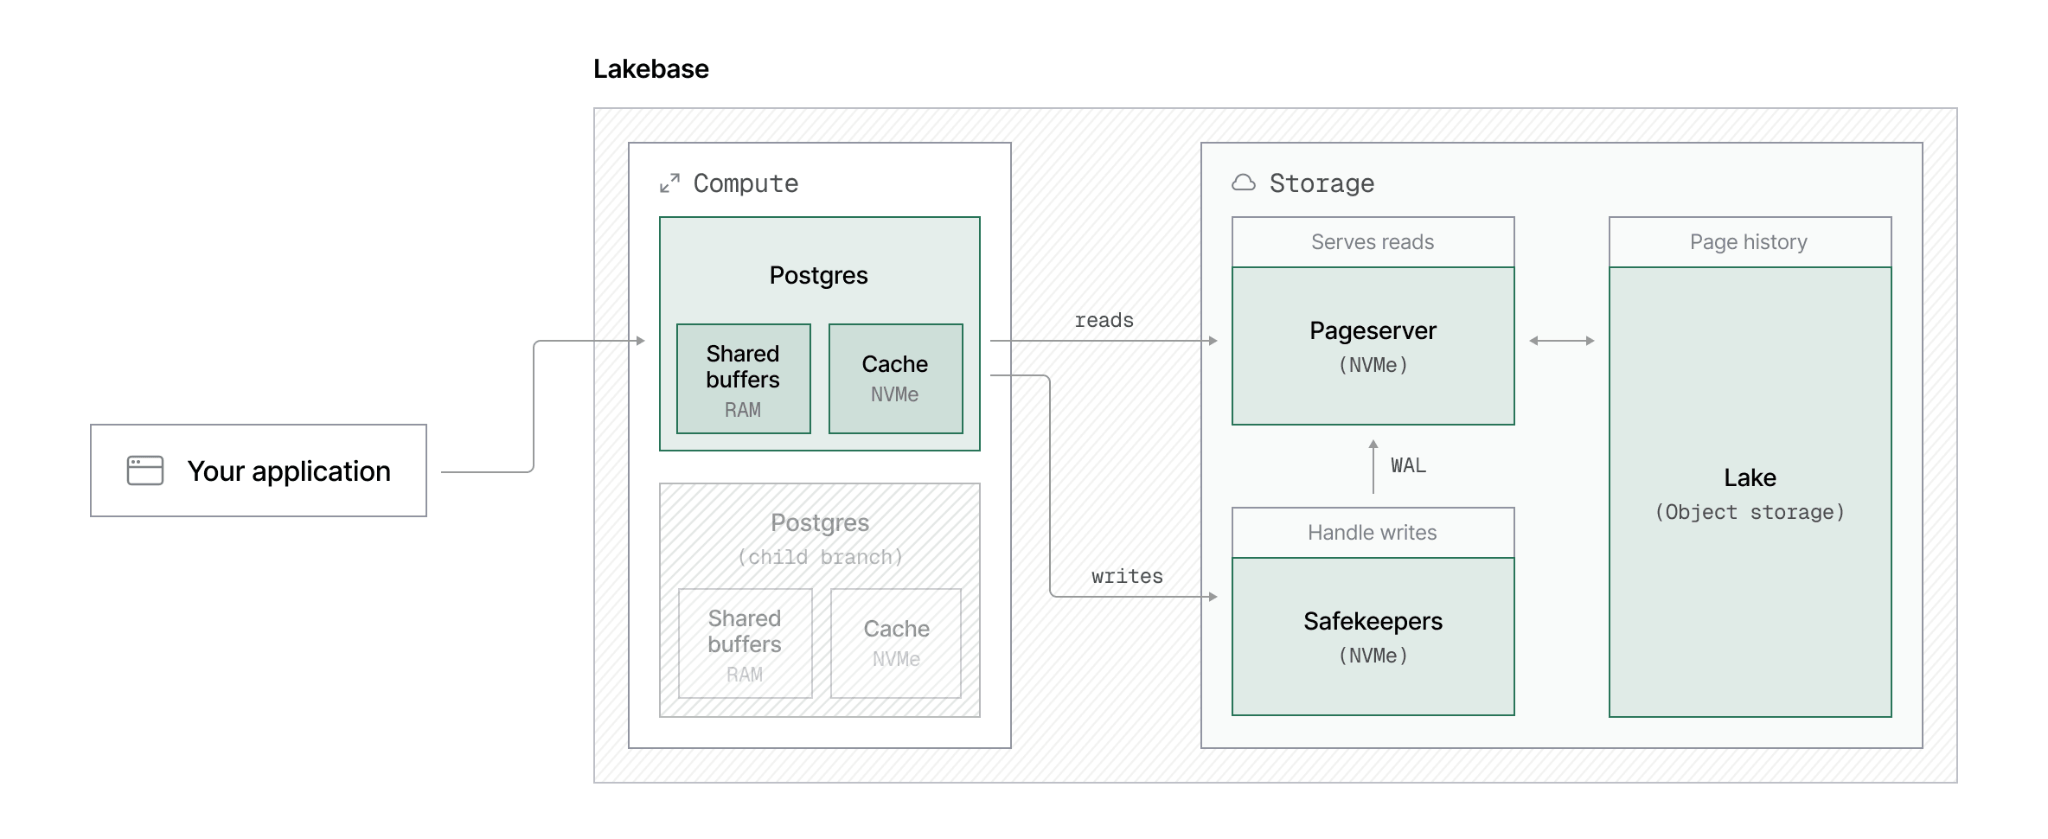
Quando arriva una scrittura:
- Postgres modifica le righe in memoria e genera il WAL
- Compute trasmette il WAL in streaming ai safekeeper
- Un quorum lo conferma e la transazione è ora persistente
- Il pageserver trasforma successivamente il WAL in versioni di pagina
- Tali versioni vengono salvate nell'object storage come cronologia immutabile
La cronologia viene memorizzata come una timeline indirizzabile
In questo design, il percorso di scrittura assume una forma interessante. L'architettura sopra descritta separa il commit di una transazione dalla materializzazione delle pagine, il che in parole povere significa: le vecchie versioni delle pagine non vengono mai sovrascritte. La cronologia del database si accumula come una timeline a cui fare riferimento, non come un'unica copia che viene modificata.
Un ripristino in Lakebase è un branch a un determinato momento nel tempo
Nel percorso tradizionale, un ripristino significa principalmente ricostruire lo stato passato in un'istanza separata. Ma con Lakebase, è presente una cronologia di storage immutabile a cui fare riferimento, quindi questo passaggio non è necessario ed è sostituito da una primitiva diversa: un branch.
Mentre i ripristini tradizionali eseguono il provisioning di una nuova istanza e vi copiano i dati, un ripristino in Lakebase è un branch a un determinato punto della cronologia. Questo nuovo branch ha il proprio compute indipendente, la propria stringa di connessione e può essere interrogato in modo completamente indipendente dalla produzione. Non è una replica dell'istanza originale, ma si comporta esattamente come tale.
Ecco come utilizzare questa primitiva per un ripristino:
- Quando qualcosa non funziona nel branch principale, si sceglie un timestamp nel passato (è possibile esaminare tale timestamp prima di procedere al ripristino, ad esempio eseguendo query)
- Una volta convalidato, il control plane mappa quel timestamp sul punto esatto della cronologia dello storage (l'LSN corretto), crea quel branch e vi associa il compute
- Il "database ripristinato" è quel nuovo branch, disponibile praticamente non appena si preme "deploy", indipendentemente dalla quantità di dati memorizzati nel database sottostante
Dato che questo è il concetto fondamentale, ribadiamolo:
Il branch non copia il database
Questo metodo di ripristino elimina completamente le copie dei dati. Il branch ripristinato non ha bisogno di copiare i dati; punta semplicemente ai layer di immagine e delta già esistenti fino a quel momento.
- In un sistema copy-and-replay, un ripristino è un'operazione di spostamento dati. Il database non è "lì" finché la copia e il replay del WAL non sono completati
- In Lakebase, il "database" è già lì. Un ripristino è costituito da metadati: un puntatore a un momento storico. Non resta che esporre quel punto come branch, con il proprio compute
Il risultato: ripristinare 100 TB è veloce quanto ripristinare 10 GB
Il vantaggio è che la scalabilità non fa più paura dal punto di vista operativo. Se un ripristino è un'operazione sui metadati, il tempo necessario non cresce con le dimensioni dei dati e il meccanismo rimane lo stesso.
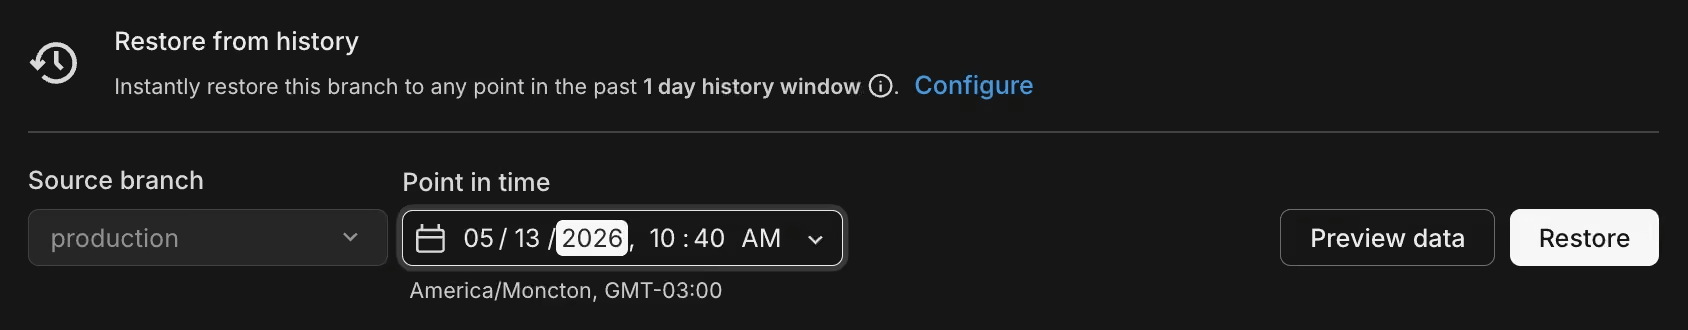
Indipendentemente dalle dimensioni del database:
- Raggiungere uno stato passato indirizzabile è quasi istantaneo
- La convalida di tale stato richiede solo il tempo necessario per i controlli e per i dati che si sceglie di leggere
Un operatore umano o un agente può sempre raggiungere immediatamente uno stato passato interrogabile dopo un incidente, anche su un enorme database Postgres.
Gli agenti possono basarsi sui ripristini
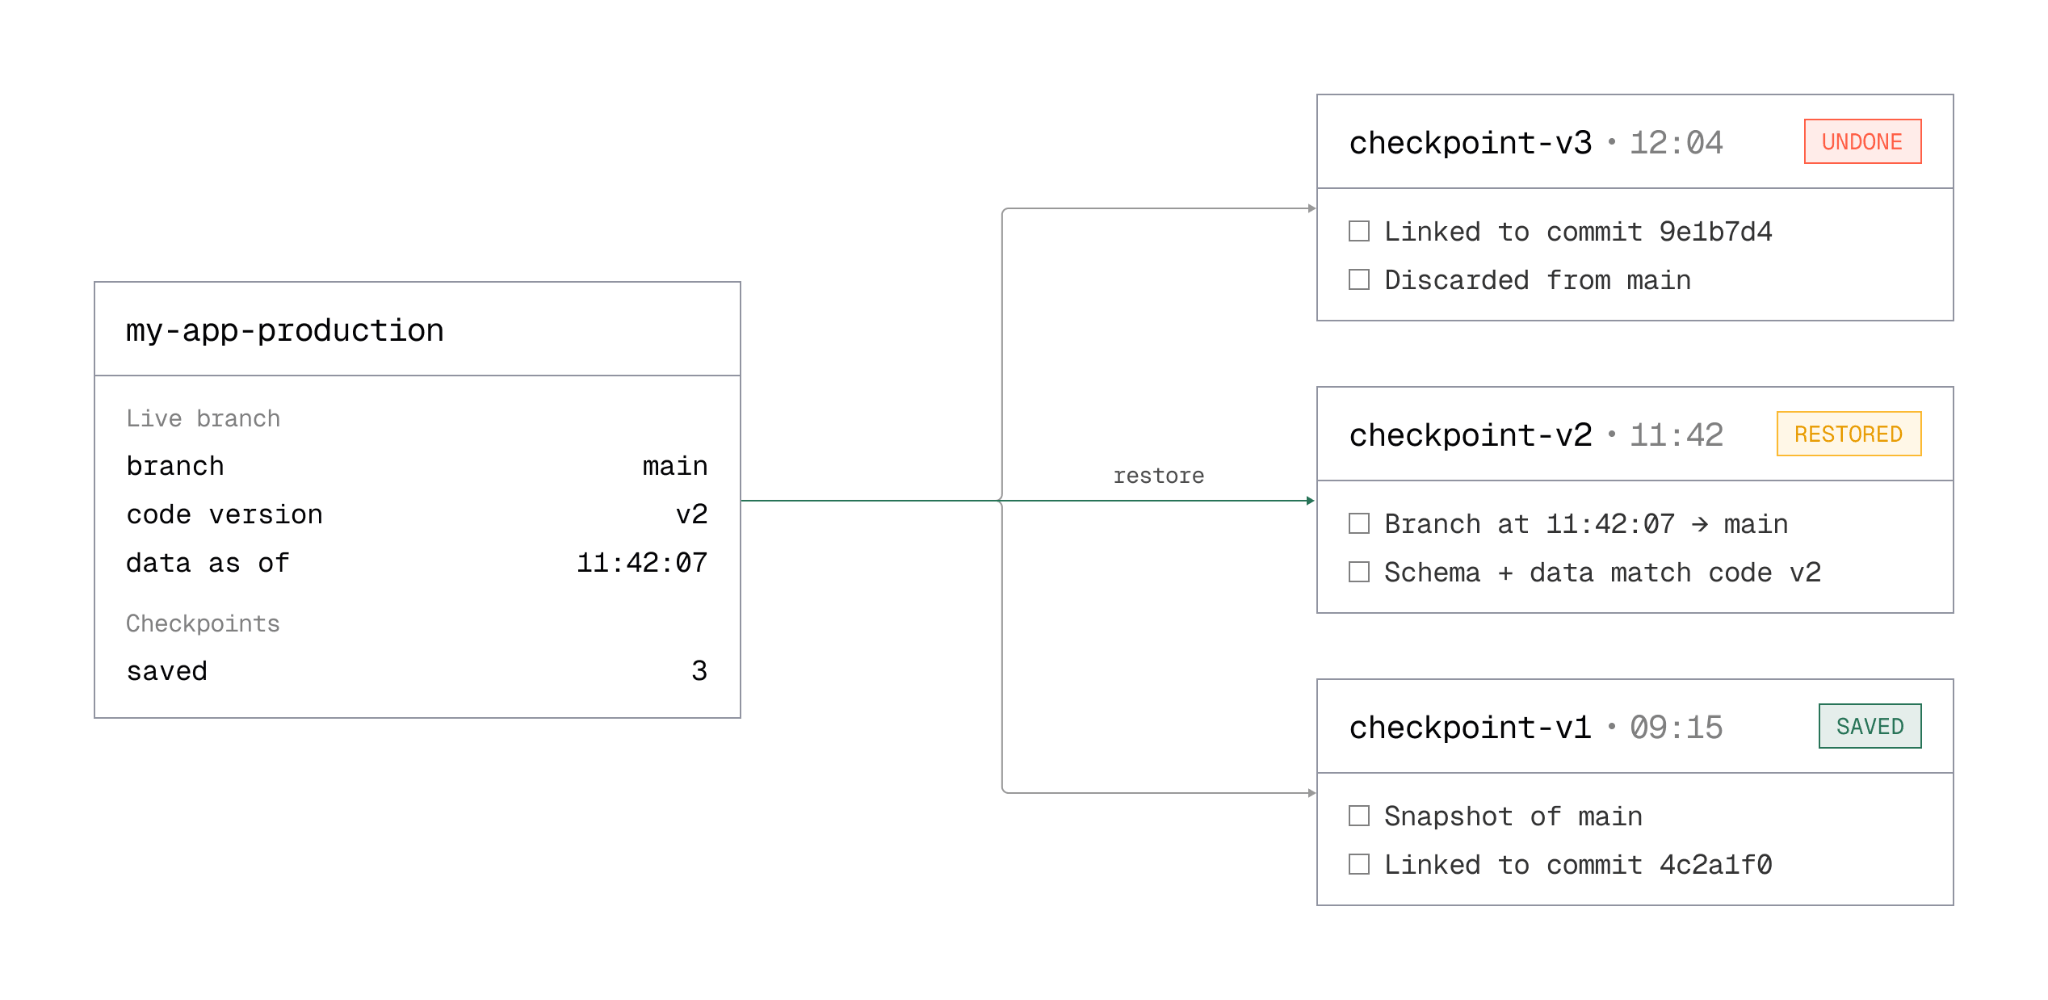
I ripristini in Lakebase sono un'operazione semplice: creare un branch a un determinato timestamp. Il ciclo è abbastanza breve da consentire agli agenti di trattarlo come una normale chiamata di strumento (tool call), non solo per risolvere gli incidenti.
Questo è l'elemento che le piattaforme di agenti come Replit o v0 industrializzano per creare funzionalità di controllo versione o di annullamento (undo). Un ciclo tipico si presenta così:
- L'agente modifica l'app, il che modifica il database
- La piattaforma salva un checkpoint come snapshot di main. Memorizza l'ID del checkpoint accanto alla versione del codice
- L'utente preme annulla (undo) o sceglie una versione precedente nell'UI
- La piattaforma cerca quel checkpoint e lo ripristina sul branch attivo
- Lo schema e i dati tornano istantaneamente alla versione del database corrispondente al "vecchio codice"
Il PITR tradizionale è troppo lento e pesante per supportare i flussi di lavoro attivi, ma un branch a un determinato timestamp è abbastanza veloce ed economico da far parte del prodotto.
L'architettura di Lakebase cambia il concetto di ripristino
I ripristini tradizionali diventano più lenti e pesanti man mano che il database cresce. I ripristini basati su branch no. La cronologia risiede già al di fuori del compute, quindi un punto passato è qualcosa che si può aprire come branch, non qualcosa da ricostruire. Indipendentemente dal fatto che si abbiano 10 GB o 100 TB, i ripristini hanno lo stesso aspetto. Scegli un timestamp, crea il branch e associa il compute. I guasti su larga scala non fanno più così paura.
Provalo di persona: crea un database Postgres Lakebase, carica una buona quantità di dati, esegui un ripristino e chiediti come hai fatto a farne a meno finora.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.