Lakebase Search: ricerca full-text e vettoriale all'avanguardia per Postgres
Ricerca rapida, scalabile e serverless in Postgres, ora disponibile a livello generale (GA)
di Zhou Sun, Jinjing Zhou, Keming Yang, Usamoi Cui, Pranav Aurora e Junyu Chen
- Lakebase Postgres ora include un motore di ricerca integrato (GA su AWS/Azure). Due estensioni, lakebase_vector (ricerca ANN) e lakebase_text (BM25), consentono di eseguire ricerche semantiche, per parole chiave e ibride direttamente in Postgres insieme ai dati operativi, eliminando la necessità di un sistema di ricerca separato + pipeline ETL.
- Supera pgvector e i motori di ricerca dedicati su larga scala. In un benchmark da 100 milioni di vettori, Lakebase offre un throughput 2 volte superiore rispetto al secondo miglior sistema, costi 4 volte inferiori rispetto a Postgres cloud con pgvector e un recall del 97% con una latenza P99 di 71 ms. Raggiunge questo risultato disaccoppiando l'archiviazione dal calcolo e utilizzando il clustering IVF gerarchico + la quantizzazione binaria (RaBitQ), in modo che le query interessino solo i dati necessari.
- L'architettura è serverless e scala a zero. Si paga per l'utilizzo delle query, non per il volume dei dati. La creazione degli indici viene scaricata dal database primario, gli avvii a freddo richiedono circa 1 secondo e 100 milioni di vettori possono essere gestiti su una singola unità di calcolo, rendendolo progettato appositamente per i pattern di recupero bursty degli agenti AI.
I sistemi OLTP tradizionali non sono stati progettati per le esigenze di ricerca degli agenti IA. Richiedono un recupero a bassa latenza e ad alta precisione su tutti i dati e spesso eseguono ricerche parallele massive. Fino ad ora, risolvere questo problema significava collegare con soluzioni di fortuna un motore di ricerca autonomo al database principale tramite una pipeline ETL.
Ma cosa succederebbe se il tuo database OLTP potesse semplicemente eseguire il carico di lavoro di ricerca in modo efficiente?
Oggi portiamo un motore di ricerca veloce e scalabile su Lakebase Postgres tramite due estensioni: lakebase_vector (ricerca scalabile dei vicini approssimati) e lakebase_text (ricerca full-text bm25). Entrambe le estensioni sono generalmente disponibili su AWS e Azure.
Con lakebase_vector, Postgres è ora alla frontiera della ricerca vettoriale. Supera l'efficienza e la scalabilità di un motore di ricerca dedicato. Nel benchmark VectorDBBench 100M, offre il doppio del throughput rispetto al secondo miglior sistema ed è 4 volte più economico di un fornitore Postgres cloud che utilizza pgvector, e questo senza considerare i risparmi aggiuntivi derivanti dall'autoscaling.
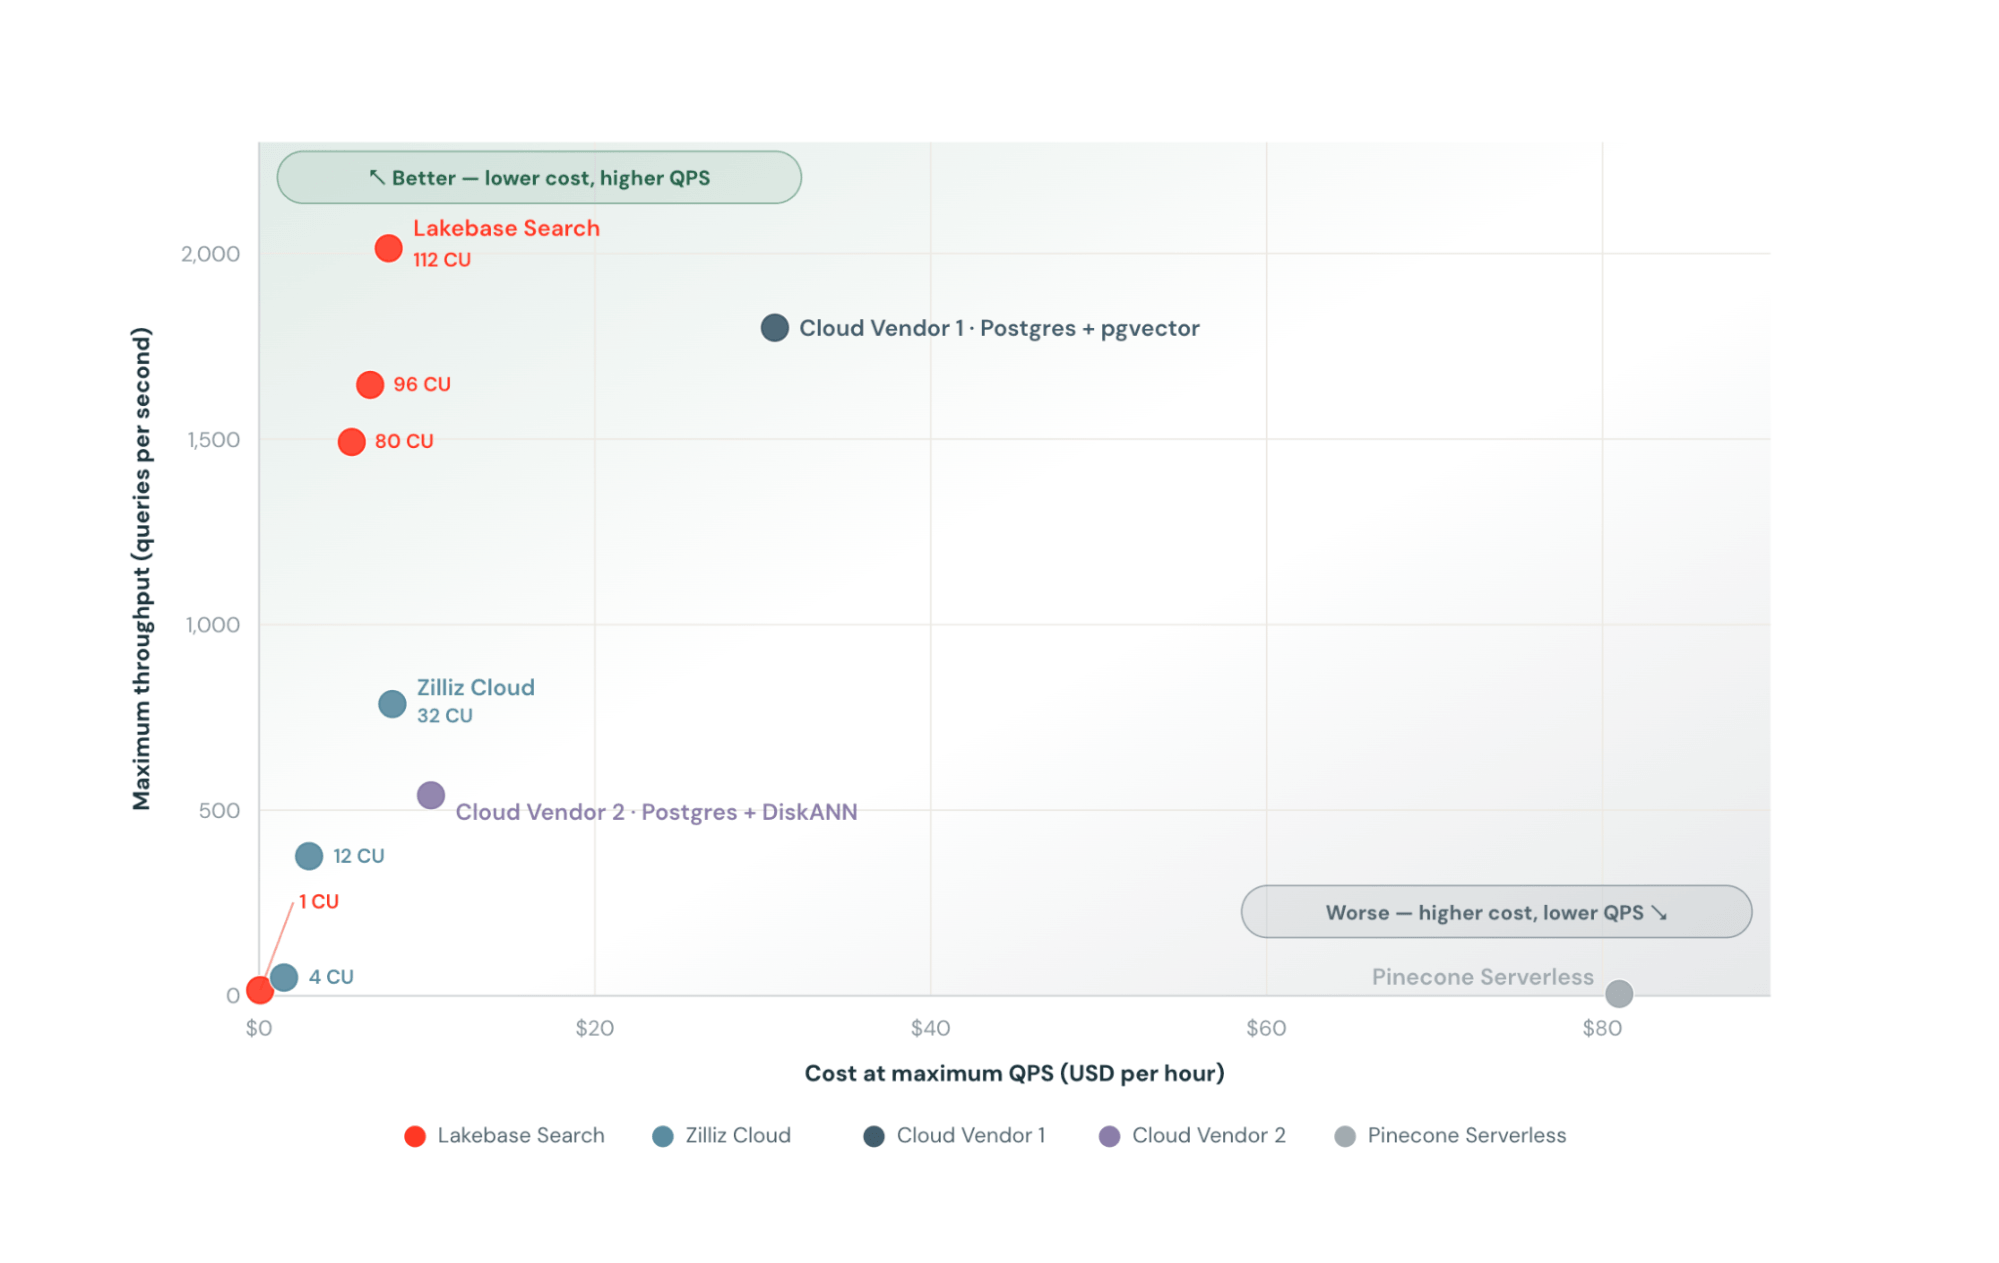
Mantiene queste prestazioni senza sacrificare l'accuratezza. Nei nostri test, lakebase_vector ha registrato una latenza P99 di 71 millisecondi con un recall del 97% (recuperando con successo i veri vicini più prossimi nel 97% dei casi).

Lakebase Postgres ora dispone di funzionalità di ricerca all'avanguardia e abbiamo visto clienti come Conexiom eseguire ricerche ibride con BM25 su oltre 100 milioni di righe con la metà dell'impronta di calcolo rispetto alla loro precedente configurazione pgvector. Ora dispongono di un database per tutti i carichi di lavoro OLTP e di ricerca che è completamente serverless e si adatta alle loro esigenze.
Lakebase Search ci offre un livello di scalabilità completamente nuovo rispetto a pgvector, e sblocca BM25 nello stesso database serverless. Utilizziamo Lakebase per connettere i dati ai nostri agenti su scala. —Jordan Voves, AI/ML Architect @ Conexiom
Perché pgvector mostra i suoi limiti su scala
Per la maggior parte degli utenti Postgres, la ricerca inizia con pgvector. Consente la ricerca di similarità vettoriale tramite algoritmi di indicizzazione come HNSW e IVFFlat sui dati nativamente in Postgres, evitando la complessità di un archivio vettoriale separato. Di fatto, pgvector è l'estensione più installata in Lakebase Postgres. Abbiamo riscontrato 3 punti critici comuni tra i clienti che eseguono pgvector su scala.
Primo: i costi scalano con il volume dei dati, non con l'utilizzo.
pgvector mantiene il suo indice nella memoria del database per essere veloce. Poiché la ricerca HNSW si basa sull'attraversamento di grafi ad accesso casuale, le query vengono eseguite in millisecondi solo se tutto rientra perfettamente nella RAM. Nel momento in cui l'indice si riversa sul disco, le query si trasformano in catene di letture casuali e le prestazioni crollano da 10 a 50 volte.
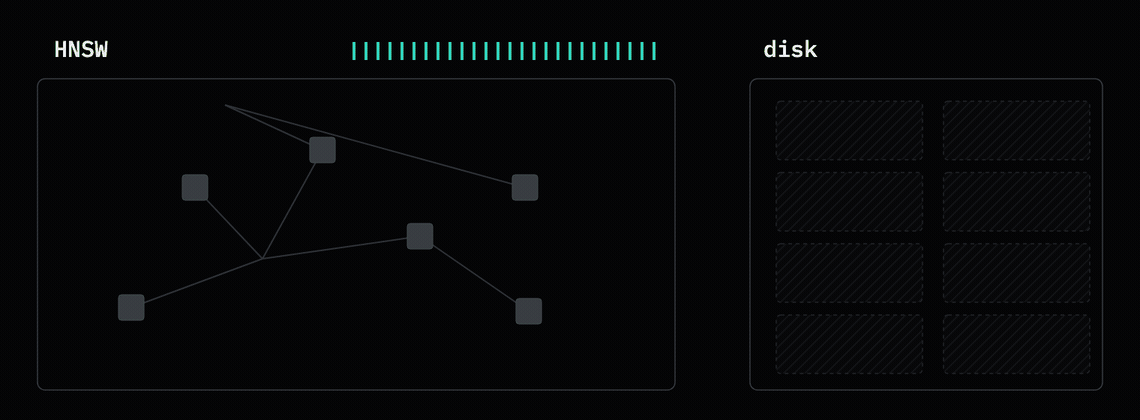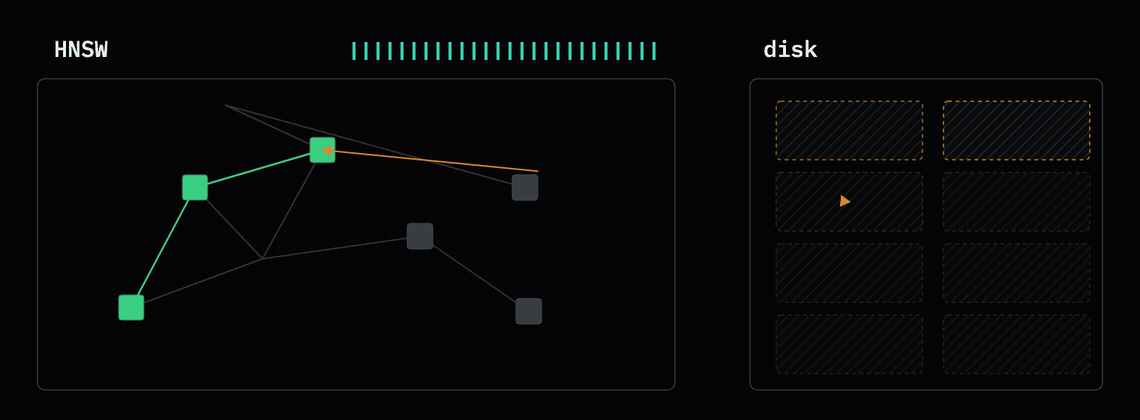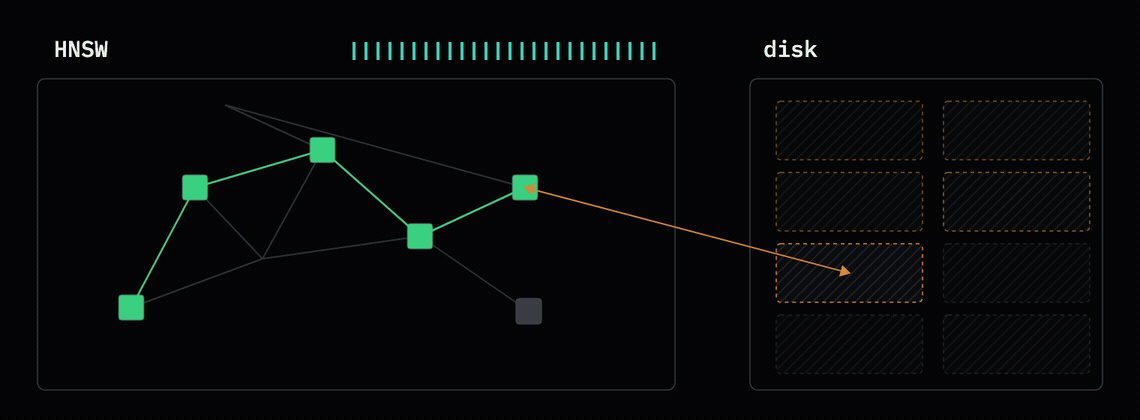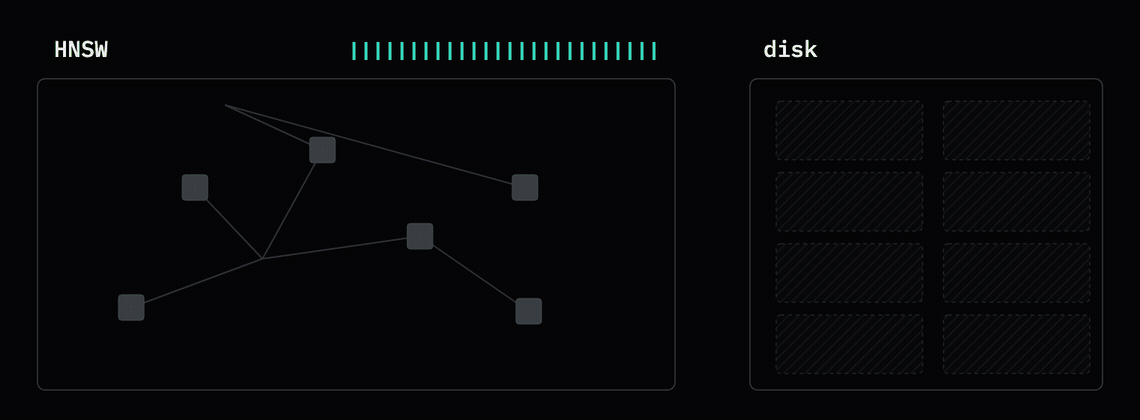
Un vettore float32 a 768 dimensioni richiede circa 3,3 KB di memoria, tenendo conto dei collegamenti del grafo e dell'overhead di Postgres. Con 100 milioni di righe, sono necessari circa 330 GB di RAM per mantenere l'indice residente per query nell'ordine dei millisecondi. Non esiste il concetto di 'working set'. È necessario allocare risorse per l'intero indice, indipendentemente dal fatto che venga interrogato tutto o in parte.
Secondo: la manutenzione dell'indice è costosa e blocca il database.
Gli indici pgvector sono limitati dalla memoria perché il grafo HNSW si basa su un accesso casuale continuo. Quando una compilazione si riversa sul disco, milioni di operazioni di I/O casuali bloccano le prestazioni, richiedendo quasi 50 ore per creare un indice pgvector su un'istanza cloud standard.
L'ingestion soffre dello stesso collo di bottiglia. L'inserimento di nuovi vettori è lento e costoso perché ogni scrittura costringe pgvector a navigare e modificare più livelli del grafo utilizzando ricerche ad accesso casuale.
In secondo luogo, l'ingestion diventa lenta e costosa poiché HNSW si basa sulla navigazione continua del grafo ad accesso casuale. Inoltre, è necessario modificare ogni livello del grafo. Quindi l'indice hnsw
La manutenzione continua aggrava il problema. Poiché HNSW non dispone di un ribilanciamento globale, il ripristino della qualità di ricerca richiede un REINDEX completo, che blocca la tabella e impedisce le scritture in produzione.
Terzo: si scende a compromessi tra qualità di ricerca e prestazioni
Ogni query pgvector viene eseguita su un singolo processo backend di Postgres, il che significa che la scansione dell'indice HNSW non viene mai parallelizzata.
Per ottenere un recall più elevato, il motore deve visitare più nodi del grafo, attivando più letture casuali della memoria e confronti di distanza. Ciò aumenta la latenza e riduce le QPS. Poiché una singola ricerca non può essere parallelizzata tra i core, l'unica opzione per ottenere un throughput più elevato è aggiungere più connessioni o repliche di lettura.
lakebase_vector porta la ricerca vettoriale scalabile su Postgres
Il collo di bottiglia principale di pgvector è che l'intero indice deve risiedere nella RAM di una singola macchina per essere veloce. E se non fosse così?
Lakebase Postgres ci offre un ottimo punto di partenza, perché separa l'archiviazione dal calcolo. I dati persistenti risiedono in un economico storage a oggetti cloud, mentre la RAM e l'NVMe locale fungono da cache temporanee per letture rapide del working set di dati. Con questa architettura, una cache HNSW si traduce in una serie di letture casuali dello storage a oggetti.
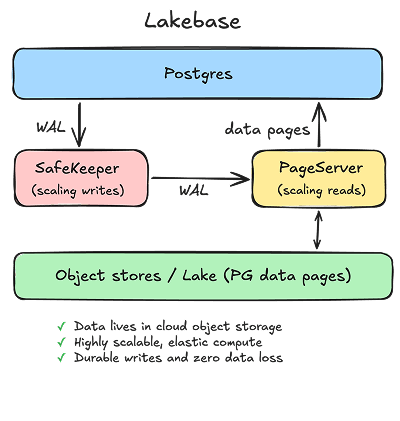
Abbiamo bisogno di un indice che sia veloce sia quando è memorizzato nella cache RAM sia quando è a freddo sullo storage a oggetti. Sfruttiamo due idee:
- Clustering IVF gerarchico. I vettori sono raggruppati in cluster memorizzati come blocchi contigui. Una query valuta i centroidi dei cluster in memoria, quindi legge solo i pochi blocchi promettenti, trasformando centinaia di passaggi casuali in una manciata di grandi letture sequenziali.
- Quantizzazione binaria (RaBitQ). Ciascun vettore viene compresso a circa 1 bit per dimensione, circa 32 volte più piccolo rispetto a float32. Le query scansionano i codici compatti per selezionare i candidati, quindi riclassificano tale selezione ristretta rispetto ai vettori a piena precisione.
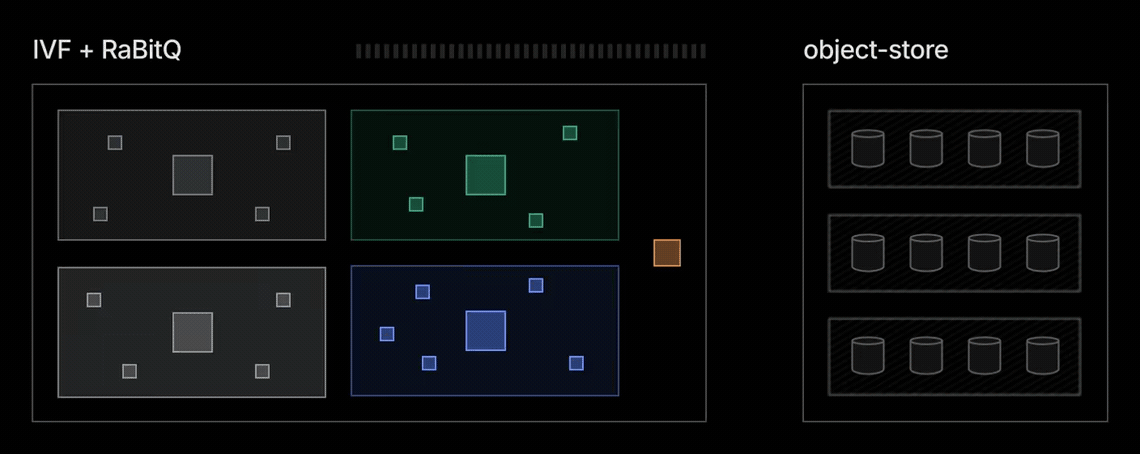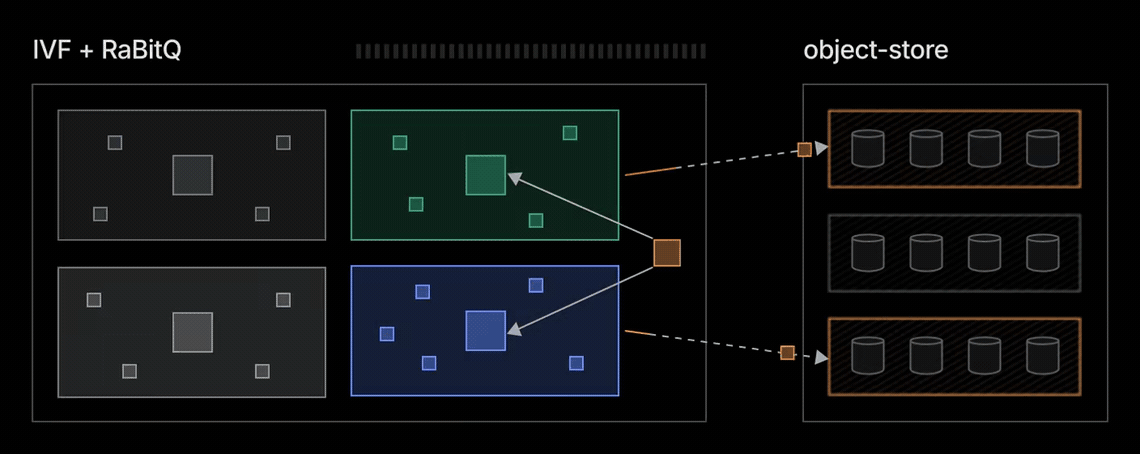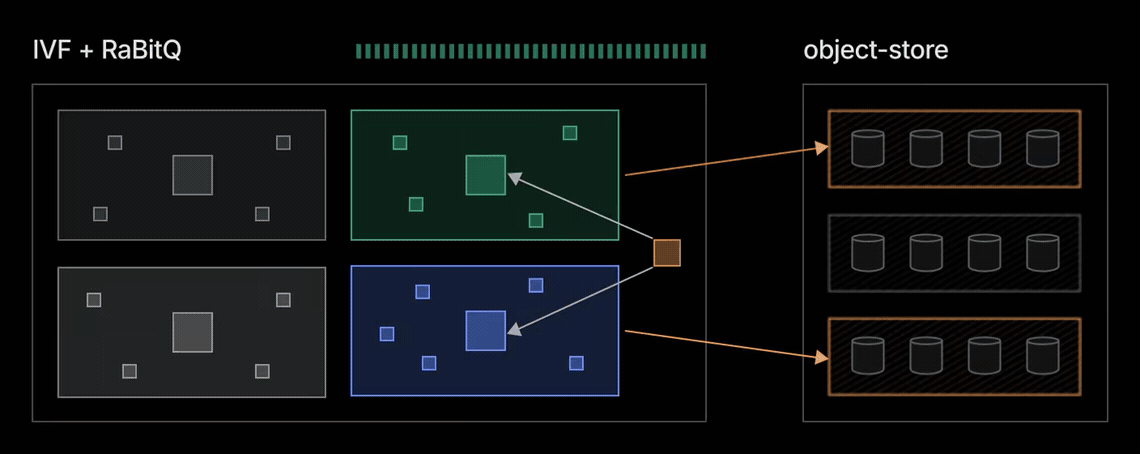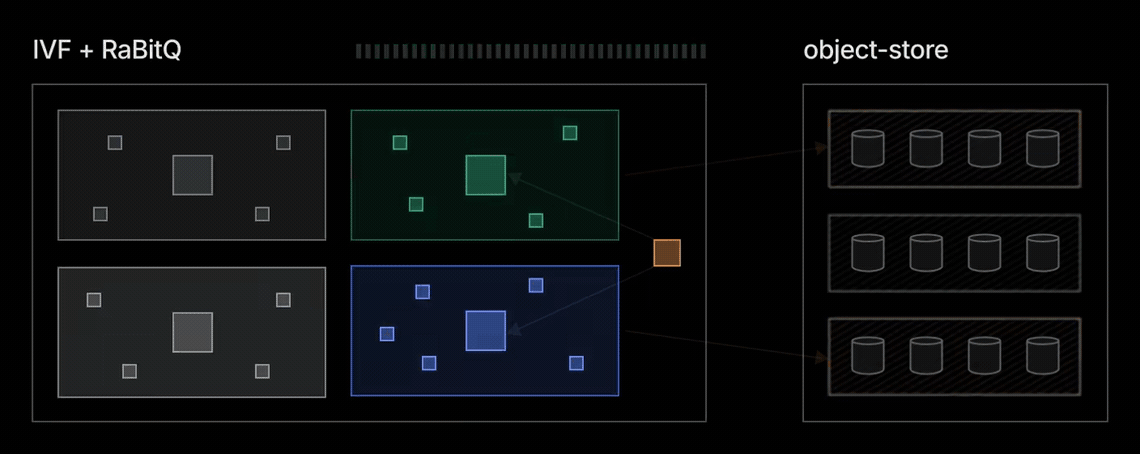
Quando è memorizzata nella cache, la ricerca opera su un'impronta minima utilizzando vettori quantizzati. Quando è a freddo, le query recuperano solo i blocchi necessari senza dover scansionare l'intero indice. Lakebase_vector offre:
Paga solo per ciò che usi e scala a zero
La separazione tra archiviazione e calcolo rende lakebase_vector completamente stateless: un nodo memorizza nella cache i dati caldi su richiesta, si sospende a zero quando è inattivo e si riattiva alla query successiva.
- A riposo, paghi solo per l'archiviazione, garantendoti un costo base ridotto per mantenere i vettori indicizzati in Lakebase.
- Gli avvii a freddo sono economici perché vengono caricati solo i codici quantizzati e i blocchi specifici interessati da una query. Il nostro P90 misurato per la prima query dopo lo scale-to-zero è di soli 1,13 secondi (100M × 768-dim).
- È persino possibile servire 100 milioni di vettori su una sola Lakebase Compute Unit (CU). Solo il dataset di lavoro attivo deve essere memorizzato nella cache dei nodi di calcolo, offrendoti un modello di prezzo che rispecchia fedelmente l'utilizzo effettivo e l'attività delle query.

Creazione rapida e offloaded degli indici
lakebase_vector crea gli indici in modo più parallelo. Addestriamo i centroidi una sola volta su un piccolo campione casuale. Questo è l'unico passaggio che esamina l'intero dataset. Dopodiché, ogni vettore viene assegnato in modo indipendente al centroide più vicino, quantizzato e scritto nel blocco del rispettivo cluster. Questo processo può essere distribuito su tutti i core disponibili, scalando con la potenza di calcolo.

Facciamo un passo avanti esternalizzando completamente la creazione degli indici dal database primario. L'archiviazione dei dati in formati aperti consente alla nostra architettura LTAP di delegare l'indicizzazione e la manutenzione a motori distribuiti come Spark, riducendo i tempi di creazione a pochi minuti grazie al calcolo parallelo. Continua a seguirci.
Ricerca rapida e accurata
lakebase_vector amplia la ricerca dei candidati in modo economico utilizzando codici compatti a 1 bit, effettuando il reranking solo su una ristretta shortlist alla massima precisione. Poiché i blocchi di indice sono indipendenti, una singola query viene parallelizzata tra i core della CPU, offrendo contemporaneamente un'elevata recall e una bassa latenza.
Il filtraggio avviene direttamente mentre lakebase_vector esegue la scansione dei blocchi del cluster. L'applicazione di predicati inline evita il recupero eccessivo di candidati e mantiene alta la recall sulle query filtrate.
lakebase_text: ricerca BM25 nativa in Postgres
La ricerca testuale standard di Postgres (tsvector) è priva di un contesto di rilevanza a livello di intero corpus. lakebase_text introduce BM25 nativo in Postgres assegnando un punteggio ai termini con la inverse document frequency (IDF) globale: attribuendo un peso maggiore ai termini rari e ad alto intento, e penalizzando al contempo le parole di riempimento comuni.
È anche più veloce dei tradizionali indici tsvector + GIN. Valutando i limiti superiori dei punteggi durante l'attraversamento, il motore salta interi blocchi di posting che non possono raggiungere i risultati top-K.
La combinazione di lakebase_text con lakebase_vector sblocca la ricerca ibrida nativa all'interno di Postgres. In una singola query, puoi fondere la ricerca vettoriale semantica con la rilevanza delle parole chiave BM25, applicare predicati di filtro SQL standard ed eseguire join direttamente con tabelle operative in tempo reale.
Lakebase Postgres è nato per l'era degli agenti
Gli agenti hanno spinto i motori di ricerca tradizionali oltre i loro limiti. Hanno reso la ricerca vettoriale un requisito fondamentale del data stack e hanno introdotto picchi estremi di attività (burstiness), in cui un singolo flusso di lavoro può attivare migliaia di richieste di recupero simultanee in pochi secondi.
Abbiamo progettato Lakebase Search specificamente per questa nuova realtà. Lakebase Postgres è ora in grado di gestire tutti i carichi di lavoro operativi e di ricerca, supportato da un'architettura serverless che scala in modo trasparente da 1 riga a 1 miliardo di vettori e da 1 QPS a migliaia, senza riprovisionamento manuale o gestione dell'infrastruttura.
Abbiamo sviluppato Lakebase Search basandoci sul feedback di centinaia di clienti beta, e i risultati parlano da soli:
- Spesa per il database ridotta di 3 volte: Conexiom ha tagliato i costi infrastrutturali di 3 volte, ottenendo al contempo un throughput 5 volte superiore rispetto a pgvector.
- Una sola chiamata di strumento SQL per gli agenti: gli sviluppatori sostituiscono complesse pipeline di recupero multisistema con una singola chiamata SQL per la ricerca ibrida nativa, regolata dalle normali regole del database.
- OLTP e ricerca unificati: i team consolidano le tabelle operative in tempo reale e i cluster di ricerca dedicati in un unico backend con tariffazione a consumo (pay-as-you-use).
Lakebase Search è generalmente disponibile oggi su AWS e Azure. Se stai già creando un'app o un agente su Lakebase, ti basta abilitare le estensioni. Se non hai ancora provato Lakebase, inizia oggi stesso.
▎ 📝 Nota: Databricks AI Search è un motore di ricerca gestito per un recupero di alta qualità pronto all'uso — potrebbe essere la soluzione ideale se desideri ottimi risultati senza ottimizzazione manuale. Lakebase Search è invece la scelta migliore se vuoi tutti i tuoi dati operativi e di ricerca in un unico database.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.