Dati manifatturieri e AI: collegare la catena del valore del prodotto
Offri a ogni fase della catena del valore manifatturiera l'accesso a dati affidabili e all'AI
- I dati di produzione coprono una catena del valore del prodotto connessa, ma i sistemi che li acquisiscono rimangono separati per funzione e impianto
- Databricks unisce i dati provenienti da sistemi diversi – o esegue query in loco – in modo che i team possano rispondere a domande relative a diverse fasi dell'intera catena del valore
- La semantica governata, l'analisi in linguaggio naturale e le applicazioni agentiche aiutano più persone a passare dalla ricerca dei dati all'azione, senza dover diventare data engineer
Un difetto di produzione raramente appartiene a un solo sistema. Un picco di scarti può essere correlato all'impostazione di una macchina, a un lotto di un fornitore, a un evento logistico o a un problema ricorrente registrato in un sistema di qualità. Tuttavia, i dati necessari per analizzarlo sono solitamente suddivisi tra stabilimenti, funzioni e sistemi diversi.
Più di 50 anni fa, la visione del Dr. Joseph Harrington del Computer Integrated Manufacturing (CIM) riconosceva che la produzione dipende da un flusso connesso di informazioni tra le varie funzioni. Oggi, quella visione sta diventando realtà poiché i dati e l'AI collegano le varie fasi della catena del valore del prodotto.
Le domande più difficili nel settore manifatturiero sono quelle che attraversano diverse fasi:
- Quale lotto del fornitore ha raggiunto i prodotti interessati?
- Questo difetto si è già presentato in passato? L'azione correttiva ha funzionato?
- Quali clienti o casi di assistenza potrebbero essere interessati?
Rispondere a una qualsiasi di queste domande richiede l'unione di dati provenienti da sistemi che non sono mai stati progettati per comunicare tra loro. I produttori non hanno bisogno di altri report isolati. Hanno bisogno di un flusso connesso di informazioni lungo tutta la catena del valore del prodotto, con la governance e il contesto aziendale necessari per rendere tali informazioni utilizzabili. Questo è il ruolo che una moderna piattaforma di dati e AI può svolgere.
Cos'è la catena del valore del prodotto nel settore manifatturiero?
La catena del valore del prodotto è la sequenza end-to-end di funzioni che trasforma le materie prime e le idee in prodotti consegnati ai clienti e supportati sul campo. Collega ricerca e sviluppo (R&D) e progettazione, acquisti, produzione e qualità, vendite e marketing, assistenza post-vendita e sul campo. Ogni fase ha i propri obiettivi, team e sistemi operativi:
- La ricerca e sviluppo (R&D) e la progettazione lavorano con Product Lifecycle Management (PLM), Computer-Aided Design (CAD), Computer-Aided Engineering (CAE) e simulazione, dati di test, requisiti e distinte base (BOM) di progettazione.
- Gli acquisti lavorano con la gestione acquisti dell'Enterprise Resource Planning (ERP), source-to-pay, contratti, rischio dei fornitori e portali dei fornitori.
- La produzione e la qualità lavorano con Manufacturing Execution Systems (MES), dati Supervisory Control and Data Acquisition (SCADA)/Programmable Logic Controller (PLC), storici di processo, Quality Management Systems (QMS)/Laboratory Information Management Systems (LIMS) e sistemi di manutenzione.
- La logistica e la supply chain lavorano con Enterprise Resource Planning (ERP), Warehouse Management Systems (WMS), Transportation Management Systems (TMS), sistemi di pianificazione, Electronic Data Interchange (EDI) e telematica.
- Le vendite e il marketing lavorano con Customer Relationship Management (CRM), Configure-Price-Quote (CPQ), determinazione dei prezzi, gestione dei concessionari, marketing automation ed e-commerce.
- L'assistenza post-vendita e sul campo lavorano con la gestione dei servizi, la garanzia, la pianificazione dei ricambi, i dati dei prodotti connessi, la diagnostica e i ticket.
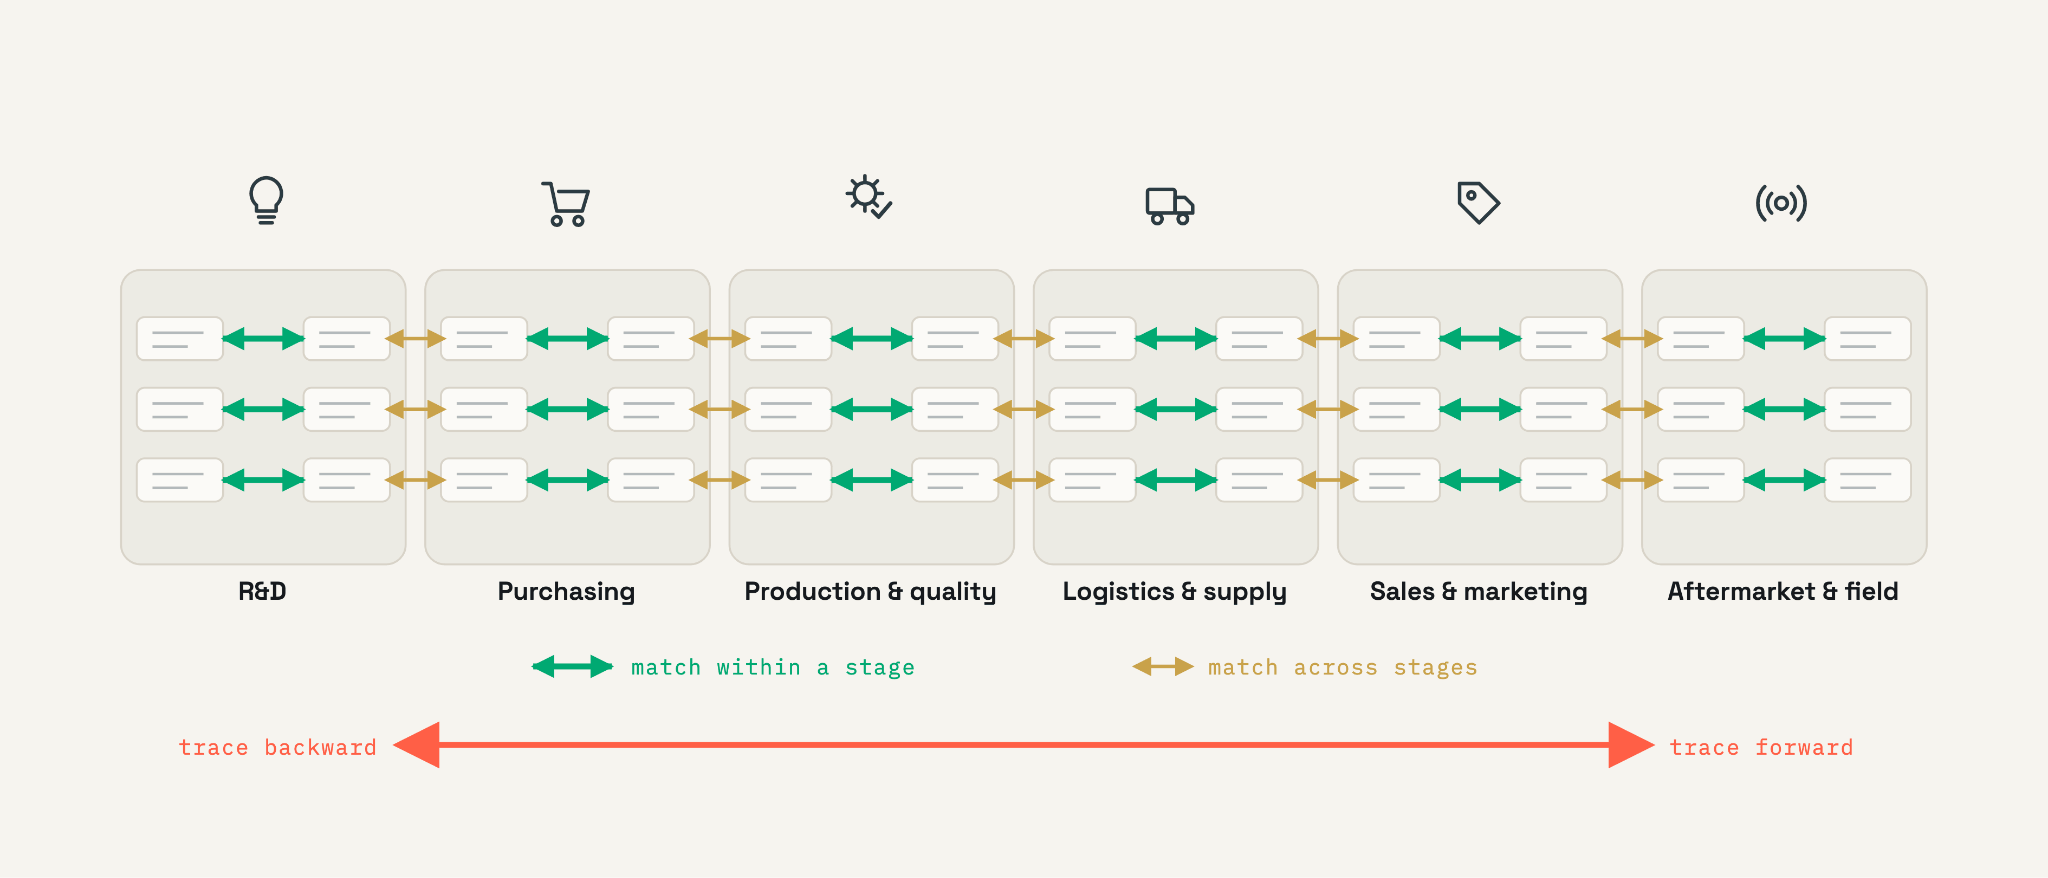
Ogni fase produce dati operativi preziosi. L'opportunità più grande deriva dal collegare un riscontro in una parte della catena a un'azione in un'altra: un problema di qualità riscontrato in produzione analizzato attraverso i registri della logistica e dei fornitori, o un avviso del fornitore tracciato fino a ogni prodotto che ha ricevuto il materiale interessato.
Perché i confini dei sistemi sono il vero problema
Quando ogni fase della catena del valore è isolata, una domanda che attraversa più fasi si trasforma in un processo manuale di ticket, esportazioni e riconciliazioni. Quando i dati sono accessibili come un unico sistema governato, la stessa domanda diventa una semplice query.
Esempio 1: Un ingegnere della qualità di uno stabilimento deve rispondere a tre domande:
- Un picco di scarti è causato dal lotto, dalla macchina o dalla configurazione, ed è ancora in corso?
- Abbiamo già riscontrato questo difetto in passato e la soluzione ha funzionato?
- Perché uno stabilimento scarta molti più pezzi dello stesso tipo rispetto a un altro?
Ogni domanda spazia su più sistemi: registri del Manufacturing Execution System (MES), dati dello storico di processo, dati dei fornitori e del Supplier Quality Management (SQM), cronologia del Quality Management System (QMS), registri Eight Disciplines (8D) e, spesso, istanze di più stabilimenti. Oggi, rispondere a ciascuna di esse significa aprire ticket, effettuare esportazioni manuali e fare affidamento su pochi specialisti.
Esempio 2: Un analista degli acquisti deve rispondere a tre domande:
- Quali componenti critici dipendono da un unico fornitore che ora è contrassegnato come a rischio di consegna?
- La puntualità e la qualità delle prestazioni di un fornitore sono diminuite negli ordini recenti?
- Se un fornitore fallisce, quali prodotti, stabilimenti e ordini aperti sono esposti al rischio?
Ogni domanda spazia su più sistemi: acquisti dell'Enterprise Resource Planning (ERP) e registri source-to-pay, contratti, feed sul rischio dei fornitori e portali dei fornitori. Oggi, rispondere a ciascuna di esse può trasformarsi in un piccolo progetto fatto di ticket, competenze specialistiche ed esportazioni manuali.
Raggruppare queste fonti di dati operativi elimina questo attrito. Riunisci la catena del valore una sola volta, governala una sola volta e usa un identificatore condiviso (un numero di serie, di lotto o di codice componente) come chiave di join, e la tracciabilità diventerà una semplice query. Sei domande, un'unica esigenza di fondo: unire dati provenienti da sistemi che non sono mai stati progettati per essere collegati e potersi fidare del risultato. Quattro funzionalità della piattaforma rendono tutto questo possibile.
In che modo Databricks collega i dati di produzione
Nessuna migrazione invasiva richiesta
Una catena del valore connessa non richiede una migrazione invasiva di ogni sistema di origine. I dati possono essere copiati quando questa è la scelta giusta, oppure possono rimanere dove sono ed essere comunque interrogati.
Con Open Sharing zero-copy e Lakehouse Federation, le organizzazioni possono accedere ai dati nei loro sistemi di origine senza creare un'altra pipeline di estrazione, trasformazione e caricamento (ETL) o una copia per ogni caso d'uso. Quando il mirroring è opportuno, i connettori e lo storage di oggetti cloud offrono un percorso scalabile per importare i dati nel lakehouse.
La Databricks Data and AI Platform unisce questa flessibilità alle funzionalità necessarie ai team di produzione: analisi storica dei dati di produzione, qualità e fornitura; elaborazione a bassa latenza per la telemetria di macchinari e veicoli; e applicazioni in grado di leggere e scrivere rapidamente singoli record.
Le quattro funzionalità su cui si basano gli esempi
Raggruppare o federare i dati di origine, senza una migrazione invasiva: la domanda dell'ingegnere della qualità spazia tra MES, storico di processo, fornitore e SQM, QMS e registri 8D in diverse istanze dello stabilimento; quella dell'analista degli acquisti spazia tra acquisti ERP, contratti e feed sul rischio dei fornitori. Con Open Sharing zero-copy e Lakehouse Federation, questi dati possono essere interrogati in loco e duplicati tramite connettori quando la copia rappresenta la scelta migliore. In ogni caso, non è richiesta una nuova copia ETL per ciascuna domanda.
Orchestrazione e perfezionamento: entrambi gli esempi eseguono il join su tabelle gold governate, non su estratti grezzi. Lakeflow aiuta i team a creare, pianificare e monitorare le pipeline che trasformano gli input grezzi in dati affidabili e pronti per l'analisi, solitamente attraverso i livelli Bronze, Silver e Gold.
Governance per dati e AI: Unity Catalog è l'unico piano di controllo per i dati duplicati e federati: un solo modello di autorizzazione, lineage completo e discovery che spazia tra dati, modelli e agenti AI, in modo che la stessa superficie governata risponda a entrambi gli esempi. Unity Gateway consente di controllare l'accesso all'AI, la spesa e l'osservabilità tra agenti, strumenti, modelli e MCP.
Funzionalità agentiche: sviluppato su questa base governata, Genie One è un assistente AI che si connette ai tuoi dati, Agent Bricks aiuta a creare agenti AI basati sui dati aziendali e Genie App Builder consente a chiunque di creare agenti e applicazioni in linguaggio naturale. L'ingegnere e l'analista possono porre le loro domande in linguaggio naturale e ottenere risposte basate sulle definizioni riconosciute dall'azienda, argomento delle prossime due sezioni.
Il principio di progettazione pratica è semplice: raggruppare i dati dove aggiungono valore, federarli dove la copia non ha senso e governare entrambi attraverso lo stesso piano di controllo. Il risultato è un modo di lavorare su diversi tipi di dati e fasi di produzione senza creare un nuovo silo per ogni caso d'uso analitico o di AI.
Migliorare la data literacy: rendere i dati utili non solo agli specialisti
Una piattaforma ha valore solo se le persone sono in grado di usarla. In molte aziende manifatturiere, un piccolo gruppo di esperti comprende i sistemi specifici dell'impianto, mentre gli utenti aziendali attendono report o esportazioni.
L'alfabetizzazione dei dati (data literacy) cresce quando le persone possono seguire un percorso pratico: trovare dati rilevanti, comprenderne le definizioni attendibili, analizzarli, porre domande in linguaggio naturale, creare agenti o applicazioni governate e condividere tali risorse con altri. Non tutti devono diventare data engineer per partecipare. Questa crescita segue sei passaggi, illustrati di seguito.

La tecnologia è solo una parte del cambiamento. La formazione, le community di pratica e una rete di "champion" aiutano ogni funzione a sviluppare sicurezza e a condividere pattern riutilizzabili. Una superficie di dati comune e governata offre a queste community una base concreta su cui lavorare: definizioni condivise, un vocabolario comune e risposte che possono essere riutilizzate tra i vari team.
Come funziona "Talk to Data" nel settore manifatturiero (e perché richiede una semantica governata)
Il modo più rapido per migliorare l'alfabetizzazione dei dati è consentire alle persone di parlare con i propri dati: nessun linguaggio di query da imparare, nessun ticket da aprire e nessun report da attendere. L'analisi in linguaggio naturale può abbassare la barriera di accesso ai dati, ma un'interfaccia conversazionale non è sufficiente. La risposta deve basarsi su definizioni riconosciute dall'azienda.
Esempio: Acquisti
Una domanda come "Quali componenti critici dipendono da un unico fornitore che ora è segnalato per rischio di consegna?" può richiedere la conoscenza di intestazioni di tabella specifiche di SAP, join e regole aziendali. Un analista degli acquisti non dovrebbe aver bisogno di diventare uno specialista dei dati per fare questa ricerca.
La demo di Purchasing Genie rende concreto questo pattern. Il progetto eseguibile segue tre passaggi: preparare dati governati, creare agenti esperti, quindi comporli sotto un supervisore e condividerli come un'unica app governata.

Questo pattern separa il lavoro che richiede competenze tecniche (la preparazione e la governance dei dati) dal lavoro che gli utenti aziendali dovrebbero essere in grado di svolgere autonomamente: porre domande, esaminare le risposte e agire.
Esempio: Reportistica KPI
Lo stesso pattern si applica alla reportistica quotidiana. Quando le definizioni dei KPI risiedono in un livello semantico governato, sia gli strumenti di BI sia l'IA operano in base alla stessa logica aziendale. Gli agenti Genie rispondono alle domande all'interno di una funzione utilizzando tali definizioni attendibili, e Agent Bricks li compone in agenti basati su personas che operano tra le varie funzioni. Il risultato: la stessa domanda ottiene ogni volta la stessa risposta, basata su definizioni riconosciute dall'azienda anziché dedotta da schemi complessi o report scollegati.
Mercedes-Benz Korea applica questo pattern nella pratica, scopri di più qui.
Un percorso pratico da seguire
Più di 50 anni ago, la visione del Dr. Joseph Harrington della Computer Integrated Manufacturing descriveva la produzione come un unico sistema coeso, unificato dal flusso di informazioni. Quella visione è ora realizzabile su scala.
La ricetta per l'implementazione prevede tre passaggi:
- Raggruppare i dati una sola volta e governarli una sola volta con Unity Catalog come unico piano di controllo, coprendo sia le origini dati speculari (mirrored) sia quelle federate.
- Utilizzare un identificatore condiviso come chiave di join (un numero di serie, di lotto o di parte), in modo che i risultati in una parte della catena del valore possano guidare l'azione in un'altra, abilitando la tracciabilità end-to-end sotto forma di query. L'identificatore adatto dipende dal dominio: unità serializzate e VIN in alcuni casi, numeri di lotto o di batch nella produzione di processo.
- Consentire alle persone di parlare con i propri dati basando l'accesso in linguaggio naturale sulla semantica aziendale governata.
Quando gli utenti aziendali possono porre domande in un linguaggio semplice e ricevere risposte affidabili, l'alfabetizzazione dei dati smette di essere il privilegio di pochi specialisti e diventa una capacità organizzativa. Il risultato non è un'altra dashboard. Sono migliaia di persone in tutta la catena del valore che possono trovare, comprendere e agire su dati attendibili.
Domande frequenti (FAQ)
Qual è il vantaggio principale del collegamento dei dati di produzione lungo tutta la catena del valore?
Il vantaggio principale del collegamento dei dati di produzione lungo tutta la catena del valore è la capacità di rispondere a domande che iniziano in una fase e richiedono un'azione in un'altra. Un difetto di produzione può essere tracciato attraverso la logistica fino al lotto del fornitore che lo ha causato, oppure un lotto sospetto del fornitore può essere tracciato in avanti fino a ogni prodotto che ha raggiunto. Senza dati collegati, ciascuna di queste indagini richiede giorni di lavoro manuale. Con un lakehouse collegato, la stessa domanda diventa una query.
I produttori devono migrare tutti i dati di origine su Databricks?
I produttori non devono migrare tutti i dati di origine su Databricks. I dati possono essere copiati quando utile, ma la condivisione aperta zero-copy (Open Sharing) e la Lakehouse Federation consentono ai dati di rimanere nei sistemi di origine e di essere interrogati in loco. Unity Catalog può governare sia i dati federati sia quelli speculari (mirrored).
Che cos'è la tracciabilità?
La tracciabilità collega le fasi del processo di produzione, i prodotti, i materiali e i record operativi in modo che i team possano risalire a ritroso da un prodotto interessato o procedere in avanti da un materiale sospetto. Supporta una risoluzione dei problemi più rapida e un'analisi dei richiami più precisa. Un esempio consiste nel tracciare i numeri di serie o di lotto dei prodotti realizzati.
Che cos'è l'LTAP e perché i produttori ne hanno bisogno?
LTAP significa Lake Transactional/Analytical Processing. Descrive l'esecuzione di carichi di lavoro analitici e transazionali su un'unica piattaforma governata. Il settore manifatturiero ha bisogno sia di analisi su larga scala dei dati storici sia di applicazioni reattive che leggono e scrivono record operativi. Storicamente questi risiedevano in due stack separati con dati copiati tra di essi; LTAP esegue entrambi su un'unica copia di dati governati.
Cosa fa crescere l'alfabetizzazione dei dati oltre alle funzionalità della piattaforma?
Le funzionalità da sole non bastano. La formazione, le community di pratica e i "champion" in ogni funzione aiutano le persone a sviluppare sicurezza, condividere pattern e utilizzare una superficie di dati comune e governata. La piattaforma fornisce le fondamenta; una community attiva la trasforma in una capacità diffusa.
In che modo "Talk to Data" diventa affidabile?
L'accesso in linguaggio naturale dovrebbe basarsi su una semantica aziendale governata: misure, dimensioni, join e definizioni documentate. Genie può quindi rispondere alle domande utilizzando lo stesso contesto attendibile anziché dedurre il significato da schemi complessi o report scollegati.
Che cos'è la Lakehouse Federation?
La Lakehouse Federation è una funzionalità di Databricks che consente ai dati di rimanere nel sistema di origine pur essendo interrogati tramite Databricks. Evita la creazione di pipeline ETL aggiuntive o copie di dati. I dati di origine sono governati tramite Unity Catalog insieme a tutti i dati speculari (mirrored), offrendo un livello di governance unificato indipendentemente da dove risiedono fisicamente i dati.
Che cos'è Unity Catalog nel contesto dei dati di produzione?
Unity Catalog è il livello di governance unificato di Databricks per dati, modelli e agenti IA. Fornisce un unico modello di autorizzazioni, la derivazione completa dei dati (data lineage) e l'esplorazione dell'intero panorama dei dati. Per il settore manifatturiero, significa un unico piano di controllo che governa i dati di produzione, i record di qualità, i dati dei fornitori e gli agenti IA, sia che tali dati risiedano nel lakehouse sia che siano federati dai sistemi di origine.
La piattaforma gestisce la telemetria di macchinari e veicoli ad alto volume?
Sì. La piattaforma combina batch e streaming. La telemetria di macchinari e veicoli ad alto volume può essere inserita come un flusso continuo a bassissima latenza e processed in modo affidabile, in modo che nessun evento venga perso lungo il percorso.
Come entrano i dati in Databricks?
L'ingestion è progettata per essere semplice. Zerobus Ingest supporta lo streaming basato su push direttamente in tabelle governate, Lakeflow Connect fornisce connettori gestiti e change data capture per i sistemi aziendali, mentre Auto Loader e Structured Streaming gestiscono file ed eventi.
La piattaforma è aperta e multi-cloud?
Sì. Le tabelle Delta sono archiviate su cloud object storage, con scalabilità indipendente di storage e compute. Databricks viene eseguito su AWS, Azure e Google Cloud, e i dati vengono salvati in formati aperti come Delta Lake e Iceberg.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.