NEAREST BY Join: scalare la Vector Search in Databricks Runtime
Come abbiamo integrato la ricerca vettoriale in Databricks come join SQL di prima classe, con profonde ottimizzazioni del kernel in Photon e un indice vettoriale in un formato di archiviazione aperto.
di Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu e Sergei Tsarev
- NEAREST BY è un nuovo join SQL per la ricerca vettoriale batch: per ogni riga di query, trova le k righe più vicine in base alla somiglianza o alla distanza vettoriale, esatta o approssimata.
- Un operatore Photon fuso con un kernel GEMM a blocchi personalizzato spinge il calcolo del punteggio di distanza verso il throughput aritmetico di picco offerto dall'hardware.
- Il tuo Lakehouse è anche il tuo vector store, senza alcun sistema separato da sincronizzare o gestire: l'indice vettoriale IVF è una normale tabella Delta con clustering liquido che esclude la maggior parte delle partizioni in fase di lettura.
La ricerca vettoriale è nata come un problema di serving. Il caso d'uso classico è un chatbot o una barra di ricerca: arriva l'embedding di una query e il sistema è ottimizzato per restituire i primi k documenti più vicini (top-k) entro poche decine di millisecondi.
Tuttavia, una buona parte dei carichi di lavoro (workload) di ricerca vettoriale sulla nostra piattaforma è intrinsecamente orientata al batch, ovvero precalcola i vicini più prossimi (nearest neighbors) esatti o approssimati offline invece di cercarli al momento della richiesta. Una società di pagamenti confronta oltre 100 milioni di transazioni giornaliere con 140 milioni di embedding di merchant per la risoluzione delle entità (entity resolution); un'azienda di dati arricchisce decine di milioni di record storici ogni notte; un fondo quantitativo esegue batch da milioni di query su un corpus di 50 milioni di vettori per la categorizzazione tassonomica.
Risoluzione delle entità (entity resolution), deduplicazione, tagging semantico, classificazione, arricchimento dei record, raccomandazioni in batch: questi sono fondamentalmente carichi di lavoro batch. Si tratta di milioni di query su milioni o miliardi di vettori pianificati nel tempo, misurati in base al completamento del job entro i relativi SLA a un costo ragionevole, piuttosto che dalla latenza di una singola ricerca (lookup). Questi carichi di lavoro meritano un'architettura molto diversa per garantire prestazioni, affidabilità ed efficienza dei costi superiori; per questo siamo tornati ai principi fondamentali.
Requisiti
- Throughput aggregato rispetto alla latenza per singola richiesta. L'unità di misura del successo è il completamento dell'intero job batch entro il suo SLA a un costo ragionevole, quindi il design dovrebbe privilegiare il throughput rispetto alla latenza per singola richiesta in ogni occasione.
- Scalabilità su entrambi i lati della join. Fino a centinaia di milioni di vettori di query contro miliardi di vettori di base. Il sistema deve gestire qualsiasi combinazione di cardinalità di query e di base.
- Parallelismo elastico. Il throughput batch deriva dalla scalabilità orizzontale. Il lavoro deve essere partizionato in modo pulito su centinaia o migliaia di core e le risorse di calcolo devono adattarsi al job: scalare verso l'alto (scale out) per l'esecuzione e ridursi a zero al termine.
- Picco aritmetico per core. Il calcolo del punteggio di distanza (distance scoring) è computazionalmente costoso. Lo scale-out si limita a moltiplicare i risultati di un singolo core, quindi i cicli interni (inner loops) devono essere eseguiti a un livello prossimo al massimo teorico stabilito dalla larghezza di banda aritmetica dell'hardware sottostante (FLOPs/s) e dalla larghezza di banda della memoria (byte/s).
- Tolleranza ai guasti (Fault tolerance). Un job che viene eseguito per ore deve sopravvivere alla perdita di worker, a errori temporanei dei task e alla pressione sulla memoria tramite lo spill su disco (spilling to disk). Queste sono proprietà di un motore di esecuzione, non funzionalità che possiamo racchiudere in un endpoint di serving in tempo reale.
Il Databricks Runtime soddisfa perfettamente questi requisiti: un motore di esecuzione distribuito, tollerante ai guasti ed elastico, basato su Spark e Photon, un motore di query nativo in C++ vettorizzato. Questo è esattamente il motivo per cui abbiamo deciso di creare la ricerca vettoriale direttamente come funzionalità nativa del motore, anziché affidarci a un'infrastruttura separata.
Architettura
La nostra prima versione della funzione SQL VECTOR_SEARCH era progettata per federare le richieste a un endpoint esterno di Vector Search in tempo reale. Era implementata come un nodo Generate che trasmetteva in streaming una riga di query alla volta: ogni riga comportava una richiesta di rete, una risposta da deserializzare e potenziali tentativi (retry). Funzionava, ma mostrava un limite prestazionale: il throughput era limitato dal dimensionamento dell'endpoint in tempo reale anziché dalle dimensioni del cluster di runtime, riducendo il motore di runtime a un semplice distributore (dispatcher). Inoltre, non coglieva la reale struttura della query. Una ricerca vettoriale batch non è un milione di piccole ricerche. È un'unica grande query: per ogni riga a sinistra, trova le k righe più vicine a destra, ovvero una join di classificazione top-k (top-k ranking join). L'esecuzione di join enormi è esattamente ciò in cui il motore di runtime eccelle.
L'implementazione nativa della ricerca vettoriale nel motore di runtime offre vantaggi sotto due aspetti.
- Copia singola dei dati. Gli embedding rimangono nelle tabelle Delta sul Lakehouse: nessun archivio vettoriale (vector store) separato, nessuna pipeline di sincronizzazione da mantenere coerente, nessun secondo sistema da gestire e pagare.
- Un unico motore per l'esecuzione. La ricerca viene eseguita in un unico motore che scala in modo elastico con il carico di lavoro, con kernel appositamente progettati per strutture di query batch, spingendo ogni core verso il picco di FLOPs e lasciando che lo scale-out moltiplichi il resto. Il motore gestisce già la tolleranza ai guasti: i task vengono riprovati automaticamente e la pressione sulla memoria esegue lo spill su disco. Nessun controllo della concorrenza lato client, rate limiting o cicli di retry.
Ciò ha portato a uno stack volutamente ridotto ma profondo: una nuova sintassi di join, NEAREST BY, che rende la join di classificazione top-k un'operazione relazionale di prim'ordine; una riscrittura che la riduce a tre primitive: funzioni di distanza accelerate da SIMD e un aggregato top-k limitato; un operatore Photon fuso che sostituisce l'intera parte centrale del piano con un kernel GEMM personalizzato; e un indice IVF opzionale creato come una normale tabella Delta con clustering liquido, che consente alle query APPROX di calcolare il punteggio di una frazione dei vettori di base con gli stessi kernel.
La sintassi: una join di classificazione top-k
I motori esistenti convergono su due tipi di interfaccia. Postgres con pgvector e Snowflake compongono gli operatori di distanza con ORDER BY … LIMIT: il batch richiede quindi una sottoquery LATERAL per ogni riga guida e l'ottimizzatore non ha un pattern da riconoscere per differenziare le query KNN e ANN. Tale riconoscimento è inoltre fragile: se ci si allontana dalla struttura prevista della query, il percorso rapido (fast path) scompare silenziosamente. BigQuery espone una funzione con valore di tabella: il batch è di prim'ordine, ma i riferimenti alle colonne sono stringhe che il parser non può convalidare.
Strutturalmente, la ricerca vettoriale batch è un'operazione relazionale binaria: due input di tabella, un output che li combina entrambi e un top-k per riga sinistra che li collega. La sintassi codifica tale struttura come una join di classificazione top-k nativa:
La join è asimmetrica, simile a LATERAL: il lato sinistro guida, il lato destro viene cercato. La direzione di classificazione è esplicita: BY SIMILARITY decrescente, BY DISTANCE crescente. LEFT OUTER mantiene le righe di query senza candidati e l'espressione BY è modulare: funziona qualsiasi scalare ordinabile su entrambi i lati, in modo che altre espressioni di punteggio possano riutilizzare la stessa clausola in seguito.
APPROX ed EXACT codificano un contratto semantico. EXACT garantisce il vero top-k tramite una valutazione esaustiva; APPROX consente all'ottimizzatore di sostituire una strategia approssimativa, come un indice ANN, laddove applicabile. Pertanto, la creazione o l'eliminazione di un indice non può mai modificare silenziosamente i risultati della query: solo le query che specificano APPROX acconsentono all'approssimazione.
La riscrittura della query
NEAREST BY viene analizzato in un nodo di join logico, che l'ottimizzatore riduce a operatori relazionali standard: la riscrittura contrassegna ogni riga di query con un ID generato, calcola il punteggio di ogni coppia (query, base), mantiene i k migliori per ID con un top-k raggruppato e reinserisce in linea le righe mantenute:
Semanticamente, questo racchiude l'intera funzionalità: una cross join, un'espressione di punteggio scalare e un aggregato top-k raggruppato. Poiché ogni operatore è un comune operatore relazionale, il piano si distribuisce, esegue lo spill e riprova come qualsiasi altro: la correttezza e la tolleranza ai guasti sono incluse gratuitamente. Ciò che la riscrittura isola realmente sono le due primitive attraverso cui scorre tutto il tempo di esecuzione: la funzione di distanza che calcola il punteggio di una coppia e l'aggregato che mantiene i k migliori di ogni gruppo.
Abbiamo implementato ogni operatore in questo piano in modo nativo in Photon, oltre a un operatore fuso aggiuntivo, creato appositamente per la ricerca vettoriale, che comprime interamente la sezione centrale del piano con un kernel più efficiente e adatto al batch.
I kernel Photon
Le funzioni vettoriali
I blocchi costitutivi fondamentali sono una famiglia di funzioni SQL vettoriali su colonne ARRAY<FLOAT>. Tre di esse sono responsabili del calcolo della somiglianza e della distanza:
| Funzione SQL | Calcola | Più vicino significa |
|---|---|---|
| vector_inner_product(a, b) | 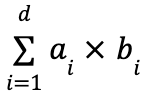 | Maggiore (BY SIMILARITY) |
| vector_cosine_similarity(a, b) | 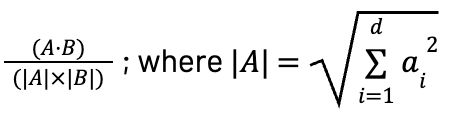 | Maggiore (PER SIMILARITÀ) |
| vector_l2_distance(a, b) | 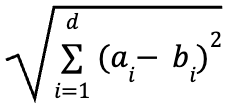 | Minore (PER DISTANZA) |
Insieme alle funzioni di similarità e distanza, abbiamo rilasciato due helper di norma — vector_norm e vector_normalize, e due aggregati, vector_sum e vector_avg. Insieme coprono sia la costruzione della query che quella dell'indice: le funzioni di distanza valutano le query e assegnano le righe al centroide più vicino, mentre gli aggregati e i normalizzatori ricalcolano tali centroidi durante il k-means.
Photon esegue l'intera famiglia come kernel SIMD nativi. Ogni metrica si basa fondamentalmente su operazioni di moltiplicazione e somma (multiply-add), e una singola istruzione FMA (fused multiply-add) calcola 𝑎 · 𝑏 + 𝑐 su un intero registro vettoriale per ogni emissione. I kernel sono implementati sulla base di quattro precise scelte di progettazione.
- Portabile fin dalla costruzione. Gli stessi kernel devono essere eseguiti su ogni cloud (AWS, Azure, GCP) e su ogni architettura CPU (x86, ARM) supportata. Poiché la larghezza SIMD e il set di istruzioni variano tra di esse, ogni kernel viene compilato in diversi cloni specifici per ISA, e quello migliore supportato dalla CPU viene selezionato a runtime (AVX-512 su un core Intel moderno, SVE2 su Graviton).
- Input zero-copy. Un ARRAY<FLOAT> è contiguo all'interno di una riga, quindi ogni vettore viene letto come un puntatore grezzo (raw pointer) nel buffer di supporto della colonna, senza copie e senza indicizzazione per elemento all'interno del hot loop.
- Semantica float rilassata. L'abbandono del rigido ordinamento IEEE consente al compilatore di fondere le moltiplicazioni-addizioni in istruzioni FMA e di suddividere la riduzione in catene di accumulatori parallele, in modo che il loop non sia serializzato su una singola somma parziale.
- Nessun elemento scalare nel loop. I hot loop sono pure riduzioni vettorizzate di moltiplicazione e somma; le operazioni scalari come sqrt e la divisione vengono eseguite una sola volta, all'esterno del loop.
L'aggregato top-k
Nel normale SQL, il top-k raggruppato è una funzione finestra: ROW_NUMBER() OVER (PARTITION BY query ORDER BY score). Questa ordina completamente ogni partizione, per poi scartare tutto tranne i primi k ranghi. Abbiamo invece esteso gli aggregati max_by / min_by esistenti con un sovraccarico (overload) del terzo parametro K. L'implementazione si basa su quattro proprietà chiave.
- Selezione a confronto singolo. Lo stato di aggregazione per gruppo è un heap limitato la cui radice rappresenta il candidato all'eliminazione e la soglia di ammissione. Una volta pieno, ogni candidato viene accettato o rifiutato con un singolo confronto. Nessun ordinamento viene mai eseguito sul flusso dei candidati.
- Stato O(k). La memoria per gruppo è indipendente dalle dimensioni dell'input. Una query valutata rispetto a un miliardo di righe comporta solo k righe di stato, e k può arrivare fino a 100.000.
- Materializzazione tardiva. L'heap memorizza gli indici, non copie completamente materializzate. Un candidato rimane un puntatore all'interno del batch colonnare attivo e viene copiato nello stato aggregato solo se sopravvive ancora quando il batch viene riciclato.
- Distribuibile. Gli aggregati hanno un contratto partial/merge. Ogni partizione emette il proprio top-k locale, lo shuffle sposta questi array di k elementi invece di coppie grezze, e il merge li reinserisce. Il risultato è esatto perché il top-k globale è sempre un sottoinsieme dell'unione dei parziali.
Il modello roofline
Con tutti i kernel nativi sopra descritti, il piano di query è completamente Photonizzato, ma è ancora lontano dall'essere ottimale su scala batch. Il motivo è teorico, non legato all'implementazione, e il modello roofline è un modo semplice ed efficace per visualizzarlo.
𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 = 𝑚𝑖𝑛(𝑃𝑝𝑒𝑎𝑘, 𝐴𝐼 × 𝐵𝑊)
𝑃𝑝𝑒𝑎𝑘 è la capacità di calcolo di picco (compute throughput) dell'hardware (FLOP/s), BW è la larghezza di banda della memoria (byte/s) e 𝐴𝐼 è l'intensità aritmetica del kernel (FLOP eseguiti per byte spostato). Tracciando 𝑃𝑎𝑡𝑡𝑎𝑖𝑛𝑎𝑏𝑙𝑒 in funzione di 𝐴𝐼 si ottiene la roofline: un limite di memoria diagonale (memory roof) che incontra un limite di calcolo orizzontale (compute roof) nel punto di flesso (ridge point), ovvero l'𝐴𝐼 minima alla quale un kernel può essere limitato dal calcolo (compute-bound). A sinistra del punto di flesso, l'unico modo per migliorare è spostare meno byte per FLOP; a destra, il kernel è limitato dal calcolo (compute-bound) e il limite è rappresentato dalle unità aritmetiche stesse. In concreto, su una macchina di riferimento m6i.2xlarge (a scopo illustrativo, le costanti variano a seconda dell'hardware):
| Per core | |
|---|---|
| Limite della capacità di calcolo | 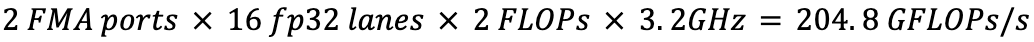 |
| Limite della larghezza di banda DRAM | 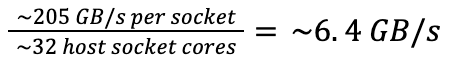 |
| Punto di flesso | 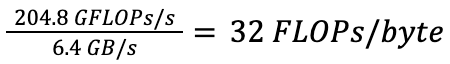 |
*I limiti delle cache L1/L2 si collocano a un livello 30-60 volte superiore rispetto alla quota equa (fair share) della DRAM, ma la tabella di base è molto più grande di qualsiasi cache, quindi ogni byte di base attraversa il limite della DRAM almeno una volta.
*Il limite della capacità di calcolo scala linearmente con i core. Un cluster di 64 esecutori m6i.2xlarge (4 core fisici ciascuno) raggiunge un picco di 64 x 4 x 204,8 GFLOP/s ≈ 52,5 TFLOP/s di FMA fp32.
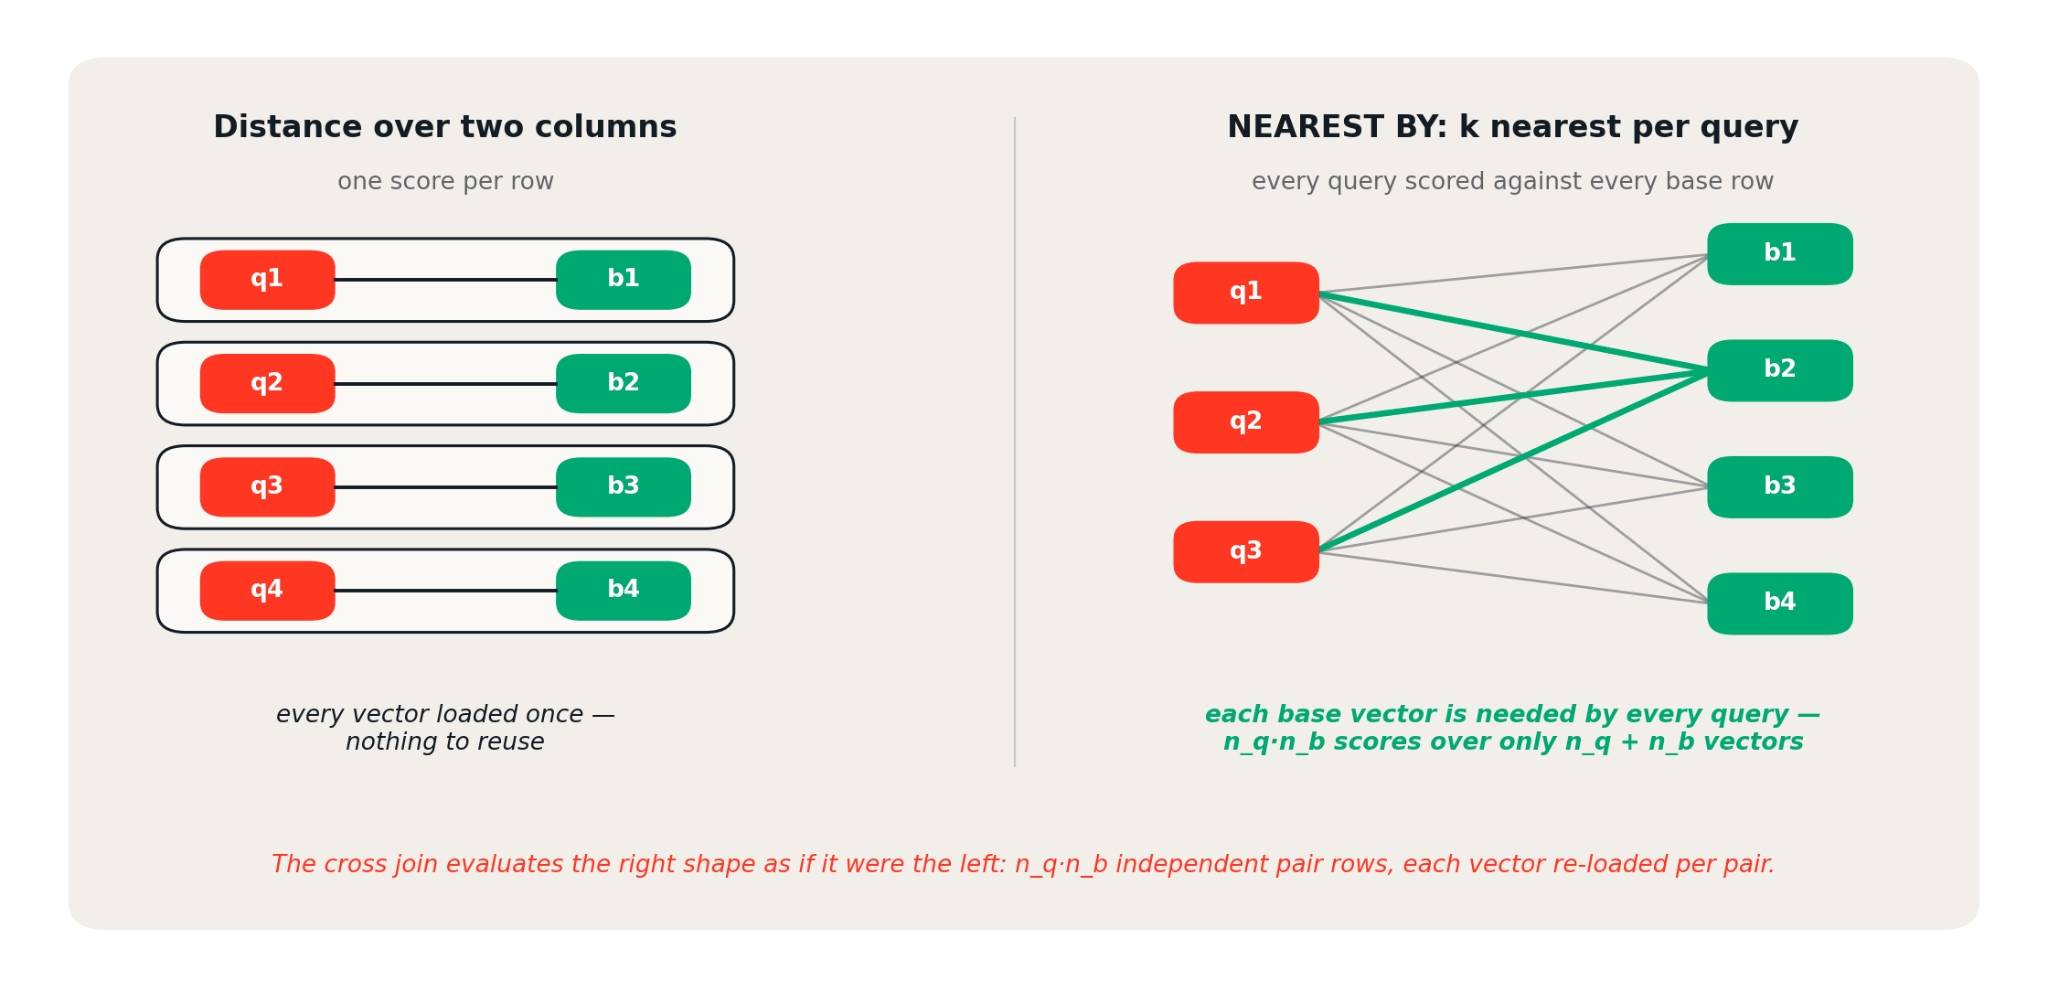
La valutazione di due colonne allineate produce un punteggio per riga: ogni vettore viene utilizzato una sola volta e non esiste alcun riutilizzo. La forma NEAREST BY produce 𝑛𝑞 × 𝑛𝑏 punteggi a partire da soli 𝑛𝑞 + 𝑛𝑏 vettori distinti, poiché ogni vettore di base è richiesto da ogni query.
Ora confrontiamo i dati spostati dalla ricerca vettoriale con un piano ingenuo (naive plan) rispetto a uno consapevole del riutilizzo (reuse-aware). I FLOP sono identici in entrambi i casi: 2 × 𝑑 × 𝑛𝑞 × 𝑛𝑏, dove 𝑛𝑞 e 𝑛𝑏 rappresentano la cardinalità lato query e lato base, e 𝑑 rappresenta la dimensione dell'embedding.
| Piano | Byte spostati | Intensità aritmetica (AI) | Scalabilità |
|---|---|---|---|
| Cross join a coppie (pairwise cross join) — ogni operando viene caricato ex novo e utilizzato una sola volta | 2 × 4 × 𝑑 × 𝑛𝑞 × 𝑛𝑏 | 1/4 | 0(1) |
| GEMM fuso — buffer, streaming singolo | 4 × 𝑑 × 𝑛𝑏 | 𝑛𝑞/2 | 0(𝑛𝑞) |
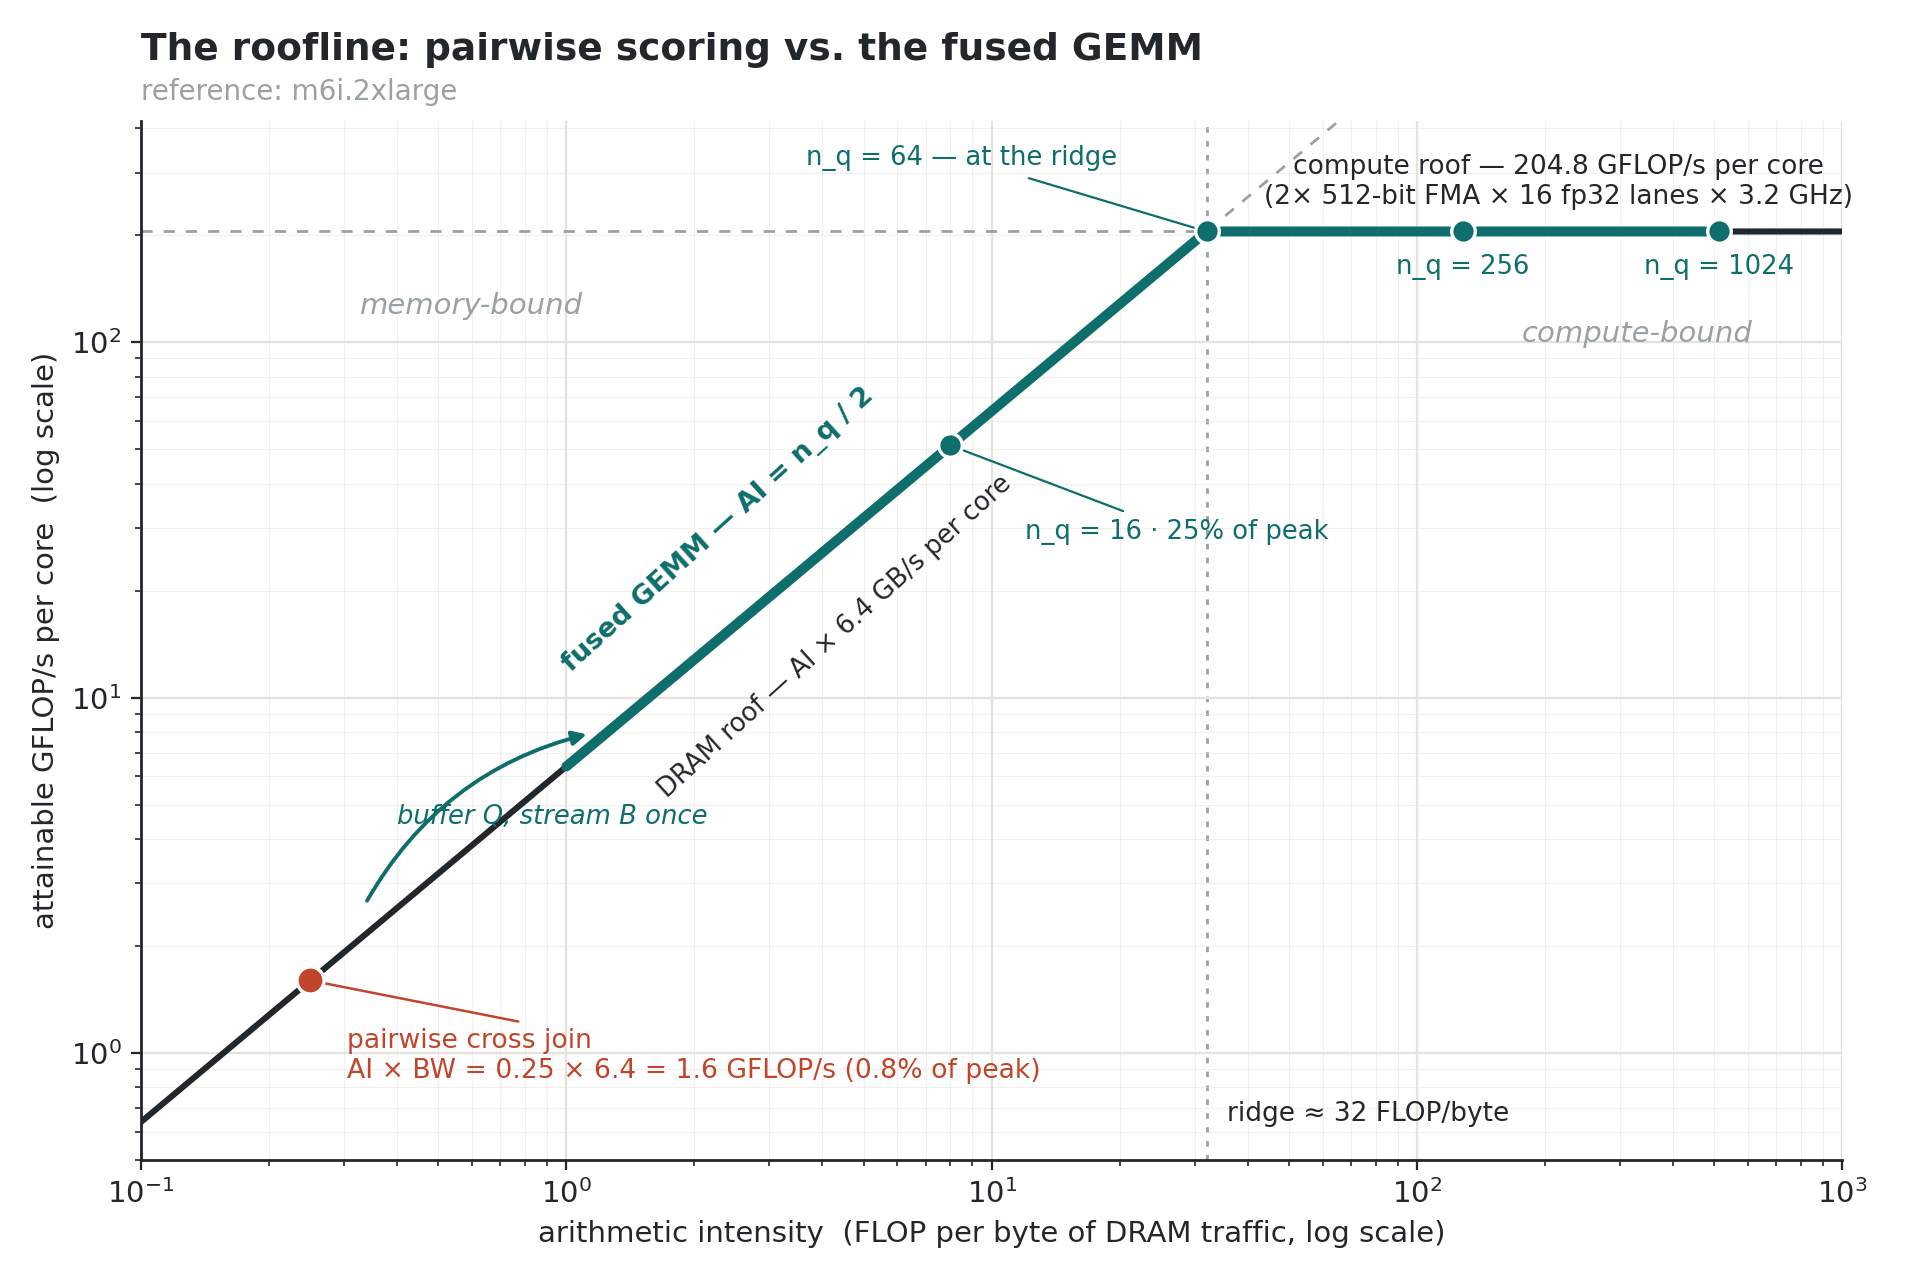
La valutazione a coppie (pairwise scoring) è bloccata sulla pendenza della DRAM allo 0,8% del picco, mentre l'intensità aritmetica del kernel GEMM fuso cresce con la dimensione del batch: 𝐴𝐼 = 𝑛𝑞/2 — consentendogli di superare il punto di flesso a 𝑛𝑞 = 64 e di seguire il limite di calcolo (compute roof) con batch più grandi. I kernel di distanza vettoriale e similarità sono quasi ottimali per la loro forma di input, ma la forma del piano ingenuo (naive plan) non presenta alcun riutilizzo dei dati da sfruttare, e l'elaborazione a lotti (batching) non può essere d'aiuto: l'esplosione delle coppie moltiplica FLOP e byte in egual misura. La soluzione è un piano con operatore fuso, che consente al kernel di sfruttare il riutilizzo dei dati, con conseguente aumento dell'intensità aritmetica.
L'operatore fuso e il kernel GEMM
L'operatore fuso è un singolo nodo di esecuzione Photon che sostituisce il cross join, la proiezione di distanza/similarità e, opzionalmente, il top-k parziale. Memorizza nel buffer l'input più piccolo, trasmette l'altro in streaming in batch, calcola i punteggi delle tile query-by-base con un kernel GEMM personalizzato e mantiene lo stato top-k per query tra le tile quando k è sufficientemente piccolo. Con il top-k fuso, il suo output è al massimo di 𝑛𝑞 × 𝑘 righe candidate anziché 𝑛𝑞 × 𝑛𝑏 coppie, consumate dal kernel di merge downstream max_by / min_by. La memoria di picco per task è data dal lato memorizzato nel buffer + un batch in transito + lo stato di selezione 0(𝑛𝑞 × 𝑘). La distribuzione segue le strategie di join standard: trasmette in broadcast il lato più piccolo quando è possibile inserirlo in memoria, altrimenti partiziona entrambi i lati ed esegue un block-cartesian.
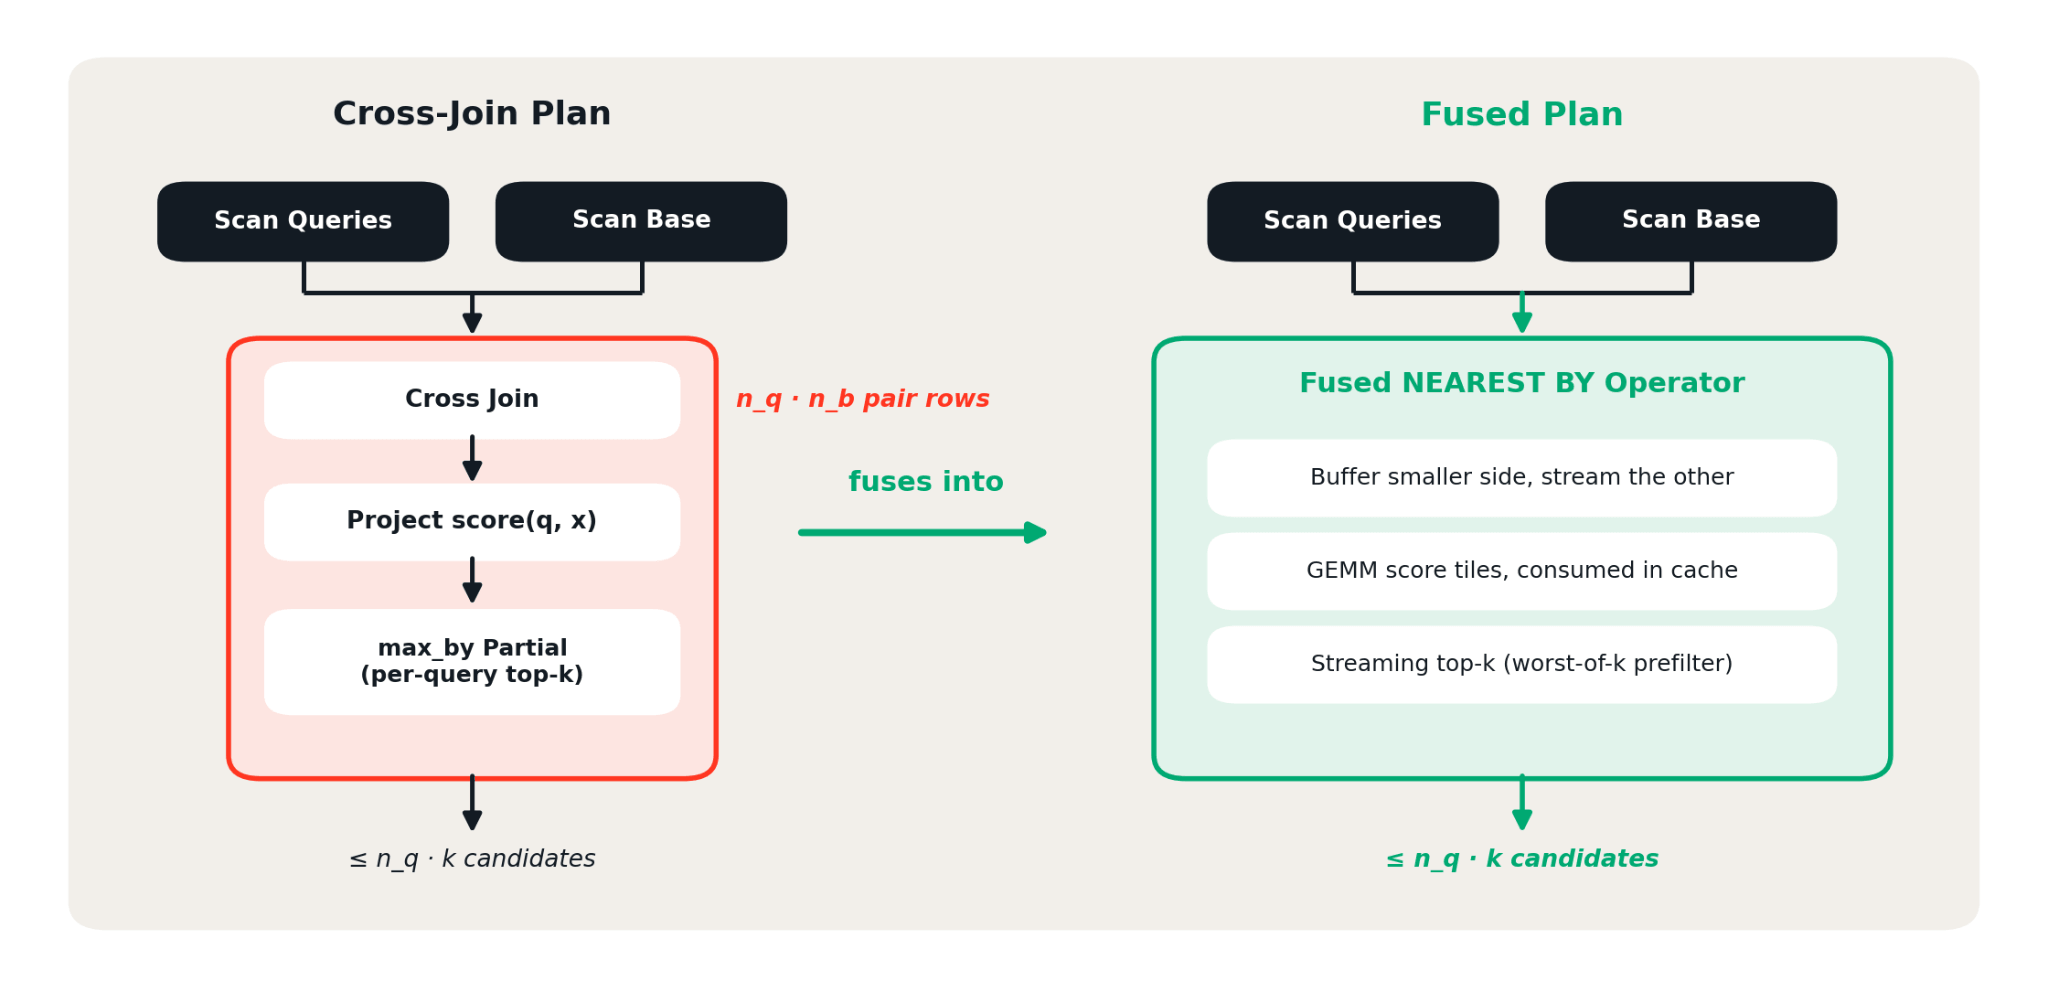
Come mostrato nel modello roofline, la fusione modifica i byte che spostiamo in memoria, non i FLOPs che eseguiamo. Ogni vettore di base viene valutato rispetto a tutte le query memorizzate nel buffer una volta caricato, quindi l'intensità aritmetica cresce linearmente con il batch e supera il punto di cresta (ridge point) di riferimento a 𝑛𝑞 = 64 — ben al di sotto delle dimensioni dei batch dei tipici carichi di lavoro di produzione. Lo stesso vale quando il lato di base è più piccolo: l'intensità aritmetica scala con il lato che rimane residente.
Superare la cresta è necessario, ma non sufficiente. Il conteggio dei byte pari a 𝑛𝑞/2 è il risultato diretto del kernel GEMM a blocchi descritto di seguito. Superare il limite della DRAM sposta solo il collo di bottiglia più in basso, verso la larghezza di banda della cache e poi la latenza FMA.
Concretely, il kernel è un classico GEMM a blocchi sulla matrice dei punteggi 𝐷 = 𝑄 · 𝐵𝑇. Il ciclo esterno avanza sulla base un pannello di vettori alla volta e impacchetta ciascun pannello in modalità dimension-major per il riutilizzo tra le tile di query. Poiché la dimensione dell'embedding è essa stessa suddivisa in pannelli, il ciclo intermedio scorre ogni tile di query memorizzata nel buffer rispetto al pannello impacchettato prima che venga recuperato quello successivo. Il ciclo più interno accumula una piccola tile di output nei registri attraverso un pannello di dimensioni; per gli embedding più ampi di un singolo pannello, i parziali correnti vengono parcheggiati nel buffer dei punteggi e letti nuovamente per continuare con il pannello successivo. Ogni tile completata viene scritta in un buffer dei punteggi limitato e riciclato che il top-k in streaming consuma sul posto, in modo che l'intera matrice dei punteggi 𝑛𝑞 × 𝑛𝑏 non venga mai scritta nella DRAM.
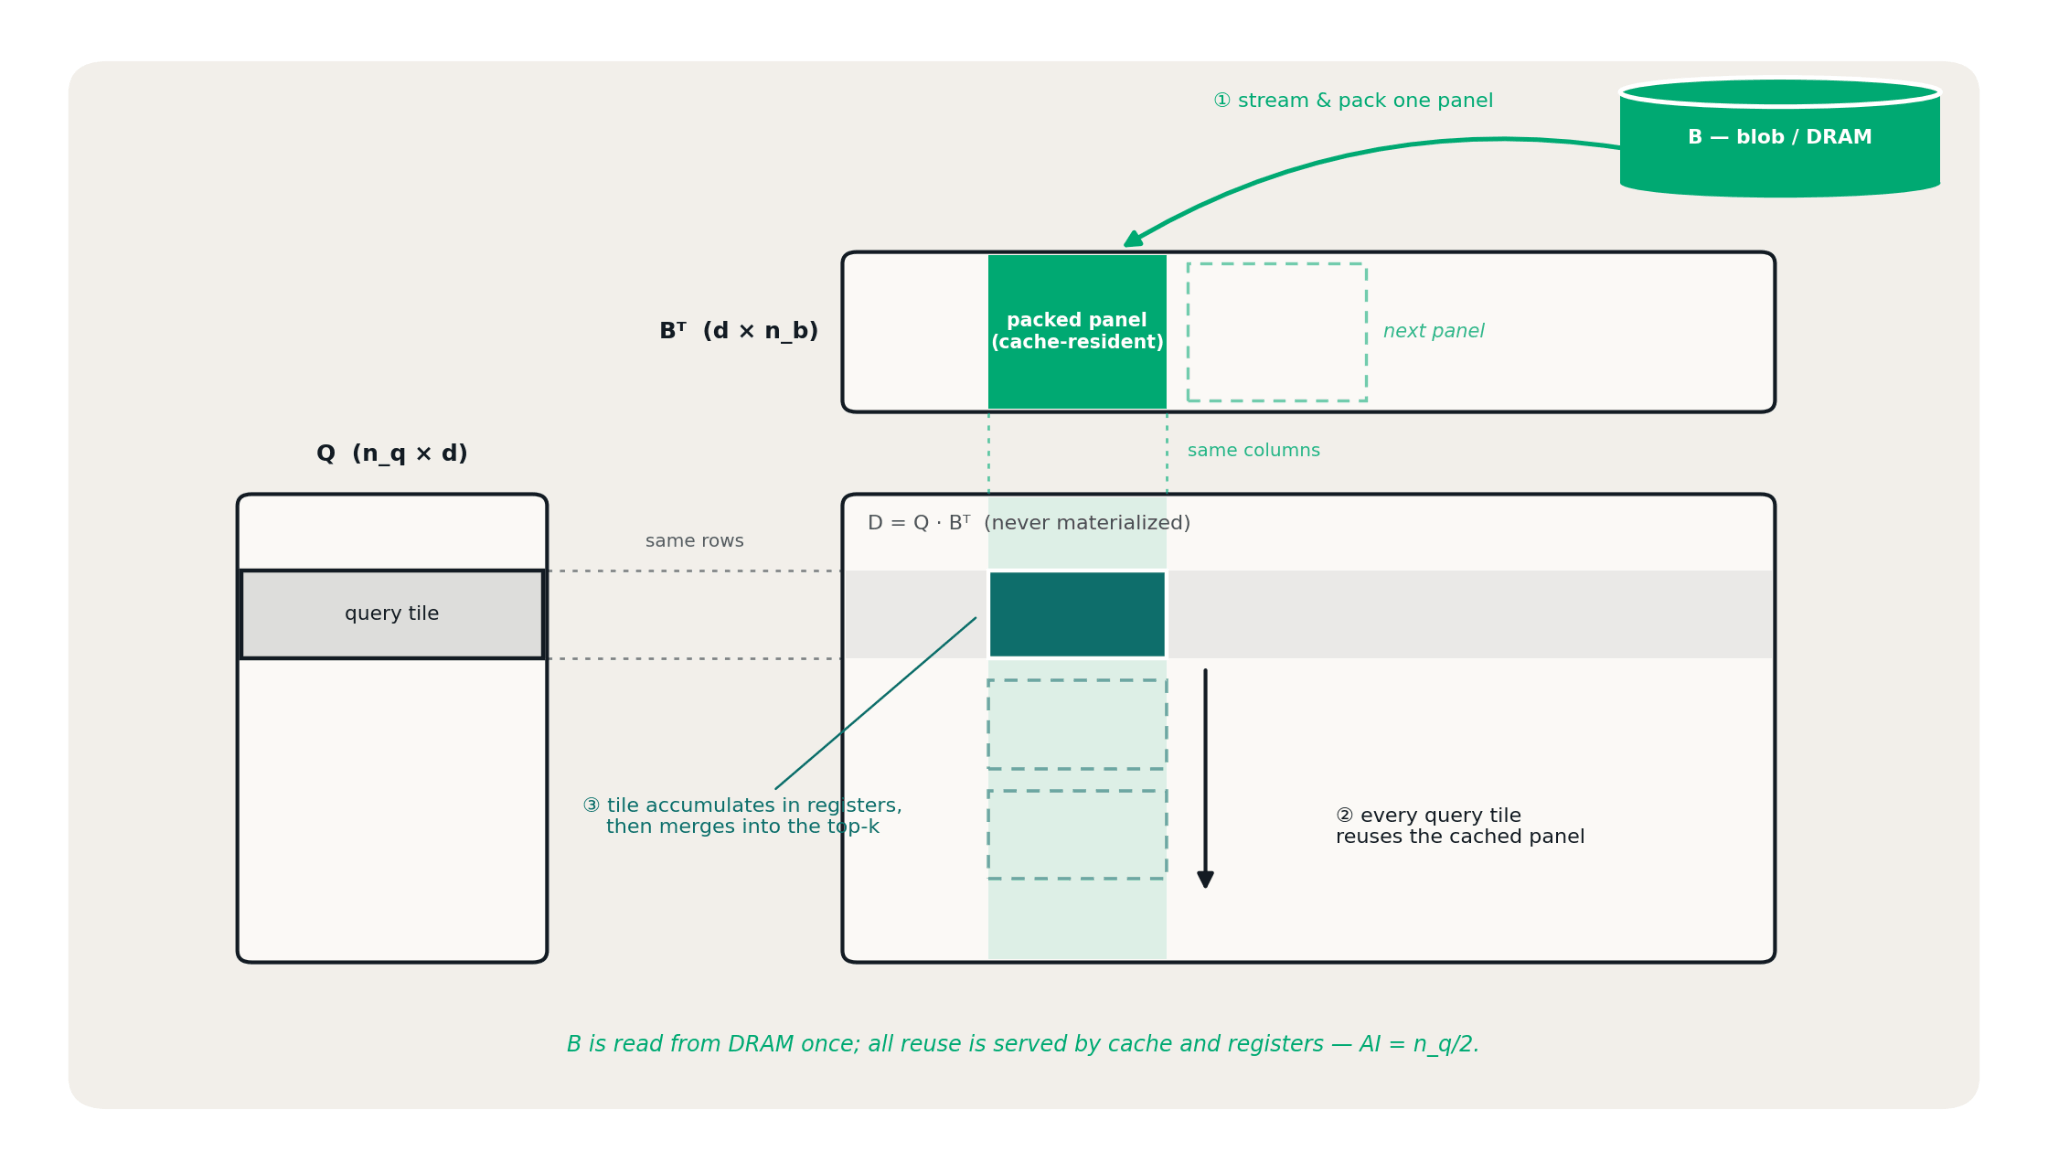
Esistono due livelli di blocking per migliorare il riutilizzo dei dati. I pannelli di base impacchettati vengono riutilizzati tra le tile di query per favorire gli hit della cache della CPU, mentre il blocking dei registri consente a ciascun valore caricato di contribuire a più FMA. Ciascuna dimensione della tile bilancia due considerazioni contrastanti:
- Dimensioni del pannello impacchettato (packed-panel): il pannello dovrebbe essere sufficientemente piccolo da entrare comodamente nella cache, ma abbastanza grande da limitare l'overhead di salvataggio e ricaricamento dei risultati parziali. Ogni limite lungo la dimensione dell'embedding richiede un viaggio di andata e ritorno (round-trip) attraverso il buffer dei punteggi. Pannelli più grandi riducono tale traffico, ma possono aumentare i cache miss.
- Dimensioni della tile di registro (register-tile): gli accumulatori e gli operandi dovrebbero rientrare nei registri vettoriali disponibili, fornendo al contempo un numero sufficiente di accumuli indipendenti per sovrapporsi alla latenza FMA. Tile più grandi aumentano il riutilizzo dei dati ed espongono un lavoro più indipendente, ma aumentano anche la pressione sui registri e il rischio di spilling in memoria.
La maggior parte dei carichi di lavoro di produzione viene eseguita con un valore k relativamente piccolo, quindi abbiamo ottimizzato il top-k in streaming per questo caso. Lo stato di selezione per query rimane all'interno dell'operatore fuso, ogni tile di punteggio si fonde (merge) nelle selezioni mentre si trova ancora nella cache e l'intera matrice 𝑛𝑞 × 𝑛𝑏 non raggiunge mai la DRAM. Una volta che una query contiene k voci, il suo punteggio peggiore diventa la soglia di ammissione, consentendo al merge di rifiutare più punteggi per ogni confronto vettorializzato. Solo le righe superstiti vengono raccolte per l'output. Quando k è sufficientemente grande da far sì che questo stato generi pressione sulla memoria, l'operatore esegue solo il GEMM a blocchi e passa le tile con i punteggi al parziale max_by / min_by esistente. Con questo fallback, l'emissione di un punteggio 𝑓𝑝32 per coppia costa 4 𝑏𝑦𝑡𝑒𝑠 a fronte di 2𝑑 𝐹𝐿𝑂𝑃𝑠, quindi 𝐴𝐼 = 𝑑/2 — ancora ben oltre la cresta per qualsiasi dimensione realistica.
L'indice vettoriale
Tutto ciò che è stato descritto finora accelera la ricerca KNN (k-nearest-neighbor) esaustiva; nulla di tutto questo cambia il fatto che la ricerca esaustiva sia 0(𝑛𝑞 × 𝑛𝑏) — un milione di query contro un miliardo di righe equivale a 1015 prodotti scalari, e nessuna tile di registro può ammortizzare un esponente. È proprio a questo che servono APPROX e l'indice vettoriale.
L'indice ha un classico design IVF (inverted file). L'indicizzazione addestra k-means su un campione del corpus per produrre un insieme di centroidi. Ogni riga di base viene assegnata al centroide più vicino e, al momento della query, ciascuna query valuta solo i vettori nei cluster più vicini. Il pruning si combina con 𝑛𝑏: su scala di miliardi, una query esamina ≤ 0,1% del corpus, con ordini di grandezza di lavoro di calcolo della distanza inferiori rispetto al brute force. Abbiamo scelto IVF rispetto agli indici a grafo perché le scansioni indipendenti dei cluster si parallelizzano tra gli executor e il layout è naturalmente in uno storage colonnare, mentre l'attraversamento del grafo è una catena di ricerche seriali.
Fisicamente, l'indice è una normale tabella Delta. Le righe di assegnazione contengono il vettore accanto al suo ID centroide e la tabella è sottoposta a liquid-clustering per ID centroide. I candidati di ciascun cluster si trovano in modo contiguo sullo storage BLOB e i file i cui cluster non hanno query esaminate vengono eliminati (pruned) prima di essere letti. L'aggiornamento è transazionale e incrementale.
Una query APPROX viene riscritta sulle stesse primitive: esamina i centroidi con lo stesso join top-k NEAREST BY, esegue un equi-join sull'ID centroide per limitare ogni query ai cluster esaminati, calcola il punteggio e il top-k, quindi esegue il merge. I file aggiunti dall'ultimo aggiornamento vengono elaborati tramite brute force in un ramo di compensazione e uniti nello stesso merge, in modo che un indice obsoleto esegua meno pruning, ma senza mai degradare la qualità della ricerca.
L'esecuzione della query è determinata dalle cardinalità della query e della base.
| Scenario | Strategia di join | Caratteristiche chiave |
|---|---|---|
| Tabella dell'indice piccola, tabella delle query piccola | BNLJ, broadcast dell'indice | Tutto in memoria |
| Tabella dell'indice piccola, tabella delle query grande | BNLJ, broadcast dell'indice | Le query rimangono partizionate e vengono trasmesse in streaming, broadcast dell'indice a tutti |
| Tabella dell'indice grande, tabella delle query piccola | BNLJ, broadcast delle query | Le partizioni dell'indice vengono trasmesse in streaming, broadcast delle query esaminate |
| Tabella dell'indice grande, tabella delle query grande | Equi-join per ID centroide, con shuffle in-place per l'indice | Esegue lo shuffle delle query esaminate per ID centroide; sfrutta il liquid clustering dell'indice per evitare uno shuffle completo dell'indice |
Il caso grande-grande è quello in cui il liquid clustering offre i maggiori vantaggi: si sposta solo il lato della query; ogni query esaminata viene sottoposta a shuffle verso le partizioni dei suoi cluster, mentre il lato dell'indice scansiona direttamente i file per trovare gli ID centroide corrispondenti. Ciascuna partizione esamina esattamente i candidati dei propri cluster.
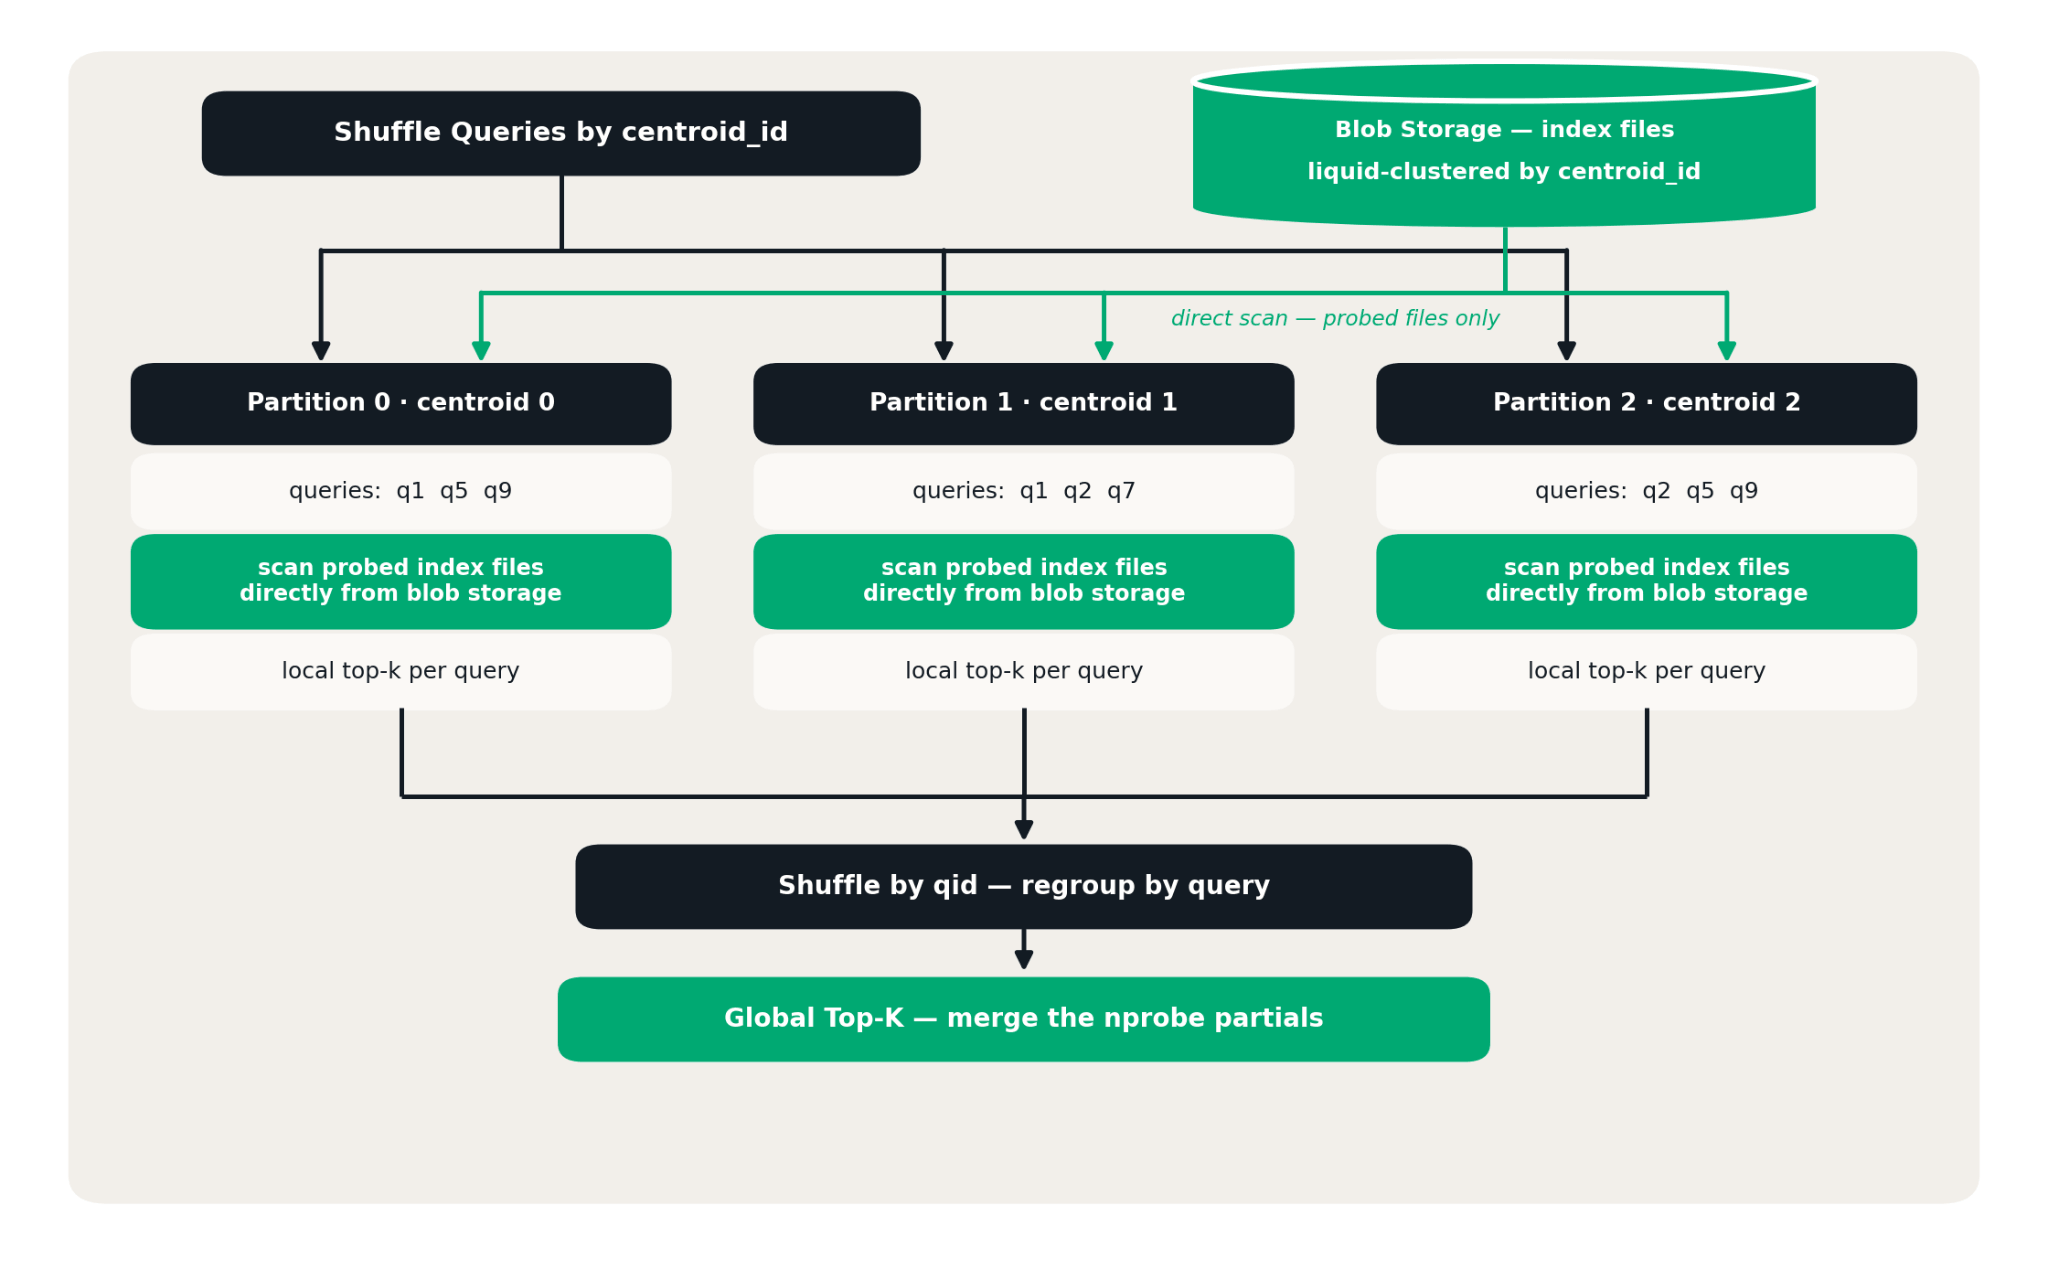
All'interno di una partizione, i candidati di ciascun cluster arrivano come un blocco contiguo denso, quindi si applica lo stesso kernel GEMM. Il percorso esatto lo esegue una volta a livello globale; il percorso approssimativo lo esegue una volta per cluster. Top-k locale per query, raggruppamento, merge dei parziali: il contratto partial/merge dell'aggregato fa esattamente ciò per cui è stato progettato.
Il risultato
Abbiamo valutato NEAREST BY su carichi di lavoro canonici osservati presso i clienti, con tabelle di base che variano da 100.000 a 5 miliardi di vettori e batch di query fino a 10 milioni di vettori, puntando a un recall@K di almeno il 96%. Utilizzando l'ANN indicizzato:
- Deduplica semantica: un self-join di una tabella da 10 milioni di record è stato completato in pochi minuti, recuperando le corrispondenze candidate per il rilevamento dei duplicati.
- Classificazione e tagging: la ricerca di 10 milioni di query rispetto a 100.000 vettori di riferimento ha richiesto meno di un minuto, supportando la classificazione tramite esempi etichettati simili.
- Aggiornamenti dei consigli: un batch di 1 milione di query rispetto a 10 milioni di vettori di catalogo ha generato candidati di raccomandazione in pochi minuti.
- Risoluzione ed arricchimento delle entità: la ricerca di 1 milione di query rispetto a 1 miliardo di vettori di riferimento è stata completata in pochi minuti, fornendo corrispondenze candidate per il collegamento dei record e il recupero di contesto aggiuntivo.
Conclusioni
La ricerca vettoriale batch non aveva bisogno di un nuovo sistema: doveva diventare un elemento di prima classe di quello che già contiene i dati. NEAREST BY esprime il carico di lavoro per quello che è strutturalmente: un join di classificazione top-k. Il modello roofline spiega perché il piano naive è limitato dalla memoria e cosa deve fare al riguardo un kernel più veloce. L'operatore fused e il suo GEMM a blocchi trasformano quell'analisi in intensità aritmetica, e l'indice vettoriale la scala ulteriormente pur rimanendo una normale Delta table con liquid clustering. I nuovi meccanismi sono deliberatamente progettati per essere semplici, mirati, ma profondi ed efficaci: una clausola di join, sette funzioni vettoriali, un overload di aggregazione, un operatore fused e una decisione sul layout di archiviazione. Tutto il resto, dagli shuffle e spill alla governance e all'autoscaling, è integrato nel motore di runtime, sviluppato e consolidato in oltre un decennio.
Se ti interessa sviluppare sistemi informatici complessi per carichi di lavoro AI/ML su larga scala in Databricks, vieni a lavorare con noi!
Scarica ora Prova NEAREST BY — leggi la documentazione
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.