PostgreSQL 19 è disponibile su Lakebase
Prova le nuove funzionalità: REPACK, consigli sui piani di query, WAIT FOR LSN e altro ancora
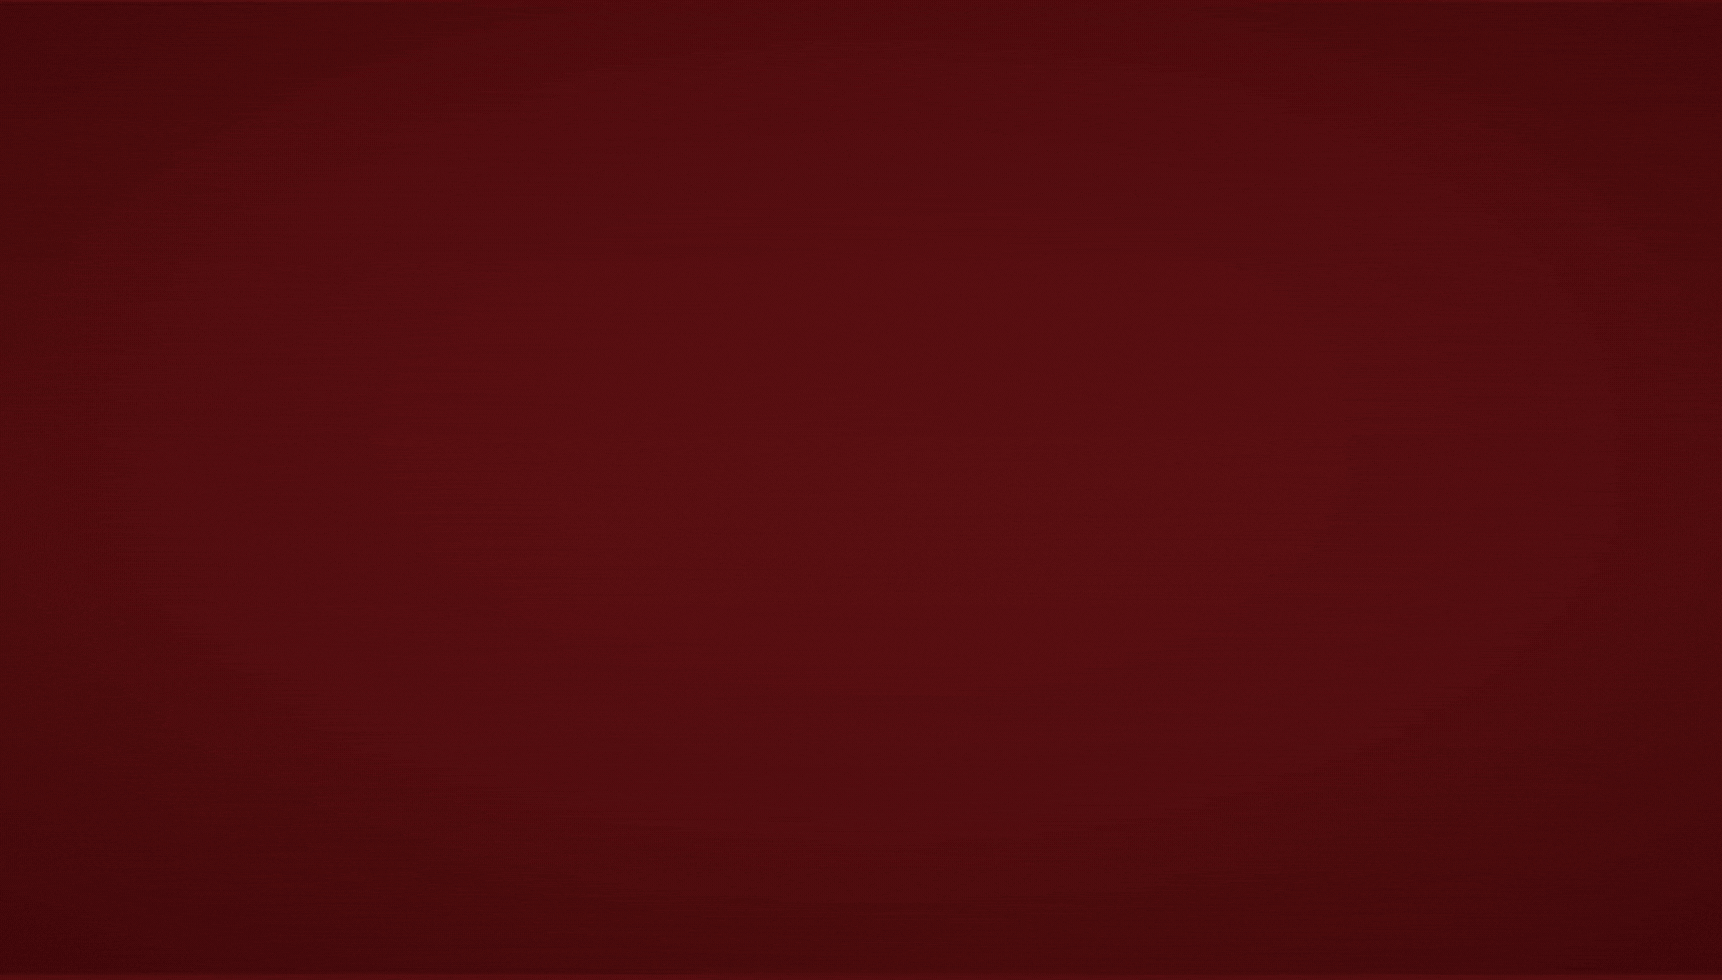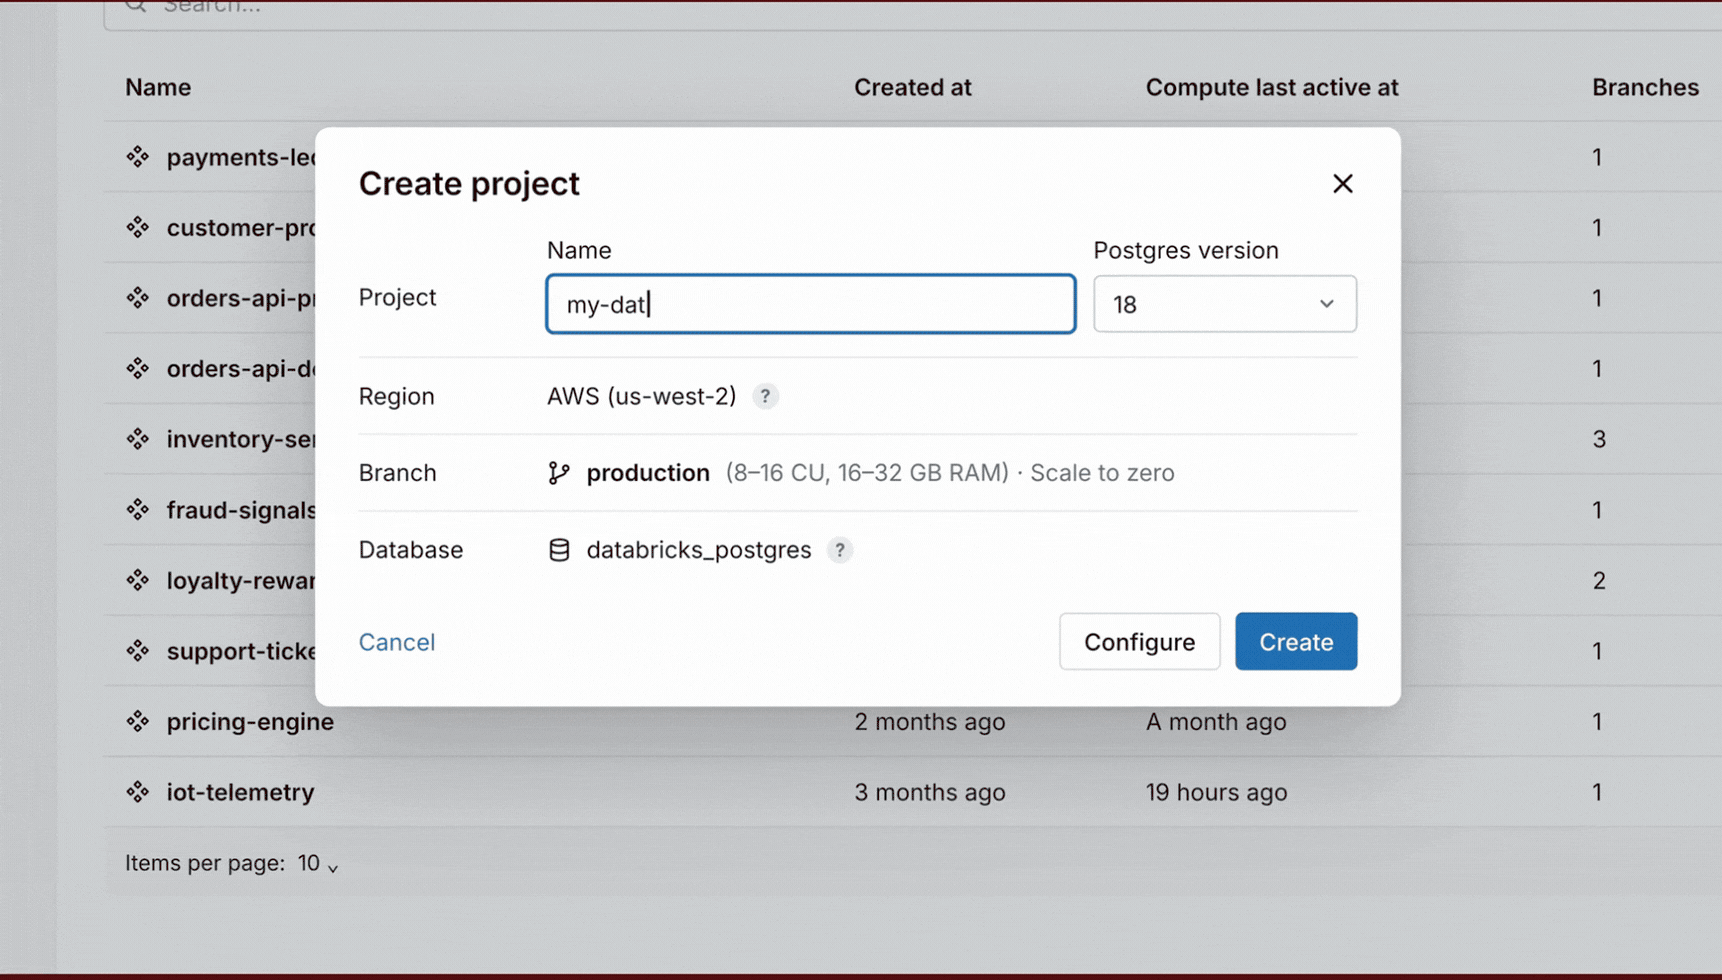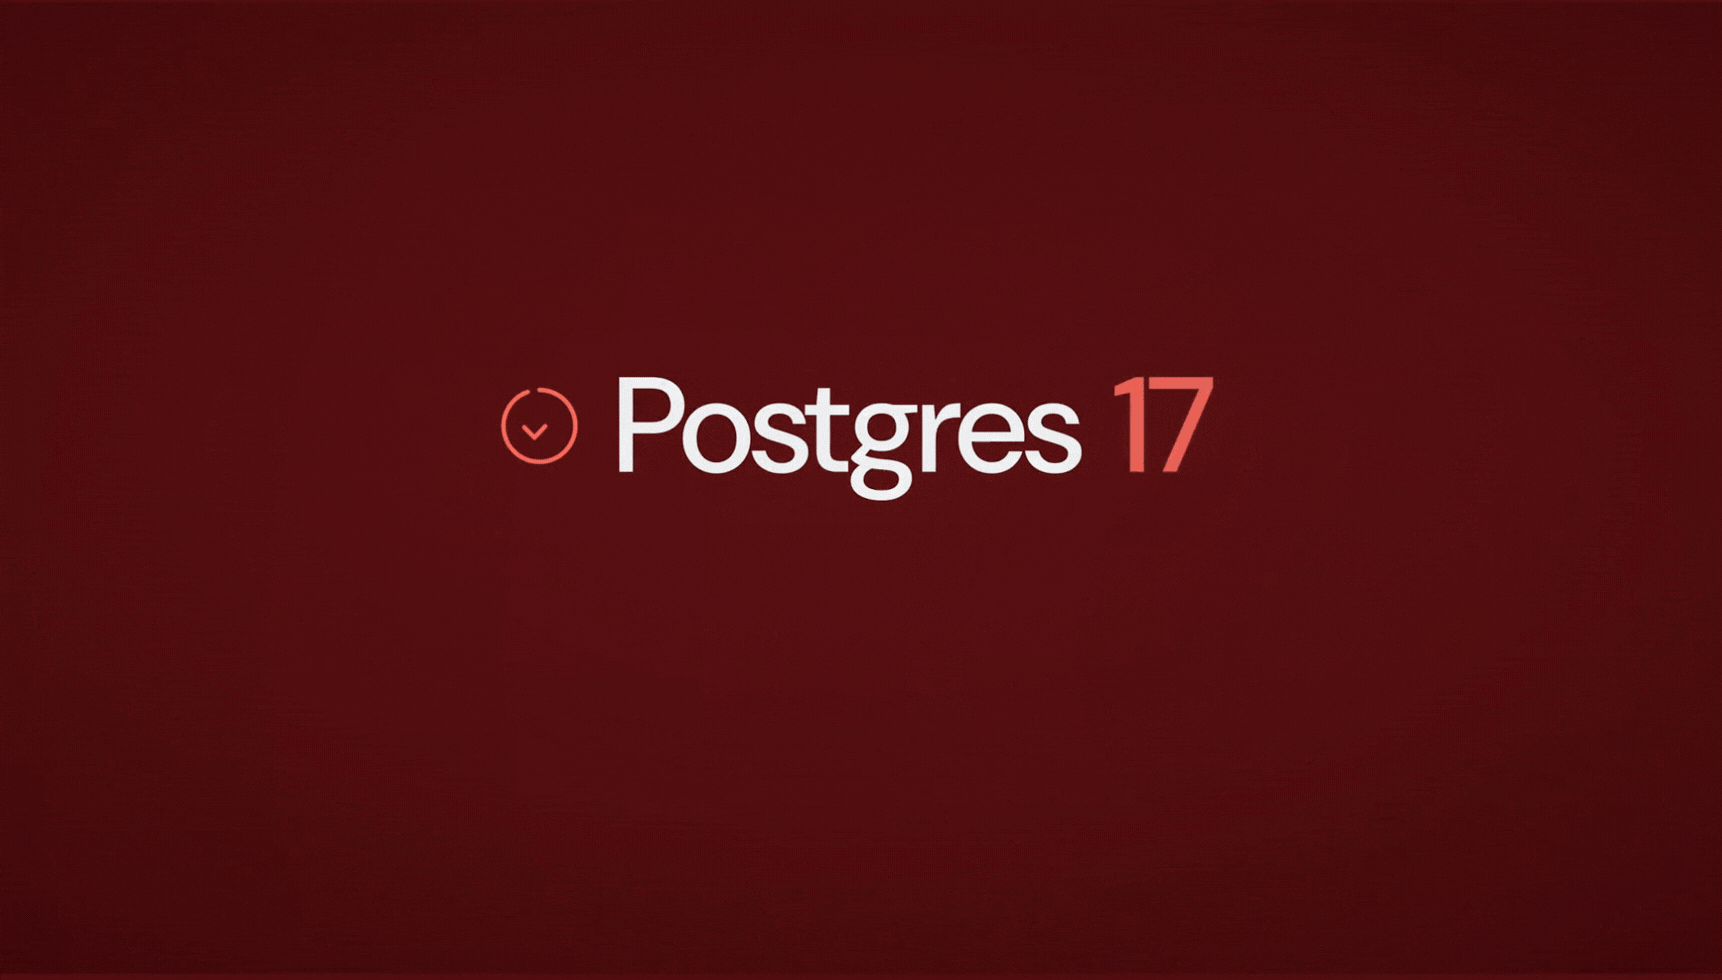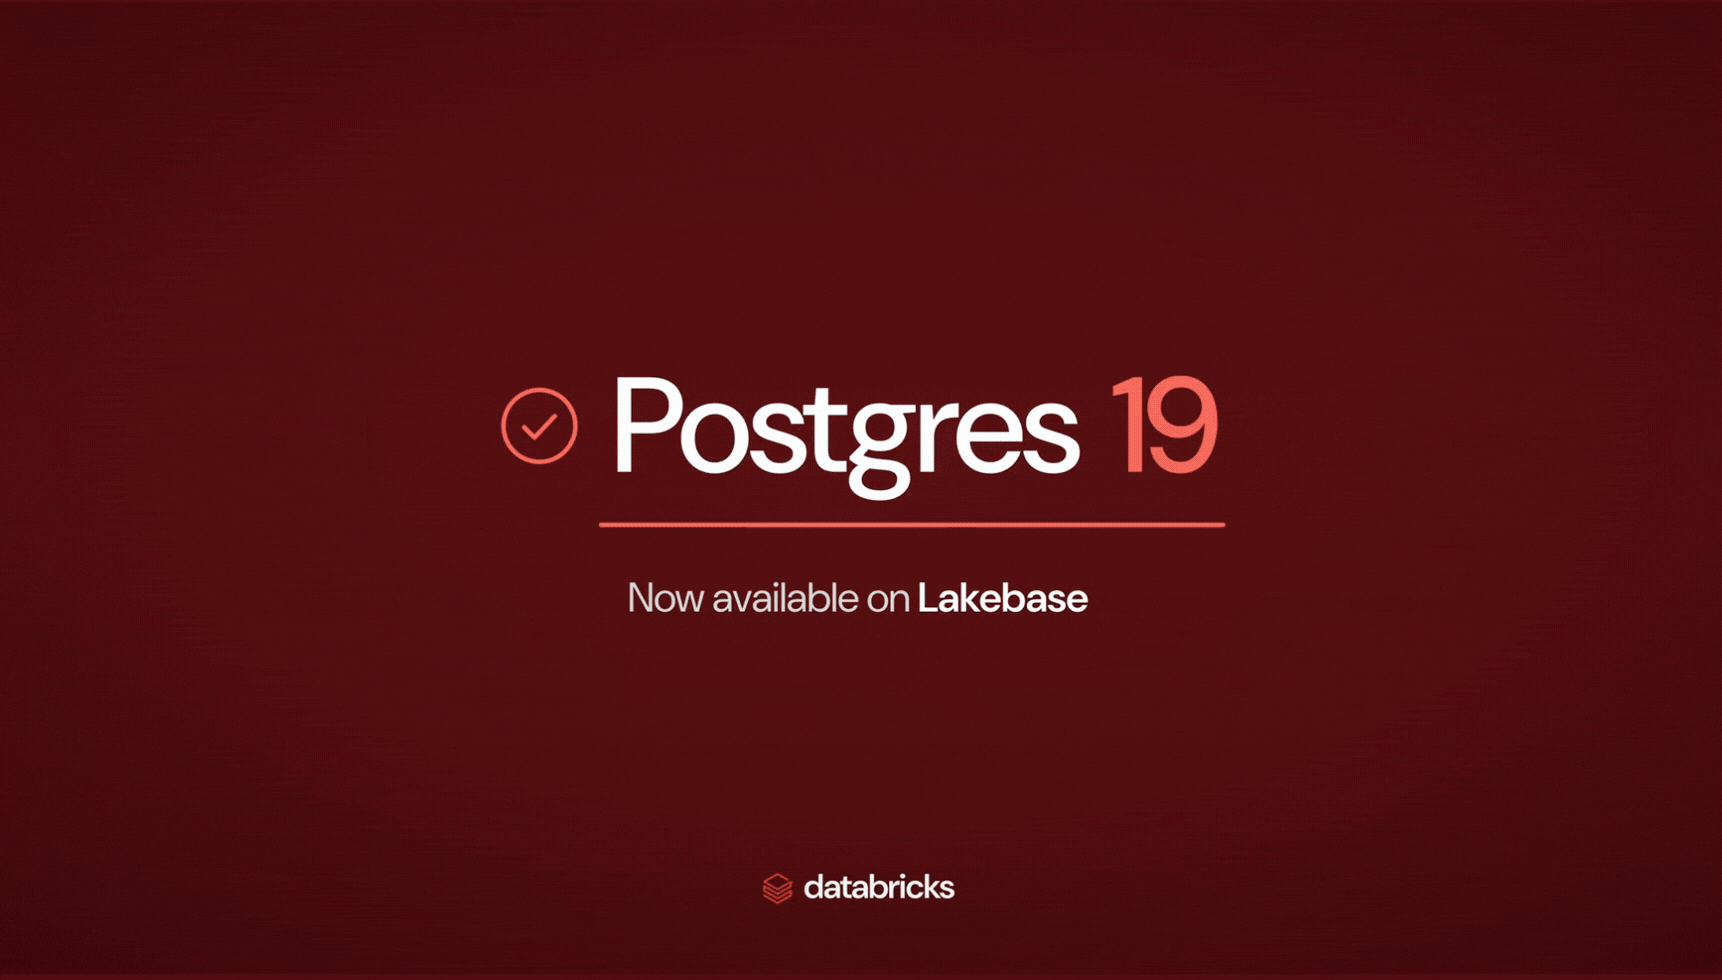
- PostgreSQL 19 è disponibile su Lakebase lo stesso giorno del rilascio da parte della community. Per provarlo, crea un nuovo progetto Lakebase e seleziona PostgreSQL 19.
- Questa release di PostgreSQL si concentra sul controllo operativo. REPACK recupera spazio mentre le letture e le scritture continuano, i consigli sui piani di query consentono di stabilizzare i piani che presentano problemi e WAIT FOR LSN offre la lettura delle proprie scritture sulle repliche. Anche la replica logica riceve diversi aggiornamenti.
- Diversi ingegneri di Lakebase sono committer e contributori di PostgreSQL che hanno lavorato a questa release, dai consigli sui piani di query alla memoria condivisa e alla gestione delle release.
PostgreSQL 19 è ora disponibile in GA su Lakebase. Le nuove versioni principali spesso impiegano settimane per arrivare su altri servizi gestiti PostgreSQL. Invece, abbiamo voluto offrirne l'accesso ai nostri clienti lo stesso giorno.
Diversi ingegneri del team Lakebase sono committer e contributori di PostgreSQL e hanno lavorato direttamente a questa release, dai consigli sui piani di query alla memoria condivisa, alla gestione delle impostazioni internazionali e alla gestione delle release. Per provarlo, crea un nuovo progetto Lakebase e seleziona PostgreSQL 19 come versione.
Cosa c'è di nuovo in PostgreSQL 19
PostgreSQL 19 è una release pratica. Non c'è un'unica funzionalità di spicco che stravolge l'identità di PostgreSQL. Piuttosto, la versione 19 affronta i problemi operativi che i team di database conoscono bene: tabelle gonfie, piani di query instabili, ritardi di replica, statistiche incomplete e operazioni di manutenzione difficili da eseguire in sicurezza in produzione.
Il filo conduttore è il controllo. PostgreSQL 19 offre più modi per intervenire quando i valori predefiniti non sono sufficienti, senza rinunciare all'attenzione del progetto per l'affidabilità e la prevedibilità del comportamento.
L'elenco completo delle modifiche è disponibile nelle note di rilascio di PostgreSQL 19.
REPACK
PostgreSQL utilizza il controllo della concorrenza multiversione, quindi un UPDATE crea una nuova versione di riga e un DELETE lascia una tupla morta. La pulizia di routine rende quello spazio riutilizzabile, ma non restituisce necessariamente lo spazio al sistema operativo né ripristina un utile ordinamento fisico delle righe. Nel tempo, le tabelle soggette a molti aggiornamenti possono diventare gonfie e poco raggruppate.
Le soluzioni tradizionali sono state VACUUM FULL, CLUSTER o strumenti esterni come pg_repack. I comandi integrati funzionano, ma richiedono un blocco ACCESS EXCLUSIVE per l'intera operazione, bloccando il normale accesso alla tabella.
PostgreSQL 19 introduce REPACK, che recupera spazio mentre le normali letture e scritture continuano durante la maggior parte dell'operazione. Ad esempio, un'applicazione di chat può ricostruire la sua tabella messages mentre raggruppa le righe per conversazione e orario di invio utilizzando un indice esistente:
REPACK recupera spazio come VACUUM FULL; con USING INDEX, ordina anche fisicamente le righe come CLUSTER. Con CONCURRENTLY, PostgreSQL ricostruisce la tabella mentre le normali letture e scritture continuano, catturando le modifiche in corso tramite decodifica logica. Acquisisce quindi un blocco ACCESS EXCLUSIVE per applicare le eventuali modifiche catturate rimanenti e sostituire i file della nuova tabella e del nuovo indice. Questa fase è solitamente breve, ma può richiedere più tempo su una tabella molto attiva.
Ci sono vincoli operativi. Il raggruppamento concomitante crea uno slot di replica aggiuntivo per la durata dell'operazione, quindi richiede capacità libera sotto max_repack_replication_slots e una tabella con una chiave primaria non differibile o un'identità di replica basata su indice idonea. Richiede inoltre spazio su disco temporaneo per una copia della tabella e di tutti i relativi indici, potenzialmente più un file di ordinamento fino alle dimensioni della tabella. Le tabelle con un traffico elevato di aggiornamenti ed eliminazioni affrontano un ulteriore limite: l'attuale implementazione upstream di PostgreSQL 19 fallisce se più di circa 104 milioni di tuple nella tabella di destinazione vengono aggiornate o eliminate mentre REPACK (CONCURRENTLY) è in esecuzione. Questo conteggia le modifiche effettuate durante il repack, non le righe già presenti nella tabella.
Non tutti i tipi di relazione sono idonei. Le transazioni a lungo termine possono ritardare il blocco finale. Il raggruppamento concomitante non è nemmeno sicuro per MVCC: dopo il commit, le transazioni che utilizzano snapshot acquisiti prima dell'inizio del repack possono vedere la tabella come vuota. Il raggruppamento fisico si degrada anche con l'arrivo di nuove scritture.
REPACK CONCURRENTLY richiede ancora pianificazione, ma integra nel core un'attività che in precedenza richiedeva più tempo di inattività o un'estensione.
Consigli sul piano di query
L'ottimizzatore basato sui costi di PostgreSQL utilizza le statistiche delle tabelle e le stime dei costi per scegliere un piano di esecuzione. Il più delle volte, questo approccio funziona bene.
Le statistiche descrivono bene le singole tabelle, ma i dataset reali spesso contengono relazioni più difficili da catturare. Immagina che i clienti aziendali costituiscano lo 0,1% dei clienti ma generino il 30% degli ordini. Le statistiche per singola tabella non possono catturare questa correlazione tra tabelle.
Con un indice su orders.customer_id, il pianificatore potrebbe stimare che ogni cliente aziendale abbia solo pochi ordini e scegliere un ciclo annidato che sonda ripetutamente l'indice. Se quei clienti rappresentano effettivamente il 30% degli ordini, ogni ricerca restituisce molte più righe del previsto e un join hash potrebbe essere più appropriato.
PostgreSQL 19 aggiunge pg_plan_advice e pg_stash_advice per queste situazioni:
pg_plan_advicedescrive le decisioni del pianificatore come consigli, applica i consigli forniti e segnala se sono stati seguiti.pg_stash_advicememorizza i consigli per ID di query e li applica automaticamente quando viene pianificata una query corrispondente
Questi componenti non aggiungono statistiche tra tabelle né sostituiscono il pianificatore. Piuttosto, consentono di intervenire quando una stima imprecisa produce un piano scadente.
Considera una query che conta gli ordini dei clienti aziendali:
Qui, c è l'alias per la tabella dei clienti filtrata. Il seguente consiglio chiede a PostgreSQL di posizionare quei clienti sul lato interno di un join hash:
Quando PostgreSQL può applicare il consiglio, EXPLAIN restituisce un feedback simile a:
matched significa che il piano risultante è conforme al consiglio. Non significa che il nuovo piano sia necessariamente migliore; devi comunque valutarlo rispetto al carico di lavoro effettivo.
A differenza dei suggerimenti dell'ottimizzatore inline, i consigli sul piano si trovano al di fuori del testo della query dell'applicazione. Puoi ispezionare il piano corrente, testare consigli mirati e quindi salvarli per ID di query.
pg_stash_advice è il componente che applica automaticamente i consigli salvati. Crea l'estensione in ciascun database prima di utilizzare le relative funzioni di gestione dei salvataggi:
Crea un salvataggio e associa il consiglio testato all'ID di query riportato da EXPLAIN (VERBOSE). Sostituisci <query_id> con l'identificatore del tuo piano:
Configura il database per utilizzare il salvataggio per le nuove connessioni:
Sostituisci appdb con il nome del tuo database.
Tratta i consigli sul piano come uno stabilizzatore una volta diagnosticato il problema. Le distribuzioni dei dati cambiano, le istruzioni preparate memorizzate nella cache potrebbero continuare a utilizzare un piano meno recente per un po' e l'ottimizzatore ha comunque ragione più spesso di quanto si sbagli.
Quando il pianificatore passa inaspettatamente una query critica a un piano peggiore, PostgreSQL 19 offre un modo supportato per stabilizzarla.
Autovacuum parallelo e nuove viste statistiche
Autovacuum può ora utilizzare worker paralleli durante la pulizia degli indici, controllati da autovacuum_max_parallel_workers. Un nuovo sistema di punteggio assegna la priorità alle tabelle idonee in base all'urgenza con cui necessitano di pulizia o analisi.
Le nuove viste statistiche mostrano maggiori dettagli sulle attività del server:
pg_stat_lockriporta le statistiche per tipo di blocco.pg_stat_recoverymostra lo stato di ripristino.pg_stat_autovacuum_scoresmostra come autovacuum assegna la priorità alle tabelle.
Anche la diagnostica a livello di query migliora. EXPLAIN (ANALYZE, IO) riporta l'attività di I/O asincrono e auto_explain.log_io può includere le stesse informazioni nei piani registrati.
PostgreSQL 19 riporta inoltre i byte scritti per le immagini a pagina intera in pg_stat_wal, EXPLAIN (ANALYZE, WAL) e nei log di vacuum e analyze.
Nel complesso, questo rende le analisi delle prestazioni meno dipendenti dalle inferenze. È possibile vedere perché è stata data priorità al lavoro di manutenzione, dove si è verificato l'I/O asincrono e quanti byte WAL provengono da immagini a pagina intera.
Replicazione logica
La replicazione logica è diventata un'infrastruttura fondamentale per il change data capture, le migrazioni, la distribuzione in tempo reale e le pipeline ETL. PostgreSQL 19 colma diverse lacune di lunga data:
- La decodifica logica può essere attivata senza un riavvio quando
wal_levelèreplica. La creazione del primo slot di replicazione logica valido portaeffective_wal_levelalogical, mostrando il livello WAL attualmente attivo. - I valori delle sequenze possono essere sincronizzati dai publisher ai subscriber.
- Le pubblicazioni possono includere tutte le sequenze con
FOR ALL SEQUENCES. CREATE PUBLICATION ... FOR ALL TABLES EXCEPT (...)pubblica tutte le tabelle tranne un insieme specificato.- Le sottoscrizioni possono riutilizzare i dettagli di connessione da un server
postgres_fdwconCREATE SUBSCRIPTION ... SERVER. - L'opzione di sottoscrizione
retain_dead_tuplesconserva informazioni sufficienti perdetect update_deletedi conflitti, in cui un aggiornamento replicato si rivolge a una riga eliminata da un'altra origine. Il rilevamento richiede anchetrack_commit_timestampsul subscriber epg_stat_subscription_statsconta questi conflitti.
La sincronizzazione delle sequenze rimuove un caso limite di migrazione scomodo, soprattutto durante gli aggiornamenti di versione principale che utilizzano la replicazione logica. La copia delle righe di tabella senza far avanzare le relative sequenze può fare in modo che un subscriber promosso generi valori già esistenti, causando errori di chiave duplicata.
PostgreSQL copia i valori di sequenza iniziali quando la sottoscrizione viene creata con copy_data = true, che è l'impostazione predefinita. Le modifiche successive alle sequenze non vengono trasmesse in streaming continuamente, quindi è necessario aggiornarle subito prima del passaggio:
Questo aggiorna le sequenze già note alla sottoscrizione ai loro valori attuali sul publisher. Se la pubblicazione ha acquisito nuove sequenze, usa ALTER SUBSCRIPTION ... REFRESH PUBLICATION per aggiungerle e sincronizzarne i valori prima del passaggio.
WAIT FOR LSN
Le repliche di lettura asincrone aumentano la capacità di lettura senza costringere i commit primari ad attenderle. Il compromesso è il ritardo di replicazione. Un'applicazione può effettuare il commit di una scrittura sul database primario, leggere immediatamente da una replica e non trovare la riga perché la replica non ha ancora eseguito il replay del WAL corrispondente.
PostgreSQL 19 aggiunge un modo diretto per coordinare questo passaggio. Un LSN identifica una posizione nel WAL di PostgreSQL e WAIT FOR LSN blocca lo standby finché il replay non raggiunge almeno la posizione richiesta:
Per impostazione predefinita, WAIT FOR LSN attende indefinitamente che lo standby esegua il replay dell'LSN richiesto. Altre modalità possono attendere che il WAL venga scritto o scaricato ed è possibile impostare un timeout.
Il client o il connection pooler deve comunque trasportare l'LSN dal database primario alla replica. Ora il database fornisce il passaggio di sincronizzazione mancante, quindi il comportamento di lettura dopo la scrittura non richiede più polling o attese arbitrarie.
ON CONFLICT DO SELECT
INSERT ... ON CONFLICT DO SELECT offre un pattern pulito per ottenere o creare dati che restituisce sia le righe esistenti che quelle appena inserite:
Sostituisce la soluzione alternativa DO UPDATE SET col = EXCLUDED.col, che esegue un aggiornamento anche se nessun valore cambia. Questo crea una versione di riga nuova e lascia una tupla morta a ogni conflitto.
Output JSON per COPY TO
COPY TO ora può emettere direttamente JSON. Per impostazione predefinita, scrive un oggetto per riga, mentre FORCE_ARRAY racchiude l'output in un unico array JSON:
Il nuovo formato JSON è solo per l'esportazione, quindi COPY FROM non lo accetta.
SQL più piccolo e modifiche alle prestazioni
Infine, alcune modifiche compatte che migliorano l'esperienza d'uso:
- Le espressioni di percorso JSON acquisiscono metodi di stringa familiari come
btrim(),lower(),replace()esplit_part(). - La famiglia
random(min, max)ora supportadate,timestampetimestamptz, il che aiuta con i test e i set di dati sintetici. - Cinque funzioni finestra accettano
IGNORE NULLSeRESPECT NULLS. - Quando
io_method = worker, i worker di I/O si ridimensionano automaticamente traio_min_workerseio_max_workers. I controlli delle chiavi esterne sono più veloci e il pianificatore e l'esecutore ricevono un altro ciclo di ottimizzazioni mirate.
Abbiamo anche perso alcune funzionalità
Diverse funzionalità importanti sono state introdotte durante lo sviluppo di PostgreSQL 19, ma sono state rimosse prima del rilascio. I revisori hanno riscontrato problemi di correttezza o di progettazione troppo rischiosi da risolvere a ciclo inoltrato, quindi la community ha rimandato le funzionalità a una versione successiva.
Alcune delle funzionalità che alla fine non saranno incluse nella versione 19:
SQL/PGQquery di property graph.CREATE PROPERTY GRAPHeGRAPH_TABLEhanno aggiunto il pattern matching per i grafi su tabelle regolari in SQL. Ripristinato il 7 settembre 2026.UPDATE and DELETE ... FOR PORTION OF.Aggiornamenti ed eliminazioni temporali che suddividono le righe per preservare la cronologia al di fuori dell'intervallo di tempo specificato. Ripristinato il 15 settembre 2026.ALTER TABLE ... MERGE PARTITIONSeSPLIT PARTITION. Comandi integrati per combinare o suddividere le partizioni. Ripristinato il 27 agosto 2026.GROUP BY ALL. Forma abbreviata per il raggruppamento in base a ogni espressione non aggregata nell'elenco di selezione. Ripristinato il 17 luglio 2026.- Formati di output non di testo per
pg_dumpall. Ripristinato il 18 giugno 2026. - Funzioni di estrazione DDL.
pg_get_role_ddl(),pg_get_tablespace_ddl()epg_get_database_ddl()sono stati ripristinati il 13 settembre 2026.
Un ringraziamento ai contributori di PostgreSQL
PostgreSQL è realizzato grazie ai suoi contributori: un ringraziamento alle centinaia di membri della community menzionati nelle note di rilascio. Un ringraziamento speciale agli ingegneri del team Lakebase che hanno lavorato su questa versione di PostgreSQL:
- Robert Haas ha scritto pg_plan_advice e pg_stash_advice (quest'ultimo insieme a Lukas Fittl)
- Heikki Linnakangas ha lavorato a un nuovo meccanismo per la registrazione della memoria condivisa, a una riprogettazione del modo in cui i sottosistemi la allocano, a correzioni per multixact e alla nuova impostazione predefinita di 128 per max_locks_per_transaction
- Jeff Davis ha scritto la modifica che consente a CREATE SUBSCRIPTION di riutilizzare i dettagli di connessione di un server postgres_fdw e ha svolto un lavoro approfondito su impostazioni internazionali e gestione dei caratteri
- Jonathan Katz ha lavorato al comunicato stampa di PostgreSQL 19 e ha gestito il coordinamento del rilascio
- Matthias van de Meent ha lavorato a vari commit, inclusa la modifica alle routine dei metodi di accesso agli indici statici
- Alexander Lakhin ha individuato e segnalato diversi bug
Aggiornamento a PostgreSQL 19
Come per ogni nuova versione principale di PostgreSQL, consigliamo un approccio graduale all'adozione. Prima di passare i carichi di lavoro di produzione alla versione 19.0, ti consigliamo di:
- Testare prima i tuoi carichi di lavoro, le tue query e le tue estensioni su PostgreSQL 19 in un ambiente di sviluppo o di staging
- Confrontare le prestazioni e il comportamento con la versione attuale, poiché i rilasci principali possono modificare i piani di esecuzione delle query e le impostazioni predefinite
- Verificare che le estensioni su cui fai affidamento siano disponibili per PostgreSQL 19 (vedi sotto).
- Mantenere l'ambiente di produzione sulla versione attuale finché non sarai soddisfatto dei risultati
PostgreSQL 19 modifica inoltre diverse impostazioni predefinite e comportamenti di compatibilità. Verificali prima di procedere con l'aggiornamento:
- La compilazione JIT è disabilitata per impostazione predefinita
- La compressione TOAST utilizza LZ4 anziché pglz per impostazione predefinita
- L'autenticazione tramite password MD5 genera avvisi di deprecazione più rigorosi
- Il supporto per l'autenticazione RADIUS è stato rimosso
- standard_conforming_strings è sempre attivo
- pg_upgrade rifiuta i cluster con indici btree_gist interessati su inet o cidr
- I nomi di database, ruoli e tablespace non possono più contenere ritorni a capo o avanzamenti di riga
Una nota sulle estensioni
Abbiamo coperto la maggior parte delle estensioni supportate nella nostra release di PostgreSQL 18, ma non tutte sono ancora disponibili su PostgreSQL 19. Ne aggiungeremo altre non appena saranno rese disponibili dai rispettivi fornitori. Se il tuo carico di lavoro dipende da un'estensione specifica, assicurati che sia disponibile su PostgreSQL 19 prima di pianificare la migrazione.
La community rilascia solitamente la prima versione minore a pochi mesi di distanza da una versione principale, man mano che l'utilizzo nel mondo reale evidenzia correzioni e miglioramenti. PostgreSQL 19.1 è previsto per febbraio e molti team programmano gli aggiornamenti di produzione in concomitanza con quel rilascio. Si tratta di una prassi comune e sensata per qualsiasi versione .0, e vale anche in questo caso.
Qualunque siano le tue tempistiche, siamo qui per aiutarti. Se desideri parlare della pianificazione degli aggiornamenti o dei test, contatta il tuo team di account o il supporto Databricks.
Provalo
PostgreSQL 19 è disponibile oggi su Lakebase. Crea un progetto PostgreSQL 19 nel tuo spazio di lavoro per provarlo oppure inizia a usare Lakebase se sei un nuovo utente.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.