RADAR: Identifica i guasti grigi con il rilevamento delle anomalie
Come il rilevamento delle anomalie in tempo reale individua interruzioni parziali e silenziose in pochi minuti — e come creare lo stesso sistema su Databricks.
- I gray failure sfuggono alle dashboard verdi, costandoti silenziosamente clienti e ricavi prima che chiunque se ne accorga.
- RADAR è un pattern a quattro fasi, agnostico rispetto alle metriche — metriche di affidabilità, rilevamento delle anomalie, alerting e analisi delle cause principali (root-cause analysis) — che Databricks esegue su se stesso per individuare questi guasti in pochi minuti, con una precisione superiore al 90% e una scoperta più rapida del 95%.
- Puoi creare lo stesso sistema su Databricks per qualsiasi metrica — fatturazione, conversione o prestazioni del modello — utilizzando componenti nativi e uno scaffold di agenti AI.
Alcune delle interruzioni di servizio più dannose sono quelle che il monitoraggio non segnala mai: una parte dei clienti riscontra problemi in silenzio, mentre tutti gli health check risultano regolari. Questi "gray failure" causano la perdita di utenti e ricavi per ore prima che qualcuno colleghi i vari elementi. Questo post spiega come individuarli tempestivamente grazie al rilevamento delle anomalie — come lo facciamo in Databricks con un sistema chiamato RADAR e come puoi creare la stessa soluzione per qualsiasi metrica sia fondamentale per il tuo business. È scritto per chi si occupa dell'affidabilità dei servizi: SRE, ingegneri di piattaforma e dei dati, personale di reperibilità e i responsabili engineering a cui fanno riferimento.
Quando tutto è verde ma niente va bene
Immagina un normale mercoledì. Il tuo lavoro consiste nel garantire l'affidabilità di un servizio rivolto ai clienti e ogni dashboard sulla parete è verde: CPU ottimale, latenza regolare, server attivi, database connesso. In base a ogni segnale monitorato dal tuo team, il sistema sembra perfetto.
Ma non lo è.
- 9:30 — Un deploy di routine introduce un bug impercettibile nel flusso di checkout.
- 9:35 — Un cliente su venti che paga con carta di credito riscontra un errore silenzioso. Dopo un paio di tentativi, rinuncia e abbandona il sito.
- 12:40 — Arriva il primo ticket di supporto. Sembra solo un altro numero di carta digitato in modo errato, quindi nessuno ci fa caso.
- 14:20 — Arrivano altri due ticket sullo stesso problema.
- 14:25 — Il responsabile del supporto nota la ricorrenza e segnala il problema.
- 16:00 — Gli ingegneri individuano il bug e rilasciano una correzione.
Per quasi sette ore, il sistema di monitoraggio ha continuato a segnalare che tutto andava bene, mentre i clienti se ne andavano e i ricavi sfumavano.
Che cos'è un gray failure?
Quel mercoledì rappresenta un gray failure da manuale. In superficie tutto sembra funzionare; sotto, un componente specifico ha smesso silenziosamente di funzionare, danneggiando i clienti senza mai attivare un avviso.
Due elementi rendono i gray failure così insidiosi:
- Sono parziali. Non riguardano tutti, ma solo una parte, come un singolo tipo di carta di credito. Non c'è un crash del server che verrebbe rilevato all'istante, ma solo una situazione intermedia confusa in cui la maggior parte degli utenti non ha problemi e un gruppo specifico riscontra costantemente errori.
- Crescono. Ciò che inizia con un piccolo gruppo di clienti interessati si diffonde. Se non si interviene, sempre più persone si scontrano con lo stesso ostacolo.
Pensa a questa situazione come al fumo dietro una parete. Dall'esterno la casa sembra a posto, ma all'interno il danno si sta diffondendo e più aspetti, più il raggio d'impatto si amplia. Anche i ricercatori hanno dato un nome al problema di fondo: lo studio di Microsoft Gray Failure: The Achilles’ Heel of Cloud-Scale Systems lo definisce "osservabilità differenziale" — i tuoi rilevatori di guasti non notano un problema che invece per gli utenti è evidente.
Perché aspettare le segnalazioni dei clienti non funziona
La maggior parte dei team gestisce i gray failure esattamente come è successo quel mercoledì: aspetta che siano i clienti a segnalarli. Le segnalazioni dei clienti sono importanti — rappresentano un disagio reale per le persone — ma i clienti non dovrebbero fungere da sistema di monitoraggio. Affidarsi esclusivamente alle segnalazioni presenta tre problemi:
- È manuale. Qualcuno deve notare lo stesso reclamo in mezzo a una montagna di ticket. È facile che sfugga.
- Richiede tempo. Prima che un numero sufficiente di persone si lamenti consentendo di collegare i vari elementi, sono già passate ore o giorni.
- È silenzioso. La maggior parte dei clienti interessati non apre affatto un ticket. Semplicemente abbandona il servizio.
La soluzione non è smettere di leggere i ticket: continua a farlo. Si tratta invece di aggiungere un rilevamento automatico che sia sempre attivo e individui ciò che sfugge alle persone. In concreto, serve un sistema che si attivi nel momento in cui un numero di clienti molto superiore alla norma inizia a riscontrare lo stesso problema contemporaneamente.
| Solo segnalazioni dei clienti | Con rilevamento automatico |
|---|---|
| Manuale — facile che sfugga | Individua ciò che sfugge alle persone |
| Ritardato — rilevato in giorni | Rapido — rilevato in tempo reale |
| I clienti riscontrano problemi in silenzio | Segnala il picco — molti utenti contemporaneamente |
Ti presentiamo RADAR
Questa è l'idea alla base di RADAR — Reliability Anomaly Detection, Alerting, and Root-cause analysis. Lo abbiamo sviluppato in Databricks per individuare i gray failure in pochi minuti anziché in ore. Il nome è azzeccato: quando la visibilità è scarsa, non aspetti che qualcosa ti colpisca, ma esegui una scansione preventiva alla ricerca di segnali deboli.
Ecco come lo indirizziamo verso un segnale particolarmente utile: gli errori dell'utente.
Un gray failure si manifesta spesso come un picco improvviso di errori che sembrano causati dall'utente. Immagina un gruppo di utenti in una determinata area geografica che all'improvviso non riesce ad avviare un certo tipo di cluster. Ogni richiesta fallisce con l'errore INVALID_ARGUMENT, che dice gentilmente: "questo è un problema tuo".
Ma quando molti utenti riscontrano lo stesso errore "causato da loro" nello stesso momento, la colpa non è più loro. È nostra. Quel picco è esattamente il pattern che RADAR è progettato per individuare.
Le quattro fasi di RADAR
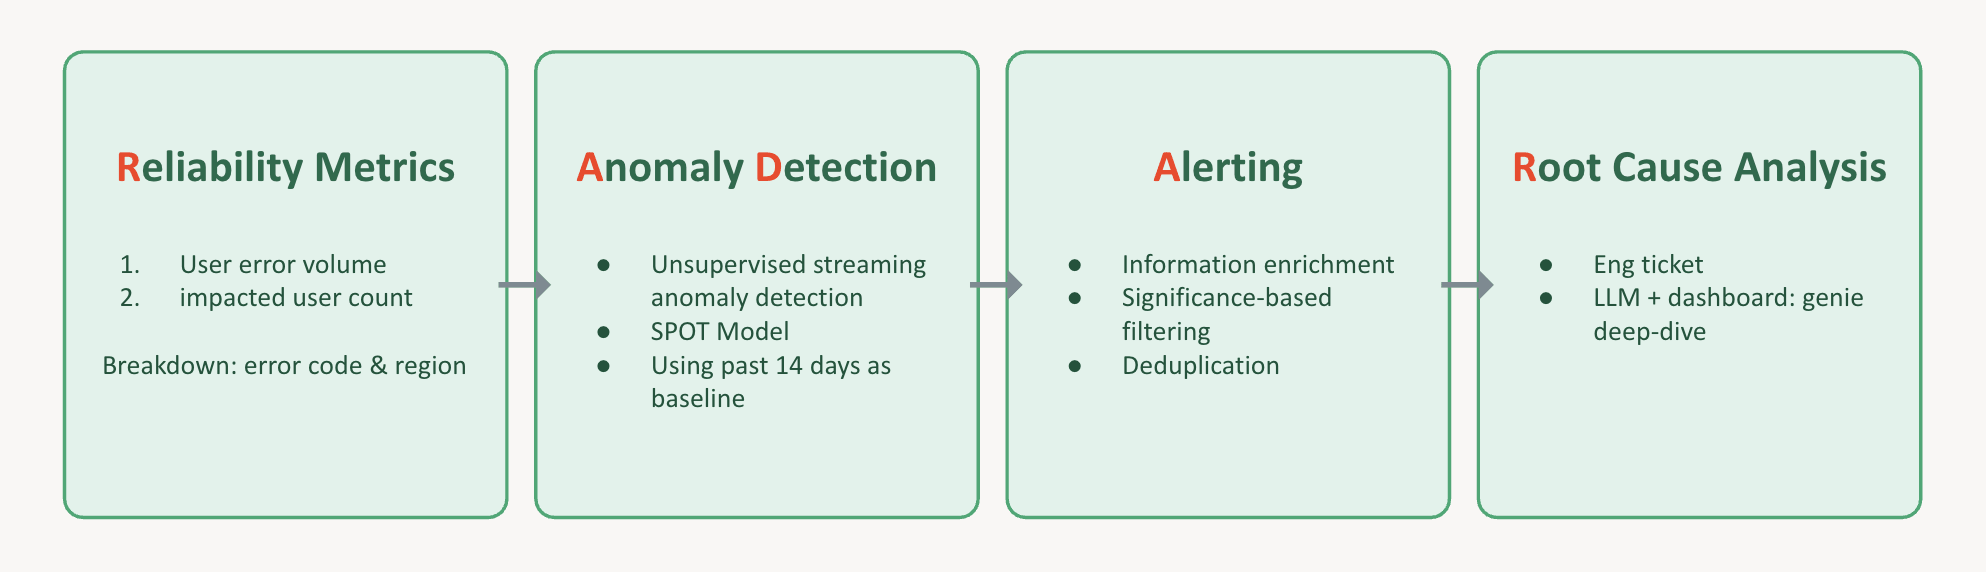
RADAR trasforma questa intuizione in una pipeline a quattro fasi:
- Metriche di affidabilità. In ogni momento, registra due elementi: quanti errori si stanno verificando e quanti singoli utenti riscontrano ciascuno di essi. Suddividili per codice di errore e area geografica. In questo modo otterrai un ricco set di serie temporali che descrivono lo stato di salute del tuo servizio.
- Rilevamento delle anomalie. Esegui il rilevamento delle anomalie su ciascuna di queste serie, in modo che il sistema possa segnalare qualsiasi anomalia, senza dover configurare manualmente una serie di soglie. Utilizziamo un modello di streaming non supervisionato chiamato SPOT, che apprende cosa sia "normale" in base agli ultimi 14 giorni e richiede solo un singolo parametro di rischio anziché soglie manuali. (SPOT deriva dallo studio di Siffer et al. Anomaly Detection in Streams with Extreme Value Theory, KDD 2017.)
- Alerting. Quando si attiva un avviso, entra in gioco il livello di alerting. Questo arricchisce l'avviso con informazioni di contesto, filtra ciò che non è significativo ed elimina i duplicati per evitare che il personale di reperibilità venga sommerso da copie della stessa segnalazione. Successivamente, genera un ticket indirizzato al team di engineering competente per quell'errore.
- Analisi delle cause radice. Ogni ticket include dettagli approfonditi sull'anomalia e un link a una dashboard supportata da un assistente basato sull'intelligenza artificiale, AI/BI Genie. Chiunque sia di turno può passare direttamente a individuare cosa si è effettivamente interrotto, nel minor tempo possibile.
I risultati che abbiamo ottenuto
L'utilizzo di RADAR all'interno della nostra infrastruttura ha cambiato radicalmente la gestione di questi incidenti. In precedenza, dipendevamo dai ticket dei clienti per scoprirli, con conseguenti giorni di ritardo. Con RADAR, abbiamo ottenuto una riduzione del 95% dei tempi di individuazione degli incidenti, con una precisione superiore al 90%, senza bisogno dell'intervento umano per identificare la ricorrenza. Di conseguenza, siamo in grado di contenere il raggio d'impatto dei gray failure.
Indirizza RADAR verso qualsiasi metrica
Ecco la parte più importante per te: a RADAR non interessa il tipo di metrica. Noi lo applichiamo agli errori dell'utente, ma lo stesso pattern funziona ovunque un valore numerico possa subire variazioni anomale in silenzio:
- Servizi finanziari — errori nei pagamenti e nelle transazioni, anomalie di fatturazione, segnali di frode
- Retail ed e-commerce — conversione del checkout, errori nel carrello, tempi di consegna
- Sanità e scienze della vita — flusso dei pazienti, elaborazione delle richieste di rimborso
- Qualsiasi prodotto di AI — prestazioni del modello e deriva della distribuzione dei dati (data drift) che si manifestano prima che un modello si interrompa visibilmente
Si tratta dello stesso pattern applicato a contesti diversi. Ovunque ci sia qualcosa che rischia di non funzionare correttamente in silenzio, RADAR può essere applicato.
Crea la tua soluzione su Databricks
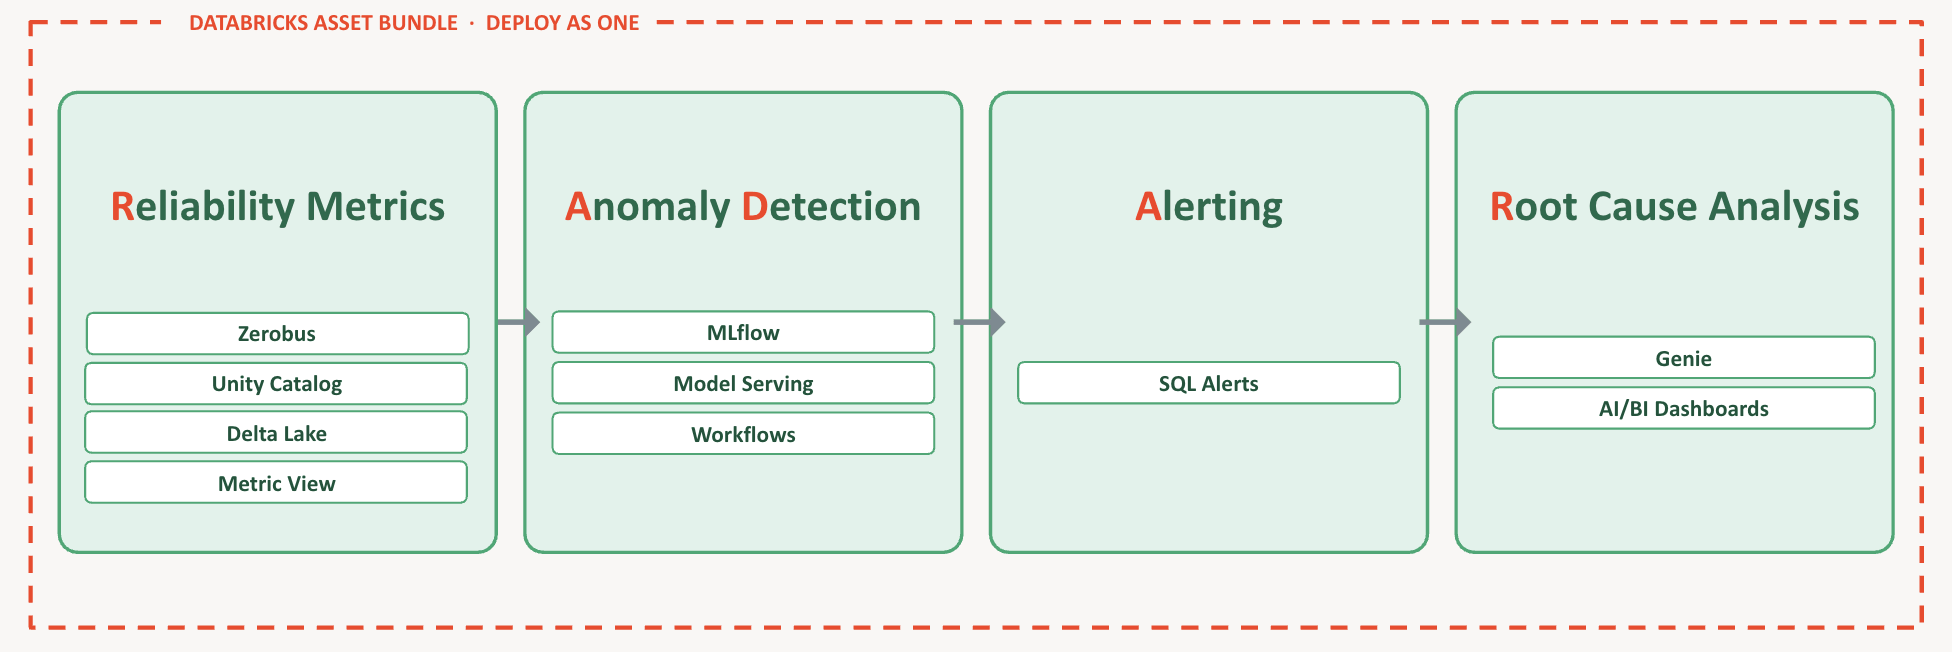
La notizia migliore è che tutti i componenti necessari sono già disponibili su Databricks. Se associ le quattro fasi alla piattaforma, la struttura si presenta così:
- Metriche di affidabilità — Zerobus per l'ingestione a bassa latenza, Unity Catalog e Metric View per la governance, Delta Lake per l'archiviazione
- Rilevamento delle anomalie — MLflow per l'addestramento dei modelli, Model Serving per distribuire l'endpoint del modello e Workflows per orchestrare i job ricorrenti
- Alerting — Databricks SQL Alerts per attivare gli avvisi
- Analisi delle cause alla radice — AI/BI Genie e AI/BI Dashboards
E l'intero sistema viene distribuito come un'unica unità tramite un Declarative Asset Bundle (DAB).
Collegare manualmente tutte queste parti è la parte più fastidiosa, quindi l'abbiamo eliminata. Abbiamo sintetizzato l'intero sistema RADAR interno in un unico scaffold: un file markdown che funziona come una ricetta, mappando ogni parte di RADAR su uno specifico componente Databricks (raccolta e archiviazione → una tabella Delta; rilevamento dell'anomalia → un job; avviso e deduplicazione → un ticket; visualizzazione → una dashboard).
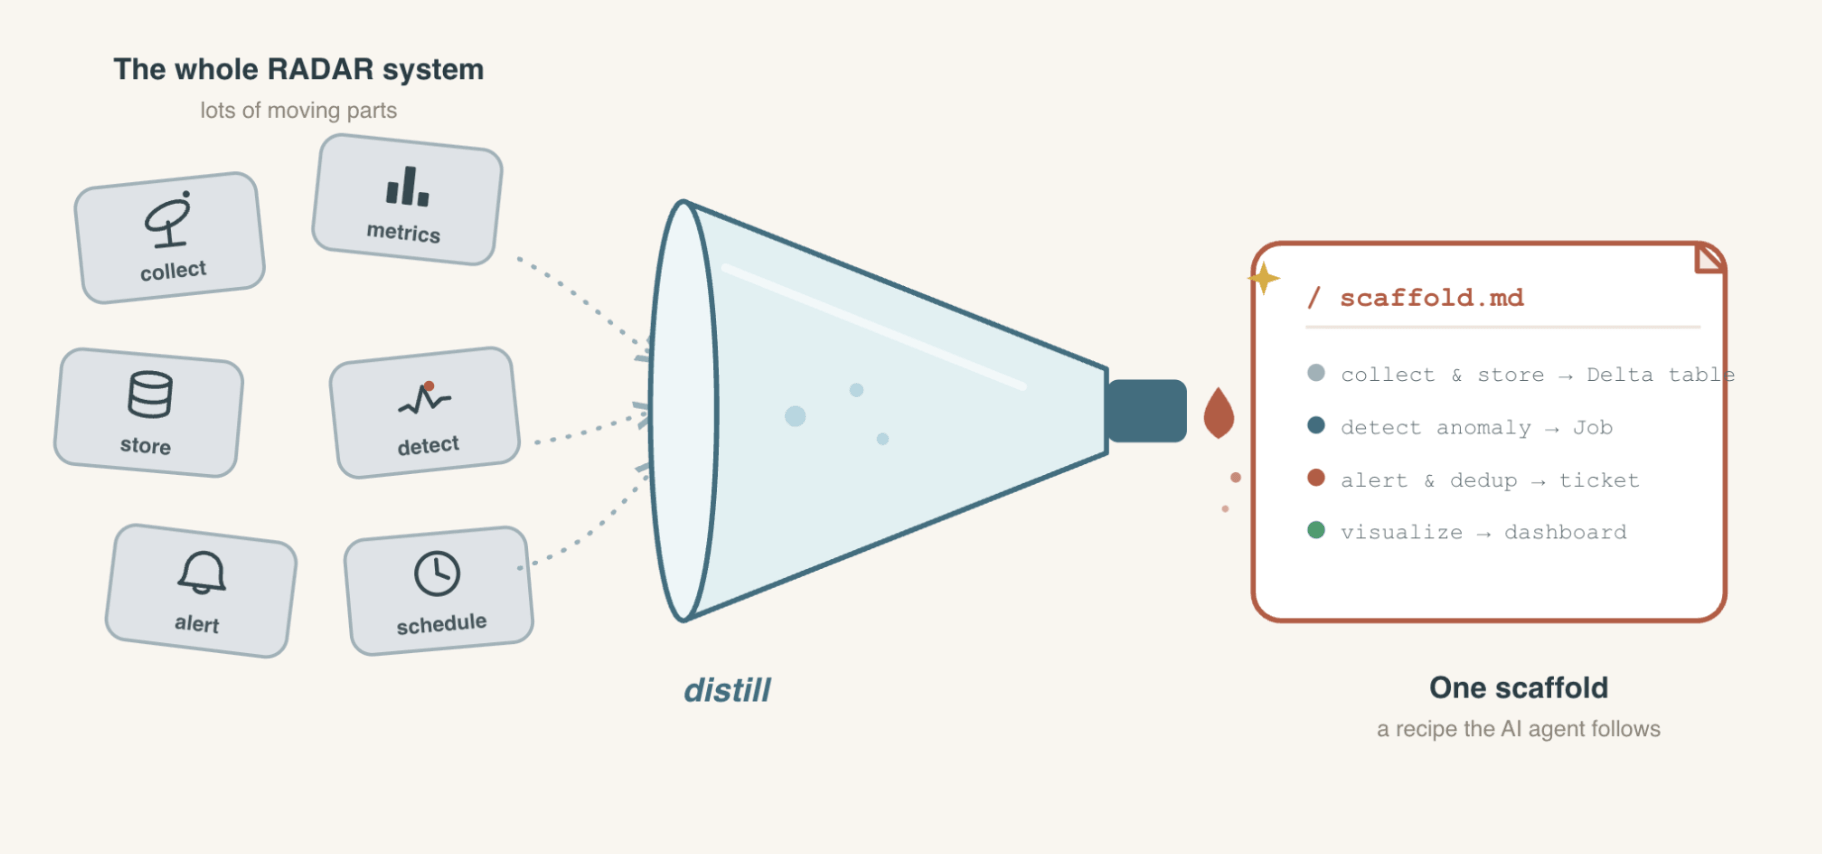
Poi arriva il bello. Ti basta inserire la tua metrica — ovunque si trovi il tuo segnale — e passare la metrica, lo scaffold e un breve prompt a un agente IA. Questo creerà l'intero sistema RADAR per te, direttamente su Databricks. Puoi seguire le istruzioni su GitHub per scoprire come crearne uno a partire da un singolo prompt.
Punti chiave
Ecco due cose da ricordare:
- Intercetta i gray failure prima che si aggravino. Le dashboard verdi non sono una prova che tutto funzioni al meglio per i clienti. Aggiungi il rilevamento delle anomalie in tempo reale in modo che un guasto parziale e silenzioso emerga in pochi minuti, anziché in giorni.
- Crea RADAR su Databricks per qualsiasi metrica sia importante per te. Lo scaffold, la demo e il prompt sono tutti pubblici: inizia da lì.
Ottieni lo scaffold di RADAR su GitHub
Perché il risultato migliore non è una risposta più rapida ai clienti arrabbiati, ma evitare che siano i clienti stessi a dover scoprire i tuoi incidenti al posto tuo.
(Questo post sul blog è stato tradotto utilizzando strumenti basati sull'intelligenza artificiale) Post originale
Ricevi gli ultimi articoli nella tua casella di posta
Iscriviti al nostro blog e ricevi gli ultimi articoli direttamente nella tua casella di posta.